Czym jest otwarty format tabeli
|
10
min. czyt.

Jesteś tu pewnie dlatego, że Twoje jezioro w jednym narzędziu wygląda już jak tabela, a w innym zachowuje się jak sterta plików.
Finansowy pulpit zmienia się po fakcie. Uzupełnienie danych naprawia jedno zapytanie i psuje drugie. Zapisy Sparka się udają, Trino czyta nieaktualne dane, a nikt nie potrafi odpowiedzieć na podstawowe pytanie: która wersja tego zbioru jest właściwa? W tym momencie ludzie przestają pytać „jakiego formatu pliku użyć?”, a zaczynają pytać: czym właściwie jest otwarty format tabeli?
Krótka odpowiedź jest prosta. Otwarty format tabeli to warstwa metadanych, dzięki której magazyn obiektowy zachowuje się jak tabela bazy danych. Dłuższa odpowiedź liczy się bardziej, bo sam format to tylko połowa historii. Druga połowa to sposób, w jaki Twój zespół go eksploatuje: kompaktowanie, kontrola schematu, katalogi i obserwowalność.
Spis treści
Moment, w którym jezioro danych przestaje być wiarygodne
Typowa awaria się zaczyna.
Finanse sprawdzają wczorajszy raport przychodów i widzą, że nie zgadza się już z pulpitem. Żaden potok nie jest czerwony. Żaden orkiestrator nie pokazuje nieudanego zadania. Pliki wciąż są w magazynie obiektowym. Ale gdzieś pomiędzy strumieniowym dopisaniem a zadaniem konserwacyjnym czytający pochwycili częściowy widok tabeli.
Dlaczego surowy magazyn psuje się w subtelny sposób
Magazyn obiektowy świetnie przechowuje pliki. Sam w sobie nie jest systemem tabel.
Jeśli trzymasz pliki Parquet w folderze i nazwiesz ten folder revenue, wciąż nie odpowiedziałeś na pytania, które obchodzą analityków:
Które pliki należą teraz do tabeli
Który zapis wytworzył bieżącą wersję
Którego schematu powinien użyć czytający
Jak tabela wyglądała w zeszłym tygodniu
Które pliki zapytanie może bezpiecznie zignorować
Bez tej warstwy metadanych każdy silnik musi wnioskować stan z list katalogów i nazw plików. Przez pewien czas to działa. Potem ktoś przepisuje partycje, kompaktuje pliki albo zmienia typ kolumny, a czytający zaczynają widzieć różne prawdy z tej samej ścieżki magazynu.
Surowe pliki mogą poprawnie przechowywać dane i mimo to dawać niewiarygodną analitykę.
Brakująca warstwa
Otwarty format tabeli dokłada obok samych danych brakujący zapis stanu tabeli. Zamiast traktować magazyn jako „jakiekolwiek pliki leżące pod tym prefiksem”, rejestruje nadzorowany widok tabeli: bieżące pliki, historyczne migawki, schemat i metadane układu.
Dlatego zespoły inwestujące w monitorowanie jeziora danych odkrywają często ten sam wzorzec. Problemem zwykle nie jest tylko wadliwy zapis pliku. Chodzi o to, że platformie brakuje wiarygodnego sposobu opisania stanu tabeli między czytającymi a zapisującymi.
Różnica wydaje się drobna aż do pierwszej cichej niespójności. Potem staje się fundamentalna.
Co naprawdę robi otwarty format tabeli
Nowy potok dostarcza pliki zastępcze dla revenue. Zadanie Sparka kończy się. Analityczka odświeża pulpit w Trino. Zadanie cech uczenia maszynowego czyta tę samą tabelę przez inny silnik. Wszystkie trzy zapytania trafiają w tę samą ścieżkę magazynu, ale nie zawsze widzą tę samą odpowiedź.
Właśnie tę lukę otwarty format tabeli ma zamykać.
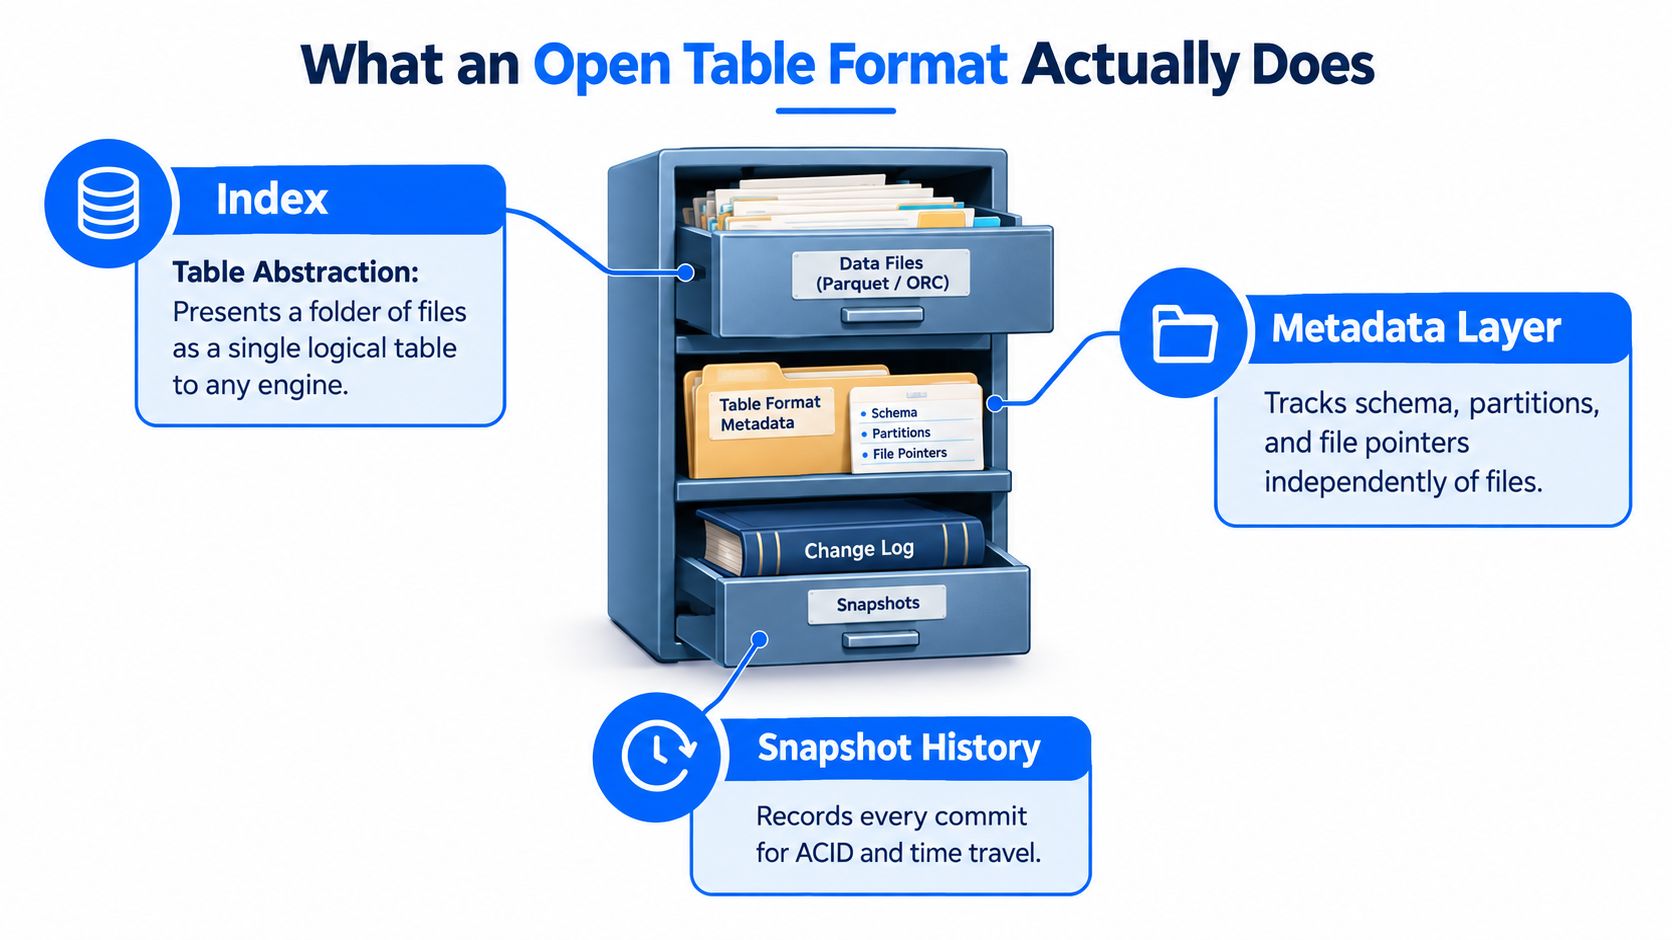
Leży nad plikami i definiuje stan tabeli
Otwarte formaty tabel bywają mylone z formatami plików, bo jedne i drugie pojawiają się w tym samym kubełku. Rozwiązują różne problemy.
Parquet, ORC i Avro definiują, jak pojedynczy plik przechowuje wiersze i kolumny. Otwarty format tabeli definiuje, jak zbiór plików staje się jedną logiczną tabelą, którą wiele silników może bezpiecznie czytać i zapisywać. Databricks opisuje otwarte formaty tabel jako warstwę metadanych nad Parquet, ORC lub Avro w magazynie obiektowym, dodającą funkcje tabel takie jak transakcje ACID, ewolucja schematu i podróż w czasie, w swoim przeglądzie otwartych formatów tabel.
Jeśli to rozróżnienie wciąż się rozmywa, pomaga ten przewodnik o tym, czym jest Parquet i jak przechowuje dane kolumnowe. Parquet odpowiada na pytanie „jak zakodowany jest ten plik?”. Format tabeli odpowiada „które pliki tworzą tabelę i której wersji czytający mają ufać?”.
Format działa jak warstwa sterowania tabeli
Użytecznym modelem myślowym jest historia Git dla plików danych, z ostrzejszymi regułami wokół współbieżności i schematu. Format tabeli prowadzi zapis bieżącego stanu i drogi, która do niego doprowadziła. Silniki zapytań nie muszą przeszukiwać folderów i zgadywać. Mogą przeczytać metadane tabeli i dostać dokładną odpowiedź.
W praktyce ta warstwa metadanych pełni cztery zadania.
Deklaruje przynależność plików
Format zapisuje, które pliki należą teraz do tabeli. Jeśli kompaktowanie przepisze dziesięć małych plików w jeden większy, czytający podążą za wskaźnikiem metadanych do poprawnego zestawu zamiast mieszać stare i nowe dane.Publikuje migawki atomowo
Zapis staje się widoczny jako nowa zatwierdzona migawka. Czytający widzą starą albo nową wersję, nie stan pośredni, w którym połowa plików już się zmieniła.Śledzi schemat jako metadane tabeli
Nazwy kolumn, typy, identyfikatory pól i dozwolone zmiany żyją w definicji tabeli, a nie tylko w tym, co akurat wypuścił zapisujący. To zaczyna się liczyć, gdy różne silniki zmieniają nazwy kolumn, poszerzają typy albo dodają pola zagnieżdżone.Przechowuje metadane układu i przycinania
Wartości partycji, statystyki plików, a czasem metadane usunięć pomagają silnikom pomijać nieistotne pliki i sprawnie planować zapytania.
Warstwę operacyjną zespoły zwykle lekceważą
Lista funkcji to łatwa część. To w modelu operacyjnym otwarte formaty tabel zarabiają na siebie.
Gdy format przejmuje stan tabeli, Twój zespół musi zdecydować, kto odpowiada za kompaktowanie, kto zatwierdza zmiany schematu i który katalog jest źródłem prawdy. To pytania produkcyjne, nie broszurowe. Jeśli nikt nie odpowiada za kompaktowanie, małe pliki się piętrzą, a wydajność zapytań dryfuje. Jeśli każdy zapisujący może swobodnie zmieniać schemat, jedno złe wdrożenie zepsuje czytających niżej. Jeśli Spark używa jednego widoku katalogu, a Trino innego, wracasz do wielu prawd, tyle że w lepszym opakowaniu.
Format daje mechanizmy. Twój zespół platformowy wciąż potrzebuje reguł.
Dlaczego ta zmiana liczy się w codziennej pracy
Bez formatu tabeli zapis danych często znaczy „pliki zostały wgrane”. Z formatem tabeli zapis danych znaczy „nowa wersja tabeli została zatwierdzona i opublikowana”.
To mocniejszy kontrakt dla każdego systemu niżej. Zadania wsadowe, zapytania BI i czytający strumieniowo mogą zgodzić się co do stanu tabeli. Silniki mogą współdziałać przez wspólne metadane zamiast przez konwencje ścieżek. Inżynierowie danych mogą myśleć o pracach konserwacyjnych, jak kompaktowanie czy ewolucja partycji, bez traktowania każdego przepisania jako potencjalnej awarii.
Otwarty format tabeli jest więc warstwą, która zamienia magazyn obiektowy w system tabel, dający się eksploatować z przekonaniem. Format pliku wciąż ma znaczenie. Ukrytą wygraną jest to, że metadane dają zespołowi kontrolowany sposób utrzymania spójnego stanu tabeli, gdy mnożą się zapisy, schematy i silniki.
Jak format ewoluował od Hive do lakehouse
Historia ma znaczenie, bo każdy format powstał, by naprawić konkretny ból, a nie po to, by wygrać tabelę funkcji.
Użyteczna oś czasu z historii i ewolucji otwartych formatów tabel umieszcza Apache Hive w 2008, Apache Hudi w 2016, Apache Iceberg w 2017 i Delta Lake w latach 2017–2019. Ta sekwencja pokazuje, jak szybko warstwa tabel lakehouse dojrzała, gdy zespoły uderzyły w limity wczesnych wzorców jezior danych.

Hive rozwiązał problem swojej epoki
Hive dał wczesnym zespołom Hadoopa sposób na traktowanie plików w HDFS jak tabel. Jego model partycji mocno opierał się na strukturze katalogów. Pasowało to do ówczesnych założeń.
Te założenia źle zestarzały się w chmurowym magazynie obiektowym. Partycjonowanie katalogami stało się kruche. Zachowanie listowania i zmiany nazw nie przypominało HDFS. Długowieczne tabele robiły się niewygodne, gdy zmieniały się strategie partycjonowania.
Kolejna fala naprawiła konkretne tryby awarii
Każdy nowszy format odpowiadał na inną słabość operacyjną.
Apache Hudi pojawił się w 2016 roku, by obsłużyć obciążenia wymagające upsertów na poziomie rekordu i przetwarzania przyrostowego w środowiskach jezior danych.
Apache Iceberg przyszedł w 2017 roku, by zająć się problemami dużych tabel analitycznych, skalowania metadanych i ewolucji partycji.
Delta Lake ukształtował się w latach 2017–2019 jako oparta na logu transakcji droga do wniesienia wiarygodnego zachowania ACID do otwartego magazynu.
W tym momencie branża wyszła poza „jak wrzucić pliki do jeziora?” do „jak wiele silników ma dzielić wiarygodne tabele na tanim magazynie?”.
Nazwa lakehouse przyszła po zwrocie inżynierskim
Zwrot architektoniczny był pierwszy. Etykieta lakehouse poszła za nim.
Jeśli chcesz szerszego kontekstu stosu wokół formatów, katalogów, silników i nadzoru, ten przewodnik o tym, czym jest lakehouse i jak utrzymać jakość danych, daje obraz całości. Ważny punkt tutaj jest węższy: otwarte formaty tabel stały się warstwą, która uczyniła obietnice lakehouse technicznie wiarygodnymi.
Do lat 2025–2026 warstwa ta dojrzała jeszcze bardziej. Ta sama oś czasu odnotowuje, że specyfikacja tabel Iceberg v3 została ratyfikowana w 2025 roku, a Iceberg 1.10 i 1.11 przyniosły stabilne wsparcie dla funkcji takich jak wektory usunięć, typy variant, typy geoprzestrzenne i znaczniki czasu z dokładnością do nanosekund w tej późniejszej fazie ewolucji formatu.
Iceberg, Delta Lake i Hudi w porównaniu
Decyzja o formacie wygląda podczas oceny prosto. Potem rusza produkcja, zadanie strumieniowe zostaje w tyle, piętrzą się małe pliki, dwa silniki nie zgadzają się co do zmian schematu i pojawia się pytanie: kto odpowiada za konserwację tabeli i jak przewidywalna jest ta praca?
Apache Iceberg, Delta Lake i Apache Hudi to formaty tabel gotowe na produkcję. Użyteczne porównanie nie dotyczy równości funkcji. Chodzi o to, jak każdy format organizuje metadane, koordynuje zapisy i przypisuje odpowiedzialność za obowiązki operacyjne, takie jak kompaktowanie, sprzątanie i zgodność między silnikami.
Największą różnicą jest architektura metadanych
Pliki danych mogą leżeć w magazynie obiektowym, ale każdy format prowadzi „spis treści” tabeli inaczej. Przegląd Dremio dotyczący architektury Iceberg, Delta Lake i Hudi jest dobrym punktem odniesienia:
Delta Lake zapisuje zmiany tabeli w sekwencyjnym logu transakcji pod
_delta_log.Iceberg śledzi stan tabeli przez metadane migawek i pliki manifestów opisujące, które pliki danych należą do której wersji.
Hudi prowadzi oś czasu działań, obejmującą zatwierdzenia i operacje konserwacyjne jak kompaktowanie, klastrowanie i czyszczenie.
Ten wybór projektowy wpływa na więcej niż wydajność odczytu. Zmienia tempo przyrostu metadanych, bezpieczeństwo zapisu z wielu silników, sposób obsługi zmian partycji oraz to, ile rutynowej opieki tabela wymaga od Twojego zespołu.
Iceberg, Delta Lake i Hudi w skrócie
Wymiar | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Projekt metadanych | Metadane migawek z listami manifestów i manifestami | Sekwencyjny log transakcji w | Oś czasu niezmiennych instantów obejmująca zapisy i usługi tabelowe |
Model partycjonowania | Ukryte partycjonowanie i ewolucja partycji, dzięki czemu logiczny schemat partycji może się zmienić bez przepisywania starszych plików | Zachowanie partycji sterowane jest stanem tabeli śledzonym w logu i konwencjami zapisujących | Zaprojektowany wokół układów o dużej ingestii, z usługami reorganizującymi pliki w czasie |
Styl współbieżności | Model izolacji migawkowej oparty na wersjach tabeli i podmianie metadanych | Protokół zatwierdzeń oparty na logu, ze wzorcami optymistycznej współbieżności | Protokół zatwierdzeń oparty na osi czasu, często w parze z usługami w tle |
Najlepsze dopasowanie | Współdzielone tabele analityczne dla wielu silników | Platformy skupione wokół Sparka, zwłaszcza tam, gdzie natywne narzędzia Delta są częścią codzienności | Częste upserty, przechwytywanie zmian i przetwarzanie przyrostowe |
Główny kompromis | Mocna interoperacyjność, ale liczy się dyscyplina katalogu, a reguły zapisu między silnikami muszą być jawne | Wzorce operacyjne są zwykle najprostsze tam, gdzie standard wyznaczają Spark i narzędzia świadome Delty | Elastyczność zapisu jest duża, ale kompaktowanie i klastrowanie wymagają aktywnego planowania i właścicieli |
Postawa wobec interoperacyjności | Szerokie wsparcie silników i katalogów. Specyfikacja Apache Iceberg to jeden z powodów, dla których wiele zespołów traktuje go jako najbardziej neutralną opcję tabeli współdzielonej | Mocne dziedzictwo Sparka, z rosnącą zgodnością w szerszym ekosystemie | Interoperacyjność się poprawiła, ale założenia operacyjne wciąż są bardziej nastawione na ingestię niż neutralne wobec silnika |
Lepsza soczewka decyzyjna: kto będzie eksploatował tabelę
Jeśli zespół porównuje tylko haczyki, wszystkie trzy wyglądają podobnie. W praktyce tworzą różną pracę dyżurną.
Iceberg pasuje często do organizacji, które chcą, by jedną tabelę czytało kilka silników, a nadzór szedł przez warstwę katalogu. Korzyścią jest przenośność. Kosztem jest dyscyplina. Zmiany schematu, kolejność sortowania, rozmiary plików, retencja migawek i spójność katalogu wymagają jasnej odpowiedzialności, zwłaszcza gdy zapisywać może więcej niż jeden silnik.
Delta Lake pasuje często do platform zbudowanych już wokół przepływów Sparka i narzędzi świadomych Delty. Ścieżka operacyjna bywa prosta, bo model transakcyjny i otaczające narzędzia są ściśle zestrojone. Kompromisem jest to, że strategia interoperacyjności zyskuje na wadze z czasem, jeśli platforma wyrasta poza pierwotne założenia co do silnika.
Hudi pasuje często do systemów o dużej ingestii, gdzie aktualizacje na poziomie rekordu i konsumpcja przyrostowa są częścią rdzenia projektu. Ta siła idzie w parze z bardziej widocznymi usługami tabelowymi. Kompaktowanie, klastrowanie i sprzątanie to nie detale. Ktoś musi je planować, obserwować i decydować, kiedy opóźnienie zapisu waży więcej niż układ do odczytu.
Tu także praca nad niezawodnością przestaje być oddzielona od pracy nad jakością. Spóźnione zadanie kompaktujące, nieprzejrzana zmiana schematu albo silnik zapisujący z błędnymi ustawieniami katalogu potrafią wywołać incydenty, których analitycy doświadczają jako „złe dane”. Zespoły z platformami skupionymi na Sparku oceniają często wybór formatu wraz z praktykami zarządzania jakością danych w Databricks, bo poprawność tabeli i kontrole jakości spotykają się w tym samym przepływie produkcyjnym.
Zły format rzadko zawodzi podczas demonstracji. Zawodzi przy zadaniu konserwacyjnym, o którym Twój zespół zakładał, że załatwi się samo.
ACID, podróż w czasie i ewolucja schematu wyjaśnione
Format tabeli staje się realny przy pierwszej awarii na produkcji. Potok zapisuje połowę plików, przy reszcie zawodzi, a analityczka odświeża pulpit dokładnie w najgorszym momencie. Bez kontroli transakcyjnej jezioro pokazuje ten bałagan wprost. Z otwartym formatem tabeli czytający wciąż widzą ostatni poprawny stan tabeli, dopóki nowy nie zostanie w pełni zatwierdzony.
ACID znaczy, że tabela ma wyraźny punkt zatwierdzenia
Praktyczna korzyść z ACID w lakehouse jest prosta. Czytający nie widzą pracy w połowie.
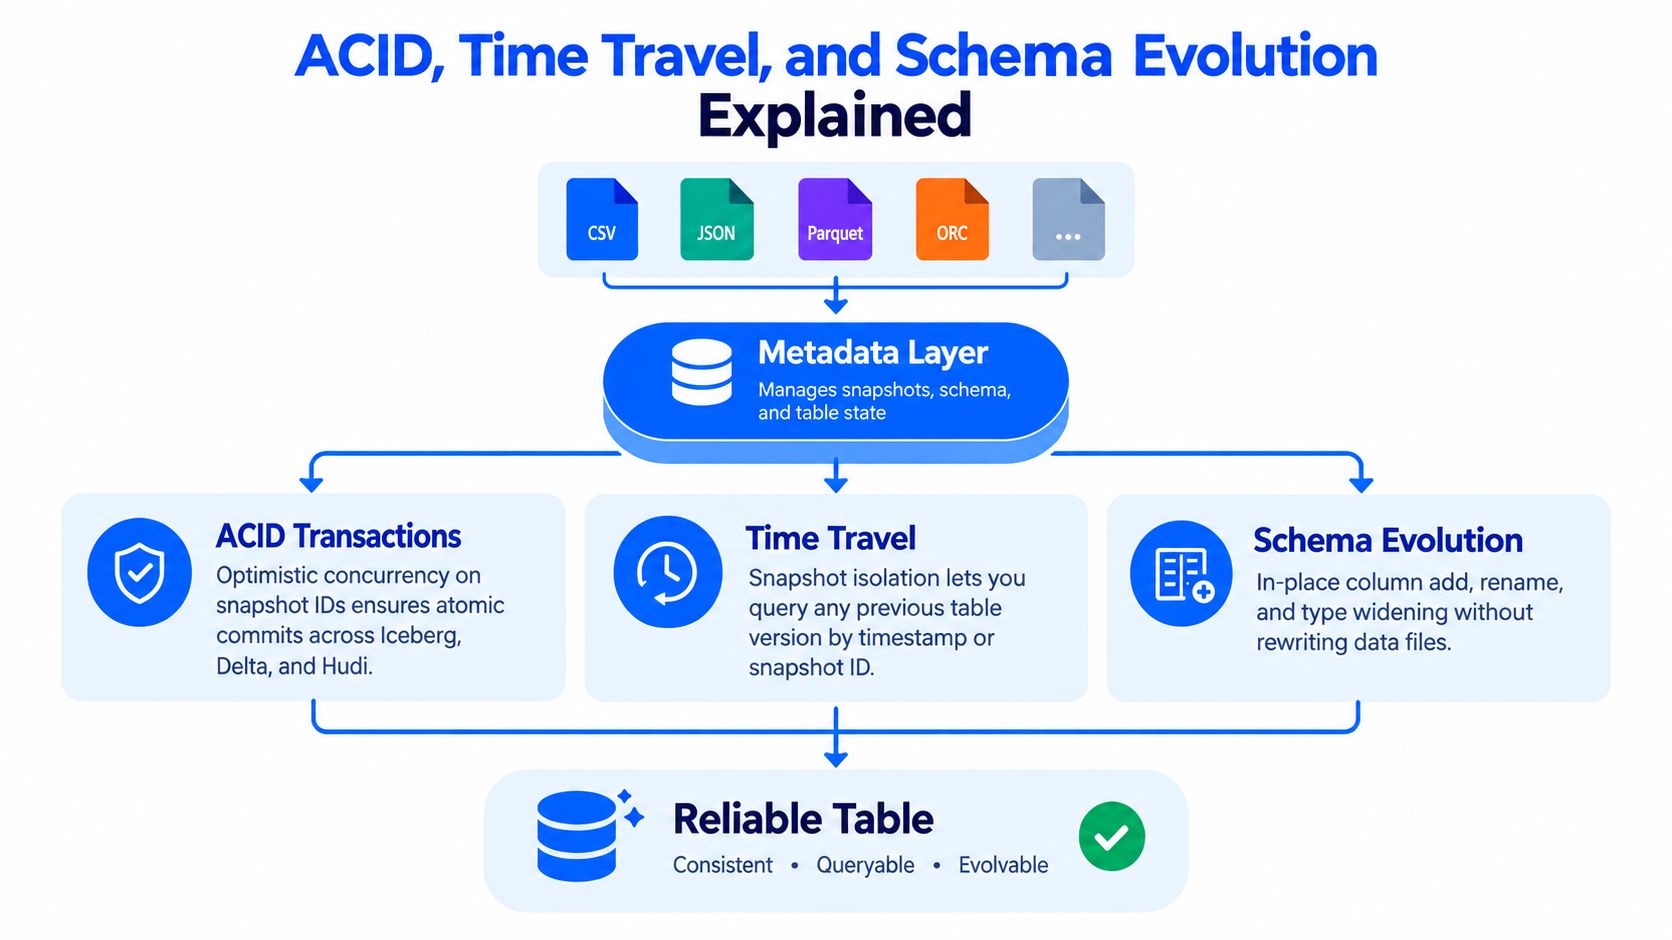
Pod spodem formaty te publikują zmiany przez zatwierdzenia metadanych. Pliki danych mogą już istnieć w magazynie obiektowym, ale stają się częścią tabeli dopiero wtedy, gdy nowa wersja metadanych zostanie przyjęta. Daje to zachowanie, którego zespoły danych oczekują od bazy danych, choć pod spodem wciąż leżą pliki w jeziorze.
W praktyce oznacza to:
zadanie wsadowe może opublikować pełne odświeżenie jako jedno atomowe zatwierdzenie
zadanie strumieniowe może dalej dopisywać, podczas gdy czytający pozostają na spójnej migawce
nieudany zapis może zostawić osierocone pliki, ale nie stanie się prawdą tabeli
współbieżni zapisujący potrzebują reguł konfliktów, logiki ponowień i koordynacji katalogu, by sobie nie wchodzić w drogę
Ten ostatni punkt łatwo zlekceważyć. ACID to nie tylko funkcja dla czytających. To także mechanizm kontroli dla wielu zapisujących, a szczegóły operacyjne różnią się w zależności od formatu, silnika i konfiguracji katalogu.
Podróż w czasie to sposób, w jaki zespoły diagnozują i odtwarzają stany danych
Podróż w czasie znaczy, że tabela potrafi udostępnić starsze zatwierdzone wersje, nie tylko bieżącą. Brzmi jak udogodnienie, dopóki raport nie zmieni się po uzupełnieniu danych albo zadanie usuwające nie skasuje więcej rekordów, niż zamierzano.
Jeśli pracowałeś z danymi historycznymi w Snowflake, model myślowy jest podobny. Odpytujesz wcześniejszy stan tabeli zamiast odtwarzać surowe pliki z kopii zapasowej.
Użyteczne pytanie nie brzmi „czy format wspiera podróż w czasie?”. Użyteczne pytanie brzmi „jak długo trzymamy historię, kto steruje retencją i co się dzieje, gdy rusza sprzątanie magazynu?”. Zespoły świętują często odczyty historyczne przy ocenie, a później odkrywają, że agresywne wygasanie migawek usunęło dokładnie tę wersję, której potrzebowały do audytu albo przeglądu incydentu.
Podróż w czasie jest tylko tak wiarygodna, jak stojąca za nią polityka retencji.
Ewolucja schematu oddziela zmianę kontrolowaną od przypadkowej awarii
Ewolucja schematu pozwala tabeli zmieniać kształt w czasie bez wymuszania przepisania każdego starego pliku. Obejmuje to zwykle dodawanie kolumn dopuszczających wartości puste, część promocji typów, a w niektórych formatach zmianę nazw kolumn przez stabilną tożsamość pola zamiast surowej pozycji.
Funkcja brzmi pobłażliwie. Użycie produkcyjne powinno być odwrotnością.
Bezpieczny proces zmiany schematu odpowiada na kilka konkretnych pytań:
Kto może zatwierdzić zmianę schematu na produkcji
Które silniki mogą zapisywać ten nowy schemat
Czy czytający niżej poradzą sobie ze zmianą
Jak zmiany partycji wpływają na istniejące zadania i założenia
Czy katalog zinterpretuje nowy schemat tak samo we wszystkich narzędziach
Tu zespoły albo zyskują elastyczność, albo tworzą długotrwałą pracę porządkową. Zmiana nazwy kolumny może być poprawna na poziomie formatu i mimo to zepsuć wyciągi BI, modele dbt albo kod wczytujący, które odwoływały się do starej nazwy. Poszerzenie typu może przejść walidację zapisu i mimo to zmienić zachowanie złączeń albo obsługę wartości pustych niżej.
Ewolucja schematu to możliwość formatu. Nadzór nad schematem to decyzja operacyjna.
Ten sam wzorzec dotyczy ACID i podróży w czasie. Format dostarcza mechanizm. Niezawodność bierze się z odpowiedzialności: kto zatwierdza zmiany, kto stroi retencję, kto sprząta pliki i kto decyduje, którym silnikom ufa się w zapisie.
Prawdziwe pytanie po wdrożeniu
Lakehouse zwykle wygląda zdrowo tuż po pierwszym udanym zapisie. Zapytania działają. Podróż w czasie działa. Wszyscy odhaczają listę funkcji i idą dalej.
Potem zaczynają się pytania operacyjne. Który katalog jest źródłem prawdy. Które silniki mogą zapisywać. Kto uruchamia kompaktowanie. Kto zatwierdza zmiany schematu technicznie poprawne, ale ryzykowne dla zadań niżej. Te decyzje kształtują codzienną niezawodność bardziej niż sam wybór formatu pliku.
Katalog ustala zasady ruchu
Otwarty format tabeli definiuje, jak metadane i pliki danych do siebie pasują. Katalog decyduje, jak systemy znajdują tę tabelę, koordynują zmiany i stosują polityki. W praktyce katalog działa jak kontrola ruchu lotniczego lakehouse. Samoloty mogą być poprawnie zbudowane, a i tak potrzebne jest jedno miejsce koordynujące starty, lądowania i zmiany tras.
Przegląd Uplatz o zbieżności i rozbieżności otwartych formatów tabel wskazuje na rosnącą rolę projektów tłumaczących i interoperacyjnych, takich jak Apache XTable, natywne wyjście Iceberg w Hudi i Delta Lake UniForm. Odnotowuje też realia produkcyjne, które umykają w porównaniach formatów. Wiele przedsiębiorstw prowadzi więcej niż jeden format, a interoperacyjność wciąż mocno zależy od wsparcia silników, zachowania katalogu i ograniczeń konkretnej chmury.
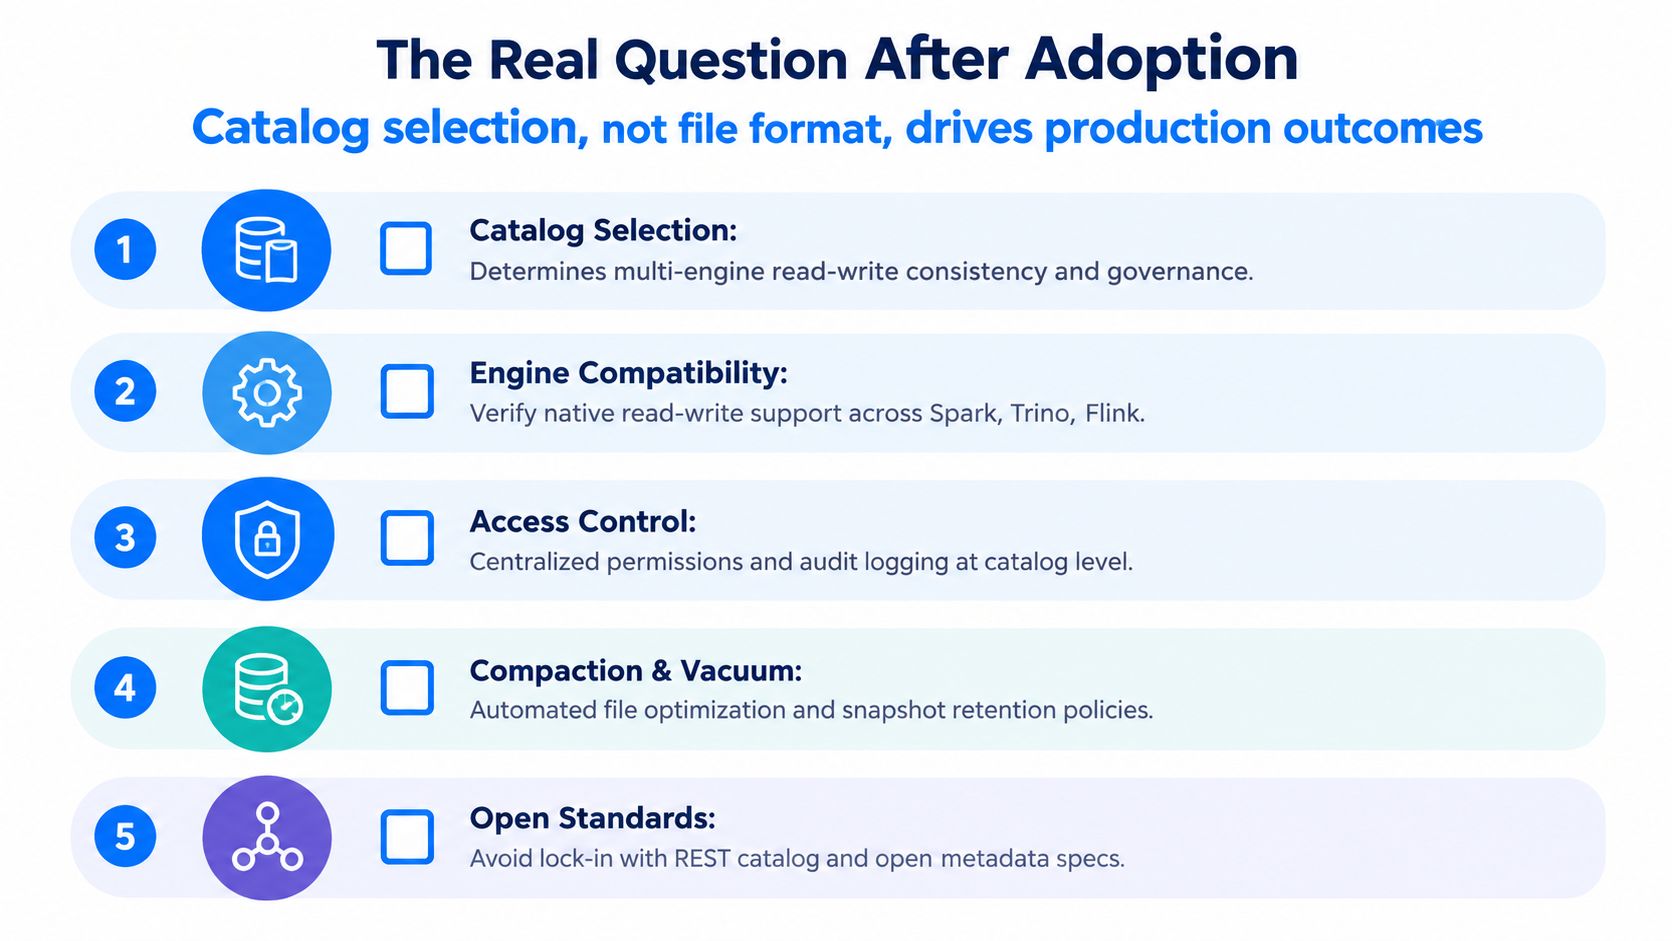
Dlatego ta sama tabela Iceberg, Delta Lake albo Hudi bywa przewidywalna w jednej konfiguracji i krucha w innej. Katalog REST, Glue, Hive Metastore, Nessie, Polaris albo warstwa sterowania zarządzana przez dostawcę będą się różnić pod względem odnajdywania, uprawnień, modeli gałęzi, koordynacji zapisu i obsługi awarii.
Odpowiedzialność za kompaktowanie staje się modelem operacyjnym
Kompaktowanie brzmi jak konserwacja w tle. Na produkcji bliżej mu do odśmiecania pamięci zmieszanego ze strojeniem indeksów. Dobrze zrobione utrzymuje sensowne planowanie zapytań i stabilną wydajność odczytu. Źle zrobione spala czas klastra, ściera się z obciążeniami ingestii i tworzy pracę porządkową po nieudanych przepisaniach.
Ktoś musi odpowiadać za:
Rytm kompaktowania
Wybory sortowania i klastrowania
Sprzątanie i retencję migawek
Kroki wycofania, gdy konserwacja pogarsza sprawę
Wykrywanie osieroconych plików
To nie są haczyki formatu. To powtarzalne zadania z trybami awarii, kompromisami kosztowymi i wyraźną potrzebą właściciela. Szczery przegląd na Shirokoff o otwartych formatach tabel mówi to wprost, wskazując narzut metadanych, pracę konserwacyjną, koszt krzywej uczenia i nierówny nadzór między narzędziami.
Niezawodność zależy od tego, kto kontroluje zmianę
Zespoły produkcyjne uczą się też, że nadzór rzadko mieszka wyłącznie w plikach tabeli. Maskowanie kolumn, kontrole na poziomie wiersza, ślady audytowe i oznaczanie PII zwykle zależą od tego, czy katalog i silniki zapytań egzekwują je spójnie.
Zespoły, które utrzymują te tabele wiarygodnymi, obserwują warstwę metadanych jak warstwę sterowania aplikacją. Śledzą wiek migawek, nieudane zatwierdzenia, liczbę plików, osierocone pliki, zaległość konserwacyjną i to, który zapisujący ostatnio zmienił stan tabeli. Zespoły patrzące wyłącznie na kondycję magazynu obiektowego często przegapiają wcześniejsze sygnały ostrzegawcze. Kubełek wygląda dobrze, a tabela staje się coraz trudniejsza do zaufania.
Praktyczny plan wdrożenia dla zespołów inżynierii danych
Czyste wdrożenie zaczyna się na małą skalę, ale nie powinno zaczynać się mgliście. Chcesz pilota, który wcześnie odsłoni operacyjne krawędzie.
Faza 1 wybiera warstwę sterowania
Najpierw wybierz katalog. Układ plików ma znaczenie, ale to katalog decyduje, jak silniki odnajdują tabele, koordynują zapisy i egzekwują polityki.
Oceniaj opcje takie jak katalogi oparte na REST, konfiguracje w stylu Hive Metastore i katalogi natywne dla chmury, zadając praktyczne pytania:
Które silniki muszą czytać i zapisywać natywnie
Gdzie będą mieszkać własność tabel i uprawnienia
Jak będą przeglądane zmiany schematu
Co się stanie, jeśli katalog będzie niedostępny
Jeśli pominiesz ten krok, często odbudujesz go później pod presją.
Faza 2 ustala bazę bezpieczeństwa i nadzoru
Przed szerokim wdrożeniem zdefiniuj minimalny kontrakt operacyjny.
Zwykle obejmuje to SSO, RBAC, szyfrowanie w tranzycie i w spoczynku, kontrolowane tożsamości usług oraz politykę ograniczeń wierszy lub kolumn tam, gdzie trzeba. Obejmuje też oczekiwania co do lineage, oznaczania PII i ścieżek zatwierdzania zmian schematu.
Użyteczną opcją narzędziową na tym etapie jest digna, która działa wewnątrz środowiska klienta i monitoruje zachowanie danych, Timeliness, walidację rekordów, zmiany schematu i metryki platformy w jeziorach, hurtowniach i potokach. Dla otwartych formatów tabel ma to znaczenie, bo problemy z niezawodnością ujawniają się najpierw jako nieaktualne migawki, dryf schematu, opóźnione zapisy albo anomalie metryk biznesowych, a nie jako twarde awarie potoków.
Faza 3 sprawdza ścieżkę zapisu pod obciążeniem
Nie waliduj architektury pojedynczym dziennym wsadem.
Użyj pilotażowego zbioru z kilkoma dziennymi zapisującymi, co najmniej jednym przepływem konserwacyjnym i jednym silnikiem zapytań innym niż główny silnik zapisujący. Włącz do próby zadanie ukrytego partycjonowania albo optymalizacji układu, żeby zespół musiał poradzić sobie ze zmianami migawek, efektami kompaktowania i decyzjami o wycofaniu w realistycznych warunkach.
Dobry pilot powinien zrodzić kilka niewygodnych pytań. Kto zatwierdza zmiany schematu? Kogo budzi się przy nieudanych zatwierdzeniach? Którzy czytający są dopuszczeni w oknach konserwacyjnych? To właśnie te problemy warto wydobyć wcześnie.
Faza 4 instrumentuje warstwę metadanych
Samo monitorowanie magazynu nie powie Ci dość.
Śledź sygnały takie jak:
Wiek migawek dla świeżości opublikowanego stanu tabeli.
Zaległość kompaktowania żeby rozrost plików nie pogarszał wydajności.
Wzorce awarii zapisujących w różnych silnikach.
Zdarzenia dryfu schematu zanim pulpity niżej się zepsują.
Przyrost osieroconych plików po ponowieniach albo przerwanych operacjach.
Jeśli nie widzisz kondycji ścieżki metadanych tabeli, działasz głównie na nadziei.
Otwarte formaty tabel rozwiązują problem warstwy tabel, ale nie usuwają potrzeby zdyscyplinowanej eksploatacji. digna pomaga zespołom monitorować zmiany schematu, Timeliness, anomalie i zachowanie platformy we własnym środowisku, co pasuje do trybów awarii pojawiających się po wdrożeniu lakehouse. Jeśli Twoje tabele obejmują już wiele silników i zadań konserwacyjnych, warto zobaczyć, jak digna może pomóc obserwować warstwę niezawodności opartą na metadanych, a nie tylko pliki pod spodem.
Zespoły wdrażające na Databricks zwykle dodają w tej samej fazie obserwowalność platformy Databricks, żeby gwarancje na poziomie tabeli i kontrole na poziomie wartości trafiły razem.
Najczęściej zadawane pytania
Jak formaty tabel ewoluowały od Hive?
Hive definiował tabelę jako układ katalogów, więc partycje były folderami, a lista plików źródłem prawdy. Załamało się to w magazynie obiektowym, gdzie listowanie jest wolne i ostatecznie spójne. Nowoczesne formaty przeniosły definicję tabeli do plików metadanych, całkowicie usuwając zależność od struktury katalogów.
Co ACID oznacza dla tabeli w jeziorze danych?
Oznacza, że zapis staje się widoczny w całości albo wcale, a współbieżni czytający nigdy nie są wystawieni na trwającą zmianę. W jeziorze gwarancja ta bierze się z atomowej podmiany wskaźnika metadanych, a nie z logu transakcji bazy danych, dlatego działa nad zwykłym magazynem obiektowym.
Czy można zmienić schemat tabeli bez jej przepisywania?
Tak. Dodanie, usunięcie, zmiana nazwy lub kolejności kolumn zapisywane są w metadanych i stosowane przy odczycie, więc istniejące pliki danych pozostają nietknięte. Haczyk polega na tym, że czytający muszą wdrożyć te same reguły — silnik z częściowym wsparciem może zwrócić wartości puste dla przemianowanej kolumny zamiast zgłosić błąd.
Dlaczego jezioro zachowuje się w jednym narzędziu jak tabela, a w innym jak sterta plików?
Bo gwarancja mieszka w warstwie metadanych i dostają ją tylko silniki, które tę warstwę czytają. Narzędzie wycelowane wprost w leżące pod spodem pliki Parquet całkowicie omija historię zatwierdzeń i widzi to, co akurat leży w magazynie, łącznie z plikami z zapisu, który nigdy nie został zatwierdzony.
Jak wygląda sensowne wdrożenie?
Przekonwertuj najpierw jedną dobrze rozumianą tabelę, zostaw oryginał zapisujący równolegle i przenoś konsumentów stopniowo, porównując wyniki. Ustal przed startem, kto odpowiada za wygasanie migawek i kompaktowanie, bo niczyja konserwacja to najczęstszy powód, dla którego udany pilot podupada w kolejnym kwartale.


