Napraw anomalie w bazie danych: Zapewnij niezawodną AI
|
6
min. czyt.

Prawdopodobnie mierzysz się teraz z jednym z dwóch objawów. Tabela transakcyjna nieustannie generuje duplikaty, wartości null w kluczach obcych lub rekordy, których nie można poprawnie wstawić. Albo Twój magazyn danych wygląda strukturalnie poprawnie, ale panel nawigacyjny się rozjechał, prognoza modelu uległa pogorszeniu, lub dzienne ładowanie danych opóźniło się na tyle, że wczorajszy raport stał się błędny.
Oba te problemy są nazywane „anomaliami bazodanowymi”, ale nie są tym samym problemem. Jeden z nich narusza spójność danych (data integrity) wewnątrz projektu relacyjnego. Drugi burzy zaufanie do danych (data trust) w potokach danych, analityce i systemach sztucznej inteligencji. Zespoły, które traktują je jako jedną kategorię, zwykle inwestują zbyt wiele w projektowanie schematów, a za mało w monitorowanie, lub robią na odwrót i próbują za pomocą samej obserwacji uciec od wadliwego modelu relacyjnego.
Ten podział ma znaczenie, jeśli odpowiadasz za niezawodność analityki. Klasyczne anomalie w projektowaniu baz danych nadal istnieją, a normalizacja wciąż jest ważna. Jednak nowoczesne stosy technologiczne potrzebują również observability w zakresie dryfu, aktualności i zachowania schematów, które nie pojawią się na podręcznikowym diagramie ERD.
Spis treści
Dlaczego nowoczesna analityka i AI są tak podatne na zagrożenia
Wdrażanie monitorowania anomalii i alertów w praktyce operacyjnej
Od wykrywania do rozwiązania: Wzorce analizy przyczyn źródłowych
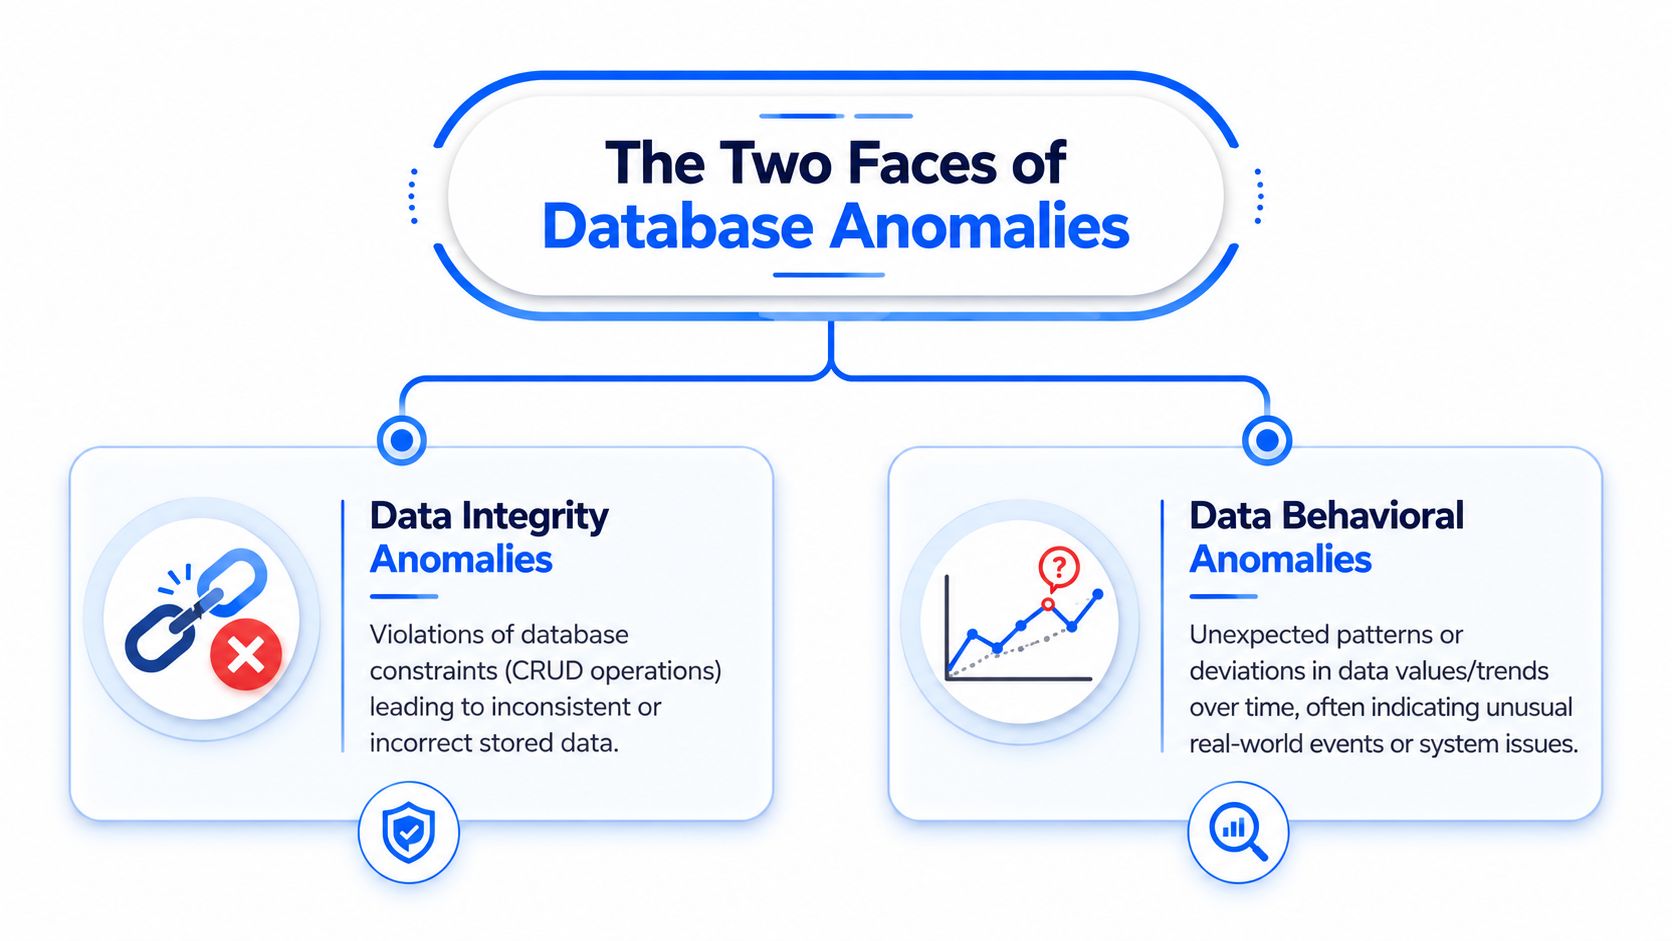
Dwie twarze anomalii bazodanowych
W poniedziałek rano panel nawigacyjny pokazuje spadek przychodów o 18 procent. Magazyn danych działa, potoki danych świecą się na zielono, a załadowanie żadnej tabeli nie zakończyło się błędem. Do południa zespół znajduje dwa odrębne problemy. Jedna tabela źródłowa nadal zawiera zduplikowane atrybuty klientów ze starego projektu, co powodowało niespójne aktualizacje. W tym samym czasie nowy typ pola nadrzędnego zmienił sposób, w jaki transformacja obsługiwała wartości null, więc liczby były błędne, mimo że zadania zakończyły się sukcesem. Oba te przypadki to anomalie bazodanowe. Pochodzą po prostu z różnych er stosu technologicznego.
Klasyczne anomalie w projektowaniu relacyjnym
Podręcznikowa definicja wciąż jest najlepszym punktem wyjścia. W systemach relacyjnych anomalie pojawiają się, gdy projekt tabeli miesza wiele faktów w jednym miejscu, powtarza dane w wierszach lub nie wymusza jasnych relacji kluczy. Rezultatem jest przewidywalny zestaw błędów spójności podczas operacji wstawiania, aktualizowania i usuwania, jak opisano w tym wyjaśnieniu anomalii relacyjnych na GeeksforGeeks.
Te trzy kategorie pozostają przydatne, ponieważ bezpośrednio odnoszą się do błędów projektowych, które inżynierowie wciąż dziedziczą w środowiskach produkcyjnych:
Anomalia wstawiania (insertion anomaly): Nie można dodać wiersza bez dostarczenia niepowiązanych danych.
Anomalia aktualizacji (update anomaly): Jedna zmiana biznesowa musi zostać powtórzona w wielu wierszach, co prowadzi do niespójności.
Anomalia usuwania (deletion anomaly): Usunięcie jednego rekordu powoduje również usunięcie faktu, którego firma nadal potrzebuje.
Zespoły zazwyczaj dostrzegają te problemy w zdenormalizowanych tabelach operacyjnych, szybkich narzędziach wewnętrznych lub starszych schematach raportowania, które rosły bez wyraźnego właściciela. Adres klienta skopiowany do każdego wiersza zamówienia działa do momentu, gdy jeden adres się zmieni i pięć rekordów będzie się różnić. Tabela produktów osadzona w tabeli sprzedaży działa do czasu usunięcia ostatniej sprzedaży, wraz z którą znika historia produktu.
Normalizacja została zaprojektowana po to, aby zapobiegać dokładnie tej klasie błędów. Podziel fakty na osobne tabele, przypisz własność za pomocą kluczy głównych i obcych i pozwól ograniczeniom odrzucać nieprawidłowe stany, zanim błędy się rozprzestrzenią. Aby uzyskać praktyczne przypomnienie, zobacz ten przewodnik po zrozumieniu przyczyn i rozwiązań anomalii bazodanowych.
Jedna zasada bardzo dobrze sprawdza się w rzeczywistych systemach. Jeśli ten sam fakt biznesowy można edytować w więcej niż jednym wierszu, schemat już teraz generuje ryzyko.
Modern anomalies in data products
To samo słowo – anomalia – obejmuje teraz drugą klasę problemów. Schemat może być poprawny. Klucze mogą być prawidłowe. Ograniczenia mogą być spełnione. Błąd ujawnia się w zachowaniu, a nie w spójności relacyjnej.
Przykłady są znane każdemu zespołowi prowadzącemu analitykę lub ML na produkcji. Dzienna metryka wykracza poza oczekiwany zakres. Dane źródłowe docierają z sześciogodzinnym opóźnieniem. Kolumna nadal istnieje, ale jej typ lub wzorzec wartości null zmienia się na tyle, że niszczy to założenia kolejnych etapów potoku. Rozkład danych wejściowych modelu przesuwa się, podczas gdy potok nadal generuje wyniki. Problemy te nie wyglądają jak anomalie wstawiania, aktualizowania czy usuwania, ale nadal podważają zaufanie do bazy danych jako systemu podejmującego decyzje.
To rozróżnienie ma kluczowe znaczenie w praktyce.
Rodzina anomalii | Co się psuje | Typowa przyczyna | Najlepsza pierwsza reakcja |
|---|---|---|---|
Anomalie relacyjne | Spójność przechowywanych danych | Słaba normalizacja, nadmiarowość, słaby projekt kluczy | Przeprojektowanie tabel, kluczy i ograniczeń |
Anomalie behawioralne | Niezawodność wyników analityki i AI | Dryf, zmiany schematu, luki w aktualności, błędy zależności | Monitorowanie wzorców, pochodzenia danych (lineage), kontraktów i czasu dostarczenia |
Klasyczne anomalie niszczą poprawność przechowywanych faktów. Nowoczesne anomalie niszczą niezawodność wniosków budowanych na podstawie tych faktów.
Zespoły inżynieryjne potrzebują ochrony przed oboma rodzajami problemów. Projektowanie schematów i normalizacja redukują wady strukturalne w momencie zapisu. Observability wyłapuje ciche awarie, które pojawiają się po pobraniu, transformacji i konsumpcji danych. To jest pomost, którego brakuje wielu zespołom, szczególnie gdy monitorowanie magazynu danych jest traktowane oddzielnie od projektowania platformy. Zespoły budujące systemy oparte w dużym stopniu na ML często napotykają tę lukę jako pierwsze, co jest jednym z powodów, dla których szersze analizy dotyczące sztucznej inteligencji coraz mocniej nakładają się na architekturę platform danych.
Why Modern Analytics and AI Are So Vulnerable
Zepsute wstawianie danych zazwyczaj kończy się głośnym błędem. Problem z aktualnością często nie. Dlatego nowoczesne stosy technologiczne bywają zaskakiwane.
Silent failures hurt more than loud failures
Najtrudniejsze anomalie to nie te, które powodują zawieszenie zadania. To te, które generują prawdopodobne, ale błędne wyniki. Model nadal ocenia rekordy, ale rozkład jego danych wejściowych uległ dryfowi. Finansowy panel nawigacyjny nadal się renderuje, ale dane dotarły z opóźnieniem i wszyscy patrzą na nieaktualne liczby. Tabela na dalszym etapie potoku nadal ma oczekiwane kolumny, ale zmiana jednego typu na wcześniejszym etapie zmieniła sposób interpretacji wartości null lub kategorii.
To dlatego przepaść między starym a nowym myśleniem o anomaliach stała się tak kosztowna. Krytyczna luka między tradycyjnymi anomaliami DBMS a nowoczesnymi „anomaliami danych” (dryf statystyczny, przesunięcia schematów, błędy aktualności) pozostawia inżynierów danych bezradnymi wobec cichego dryfu w modelach ML i potokach czasu rzeczywistego, gdzie 85% problemów z danymi ma swój początek na wcześniejszym etapie, lecz pozostaje niewykrytych przez systemy oparte na regułach.
Dla analityki oznacza to, że decydenci ufają raportom, których jakość zdążyła już spaść. Dla AI oznacza to, że system może pozostać technicznie dostępny, stając się jednocześnie operacyjnie niewiarygodny.
Prawidłowo działający potok danych wciąż może dostarczać niepoprawną treść.
Why rule checks alone miss the real problem
Zespoły często zaczynają od liczby wierszy, kontroli wartości null, akceptowanych wartości i kilku asercji biznesowych. Są one niezbędne. Ale nie wystarczają.
Kontrole oparte na regułach sprawdzają się najlepiej, gdy znasz już dany model awarii. Są nieskuteczne w przypadku stopniowego dryfu, zmieniającej się sezonowości, opóźnionych dostaw danych lub interakcji między wieloma źródłami. W takich sytuacjach inżynierowie potrzebują wyuczonych linii bazowych i detekcji uwzględniającej czas. W praktyce jest to ta sama zmiana, którą wiele zespołów wprowadza szerzej w systemach AI. Jeśli chcesz rzetelnego spojrzenia na to, czym systemy adaptacyjne różnią się od statycznej logiki, warto przeczytać te analizy dotyczące sztucznej inteligencji wraz z nowoczesnymi wzorcami monitorowania danych.
Ryzyko staje się oczywiste, gdy spojrzymy na kilka nowoczesnych scenariuszy awarii:
Dryf danych wejściowych modelu: Tabela cech nadal się ładuje, ale rozkłady wartości nie przypominają już reżimu treningowego.
Awaria aktualności danych: Nocna partia trafia z opóźnieniem i każdy zależny panel nawigacyjny wygląda na kompletny, pokazując jednak dane z wczoraj.
Zmiana zachowania schematu: Zmiana nazwy kolumny lub przesunięcie typu nie psuje całkowicie transformacji, ale zmienia semantykę na dalszych etapach.
Niezgodność między systemami: Zależność na wcześniejszym etapie ulega awarii, a systemy na dalszym etapie generują niekompletne, ale poprawne syntaktycznie dane.
Stara lekcja brzmiała: „normalizuj, aby zapobiegać anomaliom”. Nowsza lekcja brzmi: „stale obserwuj zachowanie danych, ponieważ czysta struktura nie gwarantuje wiarygodnych wyników”.
A Modern Toolkit for Anomaly Detection
Wybór odpowiedniego detektora zależy od wzorca awarii i kontekstu operacyjnego. Tabela finansowa przetwarzana wsadowo, potok strumienia kliknięć i magazyn cech mogą ulegać awariom na różne sposoby, na pierwszy rzut oka wyglądając wciąż na „zdrowe”.
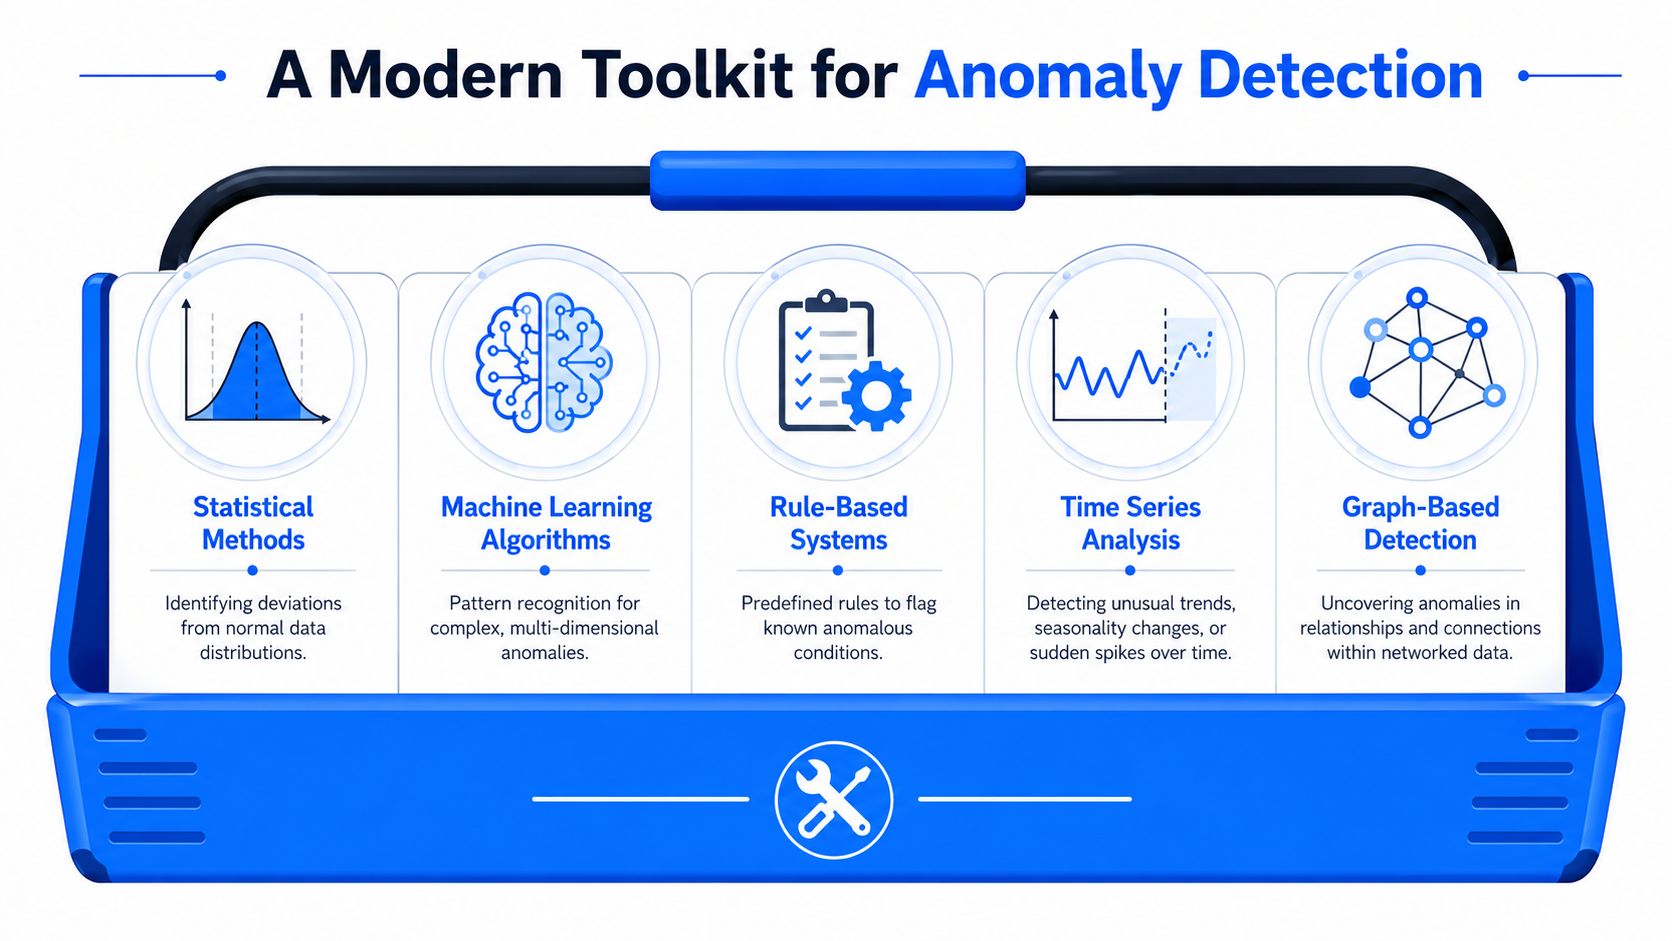
Klasyczne anomalie bazodanowe nauczyły zespoły zapobiegać nieprawidłowym stanom poprzez projektowanie schematów i ograniczenia. Nowoczesne stosy danych dodają drugie wymaganie: wykrywanie nieprawidłowych zachowań w czasie, nawet gdy tabele wciąż się ładują, a zapytania SQL nadal się wykonują. Praktyczny zestaw narzędzi musi obejmować oba te aspekty.
When simple statistical checks are enough
Zacznij od statystyki w przypadku sygnałów, które powinny mieścić się w wąskim zakresie operacyjnym. W przypadku wielu kontroli magazynu danych wciąż jest to najszybszy sposób na ustalenie linii bazowej i najłatwiejszy do wyjaśnienia podczas analizy incydentu.
Typowe opcje są proste:
Wskaźniki Z-score: Przydatne w przypadku metryk, które są w miarę stabilne i gdzie duże odchylenia od średniej zazwyczaj wskazują na rzeczywisty problem.
Rozstęp ćwiartkowy (IQR): Przydatny w przypadku rozkładów skośnych oraz do znajdowania wartości znacznie wykraczających poza normalny rozrzut.
Porównanie trendów: Skuteczne, gdy dzisiejsze wyniki powinny przypominać niedawną historię w granicach rozsądnego pasma.
Kontrole te są tanie w uruchomieniu i łatwe do wdrożenia w SQL. Dobrze sprawdzają się w przypadku liczby wierszy, nagłych skoków liczby wartości null, przyrostu duplikatów i nagłych zmian w wartościach zagregowanych.
Zawodzą jednak w przewidywalny sposób. Sezonowość, opóźnione dostawy danych na wcześniejszych etapach, promocje, premiery produktów i interakcje między wieloma tabelami mogą sprawić, że zdrowy zestaw danych będzie wyglądał podejrzanie, lub ukryć rzeczywisty problem wewnątrz oczekiwanego skoku.
Where rule-based monitoring fits
Reguły mają zastosowanie wszędzie tam, gdzie biznes może jasno określić niezmiennik. Unikalność klucza głównego, pola wymagane, dozwolone wyliczenia, spójność referencyjna i oczekiwania dotyczące schematu na poziomie kontraktu wciąż stanowią fundament.
Ma to znaczenie, ponieważ klasyczne anomalie wstawiania, aktualizowania i usuwania nigdy tak naprawdę nie zniknęły. Pojawiają się po prostu w nowych formach. Wadliwe scalenie (merge) może zduplikować rekordy klientów. Częściowa synchronizacja może zaktualizować jeden system, ale nie inny. Miękkie usunięcie (soft delete) może usunąć fakty z raportowania na dalszym etapie, pozostawiając jednocześnie na tyle nienaruszoną strukturę, że zadanie zostanie wykonane pomyślnie.
Metoda | Zastosowanie | Silna strona | Ograniczenie |
|---|---|---|---|
Kontrole statystyczne | Wartości odstające i nagłe przesunięcia | Szybkie i łatwe w interpretacji | Słabe w przypadku zachowań silnie zależnych od kontekstu |
Kontrole oparte na regułach | Znane ograniczenia biznesowe | Precyzyjne i audytowalne | Pomijają nieznane modele awarii |
Detekcja oparta na ML | Złożone i subtelne wzorce | Dostosowuje się do wielowymiarowych zachowań | Trudniejsza w dostrojeniu i wyjaśnieniu |
Używaj reguł do ochrony znanych prawd. Stosuj je agresywnie na tabelach o wysokim poziomie ryzyka. Po prostu nie oczekuj, że wyłapią dryf aktualności, zmiany semantyczne czy powolne zmiany rozkładu danych na wejściach modeli.
When machine learning earns its keep
Uczenie maszynowe zaczyna mieć znaczenie, gdy normalne zachowanie ma zbyt wiele wymiarów dla ręcznie ustawionego progu. Dzieje się tak w strumieniach zdarzeń, magazynach cech, telemetrii użytkowania i wszelkich metrykach o zmiennej sezonowości lub wielosystemowych zależnościach.
Kilka metod jest stale przydatnych w praktyce:
Lasy izolacyjne (Isolation Forests): Dobre do wyszukiwania nietypowych rekordów lub okresów w dużych zbiorach danych bez konieczności intensywnej inżynierii cech.
Modele LSTM: Przydatne do monitorowania szeregów czasowych, gdy znaczenie mają wzorce czasowe, a proste średnie kroczące generują zbyt wiele fałszywych alarmów.
Metody k-NN i naiwnego klasyfikatora bayesowskiego: Częsty wybór, gdy wykrywanie anomalii zależy od zachowania sąsiedztwa lub probabilistycznych relacji między polami.
Detekcja bez nadzoru (unsupervised): Przydatna, gdy brakuje etykietowanych anomalii, co jest częste w rzeczywistych systemach produkcyjnych.
Kompromis ma charakter operacyjny, nie akademicki. Detektory oparte na ML mogą wyjawić ciche awarie, które omijają reguły, ale wymagają dostrajania, decyzji o ponownym trenowaniu i ściślejszej odpowiedzialności. Jeśli nikt nie potrafi wyjaśnić, dlaczego uruchomił się alert, zespoły zaczynają ignorować system.
Lepszym wzorcem jest łączenie metod w tej samej warstwie monitorowania. Używaj ograniczeń do twardych błędów, statystyk do szybkiego przesiewu i wyuczonych linii bazowych do zachowań, które zmieniają się w czasie. Zespoły oceniające takie podejście mogą zapoznać się z natywnymi dla magazynów danych technikami detekcji anomalii AI, które koncentrują się na wyuczonym monitorowaniu wewnątrz platformy danych, a nie tylko na testach statycznych.
Używaj różnych detektorów do różnych zadań. Ograniczenia wychwytują nieprawidłowe stany. Kontrole statystyczne wychwytują widoczne przesunięcia. ML pomaga wychwycić ciche anomalie, które przechodzą każdą regułę, a mimo to niszczą decyzje podejmowane na dalszych etapach.
Operationalizing Anomaly Monitoring and Alerts
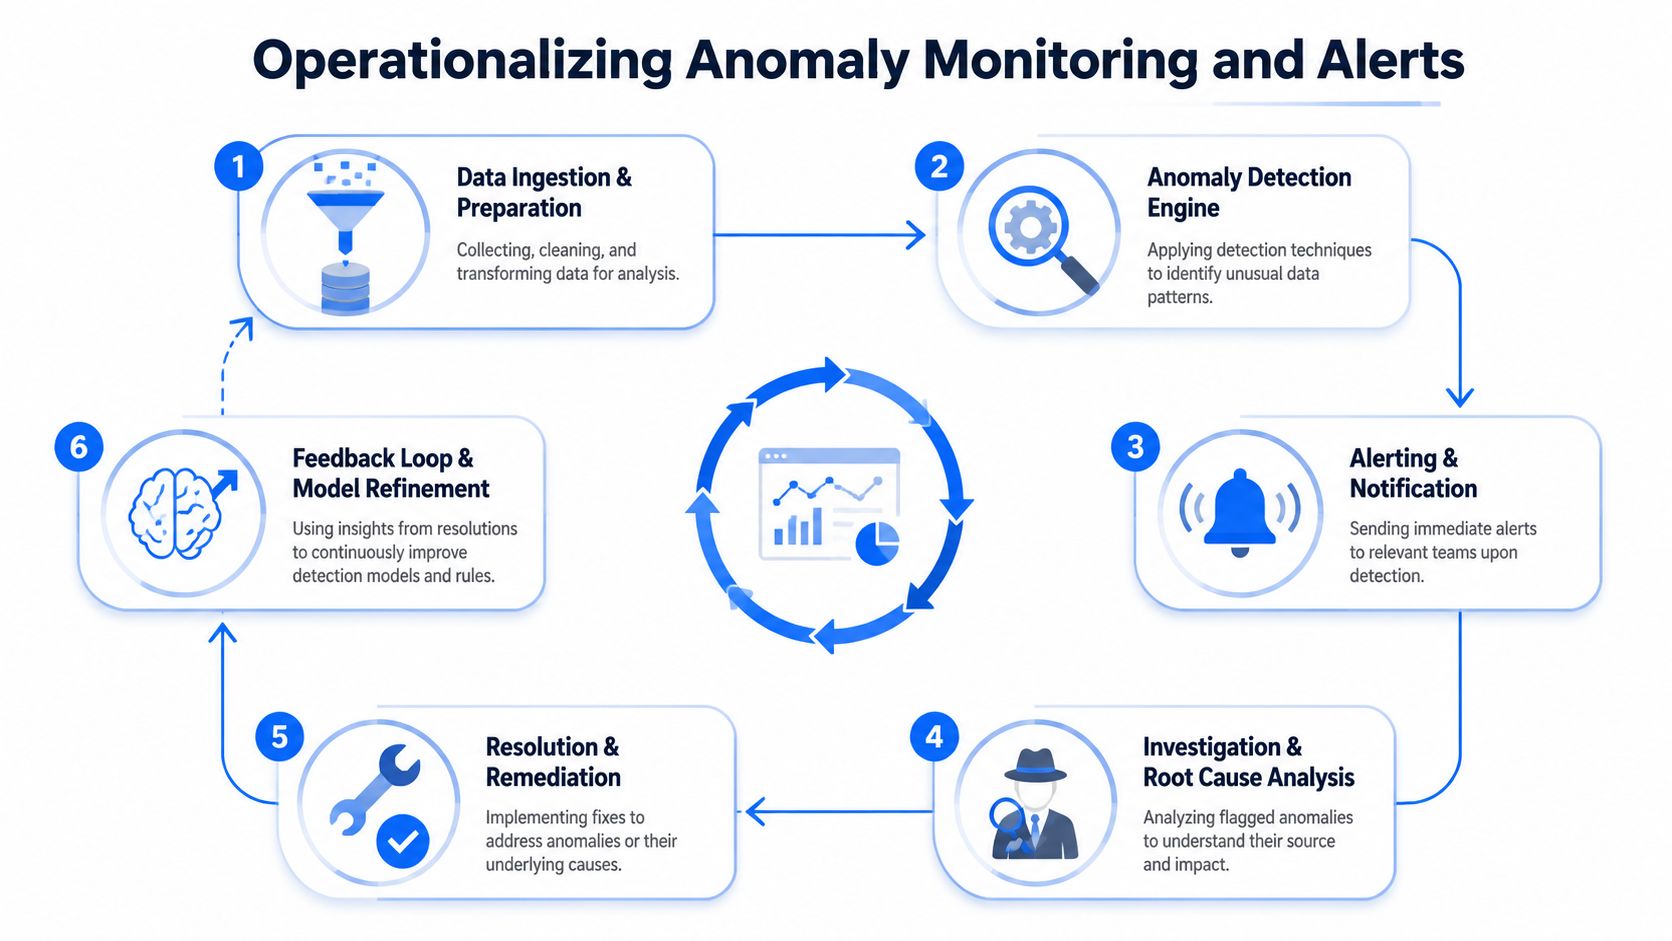
Detekcja pozbawiona działań operacyjnych staje się szumem informacyjnym. Zespoły często nie ponoszą porażki z powodu braku alertów. Przegrywają, ponieważ nikt nie ufa alertom na tyle, by szybko podjąć działanie.
Build an alerting path people will actually trust
Działająca konfiguracja monitorowania zaczyna się od odpowiedzialności, a nie od narzędzi. Każdy krytyczny zestaw danych, tabela cech i zasilanie panelu nawigacyjnego wymaga jasnego właściciela zespołu i jasnej definicji tego, jak wygląda stan „błędny”.
Wzorzec inżynieryjny, który się sprawdza, jest węższy niż oczekuje wiele organizacji:
Priorytetyzuj najpierw tabele krytyczne dla biznesu. Zacznij od zbiorów danych, które zasilają panele kadry zarządzającej, bilingi, raportowanie regulowane lub modele produkcyjne.
Monitoruj wiele wymiarów. Anomalie wartości, terminowość, zachowanie schematu i błędy walidacji powinny być traktowane jako różne sygnały.
Używaj dynamicznych linii bazowych tam, gdzie zmienia się zachowanie. Statyczne progi są dobre w przypadku twardych limitów. Słabo sprawdzają się w przypadku metryk cyklicznych.
Kieruj alerty według domen. Zespół, który jest właścicielem systemu źródłowego, powinien jako pierwszy widzieć anomalie źródłowe. Odbiorcy powinni widzieć alerty o wpływie na ich procesy.
Tłumij duplikaty. Jeden problem źródłowy nie powinien generować dziesięciu odłączonych od siebie incydentów.
Krótka lista kontrolna pomaga utrzymać wysoką jakość alertów:
Zadbaj o wyjaśnialność alertów: Dołącz informację o zbiorze danych, którego dotyczy problem, oknie czasowym, metryce i zaobserwowanym odchyleniu.
Oddziel objaw od źródła: Oznacz, czy problem pojawia się przy pobieraniu, transformacji, w schemacie czy w końcowym wyniku działania.
Dołącz kontekst: Pokaż niedawną historię, aby inżynier mógł ocenić, czy problem to skok, spadek, opóźnienie czy załamanie trendu.
Dbaj o możliwość podjęcia konkretnego działania: Jeśli alert nie wskazuje jasnego właściciela ani kolejnego kroku, dopracuj go przed wdrożeniem na szerszą skalę.
Use a response workflow instead of ad hoc debugging
Proces rozwiązywania problemów powinien być standaryzowany. Proces rozwiązywania anomalii następuje według ustandaryzowanej sekwencji: rejestrowanie anomalii z metadanymi, konsultowanie się z interesariuszami w celu potwierdzenia logiki biznesowej, walidacja problemu w środowiskach przejściowych (staging), wdrażanie poprawek wstecznie kompatybilnych z planami wycofania (rollback) oraz dokumentowanie rozwiązań w celu zapobiegania ponownemu wystąpieniu (omówienie przepływów pracy rozwiązywania anomalii Gable).
Ta sekwencja ma znaczenie, ponieważ zapobiega powszechnemu błędowi. Inżynier widzi skok, łata transformację na dalszym etapie i zamyka problem bez sprawdzenia, czy źródło na wcześniejszym etapie nie zmieniło się celowo. Metryka tymczasowo powraca do normy, ale pierwotna przyczyna pozostaje.
Widziałem, jak zespoły poprawiają jakość alertów, traktując obsługę anomalii jak reagowanie na incydenty, a nie konserwację paneli nawigacyjnych. Kiedy alerty zawierają metadane, przypisanego właściciela, walidację w środowisku przejściowym i planowanie wycofania zmian, ludzie przestają dyskutować o tym, czy anomalia jest „prawdziwa”, i zaczynają ją śledzić.
Notatka z terenu: Jeśli Twoją pierwszą reakcją na anomalię jest otwarcie SQL i zmiana logiki, prawdopodobnie działasz zbyt szybko. Najpierw potwierdź oczekiwania biznesowe.
From Detection to Resolution Root-Cause Analysis Patterns
Gdy pojawia się anomalia, charakter pracy się zmienia. W etapie wykrywania pytamy: „Czy to coś nietypowego?”. Analiza przyczyn źródłowych pyta: „Co się zmieniło, gdzie i czy tak miało być?”.
Najszybsze zespoły nie prowadzą dochodzenia po omacku. Postępują według powtarzalnych wzorców opartych na tym, jak zazwyczaj rozchodzą się anomalie.
Pattern one trace the lineage before touching code
W przypadku anomalii kontekstowych pochodzenie danych (lineage) jest często najkrótszą drogą do prawdy. Wschodzącym trendem jest integracja wykrywania anomalii uwzględniającego metadane, które śledzi pochodzenie danych w górę potoku w celu znalezienia prawdziwego źródła, co skraca czas analizy przyczyn źródłowych o 60% – kluczowa funkcja w przypadku anomalii kontekstowych, gdzie standardowe metody statystyczne zawodzą.
Ma to znaczenie, ponieważ tabela wykazująca anomalię często nie jest tabelą, która ją powoduje. Tabela raportowa może wykazywać spadek przychodów, podczas gdy rzeczywiste uszkodzenie leży w opóźnionym zadaniu pobierania danych na wcześniejszym etapie lub zmienionym kluczu łączenia w warstwie staging.
Praktyczne dochodzenie oparte w pierwszej kolejności na pochodzeniu danych często wygląda tak:
Zacznij od zasobu, na który wpłynął błąd: Kafelek panelu nawigacyjnego, tabela serwująca dane lub zestaw cech modelu.
Przechodź w górę potoku, badając po kolei każdą zależność: Sprawdzaj aktualność, historię schematu i uruchomienia transformacji.
Zatrzymaj się na pierwszej granicy, na której występuje nieprawidłowość: Pierwsze miejsce, w którym prawidłowe dane wejściowe stają się błędnymi danymi wyjściowymi, zazwyczaj zawiera przyczynę źródłową.
Pattern two separate business events from data defects
Nie każdy skok to błędne dane. Czasami anomalią jest sam biznes.
Inżynierowie popełniają błąd, gdy prowadzą dochodzenie wyłącznie od strony magazynu danych. Jeśli metryka gwałtownie rośnie, zadaj równolegle dwa pytania. Czy zmienił się kod lub schemat? Czy biznes uruchomił promocję, wprowadził produkt, zmigrował klientów lub zmienił przepływ pracy? Oba te czynniki mogą wygenerować ten sam kształt wykresu.
Użytecznym modelem mentalnym jest klasyfikacja dowodów do trzech koszyków:
Typ dowodu | Co sugeruje |
|---|---|
Wdrożenie, zmiana schematu lub zmiana w potoku danych | Prawdopodobny jest defekt techniczny |
Zdarzenie zewnętrzne lub działanie biznesowe | Sygnał z rzeczywistego świata może być prawidłowy |
Brak widocznych zmian gdziekolwiek | Szukaj ukrytej zależności lub problemu z terminowością |
Ten podział chroni zespoły przed „naprawianiem” prawidłowego sygnału lub ignorowaniem technicznej regresji, która akurat wygląda na handlowo prawdopodobną.
Traktuj każdą anomalię zarówno jako pytanie o dane, jak i o biznes, dopóki jedna ze stron nie zostanie wykluczona.
Pattern three check structure and timing together
Problemy ze schematem i aktualnością danych często idą w parze. Transmisja danych, która dociera z opóźnieniem, może wyzwolić domyślne wartości, częściowe ładowania lub pominięcie transformacji na dalszych etapach. Zmiana typu może sprawić, że metryki terminowości będą wyglądać normalnie, podczas gdy wartości będą stopniowo ulegać degradacji.
Podczas dochodzenia paruj te kontrole zamiast przeprowadzać je w izolacji:
Kontrola schematu: Dodane lub usunięte kolumny, modyfikacje typów, zmieniona możliwość przyjmowania wartości null, zmienione klucze.
Kontrola czasu: Oczekiwane dostarczenie kontra rzeczywiste przybycie, ukończenie częściowej partii, zachowanie ponownych prób.
Kontrola wartości: Przesunięcia rozkładu, nagłe koncentracje wartości null, asymetria kategorii, uszkodzone złączenia.
Inżynierowie średniego szczebla często rozwijają się najszybciej, gdy przestają patrzeć na anomalie jak na pojedyncze zdarzenia na wykresie, a zaczynają odczytywać je jako zachowanie systemu. Anomalia w metryce to tylko widoczna wskazówka. Przyczyna źródłowa zazwyczaj tkwi w kontrakcie między systemami, a nie w samym wykresie.
The In-Database Advantage Architecture and Governance
Z perspektywy architektury zarządzanie anomaliami staje się łatwiejsze, gdy ich wykrywanie odbywa się blisko danych. Nie jest to tylko kwestia wydajności. Zmienia to kwestie prywatności, governance i narzutu operacyjnego.

Why in-database observability changes the operating model
Gdy monitorowanie wymaga eksportowania dużych zbiorów danych do zewnętrznej usługi, zespoły dodają przesyłanie danych, powielanie i weryfikację pod kątem governance do problemu, który i tak wymaga szybkiej diagnozy. Wykonywanie zadań bezpośrednio w bazie danych (in-database) pozwala uniknąć większości tych barier.
Główne zalety architektoniczne są oczywiste:
Kontrola prywatności: Wrażliwe dane produkcyjne pozostają w środowisku kontrolowanym przez klienta, zamiast być kopiowane na zewnątrz do analizy.
Niższy koszt przesyłu: Obliczasz metryki tam, gdzie tabele już się znajdują, zamiast wysyłać surowe dane w inne miejsce.
Prostota operacyjna: Inżynierowie danych pracują na natywnych zasobach magazynu danych, uprawnieniach i szablonach harmonogramów.
Silniejszy governance: Łatwiej jest dopasować observability do kontroli dostępu, wymogów audytowych i oczekiwań dotyczących rezydentności danych.
Ten model jest szczególnie przydatny w finansach, opiece zdrowotnej, telekomunikacji i sektorze publicznym, gdzie zespoły dbają o to, kto może kontrolować dane równie mocno, jak o wykrywanie anomalii.
How a unified platform maps to real anomaly classes
Dobra architektura observability powinna obejmować obie twarze anomalii omówione wcześniej. Strukturalne zabezpieczenia wciąż leżą po stronie projektowania schematów i reguł walidacji. Monitorowanie behawioralne opiera się na ciągłej analizie wartości, czasu i struktury.
Dlatego ujednolicone podejście jest bardziej przydatne niż stos rozproszonych kontroli. Jednym z przykładów jest digna, która uruchamia analizy wewnątrz baz danych klientów i łączy kilka funkcji mapujących się bezpośrednio na typowe klasy anomalii:
Anomalie danych (Data Anomalies): Wyuczone linie bazowe dla nieoczekiwanych zmian zachowania w skonfigurowanych tabelach.
Terminowość (Timeliness): Monitorowanie opóźnienionych lub brakujących dostaw danych w oparciu o wyuczone wzorce i oczekiwane harmonogramy.
Śledzenie schematu (Schema Tracker): Wykrywanie dodanych lub usuniętych kolumn oraz modyfikacji typów danych.
Walidacja danych (Data Validation): Wymuszanie reguł na poziomie rekordów na potrzeby logiki biznesowej i wymogów audytowych.
Analityka danych (Data Analytics): Historyczne metryki observability do analizy trendów i priorytetyzacji.
To ma znaczenie z perspektywy governance, ponieważ zespoły mogą badać zmiany trendów, terminowość i zmiany strukturalne w jednym obszarze operacyjnym bez przekazywania danych produkcyjnych dostawcy. Ma to również znaczenie z perspektywy architektury, ponieważ ta sama platforma może obsługiwać tabele magazynu danych, data lakes i ekosystemy potoków danych, utrzymując procesy analityczne tam, gdzie znajdują się same dane.
Praktyczna korzyść nie polega na tym, że jedno narzędzie magicznie usunie każdą anomalię w systemach bazodanowych. Chodzi o spójność modelu operacyjnego. Inżynierowie mogą utrzymać klasyczną higienę relacyjną w modelu, stosować walidację tam, gdzie biznes zna reguły, oraz dodać monitorowanie uwzględniające zachowanie danych w przypadku klas błędów, którym normalizacja nigdy nie miała zapobiegać.
Niezawodna sztuczna inteligencja zaczyna się od wiarygodnego zachowania danych, a nie tylko od czystych schematów. Jeśli Twój zespół potrzebuje wykrywania anomalii, monitorowania terminowości, śledzenia schematów i walidacji w środowisku kontrolowanym przez klienta, digna to jedno z rozwiązań in-database, które warto ocenić.


