Valutazione del rischio Monte Carlo: una guida pratica
|
7
min di lettura
Il lunedì mattina inizia con un'anomalia in una dashboard che nessuno sa spiegare. I ricavi sembrano essere schizzati verso l'alto, la finanza convoca una revisione urgente e gli ingegneri iniziano a ripercorrere i log dei job di ingestion, trasformazione e reporting. A mezzogiorno il team scopre che una pipeline a monte in ritardo ha fatto conteggiare due volte le transazioni del sabato. L'alert ha funzionato, ma alla risposta mancava ancora il numero di cui il management aveva bisogno: quanto era probabile l'errore, quanto poteva diventare grande l'esposizione e quale decisione avrebbe dovuto cambiare di conseguenza?
È questa distinzione a definire la valutazione del rischio Monte Carlo. Un alert sulla qualità dei dati indica che qualcosa è uscito da un pattern atteso. Una simulazione stima la gamma di esiti di business che potrebbero seguirne, sfruttando l'incertezza legata a latenza delle pipeline, volumi di record, errori di validazione e utilizzo a valle. Il metodo collega “i dati potrebbero essere errati” a “questa è la probabilità e l'impatto su cui dobbiamo pianificare”.
Indice
Quando il vero rischio sono i dati dietro la dashboard
Gli alert descrivono eventi, non esposizione
Dai dati corrotti a una decisione difendibile
L'idea alla base della valutazione del rischio Monte Carlo
Tradurre la domanda in una simulazione
I tre ingredienti
Le cinque fasi di un flusso di simulazione affidabile
Fase uno: inquadrare la decisione
Fase due: individuare le fonti di incertezza
Fase tre: costruire il modello di propagazione
Fase quattro: eseguire e conservare
Fase cinque: comunicare la distribuzione
Costruire il modello all'interno della vostra piattaforma dati
Trasformare la telemetria in input
Propagare l'incertezza attraverso la logica di business
Leggere i risultati come un analista del rischio
Tre artefatti meritano attenzione
Riportare la coda, non solo il centro
Gli errori che rendono le simulazioni non verificabili
L'indipendenza è spesso una comoda finzione
La coda scompare quando la forma è sbagliata
Due esempi concreti tratti da finanza e qualità dei dati
La qualità dei dati ha la stessa struttura
L'observability diventa il livello di campionamento
Quando Monte Carlo è lo strumento giusto
Quando il vero rischio sono i dati dietro la dashboard
Alle 8 del mattino il CFO nota un picco di ricavi inatteso e chiede alla finanza di verificarlo prima della riunione del comitato direttivo. Gli analisti confrontano la dashboard con il data warehouse, gli ingegneri esaminano i log di orchestrazione e i data owner controllano se il sistema sorgente è cambiato. Ognuno conosce una parte della storia, ma nessuno è in grado di quantificare subito l'esposizione.
In tarda mattinata la causa principale è chiara. Un caricamento a monte in ritardo ha duplicato le transazioni del sabato. La dashboard non mostrava semplicemente un valore insolito: presentava una decisione di business poggiata su un percorso dei dati compromesso.

Gli alert descrivono eventi, non esposizione
Il team disponeva di un sistema di monitoraggio. Poteva individuare un job in ritardo, una variazione nel conteggio delle righe o una metrica inattesa. Ciò a cui non sapeva rispondere era come il guasto potesse propagarsi:
Durata: per quanto tempo la pipeline potrebbe restare errata prima del rilevamento?
Ambito: quali tabelle, report e modelli potrebbero ereditare il difetto?
Effetto sul business: quali decisioni su ricavi, rischio o conformità potrebbero essere coinvolte?
Risposta: la finanza dovrebbe sospendere il reporting, applicare una correzione o proseguire con una riserva documentata?
È questo il fallimento più profondo. Gli alert sono osservazioni. La valutazione del rischio è supporto alle decisioni. Un programma di data observability può aiutare i team a comprendere lo stato di salute e il comportamento dei dataset, come descritto nella panoramica di digna sulla data observability, ma il passo successivo è tradurre queste osservazioni in esiti probabili.
Dai dati corrotti a una decisione difendibile
Un modello Monte Carlo può campionare combinazioni plausibili di ritardo di consegna, volume di duplicati, tempo di correzione e utilizzo della dashboard. Ogni esecuzione rappresenta un possibile scenario operativo. Il risultato diventa una distribuzione dell'esposizione anziché una singola stima.
Questo cambio di prospettiva conta sia nella risposta agli incidenti sia nella governance ordinaria. Invece di dire al management che “la tabella dei ricavi è inaffidabile”, il data team può presentare un intervallo, identificare i fattori di incertezza e indicare quale soglia sarà probabilmente superata. Il resto di questa guida trasforma questo ponte in un flusso di lavoro riutilizzabile per i team di data warehouse e pipeline, trattando la verificabilità come parte del modello e non come un ripensamento.
L'idea alla base della valutazione del rischio Monte Carlo
La dashboard dei ricavi del venerdì è in scadenza, ma la sua tabella sorgente a volte arriva in ritardo. Un'esecuzione può mostrare un aggiornamento normale, mentre un'altra include un ritardo a monte, un job fallito e una riparazione lenta. La domanda non è se si verificherà uno specifico esito, ma con quale frequenza combinazioni plausibili di eventi potrebbero spingere l'aggiornamento dei dati o l'esposizione di business oltre una soglia accettabile.
Il lancio di una moneta offre un semplice punto di partenza. Con dieci lanci si possono osservare diverse teste e croci, ma l'equilibrio resta incerto. Un campione così piccolo fornisce un solo esito, non una visione affidabile del processo.
Ripetendo l'esperimento su diecimila lanci, i risultati consentono di formulare affermazioni probabilistiche. Si può esaminare la distribuzione, confrontarne il centro con gli estremi e stimare con quale frequenza supera una soglia prestabilita. Il computer non tira a indovinare: sono le prove ripetute a rivelare la forma dell'incertezza.

Tradurre la domanda in una simulazione
Supponiamo che un data platform engineer si chieda: “Con quale frequenza questa tabella sarà obsoleta di oltre trenta minuti in un determinato venerdì?” Diversi input incerti influenzano la risposta:
Il normale pattern di arrivo della sorgente.
Il ritardo dovuto alle dipendenze a monte.
La probabilità che un job fallisca o venga ritentato.
Il tempo necessario per rilevare e risolvere il problema.
L'impatto di business dei dati obsoleti durante quel ciclo di reporting.
Un calcolo deterministico assegna un unico valore di latenza a ciascun input. Una simulazione Monte Carlo campiona valori da distribuzioni di probabilità, li fa passare attraverso un modello del sistema e registra l'esito risultante in termini di aggiornamento dei dati o di impatto finanziario. Ripetere questo processo trasforma un segnale di observability in un rischio di business quantificato. Una piattaforma come digna può collegare questo ragionamento ai metodi Monte Carlo per una migliore data observability, così che i risultati delle simulazioni possano essere esaminati come evidenze anziché trattati come una previsione opaca.
Regola pratica: il valore deriva da un'esplorazione strutturata dell'incertezza, non dalla sola casualità.
I tre ingredienti
Ogni simulazione credibile ha tre componenti.
Un modello del sistema: mette in relazione gli input con un esito. Può essere una formula, un grafo aciclico diretto, una logica SQL o un harness di simulazione in Python.
Distribuzioni degli input: ogni variabile incerta richiede un intervallo e una forma difendibili. Telemetria storica, impegni di servizio e giudizio esperto documentato possono orientare queste distribuzioni.
Iterazioni sufficienti: il modello viene eseguito ripetutamente finché il suo output non è abbastanza stabile per la decisione. Più esecuzioni rendono più chiara la distribuzione simulata, ma non possono correggere ipotesi deboli.
I metodi Monte Carlo hanno una lunga storia. Tra le prime idee probabilistiche figura l'esperimento dell'ago di Buffon. Le moderne applicazioni al rischio si sono sviluppate grazie al calcolo scientifico del periodo bellico e ai lavori legati al Progetto Manhattan. Stanisław Ulam concepì l'approccio a Los Alamos nel 1946, John von Neumann contribuì a svilupparlo nel 1947 e il metodo fu usato per la prima volta per calcolare i percorsi di diffusione dei neutroni per la bomba a idrogeno, come documentato in questa ricostruzione storica dei metodi Monte Carlo. Il campionamento ripetuto ha poi reso più trattabili grandezze complesse in ambiti come l'analisi della sicurezza nucleare e la modellazione della volatilità finanziaria.
Per un data team la traduzione è diretta: definire cosa può variare, descrivere come varia, far passare questi input attraverso la logica di business ed esaminare la distribuzione risultante. Archiviate ipotesi, input campionati, versione del modello ed esito, così che la simulazione possa supportare audit e governance e non limitarsi a produrre un avviso.
Le cinque fasi di un flusso di simulazione affidabile
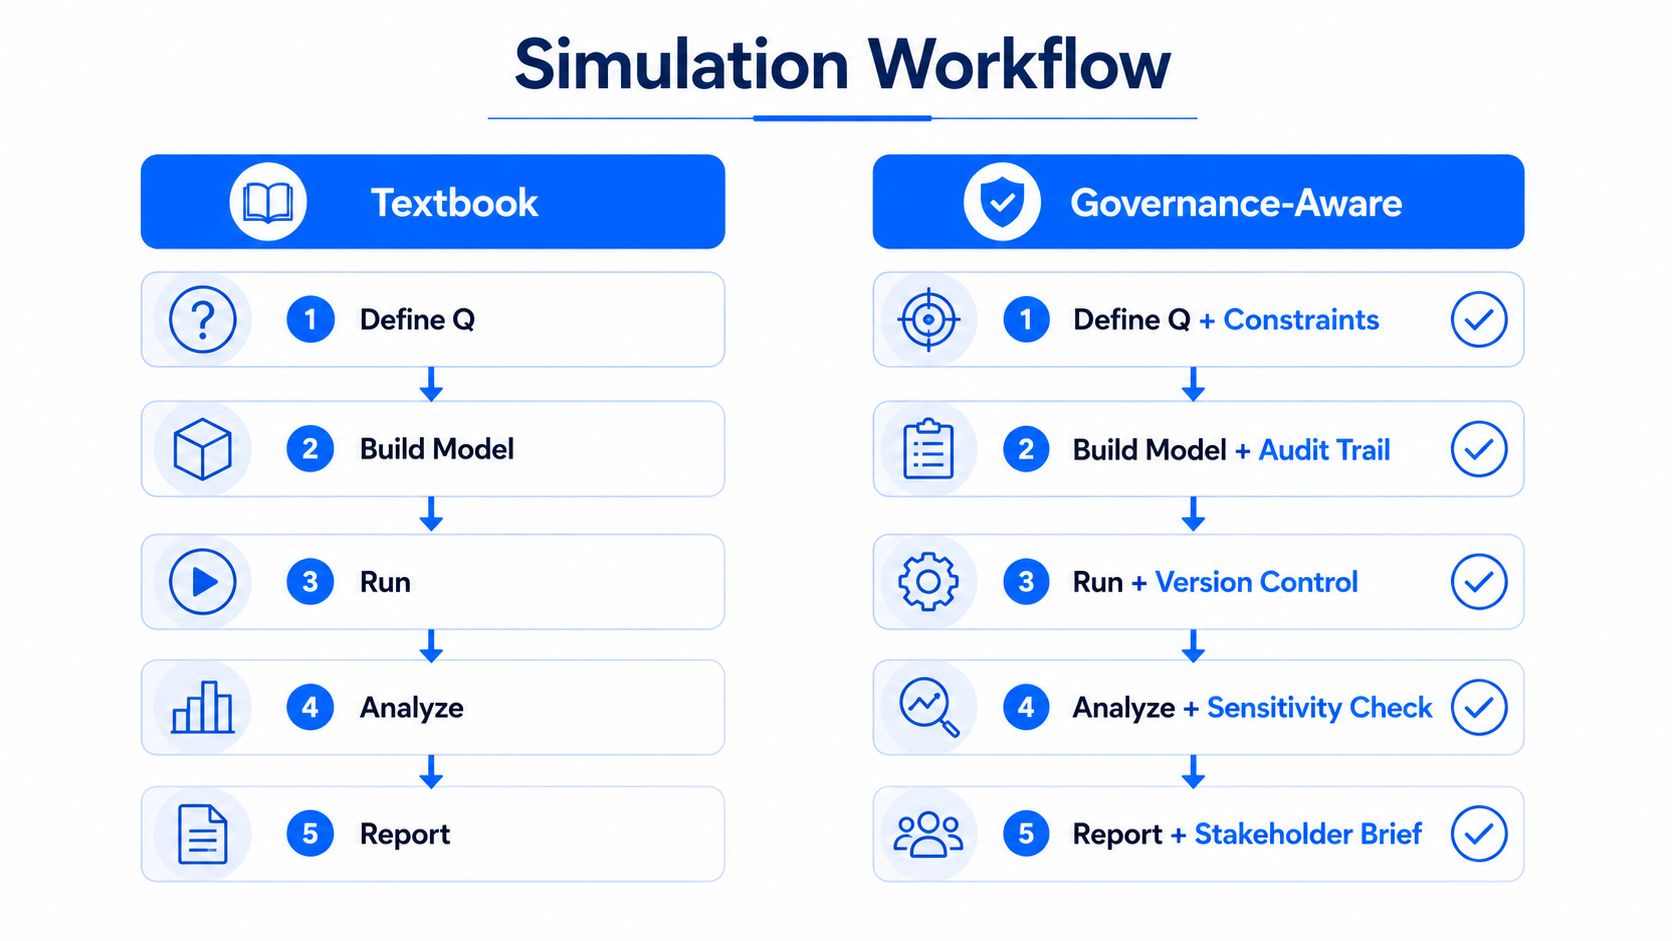
Un istogramma è solo un risultato intermedio. Un flusso di lavoro pronto per la governance consente a un altro ingegnere, a un auditor o a un comitato rischi di capire come è stato prodotto il risultato e di riprodurlo a partire dalle evidenze registrate.
Fase uno: inquadrare la decisione
Partite da una domanda di business anziché da un sintomo tecnico. “Qual è la probabilità che i ricavi riportati superino la soglia di correzione?” identifica un esito, una soglia e un responsabile della decisione. “Quanto è instabile la tabella delle transazioni?” descrive una condizione, ma non definisce un'azione.
Registrate il periodo di reporting, i dataset coinvolti, i consumatori a valle, l'incertezza accettabile e la risposta per ciascuna fascia di rischio prima di scegliere una distribuzione. Questo perimetro mantiene la simulazione legata a una decisione, evitando che si trasformi in un esercizio sui dati senza fine.
Fase due: individuare le fonti di incertezza
Elencate ogni variabile in grado di modificare l'esito e collegatela a delle evidenze. La telemetria storica sugli arrivi può descrivere il comportamento dell'aggiornamento dei dati. Gli impegni dei fornitori possono fornire una prior esterna per i ritardi di servizio. I risultati della validazione possono mostrare con quale frequenza compaiono record non validi e quanto può essere grande il loro effetto.
Documentate la motivazione di ogni scelta di distribuzione. Un parametro senza fonte impedisce ai revisori di distinguere il comportamento misurato dal giudizio di un analista. Questa distinzione è importante quando le ipotesi cambiano o quando un risultato deve essere difeso in seguito.
Fase tre: costruire il modello di propagazione
Il modello può essere una formula, un grafo delle dipendenze o un harness di simulazione. Dovrebbe rendere esplicito il percorso da ogni input campionato all'esito di business. Se dati in ritardo modificano una metrica della dashboard, la logica dovrebbe identificare i record coinvolti, calcolare la variazione della metrica e mostrare dove interviene la ponderazione a valle.
Fase quattro: eseguire e conservare
Eseguite un numero di iterazioni sufficiente a stabilizzare l'output scelto. Registrate random seed, versione del modello, versioni delle librerie, snapshot degli input ed estrazioni grezze. Un percentile finale privo di questo registro non consente una riproduzione affidabile né un debugging efficace.
Fase cinque: comunicare la distribuzione
Di solito il management ha bisogno dell'intervallo plausibile, della coda rilevante, dei fattori principali e dell'azione associata al risultato, non di ogni riga simulata. Presentate fasce percentili ed evidenze di sensitività, conservando il registro completo del modello per la revisione. Strumenti come digna possono trasformare simulazioni ripetute in evidenze verificabili e pronte per la governance sul rischio di business generato da dati errati.
La governance fornisce la traccia di evidenze che rende difendibile un valore di rischio simulato durante una revisione normativa o direzionale, soprattutto quando le conseguenze finanziarie richiedono un ragionamento solido.
Costruire il modello all'interno della vostra piattaforma dati
Un modello nativo del data warehouse parte dai segnali di observability che già descrivono il comportamento del data product. Invece di esportare le metriche in un foglio di calcolo separato, la piattaforma può costruire le distribuzioni, eseguire la simulazione e archiviare gli esiti accanto ai metadati della sorgente.
Trasformare la telemetria in input
Segnali diversi descrivono tipi diversi di incertezza:
La variazione del conteggio delle righe può alimentare un modello di conteggio, come un modello di tipo Poisson per gli arrivi di eventi o un'approssimazione normale quando il processo è sufficientemente stabile.
La deriva del tasso di null può essere rappresentata con una distribuzione beta, perché i tassi sono limitati e possono variare in modo asimmetrico.
Il ritardo di aggiornamento può usare una forma lognormale traslata quando i ritardi restano non negativi e quelli occasionalmente lunghi sono rilevanti.
Le modifiche di schema e gli errori di validazione possono alimentare variabili di scenario che modificano la popolazione coinvolta o invalidano un calcolo a valle.
Queste scelte non sono verità automatiche. Il team dovrebbe confrontare le distribuzioni candidate con il comportamento storico, esaminare le code e registrare la motivazione. Una distribuzione comoda ma che rappresenta male il processo sorgente può generare una falsa sicurezza.
Propagare l'incertezza attraverso la logica di business
Consideriamo un modello dei ricavi espresso come:
revenue = transactions × price × (1 - refund_rate)
A ogni esecuzione la simulazione campiona volume delle transazioni, prezzo e tasso di rimborso. Applica poi la formula e archivia l'esito risultante in termini di ricavi in una tabella dei risultati. Un'implementazione nel data warehouse potrebbe usare SQL per l'aggregazione e un job Python leggero per il campionamento delle distribuzioni, mentre un modello più complesso potrebbe ricorrere a un motore di simulazione dedicato.
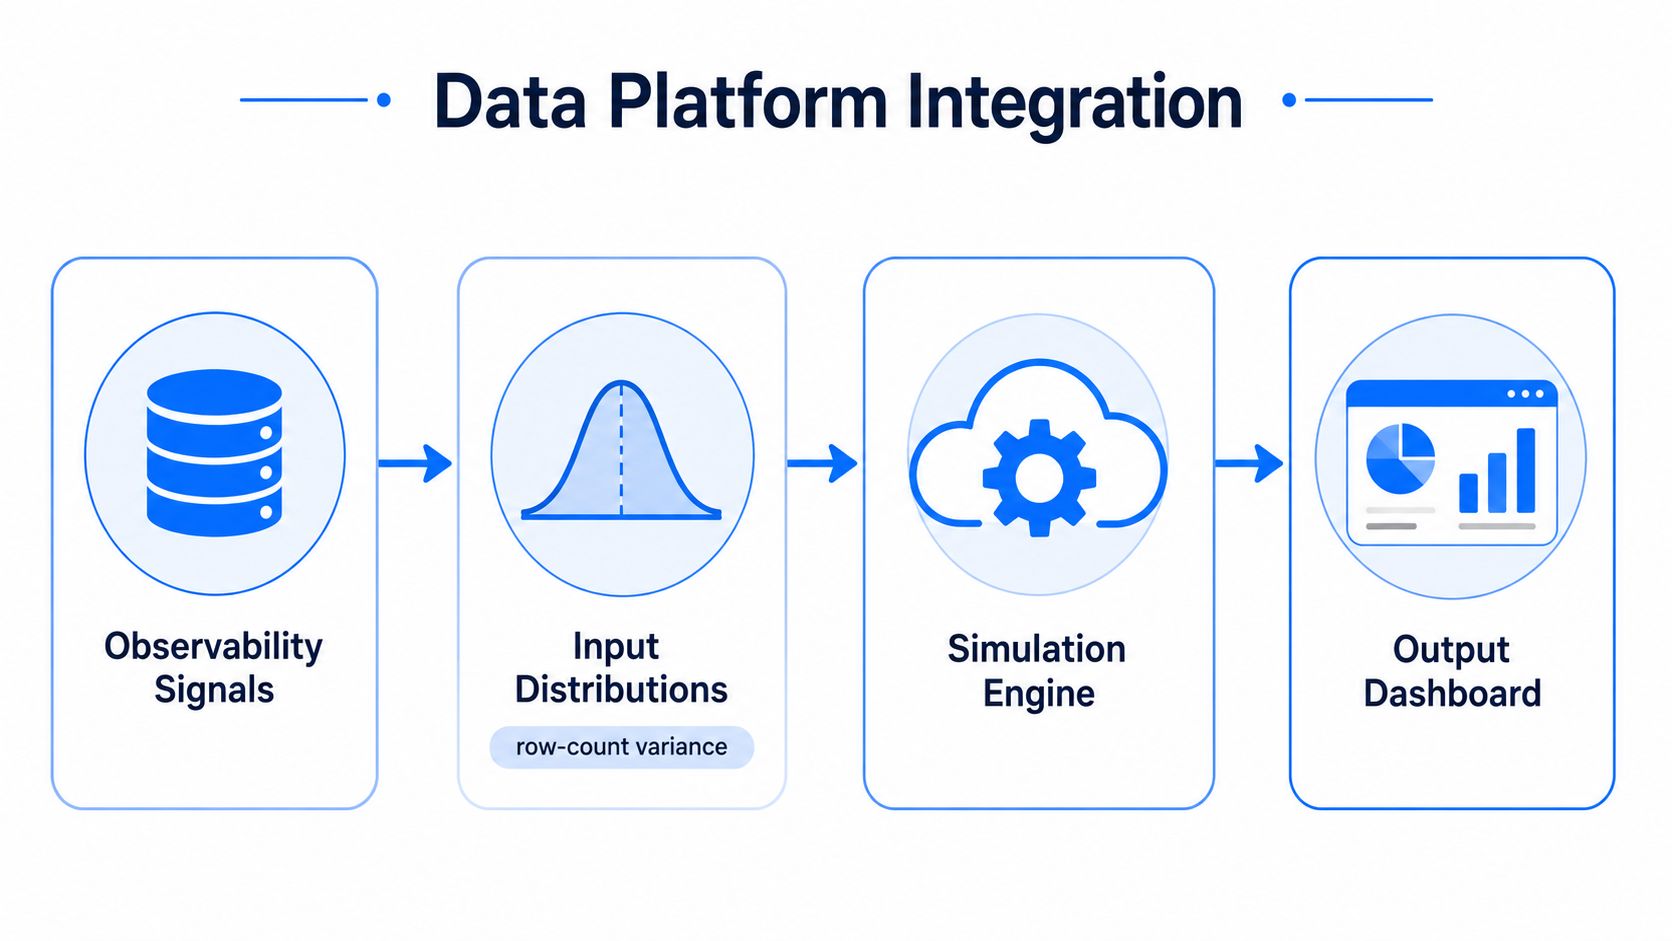
Il dettaglio operativo è importante. Archiviate a ogni esecuzione lo snapshot della sorgente, le definizioni delle feature, la versione del codice del modello, il random seed, i parametri delle distribuzioni e le versioni delle dipendenze. Se in seguito una pipeline cambia, i revisori devono poter distinguere un nuovo stato di rischio da una modifica del modello stesso.
Un approccio nel database riduce inoltre gli spostamenti superflui di dati sensibili. L'approccio in-database di digna alla qualità dei dati descrive un modello in cui metriche e analisi vengono eseguite all'interno dell'ambiente database del cliente. In un flusso Monte Carlo, punteggi di anomalia, segnali di tempestività, esiti di validazione e differenze di schema possono diventare input versionati anziché alert scollegati.
Leggere i risultati come un analista del rischio
Un istogramma è un'evidenza, non una conclusione. Il compito dell'analista è identificare l'intervallo, la coda e gli input che generano la dispersione.
Tre artefatti meritano attenzione
Le fasce percentili delimitano l'intervallo plausibile degli esiti. Permettono di indicare quanta parte della massa di probabilità simulata cade sotto o sopra una soglia. Un referente della finanza può agire su un intervallo in modo più efficace che su una media non spiegata.
I fan chart mostrano come l'incertezza si allarga nel tempo o su punti di previsione successivi. In una piattaforma dati possono illustrare l'intervallo previsto di aggiornamento dei dati, l'esposizione cumulata del reporting o una metrica in caso di ritardi ripetuti delle dipendenze.
I grafici a tornado classificano le variabili di input in base al loro contributo alla varianza dell'esito. Sono utili perché orientano le correzioni verso l'incertezza che conta di più. Se il ritardo di aggiornamento domina la dispersione, calibrare una regola di validazione a basso impatto non cambierà in modo sostanziale il profilo di rischio.
Riportare la coda, non solo il centro
Una distribuzione asimmetrica può rendere la media un numero poco significativo da mettere in evidenza. La media può collocarsi comodamente sotto una soglia mentre una coda rilevante si estende verso un'esposizione inaccettabile. Per il reporting sul rischio, un percentile di coda è spesso più verificabile perché indica il limite che l'organizzazione sceglie di gestire.
Un'affermazione adeguatamente qualificata potrebbe essere questa: “Il novantacinque per cento delle esecuzioni si colloca tra 1,8 e 2,4 milioni, mentre la coda dei ricavi al quinto percentile è di 1,4 milioni.” Questi valori illustrano un formato di reporting, non un risultato universale. Il vostro modello deve fornire l'intervallo effettivo e documentare le ipotesi su cui si basa.
La distribuzione dei dati fornisce le basi per interpretare queste forme. La confidenza appartiene all'intervallo o all'affermazione sul percentile, non a una singola stima puntuale. Accompagnate sempre il dato principale con il perimetro del modello, lo snapshot degli input e il risultato dell'analisi di sensitività.
Gli errori che rendono le simulazioni non verificabili
Una simulazione può produrre un grafico impeccabile pur incorporando ipotesi deboli. Gli errori più pericolosi sono quelli silenziosi, perché il risultato appare più rigoroso del processo che lo ha generato.
L'indipendenza è spesso una comoda finzione
Trattare gli input come indipendenti è facile da implementare, ma i guasti delle pipeline hanno spesso cause comuni. Un ritardo della sorgente può aumentare il ritardo di aggiornamento, ridurre i record disponibili e innescare contemporaneamente nuovi tentativi a valle. Uno studio del 2025 sul rischio di progetto ha rilevato che l'aggiunta di dipendenze probabilistiche ed effetti a cascata nel tempo produceva requisiti di contingenza significativamente più elevati rispetto agli approcci classici, mentre una revisione sistematica del 2022 ha sottolineato l'importanza della modellazione delle dipendenze, di un fitting attento alle code e di una validazione trasparente in questa revisione dei metodi per il rischio di progetto.
Usate matrici di correlazione o fattori di rischio latenti condivisi dove le evidenze li supportano. Verificate poi se il co-movimento simulato somiglia al comportamento osservato.
La coda scompare quando la forma è sbagliata
Una distribuzione normale può sottostimare ritardi o perdite rari ma rilevanti quando il processo sottostante ha code pesanti. Esaminate gli estremi storici, testate distribuzioni alternative ed eseguite scenari di stress espliciti per i rischi che il modello principale potrebbe non rappresentare bene.
Altre misure di salvaguardia vanno inserite nei metadati di esecuzione:
Registrazione del seed: conservate il random seed, così che un'esecuzione approvata possa essere riprodotta.
Ancoraggio allo snapshot: legate i parametri di input a uno snapshot specifico dei dati, così che la deriva della sorgente non riscriva la storia.
Controlli di convergenza: confrontate gli output principali su esecuzioni o seed aggiuntivi e registrate la decisione sulla stabilità.
Backtesting: confrontate gli intervalli simulati con gli esiti osservati in seguito e rivedete il modello quando sbaglia sistematicamente.
Revisione delle formule: validate vincoli di business, esclusioni, limiti massimi e percorsi condizionali invece di presumere che un'equazione semplificata sia sufficiente.
La spiegazione di digna su data provenance e data lineage offre un contesto utile per distinguere da dove proviene un valore da come si è spostato attraverso la piattaforma. Una simulazione affidabile ha bisogno di entrambi.
Due esempi concreti tratti da finanza e qualità dei dati
La finanza offre un'applicazione familiare. Un team di rischio di portafoglio può simulare rendimenti giornalieri correlati di azioni e tassi di interesse, aggregare ogni scenario campionato in un risultato di P&L ed esaminare la distribuzione delle perdite. La domanda non è “quale sarà il rendimento di domani?”, ma “con quale frequenza il portafoglio supera il limite di perdita, data l'incertezza modellata?”
La correlazione è importante perché asset e tassi possono muoversi insieme in condizioni di mercato comuni. Se il modello campiona ogni rendimento in modo indipendente, può produrre una distribuzione ordinata che sottostima il ribasso congiunto. Il report finale dovrebbe indicare il percentile di coda scelto, la finestra degli input, le ipotesi di dipendenza e i limiti del modello di portafoglio.
La qualità dei dati ha la stessa struttura
Ora applichiamo il metodo a una tabella che alimenta una dashboard dei ricavi. Il data team modella l'aggiornamento dei dati e la deriva del tasso di null su un orizzonte di simulazione di 90 giorni, combina questi segnali con i pesi di utilizzo a valle e stima la probabilità che i ricavi trimestrali vengano riportati in modo errato. Il risultato potrebbe supportare la decisione se ritardare la pubblicazione, avviare una riconciliazione o sottoporre il dataset al responsabile del controllo.
Il modello potrebbe considerare un caricamento in ritardo come incidente solo su una parte della popolazione di reporting, mentre un aumento del tasso di null modifica l'affidabilità di una metrica più ampia. Può anche includere errori di validazione, modifiche di schema e tempi di correzione come input condizionali. Ogni esecuzione produce una versione plausibile del trimestre, non la pretesa di conoscere esattamente il futuro.
L'observability diventa il livello di campionamento
Una piattaforma dati è diversa da un foglio di calcolo statico. Il comportamento dell'aggiornamento dei dati cambia al variare di pianificazioni, dipendenze e sistemi sorgente. I pattern dei null si spostano quando i team applicativi modificano moduli o contratti degli eventi. I risultati della validazione evolvono man mano che le regole di business maturano.
Una simulazione aggiornata di continuo richiede quindi telemetria attuale, distribuzioni versionate e ownership chiara. Una piattaforma di observability può fornire i segnali grezzi, ma il modello di rischio ha comunque bisogno di ipotesi esplicite su come tali segnali influenzano gli esiti di business. Il valore sta nel collegare le evidenze operative a una soglia decisionale, conservando poi il percorso che le unisce.
Quando Monte Carlo è lo strumento giusto
Monte Carlo si guadagna il suo posto quando la domanda riguarda una distribuzione, gli input sono incerti ma limitati o modellabili e un calcolo in forma chiusa non riesce a rappresentarne le interazioni. È particolarmente utile quando diverse condizioni delle pipeline si combinano in un'esposizione che un semplice alert non può esprimere.
Usate un metodo più semplice quando la decisione segue una regola deterministica. Una soglia fissa, uno SLA sull'aggiornamento dei dati o un controllo di validazione diretto possono bastare quando l'unica azione è “interrompere il caricamento se questa condizione è vera”. La simulazione comporta costi di modellazione, revisione, esecuzione e manutenzione, quindi il risultato dovrebbe incidere su una decisione rilevante.
Un test pratico di prontezza comprende quattro segnali:
Input documentati: il team sa spiegare da dove proviene ciascuna distribuzione.
Esecuzioni riproducibili: seed, codice, dipendenze e snapshot vengono conservati.
Revisione di governance: gli owner hanno messo in discussione le ipotesi e approvato il perimetro.
Ownership operativa: qualcuno è responsabile di aggiornare il modello e di agire in base ai suoi risultati.
I team che valutano questo approccio dovrebbero anche distinguere il giudizio qualitativo dai metodi di analisi quantitativa. Monte Carlo non sostituisce la revisione degli esperti di dominio, ma le offre un modo strutturato per esprimere l'incertezza e confrontare gli scenari.
Situazione | Usare Monte Carlo | Usare un metodo più semplice |
|---|---|---|
Più input incerti interagiscono tra loro | Modellare l'esito combinato e le dipendenze | Usare una regola quando gli input non interagiscono in modo rilevante |
Il management ha bisogno di una probabilità rispetto a una soglia | Riportare fasce percentili ed esposizione di coda | Riportare uno stato deterministico quando la soglia è chiara |
Il comportamento della pipeline cambia nel tempo | Aggiornare le distribuzioni dalla telemetria versionata | Usare un alert statico per comportamenti stabili e ben compresi |
Le evidenze sugli input sono deboli | Iniziare migliorando misurazioni e ipotesi | Evitare una simulazione dall'aspetto preciso costruita su congetture |
L'azione è immediata e binaria | Simulare se l'entità dell'esposizione influisce sull'escalation | Usare validazione o monitoraggio a soglia in caso contrario |
digna può essere una delle opzioni di runtime per fornire segnali di observability, incluse informazioni su anomalie, tempestività, validazione e modifiche di schema, così che il modello non resti intrappolato in un foglio di calcolo obsoleto. Usatela solo all'interno di un processo operativo più ampio che assegni gli owner, riveda le ipotesi e conservi le evidenze delle esecuzioni.
digna collega anomalie dei dati, tempestività, validazione, modifiche di schema e metriche di business all'interno dell'ambiente del cliente, fornendo ai modelli Monte Carlo input verificabili per stimare il rischio che si cela dietro dashboard inaffidabili. Visitate digna per vedere come la sua piattaforma di observability può aiutare il vostro team a trasformare i segnali di qualità dei dati in evidenze di rischio pronte per la governance.
Domande frequenti
Cosa aggiunge al monitoraggio la valutazione del rischio Monte Carlo?
L'esposizione, anziché gli eventi. Gli alert descrivono cosa è successo; una valutazione del rischio risponde su durata, cioè per quanto tempo la pipeline potrebbe restare errata prima del rilevamento, ambito, cioè quali tabelle e modelli ereditano il difetto, effetto sul business e risposta, cioè se sospendere il reporting, correggere o proseguire con una riserva documentata.
Cosa campiona effettivamente il modello?
Combinazioni plausibili delle variabili operative che determinano l'esposizione: ritardo di consegna, volume di duplicati, tempo di correzione e utilizzo della dashboard. È campionarle insieme che trasforma la descrizione di un singolo incidente in un'affermazione difendibile sull'entità del danno possibile.
Perché non basta disporre di un sistema di monitoraggio?
Perché il team dell'esempio il monitoraggio lo aveva. L'alert è scattato e la causa principale era chiara in tarda mattinata, eppure nessuno sapeva dire fin dove si fosse propagato il difetto o quali decisioni avesse già toccato: è questa la lacuna che la valutazione del rischio colma.
Quando è utile al di fuori di un incidente?
Nella governance ordinaria. Lo stesso modello che stima l'esposizione durante un incidente può essere eseguito in anticipo per mostrare quali data product presentano la fascia di rischio più ampia, fornendo così argomenti su dove indirizzare per primi controlli e ownership.
Cosa rende difendibile un risultato di rischio?
Esplicitare gli input e la decisione che supporta. Un numero prodotto da ipotesi non dichiarate alimenta la stessa discussione che la simulazione doveva chiudere, quindi ipotesi, intervalli campionati e azione conseguente dovrebbero sempre viaggiare insieme.


