Tutorial sulla simulazione Monte Carlo per data engineer nel 2026
|
7
min di lettura

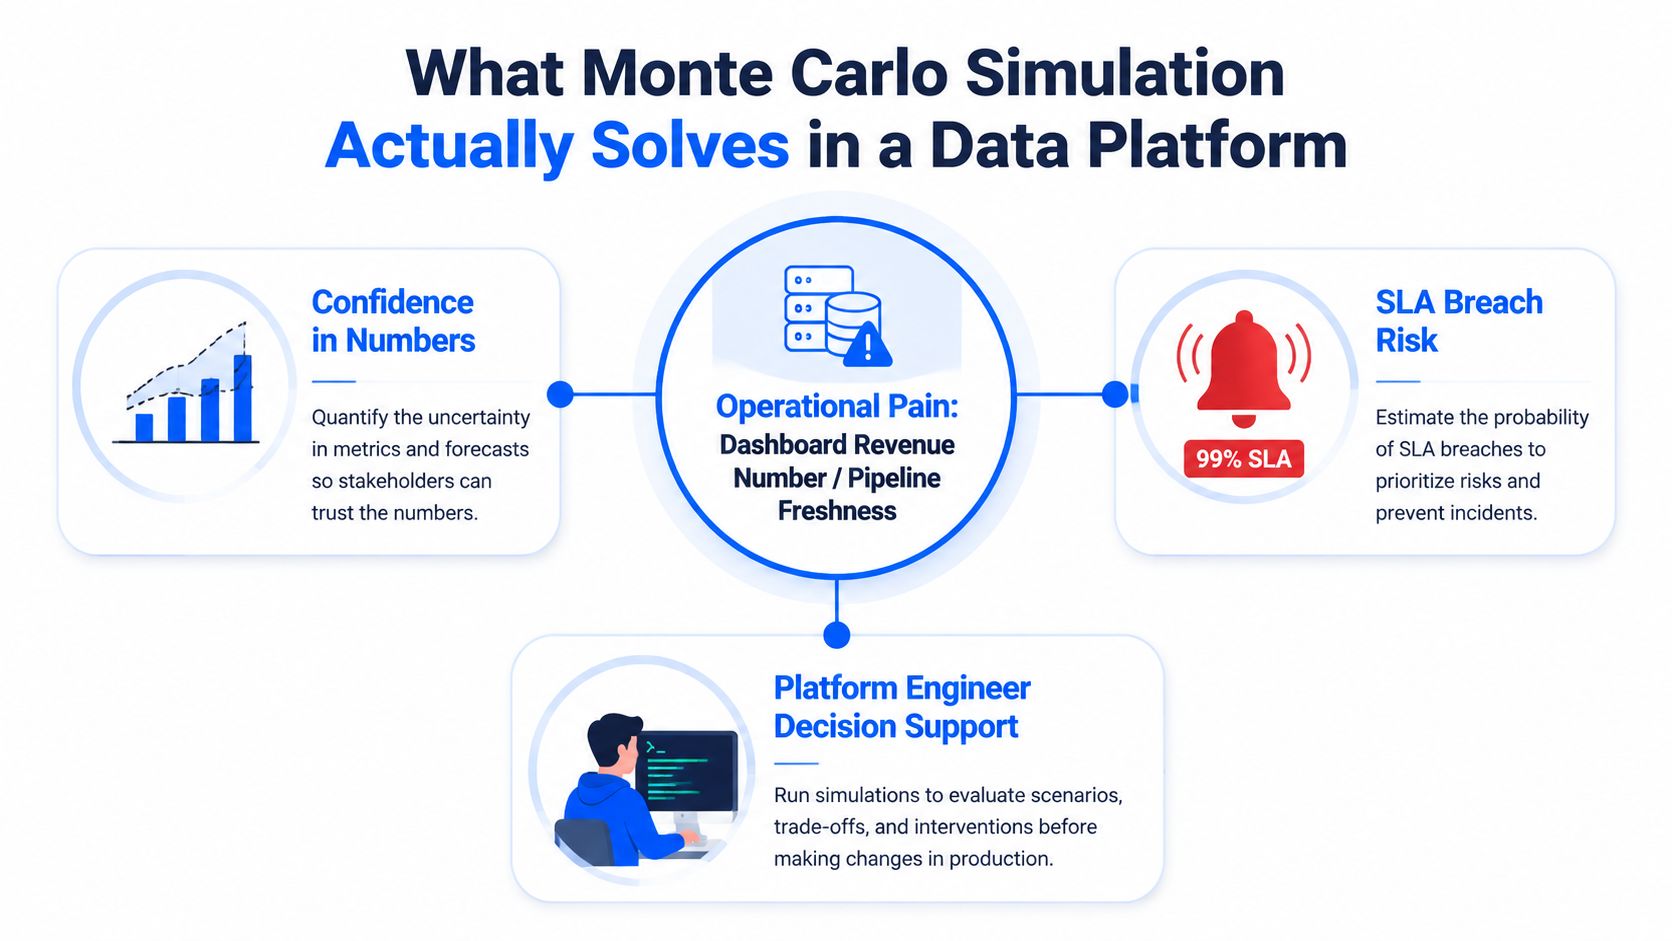
Probabilmente avete già visto questo tipo di errore. Una dashboard riporta un dato di fatturato pulito, mentre la pipeline che lo ha prodotto è arrivata in ritardo, ha elaborato un volume insolito o ha perso dei record. Il numero sembra preciso perché la dashboard mostra un unico valore, ma il platform engineer deve comunque rispondere alla domanda più difficile: quanta fiducia dovrebbe riporvi il business, e quanto è probabile che la pipeline non rispetti il proprio impegno di consegna?
Una simulazione Monte Carlo sostituisce questa falsa precisione con una distribuzione di risultati plausibili. In una piattaforma dati di produzione, il risultato utile non è un istogramma colorato fine a sé stesso. È una stima difendibile del rischio di consegna, dell'incertezza di una metrica, delle prestazioni di un rilevatore di anomalie o della capacità operativa, supportata da ipotesi validate e da controlli di convergenza.
Indice dei contenuti
Cosa risolve davvero la simulazione Monte Carlo in una piattaforma dati
Il metodo storico e il caso d'uso ingegneristico
Scegliere le distribuzioni giuste per input reali
Adattate un modello, poi mettetelo alla prova
Guida rapida alla scelta delle distribuzioni per gli input di una piattaforma dati
Costruire la prima simulazione in Python
Modello e driver vettorizzato
Riportare il risultato
Riduzione della varianza e diagnostica di convergenza
Diagnostiche da includere nell'esecuzione
Errori comuni che compromettono le simulazioni in produzione
Leggere l'errore nella dashboard
Anche i percentili hanno bisogno di incertezza
Casi d'uso pratici per i data engineer
Incertezza sulle metriche di business
Probabilità di violazione dello SLA nella consegna dei dati
Dati di anomalia sintetici per il benchmarking dei rilevatori
Checklist di produzione per rilasciare un modello Monte Carlo
Riproducibilità e governance
Controlli di runtime
Cosa risolve davvero la simulazione Monte Carlo in una piattaforma dati
Una previsione deterministica di una pipeline potrebbe indicare che un job notturno terminerà a un orario preciso. Questa stima di solito nasconde la variabilità del volume alla sorgente, dei ritardi a monte, della contesa sul data warehouse, del numero di partizioni e della durata delle fasi. Se il job deve arrivare entro le 06:00, la domanda operativa non è "qual è il tempo medio di completamento?", ma "quale quota delle esecuzioni plausibili termina in ritardo?"
La simulazione Monte Carlo risponde a questa domanda attraverso un campionamento casuale ripetuto. Si rappresentano gli input incerti con distribuzioni, si estrae un valore plausibile per ciascun input, si esegue il modello della pipeline e si registra il risultato. Ripetendo il processo si ottiene una distribuzione dei risultati anziché una singola stima puntuale. La tecnica è definita in generale come un metodo di campionamento casuale ripetuto per l'analisi numerica, e la ricerca sulla didattica della statistica la descrive come un esperimento guidato dal computer che genera dati campionari plausibili a partire da parametri noti, con applicazioni che vanno dalla fisica delle particelle e dalla modellazione molecolare al traffico, alle scienze ambientali e alla simulazione finanziaria (ricerca sulla didattica della statistica).
Il metodo storico e il caso d'uso ingegneristico
Il metodo moderno nacque a Los Alamos a metà degli anni Quaranta e fu automatizzato completamente per la prima volta su un computer ENIAC nella primavera del 1948. Le ricostruzioni storiche indicano Stanisław Ulam come inventore della versione moderna, mentre John von Neumann, Nicholas Metropolis e altri svilupparono i primi calcoli computerizzati per la simulazione del nucleo delle armi nucleari (storia del metodo Monte Carlo).
L'origine è importante perché mette in luce lo scopo del metodo. Il Monte Carlo è stato creato per sistemi troppo complessi per un calcolo diretto. Le piattaforme dati hanno un problema simile, anche se le fonti di incertezza sono diverse. Latenza di ingestion, dimensione dei carichi di lavoro, retry, concorrenza e comportamento della freschezza interagiscono in modi che una singola media non può descrivere.
Per un ragionamento in stile mercati predittivi sui risultati incerti, le strategie Monte Carlo per i mercati predittivi offrono un utile contesto concettuale. Per i team dati, l'estensione pratica consiste nel collegare l'output della simulazione all'observability invece di lasciarlo in un notebook. Una panoramica utile è l'approfondimento di digna sui metodi Monte Carlo per una migliore data observability, in particolare quando i team devono trasformare risultati probabilistici in segnali di monitoraggio ricorrenti.
Regola di produzione: una simulazione diventa affidabile solo quando le ipotesi sugli input, il comportamento di convergenza e la decisione operativa sono tutti visibili.
Scegliere le distribuzioni giuste per input reali
La scelta della distribuzione parte dalla telemetria, non da un menu a tendina. Estraete dalla piattaforma le durate storiche dei job, i ritardi di ingestion, i conteggi di righe o gli intervalli di freschezza, poi osservatene la forma prima di scegliere un modello. Un istogramma, un grafico dei quantili e una vista temporale rivelano spesso problemi che media e deviazione standard nascondono.
La latenza raramente è una buona candidata per una distribuzione gaussiana non verificata. È limitata inferiormente da zero, spesso asimmetrica a destra, e può contenere mode distinte per cache hit, esecuzioni normali, retry e periodi di sovraccarico del data warehouse. Una gaussiana di default può quindi far sembrare ragionevole il centro, sottostimando la coda superiore che determina le violazioni degli SLA.
Adattate un modello, poi mettetelo alla prova
Per durate positive dei job, un modello lognormale può essere un punto di partenza ragionevole quando il logaritmo della durata è approssimativamente normale. L'esempio seguente rende esplicito il passaggio di adattamento:
Una regola decisionale utile è usare una distribuzione parametrica quando si dispone di una solida conoscenza a priori, di più di 500 campioni e di un buon adattamento con un p-value del test KS superiore a 0,05. Queste soglie sono criteri di modellazione per questo flusso di lavoro, non garanzie che il modello sia corretto. Usate invece un bootstrap empirico quando l'input ha code pesanti, è censurato, multimodale o visibilmente influenzato da stati operativi che una singola curva parametrica non può rappresentare.
La domanda centrale non è se la curva adattata sembri elegante. È se la distribuzione preserva la parte del comportamento dell'input che incide sulla decisione, in particolare la coda.
Guida rapida alla scelta delle distribuzioni per gli input di una piattaforma dati
Tipo di input | Distribuzione consigliata | Quando usare invece quella empirica |
|---|---|---|
Durata positiva di una fase | Lognormale, quando l'adattamento è pulito | Retry, tempi di esecuzione multimodali, censura o comportamento marcato delle code |
Numero di record elaborati | Poisson o binomiale negativa, quando le ipotesi sul tasso sono difendibili | Traffico a raffiche, partizioni variabili o forte sovradispersione |
Tasso limitato | Distribuzione beta | Osservazioni scarse, cambi di regime improvvisi o coorti multiple |
Errore misurato attorno a una baseline stabile | Distribuzione normale | Asimmetria, outlier o varianza variabile |
Intervallo storico di freschezza | Distribuzione positiva adattata | Cambi di pianificazione, osservazioni mancanti o modalità operative distinte |
Per una base più ampia su come i valori osservati formano distribuzioni, consultate cosa si intende per distribuzione dei dati. La pratica importante è preservare il contesto che ha generato i dati. Una durata registrata in un periodo tranquillo non dovrebbe rappresentare automaticamente un'esecuzione di fine mese ad alto volume.
Costruire la prima simulazione in Python
Un primo modello utile dovrebbe somigliare a una decisione reale di piattaforma. Considerate un ETL notturno con diverse fasi sequenziali che deve completarsi entro le 06:00. La durata di ogni fase è modellata a partire da 90 giorni di log di Airflow, e l'output è la probabilità che l'intero flusso di lavoro arrivi dopo la scadenza.
Mantenete separati tre livelli: il modello definisce come gli input diventano un risultato, il driver di simulazione genera le estrazioni e il livello di reporting calcola le metriche decisionali. Questa separazione rende più facile testare le ipotesi senza riscrivere il codice di esecuzione.
Modello e driver vettorizzato
L'istanza esplicita di default_rng è importante. Un seed fisso rende un'esecuzione riproducibile, mentre SeedSequence fornisce ai worker paralleli flussi figli indipendenti invece di condividere accidentalmente un unico generatore. In questo esempio, il driver può eseguire 50.000 prove, registrare se ciascuna prova viola la scadenza e restituire un report pandas. Il numero di esecuzioni è una scelta di configurazione, non una prova di convergenza.
Riportare il risultato
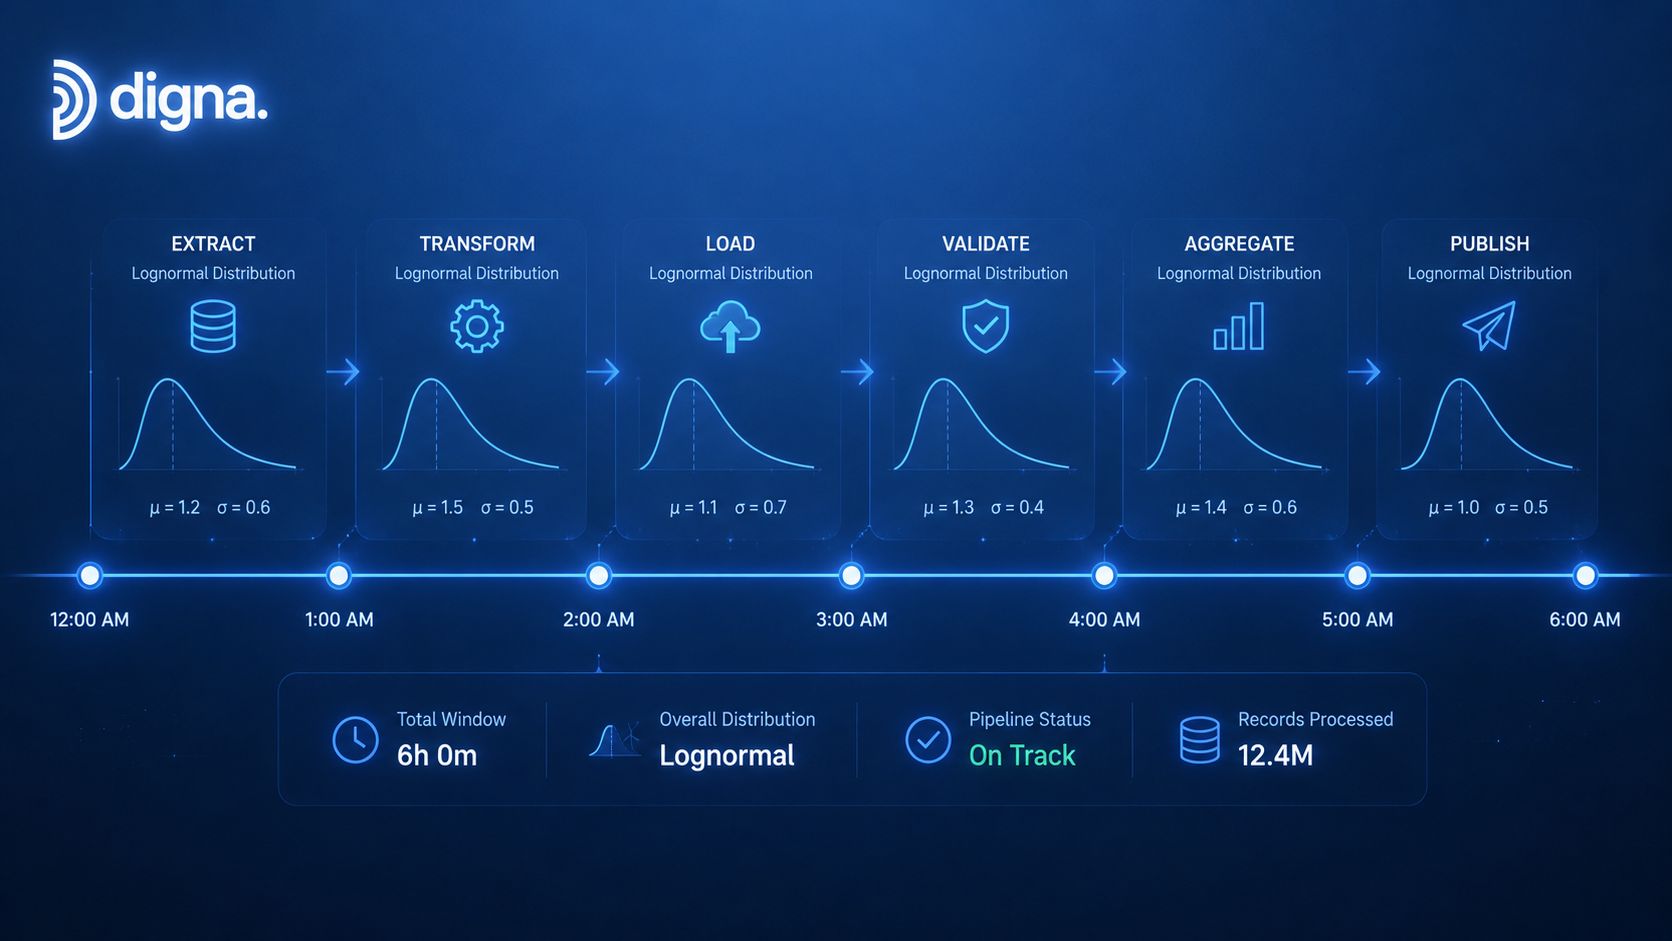
La versione di produzione dovrebbe condizionare le distribuzioni delle fasi a caratteristiche rilevanti come il volume a monte o il numero di partizioni. Dovrebbe inoltre confrontare i tempi di completamento simulati con gli arrivi osservati. Un approccio Python al rilevamento delle anomalie nei dati è utile quando la stessa pipeline ha bisogno di segnali di anomalia accanto alle previsioni di tempestività.
Riduzione della varianza e diagnostica di convergenza
Il Monte Carlo semplice ha un punto debole prevedibile. L'errore standard di una media diminuisce come O(1/√N), quindi restringere la stima può richiedere un numero sproporzionato di estrazioni in più. È un problema quando l'obiettivo è la probabilità di una violazione rara dello SLA o un percentile elevato, dove la stima può variare sensibilmente da un'esecuzione all'altra.
La riduzione della varianza aumenta l'informazione ottenuta da ogni estrazione. Le variabili antitetiche abbinano un campione uniforme u a 1 - u, il che può ridurre la varianza quando la risposta cambia in direzioni opposte all'interno della coppia. Le variabili di controllo usano una grandezza correlata con un valore atteso noto o stabile. In una pipeline di dati, il numero di righe atteso rispetto a quello effettivo può fornire un controllo utile quando l'output dipende dal volume.
Il campionamento stratificato suddivide lo spazio degli input in fasce di latenza o di carico di lavoro, quindi campiona deliberatamente da ciascuna fascia. Questo evita che una fascia ampia e ordinaria finisca per oscurarne una più piccola ma importante dal punto di vista operativo.
Diagnostiche da includere nell'esecuzione
Una media mobile cumulativa rende visibile l'instabilità:
Per le simulazioni organizzate in catene, confrontate la varianza intra-catena e inter-catena con una diagnostica in stile R-hat:
Un controllo in stile Geweke confronta il primo e l'ultimo 10% delle estrazioni con uno z-score a due campioni. L'implementazione esatta deve tenere conto dell'autocorrelazione quando le estrazioni non sono indipendenti. Come criterio pratico di arresto, richiedete un errore standard relativo inferiore allo 0,5% della stima e un accordo tra le catene entro 1,01. Queste soglie vanno registrate come impostazioni di governance, non applicate implicitamente all'interno di un notebook.
Tecnica | Obiettivo | Quando si applica | Segnale di convergenza |
|---|---|---|---|
Variabili antitetiche | Varianza di campionamento | Superfici di risposta monotone o con coppie correlate negativamente | Le stime appaiate si stabilizzano più rapidamente |
Variabili di controllo | Varianza residua | Una grandezza osservabile correlata ha un valore atteso noto | Lo stimatore corretto ha una varianza inferiore |
Campionamento stratificato | Rappresentazione non uniforme dei regimi | Fasce di latenza, volume o rischio sono rilevanti | Le stime per fascia restano stabili |
Media cumulativa ed errore standard | Instabilità del campionamento | Qualsiasi output scalare | La media si assesta e le bande di errore si restringono |
Confronto in stile R-hat | Disaccordo tra catene | Simulazioni congiunte o multi-catena | Le catene concordano entro la soglia scelta |
La lezione più ampia emerge dalle discussioni attuali sul Monte Carlo: costo computazionale, critical slowing down e necessità di varianti più efficienti significano che "eseguite semplicemente più simulazioni" è un consiglio incompleto (limiti del Monte Carlo e indicazioni sulla qualità del modello). Per un toolkit statistico più ampio, i metodi statistici per l'analisi dei dati offrono un utile contesto complementare.
Errori comuni che compromettono le simulazioni in produzione
Una simulazione può essere perfettamente riproducibile e comunque sbagliata. La maggior parte degli errori deriva dal considerare il campionatore casuale come il modello, mentre i veri difetti si trovano nei seed, nella struttura delle dipendenze o nella deriva dei dati.
La cattiva gestione dei seed è il primo sintomo da verificare. Reimpostare il seed all'interno di un ciclo riga per riga può ripetere pattern, distruggere l'indipendenza voluta e rendere privi di senso i valori dichiarati di dimensione effettiva del campione. Create un generatore per ogni flusso indipendente, derivate deliberatamente i seed dei worker e registrate l'albero dei seed insieme alla configurazione dell'esecuzione.
Leggere l'errore nella dashboard
Le tracce grezze di latenza al minuto contengono spesso autocorrelazione. Campionare queste osservazioni come se fossero indipendenti può sottostimare la probabilità di un periodo prolungato di lentezza. Esaminate l'ACF, poi usate un block bootstrap oppure modellate i residui con un processo AR(1) prima di generare sequenze sintetiche.
Le correlazioni nascoste creano un errore diverso. Dimensione delle richieste e numero di partizioni possono crescere insieme nei periodi di alto volume, eppure estrazioni gaussiane indipendenti producono combinazioni che nella realtà non si verificano mai. Preservate la relazione con una matrice di correlazione e una fattorizzazione di Cholesky:
Il valore di correlazione in questo esempio è un input di modello a scopo illustrativo, non una statistica della piattaforma. In produzione, stimatelo dalla finestra di telemetria pertinente e validatelo rispetto al comportamento attuale.
Anche i percentili hanno bisogno di incertezza
Riportare una latenza p99 da una sola esecuzione induce una falsa sicurezza. Applicate il bootstrap all'output simulato, calcolate le bande dei percentili ed esponete l'intervallo insieme alla stima puntuale. Una banda ampia significa che la simulazione non si è ancora guadagnata il diritto a un'affermazione operativa precisa.
Altri sintomi utili includono:
Grafici ACF: una correlazione persistente indica che il ricampionamento indipendente non è sicuro.
Heatmap di correlazione: le relazioni mancanti rivelano estrazioni congiunte irrealistiche.
Risultati del test KS: un adattamento non riuscito mette in discussione la distribuzione parametrica scelta.
Bande dei percentili bootstrap: bande ampie rivelano stime instabili delle code.
Log di NaN e infinito: l'overflow numerico compare spesso quando le probabilità diventano estremamente piccole.
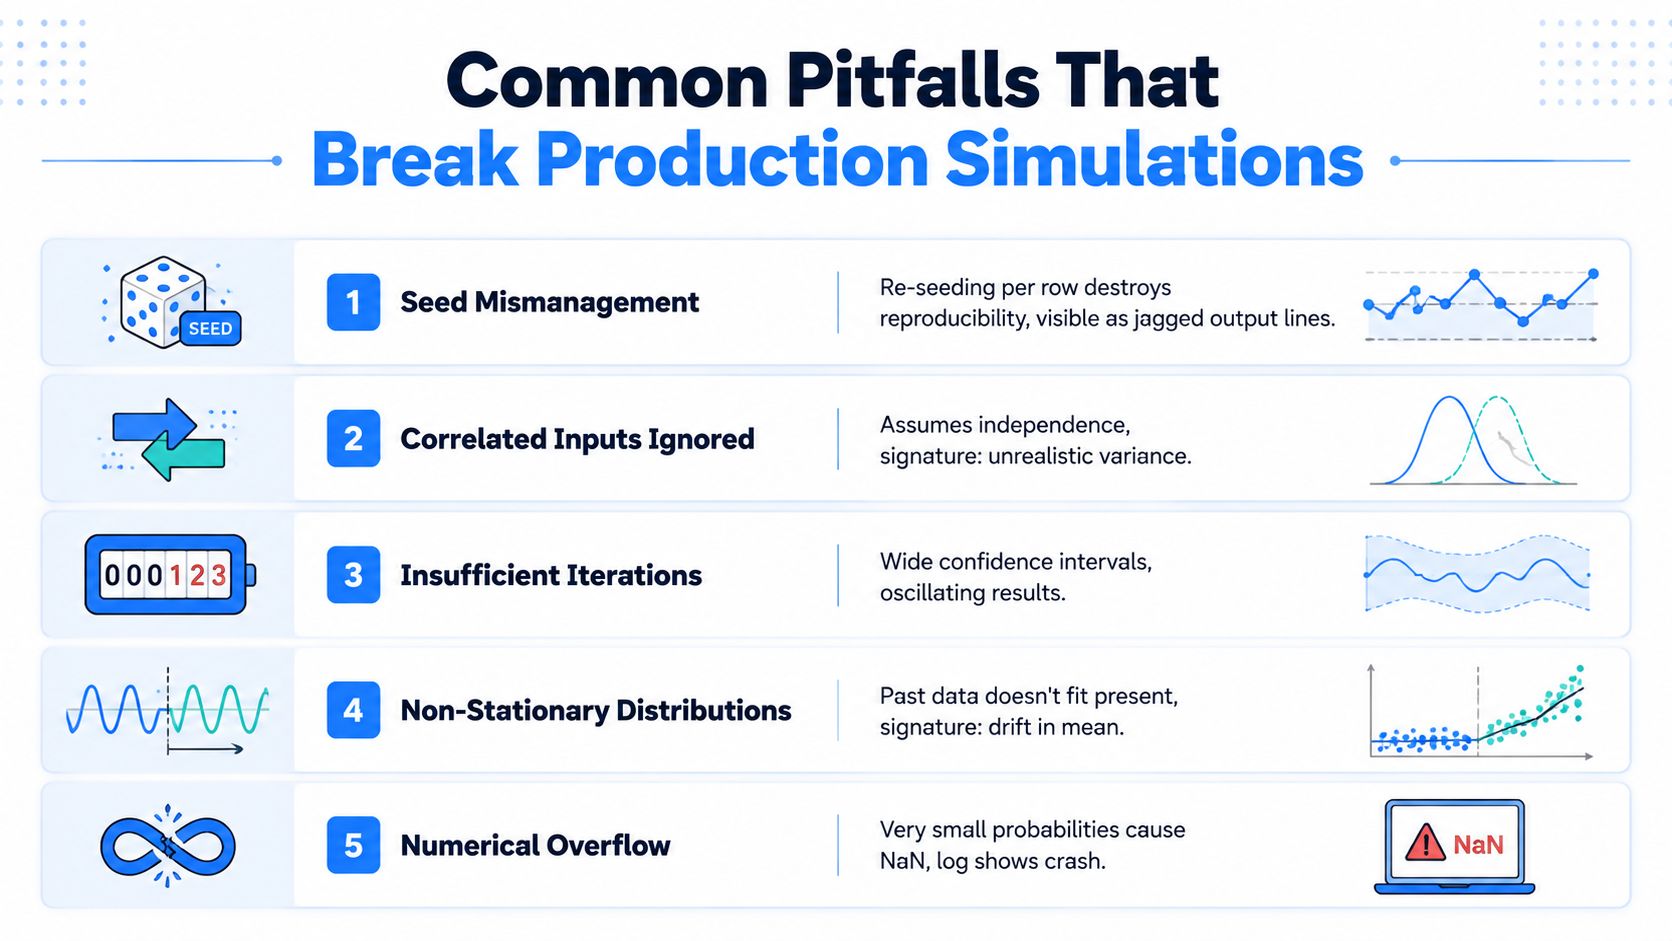
La non stazionarietà merita un alert dedicato. Una distribuzione adattata a un vecchio regime operativo può mostrare una media in deriva quando cambiano traffico, codice o configurazione del data warehouse. Aggiornate gli input secondo una pianificazione definita e confrontate la telemetria recente con la baseline prima di fidarvi della previsione.
Casi d'uso pratici per i data engineer
Il Monte Carlo giustifica il suo budget di calcolo quando l'output cambia una decisione. Tre applicazioni ricorrono nelle piattaforme dati, perché ciascuna converte un'incertezza nascosta in una metrica su cui un engineer, un analista o un incident commander può agire.
Incertezza sulle metriche di business
Un tasso di conversione è una stima, non una costante fisica. Per ogni coorte di utenti, campionate esiti di Bernoulli da una distribuzione modellata del tasso di conversione, combinate i risultati delle coorti con il traffico osservato o previsto e calcolate un risultato di fatturato per ogni prova.
Un'implementazione con pandas e NumPy può mantenere vettorizzato il ciclo interno:
La dashboard dovrebbe mostrare una mediana e una banda di incertezza, con le ipotesi a disposizione di chi interpreta la metrica. Non presentate un singolo numero come se fosse stato misurato senza errore.
Probabilità di violazione dello SLA nella consegna dei dati
Per una pipeline notturna, campionate la durata di ogni fase in funzione del volume a monte, sommate la traiettoria e pubblicate la probabilità che la consegna avvenga dopo la scadenza. Questa probabilità va affiancata a freschezza e orario di arrivo atteso, non sepolta in un notebook.
Un sistema di tempestività definisce l'orario di consegna atteso come la finestra appresa o concordata in cui un dataset, una tabella o una partizione dovrebbe essere pronta per l'uso a valle, quindi confronta l'arrivo effettivo con la pianificazione per generare alert sui dati in ritardo o mancanti (documentazione di digna sulla tempestività). Ciò integra le indicazioni sull'affidabilità che trattano la tempestività come una dimensione fondamentale della qualità dei dati e definiscono la latenza come l'ora attuale meno l'ora di creazione dei dati (la tempestività come dimensione della qualità dei dati).
Dati di anomalia sintetici per il benchmarking dei rilevatori
Le anomalie reali sono rare e le etichette spesso incomplete. Adattate una baseline a dati puliti, generate osservazioni sintetiche, iniettate anomalie puntuali, contestuali e collettive, quindi fatele passare attraverso il rilevatore. La valutazione deve misurare precision e recall a un volume di alert che il team di reperibilità sia in grado di gestire.
La letteratura accademica descrive la simulazione Monte Carlo come un modo per approssimare metriche di prestazione ideali quando un dataset simulato può generare un numero illimitato di esempi, anche per il benchmarking dei rilevatori di anomalie (discussione accademica sul benchmarking Monte Carlo). Uno studio pubblicato sul rilevamento delle anomalie ha inoltre eseguito l'intero ciclo di valutazione 500 volte, definendo esplicitamente quelle ripetizioni 500 simulazioni Monte Carlo, a dimostrazione di come la ripetizione possa stabilizzare le stime delle prestazioni (studio pubblicato sul rilevamento delle anomalie).

Questi output dovrebbero diventare metriche pianificate. Abbinateli a Great Expectations, controlli di freschezza, monitor di volume e validazione dello schema. Il Monte Carlo non sostituisce i controlli deterministici. Stima come si comportano i risultati incerti quando questi controlli operano in condizioni variabili.
Checklist di produzione per rilasciare un modello Monte Carlo
Un notebook dimostra che il codice può essere eseguito. Un modello di produzione dimostra che un altro engineer può riprodurre il risultato, comprendere le ipotesi, rilevare il degrado e usare l'output durante un incidente.
Riproducibilità e governance
Archiviate con ogni esecuzione il seed casuale, l'ambiente dei pacchetti, lo snapshot degli input, i parametri delle distribuzioni adattate, la matrice di correlazione, la configurazione delle prove e le diagnostiche di convergenza. Fissate le versioni delle dipendenze e conservate gli artefatti esatti usati per creare la previsione. Un seed senza i dati di input e la versione del modello non è riproducibilità, è solo un indizio parziale.
Versionate le ipotesi con la stessa cura del codice. Registrate il responsabile del modello, la data di revisione, le tabelle sorgente, la motivazione della scelta delle distribuzioni e le modifiche a filtri o regole di censura. Quando una pipeline cambia la propria policy di retry, la dimensione del data warehouse o la strategia di partizionamento, considerate quel cambiamento un motivo per rivedere la simulazione.
Controlli di runtime
Usate operazioni vettorizzate per il modello interno e parallelizzate solo dopo aver misurato il carico di lavoro. Impostate budget di risorse, timeout e alert sui fallimenti. Un'esecuzione che non restituisce alcun risultato perché è andata in timeout deve essere un evento operativo visibile, non un riquadro mancante nella dashboard.
Generate un alert quando:
La convergenza fallisce: la stima cumulativa o le diagnostiche delle catene restano instabili.
Gli input derivano: la telemetria recente non somiglia più alla baseline adattata.
I valori vanno in overflow: compaiono output NaN o infiniti.
Il runtime cambia: l'esecuzione supera il budget di risorse o di pianificazione concordato.
Mancano dati: il modello non dispone di abbastanza osservazioni attuali per adattare o aggiornare gli input.
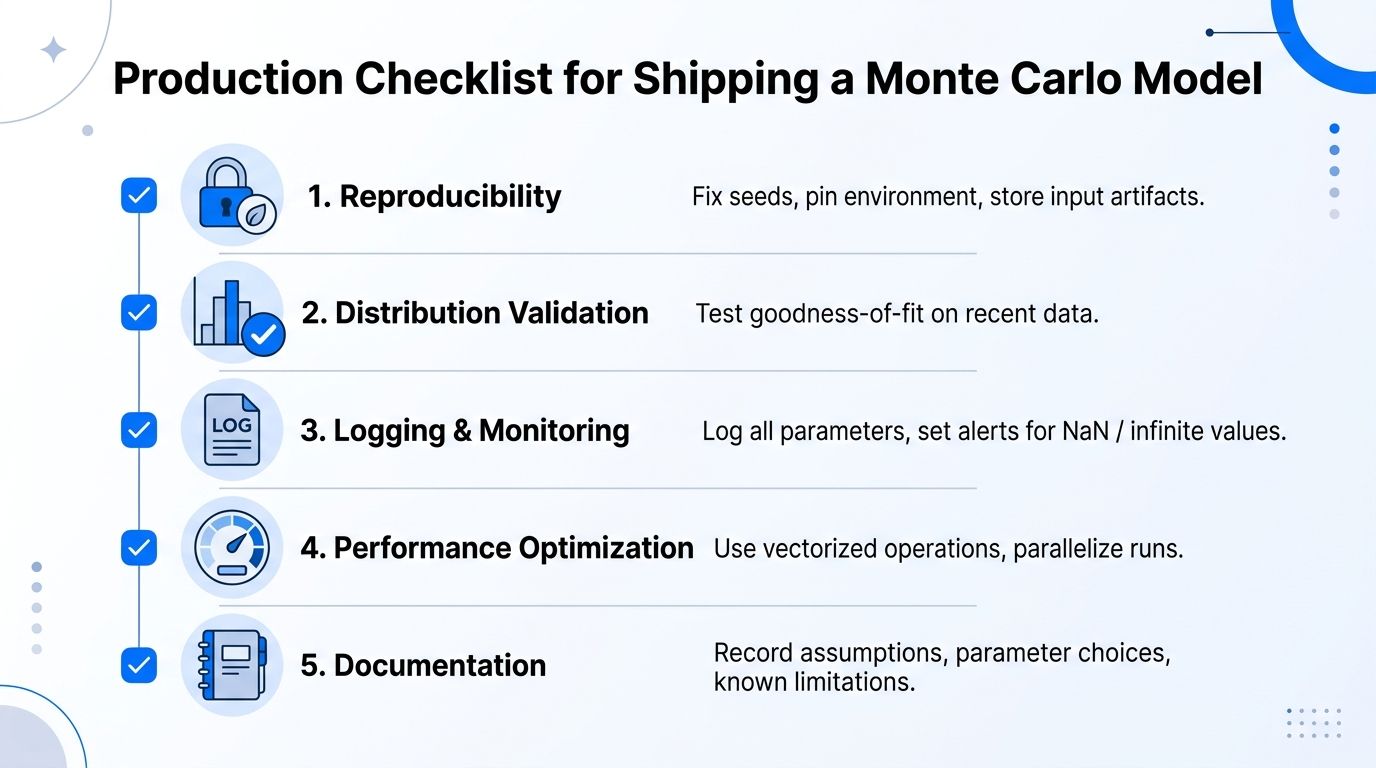
Per l'architettura della pipeline circostante, documentate responsabilità e dipendenze seguendo le indicazioni sulle pipeline di dati ETL. La simulazione deve integrarsi con l'observability esistente invece di creare un modello operativo parallelo. Le sue bande di incertezza vanno nelle dashboard e le sue probabilità di violazione nei runbook degli incidenti, con azioni chiare.
Un flusso di lavoro Monte Carlo solido ha quindi cinque proprietà: esecuzione riproducibile, distribuzioni validate, struttura delle dipendenze esplicita, convergenza verificata e una destinazione operativa per ogni output. Senza queste proprietà, più prove producono soltanto una versione più rifinita di un'ipotesi non verificata.
digna offre data observability all'interno del vostro ambiente per anomalie, validazione, modifiche dello schema, metriche di business e tempestività, dando ai team un luogo in cui collegare gli output delle simulazioni ai segnali di monitoraggio che già gestiscono. Visitate digna per vedere come previsioni probabilistiche e controlli di qualità dei dati possono integrarsi in un flusso di lavoro di affidabilità in produzione.
Domande frequenti
A quale domanda operativa risponde la simulazione per un job notturno?
Non al tempo medio di completamento. Se il job deve arrivare entro le 06:00, la domanda utile è quale quota delle esecuzioni plausibili termina in ritardo, e il campionamento casuale ripetuto risponde a questa domanda laddove una previsione deterministica offre solo un singolo orario previsto.
Come si scelgono le distribuzioni per input reali?
Partendo dalla telemetria, non da un menu a tendina. Iniziate dal comportamento osservato di ciascun input, dalla sua dispersione, dalle sue code e dalla sua stagionalità, poi scegliete una distribuzione che riproduca quel comportamento anziché una comoda da parametrizzare.
Quando è stato automatizzato per la prima volta il metodo?
Il metodo moderno nacque a Los Alamos a metà degli anni Quaranta e fu automatizzato completamente per la prima volta su un computer ENIAC nella primavera del 1948. Stanisław Ulam è indicato come l'inventore della versione moderna, mentre John von Neumann e Nicholas Metropolis svilupparono i primi calcoli computerizzati.
Cosa rende affidabile una simulazione in produzione?
Il fatto che tre elementi siano visibili contemporaneamente: le ipotesi sugli input, il comportamento di convergenza e la decisione operativa che supporta. Una simulazione che ne nasconde anche solo uno produce un numero che nessuno può mettere in discussione né utilizzare con fiducia.
Perché l'origine del metodo è importante?
Perché spiega perché è adatto. Il Monte Carlo è stato creato per sistemi troppo complessi per un calcolo diretto, che è esattamente la situazione di una pipeline multi-fase con un comportamento a monte variabile, e non quella di un problema che ha già una risposta analitica pulita.


