Test di integrità del database: guida pratica per il 2026
|
7
min di lettura

Una pipeline può essere tecnicamente verde e produrre comunque una dashboard finanziaria di cui nessuno si fida. I job terminano, i test passano e le righe ci sono, ma il libro contabile non quadra con il dato dei ricavi sullo schermo. È proprio in questo divario che i test di integrità del database dimostrano il loro valore, perché verificano se i dati sono ancora corretti dopo archiviazione, join, migrazioni, trasformazioni e il passare del tempo.
Indice
Che cosa significano davvero i test di integrità del database
Le cinque dimensioni che ogni test di integrità deve coprire
Progettare test case di integrità che mettono alla prova il sistema
Quando test verdi lasciano passare dati errati
L'alert è arrivato dalla finanza, non dall'engineering. Una dashboard mostrava un dato di ricavo che non corrispondeva al libro contabile, eppure ogni controllo della pipeline era passato e il data warehouse sembrava sano, almeno sulla carta. Un analytics engineer ha ripercorso il flusso attraverso staging, trasformazioni e livelli di reporting, per poi scoprire una verità scomoda: il database non presentava alcuna violazione evidente di integrità, eppure la risposta di business era comunque sbagliata.
È questa la trappola dei controlli ordinari. I conteggi delle righe possono sembrare corretti, un DAG può diventare verde e un semplice test di freshness può passare mentre una relazione di foreign key è rotta, un backfill ha introdotto una chiave duplicata o una trasformazione ha modificato i totali storici. Nella pratica l'integrità dipende dalla strategia di validazione costruita attorno al database, non dalla semplice presenza del database, e il mutation testing ha mostrato quanto possa essere ampio questo divario: in un'analisi del 2015 i criteri di copertura più deboli eliminavano solo il 12% dei mutanti, mentre quelli più forti arrivavano fino al 96% (McMinn 2015).
Un modo più chiaro di inquadrare il problema è la distinzione tra qualità dei dati e integrità dei dati, che il team di digna considera aspetti correlati ma non identici.
Perché merita una disciplina a sé
I test di integrità del database si affiancano al lavoro generale sulla qualità dei dati. Verificano che i record restino accurati, coerenti, validi e non corrotti mentre vengono archiviati e modificati, e richiedono test negativi che cercano di violare le regole invece di confermare soltanto il percorso ideale. Questo conta perché un sistema può essere popolato, interrogabile e comunque sbagliato.
Le linee guida di settore inquadrano oggi l'integrità attorno a cinque dimensioni fondamentali: accuratezza, completezza, coerenza, tempestività e validità (Matillion). Lo stesso concetto compare nelle linee guida di IBM sui test di integrità dei dati, che sottolineano l'importanza di verificare se il database applica le regole attese in fase di archiviazione e di recupero. Questo modello è utile perché allontana i team da una logica binaria di superato o fallito e li orienta verso controlli a più livelli, coerenti con il modo in cui falliscono i moderni warehouse, data lake e pipeline.
Che cosa significano davvero i test di integrità del database

Un database può sembrare sano in superficie e contenere comunque record errati. I test di integrità del database verificano che i dati restino corretti e non corrotti mentre vengono archiviati, recuperati, replicati e trasformati, e che il database applichi le regole da cui il sistema dipende. Si collocano al confine tra l'enforcement dello schema e il comportamento a runtime, quindi la superficie di test deve coprire entrambi.
Un semplice sistema di clienti e ordini rende subito l'idea. Ogni ordine deve fare riferimento a un cliente reale, ogni identificativo cliente deve restare univoco e campi come lo stato dell'ordine o la quantità devono rimanere entro l'insieme di valori consentiti. Se una di queste promesse viene meno, il database può comunque accettare la riga, a meno che la regola non sia stata codificata e testata.
I tipi classici di integrità
Integrità di entità significa che ogni riga ha un identificativo univoco e non nullo. Una primary key deve svolgere il suo compito, altrimenti i record iniziano a confondersi tra loro e i join a valle diventano inaffidabili.
Integrità referenziale significa che le righe figlie puntano a righe padre reali. Se un ordine fa riferimento a un cliente che non esiste, il sistema crea un record orfano e il reporting può iniziare a contare o classificare i record in modo errato.
Integrità di dominio mantiene i valori entro l'intervallo, il tipo o l'elenco consentito. Può trattarsi di un vincolo CHECK, di un tipo di dato o di una regola che blocca codici di stato non validi prima che si diffondano.
Integrità semantica è il livello di business che lo schema da solo non riesce a esprimere. Un valore updated_at non dovrebbe essere precedente a created_at e un ordine non dovrebbe risultare pagato se la tabella dei pagamenti non mostra alcuna transazione.
Regola pratica: se un vincolo di schema può esprimere la regola, testate direttamente il vincolo. Se la regola appartiene alla logica di business, testate il comportamento che la dimostra.
È in questa separazione tra controlli strutturali e controlli di qualità più ampi che la distinzione tra qualità dei dati e integrità dei dati diventa utile, perché chiarisce quali errori appartengono al database stesso e quali alla pipeline o alla logica applicativa circostante.
Le cinque dimensioni che ogni test di integrità deve coprire

Una tabella può superare i vincoli di base e portare comunque a decisioni sbagliate. La riga esiste, il tipo è corretto e il join funziona, eppure il numero può essere obsoleto, incompleto o contraddetto da un altro sistema. Ecco perché i test di integrità devono andare oltre primary key e foreign key: devono verificare i modi specifici in cui i dati possono sembrare validi pur restando inaffidabili.
Il modello a cinque dimensioni aiuta i team a non concentrarsi su un'unica modalità di errore. Ogni tabella critica dovrebbe essere associata alla dimensione che ha più probabilità di cedere, perché il test giusto per una chiave cliente non è quello giusto per uno snapshot dei ricavi. I vincoli classici intercettano le violazioni strutturali, mentre i controlli continui rilevano cambiamenti di comportamento, freshness e allineamento tra sistemi. Per le modifiche di schema che alterano queste regole, leggete anche lo schema drift e perché le modifiche strutturali rompono le pipeline.
Che cosa intercetta ciascuna dimensione
Accuratezza: il valore è giusto? Un totale dei ricavi può essere sbagliato anche quando la riga è presente e il tipo è corretto, quindi il test deve confrontare l'output con il calcolo atteso o con la fonte di verità.
Completezza: i record o i campi attesi sono presenti? Un mese di transazioni mancante è un errore diverso da un valore errato e di solito richiede controlli sui conteggi, sulla presenza o a livello di partizione. Se un job di ingestion perde una porzione di dati, la completezza è il primo punto in cui quel vuoto dovrebbe emergere.
Coerenza: cerca contraddizioni tra sistemi o livelli. Un cliente attivo in una tabella e chiuso in un'altra è il segnale che il modello ha subito una deriva, e la discrepanza può emergere solo confrontando le due tabelle fianco a fianco.
Tempestività: verifica la freshness. Un caricamento che arriva alle 23:55 ma viene considerato attuale alle 9:00 dovrebbe far fallire una regola di tempestività, anche se ogni riga è valida. La freshness conta perché dati in ritardo possono essere accurati e comunque fuorviare chi li legge come attuali.
Validità: i dati rispettano il formato o l'insieme di regole consentito? Rientrano qui indirizzi email malformati, valori di stato impossibili e date errate, oltre a qualsiasi campo che violi le regole di business associate al suo tipo.
Una buona abitudine è scrivere i test in funzione della modalità di errore, non della comodità SQL. Se una tabella contiene date, conteggi, identificativi cliente e stati di business, una query può confermare una parte del quadro, ma raramente dimostra tutte e cinque le dimensioni insieme. L'approccio più pulito è decidere che cosa può fallire e poi scegliere il controllo che renderebbe evidente quell'errore nel modo più diretto.
Indicazione operativa: una suite di test verde che controlla solo la completezza può comunque non accorgersi di un calcolo dei ricavi errato, di un batch obsoleto o di un record valido di per sé ma incoerente con il resto del modello.
Per questo le cinque dimensioni sono diventate uno standard di riferimento per la governance aziendale nei contesti regolamentati, soprattutto dove auditabilità e freshness contano quanto la correttezza.
Progettare test case di integrità che mettono alla prova il sistema
I migliori test di integrità non celebrano il percorso ideale: cercano di far fallire il modello. Se una regola esiste davvero, il test dovrebbe poterla violare di proposito e dimostrare che il database rifiuta l'input errato o rende visibile il comportamento difettoso. È così che si scoprono i casi in cui una migrazione ha eliminato un vincolo o un refactoring ETL ha smesso di applicare una logica.
Casi negativi che smascherano controlli deboli
Una primary key duplicata dovrebbe fallire immediatamente se l'integrità di entità è reale. Una riga figlia orfana dovrebbe fallire se l'integrità referenziale è applicata. Un valore enum non valido, una riga figlia inserita prima del padre o una quantità negativa in una tabella che non dovrebbe mai accettarla indicano se la regola esiste nel database o solo nella documentazione.
Lo stesso approccio vale per i controlli semantici. Un ordine pagato senza alcuna transazione di pagamento dovrebbe far fallire una query di validazione. Lo stesso vale per una riga in cui updated_at è precedente a created_at. Sono questi i test che intercettano problemi silenziosi dopo un rilascio, soprattutto quando il database “sembra a posto”.
Test case di integrità comuni e cosa intercettano
Test case | Tipo di integrità | Cosa intercetta | Asserzione di esempio |
|---|---|---|---|
Inserimento di primary key duplicata | Entità | Mancata applicazione dell'univocità | Fallisce se la chiave duplicata viene accettata |
Riga figlia orfana | Referenziale | Relazione padre-figlio interrotta | Fallisce se la riga figlia non ha un padre |
Enum o stato non valido | Dominio | Vincoli deboli sui valori | Fallisce se viene memorizzato un valore non consentito |
Inserimento della riga figlia prima del padre | Referenziale | Mancato controllo della sequenza | Fallisce se la regola FK viene aggirata |
Ordine pagato senza riga di pagamento | Semantica | Processo di business interrotto | Fallisce se lo stato del pagamento è incoerente |
Quantità negativa | Dominio | Valori di business impossibili | Fallisce se viene memorizzato un valore negativo |
| Semantica | Logica del ciclo di vita errata | Fallisce se i timestamp violano l'ordinamento |
Per una visione a livello di schema su come spesso nascono questi errori, l'approfondimento su lo schema drift spiegato è un utile complemento. La deriva strutturale può indebolire i vincoli e il sintomo può non manifestarsi finché un controllo a valle non confronta il comportamento atteso con quello effettivo del database.
Il linguaggio delle asserzioni deve essere diretto. “ID cliente duplicato accettato”, “trovata riga d'ordine orfana” e “lo stato del pagamento non corrisponde ai record delle transazioni” sono messaggi migliori di un generico superato/fallito, perché indicano al prossimo ingegnere esattamente che cosa si è rotto.
Un pattern utile è affiancare a questi errori puntuali le stesse regole monitorate nel database nel tempo. Il test statico dimostra che il vincolo esiste. L'observability continua mostra se i dati reali continuano a toccare i casi limite che contano, come la creazione ripetuta di record orfani dopo un deployment o un campo di stato che si allontana dall'insieme consentito. Questa combinazione offre sia il guardrail sia la spia di allarme.
Se cercate una piattaforma che esprima questi controlli all'interno del database invece di esportare i dati per validarli, digna è un'opzione tra le altre. La sua validazione basata su regole e il modello di esecuzione in-database si adattano a questo stile di test, il cui obiettivo è intercettare le relazioni interrotte là dove i dati risiedono già.
Integrare i test di integrità in CI/CD e nelle migrazioni
Una modifica di schema rilasciata senza rieseguire i controlli di integrità crea un punto cieco, ed è di solito da lì che passano i dati errati. Un processo di rilascio affidabile mantiene insieme migrazioni e asserzioni di integrità, così le regole che proteggono chiavi, relazioni e valori consentiti viaggiano con il codice che le modifica.
Come dovrebbe essere il flusso di rilascio
Si parte dal version control. Uno sviluppatore modifica lo schema, la logica di trasformazione o una regola di business, e la pipeline CI esegue unit test e test di integrità su un database clonato. La migrazione andrebbe applicata in due ambienti, un database vuoto e uno popolato, perché una modifica che funziona su tabelle vuote può comunque fallire in presenza di righe reali, foreign key e casi limite.
Dopo il deployment, eseguite di nuovo le stesse asserzioni. Questo secondo passaggio è importante perché una migrazione può essere applicata senza errori e modificare comunque il comportamento dei vincoli, i piani di esecuzione delle query o gli esiti della validazione. I team devono inoltre decidere in anticipo se la migrazione è reversibile o se viene formalmente accettata come irreversibile, invece di lasciare aperta la questione dopo il rilascio (bug0).
Il ruolo degli strumenti
Framework come pgTAP per PostgreSQL e tSQLt per SQL Server consentono ai team di esprimere i controlli di integrità come codice, rendendoli revisionabili e ripetibili. La validazione a livello di query rientra nello stesso workflow, soprattutto per i percorsi critici, e EXPLAIN ANALYZE può far emergere regressioni di performance prima che una modifica raggiunga il reporting o le analytics a valle. La stessa disciplina si ritrova nella validazione dei dati enterprise all'interno del database, dove i controlli restano vicini alle tabelle che proteggono.
Gli snapshot di produzione sono un altro pattern efficace. Permettono di verificare che una modifica si comporti allo stesso modo su dati con la forma di quelli reali, senza toccare il sistema in produzione. Questo conta quando una tabella è grande, critica per il business o regolamentata, perché il comportamento su tabelle di test vuote può nascondere problemi che emergono solo su larga scala o con i record storici.
Così come l'anomaly detection per i concessionari osserva variazioni insolite di comportamento nel tempo, i test di integrità in-database individuano regole che sulla carta passano ancora ma falliscono di fronte al movimento reale dei dati. Le asserzioni statiche intercettano il vincolo rotto. I controlli al rilascio e dopo il rilascio mostrano se la migrazione mantiene il database affidabile una volta che il nuovo codice è in funzione.
Dai test puntuali all'observability continua dell'integrità
Una suite di test può passare e la dashboard può comunque essere sbagliata. Succede di solito quando il problema non è un vincolo rotto, ma una deriva nel tempo, una consegna in ritardo, una modifica di schema o una trasformazione che ha cambiato lo storico senza provocare un errore bloccante. L'observability continua dell'integrità colma il vuoto lasciato dalla validazione una tantum.
Perché i test statici non bastano
I test di integrità tradizionali sono efficaci nell'intercettare violazioni esplicite, come righe orfane o valori non validi. Sono più deboli quando la pipeline cambia lentamente, perché l'output corretto di ieri può diventare la risposta sbagliata di oggi senza alcun singolo evento di errore. Rielaborazioni, backfill e refactoring sono fonti comuni di questo tipo di rottura silenziosa, e le linee guida pubbliche la trattano sempre più come un problema operativo distinto anziché come un puro problema di database (Soda).
Per questo i team aggiungono anomaly detection, tracciamento delle modifiche di schema e monitoraggio dei pattern di consegna sopra i controlli deterministici. Questi segnali aiutano a vedere la forma dei dati, non solo se violano una regola. Se una tabella di solito arriva a una certa ora e inizia ad arrivare più tardi, o se una metrica cambia in modo incoerente con il comportamento precedente, l'alert deve arrivare prima che un utente di business apra la dashboard.
Come l'observability estende l'integrità
Una configurazione efficace osserva tre aspetti insieme. Primo, la validazione a livello di record dimostra che le regole rigide sono ancora rispettate. Secondo, il monitoraggio della tempestività segnala caricamenti in ritardo o mancanti in base ai pattern di consegna attesi. Terzo, il tracciamento dello schema intercetta le modifiche strutturali prima che i job a valle falliscano per una colonna rinominata o un cambio di tipo inaspettati.
Un riferimento complementare utile è l'anomaly detection per i concessionari, perché mostra come un rilevamento basato su baseline possa far emergere comportamenti insoliti senza costringere ogni team a scrivere a mano una regola per ogni caso limite.
Regola pratica: se un controllo vi dice solo che sono arrivati dati errati, aggiungete un segnale di observability che vi dica quando il sistema ha iniziato a scivolare verso dati errati.
L'observability continua non sostituisce i test di integrità. Intercetta gli errori che i test non possono prevedere, soprattutto nelle pipeline che rielaborano lo storico o dipendono da sistemi a monte che non controllate.
Misurare copertura, SLA e ROI reale
Più test non significano automaticamente più protezione. Un lungo elenco di controlli può fare colpo e non coprire comunque le tabelle più importanti. La domanda giusta è se la suite di test copre i dati che possono danneggiare il business quando si rompono.
La copertura deve seguire il rischio
Le tabelle critiche meritano una copertura più profonda rispetto ai dati di riferimento, e le pipeline sensibili alle modifiche meritano più attenzione di quelle stabili. Modelli a valle, dataset regolamentari e tabelle di KPI sono in cima alla lista, perché righe mancanti, caricamenti in ritardo o join interrotti possono distorcere il reporting e le evidenze di compliance. Molte guide pubbliche parlano di documentazione e audit, ma raramente definiscono che cosa significhi una “buona copertura” in un ambiente misto di warehouse, data lake e pipeline (VirtuosoQA).
Definite SLA coerenti con il ruolo dei dati. Se un dataset alimenta il reporting del mattino, il team ha bisogno di un requisito di freshness più stringente rispetto a un archivio batch. Se uno schema cambia spesso, il controllo che conta non è quanti check esistono, ma se la modifica è stata intercettata prima che gli utenti ne subissero l'impatto.
Una mentalità orientata alla riduzione del rischio
I test di integrità sono un programma di riduzione del rischio, non una gara al numero di test.
Questa impostazione rende più facile giustificare l'investimento negli ambienti regolamentati, dove il costo di una riga mancante, di un caricamento in ritardo o di un KPI corrotto può tradursi in attriti in fase di audit, decisioni sbagliate o rilavorazioni tra analytics e operations. Il ROI deriva dalla prevenzione di questi errori, non dalla ricerca di una validazione esaustiva su ogni tabella.
Un modo pratico per iniziare è classificare i dataset in base alle conseguenze per il business e assegnare di conseguenza la profondità del monitoraggio. Si ottiene così un equilibrio migliore rispetto al tentativo di testare tutto allo stesso modo.
Mettere tutto insieme in uno stack dati affidabile
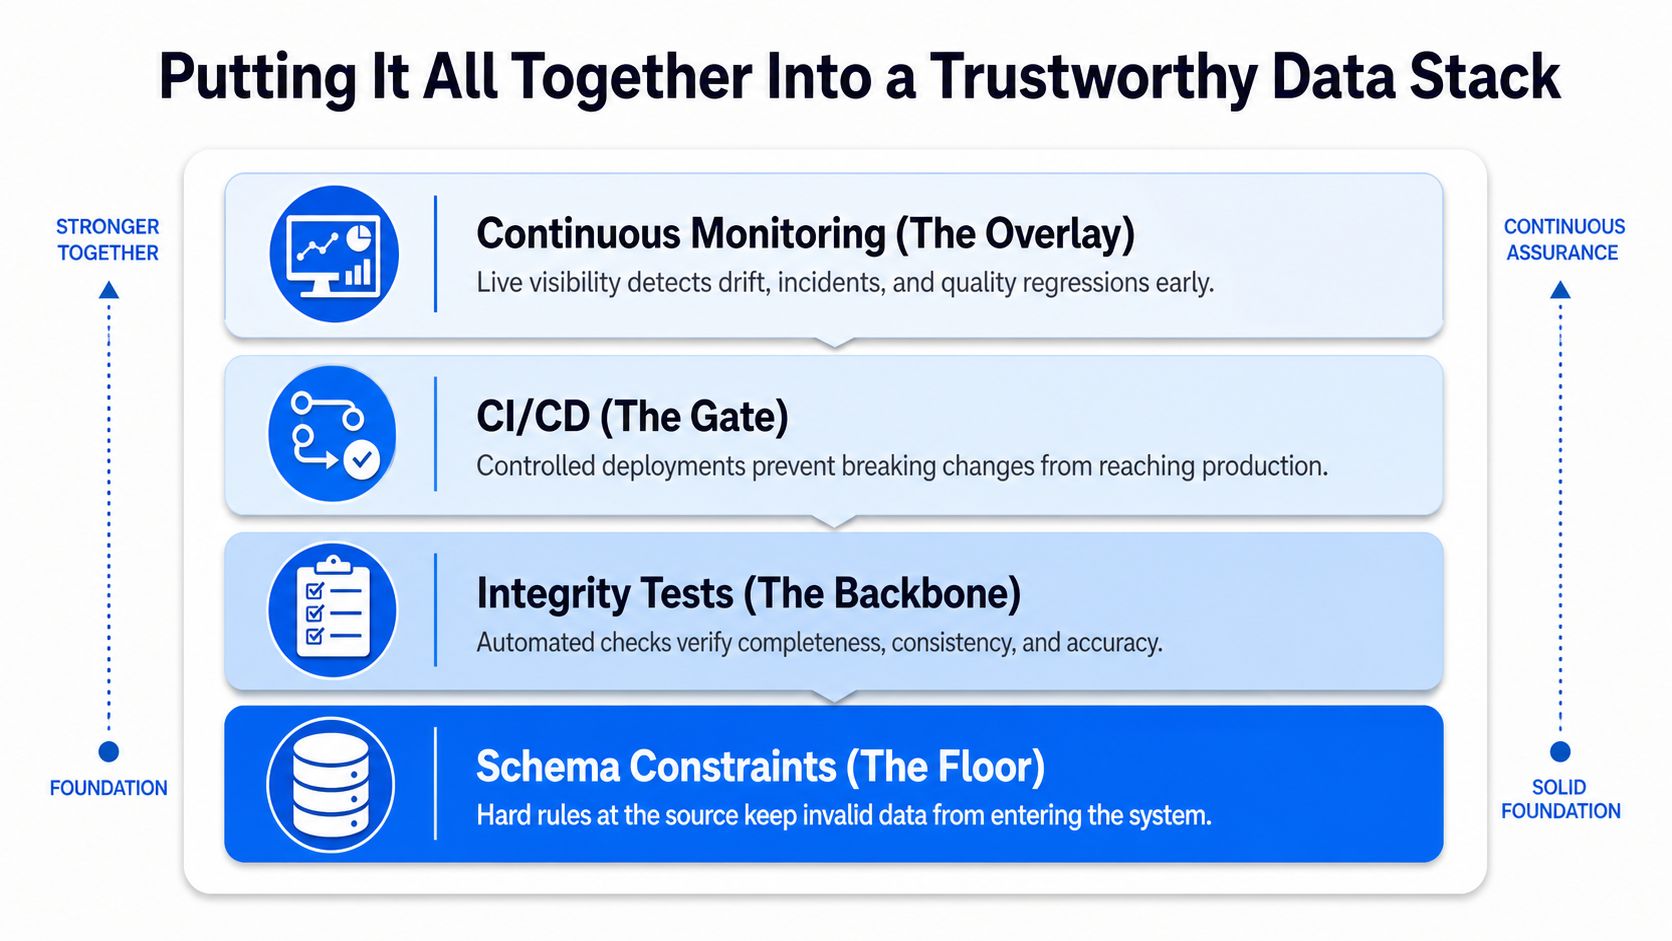
Uno stack affidabile è fatto di livelli, e ogni livello risolve un tipo diverso di errore. I vincoli di schema sono la base: bloccano le violazioni evidenti al confine del database. I test di integrità sono la spina dorsale: dimostrano che le regole funzionano ancora dopo modifiche al codice, caricamenti e migrazioni. La CI/CD è il cancello di rilascio: blocca le modifiche che violerebbero quelle regole. Il monitoraggio continuo è il livello superiore: osserva derive, ritardi e modifiche strutturali dopo il deployment.
Un modello operativo semplice
Al confine del warehouse o del data lake, i vincoli tengono fuori i record non validi. All'interno della pipeline, i test case verificano l'integrità di entità, referenziale, di dominio e semantica prima che i dati raggiungano i consumatori. Nel release management, migrazioni e asserzioni si muovono insieme, così il team può dimostrare che una modifica non ha alterato il comportamento. Dopo il rilascio, l'observability monitora il sistema in produzione alla ricerca di arrivi in ritardo, schema drift e anomalie statistiche.
Questo approccio a livelli si adatta bene anche alla governance. Eseguire i controlli in-database mantiene i dati dove si trovano, il che favorisce la sicurezza e riduce i movimenti inutili. Combinare la validazione deterministica con il monitoraggio comportamentale è ciò che consente ai team di intercettare sia le violazioni rigide sia le derive silenziose.
Un data team esperto può riassumere il modello in una frase. I test di integrità del database non sono un singolo strumento, ma un programma a più livelli che unisce la disciplina classica dei database alla moderna observability, affinché i consumatori a valle possano fidarsi dei dati.
Se volete costruire questo modello a livelli nel vostro ambiente, digna offre validazione in-database, tracciamento dello schema, monitoraggio della tempestività e anomaly detection su warehouse, data lake e pipeline. Visitate digna per vedere come questi controlli possono integrarsi nel vostro stack dati e supportare i controlli di integrità di cui il vostro team ha bisogno.
Per eseguire i controlli di entità, referenziali e semantici descritti sopra come regole all'interno del vostro database, invece di esportare i dati per validarli, scoprite come digna Data Validation applica le regole di business a livello di record là dove i dati risiedono già.
Per la parte referenziale di questi test, la query centrale è un anti-join che restituisce le righe figlie prive di padre. Trattiamo i pattern, la trappola di NOT IN e le chiavi composite in come trovare i record orfani con SQL.
Domande frequenti
Che cosa sono i test di integrità del database?
I test di integrità del database verificano che i dati restino corretti e non corrotti mentre vengono archiviati, recuperati, replicati e trasformati, e che il database applichi le regole da cui il sistema dipende. A differenza dei controlli sul percorso ideale, si basano su test negativi che cercano deliberatamente di violare le regole, ad esempio inserendo una riga d'ordine orfana.
Quali sono i principali tipi di integrità dei dati da testare?
L'articolo tratta quattro tipi classici. L'integrità di entità richiede identificativi univoci e non nulli; l'integrità referenziale garantisce che le righe figlie puntino a righe padre reali; l'integrità di dominio mantiene i valori entro intervalli o elenchi consentiti; l'integrità semantica copre la logica di business, ad esempio che updated_at non sia mai precedente a created_at.
Perché i dati possono essere errati anche quando tutti i test della pipeline passano?
I test verdi spesso coprono solo una parte del quadro. Conteggi delle righe e freshness possono passare mentre una foreign key è rotta, un backfill ha introdotto chiavi duplicate o una trasformazione ha modificato i totali storici. Un'analisi di mutation testing del 2015 ha rilevato che i criteri di copertura più deboli eliminavano solo il 12% dei mutanti, contro un massimo del 96%.
Come si aggiungono i test di integrità a CI/CD e alle migrazioni del database?
Mantenete insieme migrazioni e asserzioni di integrità. La CI dovrebbe eseguire unit test e test di integrità su un database clonato, applicando la migrazione sia a un database vuoto sia a uno popolato, e rieseguire le stesse asserzioni dopo il deployment. Framework come pgTAP per PostgreSQL e tSQLt per SQL Server esprimono questi controlli come codice.
I test di integrità bastano o serve anche la data observability?
I test statici intercettano le violazioni esplicite ma non le derive lente causate da backfill, rielaborazioni e refactoring. L'articolo raccomanda di aggiungere tre segnali continui: validazione a livello di record per dimostrare che le regole rigide sono ancora rispettate, monitoraggio della tempestività per caricamenti in ritardo o mancanti, e tracciamento dello schema per intercettare ridenominazioni o cambi di tipo prima che i job a valle falliscano.


