8 tecniche di data scrubbing fondamentali per dati affidabili
|
7
min di lettura

La presentazione per il consiglio di amministrazione è in scadenza, la dashboard sembra “a posto” e, a prima vista, l'output del modello non pare assurdo. Poi un campo obsoleto, una modifica silenziosa allo schema o un caricamento duplicato stravolgono l'intera storia. È questa la realtà che sta dietro alle tecniche di data scrubbing oggi: devono intercettare i problemi prima che si diffondano, non dopo che qualcuno si accorge di un report rotto. Gli script di pulizia tradizionali contano ancora, ma non scalano bene quando i dati si muovono velocemente, le sorgenti cambiano spesso e i team hanno bisogno di verificabilità tanto quanto di accuratezza. Una moderna piattaforma di observability come digna rende concreto questo cambiamento, abbinando l'automazione a controlli in-database e a un monitoraggio continuo.
Per un utile inquadramento sul perché oggi i team costruiscano attorno a flussi di dati osservabili e controllati, si veda questa discussione sul perché scegliere un'API di web scraping. La stessa logica vale una volta che i dati arrivano nel vostro stack, perché l'affidabilità dipende da ciò che potete verificare, tracciare e riprodurre.
Indice
1. Anomaly detection basata sull'AI con apprendimento statistico della baseline
1. Anomaly detection basata sull'AI con apprendimento statistico della baseline
3. Validazione dei dati a livello di record con applicazione delle regole di business
5. Monitoraggio della tempestività dei dati e validazione delle consegne attese
5. Monitoraggio della tempestività dei dati e validazione delle consegne attese
7. Data quality observability unificata e analisi trasversale alle dimensioni
7. Data quality observability unificata e analisi trasversale alle dimensioni
8. Monitoraggio della data quality nel rispetto della privacy con deployment on-premises
1. Anomaly detection basata sull'AI con apprendimento statistico della baseline
Un rilevatore di anomalie utile non aspetta che gli analisti definiscano record per record il comportamento normale. Apprende la baseline dai dati stessi, poi sorveglia le variazioni di volume, distribuzione o struttura che escono da quel pattern. Questo conta perché spesso il guasto non è una singola riga errata: è una pipeline che smette di comportarsi come faceva ieri.
Ecco perché l'apprendimento statistico della baseline funziona così bene nelle moderne tecniche di data scrubbing. Una piattaforma può confrontare i pattern attuali con il comportamento storico, far emergere la discontinuità e mantenere il monitoraggio legato allo stesso flusso di dati che ha generato il problema. Per una visione più ampia di come i team collegano il monitoraggio della qualità al reporting, la guida all'analisi dei dati per le PMI canadesi è un utile punto di riferimento.
L'anomaly detection per serie temporali di digna è adatta ai team che hanno bisogno di un monitoraggio continuo anziché di una pulizia una tantum. Un team di e-commerce può individuare un calo improvviso del volume delle transazioni prima della riunione del mattino. Una banca può usare lo stesso approccio per isolare comportamenti sospetti sui conti, mentre un team sanitario può tenere d'occhio distribuzioni insolite delle metriche dei pazienti che meritano un secondo controllo.
Che cosa funziona in produzione
Partite in modo ampio, poi restringete il perimetro. Un'anomaly detection ampia intercetta il segnale che non sapevate di dover cercare, mentre le regole a livello di record gestiscono la logica di business una volta che il pattern è chiaro. Di solito questa suddivisione funziona meglio che cercare di codificare in anticipo ogni caso limite.
Una moderna piattaforma di observability rende questo approccio più facile da mantenere, perché mostra il pattern storico accanto al picco o al calo. I team capiscono più chiaramente se si trovano di fronte a un outlier isolato, a una variazione della distribuzione o a un problema a livello di sorgente che richiede un approfondimento. Il compromesso pratico è semplice: un rilevamento più ampio trova più incognite, mentre regole più restrittive riducono i falsi positivi una volta compresa la modalità di guasto.
Regola pratica: lasciate che la piattaforma impari dai dati storici prima di attivare gli alert in produzione
1. Anomaly detection basata sull'AI con apprendimento statistico della baseline
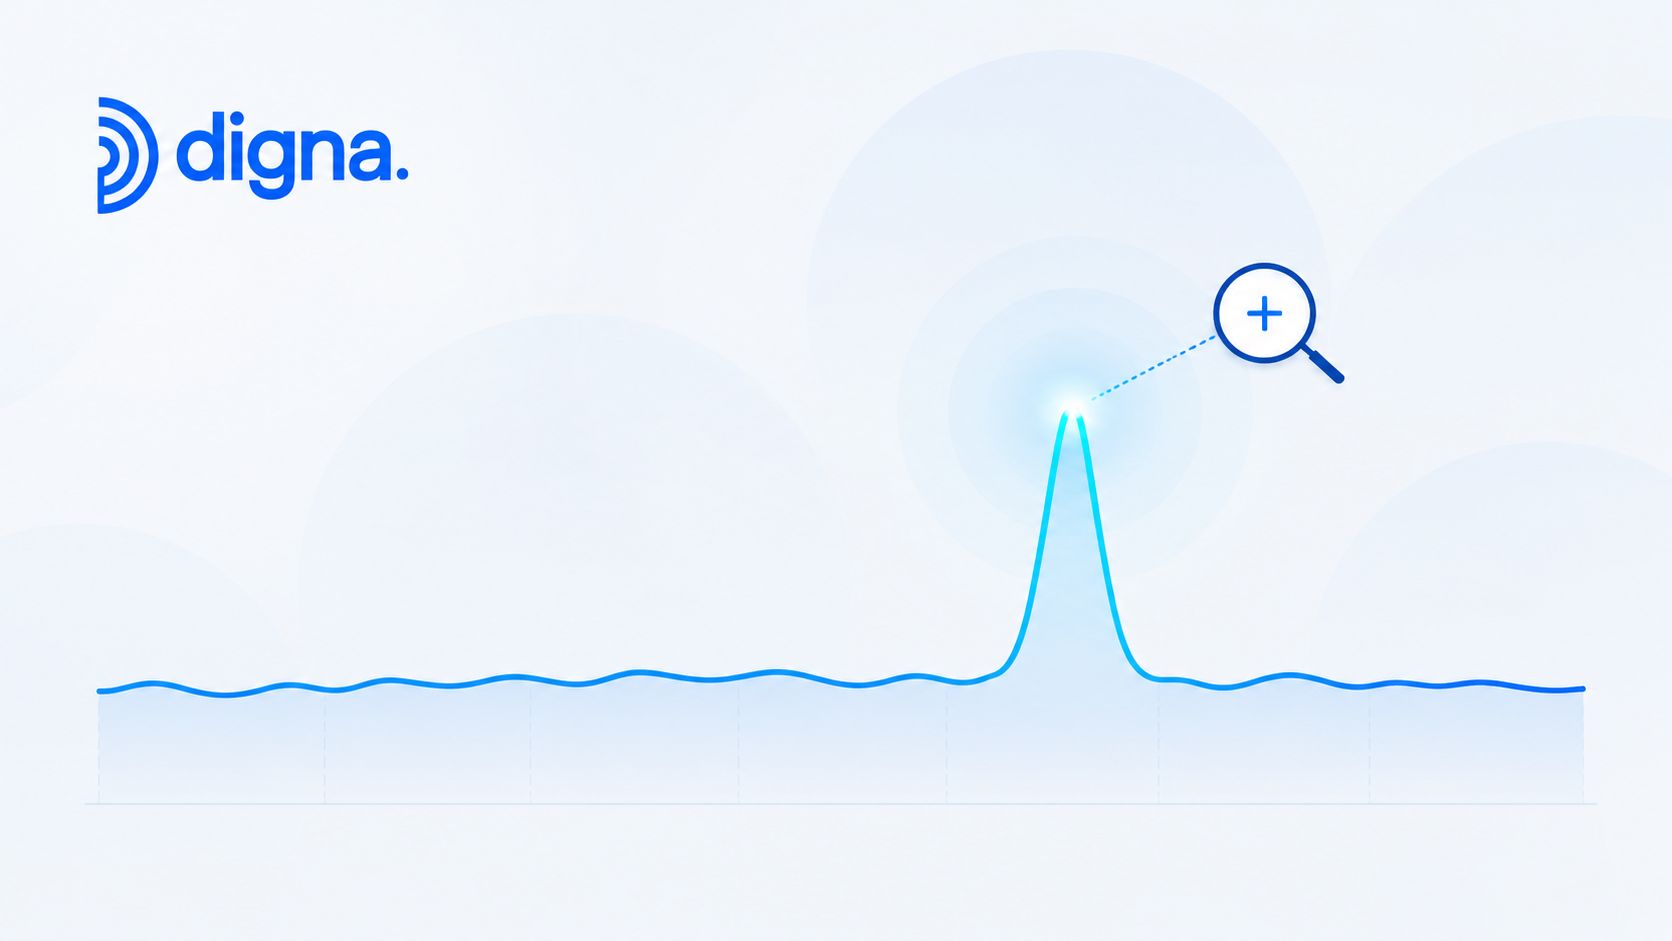
Un buon rilevatore di anomalie non aspetta che siate voi a dirgli, riga per riga, che cosa significhi “normale”. Lo apprende dai dati stessi, poi sorveglia le variazioni di distribuzioni, volumi o struttura che non corrispondono alla baseline. Questo conta perché spesso il guasto non è un record errato isolato: è una pipeline che smette di comportarsi come faceva ieri.
L'anomaly detection per serie temporali di digna è particolarmente adatta quando i team hanno bisogno di un monitoraggio continuo anziché di una pulizia occasionale. Un team di e-commerce può usarla per individuare un calo improvviso del volume delle transazioni prima della riunione del mattino. Una banca può usare lo stesso schema per isolare comportamenti sospetti sui conti, mentre un team sanitario può tenere d'occhio distribuzioni insolite delle metriche dei pazienti che meritano un secondo controllo.
Che cosa funziona in produzione
Partite in modo ampio, poi stringete. Un'anomaly detection ampia intercetta il segnale che non sapevate di dover cercare, mentre le regole a livello di record gestiscono la logica di business una volta che il pattern è chiaro. È una suddivisione migliore rispetto al tentativo di codificare in anticipo ogni caso limite.
Regola pratica: lasciate che la piattaforma impari dai dati storici prima di attivare gli alert in produzione. Senza questo periodo di riscaldamento, passerete troppo tempo a inseguire la normale variabilità.
Le configurazioni più solide abbinano l'anomaly detection al contesto. Se una dashboard segnala un problema, gli analisti devono vedere la linea di tendenza precedente, non solo l'alert. È qui che una piattaforma come digna Data Analytics aiuta, perché mantiene visibile il pattern storico accanto al picco o al calo.
Una piattaforma che mostra insieme la baseline e l'outlier accorcia rapidamente l'analisi della causa principale.
2. Calcolo delle metriche e scrubbing in-database

Spostare dati sensibili in un altro sistema solo per esaminarli crea rischi evitabili e ulteriore lavoro operativo. Lo scrubbing in-database mantiene l'analisi vicina alla sorgente, così i dati restano all'interno dell'ambiente controllato dal cliente mentre i controlli di completezza, la validazione della coerenza e la profilazione continuano a funzionare su larga scala. Questo approccio è in linea con il principio di qualità più generale secondo cui lo scrubbing consiste nel correggere record inaccurati, incompleti, incoerenti, duplicati o corrotti e nel validare poi il risultato rispetto alle regole di business e ai requisiti di tracciabilità, come descritto nelle linee guida dell'IOM sui dati disordinati e nei relativi consigli operativi della panoramica di Acceldata sul data scrubbing e nel documento dell'IOM su pulizia dei dati e dati disordinati.
Questo è importante per i team regolamentati. Un istituto finanziario europeo può eseguire lo scrubbing richiesto dalla normativa senza esportare record. Un fornitore di servizi sanitari può validare i dati dei pazienti senza spostare campi sensibili in un servizio separato. Un team telco può analizzare i call detail record mantenendo intatta la sovranità dei dati.
Dove collocare il lavoro
Il timing sul database conta più di quanto i team ammettano. Eseguite i job di scrubbing più pesanti nelle ore di minor carico, monitorate attentamente l'utilizzo delle risorse del database e usate il partizionamento dove riduce il costo delle scansioni. Se la piattaforma può mantenere il calcolo delle metriche in-database, evitate che una seconda copia della verità si allontani dalla prima.
Regola pratica: non pianificate lo scrubbing in momenti in cui entra in competizione con le vostre query di produzione più costose.
L'approccio di digna come piattaforma di data quality in-database è utile quando servono anomaly detection e validazione nello stesso percorso di esecuzione. In questo modo i dati sensibili restano dove sono, gli spostamenti si riducono e l'impronta operativa è più facile da spiegare ai team di sicurezza e compliance.
3. Validazione dei dati a livello di record con applicazione delle regole di business
A volte il problema non è nascosto in una tendenza. Si trova in un singolo record che viola una regola che il business conosce già. Controlli di intervallo, controlli di formato, logica tra campi e controlli di integrità referenziale fermano le righe errate prima che contaminino il reporting a valle o le feature dei modelli.
La guida alla pulizia dei dati della Stony Brook offre esempi pratici facili da trasformare in validazioni, come date di fine che non possono precedere le date di inizio o campi email che devono contenere una “@” e un dominio. Sono proprio i controlli che intercettano problemi che un generico strumento di rimozione dei duplicati non vedrebbe.
Costruire il set di regole con uno scopo preciso
Iniziate dalle regole che proteggono i ricavi, la conformità o la sicurezza dei pazienti. Nel banking significa validare numeri di conto, importi delle transazioni e dati dei clienti rispetto ai vincoli rilevanti per audit e operations. Nell'e-commerce significa verificare la completezza e la coerenza dei prodotti tra i sistemi di catalogo. Nella sanità significa applicare gli standard delle cartelle cliniche prima che analisti o medici vi facciano affidamento.
Rendete espliciti i livelli di severità. Una regola normativa non rispettata merita un'attenzione più rapida di un problema estetico in un campo descrittivo. Anche il volume delle regole conta, perché se gli alert sono rumorosi i team smettono di fidarsene.
Date priorità alle regole ad alto impatto: partite dai campi che incidono su denaro, sicurezza o conformità.
Documentate chiaramente la responsabilità: assicuratevi che ogni regola abbia un responsabile di business designato e uno scopo.
Rivedete regolarmente le soglie: se un alert scatta troppo spesso, le persone lo ignorano.
digna Data Validation è rilevante in questo contesto perché consente ai team di combinare regole personalizzate con segnali di anomalia, in modo che la logica di business attesa e i comportamenti imprevisti restino visibili nello stesso flusso di lavoro.
5. Monitoraggio della tempestività dei dati e validazione delle consegne attese
Una dashboard può aprirsi senza problemi e comunque trarre in inganno il team se il feed della notte precedente non è mai arrivato. I numeri sembrano normali, i grafici vengono visualizzati e i dati obsoleti finiscono nelle decisioni senza generare un errore evidente. Il monitoraggio della tempestività verifica l'orario di arrivo come parte del data scrubbing, ed è quindi uno strumento concreto per i team che devono sapere se i dati sono abbastanza aggiornati da potersene fidare.
I team del retail se ne accorgono per primi quando i caricamenti giornalieri delle vendite non arrivano in tempo per la riunione del mattino. Gli istituti finanziari lo notano quando i dati di mercato raggiungono i sistemi a valle troppo tardi per i flussi di trading. I team sanitari ci si imbattono quando gli aggiornamenti delle cartelle dei pazienti restano indietro rispetto alla dashboard clinica, anche se il sistema sorgente è già cambiato.
Rendere il ritardo misurabile, non aneddotico
Le finestre di arrivo attese funzionano meglio degli allarmi fissi, perché le pipeline reali hanno un proprio ritmo. Un pattern di consegna appreso mostra come appare di solito una consegna puntuale, mentre un'aspettativa pianificata fornisce al team il limite rigido necessario per l'escalation. Usati insieme, aiutano a distinguere una sorgente sistematicamente in ritardo da una ritardata da un evento insolito.
I caricamenti parziali richiedono la stessa attenzione. Un file può arrivare puntuale ed essere comunque incompleto, quindi l'orario di arrivo da solo non vi dice se il dataset è utilizzabile. L'approccio più solido consiste nel monitorare insieme consegne attese e anomalie di volume, per poi convogliare il risultato nello stesso flusso di observability, così gli operatori possono vedere tempistiche, completezza e comportamento della sorgente fianco a fianco.
Definite SLA chiari: stabilite quando i dati devono arrivare e chi interviene quando non arrivano.
Tenete d'occhio prima i recidivi: concentratevi sulle sorgenti che arrivano spesso in ritardo.
Monitorate le tendenze nel tempo: i pattern storici delle tempistiche mostrano se i ritardi stanno peggiorando o seguono semplicemente un ciclo prevedibile.
Nella pratica, questo funziona meglio all'interno di una moderna piattaforma di observability che tratta la tempistica delle consegne come un segnale monitorato anziché come un alert isolato. digna può combinare i controlli sulle tempistiche con l'anomaly detection e l'elaborazione in-database, così i team non devono mantenere script separati per ogni sorgente.
5. Monitoraggio della tempestività dei dati e validazione delle consegne attese
I dati in ritardo sono subdoli. Il report viene comunque generato, la dashboard si apre comunque e, quando qualcuno si accorge che i numeri sono obsoleti, le decisioni sono già state prese. Il monitoraggio della tempestività si concentra su quando arrivano i dati, non solo su che cosa contengono, ed è per questo una delle tecniche di data scrubbing più pratiche per i team operativi.
I team del retail lo avvertono per primi quando i caricamenti giornalieri delle vendite non arrivano in tempo per la riunione del mattino. Gli istituti finanziari lo avvertono quando i dati di mercato arrivano troppo tardi per i flussi di trading. I team sanitari lo avvertono quando gli aggiornamenti delle cartelle dei pazienti restano indietro rispetto alla dashboard clinica.
Trasformare il ritardo in un segnale monitorato
Le finestre di arrivo attese funzionano meglio degli allarmi fissi, perché le pipeline reali hanno un proprio ritmo. I pattern di consegna appresi mostrano che aspetto ha di solito una consegna “puntuale”, mentre le aspettative pianificate forniscono ai team il limite rigido di cui hanno bisogno per l'escalation. Combinare i due approcci rende più facile distinguere un ritardo insolito da un ritardo abituale che accompagna sempre una certa sorgente.
Usate il volume dei dati insieme all'orario di arrivo. Un caricamento parziale può arrivare puntuale ed essere comunque sbagliato, quindi la sola tempestività non basta mai. Ecco perché le configurazioni più solide monitorano insieme consegne attese e anomalie di volume.
Definite SLA chiari: stabilite quando i dati devono arrivare e chi interviene quando non arrivano.
Tenete d'occhio prima i recidivi: date priorità alle sorgenti che sono spesso in ritardo.
Monitorate le tendenze nel tempo: i pattern storici delle tempistiche rivelano problemi operativi ricorrenti.
digna Timeliness è progettato proprio per questo tipo di monitoraggio, e il suo livello di analytics aiuta i team a capire se i ritardi stanno diventando un pattern o sono solo un evento isolato.
7. Data quality observability unificata e analisi trasversale alle dimensioni
Un file in ritardo, una piccola modifica allo schema e una validazione fallita si presentano spesso come ticket separati. Il problema di fondo è di solito un unico problema condiviso nella pipeline, e i team passano troppo tempo ad abbinare indizi tra strumenti diversi. Un livello di observability unificato riunisce anomaly detection, validazione, tempestività e schema tracking in un'unica vista, così analisti e ingegneri ottengono una visibilità trasversale alle dimensioni senza dover ricostruire la storia a mano.
Questo conta perché i problemi di qualità raramente restano confinati in una sola categoria. Un caricamento in ritardo può arrivare anche con righe mancanti. Una modifica allo schema può far fallire regole in un modo che sembra dovuto a dati errati finché non si esamina il rilascio della sorgente. Un'anomalia può avere senso solo dopo che qualcuno la confronta con lo storico delle consegne, la deriva strutturale e le rotture a valle. Più a lungo questi segnali restano separati, più dura l'analisi della causa principale e più è probabile che venga allertato il team sbagliato.
Una configurazione pratica cambia anche il modo in cui lavorano i diversi team. Gli ingegneri hanno bisogno della sorgente, della tempistica e del controllo fallito. Gli analisti devono sapere se il dataset è ancora affidabile per il reporting. I team di governance hanno bisogno di lineage e di accountability. Un'unica interfaccia può servire tutti e tre quando mostra le relazioni tra i segnali invece di isolare gli alert.
Correlare i segnali prima dell'escalation
Le viste basate sui ruoli aiutano perché ogni gruppo guarda alla qualità dei dati da un'angolazione diversa. Gli ingegneri vogliono la tabella che fallisce e la modifica upstream. Gli analisti vogliono sapere se una metrica è ancora utilizzabile. I team di governance vogliono ricostruire responsabilità e impatto. Una piattaforma costruita in questo modo riduce il continuo rimpallo che di solito segue un incidente di qualità.
Questo approccio si adatta anche a casi d'uso operativi che vanno oltre un singolo dominio. Lo stesso schema aiuta un team di logistica a correlare i ritardi delle spedizioni con gli aggiornamenti di stato mancanti, il tipo di problema discusso in AI nella logistica e nella supply chain. Quando l'observability collega questi segnali, i team passano meno tempo a discutere se stanno vedendo un problema o tre.
Usate un unico livello di monitoraggio: consolidate i controlli sovrapposti quando lo stesso dataset è già osservato da più angolazioni.
Collegate i segnali ai flussi di lavoro: inviate il contesto del problema a cataloghi, sistemi di ticketing e strumenti di governance, così il responsabile successivo ha il quadro completo.
Estendete la copertura gradualmente: partite dalle tabelle a più alto rischio, poi ampliate il perimetro man mano che il modello operativo si consolida.
L'interfaccia unificata di digna è rilevante in questo contesto perché riunisce in un unico posto segnali di anomalia, risultati delle validazioni, schema drift e pattern di consegna. Questo offre ai team una visione operativa più chiara e accorcia il percorso dal sintomo alla correzione a livello di sorgente.
7. Data quality observability unificata e analisi trasversale alle dimensioni
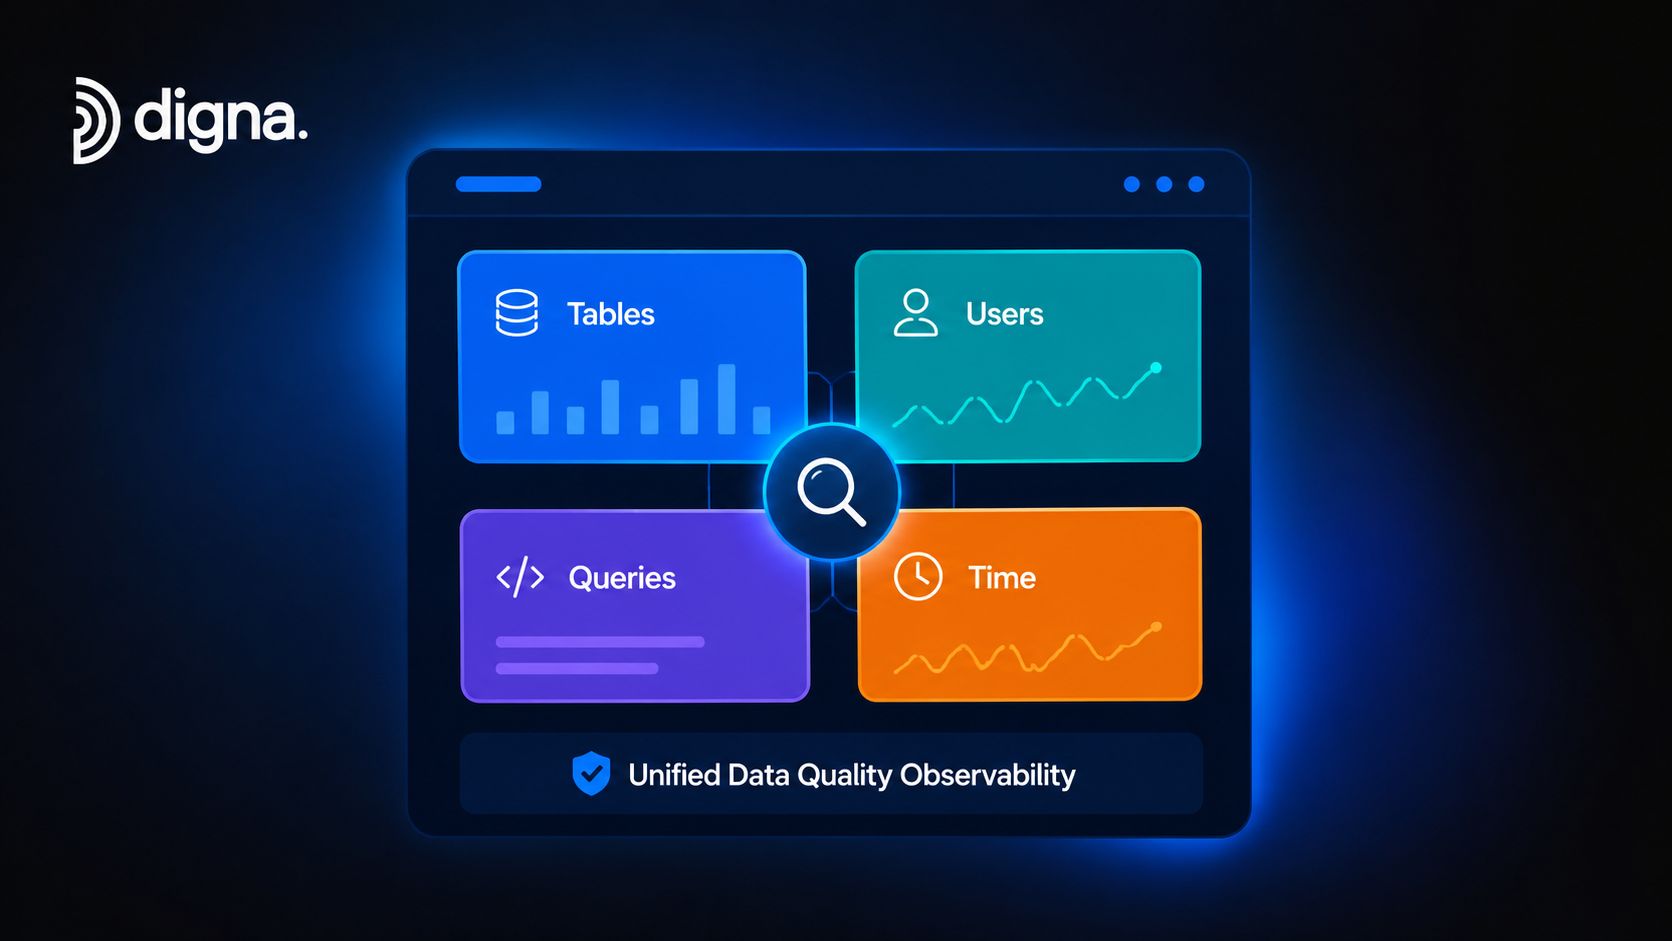
A molti team non mancano i controlli. Manca un unico posto in cui leggerli. Un livello di observability che riunisce anomaly detection, validazione, tempestività e schema tracking in un'unica vista consente di valutare la qualità su più dimensioni senza dover ricucire la storia a mano.
Questo conta nelle operations quotidiane. Un caricamento in ritardo può coincidere con un calo dei volumi. Una modifica allo schema può spiegare perché la validazione ha iniziato a fallire. Spesso un'anomalia ha senso solo dopo averla confrontata con lo storico delle consegne e la deriva strutturale. Se questi segnali si trovano in strumenti separati, l'analisi della causa principale rallenta e viene allertato il team sbagliato.
Correlare i segnali prima dell'escalation
Le viste basate sui ruoli aiutano perché ingegneri, analisti e team di governance raramente hanno bisogno della stessa schermata. Gli ingegneri vogliono la sorgente, la tempistica e il controllo fallito. Gli analisti vogliono sapere se possono fidarsi del dataset. I team di governance vogliono lineage e accountability. Un'unica interfaccia può servire tutti e tre se mostra le relazioni, non solo gli alert.
Una configurazione pratica di solito inizia riducendo le sovrapposizioni. Se la stessa tabella è già monitorata da più angolazioni, consolidate i controlli dove ha senso dal punto di vista operativo. Poi inviate il contesto del problema a cataloghi e strumenti di governance, così il responsabile successivo vede che cosa è successo e dove intervenire. Estendete la copertura partendo dalle tabelle a più alto rischio, poi ampliate il perimetro man mano che il modello operativo si consolida.
L'interfaccia unificata di digna è rilevante in questo contesto perché riunisce in un unico posto anomalie dei dati, validazione, tempestività e segnali sugli schemi. Questo riduce il carico di lavoro legato al passaggio continuo da uno strumento all'altro e rende più rapida la correlazione quando si verifica un problema nella pipeline.
8. Monitoraggio della data quality nel rispetto della privacy con deployment on-premises
Alcuni team non possono permettersi di spostare dati sensibili al di fuori del proprio perimetro controllato, nemmeno per i controlli di qualità. È qui che il monitoraggio nel rispetto della privacy diventa parte della strategia di scrubbing, e non una questione separata. L'obiettivo pratico è mantenere i dati utili per analytics e validazione, preservando la privacy e rispettando i vincoli normativi.
I consigli più diffusi sullo scrubbing si concentrano spesso sull'eliminazione degli errori evidenti, ma questo non risolve il problema più difficile: mantenere utili i dati personali (PII) riducendone l'identificabilità. Metodi orientati alla privacy come la perturbazione e lo scambio di dati (data swapping) sono pensati per preservare la struttura statistica riducendo il rischio, ed è per questo che compaiono più spesso nella letteratura sulla privacy che nelle normali guide alla pulizia dei dati. Questa lacuna è importante negli ambienti regolamentati, dove i team devono sanificare i dati per test, analytics o condivisione senza compromettere i casi d'uso a valle. Per questa prospettiva legata alla privacy, si veda la discussione di mostly.ai sullo scrubbing dei dati PII.
Prima di tutto, controllare l'ambiente
Il deployment on-premises o in private cloud offre la risposta più semplice alle preoccupazioni su residenza dei dati e accessi. Istituti finanziari europei, organizzazioni sanitarie, enti pubblici e multinazionali affrontano tutti varianti dello stesso vincolo: i dati sensibili devono restare dove la policy stabilisce che debbano restare. Questo rende la pianificazione dell'infrastruttura parte integrante della tecnica di scrubbing stessa.
Integrate il monitoraggio con il vostro stack di sicurezza e compliance esistente. I log di audit contano. Le policy di accesso contano. E conta anche la capacità di spiegare dove risiedono i dati e chi può esaminarli.
Pianificate presto il deployment: non aggiungete le decisioni sull'infrastruttura alla fine di una revisione di compliance.
Mantenete i log completi: tracciate accessi, modifiche ed esecuzioni delle validazioni.
Allineatevi alle normative regionali: assicuratevi che la piattaforma corrisponda al modello di protezione dei dati in cui operate.
Il modello di deployment di digna controllato dal cliente si adatta a questo caso d'uso, perché le analisi vengono eseguite all'interno di ambienti private cloud o on-premises, senza alcun accesso del fornitore ai dataset di produzione. È un modo concreto per mantenere insieme scrubbing, validazione e observability senza esporre i record che state cercando di proteggere.
Confronto in 8 punti delle tecniche di data scrubbing
Tecnica | 🔄 Complessità di implementazione | ⚡ Requisiti di risorse | 📊 Risultati attesi | Casi d'uso ideali | ⭐ Vantaggi principali / 💡 Consiglio rapido |
|---|---|---|---|---|---|
Anomaly detection basata sull'AI con apprendimento statistico della baseline | Media–alta, modelli automatizzati, tuning iniziale | Calcolo moderato + dati storici sufficienti | Anomaly detection continua con meno falsi positivi | Cali nell'e‑commerce, rilevamento delle frodi, anomalie nelle metriche sanitarie | ⭐ Si adatta alla stagionalità; intercetta problemi nuovi. 💡 Prevedete 2–4 settimane di dati storici e regolate la sensibilità. |
Calcolo delle metriche e scrubbing in-database | Media, basato su SQL, considerazioni sulla compatibilità con i fornitori | Elevato carico di calcolo sul DB; nessuno spostamento di dati | Scrubbing sicuro e conforme con basso overhead di rete | Settori regolamentati, carichi di lavoro sensibili alla residenza dei dati | ⭐ Mantiene i dati dove sono e sfrutta le ottimizzazioni del DB. 💡 Pianificate i job nelle ore di minor carico e monitorate l'utilizzo del DB. |
Validazione dei dati a livello di record con applicazione delle regole di business | Media, richiede definizione e manutenzione delle regole | Calcolo basso–moderato; overhead di gestione delle regole | Applica la logica di business e blocca i record errati a valle | Validazioni bancarie, integrità del catalogo prodotti, cartelle cliniche | ⭐ Audit trail chiari e conformità. 💡 Partite dalle regole ad alto impatto e classificatele per severità. |
Rilevamento delle modifiche agli schemi e validazione strutturale dei dati | Bassa–media, monitoraggio automatizzato, coordinamento con la governance | Calcolo basso; tracciamento continuo | Rilevamento precoce dello schema drift per prevenire guasti delle pipeline | Data lake, pipeline di analytics, produttori di API | ⭐ Previene rotture a valle e protegge i modelli. 💡 Integrate gli alert nei flussi di governance degli schemi. |
Monitoraggio della tempestività dei dati e validazione delle consegne attese | Bassa–media, configurazione delle pianificazioni e apprendimento dei pattern | Basso–moderato; richiede lo storico degli arrivi | Alert predittivi per caricamenti in ritardo/mancanti, monitoraggio degli SLA | Caricamenti giornalieri nel retail, feed di dati di mercato, aggiornamenti clinici | ⭐ Riduce il tempo di rilevamento dei problemi di freschezza. 💡 Configurate SLA e finestre di avviso; combinateli con controlli sui volumi. |
Analisi dei dati storici e scrubbing basato sulle tendenze | Media–alta, analytics e interpretazione di serie temporali | Storage e calcolo elevati per storici lunghi | Insight contestuali; rileva degradi graduali e tendenze | Capacity planning, analisi della causa principale, monitoraggio della qualità nel lungo periodo | ⭐ Rivela tendenze lente e cause principali. 💡 Esaminate regolarmente i report sulle tendenze e correlateli con gli eventi. |
Data quality observability unificata e analisi trasversale alle dimensioni | Alta, integra più dimensioni e strumenti | Integrazione iniziale onerosa; consolida i costi correnti | Visibilità olistica e risoluzione più rapida delle cause principali su tutte le dimensioni | Governance enterprise, MLOps, observability tra team | ⭐ Elimina la proliferazione di strumenti e correla i segnali. 💡 Configurate dashboard basate sui ruoli ed estendete la copertura gradualmente. |
Monitoraggio della data quality nel rispetto della privacy con deployment on-premises | Alta, deployment on‑premises, responsabilità operativa | Investimento infrastrutturale e manutenzione elevati | Piena conformità e sovranità dei dati con monitoraggio all'interno del proprio ambiente | Ambienti GDPR/HIPAA, pubblica amministrazione, configurazioni air‑gapped | ⭐ Garantisce che i dati non lascino mai il perimetro del cliente. 💡 Pianificate l'infrastruttura e integratela con i sistemi di sicurezza/audit esistenti. |
Automatizzare lo scrubbing, aumentare la fiducia
Un data scrubbing efficace non si basa più su script di pulizia una tantum. Si tratta di costruire un sistema continuo che intercetti le anomalie, applichi le regole, tracci lo schema drift, sorvegli le tempistiche di consegna e preservi la provenienza dei dati, così che i team possano fidarsi di ciò che usano. Le tecniche di data scrubbing più efficaci non si limitano a rimuovere i record errati: rendono la qualità abbastanza visibile da poterla mantenere nel tempo.
È questo il cambiamento che le moderne piattaforme di observability rendono possibile. Con esecuzione in-database, analisi storiche, dashboard unificate e deployment privato, digna offre ai team un modo concreto per tenere sotto controllo i dati sensibili applicando comunque l'automazione su larga scala. Il valore non sta solo in tabelle più pulite, ma in un'analisi della causa principale più rapida, in meno guasti silenziosi e in un legame più stretto tra input grezzi e output affidabili.
Se le vostre dashboard dipendono ancora da controlli manuali a campione o da fragili job di pulizia, è il momento di portare l'observability più vicino alla sorgente. Valutate come digna si inserisce nel vostro data warehouse, data lake o ambiente regolamentato, poi collegate questa settimana un dataset di alto valore a un flusso di scrubbing continuo. Prenotate una demo gratuita su digna.
Per un monitoraggio delle consegne attese che segnali i caricamenti in ritardo o mancanti prima che numeri obsoleti arrivino nella dashboard del mattino, scoprite come digna Timeliness apprende i pattern di arrivo di ogni sorgente.
Domande frequenti
Che cosa sono le tecniche di data scrubbing?
Le tecniche di data scrubbing correggono record inaccurati, incompleti, incoerenti, duplicati o corrotti e validano il risultato rispetto alle regole di business. L'articolo ne illustra otto, tra cui anomaly detection statistica, calcolo delle metriche in-database, validazione a livello di record, rilevamento delle modifiche agli schemi, monitoraggio della tempestività, analisi delle tendenze, observability unificata e monitoraggio on-premises nel rispetto della privacy.
Di quanti dati storici ha bisogno l'anomaly detection?
La tabella di confronto dell'articolo raccomanda di prevedere da due a quattro settimane di dati storici e di regolare poi la sensibilità. Lasciare che la piattaforma apprenda una baseline prima di attivare gli alert in produzione evita ai team di inseguire la normale variabilità, mentre un rilevamento ampio continua a intercettare variazioni di volume, distribuzione o struttura che nessuno aveva previsto.
Quali sono alcuni esempi di regole di validazione dei dati a livello di record?
Le regole tipiche includono controlli di intervallo, controlli di formato, logica tra campi e integrità referenziale. La guida alla pulizia dei dati della Stony Brook offre esempi semplici: una data di fine non può precedere una data di inizio e un campo email deve contenere una @ e un dominio. Le regole che proteggono ricavi, conformità o sicurezza dei pazienti dovrebbero venire per prime.
Perché la tempestività dei dati fa parte del data scrubbing?
I dati in ritardo raramente generano un errore. La dashboard si apre comunque e numeri obsoleti finiscono nelle decisioni, come quando i caricamenti giornalieri delle vendite retail non arrivano in tempo per la riunione del mattino. Il monitoraggio della tempestività combina pattern di consegna appresi con SLA pianificati e abbina l'orario di arrivo ai controlli sui volumi, perché un caricamento parziale può arrivare puntuale.
Il data scrubbing dovrebbe essere eseguito all'interno del database?
Eseguire lo scrubbing in-database mantiene i dati sensibili all'interno dell'ambiente controllato dal cliente ed evita che una seconda copia si discosti dalla prima. L'articolo consiglia di pianificare i job più pesanti nelle ore di minor carico, monitorare l'utilizzo delle risorse del database e usare il partizionamento per ridurre il costo delle scansioni, un approccio adatto a banche regolamentate, strutture sanitarie e operatori telco.