Metrics system table: schema, query e best practice
|
9
min di lettura

Il responsabile di una dashboard apre il report del mattino e scopre che i numeri non cambiano da due giorni. La pipeline risulta verde, il data warehouse è disponibile e nessun job è fallito. Più tardi qualcuno scopre che una colonna a monte ha cambiato tipo, che una trasformazione ha saltato parte del suo input o che l'ultima partizione non è mai arrivata. L'incidente non è stato causato da una dashboard mancante, ma dalla mancanza di evidenze operative.
Una metrics system table fornisce queste evidenze in forma interrogabile. Invece di disperdere i controlli tra notebook, script shell, metadati del data warehouse e strumenti di monitoraggio esterni, i team possono registrare segnali a livello di tabella e di colonna in un unico registro operativo. Questo registro può supportare controlli di freschezza, analisi dei volumi, rilevamento delle modifiche di schema, indagini storiche, flussi di lavoro basati sulla responsabilità e audit trail, senza trasformare ogni indagine in un progetto di ingegneria su misura.
Indice
Perché i data team hanno bisogno di una metrics system table
Il divario pratico tra raccolta e azione
Che cos'è una metrics system table
Perché la separazione è importante
Metadati del fornitore e registro interno controllato
Schema di base e pattern di progettazione delle colonne
Un design di riferimento
Chiavi e percorsi di accesso
Query SQL pratiche per le attività di osservabilità più comuni
Violazioni di freschezza
Anomalie di volume
Schema drift
Strategie di conservazione e aggregazione
Conservazione dei soli dati grezzi
Riepiloghi per intervalli di tempo
Conservazione a livelli
Collegare le metriche ai segnali di freschezza e di schema drift
Correlare i segnali
Una matrice decisionale per una risposta a basso rumore
Quando più metriche riducono l'efficacia dell'osservabilità
Stabilire le priorità in base alle conseguenze
Eliminare i controlli che non cambiano le decisioni
Strumentare le tabelle delle metriche nelle piattaforme enterprise
Un pattern di deployment che regge
Proteggere le prestazioni
Governance e verificabilità nei settori regolamentati
Separare chi scrive da chi legge
Riferimento rapido per la progettazione di una metrics system table
Pattern di query in produzione
Le soglie hanno bisogno di contesto
Perché i data team hanno bisogno di una metrics system table
Di solito un data team si accorge dei problemi di affidabilità attraverso i propri utenti. Un analista segnala che una dashboard dei ricavi non è aggiornata. Un utente del reparto finanza nota una variazione inattesa in un report. Un machine learning engineer scopre che una feature table contiene un tipo sconosciuto o una concentrazione insolita di valori mancanti. A quel punto il sistema ha già mancato il suo scopo operativo, anche se ogni task di orchestrazione è stato completato con successo.
Lo strato mancante è spesso un piccolo insieme di primitive di osservabilità durevoli. Una metrics system table può registrare conteggi di righe, tassi di valori mancanti, comportamento dei valori distinti, timestamp, latenza e impronte dello schema a livello di tabella o di colonna. Questi valori trasformano un cambiamento invisibile in un record che SQL può ispezionare, confrontare, conservare e indirizzare a un responsabile.
La distinzione è importante perché lo stato della pipeline risponde a una sola domanda: il task è stato eseguito? Non dice se i dati sono arrivati in tempo, se il volume in uscita è plausibile, se una colonna critica è cambiata o se un processo aziendale a valle può fidarsi del risultato. Una base di data observability aggiunge questi segnali al quadro operativo.
Il divario pratico tra raccolta e azione
Gli script ad hoc spesso funzionano per un primo controllo. Diventano difficili da governare quando ogni team implementa le proprie convenzioni di denominazione, soglie, pianificazioni e destinazioni degli alert. Gli strumenti esterni possono ampliare la copertura, ma rischiano di lasciare definizioni delle metriche, contesto storico e metadati di responsabilità sparsi su più sistemi.
Una tabella centralizzata offre agli ingegneri un'interfaccia stabile:
Rilevamento: memorizzare il valore osservato e il momento in cui è stato calcolato.
Confronto: valutarlo rispetto a una baseline, a un livello di servizio atteso o a un periodo precedente.
Escalation: associare gravità, responsabile, runbook e stato.
Evidenza: conservare che cosa è stato controllato, quando è stato eseguito il controllo e quale risultato ha prodotto.
Regola pratica: una metrica non è operativa finché qualcuno non può interrogarla, identificarne il responsabile, decidere quale azione deve attivare e rivederne la cronologia.
Le metric table di Oracle illustrano il passaggio architetturale dall'ispezione manuale puntuale a un monitoraggio standardizzato dello stato attuale e storico. Oracle 10g ha introdotto metric table che calcolavano delta e tassi, semplificando domande come il tasso di I/O attuale del database. Le viste storiche correlate supportano l'analisi delle tendenze, tra cui DBA_HIST_SYSMETRIC_SUMMARY per analisi su più giorni e DBA_HIST_METRIC_NAME per identificare le metriche in un repository AWR condiviso. La storia delle metric table di Oracle e il monitoraggio operativo mostrano perché il pattern rimane utile: i team hanno bisogno sia dello stato attuale sia delle evidenze necessarie per capire come quello stato si è sviluppato.
Senza una metrics system table, i team reagiscono ai reclami. Con una di esse, possono rilevare il degrado prima che uno stakeholder apra un ticket, correlare più segnali e generare evidenze pronte per la governance a partire dallo stesso record operativo.
Che cos'è una metrics system table
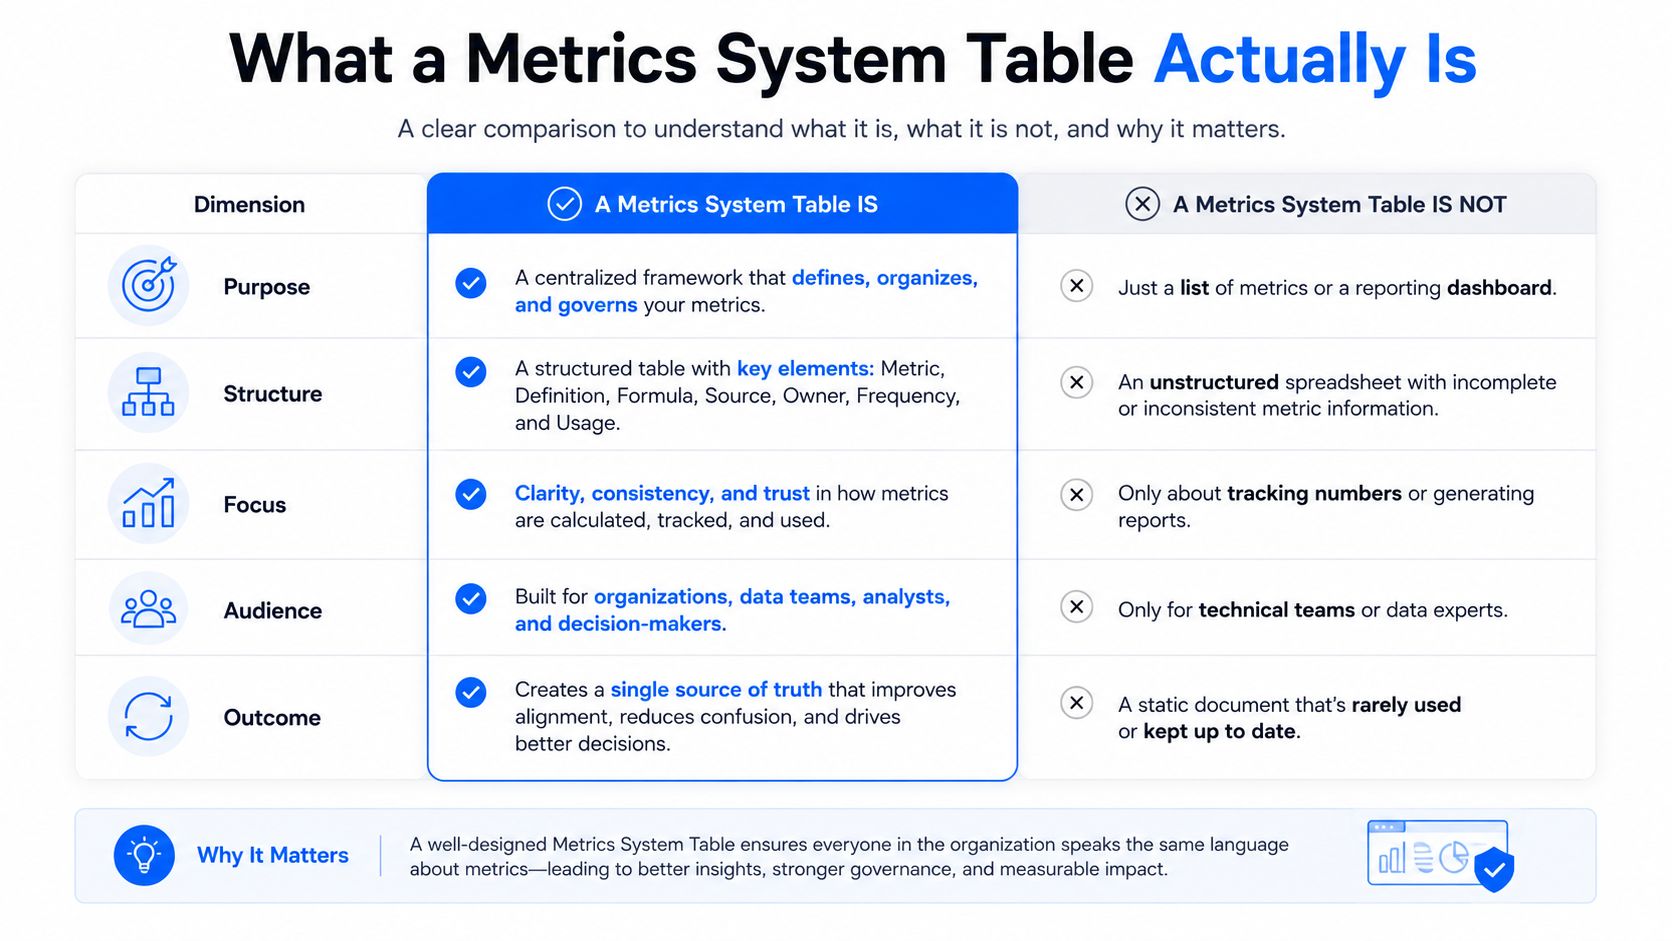
Una metrics system table è un registro operativo a bassa latenza di osservazioni calcolate sugli asset di dati. Registra misurazioni derivate da tabelle utente, pipeline o metadati della piattaforma, senza sostituire i dati sottostanti né creare una seconda copia del data warehouse.
Una tabella rivolta agli utenti contiene entità di business come ordini, utenti, eventi o sinistri. Una tabella delle metriche registra osservazioni su quelle entità, tra cui il conteggio delle righe in un determinato momento, il timestamp dell'ultimo evento, la percentuale di valori mancanti, una stima della cardinalità, l'impronta dello schema o l'esito di una validazione. Il valore misurato appartiene al record della metrica. Le righe di origine restano nella tabella applicativa o analitica.
Perché la separazione è importante
I due carichi di lavoro hanno forme diverse. Le tabelle utente possono supportare transazioni, join, aggregazioni o ingestione. Una metrics system table è in genere progettata per query su finestre temporali, ricerche filtrate, scritture in modalità append e confronti storici. Trattarla come una fact table transazionale aggiunge dettaglio, spazio di archiviazione e overhead nelle query senza migliorare le decisioni operative.
Un record pratico può includere:
Dimensioni: database, schema, tabella, colonna, tipo di metrica, ambiente e dominio di business.
Misure: valore osservato, numero di righe interessate, utilizzo delle risorse o punteggio di anomalia.
Metadati di esecuzione: momento del calcolo, query o identificativo del job di origine, versione del controllo e stato del risultato.
Contesto di governance: responsabile, gravità, riferimento di lineage e stato della remediation.
La tabella dovrebbe anche supportare la definizione delle priorità. Un flusso di misurazioni ad alto volume non è di per sé un processo di alerting. I team hanno bisogno di soglie, responsabili e campi di stato che permettano di distinguere la normale variabilità dalle condizioni che richiedono un intervento. Mantenere queste decisioni vicine all'osservazione registrata favorisce operazioni a basso rumore e pronte per la governance, e consente di eseguire i controlli sui dati direttamente nel database invece di esportare ogni dettaglio altrove.
Questo design si adatta al ruolo delle tabelle di sistema relazionali come strato di metadati. Esse espongono segnali di profilazione e monitoraggio anziché normali righe applicative. Un aggregato compatto e dotato di timestamp può fungere da registro operativo tenendo sotto controllo lo spazio di archiviazione e l'overhead delle query, come descritto nelle linee guida per la progettazione delle tabelle di sistema.
Metadati del fornitore e registro interno controllato
Snowflake, BigQuery e Databricks forniscono metadati generati dal sistema, cronologia delle query, cronologia delle tabelle e viste dell'information schema. Queste fonti aiutano nelle ispezioni specifiche della piattaforma, ma potrebbero non offrire la policy di conservazione, il modello di denominazione, i controlli di business, i campi di responsabilità o lo schema multipiattaforma di cui un'azienda ha bisogno.
Una tabella personalizzata consente a un team di definire:
quali metriche sono autorevoli,
con quale frequenza viene calcolata ciascuna metrica,
per quanto tempo restano disponibili i record grezzi e quelli riepilogati,
quali soglie generano incidenti,
e quali metadati possono essere ispezionati da auditor e data steward.
Questo controllo è importante quando un risultato di freschezza, un evento di schema o una validazione di business devono restare comprensibili anche dopo che la pipeline originale è cambiata. Un semantic layer può standardizzare il significato di business al di sopra di questi segnali senza nascondere il record operativo. I team che valutano questo confine possono confrontare l'approccio del registro con un dbt semantic layer.
Schema di base e pattern di progettazione delle colonne
Uno schema utile separa che cosa è stato misurato, quale valore è stato osservato e come è stata prodotta l'osservazione. Combinare questi ruoli in un'unica colonna sovraccarica rende più difficili il filtraggio, la conservazione e l'alerting.
Iniziate con un modello di eventi essenziale. Le dimensioni statiche identificano l'asset e la metrica. I campi dinamici memorizzano il risultato in un determinato momento di osservazione. I metadati di esecuzione spiegano il calcolo e forniscono agli operatori contesto sufficiente per riprodurre il risultato o effettuarne il triage.
Un design di riferimento
Nome della colonna | Tipo di dato | Scopo | Valore di esempio |
|---|---|---|---|
|
| Tabella misurata, nome completo |
|
|
| Colonna misurata, nullable per le metriche di tabella |
|
|
| Identità della metrica |
|
|
| Momento in cui è stata calcolata la metrica |
|
|
| Risultato numerico |
|
|
| Limite inferiore accettabile |
|
|
| Limite superiore accettabile |
|
|
| Esito della valutazione |
|
|
| Definizione del controllo e contesto diagnostico |
|
I tipi esatti variano a seconda della piattaforma, ma il principio di progettazione resta valido. Usate DECIMAL per i rapporti quando la precisione conta, TIMESTAMP WITH TIME ZONE per i momenti di osservazione e un campo di estensione strutturato come JSONB per dettagli in evoluzione come motivi di errore, definizioni dei filtri o identificativi dei job di origine. Non inserite nel JSON le dimensioni di filtro principali se gli operatori le interrogano regolarmente: promuovete quei campi a colonne indicizzate.
Un'implementazione in stile PostgreSQL potrebbe avere questo aspetto:
Chiavi e percorsi di accesso
La chiave composta impedisce osservazioni duplicate per lo stesso asset, la stessa metrica e lo stesso momento di calcolo. Nei sistemi in cui le riesecuzioni possono produrre più risultati legittimi, aggiungete un identificativo di esecuzione e fate in modo che la regola di unicità rifletta quel modello di esecuzione, anziché sovrascrivere le evidenze.
Create percorsi di accesso intorno alle domande reali degli operatori:
Una query sulle violazioni di freschezza recenti può così filtrare per tipo di metrica e intervallo di tempo invece di scansionare controlli non pertinenti. Le linee guida di MySQL sull'information schema esprimono lo stesso concetto operativo da un'altra prospettiva: metadati dinamici come conteggio delle righe, lunghezza dei dati, lunghezza degli indici, ora di aggiornamento e cardinalità possono aggiungere overhead, quindi i team dovrebbero interrogare solo gli oggetti necessari ed evitare scansioni estese. Le linee guida per l'ottimizzazione dell'information schema supportano un accesso filtrato per schema, tabella, tipo di metrica e finestra temporale.
Lo schema dovrebbe inoltre essere documentato insieme ai controlli che lo popolano. Un catalogo degli schemi del data warehouse può aiutare i team a ragionare sulle dipendenze, ma il registro delle metriche dovrebbe restare ottimizzato per l'accesso operativo, non per la completezza descrittiva. Consultate gli schemi in un data warehouse per capire il confine tra metadati strutturali ed evidenze di monitoraggio.
Query SQL pratiche per le attività di osservabilità più comuni
SQL diventa utile quando ogni query risponde a una domanda operativa e restituisce contesto sufficiente per prendere una decisione. I pattern seguenti presuppongono la tabella di riferimento della sezione precedente e usano una sintassi in stile PostgreSQL. Snowflake, BigQuery e Redshift richiedono piccole modifiche alla sintassi di timestamp, percentili e funzioni di data.
Violazioni di freschezza
Memorizzate l'ultimo timestamp di origine osservato come metric_value per una metrica di freschezza, oppure salvatelo nei metadati strutturati se la piattaforma richiede un valore numerico separato per l'età. La query seguente confronta l'osservazione più recente con uno SLA memorizzato in una tabella di configurazione.
Partizionate la tabella per computed_at dove la piattaforma lo supporta. Il predicato temporale delimitato consente il partition pruning ed evita la scansione dell'intera cronologia.
Anomalie di volume
Una baseline mobile dovrebbe riflettere la variabilità normale anziché una singola esecuzione precedente. Questo esempio utilizza una media mobile e una deviazione standard calcolate sulle metriche storiche del conteggio delle righe.
Utilizzate una chiave di partizione o di clustering su nome della tabella e momento di osservazione. La banda esatta dovrebbe riflettere il rischio di business e la stagionalità, non una costante universale.
Schema drift
Lo schema drift è più facile da rilevare quando uno snapshot di riferimento viene memorizzato come famiglia di metriche distinta. La query seguente confronta il dettaglio dell'impronta dello schema attuale con l'ultimo snapshot approvato.
I team che vogliono misurare lo schema drift a livello operativo possono monitorare la frequenza del drift e la latenza di rilevamento del drift, definite rispettivamente come il numero di modifiche di schema in un periodo e il tempo che intercorre tra una modifica e il suo rilevamento. Le linee guida sul monitoraggio dello schema drift descrivono queste misure senza richiedere che ogni modifica strutturale diventi un incidente.
Attività di osservabilità | Pattern SQL principale | Funzioni chiave | Soglia tipica |
|---|---|---|---|
Freschezza | Ultima osservazione rispetto all'età configurata |
| SLA specifico per tabella |
Anomalia di volume | Baseline mobile e banda di deviazione |
| Dipendente dalla baseline |
Schema drift | Snapshot attuale confrontato con la baseline |
| Colonna aggiunta, eliminata o con tipo modificato |
Monitoraggio del tasso di null | Rapporto attuale rispetto alla baseline |
| Tolleranza specifica per colonna |
Monitoraggio della latenza | Intervallo tra esecuzioni e confronto dei tempi di esecuzione |
| Aspettativa specifica per pipeline |
Mantenete queste query sotto controllo di versione e revisionatele come codice di produzione. Le pratiche di ottimizzazione delle query SQL sono particolarmente rilevanti quando la tabella delle metriche contiene mesi di osservazioni.
Strategie di conservazione e aggregazione
Le osservazioni grezze sono preziose durante la risposta agli incidenti e costose se conservate senza un piano. Una tabella delle metriche che registra ogni esecuzione, asset e controllo può crescere rapidamente, quindi la conservazione dovrebbe corrispondere alle domande a cui gli operatori devono rispondere.
Tre pattern coprono la maggior parte dei deployment.
Conservazione dei soli dati grezzi
Questo modello mantiene i record dettagliati e li elimina con una policy di time-to-live. Preserva il miglior dettaglio forense, compreso il contesto di esecuzione esatto e la sequenza di modifiche che ha preceduto un incidente. Lo svantaggio è che le query sulle tendenze storiche scansionano più righe e la tabella richiede una manutenzione disciplinata delle partizioni.
La conservazione dei soli dati grezzi funziona quando l'indagine sugli incidenti è il caso d'uso dominante o quando la piattaforma offre già un partition pruning poco costoso. Funziona male quando i team di governance hanno bisogno di tendenze storiche lunghe e gli operatori interrogano abitualmente l'intera tabella.
Riepiloghi per intervalli di tempo
I rollup orari o giornalieri memorizzano aggregati come minimo, massimo, media, conteggio, ultimo valore e numero di anomalie. Rendono più rapida l'analisi delle tendenze e riducono la quantità di dati storici che deve restare nel data warehouse "caldo". Il compromesso è l'irreversibilità: un riepilogo giornaliero può mostrare che una tabella si è comportata in modo anomalo, ma potrebbe non rivelare quale esecuzione, colonna o controllo ha prodotto la prima deviazione.
Usate viste materializzate o modelli dbt incrementali per questi riepiloghi. Partizionate per data dell'intervallo e mantenete le dimensioni necessarie per i filtri più comuni, come tabella, tipo di metrica, dominio e ambiente.
Conservazione a livelli
Un modello ibrido conserva i record grezzi per una breve finestra operativa e i riepiloghi aggregati per una finestra analitica più lunga. Bilancia il dettaglio degli incidenti con la visibilità delle tendenze, mentre lo storage a freddo può conservare le evidenze di conformità quando non serve una bassa latenza per le query interattive.
Decisione sulla conservazione: conservate il dettaglio grezzo dove cambia l'esito di un'indagine. Aggregate i record quando la domanda rimanente riguarda la direzione, il confronto o la governance.
Allineate la conservazione ai pattern di accesso. Se gli operatori filtrano per tabella e periodo recente, partizionate per data di osservazione e applicate clustering o indici sul nome della tabella. Se gli auditor filtrano per controllo, responsabile o periodo di rendicontazione, conservate questi campi nel riepilogo invece di costringerli a ricostruire il contesto dagli eventi grezzi.
Le funzionalità storiche del data warehouse possono integrare questo design, ma non eliminano la necessità di scegliere quali record delle metriche restano interrogabili. I pattern per i dati storici in Snowflake offrono un contesto utile per separare la cronologia operativa dall'analisi di lungo periodo.
Collegare le metriche ai segnali di freschezza e di schema drift
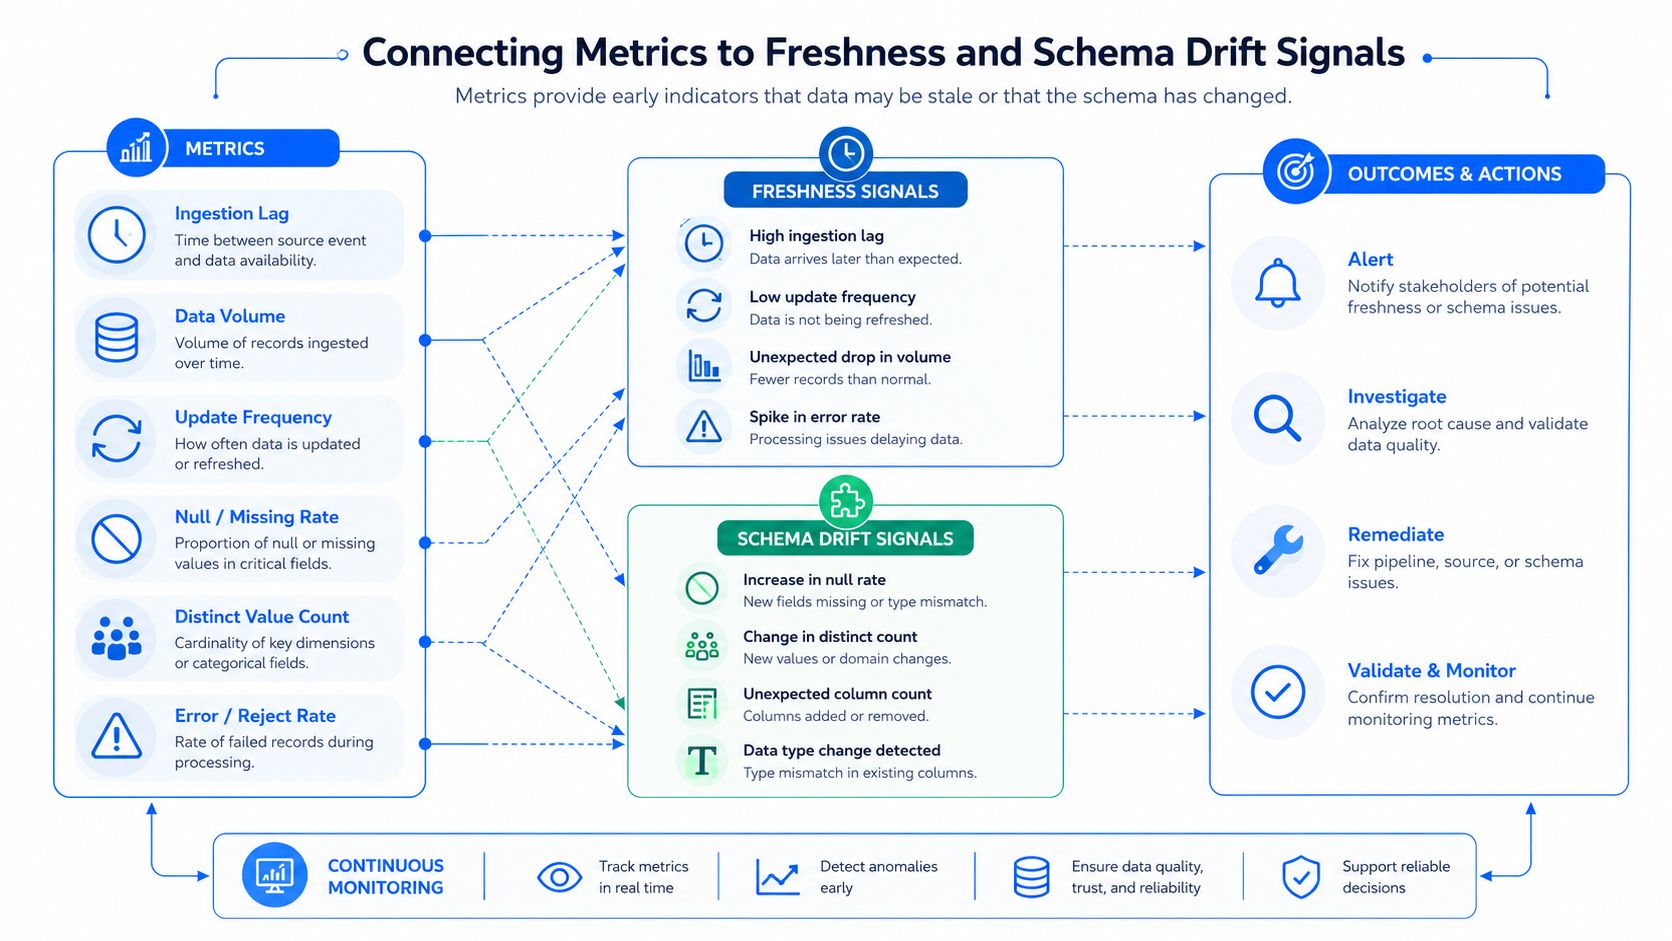
Raramente una singola metrica spiega se una tabella può essere utilizzata in sicurezza. Un arrivo in ritardo può essere innocuo se la pianificazione della sorgente è cambiata. Una variazione del numero di righe può essere prevista durante un evento stagionale. Una modifica di schema può essere retrocompatibile. Il segnale utile emerge quando più osservazioni indicano la stessa modalità di guasto.
I record di freschezza, volume e schema possono essere collegati tramite l'identificativo della tabella e una finestra temporale comune. A partire da qui i team possono costruire un indice di affidabilità composito, ma il punteggio dovrebbe ordinare le priorità di indagine anziché pretendere di rappresentare una verità oggettiva.
Correlare i segnali
Una semplice query di correlazione può identificare le tabelle con più condizioni simultanee:
La regola di escalation dovrebbe riflettere le conseguenze. Un errore di freschezza unito a un errore di volume può giustificare un nuovo tentativo automatico o un'indagine sulla sorgente. Una modifica di schema combinata con un modello a valle sensibile ai tipi dovrebbe sospendere la promozione e richiedere la revisione di uno steward. Una fluttuazione isolata del tasso di null può richiedere osservazione anziché un allarme al reperibile.
Una matrice decisionale per una risposta a basso rumore
Combinazione di segnali | Interpretazione probabile | Risposta |
|---|---|---|
Solo freschezza | Consegna in ritardo o mancante | Verificare la pianificazione a monte, poi riprovare quando è sicuro |
Solo volume | Variazione del carico o estrazione parziale | Confrontare i totali della sorgente e il carico di lavoro recente |
Solo schema | Modifica strutturale | Verificare la compatibilità e le dipendenze a valle |
Freschezza più volume | Caricamento incompleto o in ritardo | Escalation al responsabile della pipeline |
Schema più volume | Modifica del contratto o della trasformazione | Sospendere la pubblicazione a valle e verificare |
Tutti e tre | Guasto esteso dell'asset | Aprire un incidente ad alta priorità con il contesto di lineage |
Il monitoraggio dello schema drift verifica se una colonna è stata aggiunta, rimossa o ha cambiato tipo senza preavviso. La freschezza verifica se i dati arrivano nei tempi previsti. Queste definizioni sono operativamente distinte e le linee guida sui segnali di data observability sono utili per progettare la tassonomia delle metriche.
I team possono eseguire questi controlli direttamente all'interno del database, evitando spostamenti di dati non necessari e riducendo la distanza tra osservazione e decisione. L'esecuzione dell'osservabilità in-database descrive questo modello come l'esecuzione dei test direttamente nell'ambiente del database, il che si adatta a una metrics system table che memorizza risultati compatti anziché dati di origine estratti.
Quando più metriche riducono l'efficacia dell'osservabilità
La copertura sembra sicura finché la tabella delle metriche non diventa un catalogo di tutto ciò che può essere misurato. A quel punto i costi delle query aumentano, i flussi di alert diventano difficili da classificare e i guasti importanti competono con fluttuazioni innocue.
Un team può monitorare un ampio insieme di statistiche a livello di colonna e non accorgersi di un errore nella logica di business. Può anche produrre così tante notifiche che gli ingegneri le confermano senza indagare. Il problema non è la misurazione in sé, ma il fatto di considerare ogni misurazione ugualmente meritevole di azione.
Stabilire le priorità in base alle conseguenze
Iniziate dai segnali che influiscono sulla capacità di un utente di usare i dati:
Freschezza di primo livello: monitorate se le tabelle destinate al management, alle autorità di vigilanza, ai clienti o alle operazioni arrivano quando previsto.
Volume a livello di tabella: rilevate caricamenti vuoti, estrazioni parziali e modifiche impreviste della sorgente prima di aggiungere controlli granulari.
Compatibilità dello schema: applicate il monitoraggio strutturale ai percorsi critici, dove una modifica di tipo o di colonna può rompere i modelli.
Controlli mirati sulle colonne: aggiungete controlli su tasso di null, cardinalità o distribuzione quando una specifica colonna influisce su un calcolo finanziario, su una feature di un modello o su un controllo di conformità.
Questa sequenza mantiene la metrics system table un registro operativo e non un catalogo completo dei dati. Un monitoraggio più ampio a livello di tabella può coprire freschezza, schema drift e anomalie di volume senza richiedere centinaia di regole per ogni dataset, mentre una validazione più approfondita resta disponibile per gli asset ad alto rischio. Le linee guida unificate su data quality e osservabilità supportano questo approccio a livelli.
Eliminare i controlli che non cambiano le decisioni
Ogni controllo dovrebbe avere un responsabile, una risposta e un motivo per restare attivo. Se una metrica non ha prodotto alcuna risposta utile nel suo periodo di revisione, chiedetevi se la soglia è sbagliata, se l'asset ha bassa priorità o se il controllo non appartiene più al monitoraggio continuo.
Test operativo: se un alert non riesce a identificare un team responsabile e un'azione successiva, probabilmente non dovrebbe allertare nessuno.
Usate le dashboard per il contesto esplorativo e gli alert per le decisioni. Una violazione di freschezza a livello di tabella può allertare un responsabile. Un piccolo spostamento della distribuzione può restare visibile nell'analisi delle tendenze finché non si combina con un altro segnale. La trattazione di Snowflake sulla risoluzione dei problemi di data quality rafforza il compromesso più generale: la copertura del monitoraggio è utile solo quando i team possono agire sul risultato, non quando produce altro output non esaminato. Consultate i flussi di lavoro per la correzione della data quality.
L'obiettivo giusto non è il massimo volume di metriche, ma il più piccolo insieme di segnali che rileva tempestivamente un degrado significativo, supporta la diagnosi e crea un registro difendibile di ciò che è accaduto.
Strumentare le tabelle delle metriche nelle piattaforme enterprise
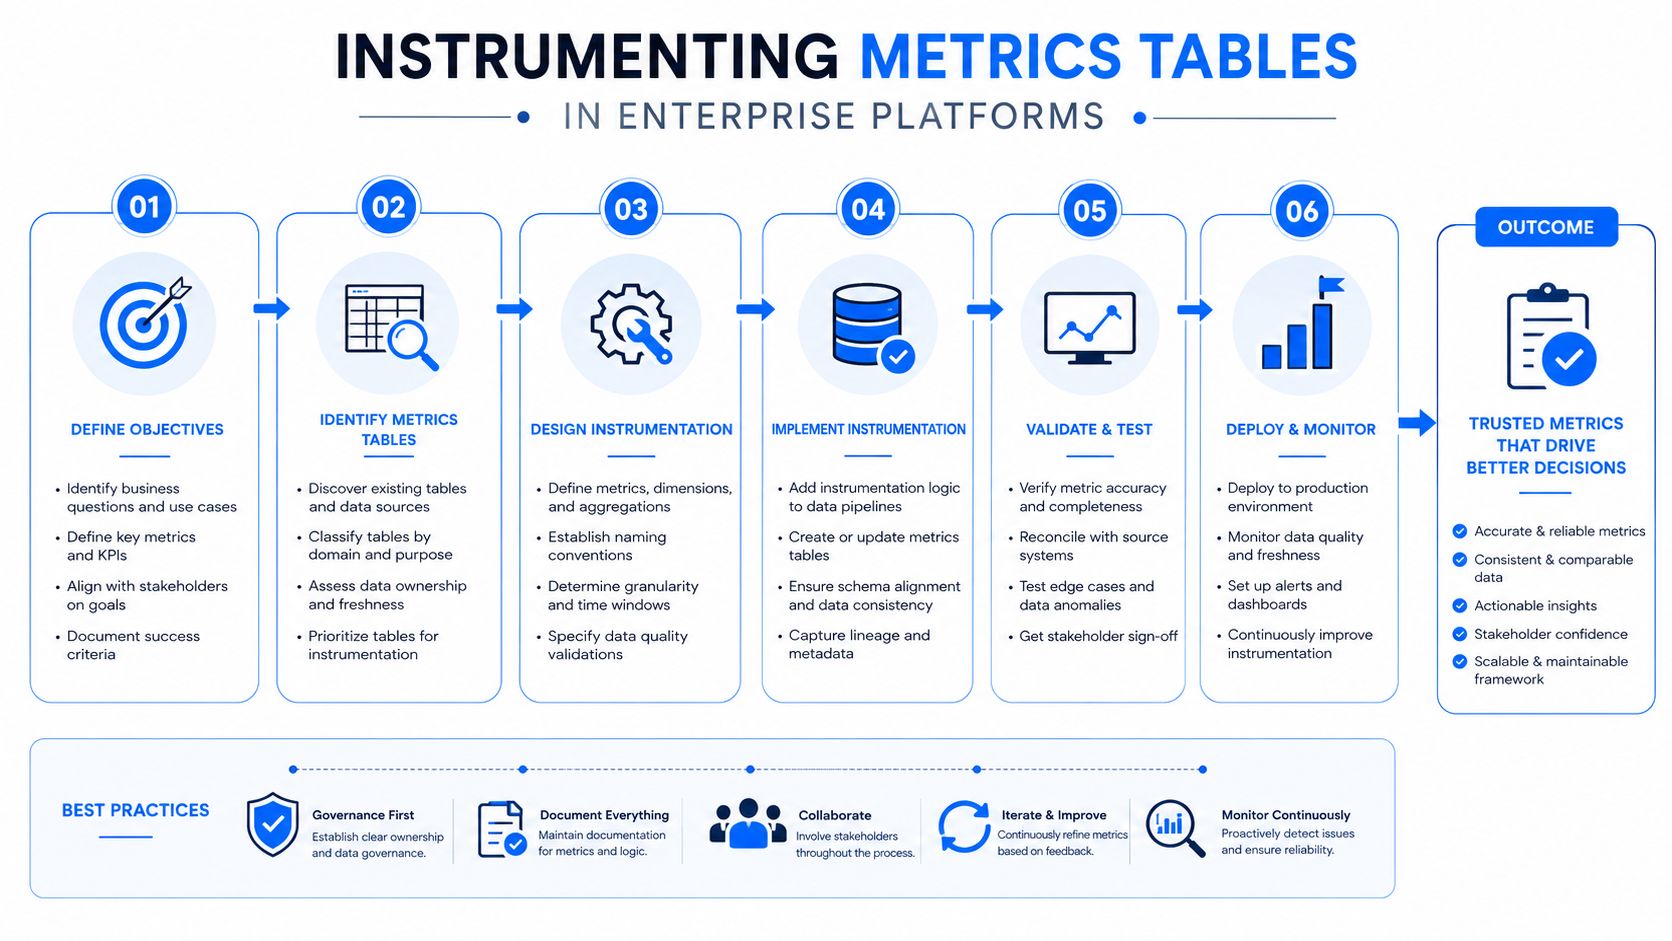
La strumentazione in produzione dovrebbe essere eseguita vicino ai dati e risiedere nel controllo di versione. Task SQL pianificati, post-hook dbt, procedure native del data warehouse e l'orchestrazione della piattaforma possono popolare una metrics system table senza esportare i record grezzi in un servizio separato.
La scelta dell'implementazione dipende dal controllo. Una query di freschezza può essere eseguita dopo l'ingestione. Uno snapshot dello schema può essere eseguito prima del rilascio dei modelli a valle. Un calcolo di distribuzione più oneroso può essere eseguito con una pianificazione commisurata al suo rischio e al suo costo. L'aspetto importante è che pianificazione, query, soglia, responsabile e policy di conservazione vengano dichiarati insieme.
Un pattern di deployment che regge
Create il registro. Aggiungete la tabella delle metriche, la tabella di configurazione, i campi di responsabilità e il meccanismo di conservazione prima di attivare gli alert.
Registrate gli asset critici. Annotate identificativi delle tabelle, dominio di business, gravità, pianificazione prevista e team responsabile.
Popolate dal database. Usate SQL pianificato, hook dbt o task nativi per calcolare aggregati compatti direttamente sul posto.
Definite una baseline prima di allertare. Conservate le osservazioni abbastanza a lungo da comprendere il comportamento normale, poi impostate soglie adatte all'asset.
Instradate i risultati utili. Inviate gli incidenti approvati a Slack, PagerDuty, dashboard di governance o a uno strumento di osservabilità esistente.
Allegate i runbook. Memorizzate i riferimenti per la remediation insieme alla configurazione della metrica, in modo che un alert si apra già con il contesto.
Una piattaforma come Monte Carlo può utilizzare i segnali del data warehouse, mentre un servizio personalizzato può interrogare direttamente il registro. digna offre il calcolo in-database delle metriche per conteggi dei record, tassi di valori mancanti, statistiche di distribuzione, aggregazioni di KPI e scostamenti di tempestività, con moduli per rilevamento delle anomalie, validazione e tracciamento dello schema.
Proteggere le prestazioni
Create indici o clustering sui campi che gli operatori filtrano più spesso. Partizionate per data di osservazione dove supportato. Evitate di ricalcolare metriche costose per ogni tabella a ogni esecuzione e non lasciate che una query di alert scansioni tutti i record storici quando una partizione recente contiene le evidenze necessarie.
Mantenete le definizioni dei controlli in un repository e revisionate le modifiche con lo stesso processo usato per il codice di trasformazione. La logica nei notebook e gli script sparsi sono difficili da verificare, riprodurre o dismettere. Una configurazione sotto controllo di versione rende visibili i cambi di responsabilità, le modifiche delle soglie e l'evoluzione dello schema.
Governance e verificabilità nei settori regolamentati
Nei settori finanziario, sanitario, delle telecomunicazioni e nella pubblica amministrazione, le evidenze di osservabilità devono sopravvivere all'incidente che le ha generate. Una metrics system table può registrare che un controllo è stato eseguito, che cosa ha misurato, quale versione è stata eseguita, se ha avuto esito positivo e chi era responsabile del risultato.
Questo record supporta più della sola risposta agli incidenti. Può aiutare un auditor a verificare che una tabella finanziaria critica sia stata validata prima di un processo di rendicontazione, o che una colonna sensibile sia rimasta entro l'intervallo di qualità previsto. Il valore deriva dal preservare le evidenze di esecuzione e dal renderle spiegabili.
Separare chi scrive da chi legge
Le scritture dovrebbero essere di competenza delle pipeline automatizzate. Auditor, data steward, responsabili dei controlli e platform engineer dovrebbero ricevere un accesso in lettura circoscritto. Evitate di concedere agli utenti operativi il permesso di modificare i risultati storici, perché evidenze modificabili indeboliscono l'audit trail.
I campi di audit utili includono:
check_executed_at, il momento in cui è stata eseguita la valutazione.observed_at, il momento rappresentato dalla metrica.check_version, che identifica la logica utilizzata.owner_team, che identifica la responsabilità.lineage_reference, che collega il risultato agli asset a monte e a valle.result_statusefailure_reason, che rendono comprensibile l'esito.remediation_status, che mostra se il problema è stato esaminato o risolto.
Nome della colonna | Tipo di dato | Scopo | Requisito di conservazione |
|---|---|---|---|
|
| Identifica il controllo governato | Conservare insieme al record del controllo |
|
| Dimostra il momento dell'esecuzione | Preservare per il periodo di audit |
|
| Identifica lo stato dei dati misurato | Preservare insieme al risultato |
|
| Stabilisce la responsabilità | Conservare finché il controllo è attivo |
|
| Collega l'asset alle dipendenze | Conservare per indagini e revisioni |
|
| Memorizza il risultato osservato | Preservare insieme alle evidenze del controllo |
|
| Registra lo stato di superamento o di errore | Preservare come evidenza immutabile |
|
| Rimanda agli artefatti di supporto | Conservare secondo la policy |
La conservazione richiesta dalle normative può estendersi ben oltre la finestra delle query "calde". Memorizzate le evidenze recenti nel data warehouse per l'accesso operativo, comprimete le partizioni più vecchie e archiviate i record immutabili in un object storage controllato quando l'accesso interattivo non è più necessario. Applicate crittografia, logging degli accessi e policy di cancellazione coerenti con la classificazione dei dati applicabile.
Una metrics system table diventa un'infrastruttura di governance quando i suoi record sono immutabili, attribuibili, riproducibili e collegati al data lineage sottostante. Non dovrebbe limitarsi a dire che un controllo è fallito: dovrebbe spiegare quale controllo è stato eseguito, su quale asset, con quale definizione e che cosa è successo dopo.
Riferimento rapido per la progettazione di una metrics system table
Un design di produzione dovrebbe essere facile da ispezionare durante un incidente. La tabella seguente riassume i campi che di solito contano di più.
Colonna principale | Tipo consigliato | Ruolo operativo | Frequenza di aggiornamento |
|---|---|---|---|
|
| Identifica l'asset misurato | A ogni osservazione |
|
| Identifica il segnale | A ogni osservazione |
|
| Memorizza il risultato calcolato | Secondo la pianificazione del controllo |
|
| Identifica lo stato dei dati | A ogni osservazione della sorgente |
|
| Confronta gli snapshot strutturali | Al controllo dello schema |
|
| Monitora il volume della tabella | A ogni caricamento o secondo la pianificazione del controllo |
Pattern di query in produzione
Controlli di freschezza: filtrate i record recenti con
metric_type = 'freshness'e confrontate l'ultima osservazione con il limite di età configurato per l'asset.Anomalie di volume: usate una finestra storica delimitata, window function e una baseline specifica per tabella invece di confrontare ogni risultato con l'esecuzione immediatamente precedente.
Alert di schema drift: confrontate lo snapshot attuale dello schema con una baseline approvata e classificate separatamente aggiunte, rimozioni e cambi di tipo.
Monitoraggio del tasso di null: filtrate per colonna e tipo di metrica, poi valutate il rapporto attuale rispetto all'intervallo previsto per la colonna.
Monitoraggio della latenza: usate
LAGsulle osservazioni ordinate per calcolare gli intervalli tra le esecuzioni e isolare le consegne in ritardo.
I filtri pronti per la produzione dovrebbero restringere per table_name, metric_type e finestra di osservazione prima di applicare i calcoli. Questa combinazione favorisce il partition pruning, l'uso degli indici e un costo di indagine inferiore.
Le soglie hanno bisogno di contesto
Non esiste uno SLA di freschezza, una banda di volume o un limite di tasso di null universale adatto a ogni tabella aziendale. Una tabella di primo livello può richiedere un'aspettativa di consegna più rigorosa rispetto a un dataset esplorativo. Una sorgente giornaliera può tollerare un andamento dei volumi diverso da un flusso di eventi ad alta frequenza. Una modifica di schema può essere innocua per un utente e bloccare il rilascio per un altro.
Usate il comportamento storico per stabilire una baseline, poi combinate le soglie con le conseguenze e la responsabilità. Richiedete più segnali correlati prima di effettuare l'escalation di condizioni rumorose e mantenete il record dell'alert abbastanza ricco da supportare un passaggio di consegne. Rivedete regolarmente i controlli, eliminate le misurazioni che non portano ad alcuna azione e conservate le evidenze sottostanti necessarie per la governance.
digna aiuta i team a calcolare e analizzare le metriche a livello di tabella in-database, a monitorare tempestività e anomalie, a validare i record e a tracciare le modifiche di schema senza spostare i dati di produzione fuori dall'ambiente del cliente. Visitate digna per scoprire come le sue funzionalità modulari di osservabilità possono trasformare una metrics system table in un flusso di lavoro governato per data engineer, steward e responsabili di piattaforma.
Domande frequenti
Che cos'è una metrics system table?
Un registro operativo a bassa latenza di osservazioni calcolate sugli asset di dati. È volutamente separata dalle tabelle rivolte agli utenti che contengono entità di business come ordini, utenti, eventi o sinistri, perché i due carichi di lavoro hanno forme diverse e pattern di query diversi.
Perché non usare semplicemente script ad hoc?
Funzionano per un primo controllo, ma poi smettono di scalare. Una tabella centralizzata offre agli ingegneri un'interfaccia stabile per il rilevamento, il confronto con una baseline o con un periodo precedente, l'escalation con gravità e responsabile e le evidenze di che cosa è stato controllato, quando è stato eseguito il controllo e quale risultato ha prodotto.
Che cosa dovrebbe contenere ogni record?
Quattro gruppi: dimensioni come database, schema, tabella, colonna, tipo di metrica, ambiente e dominio di business; misure come valore osservato, numero di righe interessate o punteggio di anomalia; metadati di esecuzione come momento del calcolo, job di origine e versione del controllo; e contesto di governance come responsabile, gravità, riferimento di lineage e stato della remediation.
Quando una metrica è davvero operativa?
Quando qualcuno può interrogarla, identificarne il responsabile, decidere quale azione deve attivare e rivederne la cronologia. Tutto ciò che resta al di sotto di questo livello è un numero raccolto, non un controllo eseguito, e lo stato della pipeline risponde soltanto alla domanda se il task è stato eseguito.
Esistono precedenti per questo design?
Sì, nelle tabelle di sistema relazionali usate come strato di metadati. Oracle 10g ha introdotto metric table che calcolavano delta e tassi, semplificando domande come il tasso di I/O attuale del database: lo stesso passaggio architetturale dall'ispezione manuale puntuale a un monitoraggio standardizzato dello stato attuale e storico.


