I 10 migliori strumenti di Data Observability del 2026: un'analisi
|
7
min di lettura

I job del warehouse sono stati eseguiti. La dashboard si è caricata. Nessuno ha ricevuto un alert di errore della pipeline. Poi uno stakeholder chiede perché i ricavi di ieri sono crollati, e la risposta è sgradevole: i dati sono stati sbagliati per ore, forse giorni, e il vostro monitoraggio non se n'è mai accorto.
È questo il divario che gli strumenti di Data Observability devono colmare. Sorvegliano dati in ritardo, schemi rotti, distribuzioni che derivano e altri guasti silenziosi che si collocano a valle dello stato di salute dell'infrastruttura. La categoria cresce rapidamente perché le pipeline moderne sono sempre più estese, i carichi di lavoro di AI sono meno tolleranti e i team non possono continuare ad aggiungere controlli manuali all'infinito. Research and Markets stima che il mercato globale degli strumenti di Data Observability raggiungerà tra 2,0 e 4,0 miliardi di USD entro il 2025, con una crescita prevista fino a 3,5 miliardi di USD entro il 2033 a un CAGR del 12,5% dal 2026 al 2033, trainata dalla domanda di visibilità end-to-end e da pipeline di dati più complesse (prospettive del mercato globale degli strumenti di Data Observability).
Se state già rafforzando la vostra pratica di affidabilità più in generale, questa guida di Webtwizz sullo stato di salute delle app è una lettura complementare utile. Per la scelta dello strumento in sé, il modo più rapido per orientarsi nel rumore dei vendor è usare un framework. Gli strumenti che seguono sono confrontati in un'ottica enterprise su nove criteri pratici: anomaly detection, profondità della validazione, contesto di lineage, copertura della tempestività, modello di deployment, approccio alla privacy, scalabilità, usabilità e chiarezza dei prezzi.
Indice
I 10 migliori strumenti di Data Observability: confronto delle funzionalità
Guida alla decisione: scegliere il vostro strumento di Data Observability
1. digna

Una pipeline si rompe alle 2 di notte. La domanda immediata non è se il vostro strumento di observability sia in grado di generare un alert. La domanda è se possa analizzare il problema senza trasferire dati di produzione sensibili nell'ambiente SaaS di qualcun altro.
digna è insolitamente esplicito su questo punto. Il suo modello si basa sull'esecuzione nel database all'interno di un'infrastruttura controllata dal cliente, con opzioni di deployment in private cloud e on-prem. Per i team regolamentati questa architettura può essere il fattore decisivo, perché spostamento dei dati, residenza e accesso del vendor sono questioni di procurement tanto quanto di engineering. Questa direzione è anche in linea con le più ampie tendenze architetturali del mercato della Data Observability.
Perché digna si distingue
digna organizza l'observability in cinque moduli: Data Anomalies, Data Analytics, Timeliness, Data Validation e Schema Tracker. In pratica, una sola piattaforma può coprire variazioni inattese delle metriche, caricamenti in ritardo o mancanti, controlli basati su regole, drift strutturale e analisi storica.
Apprezzo questa scelta di design perché rispecchia il modo in cui si sviluppano gli incidenti. Un alert di freschezza si trasforma spesso in un problema di validazione. Una modifica allo schema può generare un'anomalia. I team che acquistano strumenti separati per questi flussi di solito creano attriti nei passaggi di consegna, alert duplicati e lunghi cicli di triage.
Questa sovrapposizione confonde ancora gli acquirenti. Molti team stanno cercando di decidere se anomaly detection e controlli di qualità basati su regole debbano stare in una piattaforma o in due, e i commenti recenti sulla sovrapposizione tra Data Observability e Data Quality mostrano quanto questo confine resti sfumato sul mercato.
Se volete una spiegazione concisa dell'approccio statistico alla base di questo tipo di monitoraggio, la guida di digna ai metodi Monte Carlo per una migliore Data Observability è un riferimento utile.
Regola pratica: se il team di governance, il team di analytics engineering e il team di piattaforma stanno valutando ciascuno prodotti diversi per anomalie, freschezza e validazione, fermatevi e mappate le sovrapposizioni prima di firmare qualsiasi cosa.
digna dichiara inoltre un time to first value rapido. Lo considererei un segnale positivo, non una promessa. I deployment privati dipendono comunque dalla configurazione delle identità, dall'accesso al warehouse, dai vincoli di rete e dai cicli di revisione interni.
Casi d'uso ideali e compromessi
digna ha più senso per le aziende che valutano gli strumenti su qualcosa di più delle funzioni di alerting. Nel framework di questo articolo ciò emerge in modello di deployment, approccio alla privacy, spostamento dei dati, profondità della validazione, copertura della tempestività, monitoraggio degli schemi e prontezza enterprise. Nelle grandi organizzazioni questi criteri tendono a contare più di una trial SaaS ben confezionata.
Il principale vantaggio di digna è il controllo architetturale. I dati del cliente restano nell'ambiente del cliente e la stessa interfaccia copre anomaly detection, validazione, tempestività e schema drift. È una scelta molto adatta per i team di finanza, sanità, telecomunicazioni e pubblica amministrazione, dove la revisione di sicurezza può escludere vendor altrimenti validi ancora prima che inizi un proof of concept. Il divario è abbastanza concreto che un'analisi dei requisiti di deployment dell'observability nella pubblica amministrazione sottolinea la necessità di piattaforme che funzionino su fonti di dati eterogenee senza esporre i dataset di produzione grezzi.
I compromessi sono chiari:
Nessun prezzo pubblico: la shortlist richiede più tempo, perché gli acquirenti devono parlare con il commerciale prima di poter confrontare i costi.
Più lavoro di implementazione: le configurazioni private cloud e on-prem richiedono di solito tempo del platform engineering.
Meno ottimizzato per un acquisto SaaS rapido: i team più piccoli che vogliono una trial leggera possono preferire strumenti con una soglia di configurazione più bassa.
Per gli acquirenti che mettono privacy, flessibilità di deployment e controlli enterprise sullo stesso piano della qualità del rilevamento, digna merita una valutazione seria.
2. Monte Carlo
Uno schema di guasto comune in ambito enterprise è questo: il team individua rapidamente un problema nei dati, poi perde ore a capire quali tabelle, dashboard e modelli a valle sono coinvolti. Monte Carlo è pensato per questa seconda parte del problema. Copre warehouse, pipeline, asset di BI e i più recenti casi d'uso di AI observability, ma il suo vero valore emerge dopo che è scattato un alert.
Il prodotto dà il meglio negli ambienti in cui la risposta agli incidenti ha bisogno di struttura. Monitor automatici, lineage a livello di campo e flussi di triage sono importanti. Il rilevamento è solo metà del lavoro. La parte più difficile è valutare il raggio d'impatto, assegnare la responsabilità e decidere se mettere in quarantena i dati errati prima che raggiungano dirigenti, clienti o modelli in produzione. La funzione Circuit Breakers di Monte Carlo riflette questo modello operativo. Per chi vuole approfondire le idee probabilistiche alla base di questo approccio, la spiegazione di digna sui metodi Monte Carlo per una migliore Data Observability è un riferimento utile.
Dove Monte Carlo è più forte
Monte Carlo merita un posto nella shortlist quando i criteri di valutazione privilegiano la maturità operativa rispetto alla flessibilità di deployment. Nel framework di questo articolo ottiene buoni punteggi per ampiezza delle integrazioni, profondità del lineage, flusso di alerting e supporto alla gestione degli incidenti su larga scala. Questo lo rende una scelta pratica per i team di data platform che gestiscono già un ampio parco di warehouse e hanno bisogno di un'observability strettamente legata alle operazioni quotidiane.
Il compromesso è quello che gli acquirenti dovrebbero esaminare per primo. Monte Carlo è un prodotto enterprise venduto tramite il canale commerciale, quindi i costi possono crescere con il perimetro, e il perimetro tende ad ampliarsi quando i team iniziano a strumentare più asset. Gli acquirenti dovrebbero inoltre valutare con attenzione i requisiti di deployment e privacy. Se opzioni private cloud, controlli rigorosi sulla residenza dei dati o uno spostamento minimo dei metadati sono criteri decisionali centrali, queste domande devono avere risposte chiare prima che inizi un proof of concept.
Scegliete Monte Carlo quando gestione degli incidenti, contesto di lineage e ampia copertura dell'ecosistema contano più di un rollout leggero. Guardate altrove se la vostra priorità è un'adozione a basso costo o un controllo più stretto sull'architettura di deployment.
3. Bigeye

Bigeye sembra uno strumento pensato per acquirenti che sanno già di aver bisogno di controlli enterprise. Copre bene i segnali standard di observability, tra cui freschezza, volume, distribuzione, schema e lineage. Il punto di forza principale sono però l'approccio alla sicurezza e la flessibilità di deployment, soprattutto per i team che hanno bisogno fin dal primo giorno di modalità di accesso in sola lettura e di controlli formali sugli accessi.
È uno degli strumenti che proporrei ai team di data platform attenti alla sicurezza che non vogliono aggiungere la governance all'observability in un secondo momento. La connettività agentless in sola lettura può essere un argomento d'acquisto decisivo quando la revisione di sicurezza è rigorosa e il tempo degli sviluppatori è limitato.
Il caso d'uso ideale in pratica
Bigeye è un'opzione seria per organizzazioni più grandi e mature sul piano dei dati, che hanno bisogno di un'observability capace di superare in un colpo solo revisione architetturale, revisione di compliance e revisione di procurement. Anche i suoi servizi professionali e l'orientamento ai partner possono aiutare i team che hanno bisogno di supporto all'adozione, non solo di software.
Lo svantaggio è noto. Non ci sono prezzi pubblici e il prodotto è chiaramente rivolto a un mercato superiore a quello dei piccoli team. Se il vostro stack è ancora semplice, Bigeye potrebbe risultare più pesante del necessario. Se il vostro ambiente è regolamentato e complesso dal punto di vista organizzativo, quel peso può essere un vantaggio.
4. Soda (Soda Cloud + Soda Core OSS)
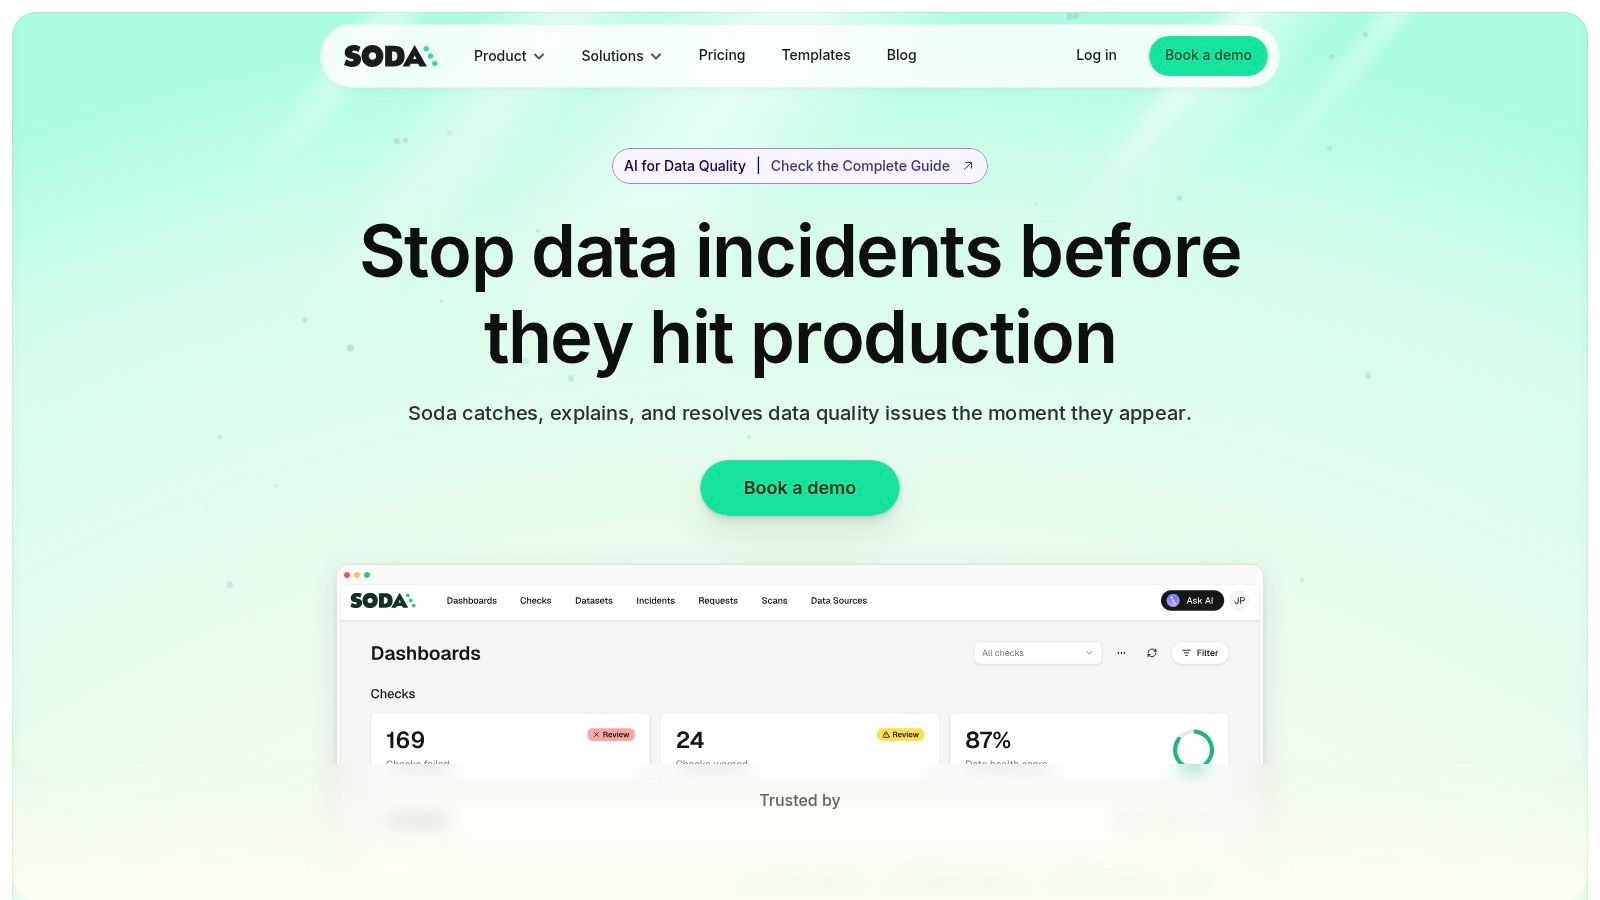
Soda resta rilevante perché offre ai team due punti di ingresso. Potete iniziare con Soda Core in versione open source e definire i controlli nel codice, poi aggiungere Soda Cloud se volete collaborazione, instradamento degli alert e flussi di lavoro di team. Questa suddivisione è utile quando l'engineering vuole prima il controllo e solo in seguito un modello operativo più ampio.
L'approccio checks-as-code è la principale attrattiva. Per gli analytics engineer e i team di piattaforma che lavorano già con Git, YAML e CI, Soda risulta naturale. Potete esprimere direttamente le aspettative note e mantenerle vicine alla logica di trasformazione.
Che cosa funziona bene
Soda ricorda bene che observability e validazione non sono la stessa cosa, anche quando gli acquirenti le confondono. Le configurazioni Soda più solide abbinano di solito il monitoraggio delle metriche a test espliciti sulle regole di business. Ecco perché il modello OSS più cloud gestito funziona. Supporta il controllo locale e offre comunque agli stakeholder non tecnici un luogo in cui vedere gli incidenti e collaborare.
Spiccano alcuni compromessi pratici:
Flessibilità open source: potete iniziare senza un lock-in immediato sulla piattaforma.
Buon passaggio di consegne nel team: Soda Cloud aggiunge uno spazio di lavoro più intuitivo per triage e assegnazioni.
Percorso di upsell verso il cloud: i flussi di lavoro avanzati si trovano spesso nel prodotto gestito.
Prezzi personalizzati: la trasparenza sui costi diminuisce quando si va oltre il punto di partenza open source.
Per i team che vogliono un'adozione code-first e non hanno problemi ad aggiungere funzionalità nel tempo, Soda resta una delle scelte più pragmatiche.
5. Anomalo
Anomalo punta con decisione sul monitoraggio automatico e sulla configurazione assistita dall'AI. Questo lo rende interessante per i team che vogliono una copertura rapida senza dover scrivere in anticipo un'ampia libreria di soglie e regole. È particolarmente credibile negli ambienti fortemente basati su Databricks, dove un rollout guidato da blueprint può contare più di una flessibilità generica.
L'impostazione del prodotto è semplice: profilare le tabelle, apprendere il comportamento normale, far emergere i cambiamenti insoliti e allegare abbastanza contesto perché gli engineer possano intervenire. Spesso è il modello giusto per le organizzazioni con troppi asset per tarare a mano ogni singolo monitor.
Quando Anomalo ha senso
Anomalo dà il meglio quando la velocità di copertura conta più di una personalizzazione profonda fin dal primo giorno. Se il vostro problema principale è “non sappiamo cosa si sta rompendo finché non ce lo dice il business”, un profiling automatico ampio può essere una prima mossa migliore di un lungo programma basato su regole.
La cautela riguarda il realismo nel procurement. I prezzi non sono pubblici e un posizionamento fortemente incentrato sull'AI può nascondere la variabilità dei costi finché non si arriva a un vero preventivo enterprise. Verificherei non solo l'adeguatezza delle funzionalità, ma anche quanto il modello commerciale resti prevedibile man mano che il perimetro monitorato si amplia. Non è un aspetto esclusivo di Anomalo, ma qui conta.
6. Acceldata

Acceldata adotta una visione più ampia rispetto alla maggior parte degli strumenti di Data Observability puri. Cerca di coprire in un'unica piattaforma stato di salute delle pipeline, Data Quality, drift, lineage e costi operativi. Questa ampiezza è utile quando il vostro vero problema non sono solo i dati errati, ma anche uno spostamento dei dati costoso, job poco performanti e una responsabilità frammentata tra i team di piattaforma.
È una delle poche opzioni in cui il FinOps entra a pieno titolo nella discussione d'acquisto. Se il vostro management vuole un unico punto in cui guardare affidabilità e costi, Acceldata è più facile da giustificare che mettere insieme tre strumenti sperando che i passaggi di consegna funzionino.
Perché i team lo scelgono
L'argomento più forte a favore di Acceldata è la riduzione della proliferazione di strumenti. Invece di un prodotto per le prestazioni delle pipeline, un altro per i controlli di qualità e un altro ancora per la visione dei costi, centralizzate una parte maggiore del modello operativo.
Questo comporta un compromesso evidente. Una piattaforma ampia richiede di solito un onboarding ponderato, una responsabilità più forte e processi interni più chiari per esprimere tutto il suo valore.
Più ampio è il perimetro della piattaforma di observability, più diventa importante il vostro modello operativo. Un'ampia copertura non serve se nessuno è responsabile della risoluzione.
Acceldata pubblica i livelli di piano per il suo Data Observability Cloud, offrendo agli acquirenti almeno un po' di trasparenza prima di una call commerciale. È un vantaggio piccolo ma significativo in un mercato in cui i prezzi spariscono spesso dietro i moduli di richiesta demo.
7. IBM Databand (IBM Data Observability by Databand)
IBM Databand è un'opzione sensata per la shortlist quando il vostro impegno sull'affidabilità dei dati è strettamente legato alle operazioni delle pipeline. Monitora run, task, dataset e SLA, e vi aggiunge anomaly detection, alerting e triage degli incidenti. In altre parole, parla la lingua dei team di orchestrazione tanto quanto quella dei team di Data Quality.
Questo è importante perché molti incidenti sui dati nascono come guasti di workflow e di tempistica, non solo come valori errati in una tabella. L'orientamento di Databand a warehouse e pipeline lo rende utile quando la domanda è “che cosa si è rotto nel percorso di esecuzione?” prima di “che cosa è derivato statisticamente?”
Un segnale pratico per l'acquisto
Il deployment self-hosted è uno dei motivi per cui IBM Databand merita l'attenzione delle grandi aziende. Molti confronti tra vendor sottovalutano ancora i vincoli di deployment, anche se alcune organizzazioni non possono adottare un modello SaaS interamente gestito dal vendor.
Anche l'ecosistema IBM fa parte del valore. Se usate già strumenti IBM o volete percorsi di integrazione con watsonx.data e con gli scheduler enterprise, Databand diventa più facile da rendere operativo. Il prezzo da pagare è un acquisto più complesso. Aspettatevi demo, preventivi e un processo di procurement più formale rispetto agli strumenti guidati dagli sviluppatori.
8. Metaplane
Metaplane si distingue perché il suo modello di prezzo è più facile da capire rispetto alla maggior parte dei prodotti di observability enterprise. Per i team piccoli e medi questo da solo cambia la dinamica d'acquisto. Potete stimare i costi, partire con un piano gratuito e aumentare le tabelle monitorate senza una lunga negoziazione iniziale.
Il prodotto è inoltre progettato per l'ergonomia del modern data stack. Controlli su freschezza, volume, distribuzione, univocità, valori nulli e schema, SQL personalizzato, monitoraggio di dbt e flussi orientati alla CI sono adatti ai team che vogliono un'observability integrata nell'analytics engineering quotidiana.
A cosa fare attenzione
I prezzi trasparenti rendono Metaplane una buona scelta iniziale, ma non cancellano i vincoli enterprise. I controlli avanzati di governance e sicurezza sono più completi nel piano Enterprise, quindi gli acquirenti regolamentati devono comunque esaminare con attenzione il livello superiore.
C'è anche un contesto di mercato da tenere presente. L'analisi dei vendor di Ramp mostra che l'adozione dell'observability nel mid-market è ancora guidata da strumenti infrastrutturali più ampi come Sentry e Datadog, mentre i vendor di pura Data Observability sono ancora in una fase più precoce della curva di adozione (adozione dei vendor di observability nel mid-market). È uno dei motivi per cui Metaplane funziona bene come punto di partenza accessibile. Va incontro ai team là dove si trovano, invece di presupporre che gestiscano già un programma formale di affidabilità enterprise.
9. Kensu
Kensu si adatta a uno scenario d'acquisto diverso rispetto agli strumenti di observability incentrati sul warehouse. Un team fa transitare i dati attraverso API, job Python, pipeline Spark e applicazioni interne, poi passa ore a ricostruire dove è stato introdotto un campo errato. Kensu è pensato per questo problema. Il suo approccio basato su agent offre observability all'interno del flusso dei dati, non solo dopo che i dati arrivano in un warehouse.
Questo design comporta compromessi reali. Ottenete un lineage più granulare e visibilità a runtime su codice applicativo e spostamento dei dati, ma vi fate carico anche del lavoro di strumentazione. Il coinvolgimento dell'engineering fa parte del modello operativo, quindi Kensu ha più senso per le organizzazioni che considerano già l'affidabilità dei dati una questione di engineering, non solo di analytics.
Il deployment è il punto chiave
Kensu è un'opzione seria per le aziende che gestiscono ambienti ibridi, multi-cloud o on-prem, in cui le regole su privacy e residenza dei dati definiscono la shortlist prima ancora del confronto delle funzionalità. In questi ambienti il modello di deployment è uno dei nove criteri che contano quanto l'anomaly detection o l'alerting. Un'esperienza SaaS curata è meno utile se i percorsi dei dati sensibili non possono lasciare un ambiente controllato.
È qui che Kensu si guadagna il suo posto in questa lista. È più adatto agli acquirenti che devono verificare come viene distribuita l'observability, quali metadati vengono raccolti e quanto il prodotto possa allinearsi ai confini di sicurezza interni. Per i team che confrontano gli strumenti in un'ottica di prontezza enterprise, questa distinzione conta più di una lunga griglia di funzionalità.
10. Lightup

Lightup si guadagna il suo posto perché copre sia il classico monitoraggio dei dati strutturati sia le più recenti esigenze di qualità legate alla GenAI. Non tutti i team ne hanno bisogno oggi, ma a sempre più team viene chiesto di monitorare dati non strutturati e flussi legati all'AI con la stessa serietà riservata alle tabelle del warehouse.
La piattaforma combina indicatori predefiniti, controlli multi-colonna, regole personalizzate, anomaly detection basata su AI, flussi di gestione degli incidenti e controlli di governance. Il deployment ibrido per i clienti enterprise la rende inoltre più rilevante degli strumenti solo cloud per gli ambienti sensibili.
Perché merita un posto
Lightup è uno degli esempi più chiari di come la categoria si stia muovendo verso piattaforme unificate. Gli acquirenti vogliono sempre più spesso anomaly detection, validazione basata su regole e funzionalità di governance in un'unica superficie operativa, invece di prodotti separati tenuti insieme dai processi.
Questo è in linea con il modo in cui l'anomaly detection viene tipicamente implementata. Gli approcci statistici comuni includono Z-Score e Interquartile Range: lo Z-Score individua gli outlier misurando la distanza dalla media, mentre l'IQR evidenzia le anomalie al di fuori della dispersione centrale di un dataset (metodi di anomaly detection nel monitoraggio della Data Quality). Per i team che valutano le promesse dei vendor sull'AI, la domanda utile non è se una piattaforma si definisce “ML-powered”. È se la qualità del rilevamento sia misurabile e regolabile per il vostro carico di lavoro.
I 10 migliori strumenti di Data Observability: confronto delle funzionalità
Prodotto | Funzionalità principali e qualità | Punti di forza distintivi | Deployment e privacy | Pubblico di riferimento | Prezzo e valore |
|---|---|---|---|---|---|
digna | Anomaly detection con AI, analytics storica, tempestività, validazione, schema tracker ★★★★ | ✨ Esecuzione nel database + apprendimento della baseline; 🏆 nessun accesso del vendor ai dati di produzione | 👥 Private cloud / on‑prem, i dati restano nell'infrastruttura del cliente | 👥 Data engineer, team di analytics e ML, warehouse enterprise | 💰 Su preventivo; time‑to‑value rapido (dall'installazione agli insight <2h) |
Monte Carlo | Observability end‑to‑end, lineage a livello di colonna, flussi di gestione incidenti ★★★★★ | ✨ Circuit Breakers e Agent Trust; 🏆 pioniere della categoria | Integrazioni cloud‑first; focus su SaaS enterprise | 👥 Grandi aziende, team di piattaforma, responsabili BI/ML | 💰 Vendita tramite commerciale; costo che cresce con il perimetro |
Bigeye | Monitoraggio automatico (freschezza, volume, schema), lineage, sicurezza ★★★★ | ✨ Opzione agentless in sola lettura; solido approccio alla sicurezza | Agentless o ibrido; controlli di sicurezza enterprise | 👥 Settori regolamentati e data team enterprise | 💰 Vendita tramite commerciale; posizionamento enterprise |
Soda (Core + Cloud) | Monitoraggio delle metriche, checks‑as‑code, alert, collaborazione ★★★★ | ✨ Soda Core open source + flusso di lavoro Cloud gestito | OSS in locale + Cloud SaaS per i team (privacy mista) | 👥 Sviluppatori e team che vogliono OSS + UI gestita | 💰 OSS gratuito; Cloud = prezzi personalizzati |
Anomalo | Profiling automatico, anomaly detection, validazione, lineage ★★★★ | ✨ Assistenti agentici (AIDA) e blueprint per Databricks | SaaS / integrazioni enterprise; promessa di configurazione rapida | 👥 Utenti Databricks, team di analytics | 💰 Vendita tramite commerciale; preventivi enterprise |
Acceldata | Data e AI observability + infrastruttura delle pipeline + FinOps ★★★★ | ✨ Vista unificata su infrastruttura, costi e dati; approccio metadata‑first | Deployment cloud ed enterprise; architettura scalabile | 👥 Team operativi e di data platform che hanno bisogno di costi e affidabilità | 💰 Livelli pubblicati per ADOC; Pro/Enterprise su preventivo |
IBM Databand | Monitoraggio di pipeline/run, validazioni dei dataset, lineage ★★★ | ✨ Integrazione nell'ecosistema IBM (watsonx), rilevamento ad autoapprendimento | Opzioni SaaS e self‑hosted; procurement enterprise | 👥 Grandi aziende, clienti IBM, utenti di orchestrazione | 💰 Prezzi enterprise tramite commerciale |
Metaplane | Freschezza, distribuzione, schema, lineage, Data CI/CD ★★★★ | ✨ Prezzi trasparenti basati sull'uso, piano gratuito, configurazione rapida | SaaS con ampia gamma di connettori; opzione di fatturazione tramite Snowflake | 👥 Team del modern data stack, startup che scalano le data ops | 💰 Pay‑as‑you‑grow; piano gratuito disponibile |
Kensu | Observability tramite agent nelle applicazioni, lineage a runtime, profiling ★★★ | ✨ Strumentazione edge/nel codice per i dati in movimento | Modello ad agent; solido supporto on‑prem e ibrido | 👥 Organizzazioni regolamentate, applicazioni embedded, infrastrutture ibride | 💰 Vendita tramite commerciale; preventivo necessario |
Lightup | Anomaly detection con AI, correlazione degli incidenti, controlli sui dati per GenAI ★★★★ | ✨ QA su dati strutturati + non strutturati; modelli di anomalia propri (BYO); integrazioni GenAI | Cloud e ibrido (Enterprise); integrazioni con cataloghi/ITSM | 👥 Team con pipeline GenAI e governance enterprise | 💰 Abbonamento annuale; su preventivo |
Guida alla decisione: scegliere il vostro strumento di Data Observability
Un aggiornamento della dashboard fallito alle 7:30 del mattino sembra di solito, all'inizio, un problema di pipeline. Alle 9:00 il problema di fondo può rivelarsi una modifica allo schema, una tabella a monte in ritardo o una regola di business errata che nessun rilevatore di anomalie avrebbe individuato da solo. Ecco perché scegliere uno strumento di Data Observability non è solo un confronto di funzionalità. È una decisione sul modello operativo.
I team più solidi valutano questi prodotti in base al rischio di rollout, non solo alla qualità della demo. Una configurazione SaaS rapida è importante. Lo sono anche i flussi di lavoro code-first. Ma per gli acquirenti enterprise, modello di deployment, controlli sulla privacy e revisione di sicurezza decidono spesso la shortlist prima che qualcuno valuti i grafici delle anomalie. Uno strumento che sembra forte in una trial può comunque non superare il procurement se richiede un ampio accesso del vendor ai dati di produzione o non può girare all'interno del vostro perimetro cloud.
I nove criteri di questa guida aiutano a distinguere questi casi:
Qualità dell'anomaly detection: il sistema apprende il comportamento normale abbastanza bene da ridurre il rumore degli alert e la taratura delle soglie?
Profondità della validazione: i team possono applicare regole di business esplicite a livello di riga, tabella e pipeline?
Copertura della tempestività: intercetta dataset obsoleti, SLA mancati e consegne in ritardo prima che gli utenti a valle agiscano sulla base di presupposti errati?
Monitoraggio degli schemi: rileva le modifiche strutturali abbastanza presto da proteggere modelli, dashboard e job dipendenti?
Contesto di lineage: gli engineer possono risalire all'impatto e alla causa principale senza ricostruire a mano le dipendenze?
Modello di deployment: il prodotto è solo SaaS o può girare in ambienti private cloud, ibridi o on-prem?
Approccio alla privacy: l'architettura mantiene i dati sensibili nel vostro ambiente o metadati e campioni di dati ne escono?
Scalabilità: può supportare grandi warehouse, architetture lakehouse e orchestrazioni complesse senza aggiungere un altro sistema da mantenere?
Chiarezza dei prezzi: il team può stimare i costi prima che l'utilizzo cresca tra domini e ambienti?
Le promesse sull'AI richiedono la stessa disciplina. La domanda utile è se la qualità del rilevamento regge rispetto ai vostri schemi di dati, alla vostra tolleranza ai falsi positivi e al vostro processo di gestione degli incidenti. I team che vogliono un framework di test più rigoroso possono esaminare le metriche comuni di anomaly detection come precision, recall, F1-score e AUC-ROC in questa spiegazione delle metriche di valutazione dell'anomaly detection.
Negli ambienti regolamentati la scelta dello strumento si restringe di solito ulteriormente. Supporto private cloud, esecuzione nel database e spostamento limitato dei dati smettono di essere aspetti secondari e diventano criteri di selezione. È uno dei motivi per cui digna merita un'analisi attenta nelle valutazioni enterprise. Come già accennato, il suo approccio si basa sull'esecuzione dell'analisi all'interno dell'ambiente del cliente, coprendo in un'unica piattaforma anomaly detection, tempestività, monitoraggio degli schemi, analisi storica e validazione a livello di record.
Questo design ha un vantaggio pratico. I team non devono suddividere i requisiti di observability e di privacy tra prodotti separati, e la revisione di sicurezza è più semplice quando i dati di produzione restano sotto controllo interno.
Se il vostro team ha bisogno di Data Observability senza inviare dati di produzione a un ambiente gestito dal vendor, prenotate una demo di digna e valutate la piattaforma rispetto ai vostri reali requisiti di deployment, privacy e validazione.
Domande frequenti
Che cosa sono gli strumenti di Data Observability?
Monitorano il comportamento di dati e pipeline nel tempo, tenendo traccia di freschezza, volume, distribuzione, schema e lineage, e generano alert quando il comportamento si discosta dalla norma appresa. Sono progettati per intercettare i guasti che superano ogni test esplicito.
Quali sono i cinque pilastri della Data Observability?
Freschezza, cioè se i dati sono arrivati quando previsto; volume, se la quantità è normale; distribuzione, se i valori hanno l'aspetto consueto; schema, se la struttura è cambiata; e lineage, che collega un problema alla sua origine e ai suoi consumatori a valle.
Come si sceglie uno strumento di Data Observability?
Decidete innanzitutto se, per motivi di governance, i controlli devono girare all'interno del vostro database, perché questo include o esclude subito diverse opzioni. Poi testate il rilevamento su un incidente reale che avete avuto ed esaminate come una segnalazione viene instradata a un responsabile.
Gli strumenti di observability sostituiscono le regole di Data Quality?
No. L'observability rileva i comportamenti inattesi; le regole applicano vincoli di business noti. Una regola può stabilire che un importo non deve mai essere negativo, cosa che nessun apprendimento comportamentale potrà dedurre. I due livelli sono complementari e la maggior parte dei team li usa entrambi.
Perché gli alert sul successo delle pipeline non colgono i problemi dei dati?
Perché riferiscono sull'esecuzione dei job, non sul significato dei dati. Il job del warehouse è stato eseguito, la dashboard si è caricata e nessuno è stato allertato, eppure i ricavi sono stati sbagliati per ore perché una fonte a monte aveva cambiato forma. Solo il monitoraggio dei dati stessi fa emergere questo tipo di problema.


