Il miglior software per la qualità dei dati: guida 2026
|
7
min di lettura

Probabilmente conoscete la sensazione. Giovedì una dashboard sembrava a posto, poi lunedì mattina i numeri non tornano, il team inizia a fare domande e la causa principale si rivela essere una pipeline arrivata in ritardo o una modifica allo schema che nessuno ha notato. In quel momento il software per la qualità dei dati non è uno strumento di pulizia: è il livello di controllo che vi dice se i dati sono ancora abbastanza affidabili da poter essere usati.
Le piattaforme moderne fanno molto più che rimuovere duplicati o standardizzare i campi. Sorvegliano anomalie, dati mancanti, schema drift e problemi di aggiornamento, quindi fanno emergere i problemi prima che si propaghino nei flussi di BI, analytics o machine learning. Questo passaggio dalla pulizia una tantum al monitoraggio continuo fa parte dell'evoluzione del settore, e la rassegna del 2022 pubblicata su Frontiers in Big Data descrive quattro fasi, dalla ricostruzione dello stato fino al monitoraggio continuo della qualità dei dati, con radici in lavori che risalgono al 1999, 2007, 2009 e 2019. Anche la descrizione di IBM di una piattaforma di qualità dei dati è in linea con questo ruolo più ampio: un software che aiuta le organizzazioni a identificare, valutare, pulire, monitorare e convalidare i dati affinché restino accurati, completi, coerenti, pertinenti e tempestivi. La rassegna di Frontiers in Big Data e la panoramica di IBM sulle piattaforme di qualità dei dati descrivono bene questo cambiamento.
Indice
Le funzionalità di base che ogni piattaforma moderna dovrebbe coprire
Validazione basata su regole e osservabilità continua a confronto
Come valutare un software per la qualità dei dati per il vostro stack
Cosa fa davvero oggi il software per la qualità dei dati
Una dashboard del lunedì mattina che si è rotta il venerdì spesso non è rotta in modo evidente. La tabella può ancora caricarsi, le query possono ancora essere eseguite e il report può ancora aprirsi, ma i numeri possono essere obsoleti perché i dati sono arrivati con ore di ritardo o un feed ha cambiato forma senza preavviso. Il moderno software per la qualità dei dati è passato da “sistemare il disordine più tardi” a sorvegliare la pipeline mentre è in esecuzione.
Dalla pulizia in batch al monitoraggio continuo
Una definizione operativa utile parte dalle basi. Una piattaforma profila i dati, convalida i record, monitora le pipeline e aiuta i team a correggere i problemi prima che i dati errati si diffondano. IBM descrive una piattaforma di qualità dei dati in questo senso operativo, e la storia della ricerca nel settore mostra come la categoria sia cresciuta dai primi lavori di pulizia fino al monitoraggio continuo della qualità dei dati.
Questa evoluzione conta perché oggi molti team gestiscono contemporaneamente warehouse, data lake, aggiornamenti pianificati, job di streaming e feed per i modelli. In questo contesto, una singola sorgente in ritardo può far sembrare corretta una dashboard rendendola invece sbagliata.
Regola pratica: se i dati possono rompersi dopo essere arrivati, il software deve continuare a sorvegliarli anche dopo la fine del caricamento.
I quattro compiti che spesso vengono confusi
Spesso si dice “qualità dei dati” intendendo diversi compiti distinti. La profilazione esamina l'aspetto attuale dei dati, la pulizia modifica i dati per correggere problemi noti, la validazione verifica se i record rispettano le regole e il monitoraggio continua a controllare nel tempo, così i nuovi problemi vengono intercettati per tempo. La confusione nasce di solito quando i team acquistano uno strumento per uno di questi compiti e si aspettano che copra anche gli altri.
Un'analogia semplice aiuta. Un rilevatore di fumo, un kit di riparazione, un'ispezione dell'edificio e un sistema di videosorveglianza riguardano tutti la sicurezza, ma nessuno fa lo stesso lavoro. Il software per la qualità dei dati funziona allo stesso modo tra analytics, BI e pipeline di machine learning. Se uno schema cambia, un feed si blocca o una metrica si allontana improvvisamente dal suo andamento normale, la piattaforma dovrebbe segnalarlo prima che gli stakeholder prendano decisioni basate su quei dati.

Le funzionalità di base che ogni piattaforma moderna dovrebbe coprire
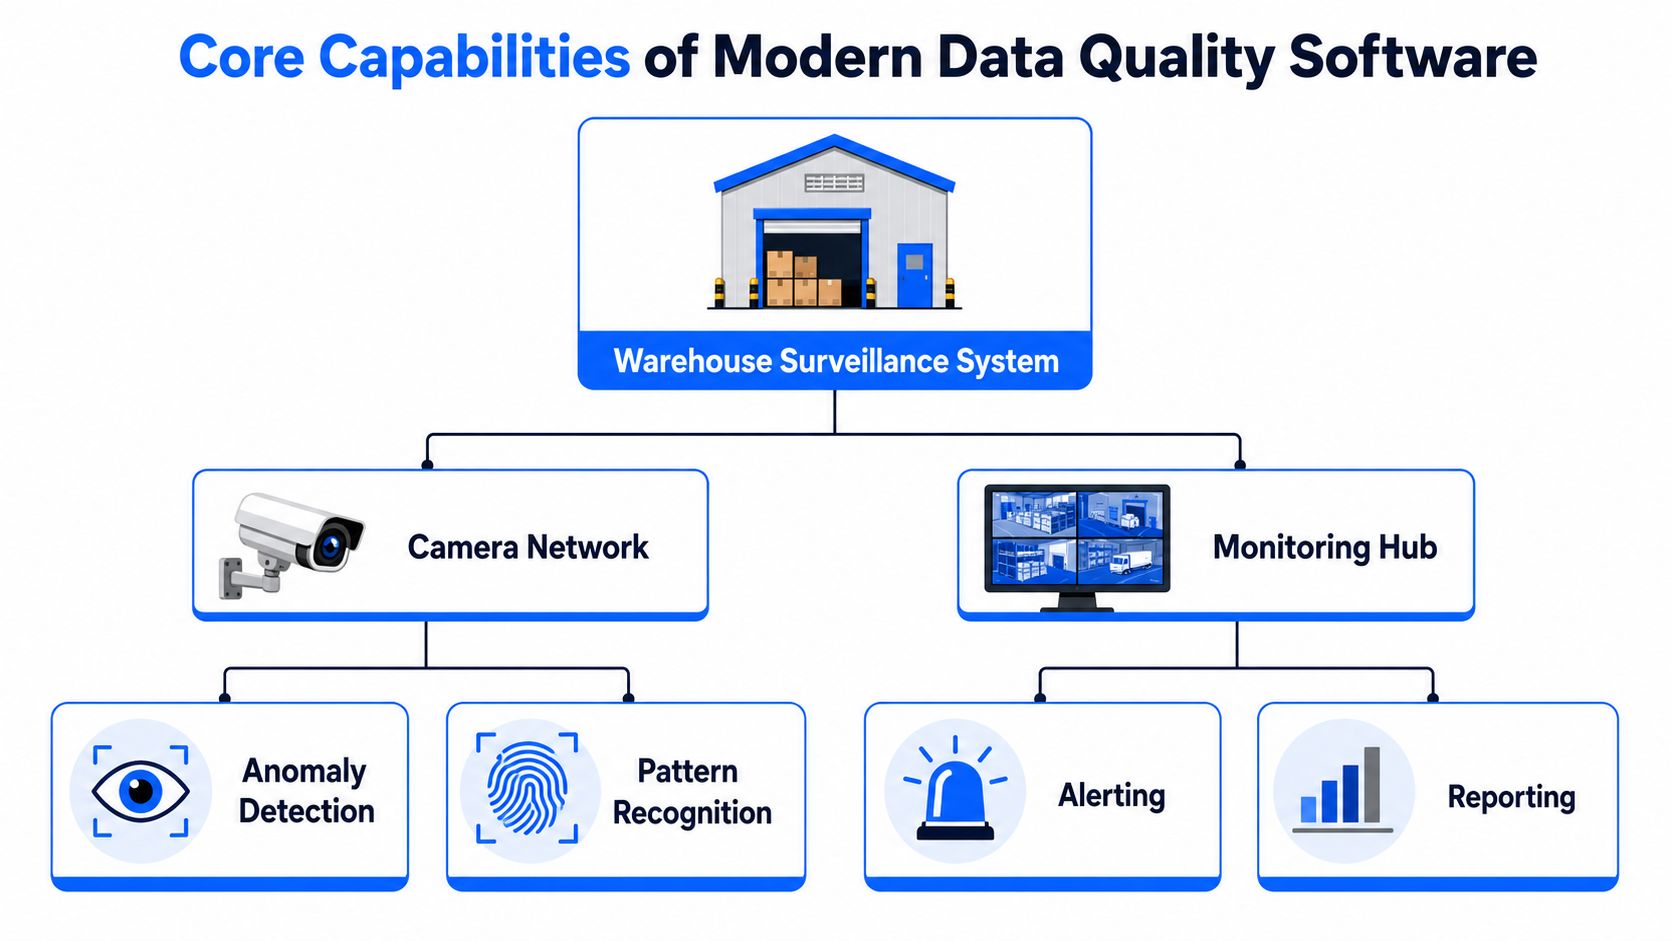
Un sistema di videocamere per un magazzino funziona solo se fa più che inquadrare un corridoio. Servono videocamere, alert, una console di monitoraggio e un processo di risposta che dica alle persone cosa fare dopo. Il software per la qualità dei dati funziona allo stesso modo, perché una singola funzionalità raramente copre l'intero problema.
Le funzionalità che contano nella pratica
Il rilevamento delle anomalie apprende com'è l'attività normale e segnala le variazioni insolite. Intercetta un calo improvviso del numero di righe, una metrica che inizia a derivare senza che una regola sia cambiata o un feed che si comporta diversamente dal solito. La validazione è il livello delle regole. Verifica se un record soddisfa un requisito di business, ad esempio che un campo obbligatorio sia compilato o che un valore resti entro un intervallo ammesso. La tempestività verifica se i dati sono arrivati secondo i tempi previsti, il che aiuta a evitare che un report diventi obsoleto prima che qualcuno se ne accorga.
Lo schema tracking gestisce i cambiamenti strutturali. Se una colonna compare, scompare o cambia tipo, la piattaforma dovrebbe segnalarlo rapidamente, perché i job a valle potrebbero fallire o continuare a funzionare con un presupposto sbagliato. La Data Analytics sulle metriche di osservabilità aggiunge la prospettiva storica, così i team possono individuare i trend invece di reagire solo ad alert isolati. Queste funzionalità corrispondono alle dimensioni standard della qualità: completezza, tempestività, validità, integrità, unicità e coerenza. La panoramica di Alation sulle dimensioni della qualità dei dati è un utile punto di riferimento per questo framework.
Regola pratica: se una piattaforma non sa dirvi cosa è cambiato, quando è cambiato e se quel cambiamento riguarda gli utenti a valle, sta risolvendo solo una parte del problema.
Perché queste funzioni vanno insieme
Un errore comune è acquistare strumenti separati per profilazione, alert, validazione e correzione. Questa suddivisione sembra ordinata sulla carta, ma crea punti ciechi in produzione, perché ogni strumento vede solo una parte del flusso di lavoro. Le piattaforme moderne trattano l'intera catena come un unico sistema: prima ispezionare, poi confrontare, poi generare l'alert e infine aiutare nella risposta.
I prodotti più solidi combinano inoltre il rilevamento automatico con controlli che tengono conto del business. Questo conta perché lo stesso dataset può essere tecnicamente valido e comunque operativamente sbagliato per il business. Un campo pulito non serve a nulla se è arrivato troppo tardi per la previsione o se non corrisponde più alla forma che un modello a valle si aspetta.
Dove viene eseguito il software e perché è importante
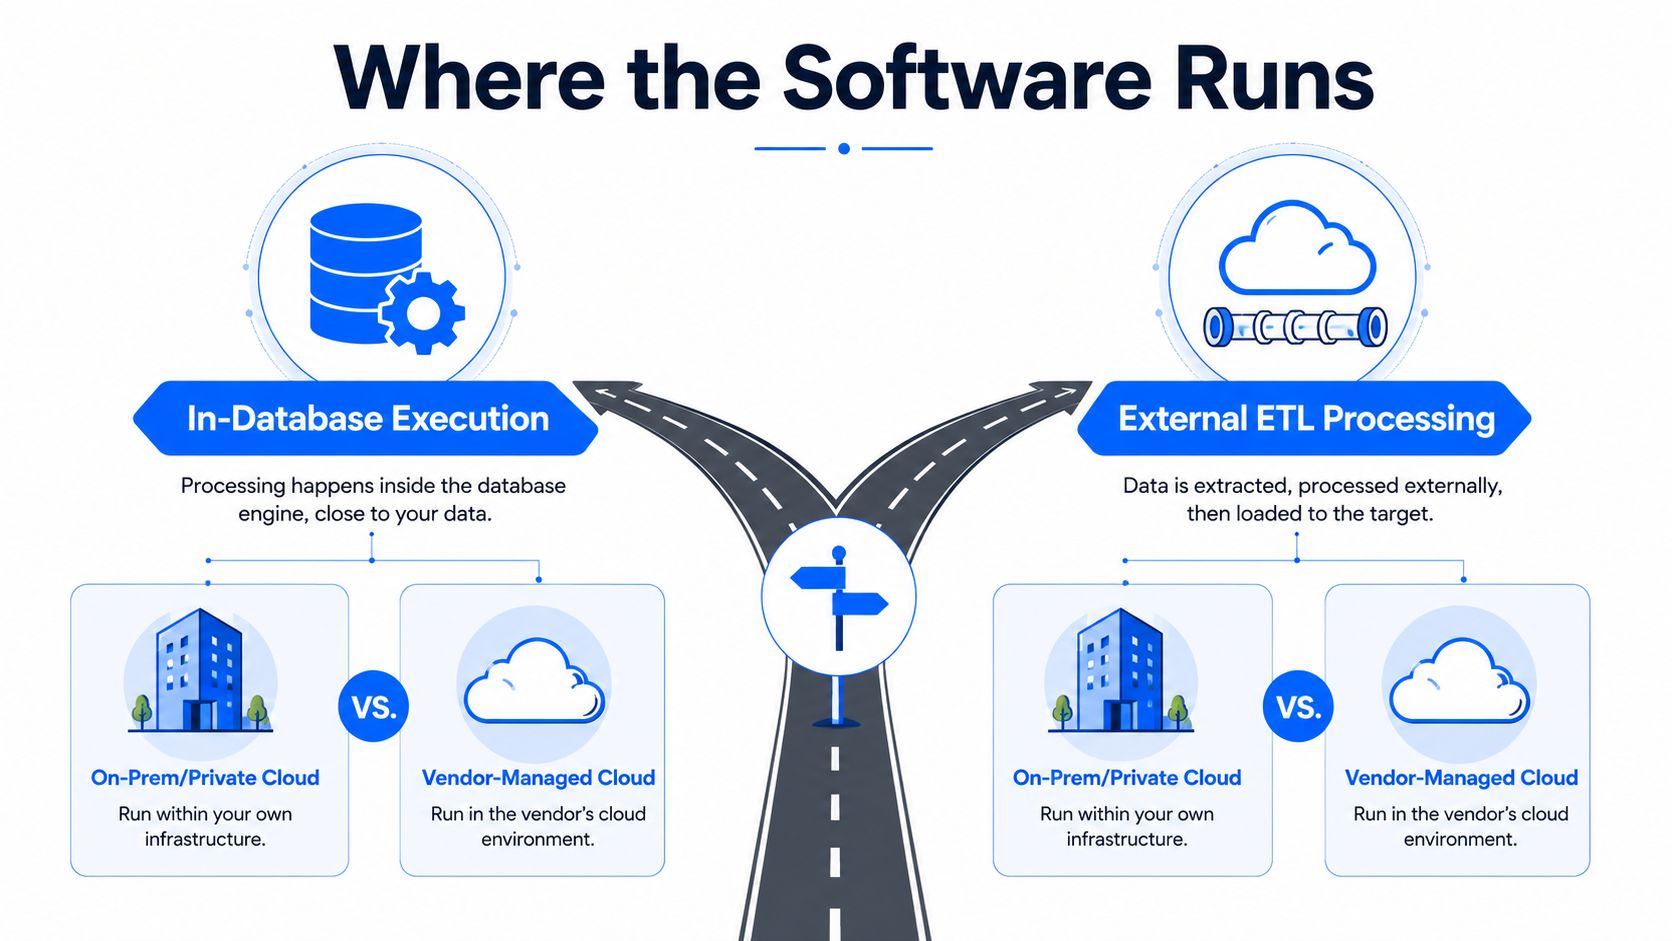
La demo di un fornitore può sembrare convincente e fallire comunque una vera valutazione di acquisto se i controlli vengono eseguiti nel posto sbagliato. Se la piattaforma copia dati sensibili in un altro sistema, o li fa passare attraverso livelli di elaborazione aggiuntivi prima dell'ispezione, il problema diventa l'architettura stessa. Per i team soggetti a regolamentazione non è una questione secondaria, ma parte della decisione di acquisto.
Esecuzione nel database o elaborazione esterna
L'analogia più semplice è l'ispezione di un edificio. L'esecuzione nel database manda gli ispettori nell'edificio, così possono verificare tutto sul posto. L'elaborazione ETL esterna invia prima i materiali a un laboratorio, il che aggiunge spostamenti, ritardi ed esposizione. Lo stesso concetto vale per le piattaforme dati, perché eseguire i controlli all'interno del warehouse o del database riduce lo spostamento dei dati e lascia al cliente il controllo dell'ambiente.
Questo design conta soprattutto nei deployment in cloud privato e on-premises, dove il fornitore non dovrebbe aver bisogno di accedere ai dataset di produzione. I team di finanza, sanità, telecomunicazioni e settore pubblico tengono a sovranità, audit trail e controllo degli accessi, quindi hanno bisogno di una piattaforma che si adatti a questi vincoli invece di aggirarli. Il framework di Gartner sottolinea la connettività tra sorgenti on-premises e cloud, ed è per questo che la flessibilità di deployment deve far parte della shortlist fin dal primo giorno. Le recensioni Gartner sulle soluzioni di augmented data quality riflettono questa aspettativa di connettività.
La scala cambia la scelta architetturale
Su scala enterprise, la domanda non è se una demo funziona su una tabella, ma se la piattaforma può monitorare warehouse e data lake ad alto volume senza costringere i team a creare un progetto separato per ogni dataset. I controlli nel database aiutano perché permettono di monitorare i dati dove risiedono già, invece di duplicare la pipeline solo per ispezionarla.
Un'azienda regolamentata dovrebbe porre una domanda diretta: questa piattaforma può essere eseguita dove si trovano già i dati, senza concedere al fornitore l'accesso alla produzione?
Questa domanda spesso rivela il compromesso di fondo. Un servizio cloud gestito dal fornitore può sembrare più semplice nei materiali commerciali, ma un deployment controllato dal cliente può fare la differenza tra adozione e rifiuto quando entrano in gioco i team legali, di sicurezza o di audit. Per molte organizzazioni il modello di deployment non è un dettaglio di implementazione: è il cancello che stabilisce se lo strumento può essere usato o meno.
La pagina di digna sul monitoraggio della qualità dei dati è un esempio di come il monitoraggio venga spesso inquadrato come un controllo continuo e non come una verifica una tantum.
Validazione basata su regole e osservabilità continua a confronto
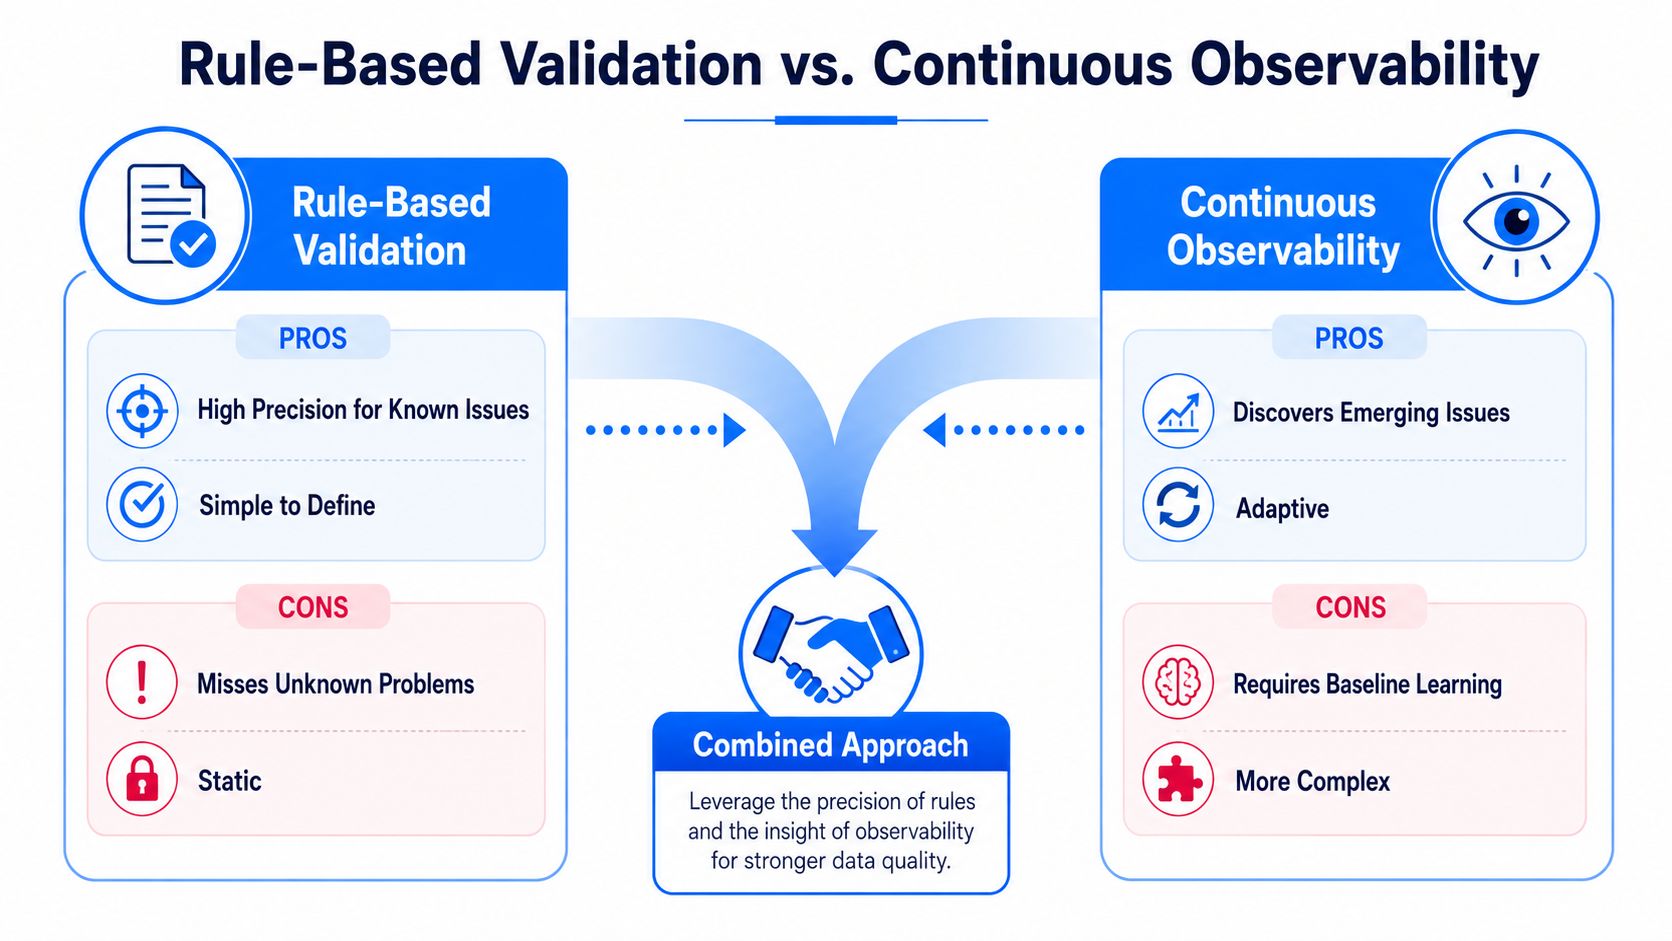
I team di solito si bloccano qui perché i due approcci sembrano rivali. Non lo sono. La validazione basata su regole intercetta con precisione le modalità di guasto note, mentre l'osservabilità continua intercetta i problemi che nessuno aveva pensato di tradurre in una regola.
Perché entrambi gli approcci meritano un posto
La validazione è come un correttore ortografico: se sapete che la parola è scritta male, individua l'errore in modo affidabile. L'osservabilità somiglia di più a un rilevatore di fumo: apprende l'andamento normale e vi avvisa quando qualcosa cambia in un modo che non corrisponde alla baseline. Le indicazioni del settore favoriscono sempre più un modello ibrido, perché i test basati su contratti intercettano i problemi noti, mentre l'osservabilità intercetta quelli sconosciuti. Anche l'impostazione di Gartner sull'augmented data quality riunisce questi elementi: profilazione, monitoraggio, individuazione delle regole e rilevamento delle anomalie basato su AI o ML. La guida di Soda a framework e strumenti è utile perché riflette il modo in cui i professionisti stanno combinando i due approcci.
Questo modello ibrido conta soprattutto su larga scala. In un team piccolo, pochi controlli codificati a mano possono coprire molto terreno. In una grande azienda con sorgenti cloud e on-premises, più domini e pipeline in continuo cambiamento, un set di regole statico si trasforma in un lavoro di manutenzione che cresce più rapidamente del patrimonio di dati stesso. La pagina di digna sul monitoraggio della qualità dei dati è un esempio di approccio orientato al monitoraggio costruito attorno a questa combinazione.
Cosa sfugge se ne scegliete solo uno
Uno strumento solo di validazione può dirvi che una regola non è stata rispettata, ma non necessariamente che sta emergendo un nuovo schema di errore. Uno strumento solo di osservabilità può far emergere l'andamento insolito, ma potrebbe non applicare la regola di business di cui il team di compliance ha bisogno. Questa lacuna di copertura è il motivo per cui gli acquirenti dovrebbero ragionare per livelli, non per schieramenti.
Negli ambienti regolamentati o in rapida evoluzione, la migliore domanda operativa è semplice: la piattaforma ci aiuta a rilevare sia i guasti attesi sia le derive inattese? Se la risposta è sì, il team passa meno tempo a discutere di strumenti e più tempo a risolvere il problema reale.
Come valutare un software per la qualità dei dati per il vostro stack
La demo di un fornitore può far sembrare competente quasi qualsiasi piattaforma. La domanda più difficile è se sia in grado di gestire le vostre tabelle, i vostri calendari, le vostre regole di accesso e le vostre modalità di guasto senza diventare l'ennesimo strumento che solo uno specialista sa usare. Partite dalla stessa checklist per ogni fornitore, così confrontate l'adeguatezza reale invece di slide commerciali patinate.
Una checklist di valutazione pratica
Criterio | Perché è importante | Cosa chiedere al fornitore |
|---|---|---|
Copertura delle dimensioni della qualità | Un solo tipo di controllo non basta. Serve copertura per completezza, tempestività, validità, integrità, unicità e coerenza, perché ciascuna intercetta una diversa classe di guasti. | Quali dimensioni sono coperte nativamente e quali richiedono sviluppi personalizzati? |
Esecuzione nel database | Mantenere i controlli vicino ai dati riduce gli spostamenti e aiuta gli ambienti privati a restare privati. | I controlli vengono eseguiti all'interno del warehouse o del database, e quali dati escono dall'ambiente? |
Flessibilità di deployment | I team regolamentati hanno spesso bisogno di opzioni in cloud privato o on-premises, non di un percorso SaaS uguale per tutti. | La piattaforma può funzionare senza che il fornitore acceda ai dataset di produzione? |
Consapevolezza di schema e lineage | Se una metrica si rompe dopo una modifica allo schema, dovete vedere la causa a monte, non solo l'output compromesso. | Lo strumento può tracciare i problemi lungo il lineage e mostrare il job a monte interessato? |
Monitoraggio di tempestività e SLA | I dati possono essere strutturalmente validi ed essere comunque inutili se arrivano in ritardo. Una dashboard aggiornata e una obsoleta rappresentano rischi di business diversi. | Può monitorare l'aggiornamento rispetto ai calendari e ai tempi di consegna previsti? |
Gestione delle regole e validazione | I team di business hanno ancora bisogno di controlli espliciti per la compliance e per la logica nota, soprattutto dove le eccezioni non sono accettabili. | Come vengono create, versionate, testate e mantenute le regole? |
Integrazione con warehouse e pipeline | Uno strumento che non si adatta al vostro stack di solito si arena nell'adozione. | Quali warehouse, data lake e strumenti di orchestrazione sono supportati nativamente? |
Una buona valutazione considera la piattaforma come un sistema, non come una checklist. Le metriche di qualità dei dati che tracciate dovrebbero corrispondere alle modalità di guasto che vi interessano, perché rilevamento delle anomalie, validazione, tempestività e schema tracking rispondono ciascuno a una domanda diversa. Il mercato è più ampio della sola pulizia. Mordor Intelligence ha stimato il mercato globale degli strumenti per la qualità dei dati in 3,27 miliardi di dollari nel 2026, e i criteri d'acquisto di Gartner mostrano come le soluzioni vengano ora valutate su profilazione, pulizia, analisi e visualizzazione, workflow, gestione delle regole, metadati e lineage, monitoraggio e rilevamento. Il report di mercato di Mordor Intelligence è utile per comprendere l'ampiezza della categoria, mentre la pagina delle recensioni ADQ di Gartner mostra la prospettiva di valutazione adottata dagli acquirenti enterprise.
Prima di approvare un proof of value, mettete alla prova la piattaforma sui vostri schemi e sui vostri casi limite. Un dataset demo patinato nasconde troppo. Volumi reali, controlli di accesso reali e rumore reale delle pipeline mostreranno se il sistema è in grado di supportare la conversione sicura dei dati per i team nei flussi di lavoro sensibili, o se funziona solo quando l'ambiente viene semplificato per la dimostrazione.
Chiedete un proof of value sui vostri schemi, non su un dataset demo patinato. Volumi reali e casi limite reali rivelano di più in una settimana di quanto faccia in un'ora una presentazione guidata da copione.
Casi d'uso reali e i problemi che risolvono
Il caso d'uso più chiaro è di solito quello che ha già fatto male. Quando una dashboard diventa obsoleta, una tabella di feature per il ML deriva o un report di compliance contiene record errati, la domanda smette di essere “Cosa può fare la piattaforma?” e diventa “Quale controllo lo avrebbe intercettato prima?”
Come si presentano i problemi in produzione
ITSV, la spina dorsale IT della previdenza sociale austriaca, ha sostituito 9.000 regole scritte a mano con un monitoraggio delle anomalie e della tempestività basato sull'AI, a dimostrazione di come un grande team possa passare da una manutenzione infinita delle regole a un sistema che sorveglia i cambiamenti in modo continuo. Questo tipo di cambiamento conta perché i controlli manuali non scalano bene quando il patrimonio di dati continua a crescere e il team non riesce a scrivere test per ogni nuova tabella.
Tre schemi si ripresentano di continuo. Primo, le pipeline di AI e ML hanno bisogno di protezione dalla deriva silenziosa e dalle modifiche allo schema, perché i modelli possono fallire anche quando i job a monte vanno tecnicamente a buon fine. Secondo, le dashboard per il management richiedono il monitoraggio della tempestività, così gli utenti di business non prendono decisioni sulla base di caricamenti obsoleti. Terzo, i flussi di lavoro soggetti a molti audit richiedono una validazione a livello di record, così i team possono dimostrare che i dati rispettavano le regole di business prima di arrivare in un report o in un processo di controllo.
Associare i problemi ai componenti
L'associazione con i componenti è semplice:
Data Anomalies aiuta a intercettare derive e comportamenti inattesi prima che raggiungano un modello o un report.
Timeliness fa emergere arrivi in ritardo e scadenze mancate.
Schema Tracker segnala colonne aggiunte, colonne rimosse o modifiche di tipo.
Data Validation supporta i controlli di compliance e le regole di business a livello di record.
Questi quattro elementi funzionano insieme perché ciascuno risolve una diversa modalità di guasto. Se il feed è puntuale ma lo schema è cambiato, la dashboard può comunque rompersi. Se lo schema è stabile ma le righe sono incomplete, un modello può comunque degradarsi.
Per i team che gestiscono file finanziari, documenti contrattuali o dati sorgente convertiti, un complemento pratico è la conversione sicura dei dati per i team, soprattutto quando il primo passo consiste nel portare input strutturati in un flusso di lavoro controllato prima che inizino i controlli di qualità.
Pilota, integrazione e dimostrazione del ROI
Un progetto pilota che cerca di monitorare tutto di solito non dimostra nulla. Partite da una manciata di tabelle importanti per il management, le operations o la compliance, poi misurate se la piattaforma intercetta i problemi che contano nel vostro ambiente.
Un piano pilota per il primo trimestre
Definite prima il perimetro. Scegliete un piccolo insieme di tabelle ad alto impatto, idealmente quelle che alimentano una dashboard, un modello e un flusso di lavoro di compliance o finanza. Poi definite le metriche di successo prima di attivare qualsiasi cosa, perché un pilota senza obiettivi si trasforma in un tour delle funzionalità.
Le metriche più utili sono quelle operative. Tracciate quanto tempo serve per rilevare un problema di aggiornamento, quale parte del patrimonio critico è coperta dal rilevamento delle anomalie, quante ore di manutenzione manuale delle regole vengono eliminate e quanti incidenti a valle evitate nelle dashboard o nei modelli di ML. Se il fornitore non supporta un'analisi delle cause principali basata sul lineage, chiedete quanto rapidamente il team può risalire dal problema alla modifica a monte che lo ha causato.
Fase del pilota | Cosa fare | Cosa misurare |
|---|---|---|
Definire il perimetro dei dati | Scegliete un piccolo insieme di tabelle con un impatto di business reale. | Copertura dei percorsi critici. |
Definire gli alert | Decidete quali problemi devono generare una notifica. | Velocità di rilevamento e precisione degli alert. |
Integrare con lo stack | Collegate warehouse, data lake e strumenti di pipeline. | Tempo necessario per il primo segnale utilizzabile. |
Eseguire con carico reale | Usate volumi e calendari simili a quelli di produzione. | Problemi non rilevati e falsi allarmi. |
Decidere sul rollout | Confrontate i risultati con il processo di riferimento. | Riduzione dell'impegno manuale e incidenti evitati. |
Una tempistica realistica aiuta a ottenere il consenso interno. Usate uno sprint di definizione del perimetro di 30 giorni per concordare tabelle, accessi e metriche. Proseguite con un proof of value di 60 giorni sui vostri dati. Poi usate un punto di decisione a 90 giorni per stabilire se la piattaforma merita un rollout più ampio.
Governance, privacy e il vostro prossimo passo
La qualità dei dati funziona meglio quando non vive al di fuori della governance. Segnali di qualità, metadati, lineage, controllo degli accessi e audit trail dovrebbero alimentare lo stesso catalogo e lo stesso livello di policy, perché i team hanno bisogno di un unico posto per capire quali dati esistono, da dove provengono e se è sicuro usarli.
È anche qui che la privacy diventa concreta. Se la piattaforma viene eseguita nell'ambiente del cliente, mantiene i dati nell'ambiente del cliente e non richiede al fornitore l'accesso ai dataset di produzione, diventa molto più facile inserirla nei modelli operativi regolamentati. Per i team in cloud privato e on-premises, questa differenza può determinare se un pilota va avanti o muore nella revisione di sicurezza.
Il prossimo passo più chiaro è semplice. Questa settimana elencate le dashboard o i modelli il cui malfunzionamento farebbe più danni, individuate le tabelle sottostanti e usate questo elenco per definire il vostro primo pilota. Poi coinvolgete governance, ingegneria e analytics nella stessa conversazione, così la valutazione riflette il modo in cui la piattaforma verrà usata, non solo come appare in una demo.
Se volete una piattaforma in linea con questa visione operativa della qualità dei dati, esplorate digna. Si concentra su rilevamento delle anomalie, validazione, tempestività e schema tracking, e viene eseguita all'interno dell'ambiente del cliente. Usatela per vedere come un approccio in cloud privato o on-premises cambia il modo in cui il vostro team monitora i dati critici.
Poiché l'integrazione nativa con i vostri warehouse e le vostre pipeline è uno dei criteri di valutazione indicati sopra, verificate i database e le piattaforme con cui digna si integra prima di definire le tabelle del vostro pilota.
Domande frequenti
Cosa fa un software per la qualità dei dati?
Il moderno software per la qualità dei dati profila i dati, convalida i record, monitora le pipeline e aiuta i team a correggere i problemi prima che i dati errati si diffondano. È passato dalla pulizia una tantum al monitoraggio continuo, sorvegliando anomalie, dati mancanti, schema drift e problemi di aggiornamento, così un feed obsoleto o modificato viene intercettato prima di raggiungere BI, analytics o ML.
Qual è la differenza tra validazione basata su regole e data observability?
La validazione intercetta con precisione le modalità di guasto note, come un correttore ortografico, mentre l'osservabilità apprende l'andamento normale e genera alert sui cambiamenti inattesi, come un rilevatore di fumo. L'articolo raccomanda un approccio ibrido: test in stile contratto per le regole di cui hanno bisogno i team di compliance, più il rilevamento delle anomalie per le derive che nessuno aveva pensato di codificare.
Perché l'esecuzione nel database è importante nella scelta di uno strumento per la qualità dei dati?
Eseguire i controlli all'interno del warehouse o del database evita di copiare dati sensibili in un altro sistema, riducendo spostamenti, ritardi ed esposizione. Per i team regolamentati di finanza, sanità, telecomunicazioni e settore pubblico, la domanda decisiva è se la piattaforma può essere eseguita dove i dati risiedono già senza concedere al fornitore l'accesso alla produzione.
Quanto dovrebbe durare il pilota di un software per la qualità dei dati?
L'articolo suggerisce uno sprint di definizione del perimetro di 30 giorni per concordare tabelle, accessi e metriche, un proof of value di 60 giorni sui vostri dati e poi un punto di decisione a 90 giorni su un rollout più ampio. Misurate la velocità di rilevamento, la copertura delle tabelle critiche, le ore di manutenzione delle regole risparmiate e gli incidenti a valle evitati.
Quali criteri usare per valutare un software per la qualità dei dati?
Usate la stessa checklist per ogni fornitore: copertura di completezza, tempestività, validità, integrità, unicità e coerenza; esecuzione nel database; flessibilità di deployment; consapevolezza di schema e lineage; monitoraggio dell'aggiornamento e degli SLA; gestione delle regole; integrazione nativa con i vostri warehouse e le vostre pipeline. Fate sempre i test sui vostri schemi, non su un dataset demo patinato.


