Software per data pipeline: come sceglierlo per scalabilità e affidabilità
|
7
min di lettura
La dashboard dei ricavi trimestrali sembra sbagliata. Il team commerciale insiste che i contratti sono stati chiusi nei tempi previsti. La finanza dice che i numeri del data warehouse non tornano. I job della pipeline sono tutti verdi, quindi il primo istinto è dare la colpa alla logica di reporting. Nelle grandi aziende, spesso è proprio questa la trappola. La dashboard non è sbagliata perché la BI si è rotta. È sbagliata perché dati errati sono arrivati in orario, hanno superato i controlli di base e hanno contaminato tutto ciò che sta a valle.
Ecco perché il software per data pipeline merita più attenzione di quanta ne riceva di solito. La maggior parte delle guide all'acquisto si concentra sui connettori, sul confronto tra batch e streaming e sulla capacità di uno strumento di spostare righe da un punto all'altro. Sono aspetti importanti. Ma su scala enterprise, la parte difficile è l'ultimo miglio: dimostrare che i dati sono ancora affidabili dopo essere stati spostati, trasformati, uniti e caricati in sistemi da cui dirigenti e modelli dipendono ogni giorno.
Indice
Che cos'è, in fondo, il software per data pipeline
Il software per data pipeline è il meccanismo che sposta i dati dai sistemi sorgente verso i luoghi in cui persone e applicazioni possono utilizzarli. Sembra semplice finché non se ne mappa la complessità: esportazioni dal CRM, tabelle ERP, flussi di eventi, API SaaS, modelli del data warehouse, file del data lake, telemetria di sicurezza e feature dei modelli, tutti in movimento con tempistiche diverse e profili di qualità diversi.
Un modello mentale migliore è quello della catena di montaggio. La materia prima arriva da molti fornitori. La linea la smista, la pulisce, la rimodella, la combina con altri input e invia il prodotto finito alla destinazione giusta. Se una stazione si guasta in modo evidente, gli ingegneri possono fermare la linea e ripararla. Se una stazione etichetta il materiale in modo sottilmente errato, l'intero impianto continua a funzionare mentre i difetti si diffondono.
Ecco perché questo software è diventato un'infrastruttura centrale anziché un semplice middleware. Il mercato riflette questo cambiamento. Il mercato globale delle data pipeline valeva 12,26 miliardi di USD nel 2025 e si prevede che raggiunga 43,61 miliardi di USD entro il 2032, con un CAGR del 19,9%, secondo Fortune Business Insights sul mercato delle data pipeline. In pratica, questa crescita rispecchia ciò che i team di piattaforma sanno già. I workload di AI, i sistemi interconnessi e le decisioni in tempo reale hanno aumentato il costo dei dati obsoleti o corrotti.
Regola pratica: se il business definisce una dashboard, un modello o un flusso di lavoro “mission critical”, allora anche la pipeline che lo alimenta è mission critical.
Negli ambienti enterprise, scegliere un software per data pipeline non significa solo spostare dati. Significa decidere quanta latenza, fragilità, fatica operativa e rischio di business siete disposti ad accettare.
Componenti principali e architetture comuni
La pipeline come sistema operativo per il movimento dei dati
Una pipeline di produzione ha alcune componenti fondamentali, indipendentemente dal fornitore.
Le sorgenti sono il punto di origine dei dati. Possono essere Salesforce, SAP, PostgreSQL, Kafka, S3, log applicativi o un foglio di calcolo di reparto diventato in qualche modo critico per il business.
L'ingestione estrae i dati da questi sistemi. Alcuni strumenti sono specializzati in connettori gestiti. Altri si aspettano che gli ingegneri costruiscano la logica di estrazione in Python, Spark o flussi incentrati su SQL.
La trasformazione dà forma ai dati. Standardizza i formati, collega i dati di riferimento, applica la logica di business e prepara gli output per analytics, operatività o machine learning.
L'orchestrazione gestisce ordine e dipendenze. Decide cosa viene eseguito, quando viene eseguito e cosa succede quando un passaggio a monte termina in ritardo o fallisce a metà.
Le destinazioni sono il punto in cui i dati arrivano. Data warehouse, data lake, lakehouse, feature store, target di reverse ETL e applicazioni a valle hanno tutti aspettative diverse in termini di freschezza e struttura.
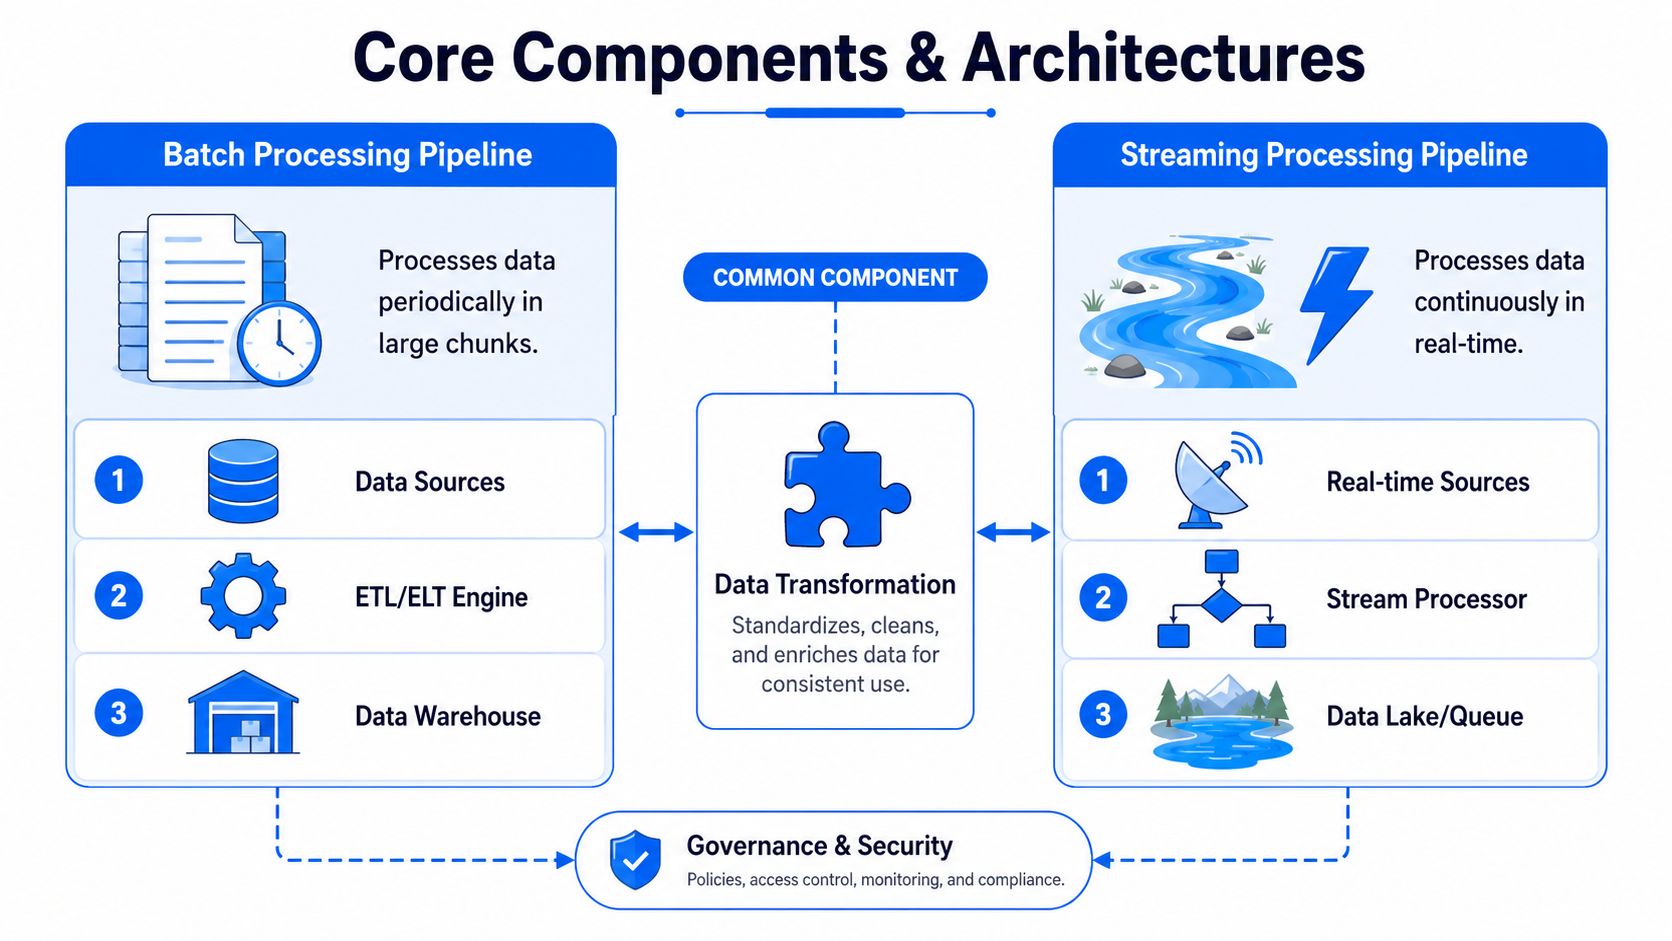
L'errore che molti team commettono è trattarle come decisioni isolate sugli strumenti. Non lo sono. Ogni componente influenza le altre. Una strategia sui connettori cambia il comportamento dei retry. Un motore di trasformazione cambia i costi e la facilità di debug. Un livello di orchestrazione cambia la velocità con cui gli operatori riescono a individuare il raggio d'impatto.
Batch contro streaming ed ETL contro ELT
La principale distinzione architetturale resta quella tra batch e streaming.
Il batch è il modello dell'estratto conto. I dati arrivano a blocchi secondo una pianificazione. È più facile da comprendere, spesso più economico da gestire e di solito sufficiente per finanza, compliance e gran parte del reporting interno.
Lo streaming è il modello dell'allerta antifrode. I dati si muovono in modo continuo, o quasi. Lo si sceglie quando la tempistica cambia il valore per il business, come per la telemetria operativa, la product analytics o le azioni degli utenti quasi in tempo reale.
Il lato della domanda è già cambiato. L'analytics in tempo reale è oggi la principale categoria di applicazione degli strumenti per data pipeline, avendo superato l'elaborazione batch tradizionale, secondo Grand View Research sul mercato degli strumenti per data pipeline. Ciò non significa che il batch sia obsoleto. Significa che sempre più team hanno bisogno di entrambi.
Un compromesso simile esiste tra ETL ed ELT:
ETL funziona bene quando serve un controllo più rigoroso prima del caricamento. Può ridurre il disordine a valle ed è utile quando le regole di governance sono severe.
ELT si adatta bene ai data warehouse e ai lakehouse moderni. Prima si carica, poi si trasforma. Di solito migliora la velocità di iterazione, perché i dati grezzi arrivano rapidamente e gli analisti possono far evolvere i modelli senza ricostruire la logica di estrazione.
I modelli ibridi sono comuni nelle grandi aziende. I team spesso pre-validano i dati sensibili o ad alto rischio, per poi completare le trasformazioni più ampie nel data warehouse.
Se la vostra organizzazione si sta muovendo verso la responsabilità per dominio, l'analytics self-service o piattaforme federate, è utile capire come il data mesh influisce sulle architetture dati moderne. La decisione architetturale non è solo tecnica. Cambia chi è responsabile delle pipeline, chi definisce i contratti e chi interviene quando i dati si rompono.
Un diagramma architetturale pulito non è la prova di una pipeline sana. L'adeguatezza operativa conta più della simmetria del diagramma.
Funzionalità essenziali del software per pipeline moderno
Cinque capacità che contano in produzione
Quando valutano un software per data pipeline, i team spesso sopravvalutano il numero di connettori e sottovalutano l'operatività quotidiana. Una piattaforma solida deve fare di più che acquisire record.

Ingestione dei dati
Deve collegarsi ai sistemi che già utilizzate, non allo stack idealizzato di una slide del fornitore. Il supporto nativo per database, piattaforme SaaS, file, API e sistemi di eventi riduce la manutenzione personalizzata.
Trasformazione
Un buon software consente ai team di esprimere chiaramente la logica di business e di testarla vicino al punto in cui viene eseguita. I flussi SQL-first funzionano bene per i team orientati all'analytics. Le opzioni code-first contano quando le trasformazioni diventano procedurali o con stato.
Orchestrazione
La pianificazione è la parte facile. Gestione delle dipendenze, riesecuzioni, idempotenza, backfill e gestione degli errori sono ciò che distingue una demo da una piattaforma.
Monitoraggio
Gli operatori devono sapere se i job sono stati eseguiti, quanto sono durate le fasi, cosa è cambiato e dove è iniziato un errore. La visibilità in fase di esecuzione fa risparmiare ore durante gli incidenti.
Sicurezza e governance
Le aziende hanno bisogno di controllo dei ruoli, verificabilità, flessibilità di deployment e allineamento con le regole interne di gestione dei dati. Se il software si scontra con il vostro modello di sicurezza, l'adozione si blocca.
Le piattaforme migliori fanno sì che queste capacità risultino collegate tra loro. Ad esempio, l'orchestrazione dovrebbe comprendere le dipendenze delle trasformazioni. Il monitoraggio dovrebbe fornire contesto dall'ingestione fino alla destinazione. La governance dovrebbe applicarsi a tutti gli ambienti, anziché essere un ripensamento aggiunto all'interfaccia utente.
Cosa fanno le piattaforme solide oltre l'elenco delle funzionalità
Le checklist di funzionalità spesso appiattiscono differenze significative. Due strumenti possono entrambi dichiarare il supporto all'orchestrazione, ma uno offre riavvii affidabili e visibilità sulle dipendenze, mentre l'altro si limita ad avviare task a orari prestabiliti.
Cercate i segnali di maturità per la produzione:
Chiarezza operativa: un ingegnere riesce a capire rapidamente cosa ha fallito e quali asset a valle sono coinvolti?
Ripristino controllato: il team può rieseguire una partizione o un intervallo di date senza duplicare i dati?
Usabilità per gli sviluppatori: la piattaforma rende pratici i test e l'iterazione in locale, oppure ogni modifica richiede il deployment di un intero ambiente?
Adeguatezza alla piattaforma: possono usarla sia i team di piattaforma centralizzati sia i team di dominio senza intralciarsi a vicenda?
La produttività a breve termine nasconde spesso un freno a lungo termine. Uno strumento che rende facili i caricamenti semplici ma difficili gli incidenti complessi diventa rapidamente costoso. In ambito enterprise, il valore centrale del software per data pipeline è offrire ai team un modello operativo ripetibile, non solo un modo più veloce per spostare tabelle.
Integrare Data Quality e Observability
Perché job verdi producono comunque dati errati
Il monitoraggio tradizionale delle pipeline vi dice se l'elaborazione è stata eseguita. Di solito non vi dice se l'output ha ancora senso. È la lacuna che molti team enterprise scoprono troppo tardi.
Una pipeline può completarsi con successo pur consegnando join incompleti, schemi modificati, dimensioni in ritardo o campi semanticamente corrotti. La dashboard si aggiorna. Il modello viene riaddestrato. Nessuno riceve un alert perché nulla è “fallito” nel senso tecnico stretto.
Questo punto cieco è più ampio di quanto molti team immaginino. I dati di settore mostrano che le pipeline falliscono senza essere rilevate fino al 40% dei casi a causa di problemi come dimensioni che arrivano in ritardo o deriva semantica, che sfuggono ai controlli standard di volume e freschezza, secondo questa discussione sui guasti silenziosi e sul rilevamento delle anomalie basato sull'AI.
Molti team confondono la qualità dei dati con lo stato di salute dei job. Controlli sul numero di righe, stati di successo dei task e timer degli SLA sono importanti, ma coprono solo i guasti evidenti. I guasti silenziosi passano inosservati perché la pipeline si comporta meccanicamente come progettato, mentre i dati stessi si discostano dalla realtà del business.
Cosa aggiunge l'observability che i soli test non offrono
I test restano importanti. Anzi, i test pratici delle pipeline sono più utili di quanto molti team li rendano. Gli ingegneri spesso validano i caricamenti lift-and-shift con conteggi di righe e aggregati, confrontano snapshot prima e dopo le modifiche, campionano intervalli di date o porzioni regionali per contenere i costi e usano query differenziali come A EXCEPT B e B EXCEPT A per isolare le derive. Questi modelli si basano su pratiche di data engineering consolidate, condivise in questa discussione sui test delle pipeline.
Ma i test da soli non copriranno ogni cambiamento di comportamento. Verificano ciò che avevate previsto. L'observability aiuta a rilevare ciò che non avevate previsto.
Usate i due approcci insieme:
I test fanno rispettare le aspettative note. Colonne obbligatorie, ID validi, intervalli ammessi, logica di riconciliazione.
L'observability traccia l'evoluzione dei comportamenti nel tempo. Variazioni di tempestività, distribuzioni insolite, schema drift e anomalie in campi per cui nessuno ha scritto una regola.
La risposta operativa ricollega il segnale alla responsabilità. Gli alert hanno bisogno di instradamento, contesto e un chiaro percorso di intervento.
Un modo utile di vederla è questo. I test chiedono: “La pipeline ha rispettato le regole che già conosciamo?”. L'observability chiede: “Che cosa è cambiato che dovrebbe preoccuparci anche se nessuna regola esplicita è stata scritta?”
I team che cercano di separare questi concetti finiscono di solito per avere delle lacune. Un approccio più solido consiste nel trattare l'observability come il livello di rilevamento esterno attorno alla pipeline, alle regole di qualità e ai contratti a valle. Se volete una distinzione più netta tra le due discipline, questa analisi su Data Observability e Data Quality a confronto è un buon punto di riferimento.
I guasti silenziosi sono costosi perché preservano la fiducia mentre corrompono i risultati.
Per le grandi aziende, è questo il requisito dell'ultimo miglio. Il software per data pipeline non dovrebbe solo spostare dati su larga scala. Dovrebbe aiutare gli operatori a sapere se i dati in arrivo sono ancora adatti a prendere decisioni.
Come valutare e selezionare un software enterprise
Partite dai vincoli operativi, non dalle demo
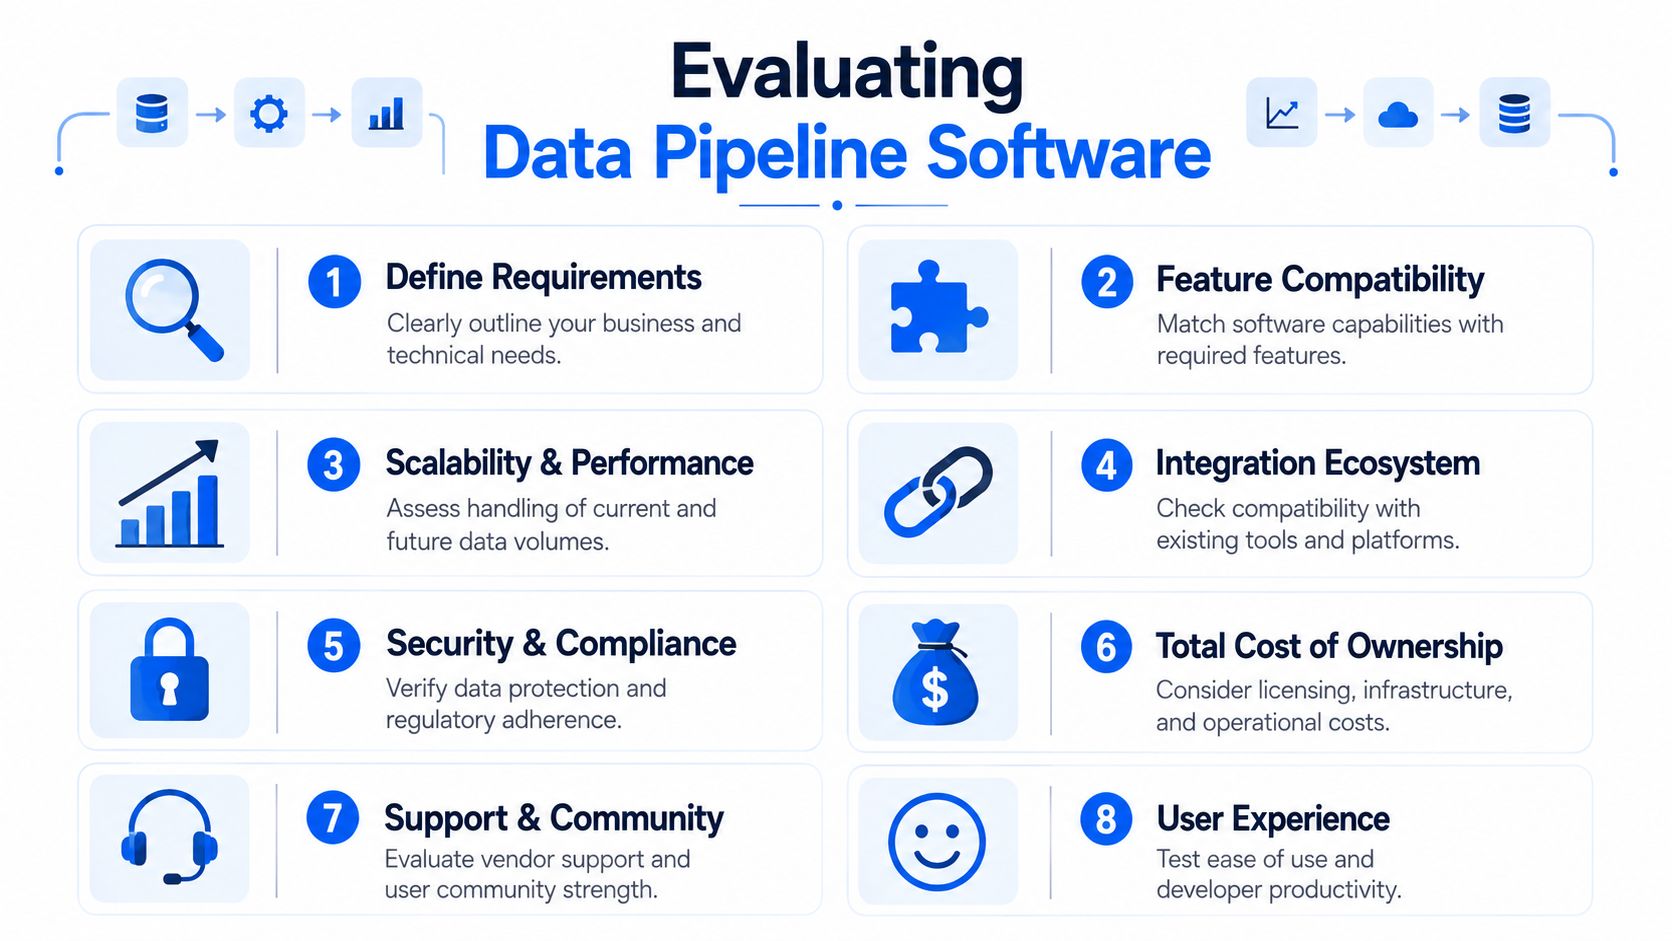
La maggior parte delle valutazioni enterprise va storta prima ancora del primo proof of concept. I team partono da demo dei fornitori, pagine delle funzionalità e matrici dei connettori. La sequenza migliore è operativa. Definite prima i vincoli inderogabili, poi eliminate tutto ciò che non può rispettarli.
Di solito si parte dal modello di deployment. Alcune organizzazioni possono utilizzare senza problemi control plane SaaS. Altre richiedono cloud privato o on-prem per motivi di policy, sovranità dei dati o controlli specifici di settore. Se è la vostra situazione, non trattate il deployment come un dettaglio di acquisto. Cambia l'architettura, le responsabilità di supporto, i modelli di accesso e i flussi di gestione degli incidenti.
Il filtro successivo è il comportamento su scala. Chiedete come la piattaforma gestisce il numero crescente di tabelle, la concorrenza, le riesecuzioni e i workload misti. Un prodotto può sembrare valido in una demo di ingestione batch limitata e poi cedere in condizioni enterprise reali, come pianificazioni tra regioni diverse, contesa delle risorse del data warehouse e backfill sovrapposti.
Valutate poi l'adeguatezza all'ecosistema. Il software per data pipeline raramente vive da solo. Deve funzionare con il vostro data warehouse, il livello di trasformazione, lo stack di orchestrazione, gli strumenti di alerting, il flusso di ticketing, il modello di identità e i processi di governance. La qualità dell'integrazione conta spesso più della profondità delle funzionalità.
Regola di selezione: acquistate pensando agli incidenti che avrete, non alla demo dello scenario ideale che vi è stata mostrata.
Un processo di acquisto è più solido quando platform engineering, sicurezza, data governance, analytics engineering e operation valutano lo strumento separatamente. I disaccordi sono utili. Mettono in luce i punti in cui un prodotto crea costi nascosti al di fuori del team di ingegneria che l'ha richiesto.
Checklist di valutazione del software per data pipeline
Criterio di valutazione | Domande chiave da porre | Perché è importante |
|---|---|---|
Modello di deployment | Può essere eseguito in SaaS, cloud privato o on-prem, secondo necessità? | Evita vicoli ciechi di sicurezza e compliance nelle fasi avanzate dell'acquisto. |
Scalabilità | Come si comporta con volumi maggiori, più pipeline e più esecuzioni concorrenti? | La pressione della crescita si manifesta gradualmente, poi tutta in una volta. |
Modello di ripristino | Supporta retry, checkpointing, riesecuzione di partizioni e backfill sicuri? | La qualità della risposta agli incidenti determina il carico sugli operatori. |
Ecosistema di integrazione | Funziona senza problemi con il vostro data warehouse, data lake, orchestratore, IAM e stack di alerting? | Un'integrazione scadente genera codice di collegamento fragile. |
Flusso di lavoro degli sviluppatori | Gli ingegneri possono testare in locale, promuovere le modifiche in sicurezza e comprendere il lineage della pipeline? | Un'iterazione più rapida riduce il rischio legato alle modifiche. |
Supporto all'observability | Gli operatori possono rilevare problemi di freschezza, modifiche allo schema e anomalie silenziose? | Job verdi non garantiscono dati affidabili. |
Governance e sicurezza | Come vengono gestiti accessi, audit, residenza dei dati e applicazione delle policy? | L'adozione in azienda dipende dal controllo, non solo dalla comodità. |
Costo totale di proprietà | Quali oneri di infrastruttura, manutenzione, formazione e supporto accompagnano la licenza? | Un software economico può essere costoso da gestire. |
Una valutazione pratica comprende di solito tre esercizi:
Eseguite un test del percorso normale: fate passare dati rappresentativi attraverso un flusso di lavoro standard.
Eseguite un test di errore: rompete uno schema, ritardate una dipendenza e forzate una riesecuzione parziale.
Eseguite un test dell'operatore: affidate l'incidente a qualcuno che non ha costruito la pipeline e osservate quanto rapidamente riesce a diagnosticarlo.
È in questo terzo esercizio che di solito emergono i limiti degli strumenti deboli.
Errori comuni e come evitarli
Il groviglio del debito tecnico emerge in produzione
I team sotto pressione per le consegne spesso ottimizzano per far passare i dati una volta sola. Il debito emerge più tardi, quando nessuno sa spiegare perché lo stesso job riesce il martedì, fallisce il mercoledì e corrompe una tabella a valle il giovedì.
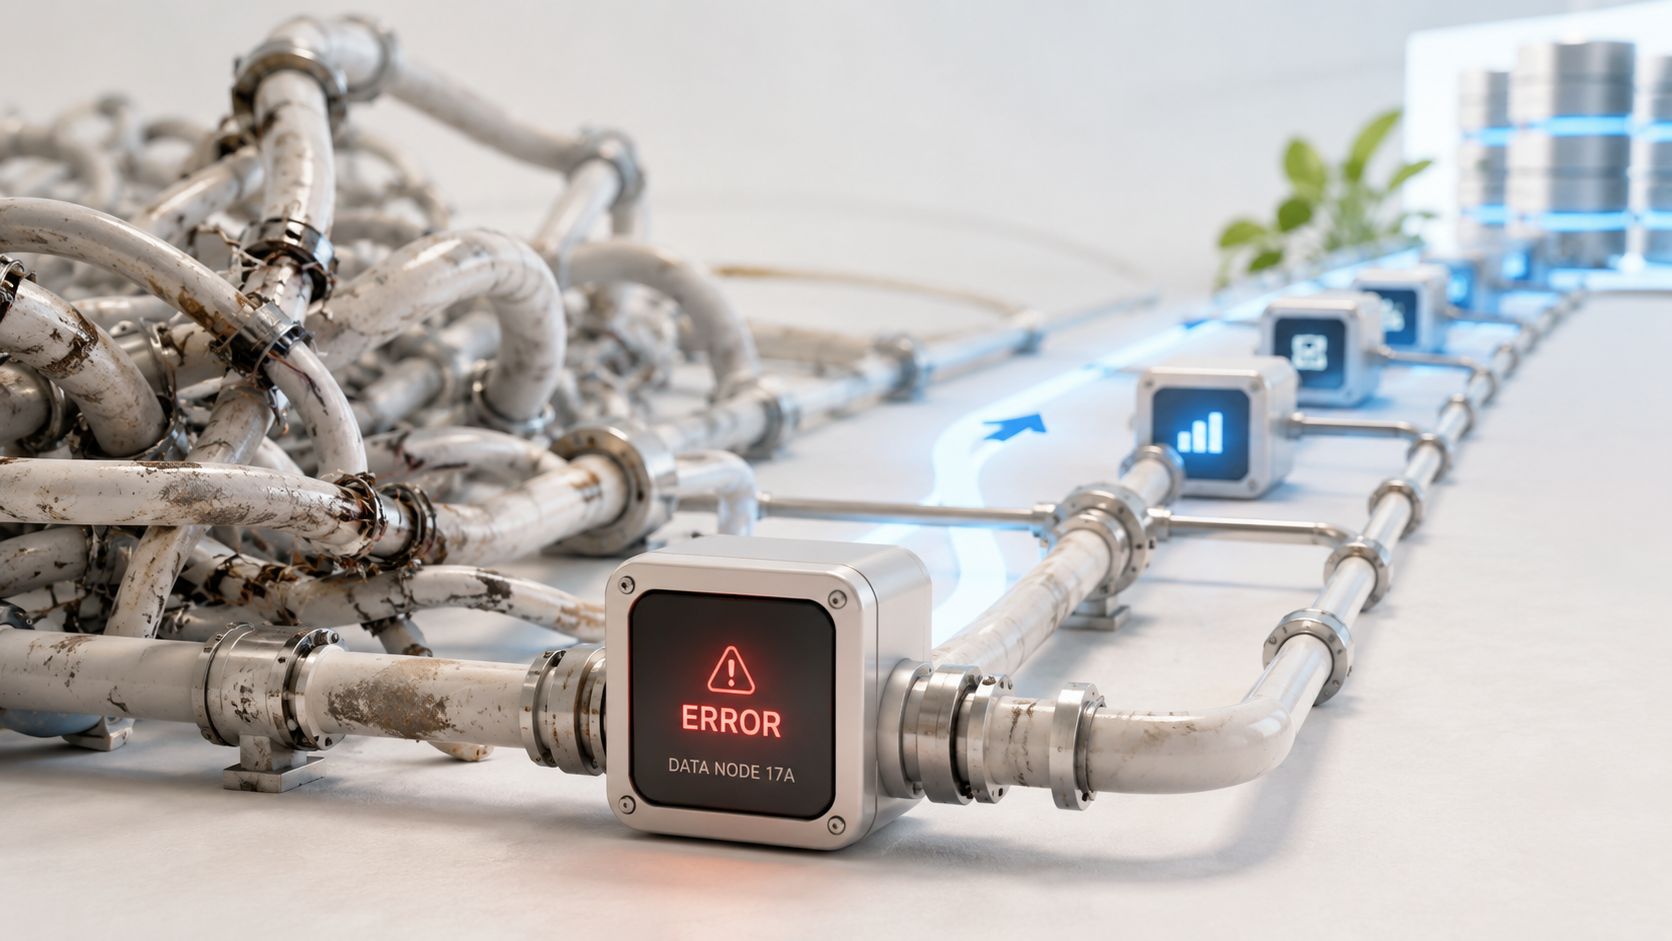
Un modello di guasto comune è progettare solo per lo scenario ideale. L'API sorgente restituisce payload malformati. Un team a monte aggiunge una colonna. Un caricamento si riavvia a metà esecuzione. Se la pipeline non ha resilienza integrata in questi percorsi, gli operatori finiscono per fare riparazioni manuali sotto la pressione del business.
Un altro errore è testare troppo poco le modifiche. I controlli di livello produttivo non devono essere sofisticati. Conteggi di righe, confronti di aggregati, test di regressione su snapshot e campionamenti mirati intercettano molti problemi. Lo stesso vale per le query differenziali ai confini delle sorgenti e prima dei join critici, dove i record errati si moltiplicano a valle.
Il debito nasce anche dall'eccessiva centralizzazione. I job monolitici con estrazione, trasformazione e caricamento incollati insieme sono difficili da testare e ancora più difficili da rieseguire in sicurezza. Suddividere le pipeline in fasi più piccole migliora di solito sia la facilità di debug sia il ripristino.
Un utile termine di paragone viene dal mondo dell'automazione leggera. Anche i team che automatizzano i social media con i template di n8n imparano presto che passaggi visibili del flusso di lavoro, comportamento dei retry e diramazioni in caso di errore contano più di uno script ingegnoso eseguito una sola volta. I sistemi dati enterprise richiedono la stessa disciplina, solo con un raggio d'impatto molto più ampio.
Cosa fanno diversamente i team resilienti
Logica di retry e checkpointing dovrebbero essere integrati nella pipeline stessa, non lasciati all'improvvisazione degli operatori. La logica di retry incorporata nelle fasi di Extract, Transform e Load, insieme al checkpointing che memorizza lo stato esternamente per i riavvii automatici, è una parte fondamentale di un'architettura di pipeline resiliente, come descritto in questa discussione sulle pipeline incentrata sulla resilienza.
Le stesse indicazioni evidenziano un altro controllo spesso trascurato. La validazione dello schema al punto di ingresso impedisce che dati sorgente di scarsa qualità o incompleti entrino nel flusso senza controlli. È uno dei punti più economici in cui fermare i danni.
Per un approfondimento sui modelli di guasto in produzione, vale la pena leggere questo articolo su perché le data pipeline falliscono in produzione e come rilevare i problemi in anticipo.
Usate una semplice checklist di resilienza:
Validate presto: verificate lo schema e le aspettative essenziali sui record prima che inizi il costoso lavoro a valle.
Memorizzate lo stato esternamente: rendete deterministici i riavvii dopo crash o espulsione dei container.
Degradate in modo controllato: saltate o mettete in quarantena i record errati quando il business può tollerarlo, invece di far crollare l'intero flusso di lavoro.
Tenete d'occhio memoria e join: la pressione sulle risorse e i join errati generano spesso guasti che sembrano casuali finché non si esamina il comportamento dell'esecuzione.
Mantenete attivi i vecchi percorsi durante le migrazioni importanti: i periodi di esecuzione in parallelo riducono gli errori di passaggio irreversibili.
Questo breve video aggiunge un'utile prospettiva operativa sull'affidabilità in produzione:
L'obiettivo non è la prevenzione perfetta. È la capacità di sopravvivere. I team solidi costruiscono pipeline che falliscono in modi circoscritti e recuperabili.
Conclusione: i prossimi passi verso dati affidabili
Analytics e AI affidabili non iniziano con dashboard migliori. Iniziano con la disciplina delle pipeline. Il software per data pipeline deve fare di più che spostare record tra sistemi. Deve supportare un ripristino sicuro, un'operatività chiara e i controlli dell'ultimo miglio che intercettano i dati errati prima che le persone ci facciano affidamento.
Se guidate un team di piattaforma o di data engineering, compiete tre passi concreti.
Primo, verificate le vostre pipeline attuali alla ricerca di rischi silenziosi. Non limitatevi a esaminare i job falliti. Esaminate quelli “riusciti” che alimentano dashboard, previsioni e modelli critici. Cercate i punti deboli legati a schema drift, arrivi in ritardo, join parziali e riesecuzioni manuali.
Secondo, aggiungete l'observability in modo incrementale. Iniziate dalle pipeline con l'impatto maggiore, non dall'intero ambiente. Combinate test deterministici e monitoraggio comportamentale, così da intercettare sia le violazioni note sia i cambiamenti inattesi.
Terzo, costruite il business case in termini operativi. I dirigenti non hanno bisogno dell'ennesima lezione sui modelli architetturali. Capiscono i report in ritardo, le decisioni sbagliate, la fiducia compromessa e i team che passano troppo tempo a diagnosticare problemi evitabili.
I team che fanno le cose per bene non inseguono l'eleganza perfetta. Progettano per chiarezza, resilienza e fiducia. È questo che rende affidabili i dati aziendali.
Se il vostro team cerca un modo pratico per monitorare anomalie nei dati, tempestività, validazione e modifiche allo schema in ambienti di cloud privato o on-prem, date un'occhiata a digna. È pensato per le aziende che hanno bisogno di Data Quality e Observability moderne senza concedere a un fornitore l'accesso ai dati di produzione.
Se la vostra valutazione fa emergere il divario tra job verdi e dati errati descritto sopra, scoprite come l'observability della piattaforma dati con digna aggiunge segnali di freschezza, schema e anomalie attorno alle pipeline che già utilizzate.
Domande frequenti
Che cos'è il software per data pipeline?
Il software per data pipeline è il meccanismo che sposta i dati dai sistemi sorgente verso i luoghi in cui persone e applicazioni possono utilizzarli. Comprende sorgenti, ingestione, trasformazione, orchestrazione e destinazioni, gestendo esportazioni dal CRM, tabelle ERP, flussi di eventi, API SaaS e feature dei modelli che seguono tutti tempistiche diverse.
Quanto è grande il mercato del software per data pipeline?
Secondo Fortune Business Insights, il mercato globale delle data pipeline valeva 12,26 miliardi di USD nel 2025 e si prevede che raggiunga 43,61 miliardi di USD entro il 2032, con un CAGR del 19,9%. I workload di AI e le decisioni in tempo reale hanno aumentato il costo dei dati obsoleti o corrotti.
Meglio scegliere pipeline batch o streaming?
Scegliete il batch, il modello dell'estratto conto, quando i dati possono arrivare a blocchi pianificati, come per finanza, compliance e reporting interno. Scegliete lo streaming, il modello dell'allerta antifrode, quando la tempistica cambia il valore per il business. L'analytics in tempo reale è oggi la principale categoria di applicazione degli strumenti per pipeline, quindi molti team hanno bisogno di entrambi.
Perché le pipeline mostrano job verdi ma consegnano comunque dati errati?
Il monitoraggio tradizionale delle pipeline vi dice se l'elaborazione è stata eseguita, non se l'output ha ancora senso. I job possono riuscire pur consegnando join incompleti, schemi modificati o dimensioni in ritardo. L'articolo cita dati di settore secondo cui le pipeline falliscono senza essere rilevate fino al 40% dei casi, perché questi problemi sfuggono ai controlli di volume e freschezza.
Come dovrebbero le aziende valutare un software per data pipeline?
Partite dai vincoli operativi anziché dalle demo: modello di deployment, comportamento su scala e adeguatezza all'ecosistema. Poi eseguite tre esercizi: un test del percorso normale, un test di errore che rompe uno schema e ritarda una dipendenza, e un test dell'operatore in cui qualcuno che non ha costruito la pipeline diagnostica l'incidente.


