Schema dei dati e modello dei dati: le differenze chiave
|
6
min di lettura

State guardando una dashboard che ieri funzionava, poi arriva una ridenominazione a monte e alcuni grafici diventano vuoti. Nessuno ha annunciato una modifica al modello, il warehouse non si è bloccato, eppure l'ingegnere di turno si ritrova all'improvviso a ricostruire la lineage attraverso job ETL, semantic layer della BI e definizioni di tabelle per trovare il punto di rottura. Questa confusione nasce di solito da un errore semplice: trattare il modello dei dati e lo schema dei dati come se fossero la stessa cosa.
Criterio | Modello dei dati | Schema dei dati |
|---|---|---|
Cosa descrive | La progettazione astratta di entità, relazioni e vincoli | L'organizzazione concreta di un database o di un insieme di tabelle |
Forma tipica | Diagrammi ER, diagrammi delle classi UML, modelli concettuali e logici | DDL, definizioni di tabelle, campi, tipi, relazioni, vincoli |
Uso ideale | Ragionamento, governance, comunicazione, progettazione | Applicazione a runtime, storage, validazione, esecuzione |
Ritmo di cambiamento | Di solito più lento, legato al significato di business | Cambia spesso, man mano che colonne, tipi e regole evolvono |
Rischio principale se confusi | I team discutono della struttura senza chiarirne il significato | I consumatori a valle si bloccano perché il contratto è cambiato |
Indice
Perché questa distinzione mette in difficoltà ogni team di dati
Perché le modifiche allo schema sono il vero rischio operativo
Perché questa distinzione mette in difficoltà ogni team di dati
Un ingegnere del warehouse rinomina una colonna a monte, e tre dashboard finiscono a null senza alcun errore evidente. Le tabelle esistono ancora, la pipeline continua a girare, e l'unico indizio visibile è che il vecchio nome del campo non viene più risolto dove lo strumento di BI se lo aspettava. È in quel momento che si inizia a usare “modello” e “schema” come sinonimi, anche se il guasto vero si è verificato a livello di schema, non a livello di progettazione astratta.
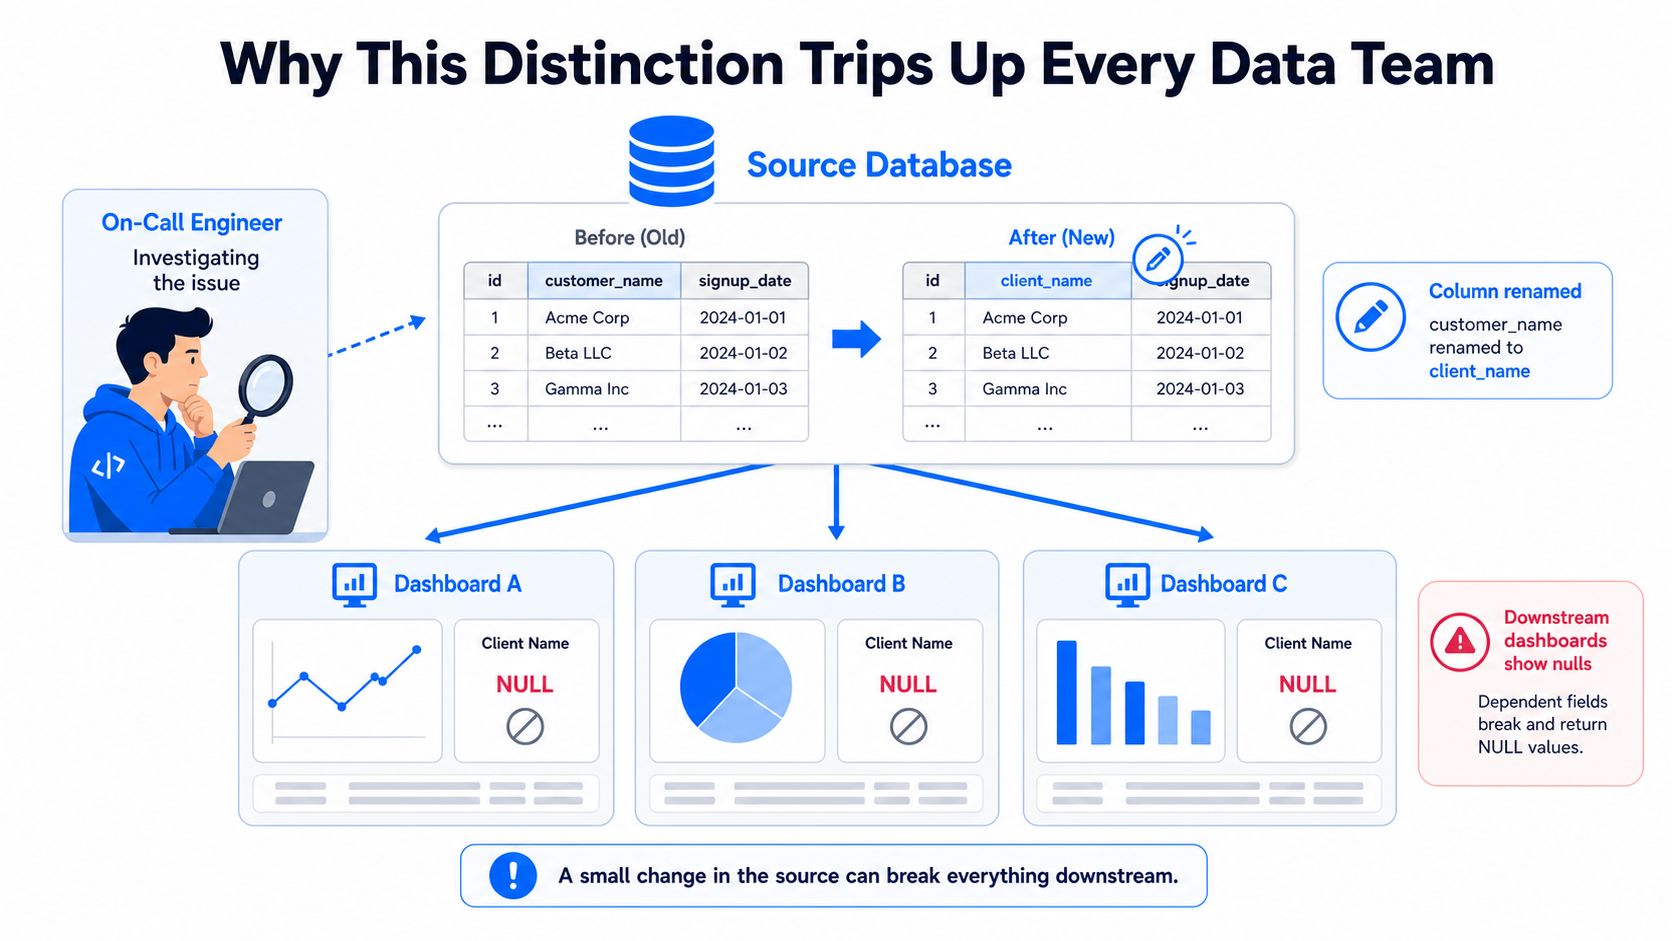
Il modo più pulito per analizzare quell'incidente è porsi un'unica domanda. Questa modifica riguarda il significato dei dati o il modo in cui sono strutturati fisicamente in questo momento? La prima domanda appartiene al modello. La seconda allo schema.
Una regola da lavagna che fa risparmiare tempo
Quando i team tengono separati questi livelli, smettono di discutere in circolo. Un product analyst può parlare di clienti, ordini e fatturato come concetti di business, mentre un data engineer può parlare di colonne, tipi e vincoli come struttura eseguibile. Sono conversazioni diverse, e il warehouse ne trae beneficio quando il team le tratta come tali.
La distinzione dà anche al lavoro di osservabilità un obiettivo più preciso. Se una metrica si rompe perché un campo è stato rimosso, non si tratta di un problema filosofico di modellazione, ma di un problema di contratto dello schema. Ciò significa che la risposta giusta è tracciare la deriva strutturale, validare i campi modificati e controllare le dipendenze a valle prima che si chiuda la successiva finestra di rilascio.
Regola pratica: se una persona lo disegnerebbe su una lavagna, probabilmente siete nel territorio del modello. Se il DBMS può applicarlo, siete nel territorio dello schema.
Questa prospettiva conta in ogni decisione successiva. Una revisione di progetto, una migrazione del warehouse o un post-mortem di un incidente diventano molto più semplici quando il team può dire “questa è una questione di modello” o “questa è una modifica allo schema”, senza mescolare le due cose.
Definire il modello dei dati su tre livelli
Un modello dei dati è la descrizione astratta delle entità, delle relazioni e dei vincoli che interessano al business. È il linguaggio che si usa prima che compaia sullo schermo qualsiasi decisione specifica di un database, ed è l'artefatto che aiuta architetti, analisti e ingegneri a ragionare insieme sulla struttura. Nell'architettura classica dei database, questo modello si può interpretare su più livelli, dal significato di business fino ai dettagli di implementazione (panoramica di Purdue sull'architettura dei database).
Concettuale, logico, fisico
A livello concettuale, si descrive il mondo del business. Un team retail potrebbe dire di avere clienti, ordini e prodotti, e che i clienti effettuano ordini che contengono prodotti.
A livello logico, lo si affina in entità, attributi, chiavi e relazioni senza scegliere un motore di database. Lo stesso dominio retail ora ha attributi come customer_id, order_date e product_name, oltre a relazioni che mostrano come gli ordini si collegano ai clienti e le righe d'ordine ai prodotti.
A livello fisico, la progettazione diventa pronta per l'implementazione. La stessa idea viene tradotta in tipi di dati concreti, indici, partizioni e strutture di tabelle per un sistema specifico. Qui le scelte di database iniziano a contare, perché il modello viene espresso in una forma che la piattaforma può eseguire.
L'esempio retail resta lo stesso, cambia la forma
Il dominio retail è utile perché il significato di business resta stabile mentre la rappresentazione evolve. Un diagramma concettuale potrebbe mostrare le relazioni generali. Un diagramma logico potrebbe aggiungere le chiavi. Una progettazione fisica potrebbe diventare tabelle Snowflake o PostgreSQL con tipi e vincoli specifici. Il punto non è che il modello scompare. Il punto è che il modello sopravvive attraverso più rappresentazioni, ed è per questo che è così utile per la governance e la comunicazione.
Buona abitudine di modellazione: tenete in vista lo stesso dominio mentre passate dal livello concettuale a quello logico e poi a quello fisico. Se il cliente retail scompare dalla conversazione a metà strada, di solito la progettazione è diventata troppo astratta o troppo sbilanciata sull'implementazione.
Per i team di warehouse, questa gerarchia è il motivo per cui un diagramma ER o un diagramma delle classi UML può essere prezioso anche prima che esista qualsiasi DDL. Il modello aiuta le persone ad allinearsi prima sul significato, per poi scegliere in seguito la forma dello storage. Se vi serve un esempio di warehouse più approfondito, il flusso di modellazione descritto in padroneggiare la modellazione dei dati del warehouse si inserisce perfettamente in questa progressione.
Definire lo schema come contratto operativo
Uno schema è la descrizione concreta di come i dati sono organizzati in uno specifico sistema di database. In termini pratici di DBMS, significa tabelle, campi, tipi, vincoli, viste e relazioni, tutti espressi in una forma che il motore può applicare a runtime. L'impostazione relazionale di IBM tratta lo schema come il progetto che definisce la forma del database, mentre il modello resta la logica di progettazione più ampia che sta sotto (riferimento sulla definizione di schema).
Dalla progettazione all'esecuzione
Riprendiamo l'esempio retail. Il modello dice che i clienti effettuano ordini. Lo schema dice che esistono una tabella customers, una tabella orders e magari una chiave esterna che le collega, con tipi di campo come VARCHAR o TIMESTAMP, oltre a regole NOT NULL e altri vincoli. È qui che un'idea concettuale diventa struttura eseguibile.
Ecco perché le modifiche allo schema non sono semplice manutenzione ordinaria. Quando una colonna viene aggiunta, rimossa, rinominata o modificata, il DBMS ha a che fare con l'artefatto operativo, non con l'idea astratta. Il codice a valle dipende esattamente da quella forma, quindi anche una piccola modifica può rompere dashboard, job ETL o feature di machine learning che si aspettano il vecchio contratto.
Lo schema è ciò di cui i consumatori si fidano davvero
Un consumatore di dati non legge il vostro diagramma concettuale al momento della query. Lo strumento di BI legge la forma della tabella, la pipeline legge nomi e tipi dei campi e il warehouse applica le regole dello schema. Questo fa dello schema un contratto, anche quando nessuno scrive la parola “contratto” nel documento di architettura.
La metafora del contratto è importante perché spiega perché, in produzione, la responsabilità dello schema è spesso più urgente di quella del modello. Il modello può restare stabile mentre lo schema cambia sotto carichi di lavoro reali. In termini di osservabilità, lo schema è il livello eseguibile e versionato che richiede un'attenzione costante.
Il modello vi dice cosa significa il sistema. Lo schema dice al database come memorizzarlo e applicarlo.
È questo il passaggio di consegne chiaro da tenere a mente quando leggete un DDL, esaminate una migrazione o eseguite il debug di un consumatore che non funziona. Se la modifica è percepibile dal DBMS, è una questione di schema. Se la modifica riguarda la struttura e il significato di business, è una questione di modello.
Schema dei dati e modello dei dati a confronto
Il modo più semplice per distinguerli è confrontarli in base a come vengono usati, non solo a come vengono definiti. Un modello aiuta le persone a pensare. Uno schema aiuta i sistemi a funzionare. Il modello di solito dura più a lungo. Lo schema cambia più spesso.
Criterio | Modello dei dati | Schema dei dati |
|---|---|---|
Pubblico principale | Architetti, analisti, team di governance | DBA, platform engineer, responsabili delle pipeline |
Scopo principale | Descrivere significato e struttura di business | Applicare una struttura concreta in un database |
Ciclo di vita | Artefatto di progettazione di lunga durata | Artefatto operativo legato al sistema in produzione |
Mutabilità | Evolve con il cambiare della comprensione del business | Viene rivisto quando cambiano tabelle, campi o tipi |
Applicazione | Spesso basata su revisioni o guidata dai processi | Applicata automaticamente dal DBMS |
Tipo di guasto | Le persone perdono un linguaggio condiviso per il dominio | I contratti a valle si rompono a runtime |
La relazione chiave è semplice. Il modello determina lo schema, e lo schema è il contratto operativo. È la frase da ripetere in una revisione di progetto quando qualcuno cerca di risolvere una rottura dello schema ridisegnando il modello astratto invece di correggere la forma effettiva del database.
Come si comportano i due artefatti nella pratica
Un modello è l'artefatto che si porta in una discussione di progettazione. Uno schema è l'artefatto che si rilascia. Se uno stakeholder chiede se cliente e conto debbano essere concetti separati, è una questione di modello. Se il responsabile del warehouse chiede se una colonna debba ammettere valori nulli, è una questione di schema.
Questa distinzione cambia anche chi deve aggiornare cosa. Analisti e architetti di solito influenzano il modello quando cambiano le regole di business. Data engineer e responsabili di piattaforma di solito modificano lo schema quando le implementazioni devono riflettere quelle regole. Lo stesso requisito può toccare entrambi i livelli, ma raramente parte da entrambi contemporaneamente.
Scorciatoia per le revisioni di progetto: se la decisione cambia il modo in cui le persone comprendono il business, rivedete il modello. Se la decisione cambia il modo in cui il DBMS memorizza o valida le righe, rivedete lo schema.
Il confronto aiuta anche a spiegare perché i team finiscono nei guai quando saltano un livello. Un modello splendido con uno schema trascurato rompe comunque le dashboard. Uno schema che cambia rapidamente senza un modello stabile lascia tutti a indovinare il significato dei dati. I buoni team tengono entrambi in vista, ma non fingono che siano intercambiabili.
Dove la distinzione si incrina nei sistemi moderni
Gli stack moderni rendono il confine meno netto, perché piattaforme diverse usano la parola schema in modo diverso. In un lakehouse, modello e schema possono finire per convivere a stretto contatto in file e metadati delle tabelle. In un document store, lo schema può essere un contratto JSON applicato da chi scrive i dati anziché dal database. Negli stream di eventi, lo schema può risiedere in un registry ed evolvere secondo regole di compatibilità.
Perché la parola significa cose diverse in sistemi diversi
È qui che la confusione diventa concreta. Nei team NoSQL, schema e modello vengono spesso usati come sinonimi, perché la struttura è più flessibile e l'applicazione delle regole è in parte esterna. Nei sistemi schema-on-read, i consumatori possono imporre la propria interpretazione in un secondo momento, il che rende il confine tra “progettazione” ed “esecuzione” più sfumato rispetto a un warehouse relazionale classico.
Chi lavora sul campo ha fatto notare che qui i team spesso non si capiscono, perché lo stesso termine può indicare il DDL fisico, la forma di un JSON o le regole di validazione a seconda della piattaforma. È proprio per questo che la definizione da manuale, per quanto pulita, non basta da sola. Il confine operativo si sposta con il pattern di storage e di ingestione.
Chiedersi quale livello viene effettivamente applicato
La soluzione è chiedersi dove avviene l'applicazione delle regole. Se chi scrive valida un payload JSON prima di pubblicarlo su Kafka, quel contratto si comporta come uno schema anche se il database non vede mai la struttura grezza. Se una tabella lakehouse memorizza dati semi-strutturati e interpreta i campi solo in seguito, lo schema apparente può essere più scarno di quanto il team del warehouse si aspetti. Se un registry gestisce le regole di compatibilità, anche il contratto operativo risiede lì.
Questo non cancella la distinzione tra modello e schema. Significa soltanto che il confine dello schema può spostarsi da uno strumento all'altro. L'abitudine utile è capire, prima di apportare una modifica, se una conversazione riguarda il significato concettuale, la validazione lato scrittura o l'applicazione delle regole lato database.
Nei sistemi moderni, la domanda raramente è “abbiamo uno schema?”. La vera domanda è “dove viene applicato lo schema, e chi ne dipende?”
Questa domanda evita molti attriti inutili tra team. Mantiene inoltre oneste le discussioni sulla governance, perché la risposta cambia a seconda che si stia guardando una tabella del warehouse, un evento JSON o uno stream basato su registry.
Perché le modifiche allo schema sono il vero rischio operativo
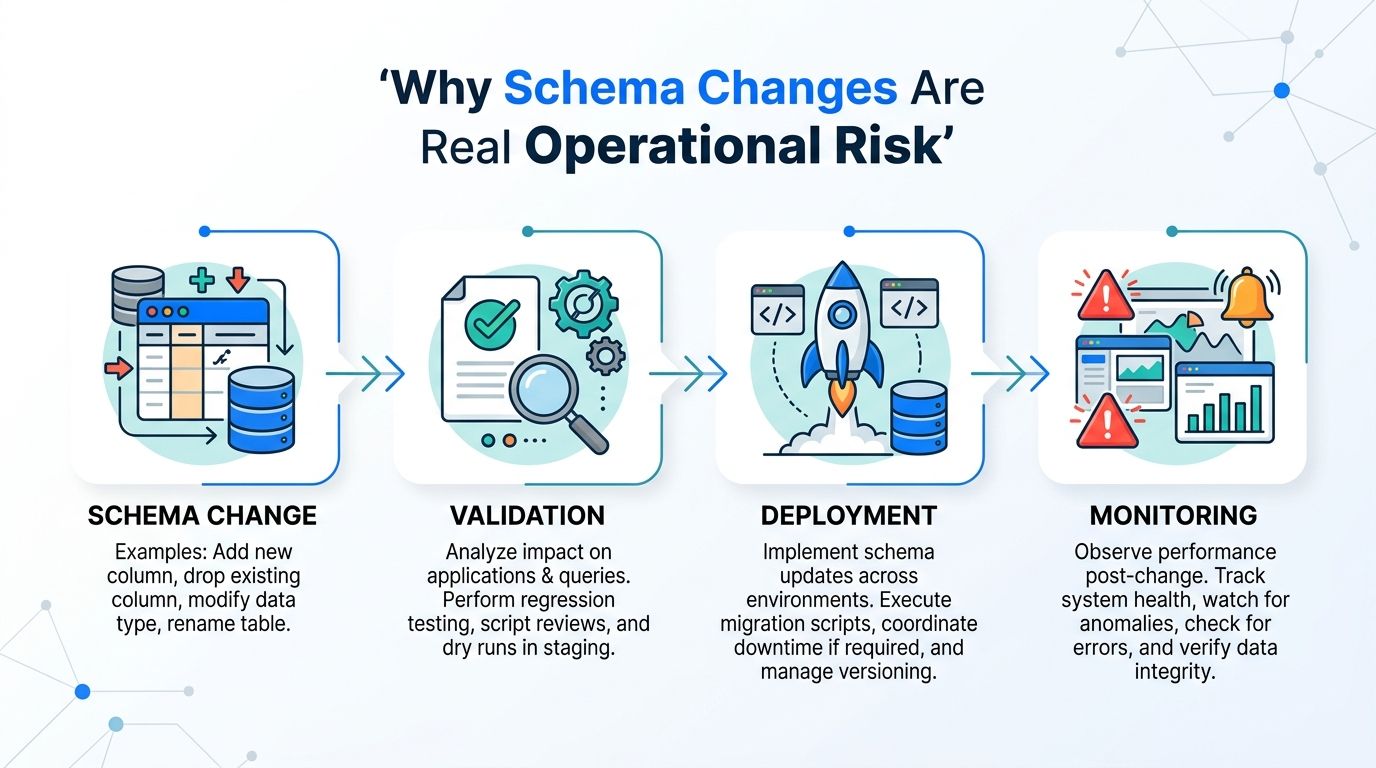
Il rischio più grande in produzione non è che esista un modello. È che lo schema cambi in modi che i sistemi a valle non si aspettavano. Colonne aggiunte, colonne rimosse, cambi di tipo, modifiche ai valori predefiniti e ai vincoli possono tutti rompere la BI o la logica delle pipeline, anche quando il modello di business è ancora intatto. In pratica, lo schema è il livello in cui iniziano le rotture silenziose.
La deriva è un problema di runtime, non di teoria
Quando i team trattano la deriva dello schema come una questione teorica di progettazione, di solito la scoprono da una dashboard guasta, da un set di feature non aggiornato o da una trasformazione interrotta. Il problema è operativo, perché il DBMS continua a funzionare mentre il contratto gli cambia intorno. Ecco perché il monitoraggio dello schema deve stare, nello stack di osservabilità, accanto ai controlli di puntualità e alla validazione a livello di record.
Lo schema è anche il modo più rapido per individuare accoppiamenti nascosti. Un report che dipende da un campo nullable che diventa non-null, o un modello a valle che presume che un campo stringa mantenga lo stesso tipo, di solito fallisce solo dopo che la modifica è stata rilasciata. A quel punto, il lavoro sull'incidente non riguarda più l'eleganza della progettazione. Riguarda il ripristino della fiducia nella pipeline.
Per un approfondimento su questo tipo di guasto, la discussione incentrata sulle pipeline in deriva dello schema e rotture strutturali applica la stessa idea ai guasti a valle.
Monitorare la forma, non solo le righe
L'osservabilità dello schema è utile perché sorveglia il segnale di runtime da cui dipendono i consumatori. Se una colonna compare, scompare o cambia tipo, si tratta di un evento strutturale che vale la pena tracciare. Se cambia un vincolo, può alterare il significato dei dati validi tanto quanto un'anomalia a livello di riga.
È l'approccio giusto per i warehouse con molti consumatori. Agli strumenti di BI, alle pipeline di feature e ai job di reverse ETL non importa che il modello concettuale sembri ancora elegante. A loro importa che il contratto su cui sono stati scritti esista ancora.
Best practice e il ruolo di digna
Un buon programma di gestione dello schema è soprattutto disciplina, non dramma. Versionate il DDL, esaminate le modifiche allo schema prima del deployment, usate migrazioni retrocompatibili ed eseguite test di contratto sui consumatori a valle. Poi monitorate insieme modifiche strutturali, errori di validazione e ritardi, perché questi guasti si presentano spesso a grappolo anziché come un singolo evento ben definito.
Una checklist pratica
Trattate il DDL come codice. Mantenete le migrazioni sotto controllo di versione, così che ogni modifica sia tracciabile.
Esaminate le modifiche prima del rilascio. Una ridenominazione o un cambio di tipo dovrebbe seguire lo stesso percorso di revisione del codice applicativo.
Preferite migrazioni retrocompatibili. Aggiungete il nuovo campo prima di rimuovere quello vecchio, poi spostate gradualmente i consumatori.
Eseguite test di contratto. Verificate che campi, tipi e valori obbligatori attesi esistano ancora prima e dopo il deployment.
Monitorate la deriva strutturale a runtime. Intercettate colonne aggiunte, rimosse o modificate non appena compaiono.
Collegate lo schema a validazione e puntualità. Una forma stabile non serve se i record arrivano in ritardo o violano le regole di business.
Questo playbook si collega naturalmente agli strumenti di osservabilità. Schema Tracker copre il livello strutturale, perché segnala le colonne aggiunte, rimosse e con tipo modificato. Data Validation copre le regole di business a livello di record. Timeliness monitora l'arrivo previsto e rileva i ritardi. Data Anomalies cerca valori inattesi quando la forma non è cambiata. Data Analytics aiuta i team a osservare i trend storici e a individuare la deriva nel tempo. Come una delle diverse opzioni disponibili, digna riunisce questi controlli in ambienti controllati dal cliente e lascia i dati dove si trovano mentre esegue l'analisi.
Abbinare lo strumento al tipo di guasto
Se lo schema è cambiato, partite dal tracciamento strutturale. Se i dati rispettano ancora lo schema ma violano una regola di business, usate la validazione. Se i record arrivano in ritardo, il primo alert dovrebbe venire dal monitoraggio della puntualità. Se lo schema è stabile ma i valori sembrano strani, il rilevamento delle anomalie è la scelta più adatta.
Questa separazione evita che i team reagiscano in modo eccessivo al segnale sbagliato. Una colonna mancante e un caricamento in ritardo possono entrambi rompere una dashboard, ma non richiedono la stessa risposta. Una buona osservabilità rende evidenti queste differenze prima che se ne accorgano gli utenti.

Domande comuni su schemi e modelli
No, il database in sé non è lo schema. Il database è il contenitore, mentre lo schema è la struttura formale al suo interno. Anche la responsabilità di solito si divide allo stesso modo: architetti e analisti danno forma al modello, mentre data engineer e team di piattaforma modificano lo schema.
Un diagramma ER è sufficiente quando l'obiettivo è allinearsi sul significato di business. Il DDL è necessario quando serve che il DBMS applichi la struttura. Se vi serve una sola frase per uno stakeholder non tecnico, usate questa: il modello è ciò che i dati significano, e lo schema è il modo in cui il database li memorizza e ne applica le regole.
Se gestite deriva dello schema, validazione e puntualità in un warehouse in produzione, digna vi offre un unico punto da cui osservare insieme i segnali strutturali e operativi. Traccia le modifiche allo schema, controlla le regole a livello di record e monitora l'arrivo dei dati all'interno di ambienti controllati dal cliente, il che rende più facile collegare le modifiche al modello al rischio a runtime. Visitate digna per vedere come si inserisce nel vostro stack di dati.
Domande frequenti
Qual è la differenza tra uno schema dei dati e un modello dei dati?
Un modello dei dati descrive cosa intende il business e come si relazionano le entità, a livello concettuale, logico e fisico. Uno schema è il contratto operativo che un database applica effettivamente: nomi delle tabelle, tipi delle colonne, chiavi e vincoli così come esistono nel sistema.
Quali sono i tre livelli di un modello dei dati?
I modelli concettuali mostrano entità e relazioni per la discussione con il business. I modelli logici aggiungono attributi, chiavi e cardinalità senza vincolarsi a una piattaforma. I modelli fisici descrivono come la progettazione viene implementata in un database specifico, inclusi tipi, partizionamento e indici.
Perché la distinzione conta nella pratica?
Perché i consumatori si fidano dello schema, non del modello. Una ridenominazione nel warehouse rompe le dashboard anche se il modello concettuale è invariato, ed è per questo che le modifiche allo schema richiedono alerting e versionamento, mentre le modifiche al modello richiedono revisione e comunicazione.
Schema e modello possono allontanarsi l'uno dall'altro?
Facilmente. I team aggiungono colonne per comodità, cambiano tipi sotto la pressione delle scadenze o eliminano campi che il modello documentato mostra ancora. La deriva resta invisibile finché qualcuno non esegue una query basandosi sul modello e ottiene un risultato che lo schema non ha mai promesso.
Come si mantengono allineati schema e modello?
Trattate lo schema come stato di produzione: versionatelo, impostate alert sulle modifiche e richiedete che ogni intervento strutturale faccia riferimento al modello che implementa. Una riconciliazione periodica tra il modello documentato e lo schema in produzione intercetta la deriva prima che lo faccia un consumatore.


