Star snowflake schema: schema a stella e a fiocco di neve
|
6
min di lettura

Probabilmente il vostro data warehouse non è nato da un dibattito sugli schemi. È nato da una richiesta di dashboard, un report sui ricavi, una vista clienti, e poi da una serie di nuove sorgenti che dovevano tutte confluire in un posto sensato. Qualche mese dopo, gli analisti aggiungono join per abitudine, le query di BI diventano più lente e nessuno è d'accordo se il modello debba essere semplice per il reporting o rigoroso per la governance.
È qui che di solito compare la discussione sul cosiddetto Star Snowflake Schema. In pratica, l'espressione è fuorviante. I team la usano quando non lavorano più con uno schema a stella puro o a fiocco di neve puro e hanno bisogno di un modo pratico per parlare dei modelli misti in produzione. La questione centrale non è accademica. È capire se tabelle dei fatti, dimensioni, join e controlli di qualità supportano ancora il modo in cui le persone interrogano il warehouse e si fidano di esso.
La maggior parte degli articoli si ferma alle definizioni. Non basta, una volta che un modello è in produzione, condiviso tra più team e in evoluzione sotto carico. Il problema più difficile è operativo: come scegliere il pattern giusto, dove un design ibrido aiuta e come monitorare i punti di rottura che emergono quando strutture denormalizzate e normalizzate coesistono.
Indice
Il bivio della progettazione del data warehouse
Nei team dati in crescita si osserva uno schema ricorrente. Il primo modello del warehouse viene costruito in fretta, di solito attorno a poche dashboard e ad alcune sorgenti ben conosciute. Funziona. Poi il business aggiunge il reporting regionale, la gerarchia dei prodotti cambia, la finanza chiede riconciliazioni più rigorose e qualcuno si domanda perché la dashboard che prima si caricava all'istante ora si trascina tra diversi join.
A quel punto la progettazione dello schema smette di essere una preferenza di modellazione e diventa un vincolo operativo. Il modo in cui strutturate fatti e dimensioni influisce sulla velocità delle query, sull'usabilità della BI, sul comportamento dello storage e su quanto saranno dolorose le modifiche future. Influisce anche su chi può lavorare con il modello in sicurezza. Un design appiattito aiuta gli analisti a muoversi velocemente. Uno più normalizzato offre agli ingegneri un controllo più stretto sulla coerenza delle dimensioni.
I team raramente si pentono di aver deciso in modo consapevole. Si pentono di aver ereditato una struttura cresciuta per caso.
L'espressione star snowflake schema compare spesso proprio qui, nel momento in cui un warehouse non è più nettamente una cosa o l'altra. Nelle conversazioni è una scorciatoia utile, ma nasconde un dettaglio importante. Non state scegliendo uno standard ibrido formale. State decidendo dove mantenere piatte le dimensioni, dove normalizzarle e cosa ciò comporta per prestazioni, governance e osservabilità in produzione.
Architetture di base: schema a stella e schema a fiocco di neve
Il termine star snowflake schema sembra indicare un'unica tecnica di modellazione. Non è così. Fonde due pattern dimensionali distinti che risolvono problemi diversi.
Il primo è lo schema a stella. Il secondo è lo schema a fiocco di neve. Secondo la spiegazione di Snowflake sui fondamenti dello schema a stella, lo schema a stella è l'approccio più diffuso per sviluppare data warehouse, con una o più tabelle dei fatti collegate a tabelle delle dimensioni denormalizzate per query più semplici e prestazioni più rapide. Lo schema a fiocco di neve è la forma estesa, in cui queste dimensioni vengono normalizzate in tabelle di sotto-dimensioni.
Per i team che progettano modelli analitici, questa differenza è tutto.
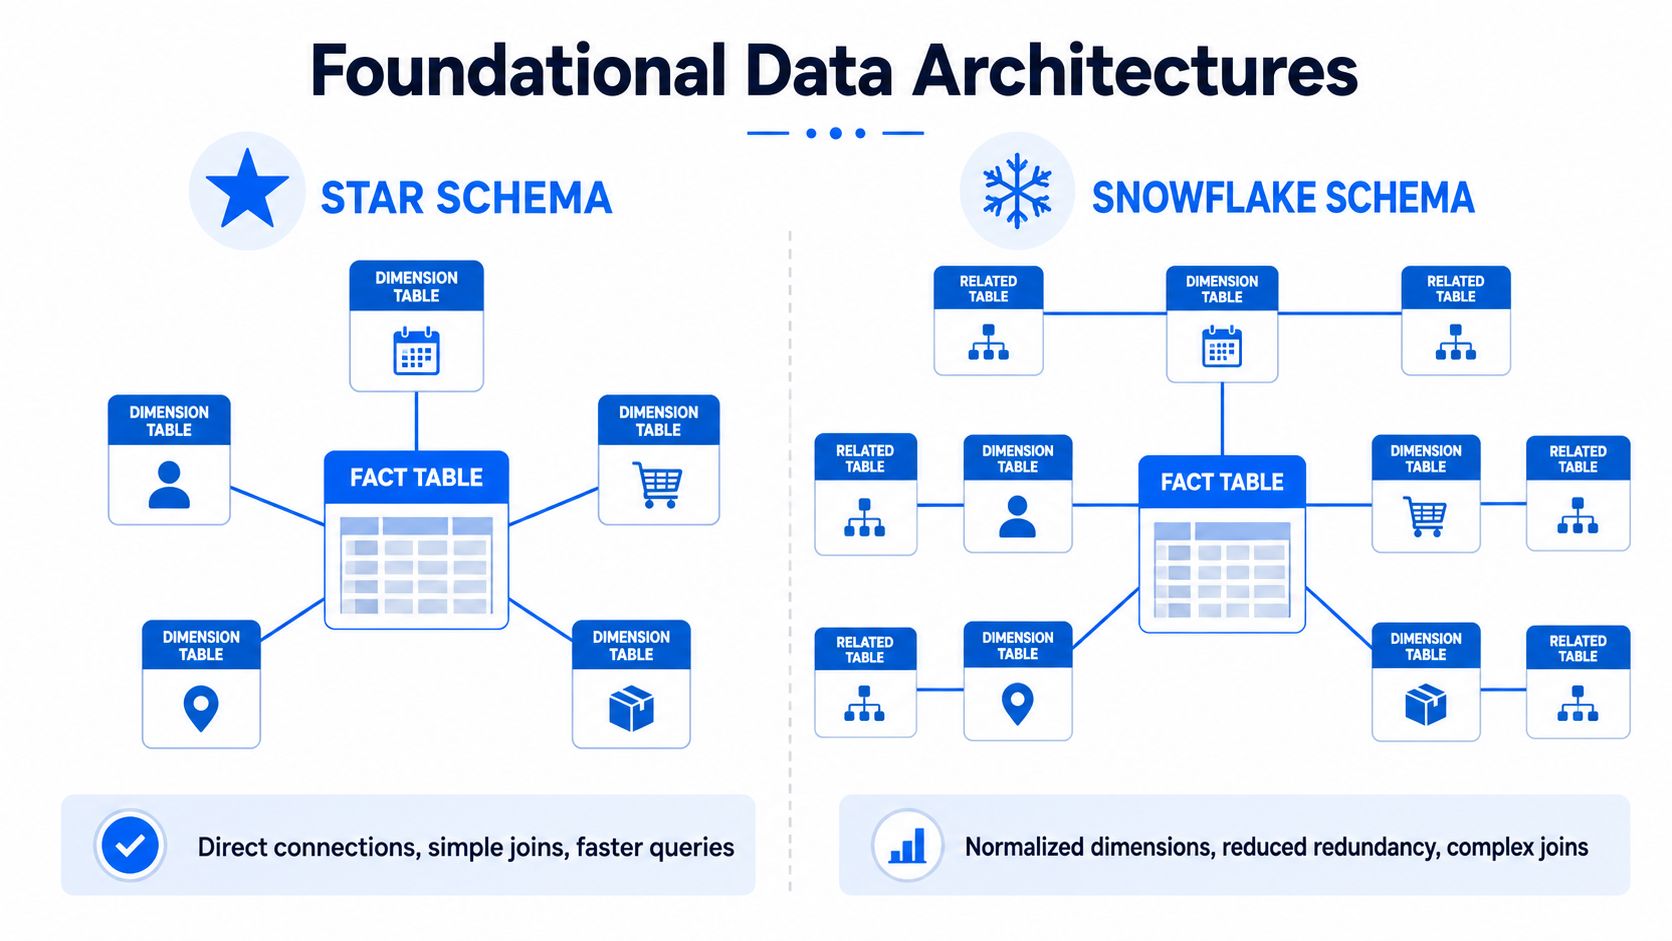
Lo schema a stella come modello a hub
Uno schema a stella mette al centro una tabella dei fatti e la collega direttamente alle tabelle delle dimensioni circostanti. Immaginate i fatti di vendita al centro e, attorno, le dimensioni prodotto, cliente, data e negozio. Ogni dimensione contiene gli attributi descrittivi di cui gli analisti hanno bisogno per raggruppare e filtrare.
Questa forma diretta è importante perché mantiene l'SQL breve e prevedibile. Gli analisti possono collegare la tabella dei fatti alle dimensioni senza navigare tabelle gerarchiche per categoria, regione o reparto. Se la vostra priorità è la velocità del reporting e la leggibilità del modello, ecco perché gli schemi a stella restano il punto di partenza predefinito.
Un riferimento pratico sulla modellazione del warehouse come la guida di digna alla modellazione dei dati nel warehouse è utile in questo contesto, perché inquadra la scelta progettuale in base al comportamento analitico e non solo alla normalizzazione da manuale.
Lo schema a fiocco di neve come modello ramificato
Uno schema a fiocco di neve parte dallo stesso centro, ma le tabelle delle dimensioni si ramificano in sotto-dimensioni correlate. Il prodotto può suddividersi in tabelle di sottocategoria e categoria. La geografia può suddividersi in città, regione e paese. La forma diventa più gerarchica e il livello delle dimensioni riflette in modo più esplicito i dati di riferimento condivisi.
Questa normalizzazione riduce la ridondanza e favorisce una maggiore coerenza tra gli attributi dimensionali. Se il nome di una categoria cambia, aggiornate la riga della dimensione corrispondente invece di ripetere la modifica in una tabella denormalizzata più piatta. Il compromesso è evidente nell'SQL. Più tabelle significano più join. Più join significano più complessità nelle query di BI, nella pianificazione delle query e nel troubleshooting.
Regola pratica: usate uno schema a stella quando le persone eseguono query di continuo. Usate uno schema a fiocco di neve quando sbagliare la coerenza delle dimensioni costa caro.
Un confronto dettagliato delle differenze principali
Una scelta progettuale inizia a contare quando viene messa alla prova dal traffico di produzione. La differenza tra stella e fiocco di neve emerge prima di tutto in tre ambiti: latenza delle query, manutenzione del modello e quantità di monitoraggio necessaria per mantenere affidabili le dimensioni nel tempo.
Tabella di confronto iniziale
Criterio | Schema a stella | Schema a fiocco di neve |
|---|---|---|
Struttura di base | Dimensioni denormalizzate attorno a una tabella dei fatti centrale | Dimensioni normalizzate che si ramificano in sotto-dimensioni |
Comportamento delle query | SQL più semplice, meno join | Più percorsi di join, SQL più complesso |
Usabilità per gli analisti | Più semplice per gli strumenti di BI e il reporting self-service | Più difficile da capire e usare per gli utenti occasionali |
Coerenza dimensionale | Buona, ma duplica i dati descrittivi | Integrità più solida per gli attributi condivisi |
Modello di storage | Maggiore ridondanza nelle dimensioni | Migliore efficienza dello storage |
Stile di manutenzione | Più rapido da costruire, più semplice da esporre | Modellazione e gestione delle dipendenze più accurate |
Ideale per | Analytics e dashboard con prevalenza di letture | Dimensioni di grandi dimensioni e governance più rigorosa |
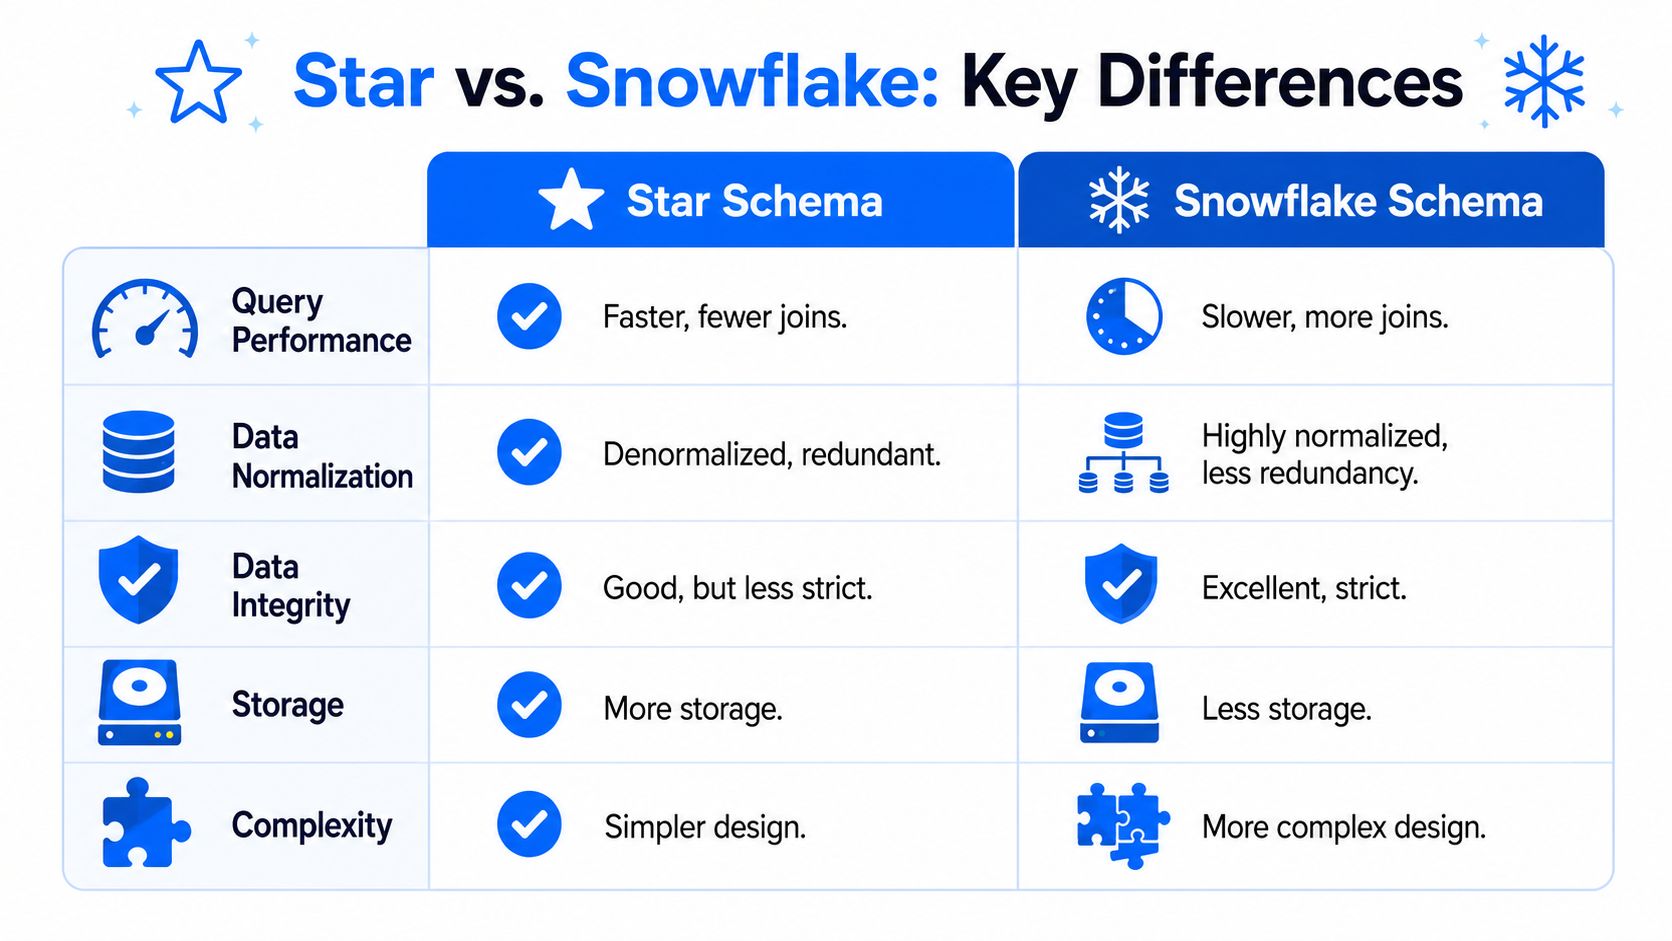
Prestazioni e comportamento dei join
Il numero di join resta l'indicatore più chiaro del comportamento quotidiano delle query. In uno schema a stella, gli analisti di solito collegano la tabella dei fatti a un piccolo insieme di dimensioni ampie e si fermano lì. In uno schema a fiocco di neve, queste dimensioni sono spesso suddivise in tabelle gerarchiche, quindi ogni report che raggruppa per categoria, regione o reparto aggiunge lavoro di join per il motore e più spazio per errori SQL.
Il confronto di Fivetran tra schema a stella e pattern one big table conferma la direzione generale di questo compromesso su Redshift, Snowflake e BigQuery. I modelli più piatti di solito si leggono più velocemente. Questo non rende lo schema a fiocco di neve un cattivo design. Significa che ogni ramo normalizzato deve giustificare il proprio costo in termini di latenza, complessità semantica e carico di supporto.
Questo emerge rapidamente negli strumenti di BI. I livelli semantici sono più facili da modellare sugli schemi a stella, perché il grafo dei join è più piccolo e più stabile. Anche i piani di esecuzione sono più facili da interpretare durante la risposta agli incidenti. Quando una dashboard rallenta dopo una modifica di schema, un modello dimensionale piatto offre agli ingegneri meno punti da ispezionare.
Integrità, storage e manutenzione operativa
Gli schemi a fiocco di neve si guadagnano il loro posto quando la coerenza dimensionale ha un costo operativo reale. Tassonomie di prodotto, strutture delle entità legali, classificazioni regolamentate dei clienti e gerarchie geografiche cambiano spesso sotto una governance più rigida rispetto ai fatti che vi fanno riferimento. Normalizzare queste strutture riduce gli attributi duplicati e la probabilità che due report usino versioni diverse dello stesso valore di riferimento.
L'efficienza dello storage è oggi un vantaggio secondario, dato che il calcolo nel warehouse richiede di solito più attenzione dello spazio su disco. Il problema maggiore è la gestione del cambiamento. Uno schema a stella sposta la complessità nelle pipeline ETL o ELT che appiattiscono le dimensioni prima che gli analisti le interroghino. Uno schema a fiocco di neve mantiene più pulito il modello di riferimento, ma sposta più complessità su join, definizioni semantiche e tracciamento delle dipendenze.
Questo compromesso incide sui diversi team in modi diversi:
Gli analisti scrivono SQL più breve sugli schemi a stella e dedicano meno tempo a ricostruire la logica gerarchica su più tabelle.
I data engineer impiegano meno tempo a esporre data mart curati su schemi a stella semplici, ma più tempo a gestire attributi duplicati e backfill quando i valori delle dimensioni derivano.
Gli sviluppatori BI e gli analytics engineer svolgono più lavoro di modellazione semantica sugli schemi a fiocco di neve, perché ogni ramo aggiuntivo richiede logica di join testata, nomi chiari e protezioni contro gli errori di fan-out.
I team di piattaforma hanno bisogno di un'osservabilità più solida sugli schemi a fiocco di neve. Collegamenti gerarchici interrotti, chiavi orfane e caricamenti ritardati delle dimensioni possono compromettere la correttezza dei report senza causare un errore bloccante della pipeline.
In produzione, quest'ultimo punto conta più di quanto ammettano molte guide di progettazione. Uno schema a stella di solito si guasta in modo visibile, ad esempio con attributi denormalizzati non aggiornati o ricostruzioni più lente. Uno schema a fiocco di neve può guastarsi in modo subdolo. Una sola riga mancante in una sotto-dimensione può modificare gli aggregati, far sparire categorie dalle dashboard o produrre percorsi di drill-down incoerenti tra strumenti diversi. Ecco perché la scelta dello schema dovrebbe includere una domanda operativa, non solo di modellazione: quale modalità di guasto è più facile da rilevare, spiegare e correggere per il vostro team?
L'ascesa dei modelli ibridi stella-fiocco di neve
Pochissimi warehouse di produzione restano puri a lungo. Le dimensioni di prodotto restano piatte perché gli analisti le interrogano ogni giorno. La geografia viene normalizzata perché le gerarchie regionali cambiano. Gli attributi dei clienti vengono suddivisi perché le regole di governance richiedono un controllo più stretto su alcuni campi ma non su altri. È ciò che viene spesso chiamato star snowflake schema.
Non è una terza architettura canonica. È un modello misto pragmatico.
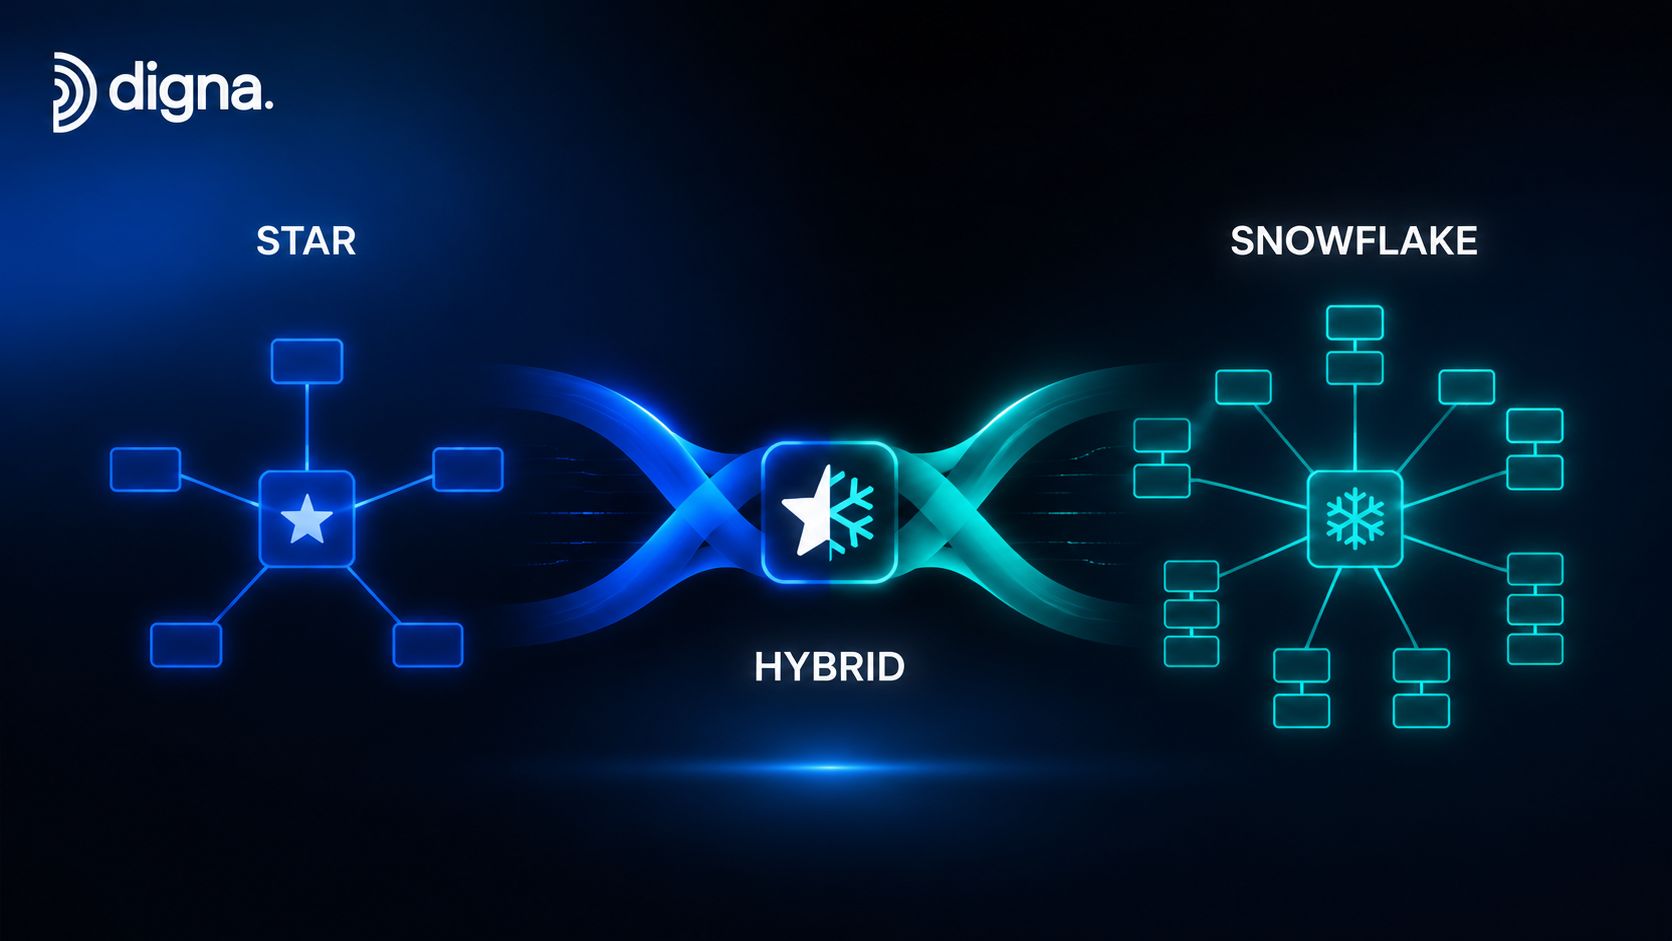
Dove compaiono i modelli ibridi
I pattern ibridi emergono di solito in uno di tre modi.
Un warehouse prevalentemente a stella con una dimensione a fiocco di neve. È frequente con geografia, tassonomia di prodotto o gerarchia organizzativa.
Un nucleo governato con data mart appiattiti. Il warehouse mantiene dimensioni di riferimento normalizzate, poi i data mart a valle espongono viste denormalizzate per il consumo in BI.
Un modello evoluto nel tempo. Nuove dimensioni sono state aggiunte con vincoli diversi, quindi alcune sono rimaste piatte mentre altre sono state normalizzate.
Questo approccio misto è spesso ragionevole. Secondo il confronto di Big Data Boutique, gli schemi a stella restano il punto di partenza ottimale per il 90% dei casi d'uso analitici, mentre i pattern a fiocco di neve sono riservati a dimensioni di grandi dimensioni o a requisiti di governance rigorosi.
Cosa funziona e cosa si rompe
Ciò che funziona è la normalizzazione selettiva. Un team può mantenere piatte le dimensioni ad alto traffico per le prestazioni delle dashboard e normalizzare a fiocco di neve le poche dimensioni in cui il costo della ridondanza o della governance è reale. Può essere un design disciplinato.
Ciò che non funziona è l'incoerenza accidentale. Una dimensione segue una nomenclatura conforme. Un'altra memorizza attributi duplicati in due punti. Gli analisti non sanno se la categoria debba provenire dalla tabella prodotto piatta o dalla tabella categoria normalizzata. L'SQL inizia a restituire risposte tecnicamente valide ma logicamente incoerenti.
Un modello ibrido aumenta anche il carico operativo:
Scelta di design ibrido | Vantaggio | Rischio comune |
|---|---|---|
Dimensione prodotto piatta | Analisi rapide per segmenti in BI | Deriva degli attributi di categoria duplicati |
Dimensione geografica normalizzata | Gerarchia riutilizzabile | Join aggiuntivi nel reporting basato sulla localizzazione |
Tabelle di riferimento condivise | Integrità migliore | Lineage e analisi d'impatto più complesse |
Data mart e modelli core misti | Consumo flessibile | Confusione su quali campi siano autorevoli |
I modelli ibridi falliscono quando i team mescolano i pattern senza disciplina su nomenclatura, responsabilità e validazione.
Come scegliere lo schema giusto per il vostro caso d'uso
Una decisione sullo schema viene di solito imposta da un problema di produzione, non dalla teoria. Un team di BI riceve lamentele per dashboard lente. Un responsabile della governance trova gerarchie di prodotto in conflitto tra i report di finanza e vendite. Un team di piattaforma passa troppo tempo a riparare aggiornamenti delle dimensioni dopo modifiche alle sorgenti. La scelta giusta parte dalla modalità di guasto che dovete ridurre.

Una chiave di lettura pratica per decidere
Partite dal percorso delle query. Se analisti, sviluppatori BI o strumenti a valle accedono direttamente alle tabelle del warehouse, lo schema a stella è di solito la scelta predefinita più sicura, perché mantiene prevedibili i join e rende più facile individuare gli errori semantici. Se un livello semantico nasconde la complessità del modello, avete più margine per normalizzare, ma il costo di manutenzione non scompare. I data engineer restano comunque responsabili di join, gestione delle chiavi e logica gerarchica sottostante.
La domanda successiva riguarda la frequenza dei cambiamenti. La normalizzazione a fiocco di neve ripaga quando le strutture delle dimensioni cambiano abbastanza spesso da rendere gli aggiornamenti ripetuti degli attributi un vero costo operativo. Tassonomie di prodotto, consolidamenti di entità legali, mappature regionali e piani dei conti sono esempi comuni. In questi casi, la normalizzazione riguarda meno l'eleganza e più il controllo dei percorsi di aggiornamento, la riduzione della logica di business duplicata e la minore probabilità che un report usi dati di riferimento non aggiornati.
Le prestazioni contano ancora, ma il compromesso va oltre il numero di join. Gli schemi a stella di solito rendono l'analisi ad hoc più rapida e più facile da ottimizzare. Gli schemi a fiocco di neve possono migliorare la coerenza nelle dimensioni condivise, ma creano anche più dipendenze, più lineage da tracciare e più modi in cui le modifiche a monte possono rompere le query a valle.
Usate queste domande per rendere concreta la decisione:
Chi gestisce l'ultimo miglio delle query? Gli utenti che scrivono SQL direttamente si trovano di solito meglio con dimensioni più piatte.
Quali dimensioni cambiano a livello strutturale, e non solo nel numero di righe? Cambiamenti frequenti nelle gerarchie giustificano spesso la normalizzazione.
Dove i dati errati generano il costo più alto? Se valori di riferimento duplicati o contrastanti creano problemi di audit, finanza o compliance, il controllo può contare più della velocità.
Quanti modelli a valle riutilizzano la stessa logica dimensionale? Una logica condivisa spinge il design verso un controllo centrale più forte.
Il team è in grado di monitorare il modello abbastanza bene da sostenere la complessità aggiuntiva? Un design a fiocco di neve o ibrido richiede lineage più rigorosa, controlli di freschezza e monitoraggio dell'integrità delle chiavi. I team che già investono in pratiche di data observability possono gestire questa complessità in modo più sicuro.
Punti di partenza per caso d'uso
Alcune scelte predefinite reggono bene alla prova dei fatti.
Analytics delle vendite retail: partite da uno schema a stella. Le dimensioni prodotto, negozio, cliente e data vengono filtrate di continuo, e la reattività delle dashboard conta di solito più della riduzione di una modesta ridondanza dimensionale.
Reporting finanziario con gerarchie controllate: partite da una normalizzazione selettiva a fiocco di neve o da un ibrido governato. Le strutture di conti ed entità cambiano sotto controlli formali, e consolidamenti incoerenti creano rapidamente rischi di reporting.
Analytics del comportamento utente e di prodotto: mantenete un modello piatto, a meno che una dimensione non sia sia grande sia molto riutilizzata. Questi team cambiano le definizioni rapidamente e ogni join aggiuntivo rallenta l'analisi e aumenta la probabilità di SQL incoerente.
Sanità e attività regolamentate: aspettatevi un ibrido. Gli utenti del reporting hanno comunque bisogno di data mart utilizzabili, ma i dati di riferimento su strutture sanitarie, sedi, set di codici e organizzazione richiedono spesso un controllo più stretto e responsabilità più chiare.
Una breve verifica decisionale intercetta molte implementazioni sbagliate:
Chiedete al team di BI quali dimensioni determinano la maggior parte di filtri, percorsi di drill-down e latenza delle dashboard.
Chiedete ai responsabili della governance quali attributi devono provenire da un'unica tabella controllata.
Chiedete agli analisti dove la logica dei join causa già risposte incoerenti.
Chiedete agli ingegneri di piattaforma quali dimensioni si guastano più spesso durante modifiche di schema nelle sorgenti o aggiornamenti arrivati in ritardo.
Se le risposte sono vaghe, il design non è pronto. Lo schema dovrebbe riflettere il modo in cui il warehouse viene gestito, monitorato e sottoposto a debug in produzione, non solo come appare su una lavagna.
Monitoraggio e osservabilità del vostro schema
La progettazione dello schema non è una scelta una tantum. È una superficie operativa che continua a cambiare con gli aggiornamenti di ingestione, le revisioni del modello, i rilasci delle applicazioni sorgente e i nuovi consumatori a valle. Il modello corretto lo scorso trimestre può diventare fragile senza che nessuno lo riprogetti formalmente.
Questo vale in particolare per uno star snowflake schema, inteso in senso pratico come modello misto di produzione.
La scelta dello schema non chiude il lavoro
I team monitorano spesso il successo delle pipeline e i costi del warehouse, ma non monitorano abbastanza da vicino il modello stesso. Questa lacuna si manifesta come schema drift, deriva silenziosa delle distribuzioni nelle tabelle dei fatti, dimensioni arrivate in ritardo, foreign key orfane o logica di business che supera i controlli strutturali pur fallendo sul piano analitico.
Il problema si acuisce negli ambienti ibridi. L'analisi di ThoughtSpot sulla complessità degli schemi rileva che il 40% dei team di analytics utilizza oggi modelli ibridi per bilanciare velocità delle query e storage, mentre le indicazioni più diffuse lasciano ancora una lacuna sulla validazione della logica di business a livello di record in queste strutture eterogenee.
Un programma di osservabilità generale per questi modelli dovrebbe sorvegliare quattro aspetti:
Modifiche strutturali: colonne aggiunte, colonne rimosse e cambi di tipo di dato nelle tabelle dei fatti o delle dimensioni.
Salute relazionale: foreign key interrotte, righe di dimensione mancanti e mappature gerarchiche non corrispondenti.
Deriva comportamentale: variazioni inattese di volumi, distribuzioni dei valori o pattern di valori nulli anche quando lo schema non è cambiato.
Tempistiche di consegna: caricamenti in ritardo che non rompono l'SQL ma minano la fiducia nei report.
Cosa monitorare nei modelli misti
Un'opzione pratica è l'approccio di digna alla data observability, in particolare quando un team ha bisogno di un monitoraggio in-database all'interno di un ambiente private cloud o on-premise. La documentazione della piattaforma indica che calcolo delle metriche, baseline e analisi dei trend vengono eseguiti all'interno del database del cliente senza alcuno spostamento di dati, e che il suo Schema Tracker segnala in tempo reale modifiche strutturali come colonne aggiunte o rimosse e cambi di tipo di dato. Il rilevamento delle anomalie apprende il comportamento normale per tempistiche e pattern stagionali e può individuare deviazioni nei volumi di record, nelle distribuzioni, problemi sulle chiavi di business composte e record orfani di foreign key. Il monitoraggio della tempestività traccia inoltre i pattern di consegna attesi, così che i ritardi vengano intercettati prima di propagarsi nei report.
Questo è importante perché i modelli a stella e a fiocco di neve si guastano in modo diverso. In un design a stella, le dimensioni denormalizzate tendono a nascondere duplicazioni e attributi descrittivi non aggiornati. In un design a fiocco di neve, il rischio si sposta verso catene di join interrotte, aggiornamenti gerarchici mancati e regressioni latenti delle prestazioni. In un modello ibrido, si presentano entrambe le classi di guasto.
Non limitatevi a monitorare se le tabelle sono state caricate. Monitorate se il modello significa ancora ciò che i vostri utenti pensano che significhi.
Esempi di modelli di dati e query SQL
La differenza di design diventa evidente quando si scrive SQL su entrambi i pattern. Di seguito lo stesso caso d'uso di vendita modellato in due modi: vendite totali per categoria di prodotto e regione del cliente.
Esempio di schema a stella
Un modello a stella mantiene categoria e regione direttamente nelle dimensioni che la maggior parte degli analisti già utilizza.
Query:
Questa query è breve, leggibile e difficile da usare in modo errato. Per la maggior parte dei carichi di lavoro di BI, è proprio questo il punto.
Esempio di schema a fiocco di neve
Un modello a fiocco di neve sposta categoria e regione in tabelle gerarchiche normalizzate.
Query:
I join aggiuntivi non sono catastrofici. Sono semplicemente cumulativi. Uno o due sono gestibili. Una gerarchia più profonda su diverse dimensioni diventa più difficile da mantenere, spiegare e ottimizzare.
In pratica, è per questo che molti team approdano a un ibrido selettivo. Mantengono in forma simile a una stella le dimensioni che gli analisti usano di continuo e normalizzano quelle che richiedono un controllo più forte.
Se il vostro warehouse mescola già dimensioni piatte e normalizzate, la parte difficile non è dare un nome al pattern. È mantenere il modello affidabile mentre strutture e comportamento dei dati cambiano. digna è un'opzione per i team che hanno bisogno di tracciamento dello schema, rilevamento delle anomalie, monitoraggio della tempestività e validazione a livello di record all'interno del proprio ambiente di database, senza spostare i dati di produzione fuori dal proprio controllo.
Poiché i modelli ibridi si rompono spesso a causa di una colonna aggiunta o di un tipo di dato modificato in una tabella dei fatti o delle dimensioni, è utile sapere come digna Schema Tracker segnala le modifiche strutturali prima che raggiungano i report.
Domande frequenti
Che cos'è uno star snowflake schema?
Non è una terza architettura canonica, ma un modello misto pragmatico, in cui alcune dimensioni restano piatte come in uno schema a stella e altre vengono normalizzate in sotto-dimensioni come in uno schema a fiocco di neve. Un esempio tipico mantiene piatta la dimensione prodotto, mentre la geografia viene normalizzata in città, regione e paese.
Qual è la differenza tra uno schema a stella e uno schema a fiocco di neve?
Uno schema a stella collega una tabella dei fatti centrale direttamente a tabelle delle dimensioni denormalizzate, mantenendo l'SQL breve e con meno join. Uno schema a fiocco di neve normalizza le dimensioni in sotto-dimensioni, ad esempio il prodotto in sottocategoria e categoria, migliorando coerenza ed efficienza dello storage ma aggiungendo join e complessità semantica.
Uno schema a stella è più veloce di uno schema a fiocco di neve?
Di solito sì, perché il numero di join è l'indicatore più chiaro del comportamento quotidiano delle query, e i modelli più piatti si leggono generalmente più velocemente su Redshift, Snowflake e BigQuery. Nell'esempio dell'articolo, le vendite totali per categoria di prodotto e regione del cliente richiedono due join nello schema a stella ma quattro nella versione a fiocco di neve.
Quando conviene usare uno schema a fiocco di neve invece di uno schema a stella?
Usate uno schema a fiocco di neve quando sbagliare la coerenza delle dimensioni costa caro, ad esempio per tassonomie di prodotto, consolidamenti di entità legali, mappature regionali o un piano dei conti che cambiano sotto controlli formali. Altrimenti partite da uno schema a stella, che un confronto citato definisce il punto di partenza ottimale per il 90% dei casi d'uso analitici.
Cosa bisogna monitorare in un modello ibrido star snowflake?
Sorvegliate quattro aree: modifiche strutturali come colonne aggiunte o cambi di tipo, salute relazionale come foreign key interrotte e righe di dimensione mancanti, deriva comportamentale in volumi, distribuzioni e valori nulli, e tempistiche di consegna. I modelli ibridi ereditano entrambe le classi di guasto: attributi piatti non aggiornati e catene di join normalizzate interrotte.


