Ruoli della data governance: guida pratica al team moderno
|
8
min di lettura

Potete avere un charter, un consiglio e una presentazione sulla governance perfettamente rifinita, e perdere comunque il controllo nel momento in cui un caricamento errato rompe una dashboard o una revisione sulla privacy blocca un rilascio. È la parte che i team avvertono per prima. Il documento esiste, la riunione si è tenuta, ma nessuno sa dire chi è responsabile della prossima azione, chi verifica le prove o chi corregge i dati prima che se ne accorgano gli utenti di business.
È per questo divario che i ruoli della data governance contano più delle etichette nell'organigramma. Il compito è assegnare diritti decisionali, percorsi di escalation e stewardship quotidiana, in modo che il lavoro prosegua quando una policy si trasforma in un incidente. Se state costruendo o riorganizzando un programma di governance, la domanda utile non è “quali titoli abbiamo?”, ma “chi è responsabile del lavoro operativo e come si riflette questa responsabilità nel catalogo, nel monitoraggio e nel processo di revisione?”
Indice
Perché i ruoli della data governance smettono di funzionare nei team moderni
Perché l'elenco dei ruoli non basta
Il modello a quattro livelli che organizza ogni ruolo della data governance
Esecutivo, strategico, tattico, operativo
Come usare il modello nella pratica
I ruoli chiave della data governance e di che cosa è responsabile ciascuno
Il Chief Data Officer stabilisce la direzione
Il data owner risponde del dominio
Il data steward gestisce il lavoro rivolto al business
Il data custodian gestisce i controlli tecnici
I ruoli di engineering e come si inseriscono nella matrice RACI
Responsible non significa accountable
Dove avvengono di solito i passaggi di consegne
Una semplice istantanea RACI
Collegare i ruoli alle funzionalità di observability e Data Quality
Chi è responsabile dell'output di ogni controllo
Associare la funzionalità al ruolo
Perché questo cambia il lavoro quotidiano
KPI, punti fermi delle job description e consiglio di governance
Riferimento ruoli-KPI
Che cosa dovrebbe fare davvero il consiglio
Come assegnare e rendere operativi i ruoli senza ricostruire l'organigramma
Una sequenza pratica
Perché i ruoli della data governance smettono di funzionare nei team moderni
Un programma di governance può sembrare completo fino al primo vero incidente. Il team ha un charter, un consiglio e dei responsabili nominati, eppure il problema che arriva in produzione è operativo, non cerimoniale. Uno schema cambia, un dataset arriva in ritardo, una richiesta di accesso necessita di prove, e tutti si pongono la stessa domanda: chi è responsabile del lavoro adesso?
Questa confusione nasce perché i ruoli della data governance non sono semplici titoli professionali. Sono una struttura di responsabilità a più livelli che collega la strategia all'esecuzione, e questa struttura deve reggere durante il monitoraggio, il triage, la validazione e la raccolta delle prove. Come illustrato in precedenza, la Commissione europea inquadra la governance in termini stratificati, separando responsabilità esecutive, manageriali e operative, con ruoli come data owner, data steward e data user distribuiti tra organi di governance, sicurezza, ufficio legale e funzioni di management nella sua sintesi dei modelli di governance.
Perché l'elenco dei ruoli non basta
La maggior parte dei fallimenti inizia quando un team tratta la governance come un documento anziché come un modello operativo. Una policy può dire che cosa dovrebbe accadere, ma non dice chi sorveglia le derive, chi raccoglie le prove o chi approva le eccezioni quando la realtà non corrisponde allo standard. Ecco perché i soli nomi dei ruoli non risolvono il problema.
Regola pratica: se nessuno è responsabile del lavoro di routine, nessuno è responsabile del programma.
Gli articoli di settore di DATAVERSITY descrivono la governance in quattro livelli di responsabilità, esecutivo, strategico, tattico e operativo, esprimendo lo stesso concetto in modo diverso. Il modello serve ad assegnare chi decide, chi coordina, chi gestisce il processo e chi si occupa delle eccezioni (panoramica di DATAVERSITY). Quando questi livelli si confondono, uno steward viene trascinato nella strategia, un ingegnere si ritrova a decidere le policy o un consiglio finisce per esaminare alert che avrebbero dovuto essere gestiti prima.
Il cambio di prospettiva utile è semplice. Smettete di chiedervi se l'azienda ha i titoli “giusti”. Iniziate a chiedervi se ogni ruolo ha un carico di lavoro reale, un passaggio di consegne chiaro e un luogo in cui confluiscono le prove quando qualcosa va storto.
Il modello a quattro livelli che organizza ogni ruolo della data governance
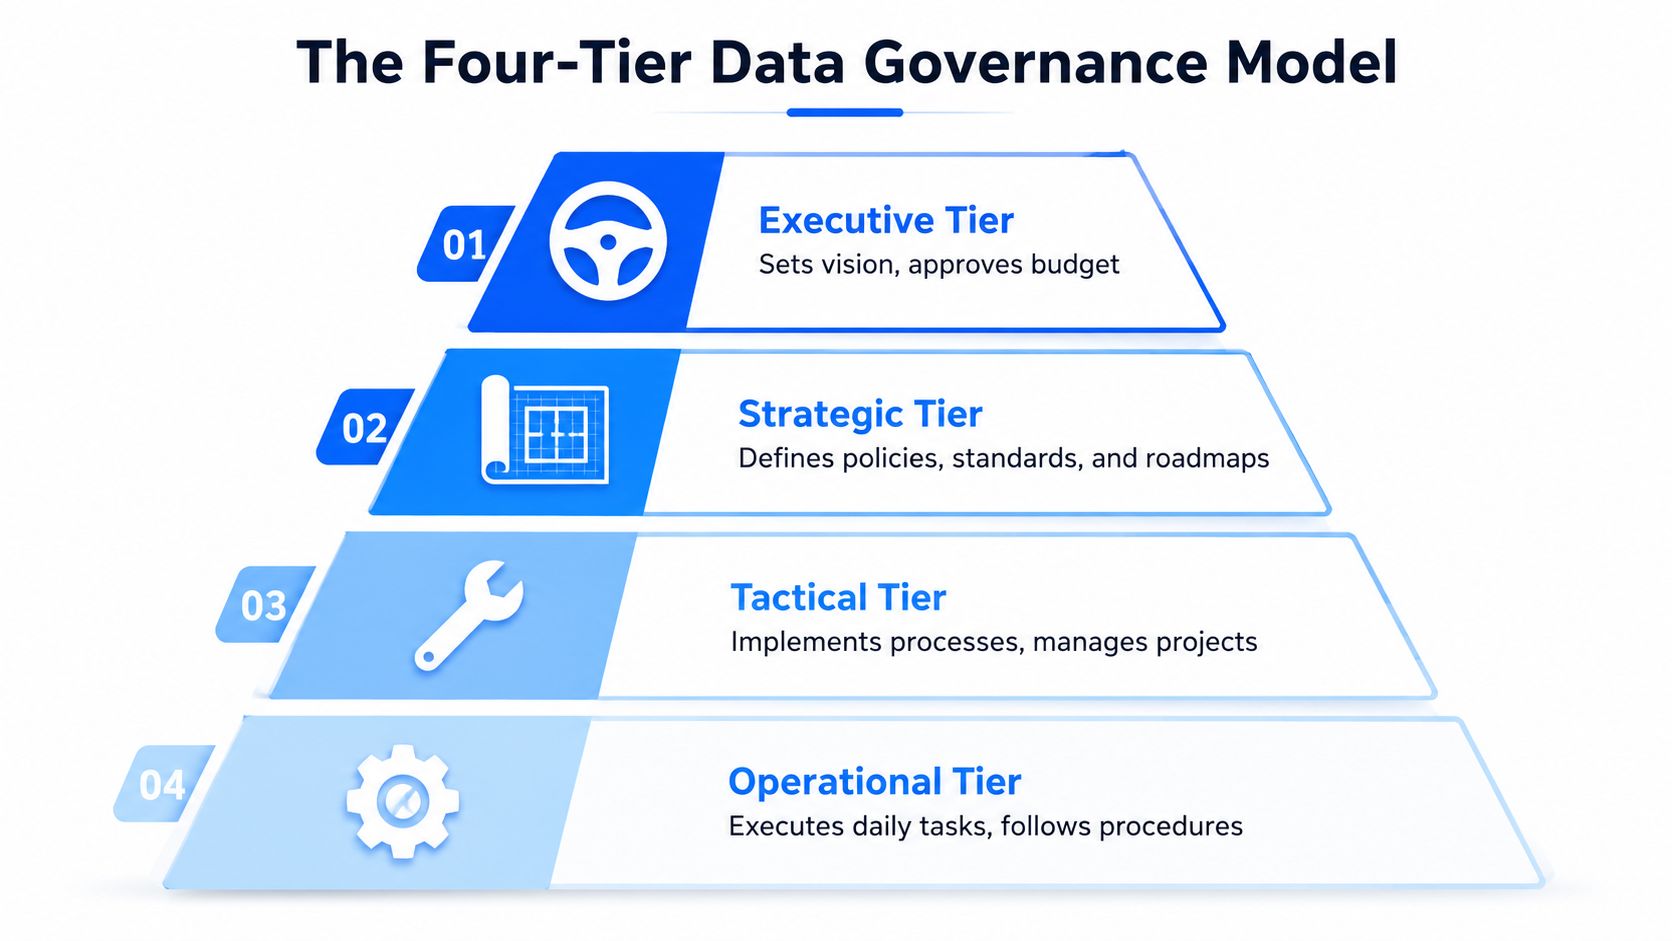
Un titolo di governance diventa più facile da collocare quando si sa a quale livello appartiene. Chi stabilisce la direzione si trova nella parte alta del modello. Chi esegue i controlli, registra le prove o gestisce le eccezioni si trova più in basso. La confusione inizia quando ci si aspetta che un solo titolo copra tutti i livelli contemporaneamente.
Esecutivo, strategico, tattico, operativo
Il livello esecutivo stabilisce direzione, finanziamenti e propensione al rischio. Risponde a una domanda semplice: perché esiste questo programma di governance e quali compromessi sono accettabili?
Il livello strategico traduce questa direzione in policy, standard e priorità. Decide le regole che il business seguirà e i risultati che il programma dovrebbe misurare.
Il livello tattico organizza il programma. Un governance office o un team di programma coordina standard, progettazione del framework, percorsi di escalation e allineamento interfunzionale. È il livello che impedisce al lavoro di diventare un insieme di decisioni scollegate.
Il livello operativo gestisce il lavoro che si presenta ogni giorno. Le persone a questo livello gestiscono la classificazione degli accessi, le definizioni, il monitoraggio, la documentazione, il triage dei problemi e le prove che dimostrano il rispetto dei controlli.
Come già osservato nella panoramica dei modelli di governance, la Commissione europea adotta un approccio stratificato che separa le responsabilità tra livelli esecutivo, manageriale e operativo, con organi di supporto e titolari di ruolo distribuiti in tutta l'organizzazione. Questo è importante perché dimostra che tale struttura è un modo pratico per evitare che un solo titolo si faccia carico di compiti in conflitto tra loro.
Come usare il modello nella pratica
Se state leggendo una job description o redigendo un charter, collocate prima il ruolo in un livello. Poi chiedetevi quale lavoro ricade su quel ruolo ogni giorno. Un data owner si colloca più vicino alla responsabilità strategica, mentre un data steward di solito si trova più vicino all'esecuzione tattica e operativa, come illustrato in questa definizione di data steward. Un data custodian opera nelle operations tecniche, e il Chief Data Officer si colloca al di sopra di loro, legando la governance agli obiettivi di business.
Il modello diventa utile quando lo collegate al lavoro reale, non solo ai titoli. Uno steward dovrebbe sapere quale coda di segnalazioni monitora, quali controversie sulle definizioni gestisce e quali prove raccoglie per gli audit. Un custodian dovrebbe sapere quali controlli convalida e quali sistemi ispeziona quando qualcosa deriva. Se vi serve un esempio pratico di come la conoscenza si sposta tra i team, la stessa logica emerge negli sforzi per costruire un team più efficace con una conoscenza migliore, dove la responsabilità funziona solo quando il passaggio di consegne è chiaro.
Una volta individuato il livello, il passo successivo è molto più semplice. Potete scrivere responsabilità che corrispondono al lavoro, definire passaggi di consegne senza sovrapposizioni ed evitare di caricare un singolo ruolo di strategia, coordinamento ed esecuzione quotidiana allo stesso tempo.
I ruoli chiave della data governance e di che cosa è responsabile ciascuno
Molti team usano gli stessi quattro ruoli, ma li descrivono in modo così vago che nessuno sa dire dove finisce uno e dove inizia l'altro. È rischioso, perché il Chief Data Officer, il Data Owner, il Data Steward e il Data Custodian rispondono ciascuno a una domanda diversa. Se li confondete, confondete anche le responsabilità.
Il Chief Data Officer stabilisce la direzione
Il Chief Data Officer, o CDO, è il dirigente che definisce ed esegue la strategia sui dati, supervisiona policy e framework di governance, garantisce la conformità alle normative e agli standard di sicurezza e allinea il lavoro di governance agli obiettivi di business, come descritto da Actian (Actian sui ruoli di governance). Il CDO non è responsabile di ogni dataset. Il CDO è responsabile della forma del programma e del suo business case.
Questa distinzione conta nelle organizzazioni reali. Un CDO dovrebbe saper rispondere a domande su priorità, finanziamenti ed escalation del programma, ma non essere coinvolto nell'approvazione di ogni richiesta di accesso o nella correzione di ogni definizione errata.
Il data owner risponde del dominio
Il Data Owner è la persona che risponde dei dati di un dominio e della loro idoneità all'uso. In pratica, ciò significa approvare le policy del dominio, fare scelte di compromesso sui rischi e dare il via libera quando servono eccezioni.
Un buon modo di pensare al ruolo dell'owner è: responsabilità senza lavoro operativo quotidiano. L'owner decide che cosa significa “buono”, chi può usare i dati e che cosa succede quando la qualità non è all'altezza.
Il data steward gestisce il lavoro rivolto al business
Il Data Steward lavora all'interno della business unit ed è il più vicino ai dettagli operativi. Una definizione del ruolo di stewardship di digna descrive questo ruolo come quello che mantiene le definizioni, chiarisce come i dati devono essere usati e gestisce il lavoro quotidiano di governance, il che la rende un riferimento utile per redigere un charter pratico (definizione di data steward).
Una descrizione separata di DATAVERSITY afferma che gli steward operativi creano e approvano le definizioni dei dati, identificano e classificano i livelli di accesso e definiscono come i dati saranno usati e gestiti (panoramica delle responsabilità operative). È il ruolo che viene coinvolto nella raccolta delle prove, nel follow-up dei problemi e nella conversazione su “che cosa è cambiato?” dopo un incidente sui dati.
Per i team che hanno bisogno di un modello operativo più ampio, anche la condivisione della conoscenza aiuta. Una risorsa come costruire un team più efficace con una conoscenza migliore è utile perché la governance crolla rapidamente quando le persone non riescono a trovare le definizioni, le decisioni o lo storico delle eccezioni più recenti.
Il data custodian gestisce i controlli tecnici
Il Data Custodian è responsabile del lato tecnico: storage, controlli di accesso, backup, archiviazione e infrastruttura. I framework di ruolo del settore collocano i custodian sul lato dell'implementazione, dove avviene il controllo tecnico.
Ciò significa che il custodian non decide la policy, ma garantisce che la piattaforma la applichi. Se uno steward stabilisce che un dataset richiede un accesso limitato o una regola di conservazione, è il custodian a rendere concreto il controllo.
Usate questo test: se il lavoro cambia la regola, appartiene ai livelli superiori. Se il lavoro applica la regola, appartiene ai livelli inferiori.
I ruoli di engineering e come si inseriscono nella matrice RACI
Gli ingegneri chiedono spesso dove si collocano, perché i diagrammi di governance di solito saltano dall'owner allo steward e tralasciano il livello di delivery. Questo lascia un vuoto reale. Pipeline di dati, modelli semantici e sistemi di ML hanno comunque bisogno di qualcuno che implementi i controlli, e queste persone sono di solito data engineer, analytics engineer e ML engineer.
Responsible non significa accountable
Una lettura RACI pulita aiuta. Il Data Owner resta Accountable per il dominio dei dati. I ruoli di engineering sono di solito Responsible dell'implementazione dei controlli e delle verifiche richiesti dalla governance.
Un Data Engineer è Responsible della realizzazione dei controlli di pipeline definiti dallo steward, incluse la logica di caricamento, gli hook di validazione e le correzioni operative. Un Analytics Engineer è Responsible della modellazione dei dati in linea con le definizioni e le aspettative di lineage, così che il livello di business rifletta il significato concordato dei dati. Un ML Engineer è Responsible della governance di feature e modelli, inclusi lineage, controlli sui bias e regole di validazione.
Nessuno di questi ruoli di engineering dovrebbe essere considerato l'owner del dominio stesso. Possono essere responsabili di un'attività, di una pipeline o di un modello, ma la responsabilità di business resta in capo al Data Owner.
Dove avvengono di solito i passaggi di consegne
Il passaggio di consegne inizia con una definizione o una decisione di policy, poi passa all'implementazione. Lo steward chiarisce la regola, l'ingegnere la codifica e l'owner dà il via libera quando il dominio richiede un'eccezione o una decisione sul rischio.
Questa suddivisione mantiene la governance concreta. Gli ingegneri non devono indovinare le policy e gli owner non devono fare il debug del codice. Il sistema funziona perché ogni persona ha un tipo specifico di responsabilità.
Negli ambienti sensibili alla privacy o con un uso intensivo dell'AI, il passaggio di consegne diventa ancora più importante. I team non possono affidarsi soltanto ad accessi ampi, quindi il ruolo di governance deve definire quali dati possono essere visti, quali controlli devono essere eseguiti e quali prove devono essere conservate. Una piattaforma attenta alla governance può aiutare, e strumenti come digna sono progettati per funzionare nell'ambiente del cliente, validando i record, monitorando la tempestività, rilevando le modifiche allo schema e monitorando le metriche di business e di piattaforma.
Una semplice istantanea RACI
Ruolo | Nella matrice RACI | Responsabilità tipiche |
|---|---|---|
Data Owner | Accountable | Rischio del dominio, approvazioni, eccezioni |
Data Steward | Responsible | Definizioni, regole, follow-up |
Data Engineer | Responsible | Pipeline, controlli tecnici, correzioni |
Analytics Engineer | Responsible | Modelli semantici, lineage, coerenza |
ML Engineer | Responsible | Feature, controlli sui modelli, validazione |
Se mantenete chiara questa suddivisione, il resto del programma diventa più facile da governare. Altrimenti, ogni problema si trasforma in un dibattito su chi avrebbe dovuto accorgersene per primo.
Collegare i ruoli alle funzionalità di observability e Data Quality
I team spesso acquistano l'observability per il segnale, poi dimenticano di collegare il segnale al modello dei ruoli. È un approccio al contrario. Le funzionalità di observability esistono perché le persone possano svolgere il proprio lavoro più velocemente e con prove migliori, non perché le dashboard restino in un angolo separato dello stack.
Chi è responsabile dell'output di ogni controllo
Un Data Steward definisce che cosa significa “buono” per un dataset, inclusa la soglia di qualità accettabile e il significato di business delle regole. La piattaforma poi sorveglia le deviazioni tramite rilevamento delle anomalie, monitoraggio della tempestività, tracciamento dello schema e validazione a livello di record. Queste funzionalità sono centrali nel modo in cui digna descrive i propri moduli di Data Quality e observability, insieme all'esecuzione in-database e al monitoraggio all'interno dell'ambiente del cliente.
Quando la piattaforma segnala qualcosa, l'ingegnere analizza la causa principale. L'owner approva la remediation o la gestione dell'eccezione quando il problema incide sull'uso di business. Questa sequenza è importante perché l'observability non sostituisce la responsabilità: fornisce a ogni ruolo le prove di cui ha bisogno per agire.
Associare la funzionalità al ruolo
Un modo utile di pensarci è partire dall'output, non dallo strumento.
Il rilevamento delle anomalie fa emergere comportamenti inattesi. L'ingegnere indaga e lo steward decide se la deviazione viola la regola.
Il monitoraggio della tempestività mostra se i dati sono arrivati quando previsto. Il responsabile delle operations o l'ingegnere interviene per primo, mentre lo steward conferma se il ritardo incide sull'uso a valle.
Il tracciamento dello schema intercetta la deriva strutturale. Il custodian o l'ingegnere corregge la pipeline e lo steward verifica se le definizioni devono essere aggiornate.
La validazione a livello di record dimostra che le regole di business sono rispettate a livello di riga o di record. Lo steward è responsabile della regola e l'ingegnere implementa il controllo.
La piattaforma dovrebbe generare l'alert, ma sono comunque le persone a dover decidere che cosa significa.
Questo principio diventa ancora più importante negli ambienti regolamentati. Se vi serve un esempio pratico di come vengono gestite le formulazioni su conservazione, condivisione e controllo in un contesto formale, consultate il DPA legale di Formcarry. È un utile promemoria del fatto che i ruoli di governance non si limitano a definire le policy, ma supportano anche la traccia probatoria alla base degli impegni in materia di privacy e trattamento dei dati.
La stessa logica emerge nelle indicazioni più generali sull'observability. La panoramica di digna su che cos'è la data observability mostra perché il monitoraggio ha valore solo quando il team sa chi risponde al segnale. È questo il workflow centrale: definire la regola, osservare i dati, analizzare l'eccezione e registrarne la risoluzione.
Perché questo cambia il lavoro quotidiano
Uno steward non dovrebbe controllare ogni riga di una dashboard tutto il giorno. Non è stewardship, è sovraccarico operativo. Lo steward dovrebbe ricevere prove chiare, decidere se la regola corrisponde ancora all'esigenza di business ed effettuare l'escalation quando un pattern ricorrente suggerisce un cambiamento nella governance.
Questa separazione mantiene l'observability utilizzabile. La piattaforma fa emergere i problemi. I ruoli trasformano quei problemi in azioni.
KPI, punti fermi delle job description e consiglio di governance
Un ruolo senza un output misurabile tende a perdere la rotta. Il modo più semplice per mantenere la governance con i piedi per terra è associare un KPI a ogni ruolo e usare queste metriche nel consiglio. Per i team che hanno bisogno di una prospettiva più ampia sulle metriche, la guida di Kogifi alle metriche di governance del cloud ibrido è un utile punto di riferimento per pensare insieme a controllo, prestazioni e responsabilità.
Riferimento ruoli-KPI
Ruolo | KPI principale | Output operativo |
|---|---|---|
Data Owner | Percentuale di dataset critici con owner documentati | Ownership approvata e decisioni sulle eccezioni |
Data Steward | Tempo medio di triage degli incidenti sui dati | Revisione dei problemi, chiarimento delle regole, escalation |
Data Custodian | Percentuale di pipeline con alert sulle modifiche allo schema | Copertura dei controlli e applicazione tecnica |
Data Engineer | Percentuale di pipeline monitorate con controlli di validazione | Controlli funzionanti, correzioni e risoluzione degli incidenti |
Data Governance Office | Percentuale di standard di governance con workflow assegnati | Coordinamento del programma e manutenzione del framework |
Il consiglio di governance è il luogo in cui si risolvono i compromessi tra domini. Non è una riunione di aggiornamento sullo stato. È il luogo in cui privacy e accesso, velocità e controllo, costi e qualità vengono discussi con i giusti decisori presenti.
Che cosa dovrebbe fare davvero il consiglio
Il consiglio dovrebbe definire i percorsi di escalation, confermare i diritti decisionali ed esaminare i KPI che mostrano se il modello operativo funziona. Se uno steward continua a effettuare l'escalation dello stesso tipo di problema, il consiglio dovrebbe chiedersi se la policy è sbagliata, se manca il controllo o se la linea di responsabilità è poco chiara.
Un charter pratico di solito comprende tre elementi. Primo, quali ruoli partecipano e chi può prendere decisioni. Secondo, quali tipi di problemi arrivano al consiglio. Terzo, come le eccezioni vengono registrate e riesaminate in seguito.
La cadenza delle riunioni conta meno della disciplina. Una revisione regolare e breve con decisioni reali è più utile di una lunga sessione che produce soltanto appunti. Il consiglio dovrebbe lasciare dietro di sé azioni definite, responsabili assegnati e requisiti di prova.
Come assegnare e rendere operativi i ruoli senza ricostruire l'organigramma
Il modo più sicuro per assegnare i ruoli di governance è partire dal lavoro che le persone già svolgono. Il data governance toolkit del Nuovo Galles del Sud raccomanda di assegnare le responsabilità in tutta l'organizzazione, mapparle in un data catalogue e formalizzarle dove già esistono, invece di assegnarle a qualcuno che non svolge quel lavoro quotidianamente (toolkit di governance del NSW). È l'istinto giusto per la maggior parte delle aziende.
Una sequenza pratica
Iniziate identificando chi gestisce già definizioni, approvazioni, prove e follow-up degli incidenti. Poi formalizzate queste responsabilità invece di inventare un nuovo livello di accountability. Se il business ha già uno steward di fatto, nominate esplicitamente quella persona o quel team.
Poi individuate le lacune. La maggior parte dei programmi ha bisogno di uno sponsor esecutivo e di un coordinatore del consiglio, e devono essere persone con un nome, non comitati generici. Lo sponsor conferisce autorità al programma e il coordinatore fa sì che le decisioni non si perdano tra una riunione e l'altra.
Quindi collegate ogni ruolo al catalogo, agli output del monitoraggio e al percorso di escalation. Se una persona è responsabile di un dominio, questa responsabilità dovrebbe comparire nel catalogo. Se scatta un controllo, l'alert dovrebbe arrivare alla persona giusta. Se serve una decisione, il percorso di escalation dovrebbe essere visibile prima che il problema diventi urgente.
Infine, riesaminate il modello ogni trimestre usando i KPI del consiglio. In questo modo la progettazione dei ruoli resta legata al comportamento reale e non a pii desideri.
Un programma non ha bisogno di un nuovo organigramma per funzionare. Ha bisogno di responsabilità chiare, prove visibili e di un modo per passare dall'alert all'azione senza confusione. Se volete un modo strutturato per implementare questo modello operativo, consultate come implementare la data governance e traducete i ruoli nel vostro catalogo, nei vostri controlli e nella vostra cadenza di revisione.
Se state definendo o correggendo i ruoli della data governance, digna può aiutarvi a collegare la responsabilità al lavoro di monitoraggio che avviene dietro le quinte. Funziona all'interno del vostro ambiente, valida i record, monitora la tempestività, rileva le modifiche allo schema e fa emergere le prove di cui i team hanno bisogno per agire. Visitate digna per vedere come si inserisce in un modello operativo di governance reale.
Una volta che uno steward ha definito che cosa significa “buono” per un dataset, digna Data Validation è lo strumento con cui gli ingegneri possono trasformare quelle regole di business in controlli a livello di record che producono le prove approvate dagli owner.
Domande frequenti
Quali sono i quattro livelli dei ruoli della data governance?
Il modello distingue i livelli esecutivo, strategico, tattico e operativo. Il livello esecutivo stabilisce direzione, finanziamenti e propensione al rischio; il livello strategico redige policy e standard; il livello tattico, di solito un governance office, coordina escalation e allineamento; il livello operativo gestisce ogni giorno classificazione, definizioni, monitoraggio, triage e prove per gli audit.
Qual è la differenza tra un data owner e un data steward?
Il data owner risponde dei dati di un dominio e della loro idoneità all'uso: approva le policy, fa scelte di compromesso sui rischi e approva le eccezioni. Lo steward lavora nella business unit e svolge il lavoro quotidiano: mantiene le definizioni, chiarisce l'uso dei dati, raccoglie le prove e segue i problemi dopo gli incidenti. Ownership significa responsabilità senza lavoro operativo quotidiano.
Che cosa fa un data custodian nella data governance?
Un data custodian è responsabile del lato tecnico: storage, controlli di accesso, backup, archiviazione e infrastruttura. Il custodian non decide la policy, ma garantisce che la piattaforma la applichi. L'articolo propone un test semplice: se il lavoro cambia la regola, appartiene ai livelli superiori; se applica la regola, appartiene ai livelli inferiori.
Dove si collocano i data engineer in una matrice RACI di governance?
Gli ingegneri sono Responsible, non Accountable. I data engineer realizzano i controlli di pipeline definiti dagli steward, gli analytics engineer modellano i dati in linea con definizioni e lineage concordati e gli ML engineer gestiscono i controlli su feature e modelli. La responsabilità del dominio resta al data owner, quindi gli ingegneri possono essere responsabili di una pipeline senza esserlo dei dati.
Quali KPI andrebbero assegnati ai ruoli della data governance?
Associate un KPI principale a ogni ruolo ed esaminateli nel consiglio di governance. Tra gli esempi suggeriti: la percentuale di dataset critici con owner documentati per i data owner, il tempo medio di triage per gli steward, la percentuale di pipeline con alert sulle modifiche allo schema per i custodian e la percentuale di pipeline monitorate con controlli di validazione per gli ingegneri.


