Rilevamento del model drift: guida pratica per il 2026
|
8
min di lettura

Di solito il model drift non si nota quando inizia. Le dashboard restano verdi, il modello continua a produrre punteggi e il primo segnale arriva da un utente di business che dice che approvazioni o raccomandazioni sembrano “strane” rispetto al mese scorso. Quando qualcuno apre un ticket, il modello sta spesso girando su presupposti superati da giorni, a volte anche di più, e il team sta già facendo debug sul livello sbagliato.
Ecco perché il rilevamento del model drift deve partire come un problema di data observability. Il modello è solo una parte del sistema. Gli input cambiano, gli schemi si rompono, le etichette arrivano in ritardo, la confidenza cambia impercettibilmente e la distribuzione degli output inizia a oscillare prima che si manifesti un evidente calo di accuratezza.
Indice
Perché le metriche di performance intercettano il drift troppo tardi
Baseline, soglie e instradamento degli alert che funzionano davvero
Quando un modello smette silenziosamente di funzionare
Un modello antifrode può sembrare in salute per settimane mentre il business perde soldi. Le dashboard mostrano un traffico normale, il modello restituisce ancora punteggi e nessuno vede nulla di allarmante finché un responsabile dei pagamenti non chiede perché un segmento di clienti ben noto venga rifiutato più spesso del previsto. È questa la parte dolorosa del drift. Non sempre arriva come un crash: spesso arriva come un cambiamento di comportamento che le persone notano prima del monitoraggio.
Un buon programma di gestione del drift intercetta questo spostamento prima che la lamentela arrivi su Slack. Il compito pratico non è solo osservare l'accuratezza, ma osservare il sistema che alimenta il modello, le previsioni che emette e la tempistica delle etichette che alla fine confermano se aveva ragione. È la differenza tra un semplice monitor del modello e un vero livello di data observability per il ML.
Regola pratica: se uno stakeholder nota il drift prima della piattaforma, la piattaforma sta monitorando la cosa sbagliata.
Il modello mentale utile è semplice. Il drift degli input si manifesta quando cambiano le distribuzioni delle feature. Il drift degli output si manifesta quando si spostano le distribuzioni dei punteggi o la confidenza. Lo schema drift si manifesta quando le colonne cambiano forma, scompaiono o arrivano in ritardo. Il ritardo delle etichette nasconde la verità fino a molto dopo che la previsione è andata in produzione. Dovete tenerli d'occhio tutti e quattro, perché ognuno di essi può compromettere l'utilità del modello senza un calo drammatico dei soliti KPI.
Ecco perché i team enterprise finiscono per trattare il rilevamento del model drift come parte della pipeline più ampia, non come un'aggiunta riservata al modello. Una volta impostata così la questione, la soluzione diventa più chiara. Non vi limitate a riaddestrare più in fretta: rilevate prima i cambiamenti a monte, li localizzate prima e li instradate prima al responsabile giusto.
I quattro tipi di drift che dovete davvero distinguere
Data drift, concept drift, label drift e feature drift sono correlati, ma non richiedono la stessa risposta. In produzione, confonderli fa perdere tempo. Un team può passare mezza giornata a riaddestrare un modello che ha bisogno di una correzione dello schema, oppure continuare a mettere a punto le feature quando è cambiata la relazione sottostante.
Partite dal data drift
Il data drift è il più facile da individuare e quello a cui è più facile reagire in modo eccessivo. Significa che la distribuzione degli input è cambiata, mentre il compito di business può essere rimasto lo stesso. Un modello di rischio di credito potrebbe vedere uno spostamento nelle fasce di reddito dei richiedenti dopo il lancio di un nuovo prodotto, oppure un modello di churn potrebbe acquisire più utenti mobile dopo un cambiamento nel mix dei canali. Il modello non è necessariamente già sbagliato, ma il suo mondo è cambiato abbastanza da far sì che i suoi presupposti potrebbero non essere più validi.
Distinguete il concept drift dal drift degli input
Il concept drift è il più difficile. La relazione tra input e target cambia, anche se gli input sembrano ancora familiari. Un modello antifrode può continuare a vedere gli stessi pattern di transazione, ma i criminali cambiano tattica e i vecchi segnali smettono di prevedere le frodi bene come prima. Non è un problema di feature. È un problema della mappatura appresa in sé.
Trattate in modo diverso label drift e feature drift
Il label drift significa che cambia il bilanciamento delle classi. In un flusso di credito, il mix tra casi approvati e rifiutati può spostarsi, e questo da solo può distorcere metriche e soglie. Il feature drift è più circoscritto: riguarda la modifica di un input specifico, come un nuovo valore categoriale, un intervallo numerico che si allarga o un campo mancante che prima non mancava. Il feature drift deriva spesso da problemi nei dati a monte più che dal comportamento del modello, ed è per questo che la risposta è di solito la riparazione della pipeline, non il riaddestramento.
Un controllo utile è porsi due domande. Sono cambiati gli input, o è cambiata la relazione? E il problema sta nel modello, o nel percorso dei dati che lo alimenta?
La distinzione conta perché una rottura dello schema, un picco di valori null o una tabella in ritardo possono sembrare drift in una dashboard anche quando la logica del modello è corretta. Per un percorso di implementazione concreto, la guida di digna al rilevamento del data drift è utile perché incentra i segnali operativi sul livello dei dati, invece di dare per scontato che saranno le etichette a salvarvi.
Scegliere la metrica giusta per ogni segnale
La metrica migliore dipende da cosa state osservando e da quanto velocemente dovete agire. Negli ambienti regolamentati, i team di solito vogliono una statistica trasparente legata a una baseline. Negli ambienti più dinamici, hanno spesso bisogno di una metrica che possa girare in modo continuo su più segmenti senza diventare rumorosa.
La base più antica e ancora oggi più pratica è il test d'ipotesi formale. Il Kolmogorov–Smirnov (KS) funziona bene per le variabili continue perché confronta la forma delle distribuzioni live e di riferimento senza presupporre la normalità. Il chi-quadro è la scelta naturale per gli input categoriali, quando vi interessa sapere se il mix di categorie è cambiato abbastanza da contare. Il Population Stability Index (PSI) è ampiamente usato come controllo di stabilità basato su soglie, e un PSI superiore a 0,25 viene comunemente considerato un forte segnale di allarme Statsig sui metodi di rilevamento del drift e sul PSI.
Per distribuzioni più complesse, la divergenza di Jensen-Shannon è un'opzione sensata, soprattutto per output categoriali, embedding o monitoraggio dello spazio delle previsioni. È utile quando vi interessa quanto differiscono due distribuzioni di probabilità, non solo se una singola feature ha superato una soglia. La chiave è non scegliere una sola metrica e fingere che copra ogni segnale.
Una singola metrica raramente copre tutte le modalità di guasto. Lo stack giusto usa una statistica per la feature, un'altra per l'output e una terza per il segmento a cui il business tiene di più.
Riferimento rapido alle metriche di drift | Ideale per | Soglia di alert comune |
|---|---|---|
Population Stability Index | Feature continue in ambito regolamentato, controlli di stabilità rispetto alla baseline | 0,25 per un forte segnale di allarme |
Test di Kolmogorov–Smirnov | Distribuzioni continue, confronto non parametrico | Usate una soglia di p-value allineata alla vostra policy |
Test del chi-quadro | Input categoriali, cambiamenti nel mix di categorie | Usate una soglia di p-value allineata alla vostra policy |
Divergenza di Jensen-Shannon | Embedding, distribuzioni delle previsioni, segnali ad alta dimensionalità | Usate una soglia di policy basata sul comportamento di riferimento |
L'impostazione predefinita pratica è eseguire più statistiche in parallelo su finestre sia brevi sia lunghe. Le finestre brevi intercettano rapidamente gli incidenti. Le finestre lunghe intercettano il degrado lento che non fa scattare un controllo giornaliero. Se state decidendo da dove partire, la guida su come descrivere la distribuzione dei dati è un buon punto di riferimento per capire quale forma di distribuzione state confrontando.
Costruire la pipeline di rilevamento end-to-end
Una pipeline di rilevamento del drift in produzione ha cinque compiti, e ognuno risponde a una domanda diversa. Primo, raccogliere i segnali giusti. Poi calcolare i profili. Poi confrontare il comportamento live con un riferimento. Poi allertare il team giusto. Infine, imporre una risposta, che si tratti di indagine, ricalibrazione, riaddestramento o correzione della pipeline.
Raccogliete i segnali che rendono visibile il drift
L'insieme minimo di dati da raccogliere è chiaro, ma i team ne perdono comunque dei pezzi. Vi servono input del modello, output, confidenza delle previsioni, timestamp e etichette di ground truth quando finalmente arrivano. Se monitorate un flusso basato su LLM, raccogliete anche prompt, risposte, numero di token, latenza e attivazioni dei guardrail. Questi segnali aggiuntivi contano perché i guasti silenziosi nei sistemi generativi si manifestano spesso nel comportamento, non in un singolo valore di accuratezza.
Calcolate i profili vicino ai dati
Il livello dei profili dovrebbe confrontare il comportamento in produzione con un profilo di riferimento, non solo con uno snapshot isolato. In pratica, significa conservare statistiche di baseline e calcolare le metriche live sulle stesse famiglie di tabelle nel tempo. Questo calcolo deve avvenire vicino ai dati, idealmente nel warehouse o nel lake, perché spostare grandi dataset in un archivio di analytics separato crea ritardi, overhead di copia e più punti in cui il percorso di monitoraggio può fallire.
Eseguite il rilevamento del drift per segmenti, non solo a livello globale
Le medie globali nascondono i guasti localizzati. Un modello può sembrare stabile nel complesso mentre un'area geografica, una linea di prodotto o un canale si stanno degradando. Ecco perché il monitoraggio in produzione ha bisogno di segmentazione. Le finestre brevi aiutano con gli incidenti, quelle lunghe con il degrado lento, ed entrambe dovrebbero essere suddivise per i segmenti che contano per il business.
Alert orientati all'azione, non al rumore
L'alerting dovrebbe essere legato a un percorso di risposta. Un debole spostamento di una feature può stare in una dashboard. Una rottura improvvisa della distribuzione può meritare una chiamata. Un errore di validazione potrebbe dover andare al responsabile di data engineering, non al team ML. La risposta funziona solo quando il segnale arriva alla persona in grado di risolvere il problema sottostante.
Per i team che costruiscono tutto questo in un contesto di piattaforma, uno strumento come digna si inserisce in modo naturale quando l'obiettivo è calcolare le baseline all'interno del warehouse e abbinarle a controlli di anomalie, tempestività, schema e validazione. In questo modo i dati restano residenti dove già si trovano e gli operatori hanno un unico posto in cui esaminare trend, freschezza e modifiche strutturali.
Perché le metriche di performance intercettano il drift troppo tardi
I team amano i grafici di accuratezza perché sono familiari. Il problema è che accuratezza, precision, recall, F1, MAE, RMSE e AUC-ROC sono di solito segnali a valle, non allarmi precoci. Se le etichette arrivano in ritardo o in modo sporadico, la metrica vi dice che il modello non funziona solo dopo che l'impatto sul business è già iniziato.
Questo ritardo è il problema operativo centrale. Un modello può continuare a servire previsioni mentre la ground truth manca ancora. Quando un calo significativo delle performance diventa visibile, il modello potrebbe aver sbagliato abbastanza a lungo da influire su approvazioni, frodi intercettate, raccomandazioni o instradamento dei servizi.
Verità operativa: le metriche di performance sono strumenti di conferma, non sempre strumenti di rilevamento.
Ecco perché i segnali proxy contano. Gli spostamenti nella distribuzione degli input possono mostrarvi che la popolazione in ingresso è cambiata. Gli spostamenti nella distribuzione delle previsioni possono mostrarvi che la confidenza del modello si è mossa ancora prima che arrivino le etichette. I deployment in shadow mode possono mettere in luce i comportamenti fianco a fianco. La calibrazione della confidenza può mostrare che il modello sembra ancora sicuro mentre diventa meno affidabile. Questi proxy non provano che il modello abbia fallito, ma sono spesso la prima evidenza che qualcosa è cambiato.
Il modo più utile per spiegarlo internamente è trattare i segnali di drift come piste da seguire, non prove di un guasto. Questa impostazione evita che il team reagisca in modo eccessivo a ogni oscillazione, pur dandogli il permesso di indagare prima che l'arretrato diventi un incidente di business. Nei flussi ad alto rischio, soprattutto dove le etichette sono in ritardo o incomplete, è l'unico approccio che funziona in modo affidabile.
Baseline, soglie e instradamento degli alert che funzionano davvero
Un programma di gestione del drift conquista fiducia quando le sue baseline corrispondono alla realtà. Una baseline congelata al periodo di training va bene per il lancio, ma spesso invecchia male nei sistemi live. Una baseline di produzione mobile è migliore per i flussi che evolvono naturalmente. Le baseline in shadow mode possono aiutare quando un modello viene valutato accanto a quello in carica, perché riflettono il traffico attuale senza contaminare il percorso decisionale principale.
L'errore che molti team commettono è presumere che un'unica soglia statica possa coprire tutto. Non può. I cambiamenti improvvisi meritano un'escalation più rapida di un lento scivolamento. Una feature che cambia forma gradualmente può giustificare un avviso e una coda di indagine, mentre un salto improvviso del KS su un campo sensibile può richiedere un triage immediato. La soglia dovrebbe riflettere sia la metrica sia il contesto operativo.
Un modello di instradamento a livelli funziona meglio di una casella condivisa. Instradate i problemi di schema al responsabile di data engineering. Instradate gli spostamenti di confidenza o di output alla piattaforma ML o al team di modellazione. Instradate freschezza e caricamenti mancanti al responsabile della pipeline. Questa suddivisione conta perché chi interviene per primo non dovrebbe dover indovinare dove è avvenuta la rottura.
Se l'alert non indica un responsabile, non è un alert. È solo rumore con una formattazione migliore.
Il modo più rapido per ridurre l'alert fatigue è rendere l'alert abbastanza informativo da accorciare la prima indagine. Includete il segmento interessato, la finestra di confronto, la metrica che si è mossa e la baseline di riferimento. Poi lasciate che sia chi risponde a decidere se la soluzione è il riaddestramento, la ricalibrazione, la riparazione di una feature o il passaggio al data engineering.
Root cause analysis e il ruolo dell'observability
Un buon alert di drift dovrebbe portare a una correzione, non a un dibattito. Considerate una feature di pagamento che all'improvviso fa scattare un picco del KS. Il team del modello potrebbe sospettare prima di tutto un concept drift, ma la causa reale può essere una modifica dello schema a monte, come un campo a cui è stato cambiato il tipo o una colonna nullable che inizia improvvisamente ad arrivare con valori inattesi. In questo caso la correzione giusta è la riparazione della pipeline, non il riaddestramento.
Un altro caso sembra più sfumato. Un trend del PSI sale lentamente dopo il lancio di un prodotto, e il team osserva un comportamento peggiore del modello su una parte del traffico. Spesso questo indica uno spostamento nel mix di clienti, non un modello rotto. Il modello può essere ancora valido, ma la sua popolazione di riferimento non è più rappresentativa. È qui che il contesto storico conta, perché un trend senza storico è solo un punto nel tempo.
Il terzo pattern è il drift di calibrazione. Il modello restituisce ancora punteggi, ma le etichette arrivate in ritardo mostrano alla fine che la confidenza non segue più la realtà come prima. È un promemoria del fatto che il monitoraggio deve gestire con eleganza le etichette tardive. I segnali proxy vi danno un preavviso, mentre le etichette che arrivano in seguito confermano se il timore era fondato.
Una piattaforma di data observability dovrebbe rendere questa indagine più rapida offrendo schema tracking per colonne aggiunte o rimosse, monitoraggio della tempestività per arrivi mancanti o in ritardo, anomaly detection per spostamenti inattesi e viste storiche dei trend per il contesto. È qui che digna si inserisce nella pratica, perché calcola le baseline ed esegue controlli di anomalie, tempestività, schema e validazione all'interno del database del cliente. Il vantaggio non è solo la privacy, ma anche un percorso di triage più pulito, dato che gli ingegneri possono esaminare il segnale senza spostare dati sensibili in un altro sistema.
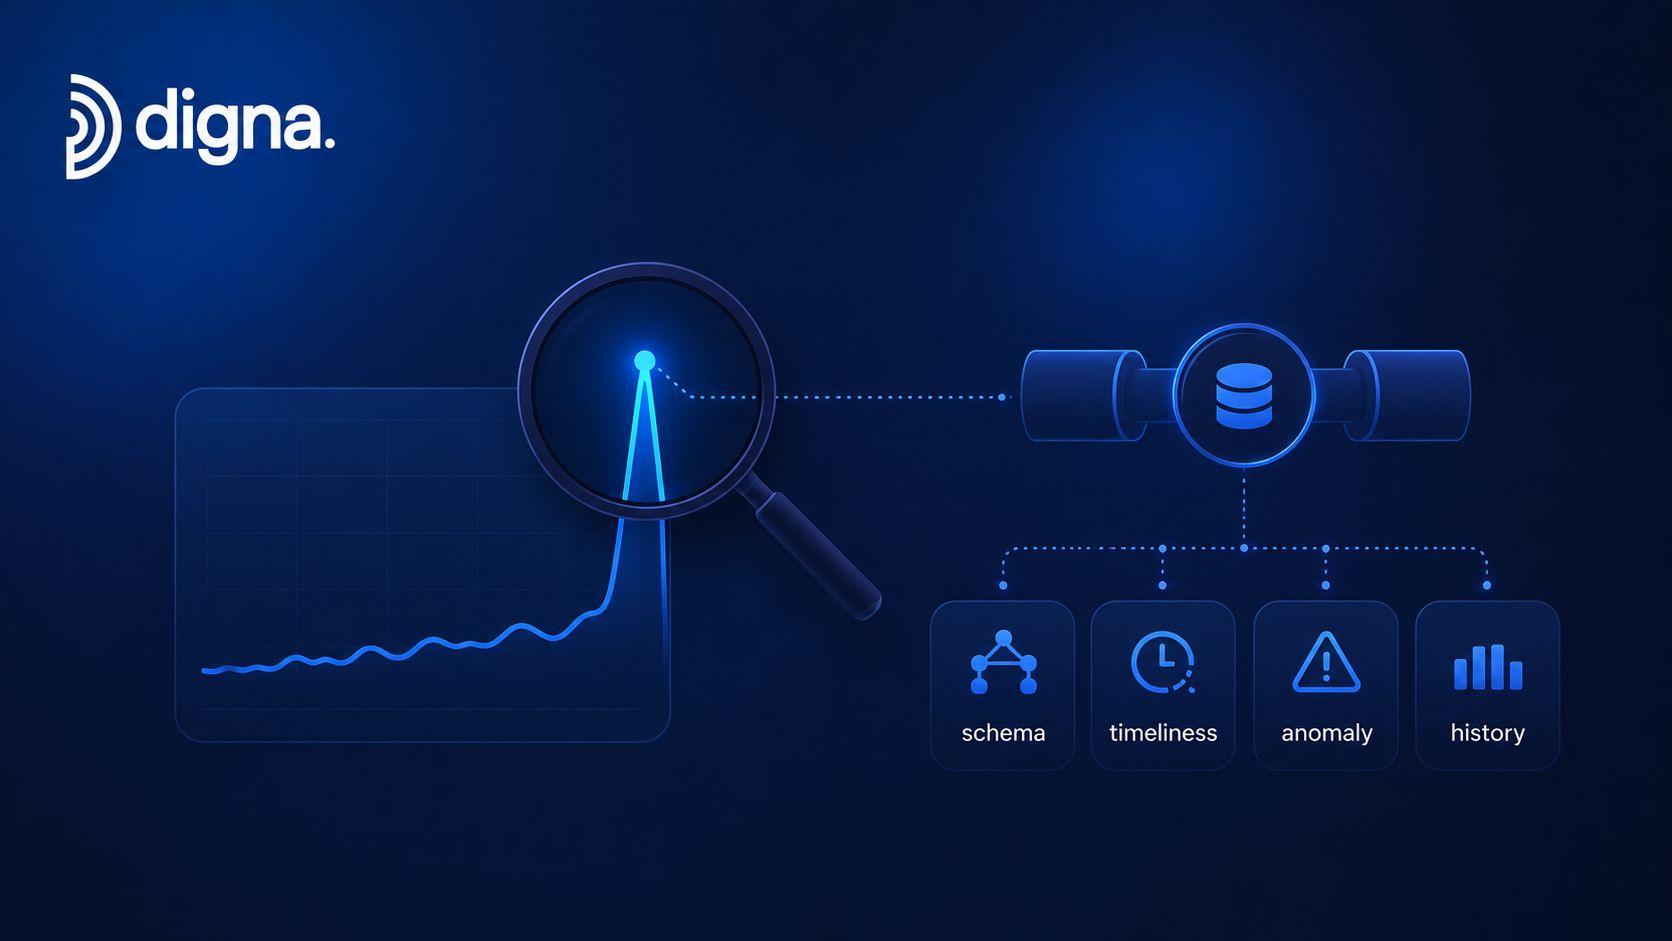
Se il vostro team aspetta ancora le etichette prima di indagare sul drift, il ciclo di monitoraggio è già troppo lento. Visitate digna per vedere come baseline native del warehouse, controlli delle anomalie, monitoraggio della tempestività, schema tracking e validazione possono dare ai vostri sistemi di ML un segnale di drift più pulito e un percorso più rapido dall'alert alla causa principale.
Per baseline native del warehouse che fanno emergere gli spostamenti nelle distribuzioni di input e output prima che arrivino le etichette, scoprite come digna Data Anomalies apprende il comportamento normale e segnala i cambiamenti inattesi.
Domande frequenti
Quali sono i principali tipi di model drift?
Ce ne sono quattro da distinguere: data drift, concept drift, label drift e feature drift. Il data drift è uno spostamento nella distribuzione degli input, il concept drift cambia la relazione tra input e target, il label drift cambia il bilanciamento delle classi e il feature drift riguarda un input specifico, spesso a causa di problemi nella pipeline a monte.
Qual è la differenza tra data drift e concept drift?
Il data drift significa che la distribuzione degli input è cambiata mentre il compito di business resta lo stesso, come nuove fasce di reddito dei richiedenti dopo il lancio di un prodotto. Il concept drift significa che è cambiata la relazione tra input e target, come quando i truffatori cambiano tattica e pattern di transazione familiari smettono di prevedere le frodi bene come prima.
Quale test statistico conviene usare per rilevare il drift?
Dipende dal segnale. Il Kolmogorov-Smirnov è adatto alle variabili continue, il chi-quadro agli input categoriali e il Population Stability Index funziona come controllo basato su soglie, con un PSI superiore a 0,25 comunemente considerato un forte segnale di allarme. La divergenza di Jensen-Shannon gestisce embedding e distribuzioni delle previsioni. Eseguite più metriche su finestre brevi e lunghe.
Perché le metriche di accuratezza intercettano il model drift troppo tardi?
Accuratezza, precision, recall, F1, AUC-ROC e metriche simili dipendono dalle etichette di ground truth, che spesso arrivano in ritardo o in modo sporadico. Quando le performance calano visibilmente, il modello potrebbe aver già danneggiato approvazioni o frodi intercettate. Segnali proxy come gli spostamenti degli input, gli spostamenti nella distribuzione delle previsioni e la calibrazione della confidenza offrono un preavviso maggiore.
Come dovrebbero essere instradati gli alert di model drift?
Instradate ogni alert al responsabile in grado di correggerne la causa, invece che a una casella condivisa. I problemi di schema vanno al data engineering, gli spostamenti di confidenza o di output al team ML, e freschezza o caricamenti mancanti al responsabile della pipeline. Includete il segmento interessato, la finestra di confronto, la metrica che si è mossa e la baseline di riferimento.


