Data quality vs data integrity: la guida definitiva 2026
|
6
min di lettura

Ieri la vostra dashboard dei ricavi sembrava normale. Stamattina mostra un calo netto, il team commerciale sta facendo escalation e nessuno è d'accordo su cosa si sia rotto. Un engineer controlla i log della pipeline e dice che tutti i job sono andati a buon fine. Un analista indica record mancanti nella sorgente. Un responsabile di piattaforma sospetta una modifica di schema che non ha fatto fallire nulla, ma ha spostato il significato di un campo chiave.
È proprio in questa confusione che molte organizzazioni si bloccano sul confronto tra data quality e data integrity. Trattano i due termini come intercambiabili, poi assegnano il problema al team sbagliato, usano i controlli sbagliati e ripetono lo stesso errore un mese dopo. La differenza non è accademica. Determina se dovete correggere un vincolo del database, un processo della sorgente, una regola di freschezza, un contratto semantico o una lacuna nel monitoraggio del ML.
Cambia anche il modo in cui costruite la fiducia. I team che tengono a guidare le decisioni con i dati di solito investono prima nelle dashboard. La parte più difficile è mantenere affidabili i numeri quando le pipeline continuano a girare ma il significato dei dati subisce drift. Ecco perché il rilevamento precoce è importante, soprattutto per i problemi silenziosi come arrivi in ritardo, variazioni insolite di volume e comportamenti inattesi dei campi: è esattamente ciò che il rilevamento delle anomalie nelle pipeline moderne deve far emergere prima che finanza o operations vedano il danno.
Indice
La dashboard è sbagliata, ma perché?
Una dashboard sbagliata di solito dà inizio a una discussione sbagliata.
Il commerciale vede un calo e presume che il business sia cambiato da un giorno all'altro. L'analytics controlla il modello e scopre che l'SQL gira ancora. L'engineering verifica l'orchestrazione e conferma che la pipeline è stata completata. Poi la riunione si divide in due fazioni. Una sostiene che i dati siano stati danneggiati durante lo spostamento. L'altra sostiene che i dati siano arrivati intatti ma incompleti, obsoleti o sbagliati rispetto al contesto.
Si tratta di classi di guasto diverse.
Se un'operazione di scrittura, un trasferimento o una relazione di schema ha danneggiato il dataset, siete di fronte a un problema di integrità. Se i record sono strutturalmente validi ma mancano campi di business, sono in ritardo, obsoleti o semanticamente inadatti al caso d'uso, siete di fronte a un problema di qualità. Nella pratica, i team perdono spesso ore perché partono dai log degli strumenti, quando avrebbero dovuto partire da una domanda più basilare: il sistema ha preservato correttamente i dati, oppure ha preservato perfettamente i dati sbagliati?
Regola pratica: se il data warehouse ha accettato i record e i join funzionano ancora, non date per scontato che il dataset sia utilizzabile.
Un esempio familiare è una dashboard dei ricavi che crolla all'improvviso dopo che un sistema sorgente ha cambiato il modo in cui vengono popolati gli sconti. La tabella arriva comunque. I tipi di colonna corrispondono ancora. I legami referenziali reggono. Nulla nella pipeline segnala un guasto. Ma i ricavi netti ora sono sottostimati, perché la regola di business dietro un campo è cambiata a monte. Questa è bassa qualità, non integrità compromessa.
Il caso opposto è altrettanto comune. Una migrazione introduce scritture parziali o corruzioni silenziose durante il trasferimento. La dashboard è sbagliata perché parti del dataset non sono più nello stato originale, anche se le definizioni di business non sono cambiate. Questa è integrità.
Come suona di solito il dibattito
L'engineering dice: “Il job è andato a buon fine, quindi la pipeline è a posto.”
L'analytics dice: “I numeri non si riconciliano con la sorgente.”
Il business dice: “Non possiamo fidarci della dashboard.”
Possono avere ragione tutti e tre contemporaneamente. Il job può riuscire, la dashboard può essere sbagliata e la causa principale può comunque trovarsi al di fuori del livello di orchestrazione.
Definire i concetti fondamentali
Il modo più pulito di pensare a questa distinzione è semplice. La data quality chiede se i dati sono adatti all'uso. La data integrity chiede se i dati sono rimasti integri, strutturalmente corretti e inalterati attraverso storage, trasferimento ed elaborazione.
Un'analogia con la biblioteca aiuta. La qualità indica se il libro è utile per il lettore: è aggiornato, completo, ed è l'edizione giusta per la domanda che ci si pone? L'integrità indica se tutte le pagine sono presenti, in ordine e invariate rispetto alla copia originale. Potete avere l'una senza l'altra. Un libro può essere perfettamente conservato ed essere comunque superato. Può anche avere contenuti aggiornati ma essere danneggiato in un modo che rende inaffidabili alcune sue parti.

Per i team che lavorano a stretto contatto con ricavi, inventario o prezzi, questa distinzione diventa importante in fretta. Un'utile spiegazione della data quality per i team di pricing mostra perché “abbastanza corretto per agire” dipende dal contesto, non solo dalla validità tecnica. E quando la preoccupazione riguarda la fiducia strutturale sulle piattaforme moderne, i controlli per proteggere l'integrità dei dati tra i sistemi si collocano su un livello diverso rispetto alle regole di qualità rivolte al business.
Un modo semplice per distinguerli
La data quality è rivolta al business. Copre dimensioni come accuratezza, completezza, coerenza e puntualità. Un inquadramento pratico dei benchmark prevede che la qualità possa essere valutata attraverso dimensioni come un'accuratezza ≥99% per i dati di livello gold e una puntualità come l'arrivo entro una finestra di ritardo <5 minuti, mentre la data integrity si concentra sulla preservazione dello stato originale attraverso misure come un'accuratezza dei record di modifica ≥99,9% e la latenza di rilevamento delle manomissioni, come descritto nell'analisi delle dimensioni della data quality di OvalEdge.
La data integrity è rivolta ai sistemi. Viene garantita tramite vincoli, garanzie transazionali, controlli di accesso, auditabilità e verifiche che i dati non siano stati alterati, eliminati o corrotti senza autorizzazione.
Dove i team confondono di solito il confine
La confusione nasce di solito da un unico presupposto sbagliato. I team pensano che, se i dati sono fedeli alla sorgente, debbano essere anche utili al business. Non è vero.
Una tabella clienti può preservare ogni riga esattamente come ricevuta ed essere comunque di bassa qualità, perché metà dei record sono superati per la campagna in corso oggi. Un feature store può preservare esattamente gli input di training ed essere comunque di bassa qualità per un modello, perché la distribuzione è cambiata in un modo che nessuno ha monitorato.
Dati preservati non significa automaticamente dati affidabili. La fiducia richiede sia solidità strutturale sia idoneità all'uso.
Un confronto dettagliato tra data quality e data integrity
Il modo più semplice per rendere operativa la distinzione è confrontarle in base al modo in cui lavorano i team: cosa protegge ciascuna, chi ne è responsabile e come si manifestano i guasti.
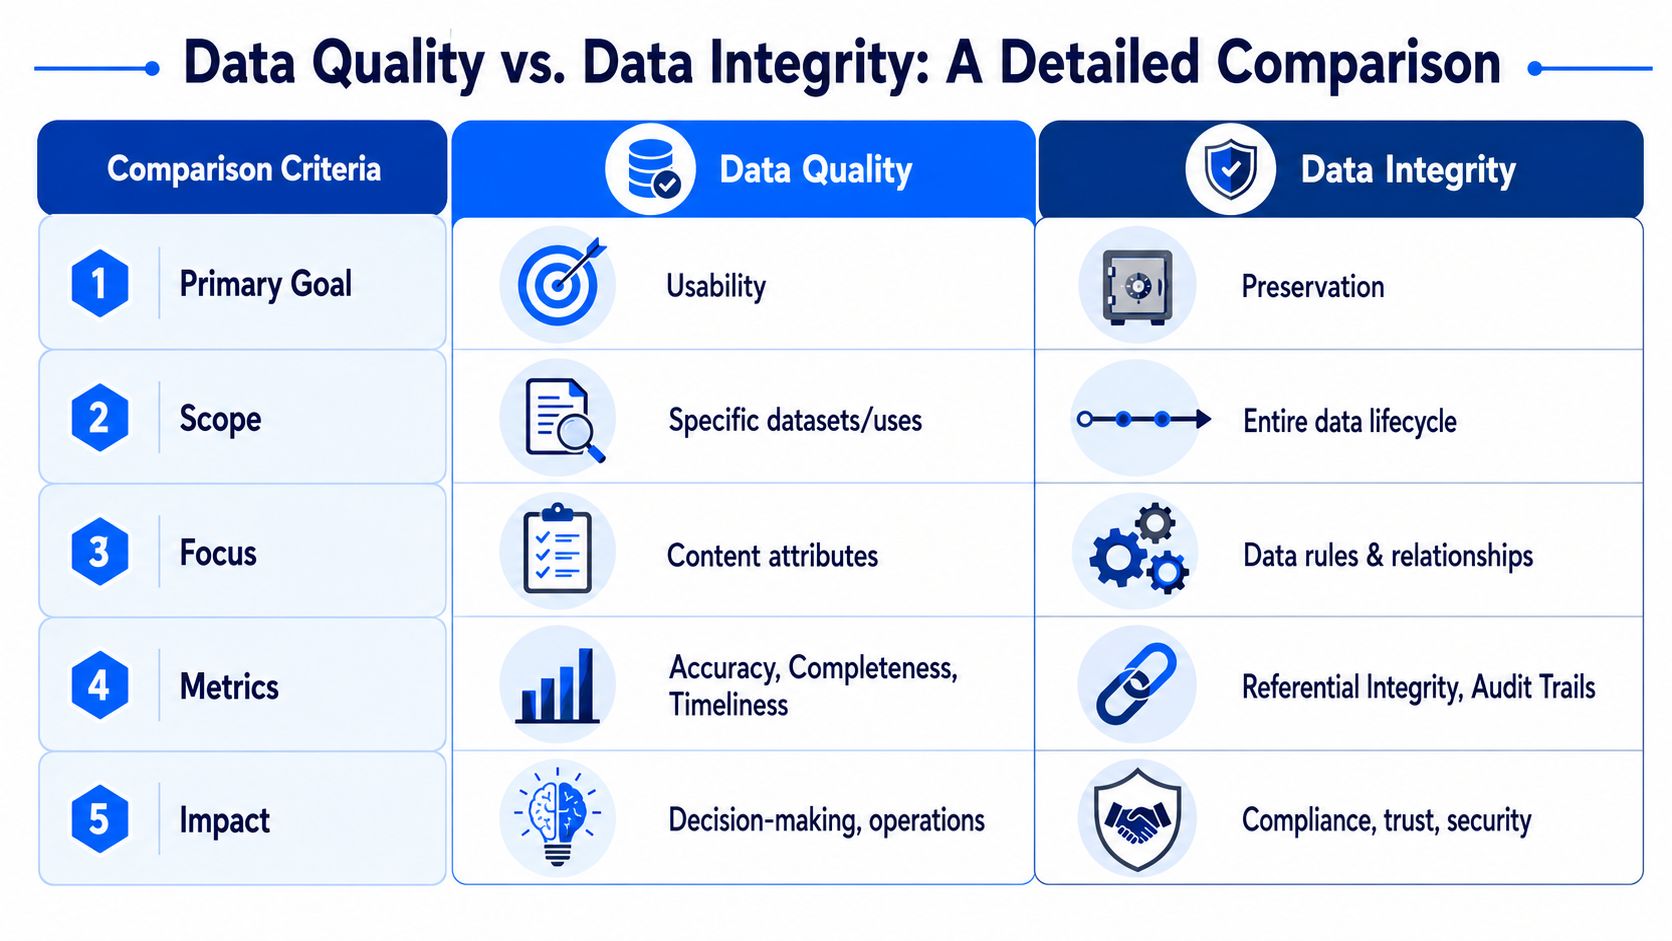
Tabella di confronto
Criterio | Data quality | Data integrity |
|---|---|---|
Obiettivo principale | Rendere i dati utilizzabili per una decisione, un workflow o un modello | Preservare lo stato originale dei dati e la fiducia strutturale |
Ambito | Dipende dal caso d'uso e dalla definizione di business | Si applica a storage, trasferimento ed elaborazione |
Responsabile tipico | Analisti, analytics engineer, data steward, team di dominio | Data engineer, platform engineer, DBA, team di sicurezza |
Controlli tipici | Accuratezza, completezza, puntualità, coerenza, validità | Vincoli, audit trail, riconciliazione, checksum, controllo degli accessi |
Segnale di guasto | I report sono fuorvianti, i modelli peggiorano, le operations agiscono su input obsoleti | I record sono corrotti, alterati, persi o strutturalmente incoerenti |
Questa suddivisione delle responsabilità è importante perché i team spesso inviano i problemi di qualità solo ai team di piattaforma, o i problemi di integrità solo ai data steward di business. Nessuno dei due approcci funziona. I problemi di qualità richiedono definizioni di dominio. I problemi di integrità richiedono controlli tecnici rigorosi.
La trappola dell'alta integrità e della bassa qualità
Il caso più frainteso è quello che danneggia maggiormente i programmi di AI e analytics. I dati sono intatti, sicuri e strutturalmente validi. Nulla è stato corrotto. Non è avvenuta alcuna modifica non autorizzata. Eppure il modello funziona male, perché il significato dei dati è cambiato in un modo che il sistema non ha mai considerato un guasto.
È la trappola dell'alta integrità e bassa qualità.
Un esempio comune è uno schema drift o un drift semantico che non viola le regole di integrità. Un campo resta presente, i valori rispettano ancora il tipo e la tabella arriva puntuale. Ma la distribuzione cambia, una mappatura delle categorie si sposta o un'applicazione sorgente inizia a popolare un campo in modo diverso. I controlli di integrità tradizionali restano verdi. Il modello continua a consumare i dati. Il business continua a ricevere output. Sono solo meno affidabili.
Secondo l'analisi di Atlan su data integrity e data quality, oltre il 60% dei fallimenti dei modelli di AI deriva da problemi di data quality invisibili ai controlli di integrità tradizionali, comprese le modifiche di schema che alterano la distribuzione statistica senza violare le regole di integrità. È esattamente la lacuna in cui i dati sono “fedeli alla sorgente” ma “falsi per il modello”.
Se i vostri controlli rispondono solo a “I dati sono stati preservati?”, non intercetteranno “I dati significano ancora la stessa cosa?”
Ecco perché data quality e data integrity non possono essere gestite come due definizioni isolate in un glossario. Vanno trattate come due livelli di un unico modello di fiducia. L'integrità è la base minima. La qualità decide se vale ancora la pena usare il dataset.
Modalità di guasto reali e impatto sul business
I team non hanno bisogno di un'altra definizione astratta. Hanno bisogno di riconoscere lo schema mentre si sta verificando.
Quando la qualità fallisce ma i sistemi sembrano in salute
Un team di marketing regionale preleva le località dei clienti dal data warehouse per allocare il budget delle campagne. Le tabelle si caricano nei tempi previsti. Le chiavi primarie sono a posto. I join funzionano. L'orchestrazione non genera alcun alert.
Il problema emerge più tardi. Una quota consistente dei campi di località è incompleta o incoerente, perché a monte gli standard di acquisizione non sono stati applicati. La dashboard viene comunque visualizzata. La logica di segmentazione continua a girare. Il budget finisce nelle aree geografiche sbagliate e rende meno del previsto, perché i dati erano utilizzabili solo in senso tecnico, non in senso di business.
Questo schema è costoso. Secondo la sintesi di IBM della ricerca di Mitre Corporation, i problemi di data quality costano alle organizzazioni statunitensi in media 12,9 milioni di dollari all'anno, il 68% degli errori deriva da dati incompleti o incoerenti e il 30% delle decisioni di business si basa su informazioni errate negli ambienti interessati, come indicato nella discussione di IBM su data integrity e data quality.
Quando l'integrità si rompe sotto il sistema
Un guasto diverso nasce più in basso nello stack. Durante una migrazione, una pipeline di record finanziari subisce problemi di scrittura mentre sposta i dati tra i sistemi. Alcuni record vengono alterati o persi durante il trasferimento. Le tabelle a valle si popolano comunque abbastanza da mantenere vivi i report, ma la riconciliazione inizia a fallire. Gli audit trail non corrispondono più alle transazioni della sorgente. Ora la finanza ha un problema di fiducia strutturale.
Questo tipo di problema richiede di solito controlli di engineering, non una pulizia lato business. Non lo risolvete ridefinendo un KPI. Lo risolvete validando gli spostamenti, imponendo le relazioni, riconciliando le copie e intercettando rapidamente le modifiche non autorizzate o involontarie.
Un modo utile per distinguere l'impatto è questo:
I problemi di qualità distorcono le decisioni. I team lanciano la campagna sbagliata, si fidano del KPI sbagliato o forniscono feature obsolete a un modello.
I problemi di integrità distorcono il dato stesso. I team perdono la certezza che il dataset rappresenti ancora ciò che era stato originariamente archiviato o trasferito.
I problemi combinati sono lo scenario peggiore. Un dataset strutturalmente danneggiato può anche essere obsoleto, incompleto o semanticamente sbagliato.
Dashboard pulite possono comunque nascondere input di business sbagliati. Pipeline stabili possono comunque nascondere record danneggiati.
La conseguenza pratica riguarda la responsabilità. I problemi di qualità emergono di solito per primi nell'analytics, nelle operations o nel comportamento del ML. I problemi di integrità emergono di solito per primi nella riconciliazione, negli audit, nelle migrazioni o nelle discrepanze tra sistemi. Se il vostro processo di gestione degli incidenti non distingue questi percorsi, i tempi di risposta si allungano e l'analisi della root cause va alla deriva.
Come misurare e monitorare entrambe
Una volta che i team hanno compreso la distinzione, l'errore successivo è usare un unico pattern di monitoraggio per entrambe. Non funziona. Qualità e integrità richiedono segnali diversi, soglie diverse e percorsi di escalation diversi.
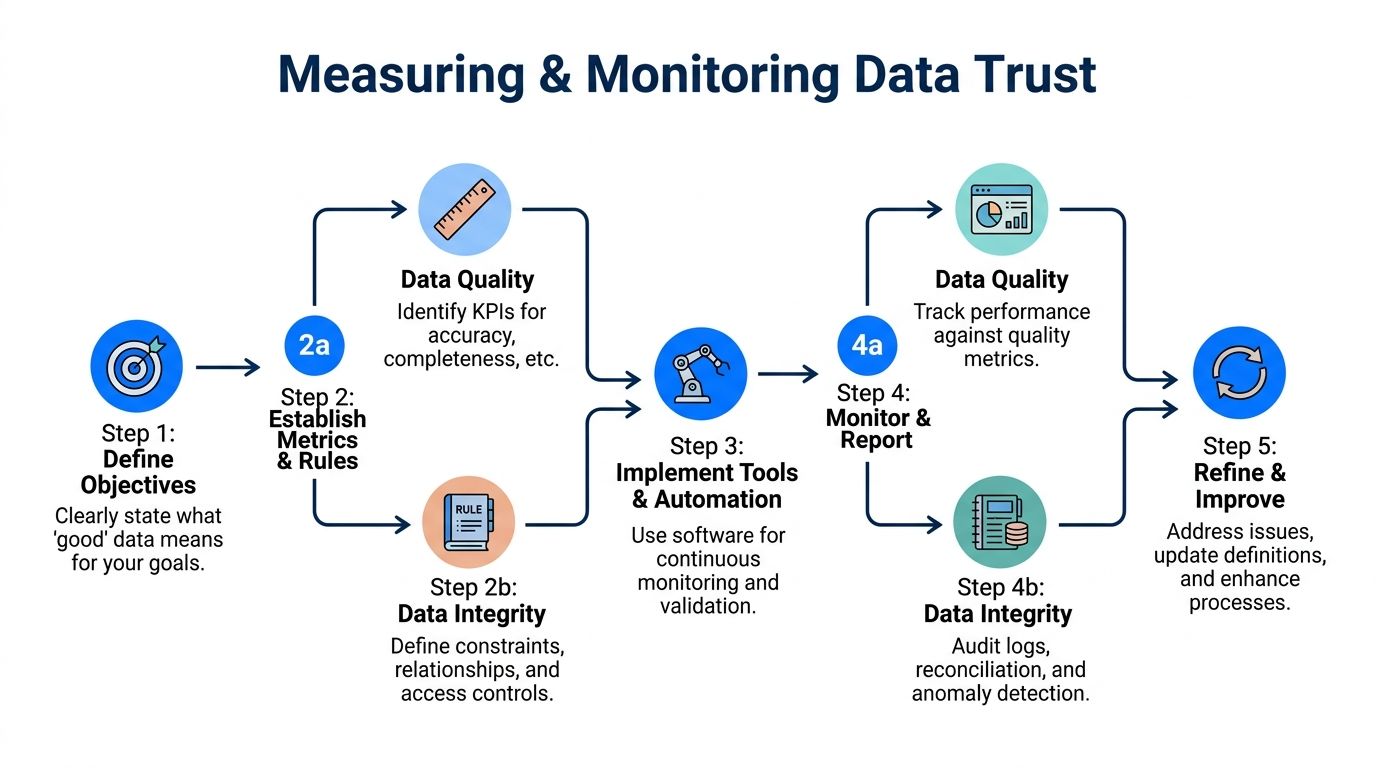
Cosa monitorare per la qualità
Il monitoraggio della qualità parte dal caso d'uso di business. Una tabella finanziaria di livello gold richiede aspettative più rigorose di un dataset esplorativo. Un feature store per un modello in produzione richiede controlli su distribuzione e freschezza che un archivio di back office potrebbe non richiedere.
Un buon monitoraggio della qualità combina di solito più livelli:
Profilate prima i dati. Stabilite intervalli normali, pattern comuni dei valori null, conteggi distinti e distribuzioni dei campi prima di scrivere regole rigide.
Monitorate il drift in modo continuo. Cercate variazioni di volume, frequenza delle categorie, tassi di null, freschezza e forma della distribuzione.
Validate i record rispetto alla logica di business. Controllate regole come combinazioni di stato valide, campi obbligatori o combinazioni di valori impossibili.
Tracciate esplicitamente la puntualità. Un record corretto che arriva troppo tardi resta di bassa qualità per molti workflow.
I team che vogliono un approccio pratico basato su scorecard di solito partono da un piccolo insieme di metriche di data quality collegate al rischio di business, per poi rafforzare i controlli sui dataset che alimentano reporting, operations e ML.
Cosa imporre per l'integrità
I controlli di integrità vanno collocati più vicino allo storage e agli spostamenti. Rispondono alla domanda se i dati siano rimasti strutturalmente corretti e inalterati lungo tutto il loro ciclo di vita.
Di solito questo significa:
Vincoli del database come chiavi primarie, chiavi esterne, unicità e controlli referenziali.
Protezioni transazionali per i sistemi in cui scritture parziali o conflitti di concorrenza possono creare incoerenze strutturali.
Checksum e riconciliazione durante il trasferimento, così i team possono verificare che ciò che è uscito da un sistema sia ciò che è arrivato in un altro.
Audit trail e controllo degli accessi per rilevare modifiche non autorizzate o inspiegabili.
Rilevamento delle modifiche di schema, affinché le modifiche strutturali non passino inosservate nei sistemi a valle.
Nelle pipeline complesse non è facoltativo. Secondo l'analisi di Dataversity su data integrity e data quality, l'integrità dei dati è compromessa nel 60% delle pipeline di dati enterprise e il 67% di questi problemi resta non rilevato finché non incide sull'analytics a valle, ed è proprio per questo che il monitoraggio automatizzato è importante.
Cosa funziona e cosa no
Ciò che funziona è abbinare l'osservabilità all'applicazione dei controlli. La qualità richiede rilevamento delle anomalie, profilazione e validazione basata su regole. L'integrità richiede vincoli, auditabilità, riconciliazione e controlli sugli schemi.
Ciò che non funziona è affidarsi ai job riusciti come prova di affidabilità. Un orchestratore può dirvi che un task è stato completato. Non può dirvi se i dati sono rimasti significativi o strutturalmente solidi, a meno che non integriate questi controlli nel sistema.
Unificare qualità e integrità con digna
Team separati acquistano spesso soluzioni separate. Uno strumento osserva lo stato delle pipeline. Un altro gestisce le regole di validazione. Un terzo traccia le modifiche di schema. Un quarto supporta le dashboard di governance. Il risultato è di solito una responsabilità frammentata e un sovraccarico di alert.
Perché strumenti separati lasciano punti ciechi
Una modifica di schema può essere visibile in un sistema, mentre il drift di qualità che ne deriva emerge altrove. Un problema di puntualità può essere segnalato dall'orchestrazione, mentre l'impatto sul business compare solo nel reporting. Quando questi segnali vivono in luoghi diversi, i team perdono tempo a ricostruire l'incidente quando la fiducia è già compromessa.
Ecco perché il modello operativo più utile tratta qualità e integrità come un unico livello di affidabilità con tipi di controllo diversi. L'integrità vi dice se i dati sono rimasti strutturalmente affidabili. La qualità vi dice se sono rimasti adatti al workload che li consuma.
Come un unico modello operativo copre entrambe
Una piattaforma come digna può coprire questi due livelli senza confonderli. Schema Tracker si collega all'integrità, segnalando modifiche strutturali come colonne aggiunte o rimosse e cambi dei tipi di dato. Data Validation supporta la qualità applicando regole di business a livello di record. Il monitoraggio della puntualità intercetta gli arrivi in ritardo. Il rilevamento delle anomalie basato su AI aiuta a far emergere variazioni nelle distribuzioni, volumi insoliti e cambiamenti silenziosi di comportamento che non violano le regole di integrità ma riducono comunque la fiducia.
Il dettaglio architetturale che conta qui è l'esecuzione in-database. Secondo la discussione di Lumenalta sui benchmark di data integrity e data quality, le piattaforme dati moderne migliorano l'affidabilità delle decisioni del 40-60% quando combinano controlli di integrità, come il tracciamento degli schemi in tempo reale, con l'osservabilità della qualità, come il rilevamento delle anomalie basato su AI, riducendo lo spostamento dei dati di oltre il 90% grazie al calcolo in-database. Questo modello è importante perché copiare i dati in un numero crescente di strumenti può creare nuovi problemi di fiducia e di governance.
L'obiettivo pratico non è “più monitoraggio”. È un unico luogo in cui i team possono vedere insieme modifiche strutturali, drift di comportamento, ritardi e violazioni delle regole.
È questa visione unificata a colmare il divario tra alta integrità e bassa qualità. La piattaforma non si limita a chiedersi se i dati sono arrivati. Si chiede se il dataset si comporta ancora come si aspettano la vostra dashboard, il vostro modello o il vostro processo decisionale.
Una checklist pratica per i team dati
Usatela come checklist operativa, non come modello di maturità. Se un dataset critico non soddisfa due o tre di questi punti, la fiducia è già più debole di quanto suggerisca la dashboard.
Per l'integrità, imponete presto le relazioni. Collocate i controlli su chiave primaria, unicità e integrità referenziale il più vicino possibile all'ingestion e allo storage.
Per l'integrità, verificate gli spostamenti. Riconciliate i conteggi delle righe e usate la verifica dei trasferimenti, così che corruzioni o perdite silenziose non aspettino un report finanziario per venire alla luce.
Per l'integrità, tracciate le modifiche di schema. Non lasciate che colonne aggiunte, campi rinominati o cambi di tipo scivolino inosservati nei sistemi a valle.
Per la qualità, definite l'idoneità in base al caso d'uso. Una tabella di KPI per il consiglio di amministrazione, un data mart di product analytics e una tabella di feature ML non dovrebbero condividere le stesse aspettative.
Per la qualità, monitorate freschezza e drift. Dati in ritardo, distribuzioni spostate e pattern insoliti di valori null sono tra i modi più rapidi per perdere la fiducia senza che fallisca un job.
Per la qualità, validate le regole di business a livello di record. Il data warehouse può accettare un valore che il business non è in grado di usare.
Per i dataset ricchi di identità, deduplicate in modo consapevole. I dati su clienti ed entità spesso falliscono sul piano della qualità prima che i team se ne accorgano nella BI. Un riferimento pratico è il processo di deduplicazione di SourceLoop, che mostra come l'identity stitching e la gestione dei duplicati influiscano sull'affidabilità a valle.
Per entrambe, assegnate i responsabili. Ogni dataset affidabile ha bisogno di un responsabile di engineering per i controlli strutturali e di un responsabile di business o di dominio per le regole di idoneità.
Per entrambe, fate escalation in base all'impatto. Il percorso di risposta giusto per un audit trail compromesso non è lo stesso di quello per attributi di marketing obsoleti.
I team che gestiscono bene data quality e data integrity non discutono di definizioni durante gli incidenti. Sanno quale livello ha fallito, quali controlli avrebbero dovuto intercettarlo e quale responsabile deve correggerlo.
Se il vostro team ha bisogno di un'unica vista operativa su modifiche di schema, anomalie, puntualità e validazione a livello di record, digna è pensato per questo tipo di workflow di fiducia nei dati, mantenendo l'analisi all'interno del vostro ambiente.
Per applicare le regole di business a livello di record che stabiliscono se dati strutturalmente solidi sono davvero adatti all'uso, vedete come digna Data Validation le applica direttamente all'interno del vostro database.
Domande frequenti
Qual è la differenza tra data quality e data integrity?
La data quality chiede se i dati sono adatti a un uso specifico, e copre accuratezza, completezza, coerenza e puntualità. La data integrity chiede se i dati sono rimasti integri, strutturalmente corretti e inalterati attraverso storage, trasferimento ed elaborazione. Nell'analogia della biblioteca proposta dall'articolo, la qualità è avere l'edizione giusta; l'integrità è avere ogni pagina presente e invariata.
I dati possono avere un'alta integrità ma una bassa qualità?
Sì, e l'articolo la chiama la trappola dell'alta integrità e bassa qualità. I dati possono essere intatti, sicuri e strutturalmente validi mentre una mappatura delle categorie o una distribuzione dei valori cambia silenziosamente. Citando Atlan, l'articolo osserva che oltre il 60 percento dei fallimenti dei modelli di AI deriva da problemi di qualità invisibili ai controlli di integrità tradizionali.
Chi è responsabile della data quality e chi della data integrity?
La responsabilità di solito si divide per livello. La qualità spetta tipicamente ad analisti, analytics engineer, data steward e team di dominio, perché dipende dalle definizioni di business. L'integrità appartiene di solito a data engineer, platform engineer, DBA e team di sicurezza, che applicano vincoli, audit trail, riconciliazione, checksum e controllo degli accessi. Ogni dataset affidabile ha bisogno di entrambi i responsabili.
Come si monitora la data integrity nelle pipeline di dati?
Imponete l'integrità vicino allo storage e agli spostamenti: vincoli di chiave primaria, chiave esterna e unicità, protezioni transazionali contro le scritture parziali, checksum e riconciliazione dei conteggi delle righe durante il trasferimento, audit trail e rilevamento delle modifiche di schema. I dati di Dataversity citati nell'articolo indicano che l'integrità è compromessa nel 60 percento delle pipeline enterprise, con il 67 percento dei problemi non rilevato.
In che modo digna copre sia la data quality sia la data integrity?
digna collega i propri moduli a entrambi i livelli senza confonderli. Schema Tracker supporta l'integrità segnalando colonne aggiunte o rimosse e cambi dei tipi di dato, Data Validation applica regole di business a livello di record, Timeliness intercetta gli arrivi in ritardo e il rilevamento delle anomalie basato su AI fa emergere le variazioni nelle distribuzioni, il tutto eseguito all'interno del database.


