Problemi di qualità dei dati: guida al rilevamento e alla remediation
|
5
min di lettura

La scarsa qualità dei dati costa alle aziende in media 12,9 milioni di dollari all'anno, secondo Gartner (sintesi di Revefi dei dati Gartner). Questo numero cambia i termini della discussione. I problemi di qualità dei dati non sono solo un fastidioso lavoro di pulizia per gli analisti o una voce del backlog del data engineering. Sono un rischio diretto per il business.
Spesso il problema viene notato prima in forme più piccole. Una dashboard smette di aggiornarsi poco prima di una riunione settimanale. Un report finanziario non corrisponde al sistema sorgente. Un modello che funzionava il mese scorso inizia a fare previsioni strane. Qualcuno apre un ticket, qualcun altro esegue query SQL estemporanee e il team passa la giornata a dimostrare se i dati siano sbagliati o se sia cambiata la definizione della metrica. Negli ambienti regolamentati, questo stesso schema aggiunge un ulteriore problema: molti strumenti di observability si aspettano che spostiate i dati sensibili nel cloud del vendor per poterli ispezionare.
Questo compromesso è spesso inaccettabile. Se operate nei settori finanziario, sanitario, delle telecomunicazioni o nel settore pubblico, la domanda pratica non è solo come rilevare i problemi di qualità dei dati. È come rilevarli senza inviare dati di produzione a terzi. È qui che conta un approccio di observability in-database. I dati restano dove sono, le metriche vengono calcolate là dove i dati già risiedono e ottenete comunque rilevamento delle anomalie, schema tracking, monitoraggio della tempestività e validazione a livello di record.
Indice
Perché la qualità dei dati è un rischio silenzioso per il business
La parte costosa dei dati errati di solito non è il primo errore. È il ritardo prima che qualcuno si convinca che l'errore esiste. I team perdono tempo a discutere della dashboard, rieseguire job, confrontare sistemi e verificare se un campo sia cambiato a monte. Nel frattempo, gli utenti di business devono comunque agire.
I dati errati restano silenziosi perché spesso non provocano crash clamorosi. Una pipeline può completarsi producendo un output sottilmente sbagliato. Una tabella può caricarsi in orario mentre valori chiave si allontanano dai pattern normali. Un record cliente può restare strutturalmente valido diventando ogni mese meno utile.
Dove i team lo percepiscono davvero
Nell'operatività quotidiana, i problemi di qualità dei dati si manifestano come:
Dashboard rotte: i dirigenti vedono grafici vuoti o numeri che non tornano.
Report obsoleti: i team di business lavorano sulla realtà di ieri quando avrebbero bisogno di quella di oggi.
Cicli di verifica manuale: gli analisti passano tempo a controllare i dati prima di poter rispondere alla domanda.
Fiducia perduta: quando le persone dubitano del dataset, creano fogli di calcolo paralleli e logiche alternative.
Regola pratica: se gli utenti chiedono se la dashboard sia affidabile prima ancora di chiedere che cosa significhi, avete un problema di qualità dei dati.
Perché è un problema di business, non solo di engineering
Un team di data platform può tamponare i singoli incidenti per un po'. Ma non è un approccio scalabile. Il problema di fondo è che le organizzazioni moderne si affidano ai dati per pianificazione, automazione, compliance e AI. Quando la fiducia cala, cala anche la velocità decisionale.
Per questo tratto i problemi di qualità dei dati come un problema di affidabilità operativa. Incidono contemporaneamente su revenue operations, reporting finanziario, assistenza clienti e prestazioni dei modelli. Il sintomo tecnico può essere un caricamento in ritardo o una modifica di schema. Il sintomo di business sono decisioni più lente e rischi più elevati.
Le otto categorie comuni di problemi di qualità dei dati
La maggior parte degli incidenti rientra in un piccolo insieme di pattern ricorrenti. Dare loro un nome preciso è importante, perché la soluzione per un record duplicato non è quella per una pipeline in ritardo, e la soluzione per lo schema drift non è quella per un input incompleto dei clienti.
Una tassonomia pratica
Ecco il vocabolario che uso con i nuovi membri del team.
Categoria di problema | Impatto sul business | Esempio di soluzione digna |
|---|---|---|
Completezza | I campi mancanti compromettono segmentazione, reporting o workflow a valle | Data Validation |
Accuratezza | I team agiscono su valori che non corrispondono alla realtà | Data Validation |
Tempestività | Gli utenti prendono decisioni su dati obsoleti | Timeliness |
Coerenza | Rappresentazioni contrastanti creano problemi di riconciliazione | Data Validation |
Schema drift | Le modifiche strutturali interrompono query, modelli e dashboard | Schema Tracker |
Duplicati | I conteggi si gonfiano e le viste sui clienti si frammentano | Data Validation |
Outlier | Picchi o cali insoliti nascondono difetti o eventi reali | Data Anomalies |
Guasti della pipeline | I caricamenti riescono solo in parte o falliscono silenziosamente a valle | Data Anomalies e Timeliness |
Come si presenta ciascuna categoria nella pratica
Completezza
Un record è incompleto quando un campo obbligatorio è assente o null in un modo che rende la riga meno utile. Pensate a una tabella clienti con ID validi ma senza stato del consenso o regione.
Accuratezza
I dati sono inaccurati quando non riflettono lo stato reale che si sta cercando di modellare. Un ordine spedito contrassegnato come in sospeso è strutturalmente corretto e tuttavia sbagliato per le operations.
Tempestività
La tempestività riguarda il fatto che i dati siano arrivati quando il business se li aspettava. Una dashboard delle vendite generata da un vecchio output della pipeline può essere internamente coerente e tuttavia non sicura da usare.
Coerenza
I problemi di coerenza emergono quando due sistemi rappresentano in modo diverso la stessa entità di business. Finance e CRM possono entrambi contenere il cliente, ma non con la stessa logica di stato o la stessa formattazione.
Molti incidenti dolorosi si verificano perché un dataset è valido preso da solo ma fuorviante nel suo contesto.
Schema drift
Lo schema drift è la modifica strutturale silenziosa che coglie i team alla sprovvista. Una colonna viene rinominata, rimossa o cambia tipo. Il produttore a monte può considerarlo un aggiornamento innocuo. La trasformazione a valle non è d'accordo.
Duplicati
I duplicati creano rumore operativo nascosto. Le email di marketing partono due volte. L'assistenza clienti vede più record per la stessa persona. I conteggi dei KPI salgono per ragioni che nessuno aveva previsto.
Outlier
Gli outlier non sono sempre errori. A volte sono il primo segnale che una sorgente è cambiata, che un feed ha duplicato delle righe o che si è verificato un evento di business che nessuna regola a soglia aveva previsto.
Guasti della pipeline
I guasti della pipeline non si limitano ai crash veri e propri. La versione più pericolosa è il successo parziale. Un job viene eseguito, alcune tabelle si aggiornano, altre no, e la dashboard viene comunque visualizzata.
Perché la classificazione è importante
Una volta classificato il problema, potete scegliere il controllo giusto:
Regole a livello di record per valori non validi e campi mancanti
Monitoraggio dello schema per le modifiche strutturali
Monitoraggio della freshness per consegne in ritardo o mancanti
Rilevamento statistico delle anomalie per la deriva silenziosa e i comportamenti insoliti
Senza questa distinzione, i team finiscono per accumulare sempre più controlli SQL su ogni tabella. Questo genera rumore e continua a non cogliere i problemi che contano.
Individuare le cause principali dei dati errati
La maggior parte dei problemi ricorrenti di qualità dei dati deriva dalla progettazione dei sistemi e dalle abitudini operative, non da una singola riga errata. Dovete guardare a monte, attraverso i processi e nel tempo.
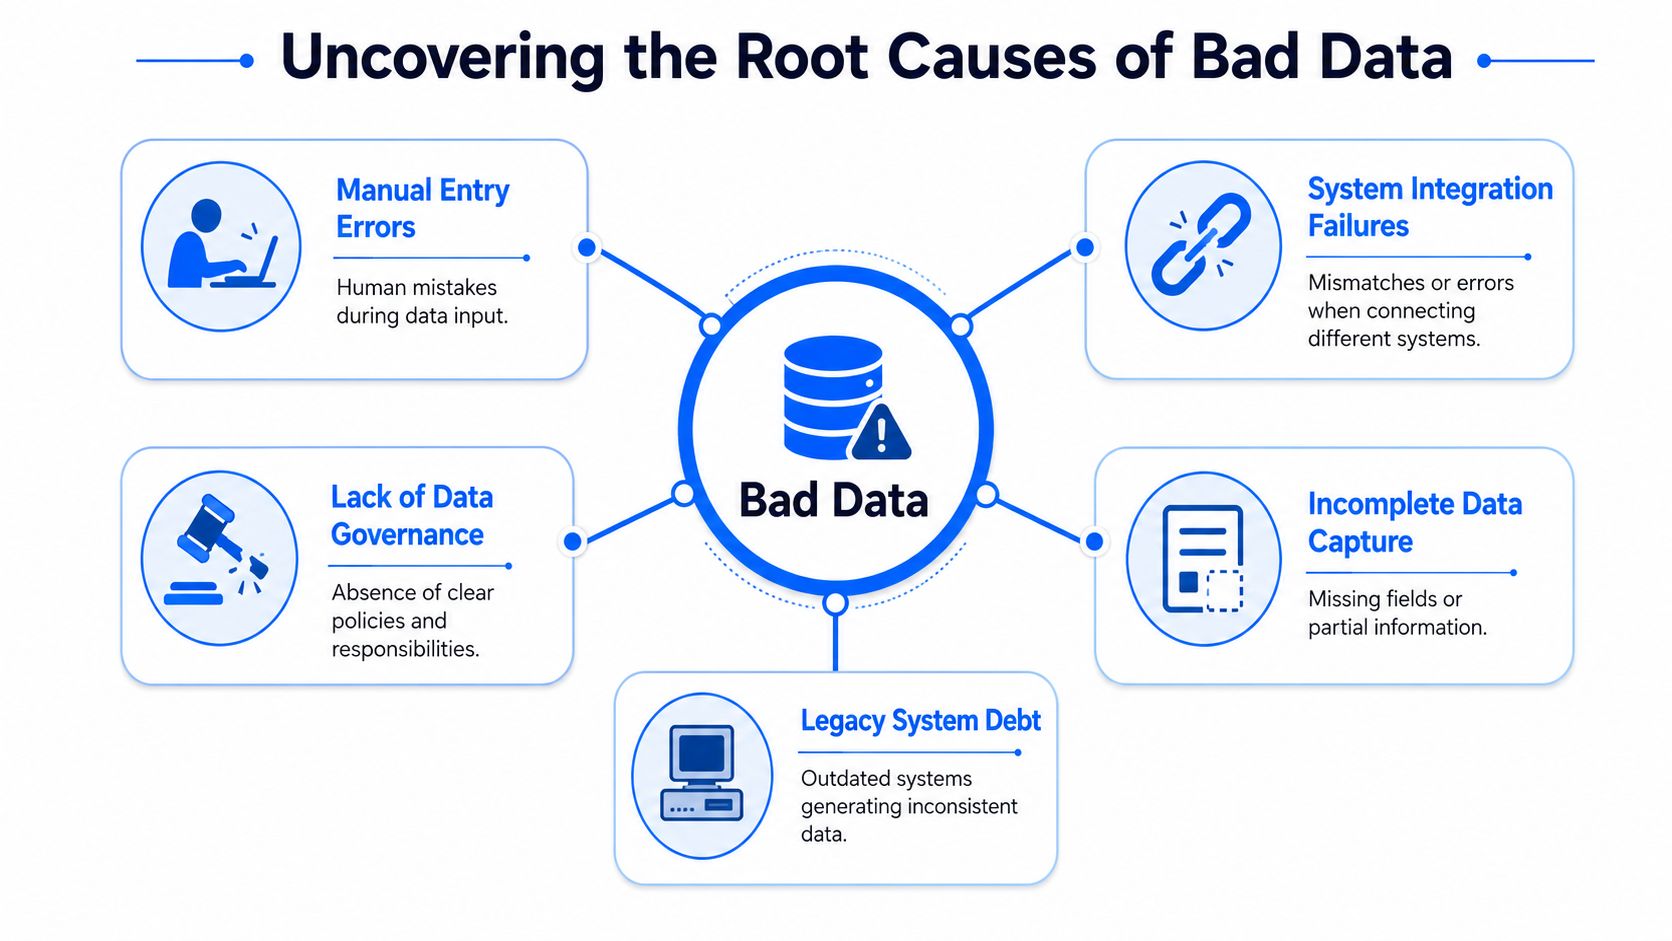
Le cause di solito si nascondono in piena vista
L'inserimento manuale è ancora una delle principali fonti di difetti. I team copiano valori da email, PDF e moduli sotto pressione, e quei piccoli errori si propagano poi in CRM, fatturazione e analytics. Se il vostro workflow dipende ancora da persone che ridigitano dati commerciali, vale la pena valutare modi per prevenire gli errori di inserimento dati nelle offerte prima che arrivino al data warehouse.
I guasti di integrazione tra sistemi emergono quando due applicazioni non concordano su significato, formato o tempistica di un campo. Vedete un sintomo in una dashboard, ma il difetto reale è nato quando la sorgente A ha inviato un valore che la sorgente B ha interpretato in modo diverso.
Le lacune di governance peggiorano ulteriormente la situazione. Se nessuno è responsabile di un dominio di dati, la gestione degli incidenti diventa un tirare a indovinare. Gli ingegneri possono ripristinare una pipeline, ma non possono decidere se una regola di business sia cambiata, a meno che qualcuno non sia responsabile di quei dati.
I dati peggiorano anche quando nessuno rompe nulla
I dati non sono statici. Il decadimento dei dati avviene a un tasso globale di circa il 3% al mese, il che significa che i record diventano naturalmente obsoleti a meno che i team non li mantengano (lakeFS sui problemi di qualità dei dati). I dati di contatto cambiano. I cataloghi prodotti evolvono. Stato degli account, condizioni di prezzo e relazioni con i clienti non restano fermi.
Questo decadimento è importante perché molti team monitorano solo il successo della pipeline. Non monitorano se il dataset rifletta ancora la realtà attuale.
Un caricamento riuscito può comunque fornire informazioni obsolete
Uno schema valido può comunque contenere valori non aggiornati
Una riga completa può comunque essere sbagliata per la decisione di oggi
Il workflow di analisi delle cause che aiuta davvero
Quando si presenta un incidente, lo ricostruisco in quest'ordine:
Partite dal sintomo. Quale report, tabella o modello è diventato inaffidabile?
Controllate la tempistica di consegna. Il caricamento previsto è arrivato in ritardo, è parziale o manca del tutto?
Ispezionate la struttura. È cambiata una colonna, un tipo o un'interfaccia a monte?
Esaminate il comportamento dei valori. Le distribuzioni si sono spostate pur con uno schema rimasto stabile?
Verificate la ownership. Chi può dire se si tratta di un difetto o di un reale cambiamento di business?
Per i team che stanno formalizzando questo processo, una guida strutturata all'analisi delle cause principali dei problemi dei dati con l'AI può rendere molto più rapido il passaggio dall'alert alla diagnosi.
L'analisi delle cause diventa più semplice quando il vostro monitoraggio rispecchia il modo in cui i guasti si verificano davvero: tempistica, struttura, valori e infine ownership.
Il vero costo dell'inazione: impatti su business e ML
Il danno operativo causato dalla scarsa qualità dei dati non si limita alle rilavorazioni. Cambia il comportamento dei team. Smettono di fidarsi dell'automazione, duplicano i controlli a mano e rimandano le decisioni finché qualcuno non ha validato i numeri.
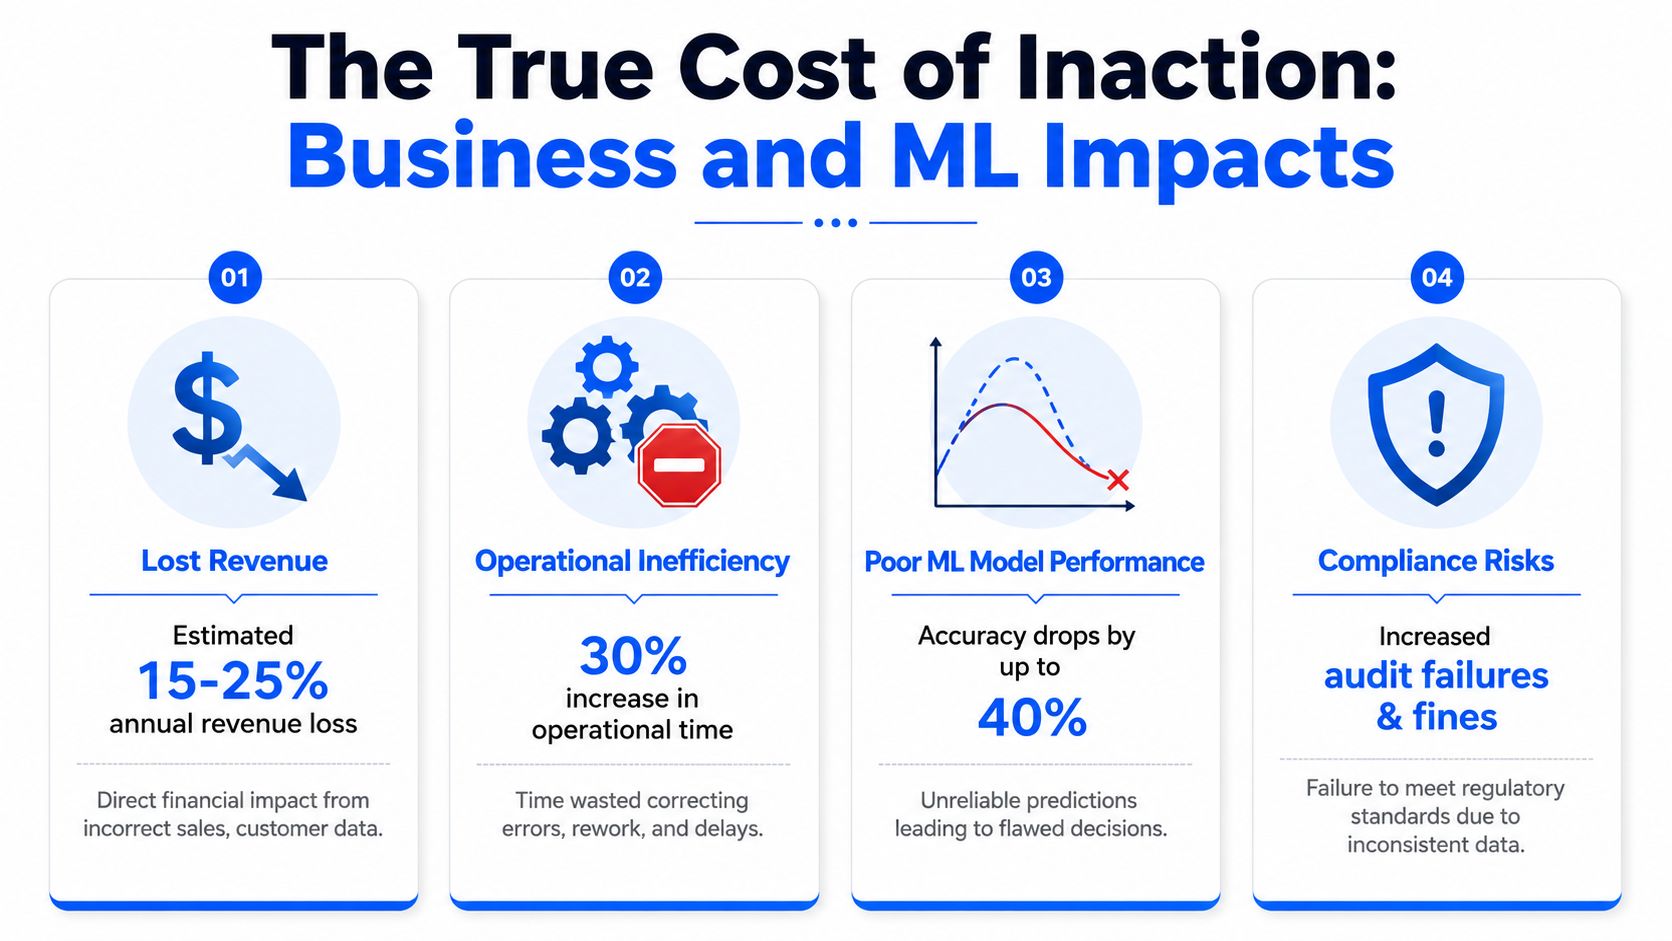
I sistemi di business pagano per primi
Quando la fiducia nei dati cala, la prima vittima è la velocità. I team commerciali mettono in dubbio i report sulla pipeline di vendita. Il finance riconcilia di più a mano. I team di compliance chiedono prove che nessuno riesce a produrre in modo pulito, perché il lineage è poco chiaro o la sorgente è cambiata senza che nessuno se ne accorgesse.
Nei workflow di forecasting questo è particolarmente evidente. Se state cercando di collegare l'affidabilità delle sorgenti alla pianificazione commerciale, questa guida su come diagnosticare e migliorare le previsioni di vendita è utile, perché mostra come i difetti dei dati distorcano la pianificazione prima che i responsabili si rendano conto che il modello non è l'unico problema.
I sistemi di ML falliscono in modo diverso
Le pipeline di machine learning sono meno indulgenti di quanto molti team si aspettino. Una dashboard può apparire strana e innescare una revisione umana. Un modello può continuare a fornire previsioni mentre la qualità degli input peggiora.
La tradizionale validazione basata su regole spesso non coglie fino al 90% delle anomalie rilevanti per il ML, perché si basa su soglie statiche anziché sull'apprendimento dinamico delle baseline, e il costo di un singolo evento di drift non rilevato può superare 1 milione di dollari di ricavi persi a causa di decisioni automatizzate errate (Atlan sui problemi di qualità dei dati).
Questo ha due implicazioni pratiche:
I controlli statici non bastano per gli input dei modelli. I controlli sui null e sugli intervalli intercettano i difetti evidenti, non le variazioni sottili delle distribuzioni.
Il drift silenzioso è costoso. Quando gli utenti notano il peggioramento degli output, il modello ha già influenzato le decisioni.
Se una pipeline di feature è abbastanza importante da alimentare un modello, è abbastanza importante da essere monitorata per il drift, non solo per la validità.
Il costo nascosto è l'attenzione dell'engineering
Il lavoro reattivo sui dati consuma l'attenzione che dovrebbe andare ai miglioramenti della piattaforma. Invece di costruire data product riutilizzabili, i team inseguono incidenti, rispondono a domande sulla fiducia e rieseguono job. È una tassa sulla capacità di engineering e sulla fiducia degli stakeholder.
Come rilevare e misurare la qualità dei dati
Esistono due approcci principali al rilevamento. Quello tradizionale chiede agli ingegneri di definire in anticipo regole per tutto ciò che riescono a immaginare. Quello più recente combina regole esplicite con un'observability continua che apprende il comportamento normale e segnala gli scostamenti.
In cosa sono efficaci i controlli tradizionali
I controlli SQL manuali e i test basati su regole hanno ancora il loro posto. Sono adatti ai requisiti rigidi:
Campi obbligatori
Elenchi di valori ammessi
Integrità referenziale
Logica di business, come i vincoli su stati o importi
Questi controlli sono verificabili e prevedibili. Per i dataset sensibili in termini di compliance, sono indispensabili.
Dove i controlli tradizionali cedono
Il problema è la copertura. Gli studi indicano che l'85% delle pipeline di dati subisce modifiche strutturali impreviste, come colonne aggiunte o rimosse, che sfuggono ai tradizionali sistemi di monitoraggio basati su regole (Atlan sui software di data quality). Se i vostri controlli verificano solo ipotesi note, non intercetteranno nuove modalità di guasto.
Una regola statica fatica anche con comportamenti che cambiano nel tempo. Una tabella può mantenere lo stesso schema mentre una metrica chiave va lentamente alla deriva. Questo può peggiorare il reporting o la qualità dei modelli senza violare una sola soglia codificata.
Che cosa aggiunge l'observability moderna
Gli strumenti di observability moderni misurano i pattern, non solo il rispetto delle regole. Monitorano baseline storiche, comportamenti stagionali, modifiche di schema e calendari di consegna previsti. Il cambiamento chiave è questo: invece di chiedere agli ingegneri di indovinare ogni problema futuro, la piattaforma sorveglia i comportamenti che diventano anomali rispetto al passato.
Uno stack di misurazione pratico comprende di solito:
Metodo di rilevamento | Ideale per | Limite |
|---|---|---|
Test SQL | Regole di business rigide | Non coglie la deriva sottile |
Monitoraggio dello schema | Modifiche di colonne e tipi | Non spiega le anomalie nei valori |
Monitoraggio della tempestività | Caricamenti in ritardo o mancanti | Non verifica la correttezza dei record |
Rilevamento delle anomalie | Variazioni silenziose e pattern insoliti | Richiede un buon apprendimento delle baseline |
Che cosa misurare per primo
Se state costruendo un programma di base, partite da un piccolo insieme di metriche visibili e rendetele operative. Un riferimento utile è questa panoramica sulle metriche di qualità dei dati, soprattutto se dovete allineare ingegneri e stakeholder di business su che cosa misurare e perché.
Il mio ordine predefinito è semplice:
Tempestività delle tabelle critiche
Modifiche di schema sui dataset condivisi
Regole a livello di record per campi regolamentati o ad alto impatto
Anomalie comportamentali sulle metriche di business principali
La configurazione di rilevamento più solida combina controlli deterministici e baseline apprese. I primi intercettano ciò che non deve mai accadere. Le seconde intercettano ciò che nessuno ha pensato di codificare.
Un workflow moderno di remediation e monitoraggio con digna
Un flusso di remediation efficace deve fare quattro cose in sequenza: rilevare il problema, localizzarlo, validarne l'impatto e notificare il responsabile giusto, senza spostare dati sensibili al di fuori dell'ambiente del cliente.
Partite dal rilevamento all'interno del database
Negli ambienti regolamentati, la decisione architetturale conta quanto l'insieme delle funzionalità. Molti team non possono inviare dati di produzione a un cloud di terze parti per l'analisi, soprattutto quando le stesse tabelle contengono record operativi, identificativi dei clienti o eventi di business sensibili.
Un workflow in-database mantiene i dati dove sono e calcola le metriche là dove risiedono già il data warehouse o il data lake. digna è un esempio di questo approccio. Esegue rilevamento delle anomalie, monitoraggio della tempestività, schema tracking, analytics storici e validazione a livello di record all'interno di ambienti controllati dal cliente, come deployment in private cloud o on-premise.
Questo cambia il compromesso. Non dovete scegliere tra observability e residenza dei dati.
Un flusso pratico di gestione degli incidenti
Ecco il tipo di sequenza che funziona bene in produzione:
Compare un'anomalia. Su una tabella critica viene rilevato un calo di volume, una variazione della distribuzione o un picco insolito.
Si verifica la tempestività. Il caricamento è arrivato in ritardo o è incompleto?
Si ispeziona lo schema. Una colonna aggiunta, rimossa o modificata ha cambiato il comportamento a valle?
Si validano i record. Le regole di business falliscono a livello di riga?
I responsabili ricevono il contesto. L'alert include la tabella, la metrica, la finestra temporale e la probabile area di origine.
I problemi di tempestività sono all'origine del 62% dei report obsoleti e delle dashboard rotte, e i ritardi dei dati aumentano di 3,2 volte il tempo di analisi delle cause rispetto a un rilevamento immediato delle anomalie (dati di digna sul monitoraggio della tempestività). Se il sistema intercetta il ritardo nel momento in cui si verifica, gli ingegneri indagano su un singolo passaggio della pipeline. Altrimenti, impiegano molto più tempo a ricostruire la catena degli eventi.
Che cosa funziona meglio delle emergenze gestite caso per caso
Il vecchio schema di remediation è noto: qualcuno segnala un grafico rotto, un ingegnere esegue query SQL, un analista controlla i dati a monte e il team tampona il sintomo. Questo può risolvere l'incidente di oggi lasciando comunque in agguato quello di domani.
Uno schema migliore combina:
Monitoraggio delle consegne previste, così che i dati obsoleti vengano intercettati prima di riunioni e report
Alert sulle modifiche di schema, così che i difetti strutturali non si nascondano dietro esecuzioni di job riuscite
Validazione a livello di record per i campi legati a compliance, fatturazione o comunicazione con i clienti
Viste storiche dei trend, così che i team possano capire se una variazione è nuova, stagionale o di lunga durata
Se il vostro problema a valle riguarda la qualità della comunicazione con i clienti più che l'integrità del data warehouse, contano anche le pratiche di igiene adiacenti. Per esempio, i team che puliscono i dati in uscita per aumentare il ROI delle email stanno risolvendo un livello diverso dello stesso problema di fiducia: record errati producono risultati errati.
Perché è importante un'observability privacy-first
L'argomento più forte a favore dell'observability in-database è il realismo operativo. In molte aziende, i team di sicurezza e legali bloccheranno le architetture che richiedono un ampio accesso del vendor ai dataset di produzione. Un design di monitoraggio che rispetti questo vincolo ha maggiori probabilità di essere approvato, implementato e mantenuto in servizio.
Costruire una cultura proattiva della qualità dei dati
Gli strumenti aiutano, ma è la cultura a determinare se gli alert portano a sistemi migliori o solo a più ticket.

I team che gestiscono bene i problemi di qualità dei dati fanno con costanza alcune cose:
Assegnano la ownership: ogni dataset importante ha bisogno di una persona o di un team in grado di dire se un cambiamento è previsto.
Automatizzano l'ovvio: non sprecano il tempo degli analisti in controlli che un sistema può eseguire in modo continuo.
Distinguono le violazioni delle regole dalle variazioni di comportamento: regole di compliance, modifiche di schema e anomalie richiedono risposte diverse.
Rendono visibile la qualità: ingegneri, analisti e utenti di business dovrebbero vedere gli stessi segnali di salute.
Analizzano gli incidenti in ottica di prevenzione: ogni correzione dovrebbe produrre una protezione migliore, non solo una rettifica una tantum.
Le buone culture dei dati non aspettano che siano i dirigenti a scoprire il problema in una dashboard. Lo fanno emergere prima, con contesto e ownership già associati.
Una checklist pratica per un nuovo team è breve:
Individuate le vostre tabelle e i vostri report critici
Definite i responsabili di ciascun dominio di dati
Monitorate freshness e schema sugli asset condivisi
Validate i campi regolamentati e critici per il business
Monitorate i trend, così che gli incidenti ricorrenti diventino visibili
Se state valutando approcci privacy-first per rilevare e risolvere i problemi di qualità dei dati, vale la pena dare un'occhiata a digna. Si concentra su observability in-database, rilevamento delle anomalie, validazione dei record, monitoraggio della tempestività e schema tracking in ambienti controllati dal cliente, il che la rende rilevante per i team che hanno bisogno di un monitoraggio solido senza spostare dati sensibili in un cloud di terze parti.
Poiché completezza, accuratezza, coerenza e duplicati corrispondono tutti a regole a livello di record nella tassonomia precedente, scoprite come digna Data Validation verifica queste regole all'interno del vostro database.
Domande frequenti
Quali sono i problemi di qualità dei dati più comuni?
La maggior parte degli incidenti rientra in otto categorie: completezza, accuratezza, tempestività, coerenza, schema drift, duplicati, outlier e guasti della pipeline. Dare un nome alla categoria è importante perché ognuna richiede un controllo diverso, per esempio regole a livello di record per i campi mancanti, monitoraggio dello schema per le modifiche strutturali e monitoraggio della freshness per i caricamenti in ritardo o mancanti.
Quanto costa a un'azienda la scarsa qualità dei dati?
Secondo un dato Gartner citato nell'articolo, la scarsa qualità dei dati costa alle aziende in media 12,9 milioni di dollari all'anno. I costi nascosti vanno oltre: decisioni più lente, riconciliazioni manuali nel finance e tempo di engineering speso a rieseguire job e rispondere a domande sulla fiducia invece di costruire data product riutilizzabili.
Come si individua la causa principale di un problema di qualità dei dati?
Ricostruitelo in un ordine preciso: partite dal sintomo, poi controllate la tempistica di consegna, ispezionate la struttura, esaminate il comportamento dei valori e infine verificate la ownership. Questo ordine rispecchia il modo in cui i guasti si verificano davvero, così scoprite se un caricamento è arrivato in ritardo o è parziale prima di discutere se una colonna sia cambiata o le distribuzioni si siano spostate.
Perché i controlli di qualità dei dati basati su regole non colgono alcuni problemi?
Le regole statiche verificano solo le ipotesi che qualcuno ha già codificato. L'articolo cita ricerche secondo cui l'85% delle pipeline di dati subisce modifiche strutturali impreviste, come colonne aggiunte o rimosse, che sfuggono al monitoraggio basato su regole, e una tabella può mantenere il proprio schema mentre una metrica chiave va lentamente alla deriva senza superare alcuna soglia.
Perché la qualità dei dati peggiora anche quando nulla si rompe?
I dati decadono da soli a un ritmo di circa il 3% al mese, man mano che cambiano dati di contatto, cataloghi prodotti, prezzi e stato degli account. Un caricamento riuscito può quindi comunque fornire informazioni obsolete, ed è per questo che i team dovrebbero monitorare se un dataset riflette la realtà attuale, non solo se la pipeline si è conclusa.


