Monitoraggio delle pipeline di dati: metriche e alert intelligenti
|
5
min di lettura

Potete avere tre dashboard verdi e svegliarvi comunque con un board pack rotto, un feed finanziario mancante o un report BI di cui nessuno si fida. È la fastidiosa verità del monitoraggio delle pipeline di dati. Il compito non è fissare più grafici, ma sapere, abbastanza presto, se i dati sono in ritardo, malformati, in drift o sul punto di rompere qualcosa a valle.
In Europa questa pressione è più forte, perché il monitoraggio non è solo un'abitudine tecnica. Il piano spagnolo Digital Spain 2025, lanciato con un budget di 2,5 miliardi di €, ha messo dati e interoperabilità al centro dell'infrastruttura pubblica, e l'EU Data Governance Act ha aggiunto un ulteriore livello di aspettative in materia di fiducia e accesso per i flussi di dati tra organizzazioni: ciò significa che oggi i controlli sulle pipeline si inseriscono in un quadro di governance più ampio, non al di fuori di esso. Questo contesto normativo sta diventando impossibile da ignorare, soprattutto quando tempestività, coerenza degli schemi e tracciabilità sono requisiti di business tanto quanto requisiti di engineering.
Oltre l'emergenza delle 3 di notte
Alle 3 di notte il primo indizio è di solito un messaggio di qualcuno a cui non interessa lo stato del vostro DAG. La finanza vuole i numeri. Le operations vogliono risposte. La dashboard è rotta, la pipeline segnala successo e i log sono sparsi tra tre strumenti che sostengono ciascuno di aver fatto il proprio lavoro. È il tipo di notte che trasforma un buon engineer in un addetto permanente alla gestione degli incidenti.
La soluzione non sono “più alert”. È il passaggio dal monitoraggio reattivo all'observability. L'obiettivo pratico è vedere il guasto prima che una persona del business lo percepisca, il che significa tracciare end-to-end la tempestività dei dati, le modifiche agli schemi e le lacune nelle consegne. Negli ambienti europei regolamentati questo passaggio conta ancora di più, perché la domanda non è solo “il job è stato eseguito?”, ma “sono arrivati i dati giusti, con la forma giusta, dove dovevano arrivare?”
Regola pratica: se l'alert vi dice solo che il calcolo è in salute, non state monitorando la pipeline, state monitorando il server.
Ecco perché questo problema è passato dall'igiene operativa alla governance. Un buon punto di partenza è una checklist di affidabilità ad ampio raggio e, se vi serve una base per ragionare sul rischio delle pipeline, questa checklist sull'affidabilità dei dati per i data team merita di essere tenuta a portata di mano mentre progettate le vostre regole di monitoraggio.
Che cosa monitorare davvero nelle vostre pipeline
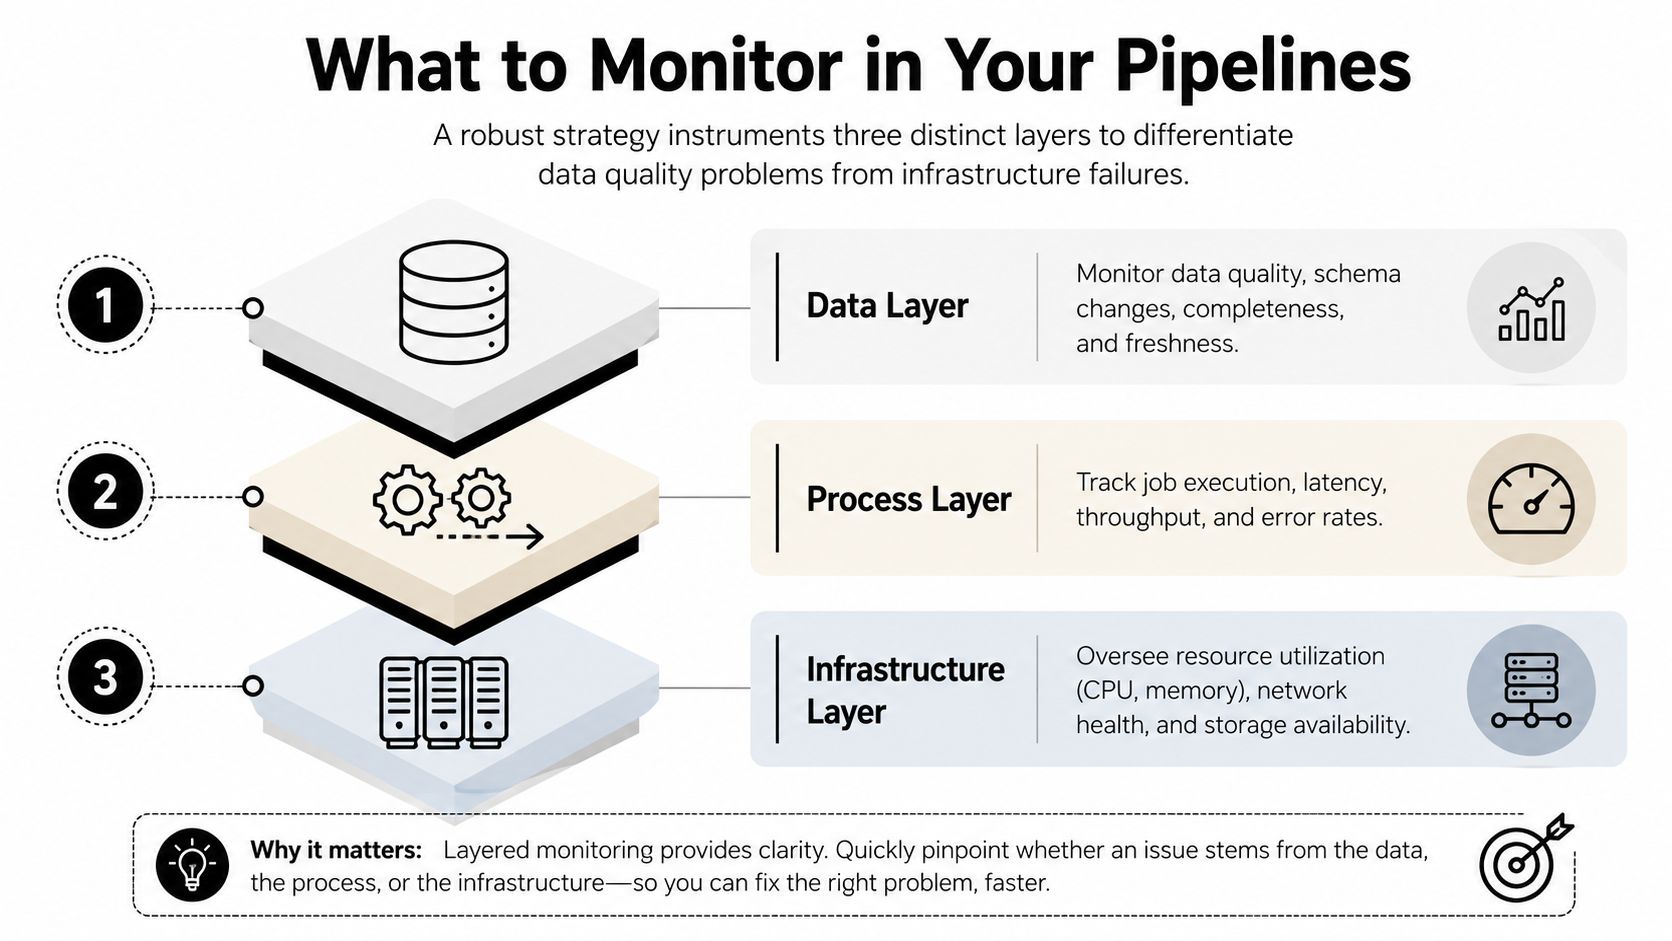
Una pipeline è più facile da sottoporre a debug quando ogni segnale appartiene a un livello ben definito. Se mescolate Data Quality, esecuzione dei job e stato del cluster nello stesso contenitore, passerete metà del tempo a chiedervi se il problema sia nella sorgente, nella trasformazione o nella piattaforma. La mossa più pulita è strumentare tre livelli contemporaneamente, per poi stabilire che cosa si è guastato senza una caccia al tesoro.
Livello dei dati
È di solito qui che iniziano i danni silenziosi.
I timestamp di freschezza vi dicono se i dati sono arrivati in ritardo, il che è importante quando la reportistica e gli SLA a valle sono sensibili alle tempistiche.
Il numero di record intercetta cali e duplicazioni, ma il segnale più forte è l'andamento nel tempo, non una singola soglia.
Lo schema drift rivela campi aggiunti, rimossi o con tipo modificato prima che i modelli BI e le trasformazioni inizino a fallire.
Tassi di valori nulli e anomalie di distribuzione rivelano corruzioni che a livello di job sembrano ancora “riuscite”.
L'orario di consegna previsto rispetto all'arrivo effettivo è particolarmente utile per i feed che arrivano secondo un calendario, perché individua i ritardi prima che qualcuno veda una dashboard obsoleta.
Livello dei processi
Qui emergono spesso i problemi di orchestrazione.
La durata delle run vi aiuta a individuare un rallentamento progressivo prima che i job inizino a sovrapporsi.
La latenza tra le fasi mostra se un task sta rallentando un altro, spesso il primo segnale di problemi nelle dipendenze.
I tassi di errore per task distinguono una trasformazione instabile da un disservizio della sorgente.
Gli ID univoci delle run consentono di seguire una singola esecuzione attraverso log, alert e impatti a valle.
Il tempo trascorso dall'ultima run riuscita è uno dei controlli di buon senso più rapidi quando un team inizia a chiedersi perché una tabella non si è aggiornata.
Livello dell'infrastruttura
Questo livello è importante, ma non dovrebbe essere l'unico.
CPU e memoria vi aiutano a intercettare la pressione sulle risorse prima che i job falliscano del tutto.
I/O su disco e disponibilità dello storage contano quando i caricamenti rallentano per motivi che sembrano problemi di dati.
Lo stato della rete può spiegare perché l'ingestione si è bloccata anche se il codice non è cambiato.
I segnali di guasto a livello di piattaforma sono utili come rete di sicurezza, ma non intercettano un job apparentemente pulito che ha scritto dati errati.
Se vi serve un riferimento sui tipi di controlli di Data Quality che appartengono al primo livello, queste metriche di Data Quality sono un buon modo per tradurre l'astratta “qualità” in segnali di observability concreti. E se state normalizzando feed di dominio disordinati, lo stesso principio vale sia che lavoriate con la finanza sia che stiate normalizzando dati esport per CS2: la struttura dei dati conta più dell'etichetta del sistema sorgente.
Scegliere il vostro stack di observability
La scelta tra costruire e acquistare si complica rapidamente quando entra in gioco la privacy. Uno stack fai-da-te costruito con log di orchestrazione, query sul warehouse e regole di alert personalizzate può funzionare, ma vi lascia più codice da gestire, più tuning da mantenere e più punti in cui lo stesso livello di monitoraggio può rompersi. È accettabile per un piccolo team con flussi semplici. Diventa doloroso nella finanza, nella sanità, nel settore pubblico e in qualsiasi contesto in cui la residenza dei dati ha un peso significativo.
Il problema più grande è l'architettura. Molti strumenti di monitoraggio tradizionali richiedono ancora che metadati, estratti o campioni vengano inviati nell'ambiente del vendor. Va bene finché il dataset non è sensibile, regolamentato o tenuto a non uscire dal perimetro controllato dal cliente. Per le aziende europee è l'impostazione predefinita sbagliata. Il monitoraggio dovrebbe vivere dove vivono i dati.

L'observability nel database cambia la natura del problema. Piattaforme come digna calcolano automaticamente le metriche dei dati nel database, apprendono le baseline, analizzano i trend e monitorano i calendari all'interno dell'ambiente del cliente. La sua anomaly detection calcola metriche come Sum, Min e i conteggi dei valori per ogni colonna, il che significa che il sistema osserva il comportamento senza richiedere spostamenti di dati. Il modello di implementazione è documentato qui, e il vantaggio pratico è semplice: il livello di monitoraggio può adattarsi al perimetro di residenza dei dati invece di scontrarsi con esso.
Se il vostro piano di monitoraggio dipende dall'invio dei dati di produzione altrove, avete già creato il problema di compliance che cercavate di evitare.
C'è anche un vantaggio di governance che sfugge in molte discussioni sugli strumenti. L'esecuzione nel database riduce gli attriti operativi, preserva la verificabilità e rende più facile mantenere il piano di controllo vicino al piano dei dati. È una soluzione molto più adatta alle aziende europee rispetto a un livello di visibilità che di fatto diventa una pipeline di esportazione dei dati.
Strumentare le pipeline per una visibilità completa

Una pipeline diventa monitorabile solo quando emette i metadati giusti. Airflow, dbt, Spark e strumenti simili non vi daranno magicamente la causa principale se i vostri job non registrano abbastanza contesto per collegare i punti. Lo schema più pulito è rendere ogni run tracciabile fin dal momento in cui parte, per poi associare le metriche di qualità quando i dati arrivano.
Un esempio pratico: un feed orario delle vendite
Prendiamo un caricamento orario delle vendite di un e-commerce. La sorgente deposita gli ordini, la trasformazione li arricchisce e una tabella del warehouse alimenta la reportistica. La prima cosa da aggiungere è un ID univoco della run che segua il job dall'ingestione alla trasformazione fino al caricamento. Senza di esso, ogni incidente si trasforma in archeologia dei log.
Poi registrate eventi strutturati all'inizio e alla fine di ogni task. Acquisite lo snapshot della sorgente, la tabella di destinazione, il numero di righe in ingresso, il numero di righe in uscita ed eventuali modifiche allo schema osservate lungo il percorso. Se la dashboard a valle mostra all'improvviso meno vendite, volete sapere se l'estrazione era incompleta, se la trasformazione ha scartato righe o se il caricamento non è mai stato completato.
Che cosa emettere ogni volta
Identificativo della run per la tracciabilità tra i sistemi.
Timestamp delle fasi per misurare dove si è perso tempo.
Numero di record prima e dopo la trasformazione per intercettare perdite silenziose.
Metadati dello schema perché nuove colonne o modifiche di tipo non passino inosservate.
Risultati della validazione per le regole di business che contano, come ID d'ordine duplicati o chiavi cliente mancanti.
La migliore abitudine di implementazione è la coerenza. Se ogni pipeline emette metadati con una forma leggermente diversa, alerting e dashboard diventano più difficili da interrogare dei dati stessi. Standardizzate presto lo schema degli eventi, poi mantenetelo noioso. Metadati noiosi sono buoni metadati.
Anche il comportamento storico conta. Le indicazioni di Astera sul monitoraggio sono schiette sul problema dei controlli statici: creano rumore e non colgono il drift graduale, quindi quando strumentate la pipeline usate baseline storiche, non solo soglie rigide. Un percorso code-first per portare l'observability nei vostri job di dati è utile se volete integrarla nello sviluppo invece di aggiungerla in un secondo momento.
Configurare alert intelligenti e dashboard
Le soglie statiche sono facili da impostare e facili da rimpiangere. “Alert se il numero di righe scende sotto X” sembra ordinato finché il business non cambia, non subentra la stagionalità o una sorgente non si ferma normalmente nel fine settimana. A quel punto il canale degli alert si riempie di spazzatura, tutti lo silenziano e l'unico incidente reale viene ignorato perché il team è stato abituato a diffidare del rumore.
Il modello migliore è l'alerting basato sulla baseline. Significa osservare la forma dei dati nel tempo e segnalare una deviazione dal comportamento normale, anziché un numero qualsiasi che supera una linea. Nella vita operativa la differenza è enorme. Un feed giornaliero con volumi più bassi nel fine settimana non dovrebbe svegliare nessuno. Un improvviso ritardo di freschezza su un dataset regolamentato probabilmente sì.

È qui che l'anomaly detection basata sull'AI dimostra il suo valore. digna apprende automaticamente il comportamento normale di un dataset e segnala le deviazioni senza manutenzione manuale delle regole, mantenendo anche il contesto storico di observability attorno a ogni alert. L'approccio all'automazione è descritto qui, e il valore non sta nel sembrare intelligente, ma nel ridurre gli alert inutili che portano i team a smettere di prestare attenzione.
Una dashboard utile è una dashboard breve. Dovrebbe mostrare a colpo d'occhio stato degli SLA, freschezza, drift e incidenti in corso, per poi consentirvi di approfondire la tabella o il job che fallisce senza cercare in cinque schede. Se la dashboard ha bisogno di una spiegazione a voce ogni volta che qualcuno la apre, è già troppo complicata.
Regola empirica: le dashboard servono al triage, non allo spettacolo.
Per i team europei c'è un secondo vantaggio. Un alerting più intelligente vi aiuta a restare selettivi, il che conta quando l'utilizzo del cloud e gli oneri di governance sono entrambi preoccupazioni crescenti. Volete un monitoraggio che si guadagni il suo posto facendo emergere deviazioni su cui si può agire, non inondando la stanza di costose certezze su cose irrilevanti.
Dall'alert alla risoluzione: un flusso di troubleshooting
Un alert dovrebbe avviare una diagnosi, non il panico. La prima domanda riguarda sempre il raggio d'impatto, perché un feed rotto può avvelenare un report o dieci consumatori a valle. La seconda domanda è se il guasto proviene dalla sorgente, dalla trasformazione o dal percorso di consegna. Se saltate queste domande, finite per fare debug girando in tondo.
Il flusso più rapido parte dal contesto dell'alert stesso. Una buona piattaforma non si limita a dire “anomalia rilevata”: mostra da quanto tempo la metrica ha questo andamento, se lo schema si è già verificato in passato e se il problema è isolato o fa parte di uno schema più ampio del dataset. È esattamente questo tipo di contesto che fornisce il modello di alerting di digna, e accorcia il percorso dal sintomo alla causa probabile.
Un semplice ordine di intervento
Controllate prima il contesto dell'alert. Verificate se il problema è una rottura improvvisa o un drift lento.
Tracciate l'ID della run. Usatelo per seguire la pipeline attraverso i log centrali, gli eventi dei task e le dipendenze a valle.
Esaminate lineage e consumatori. Scoprite quali dashboard, modelli o report dipendono dalla tabella interessata.
Rivedete le modifiche recenti a codice o configurazione. Molti guasti derivano da una modifica al calendario o da un aggiornamento dello schema apparentemente innocui.
Confrontate con gli incidenti precedenti. Gli schemi ripetuti indicano di solito una sorgente instabile o un presupposto fragile.
Questa sequenza trasforma il troubleshooting in un processo ripetibile. Aiuta anche i team a evitare il classico errore di trattare ogni incidente come un caso isolato. Se la stessa classe di guasti continua a ripresentarsi, di solito il problema non è l'alert. È l'assenza di un vero modello delle dipendenze.
I migliori operatori tengono a mente un'abitudine: ogni alert ha una storia, anche quando la storia è confusa. Usatela. Poi usate l'ID della run, il contesto della baseline e la vista degli impatti a valle per decidere se avete a che fare con un problema di dati, un problema di orchestrazione o un problema di progettazione della pipeline da risolvere alla fonte.
Se state riprogettando il vostro monitoraggio per un ambiente europeo regolamentato, partite dai perimetri, non dagli alert. Mappate ciò che deve restare all'interno dell'ambiente del cliente, definite le metriche che contano per ciascun dataset e poi testate un livello di monitoraggio nel database su una pipeline reale prima di estenderlo. Un passo successivo pratico è valutare digna rispetto ai vostri requisiti di residenza dei dati, tempestività e schema drift, e poi usare un vero feed di produzione per verificare se fa emergere i problemi prima dei vostri utenti.
Per il controllo tra arrivo previsto ed effettivo descritto nel livello dei dati, guardate come digna Timeliness monitora quando i dati dovrebbero arrivare e segnala i caricamenti in ritardo o mancanti.
Domande frequenti
Che cosa bisogna monitorare in una pipeline di dati?
Monitorate tre livelli separatamente. Il livello dei dati copre timestamp di freschezza, numero di record, schema drift, tassi di valori nulli e orario di arrivo previsto rispetto a quello effettivo; il livello dei processi copre durata delle run, latenza tra le fasi, tassi di errore per task e ID delle run; il livello dell'infrastruttura copre CPU, memoria, I/O su disco e stato della rete.
Perché un ID univoco della run è importante per il monitoraggio delle pipeline?
Un ID univoco della run consente di seguire una singola esecuzione dall'ingestione alla trasformazione fino al caricamento, attraverso log, alert e impatti a valle. Nell'esempio dell'articolo sulle vendite orarie di un e-commerce è la prima cosa da aggiungere, perché senza di esso ogni incidente si trasforma in archeologia dei log.
Quali metadati dovrebbe emettere ogni run di una pipeline?
Ogni run dovrebbe emettere un identificativo della run, i timestamp delle fasi, il numero di record prima e dopo la trasformazione, i metadati dello schema e i risultati della validazione per regole di business come ID d'ordine duplicati o chiavi cliente mancanti. L'articolo raccomanda inoltre di standardizzare presto lo schema degli eventi, in modo che alerting e dashboard restino facili da interrogare.
Perché le soglie statiche non vanno bene per gli alert sulle pipeline?
Regole statiche come “alert se il numero di righe scende sotto X” si rompono quando subentra la stagionalità o una sorgente si ferma nel fine settimana, così il canale si riempie di rumore e i team lo silenziano. L'alerting basato sulla baseline segnala invece le deviazioni dal comportamento normale appreso, intercettando il drift graduale che le soglie rigide non colgono.
Come si gestisce il troubleshooting di un alert su una pipeline di dati?
Partite dal contesto dell'alert per capire se si tratta di una rottura improvvisa o di un drift lento. Poi tracciate l'ID della run attraverso i log, esaminate lineage e consumatori a valle, rivedete le modifiche recenti a codice o configurazione e confrontate con gli incidenti precedenti, perché gli schemi ripetuti indicano di solito una sorgente instabile.


