Monitoraggio della data quality su Databricks: guida pratica
|
9
min di lettura
All'inizio il problema non sembra mai drammatico. Un lakehouse Databricks può apparire pulito in ogni dashboard, eppure una tabella gold che alimenta un modello dei ricavi può perdere record arrivati in ritardo per giorni o settimane, e il primo ad accorgersene potrebbe essere il reparto finance, non il data engineering. Ecco perché il monitoraggio della data quality su Databricks va trattato come una disciplina a più livelli, non come un singolo interruttore.
Di solito i team iniziano con qualche controllo in fase di scrittura, per poi rendersi conto che le tabelle curate continuano a deviare, che le modifiche agli schemi continuano a passare inosservate e che i consumatori downstream continuano a fidarsi di dati errati finché qualcuno non si lamenta. Databricks offre abbastanza funzionalità native per costruire i livelli giusti vicino ai dati, e questo conta in ambienti in cui storage, calcolo, governance e orchestrazione convivono. Come promemoria pratico di come i team finanziari affrontano questo problema, i consigli per dati finanziari affidabili sono un utile riferimento esterno, perché mantengono l'attenzione su fiducia, auditabilità e impatto downstream, invece che sui soli controlli tecnici.
Indice
Perché il monitoraggio della data quality su Databricks è diverso
I componenti nativi di Databricks
Partire dall'enforcement in fase di scrittura
Monitorare continuamente le tabelle curate
Usare consapevolmente il modello a più livelli
Scegliere tra strumenti in-database e piattaforme esterne
Le metriche chiave da monitorare su Databricks
Freshness e puntualità
Completezza e conteggi
Anomalie statistiche e schema drift
Validazione delle regole di business
Alerting, lineage e flussi di remediation
Aggiungere un livello di observability dedicato con digna
Abbinare il modulo al problema di monitoraggio
Mantenere i dati all'interno dell'ambiente
Usarlo come livello aggiuntivo, non come sostituto
Una checklist iniziale per il vostro programma di qualità su Databricks
Perché il monitoraggio della data quality su Databricks è diverso
Un lakehouse può essere sano in senso stretto e continuare comunque a mentire al business. Una tabella può aggiornarsi puntualmente, superare i controlli sugli schemi e mancare comunque di record arrivati in ritardo che contano per una previsione dei ricavi. È il tipo di guasto difficile da intercettare se validate solo in fase di ingestion e non sorvegliate mai le tabelle curate dopo il loro caricamento.
Databricks è diverso perché la piattaforma riunisce in un unico posto lo storage Delta, il calcolo, la governance di Unity Catalog e l'orchestrazione delle pipeline. Questo offre ai team dati l'opportunità di mantenere i controlli di qualità vicino ai dati, invece di disperderli tra strumenti separati e percorsi di alerting scollegati. Significa anche che il monitoraggio ha un raggio d'impatto più ampio, perché una sola piattaforma può servire contemporaneamente analytics, funzionalità di AI e consumo operativo.
La distinzione pratica è tra controlli puntuali e observability continua. I controlli puntuali sono ciò che impedisce ai record errati di entrare nelle tabelle bronze o silver. Il monitoraggio continuo è ciò che intercetta le derive nelle tabelle gold, dove i dati possono essere ancora strutturalmente validi ma non più affidabili.
Regola pratica: se una tabella viene utilizzata da persone, modelli o dashboard, trattatela come un asset monitorato, non solo come l'output di un job andato a buon fine.
È questa la mentalità di cui i team Databricks hanno bisogno se vogliono evitare un degrado silenzioso. La piattaforma può ospitare controlli, lineage e alert vicino al workload, ma nessuna singola funzionalità nativa copre ogni livello con la stessa profondità. I programmi più solidi combinano enforcement in fase di scrittura, validazione in fase di trasformazione e monitoraggio post-caricamento, così che un feed upstream errato non diventi un problema di business downstream.
Questa visione a più livelli è anche il motivo per cui la data quality su Databricks non può essere copiata da un playbook generico per data warehouse. Lo stesso ambiente può supportare job di ingestion, tabelle analitiche curate e output di inferenza ML, quindi la superficie da monitorare è più ampia di una singola tabella di report. Una dashboard finance, per esempio, può mostrare solo il sintomo, mentre il difetto vero e proprio è nato in un feed bronze diversi passaggi prima.
I componenti nativi di Databricks
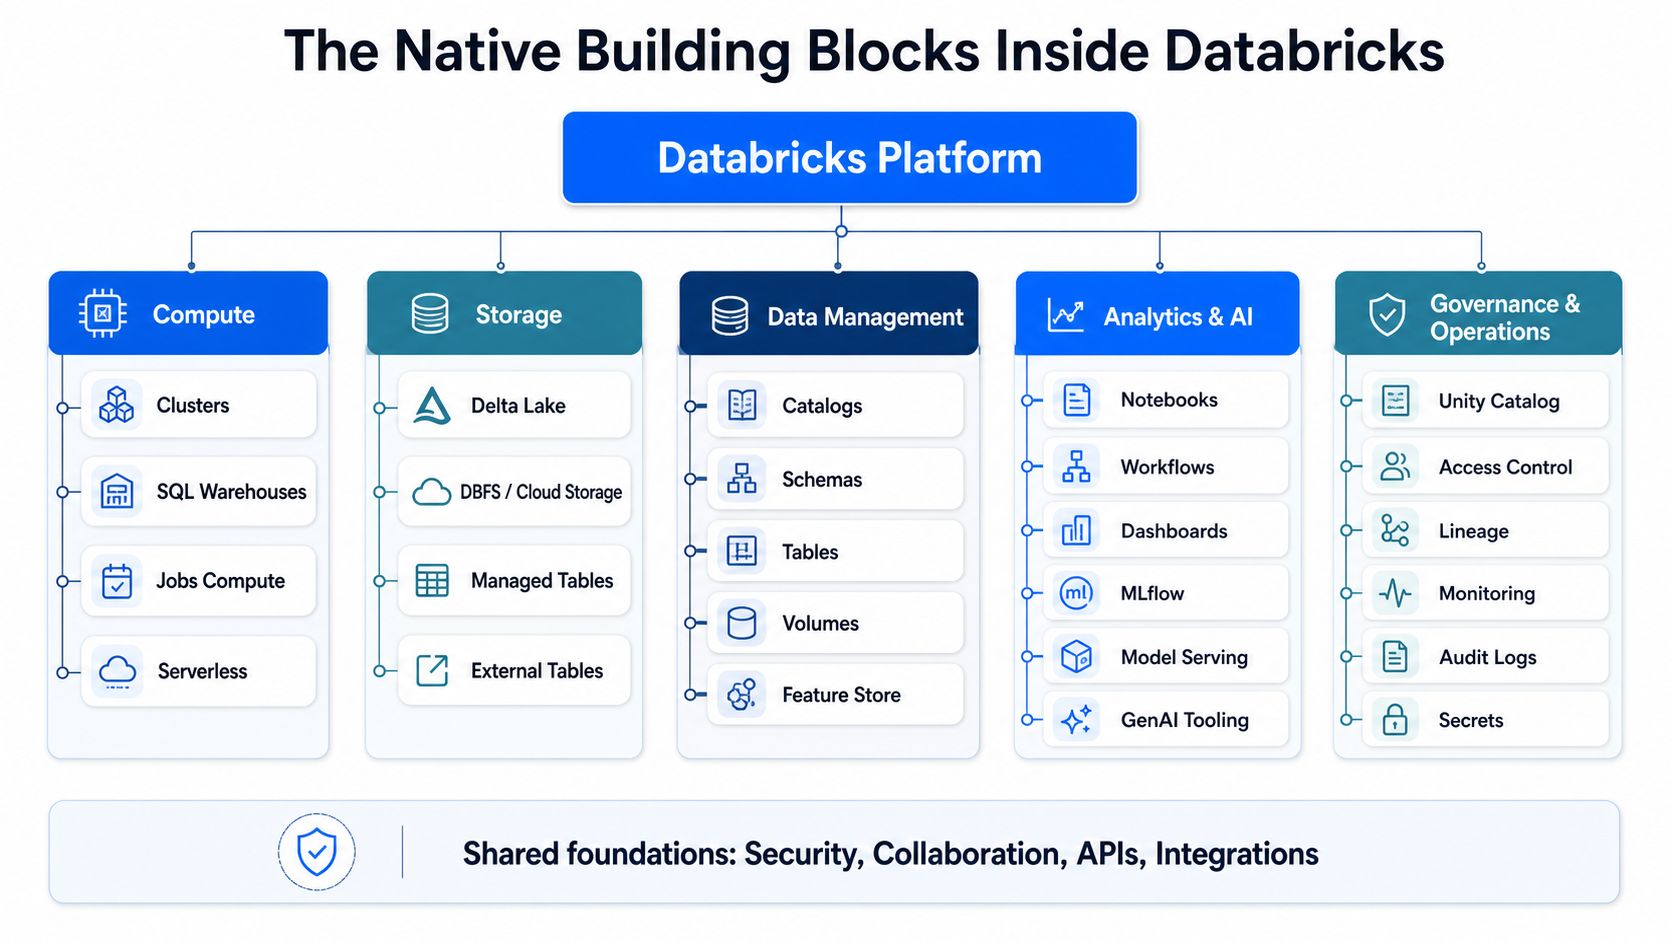
Il modo più chiaro di pensare allo stack nativo è come tre livelli di controllo più una superficie di monitoraggio. I vincoli di Delta Lake e validate applicano le regole in fase di scrittura. Le expectations di Delta Live Tables permettono di definire controlli dichiarativi durante l'esecuzione delle pipeline. Unity Catalog Data Quality Monitoring sorveglia continuamente l'insieme delle tabelle. Le system table e Lakehouse Monitoring aggiungono profiling, rilevamento delle derive e contesto operativo.
Partire dall'enforcement in fase di scrittura
I vincoli e la validazione di Delta appartengono ai confini di ingestion e trasformazione. Il loro compito è fermare i record palesemente errati prima che si diffondano. È lì che la logica deterministica conta di più, perché una regola violata dovrebbe far fallire subito il processo o mettere i dati in quarantena, non essere accettata in silenzio e spiegata più tardi durante una revisione delle dashboard.
Le expectations di DLT rientrano nello stesso piano di controllo, ma in fase di esecuzione della pipeline. Funzionano al meglio quando la regola appartiene alla trasformazione stessa, per esempio quando un campo derivato non deve mai essere nullo o un valore deve restare all'interno di un dominio valido. Il punto è mantenere la logica vicino alla trasformazione che crea i dati, non sepolta in un job di audit downstream.
Monitorare continuamente le tabelle curate
Unity Catalog Data Quality Monitoring è pensato per il problema opposto: il guasto lento che non fa scattare una regola evidente. La documentazione Databricks di Microsoft spiega che valuta automaticamente freshness e completezza per ogni tabella, può monitorare tutte le tabelle di uno schema, crea un job in background e utilizza lo smart scanning per decidere quando le tabelle devono essere analizzate, senza richiedere una pianificazione manuale (Databricks Lakehouse Monitoring). Questo lo rende utile per le tabelle curate che richiedono un controllo costante senza una pianificazione personalizzata tabella per tabella.
La parte di profiling è più dettagliata di quanto molti team immaginino. Il profiling di Databricks raccoglie statistiche di sintesi come valori nulli, zeri, conteggi, medie, valori min/max, deviazione standard e fino a 1.000 quantili per colonna, mentre le metriche di drift confrontano ogni finestra con una baseline o con la finestra precedente per rilevare cambiamenti graduali o improvvisi (documentazione Databricks sul monitoraggio della data quality). Lo stesso materiale di riferimento mostra anche dati sull'impatto operativo nelle system table, tra cui il numero di query eseguite sulle tabelle downstream interessate negli ultimi 30 giorni, indicato come 120 nell'esempio di schema. È utile perché la piattaforma non vi dice soltanto che qualcosa è cambiato, ma anche dove si estende il raggio d'impatto.
Indicazione operativa: i controlli in fase di scrittura prevengono i record errati, il monitoraggio vi dice quando dati dall'aspetto corretto diventano sospetti.
Usare consapevolmente il modello a più livelli
Le indicazioni dell'ecosistema Databricks che reggono meglio alla prova dei fatti sono quelle a più livelli. Applicate la validazione di schemi e regole in fase di ingestion, mettete in quarantena le violazioni, pulite e trasformate nei livelli bronze e silver, poi monitorate continuamente le tabelle gold per drift, freshness, completezza e anomalie statistiche (indicazioni Databricks a più livelli). Questa sequenza conta perché ogni livello risponde a una domanda diversa, e cercare di far fare tutte e tre le cose a un solo livello di solito crea troppi falsi positivi o troppi punti ciechi.
Scegliere tra strumenti in-database e piattaforme esterne
La decisione non riguarda quale strumento sia “il migliore”. Riguarda quale livello debba gestire ciascuno strumento, e dove volete che risiedano i dati mentre i controlli vengono eseguiti. Per i patrimoni di dati sensibili dal punto di vista della sicurezza, l'esecuzione in-database è spesso il primo filtro, perché spostare i dati all'esterno per il monitoraggio crea sia attriti di governance sia lavoro operativo aggiuntivo.
Approccio | Dove viene eseguito | Ideale per | Compromesso |
|---|---|---|---|
Deequ | All'interno dei job Spark | Controlli sui vincoli, profiling, logica di regole personalizzata | Ottimo per controlli ingegnerizzati, ma più codice e manutenzione a vostro carico |
Delta Expectations | All'interno delle pipeline DLT | Regole di qualità dichiarative in fase di trasformazione | Ottime per l'enforcement nelle pipeline, meno adatte all'observability sull'intero patrimonio dati |
Job Spark personalizzati | All'interno del calcolo Databricks | Logica di business su misura e casi limite | Massima flessibilità, massimo onere di engineering continuativo |
Piattaforma di observability esterna | All'interno dell'ambiente del cliente, integrata con Databricks | Monitoraggio multipiattaforma, apprendimento della baseline, flussi di governance unificati | Aggiunge un'altra piattaforma da gestire, ma può ridurre la taratura manuale delle soglie |
Deequ è una buona scelta quando volete esprimere i controlli nel codice e mantenerli vicino all'elaborazione Spark. Le Delta Expectations sono ancora più naturali quando le regole di qualità appartengono a una pipeline dichiarativa e devono bloccare o annotare l'output prima che la fase successiva lo utilizzi. I job Spark personalizzati restano importanti quando la vostra logica di business non rientra in un modello di regole standard, soprattutto per controlli di integrità con molte join o confronti tra tabelle.
Il limite di tutti e tre è la manutenzione. Più le regole sono specifiche, più tempo passate a curare le soglie, aggiornare la logica e inseguire casi limite in tutto il patrimonio dati. È qui che un livello di observability esterno dimostra il suo valore, soprattutto quando combina controlli deterministici con baseline apprese, invece di costringere i team a tarare le soglie a mano per sempre.
Un esempio pratico è una piattaforma che monitora all'interno dell'ambiente, mantiene i dati dove sono e aggiunge alerting e analisi dei trend su più sistemi. Ecco perché molti team valutano opzioni come l'esecuzione in-database della data quality per pipeline esterne più sicure e veloci insieme ai controlli nativi di Databricks: la questione riguarda in realtà il modello di esecuzione e l'adeguatezza alla governance.
Il compromesso non è solo tecnico, è operativo. I controlli nativi sono eccellenti per l'enforcement e il controllo locale. L'observability esterna è migliore quando servono una copertura ampia, un instradamento degli alert più ricco e una visione unificata del comportamento di warehouse, lake e pipeline, senza disseminare script personalizzati ovunque.
Le metriche chiave da monitorare su Databricks
Un buon programma di qualità su Databricks non inizia monitorando tutto. Inizia scegliendo famiglie di metriche allineate alle modalità di guasto più comuni: caricamenti in ritardo, righe mancanti, cambi di tipo silenziosi e regole di business che si rompono a valle. Se all'inizio potete strumentare solo poche cose, osservate i segnali che vi dicono se la tabella si comporta ancora come al solito.
Freshness e puntualità
La freshness vi dice se una tabella si aggiorna quando dovrebbe. La puntualità fa un passo in più, perché un feed può essere presente ma comunque abbastanza in ritardo da compromettere analytics, modelli o decisioni operative. Il modello di scansione in background di Databricks aiuta, perché Unity Catalog Data Quality Monitoring può continuare a controllare le tabelle senza pianificazione manuale (Databricks Lakehouse Monitoring).
Se la vostra tabella dei fatti notturna arriva dopo che gli utenti di business hanno iniziato a estrarre i report, la freshness non è più una metrica di ordinaria amministrazione. Diventa un rischio per i consumatori dei dati. Il monitoraggio della puntualità è ciò che vi dice che una tabella si sta discostando dal comportamento di arrivo atteso prima che gli stakeholder inizino a chiedere perché i numeri sembrano scarsi.
Completezza e conteggi
La completezza è la famiglia di metriche che intercetta record mancanti e caricamenti parziali. È anche il primo punto in cui i team scoprono che una sorgente ha cambiato comportamento senza preavviso, perché il numero di righe può calare anche mentre gli schemi sembrano ancora a posto. Il monitoraggio nativo di Databricks valuta direttamente la completezza, il che lo rende un solido primo livello per i controlli di salute a livello di tabella (Databricks Lakehouse Monitoring).
I conteggi delle righe contano perché sono semplici, facili da interpretare e spesso il primo segnale che una pipeline è sbagliata. Il trucco è non confondere “sono arrivate alcune righe” con “la tabella è completa”. Un caricamento parziale può sembrare sano a uno scheduler di job ed essere comunque inaccettabile per i consumatori downstream.
Anomalie statistiche e schema drift
Il monitoraggio statistico è ciò che intercetta i cambiamenti che superano la validazione ma non rientrano nel pattern abituale. Spostamenti della media, variazioni della varianza e derive dei quantili spesso compaiono prima che qualcuno noti l'impatto sul business. Ecco perché le funzionalità di profiling e di drift di Databricks contano: catturano sia sintesi distribuzionali sia variazioni da una finestra all'altra (documentazione Databricks sul monitoraggio della data quality).
Lo schema drift è altrettanto importante. Colonne aggiunte, colonne rimosse e cambi di tipo di dato possono rompere i consumatori, soprattutto quando i lettori sono tolleranti finché non lo sono più. Se vi è mai capitato che una modifica in un sistema sorgente passasse inosservata perché l'inferenza dello schema era troppo permissiva, sapete già perché questo appartiene al primo livello di monitoraggio.
Validazione delle regole di business
La validazione delle regole è il punto in cui la piattaforma deve riflettere il significato di business reale, non solo la forma tecnica. Databricks permette agli utenti di definire metriche personalizzate legate alla logica di business e di ricevere alert quando vengono rilevati problemi di qualità (gestione della data quality in Databricks). Questo conta per controlli come “i record dei clienti attivi non dovrebbero calare inaspettatamente” o “un flag critico non dovrebbe mai essere nullo”.
Se vi serve una regola decisionale rapida per le priorità, partite da qui:
Freshness: intercetta caricamenti in ritardo o mancanti prima che gli utenti si lamentino.
Completezza: intercetta ingestion parziali e troncamenti silenziosi.
Schema drift: intercetta presto le rotture strutturali.
Drift statistico: intercetta i cambiamenti di comportamento quando i dati sembrano ancora validi.
Regole di business: intercettano i guasti specifici del dominio che i controlli tecnici non vedono.
Per i team che desiderano un inventario di metriche più ampio, le metriche di data quality per Databricks sono un modo utile per tradurre queste famiglie in un piano di monitoraggio senza trattare ogni tabella allo stesso modo.
Alerting, lineage e flussi di remediation
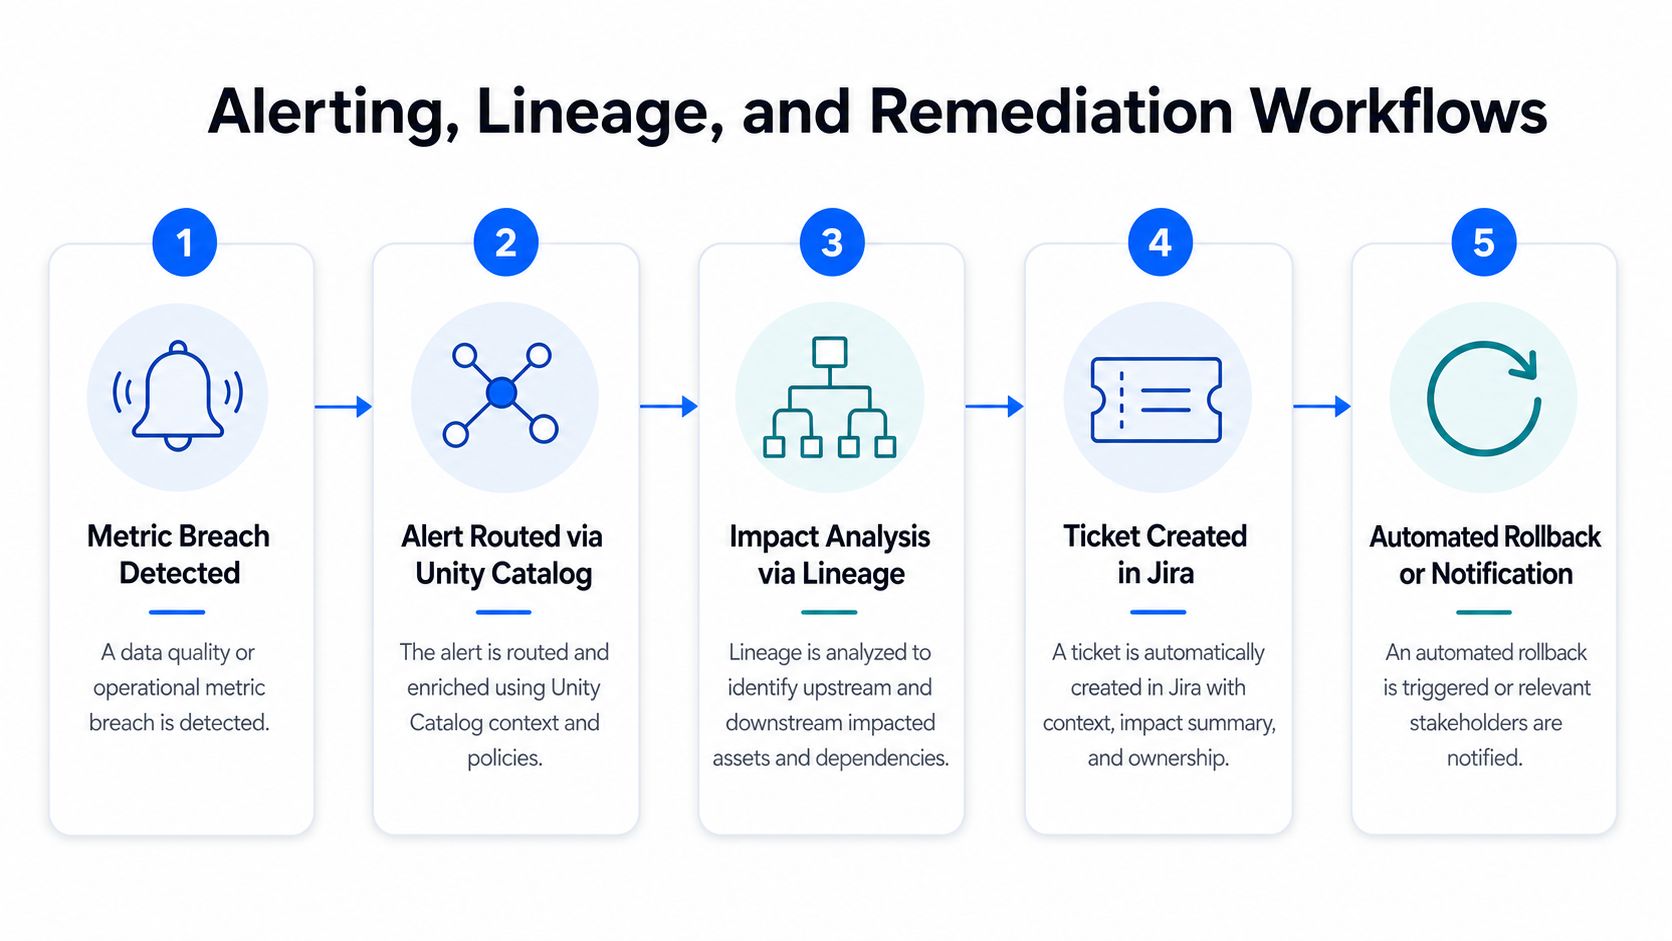
Le metriche sono utili solo se fanno scattare un'azione. In Databricks, il modello più efficace è collegare gli alert al lineage di Unity Catalog, così che l'ingegnere di turno possa vedere non solo che qualcosa si è rotto, ma anche quali tabelle, dashboard e consumatori downstream sono interessati. Questo trasforma l'incidente da un vago “problema di qualità” a un problema di dipendenze gestibile.

Databricks offre inoltre tre modalità native per gestire i dati errati a valle. Vincoli e validate permettono di fallire subito. La messa in quarantena dei dati isola i record errati prima che si diffondano. La segnalazione delle violazioni lascia passare i dati con un marcatore esplicito quando bloccare la pipeline sarebbe peggio che lasciar decidere al consumatore. Queste opzioni rendono la strategia di controllo molto più pratica di una rigida regola sì-o-no in ogni caso (gestione della data quality in Databricks).
La logica di instradamento deve seguire il contesto di business, non solo la ownership tecnica. Un calo inatteso dei record dei clienti attivi dovrebbe allertare il responsabile analytics che conosce il KPI. Un caricamento notturno mancante dovrebbe andare direttamente al data engineering, perché il percorso di remediation è operativo, non analitico. Se gestite ogni alert allo stesso modo, la coda si riempie di rumore e la persona giusta vede il problema troppo tardi.
Regola pratica: instradate gli incidenti in base all'impatto e alla ownership, non in base a quale job è fallito per primo.
È qui che anche ChatOps e ticketing ripagano. L'alert deve aprire un percorso di indagine, non essere solo una notifica. In pratica, ciò significa collegare gli alert consapevoli del lineage a qualunque strumento il team usi per gli incidenti e assicurarsi che l'esito della validazione sia visibile dove avviene l'analisi delle cause, non sepolto in un report separato.
Per i team attenti all'igiene operativa degli alert, i consigli di CleanMyList sulla reputazione del mittente ricordano bene che il volume degli alert e la disciplina nella loro consegna contano quanto la qualità del segnale. Lo stesso principio vale all'interno delle piattaforme dati: gli alert rumorosi vengono ignorati, e gli alert ignorati diventano costosi.
L'obiettivo operativo è semplice: ridurre il tempo medio di rilevamento e di remediation. Monitorare solo a livello di reportistica rallenta questo processo, perché lo scoprite dopo che il business ha già utilizzato i dati errati. Alert consapevoli del lineage e percorsi di gestione chiari anticipano la risposta nel ciclo di vita, dove le correzioni costano meno e il raggio d'impatto è più ridotto.
Aggiungere un livello di observability dedicato con digna
I controlli nativi di Databricks sono solidi, ma non sempre coprono l'intero patrimonio dati con la stessa profondità. È qui che può inserirsi un livello di observability dedicato, soprattutto quando servono copertura multipiattaforma, un apprendimento della baseline più ricco e un'unica vista operativa per ingegneri, analisti e responsabili della governance. In questo ruolo, digna per l'observability su Databricks è un'opzione da valutare, perché integra la piattaforma invece di cercare di sostituirla.
Abbinare il modulo al problema di monitoraggio
La corrispondenza più chiara è semplice. Data Anomalies si adatta all'apprendimento della baseline e all'anomaly detection continua. Data Validation gestisce le regole di business a livello di record. Timeliness monitora i pattern di arrivo e l'orario di consegna atteso. Schema Tracker sorveglia le modifiche strutturali. Data Analytics aiuta con trend, volatilità e analisi di observability più ampie.
Questa struttura modulare conta perché non tutti i team hanno bisogno di ogni funzionalità fin dal primo giorno. Una piattaforma può partire con un modulo ed espandersi man mano che il patrimonio dati matura, il che è molto più semplice che imporre un rollout ampio prima che il team abbia stabilizzato le proprie soglie di alert. Il punto è coprire la modalità di guasto che avete davvero, non quella che fa più bella figura in una demo di prodotto.
Mantenere i dati all'interno dell'ambiente
Il modello di deployment è il motivo principale per cui i team lo prendono seriamente in considerazione. digna viene eseguito all'interno del cloud, della VPC o del data center del cliente, e i controlli vengono eseguiti in-database, così i dati non lasciano l'ambiente. Questo lo rende un'opzione pratica quando revisioni di sicurezza, governance o requisiti di residenza dei dati renderebbero scomodo un flusso SaaS esterno.
Ciò non lo rende un sostituto dei controlli nativi di Databricks. Le expectations di DLT restano nelle pipeline di trasformazione, e il monitoraggio di Unity Catalog resta sulle tabelle curate. Un livello di observability come digna si colloca sopra queste fondamenta e vi offre un rilevamento dei pattern più ampio, un supporto aggiuntivo ai flussi di lavoro e un unico livello di dashboard senza spostare i dati sottostanti.
Usarlo come livello aggiuntivo, non come sostituto
I programmi più solidi che ho visto mantengono un'architettura a più livelli. L'enforcement nativo ferma i difetti evidenti. Il monitoraggio nativo sorveglia le tabelle curate. Un livello di observability dedicato aggiunge una vista multipiattaforma, ulteriore anomaly detection e flussi di lavoro compatibili con la governance per i team che hanno bisogno di qualcosa di più dei controlli di salute a livello di tabella.
Questa suddivisione è particolarmente utile quando il patrimonio dati include più di un motore o più di un team con definizioni diverse di “sano”. In pratica, il livello di observability diventa il luogo in cui operatori della piattaforma, analytics engineer e responsabili della governance condividono lo stesso quadro degli incidenti, senza che ciascuno costruisca un proprio piano di controllo separato.
Una checklist iniziale per il vostro programma di qualità su Databricks
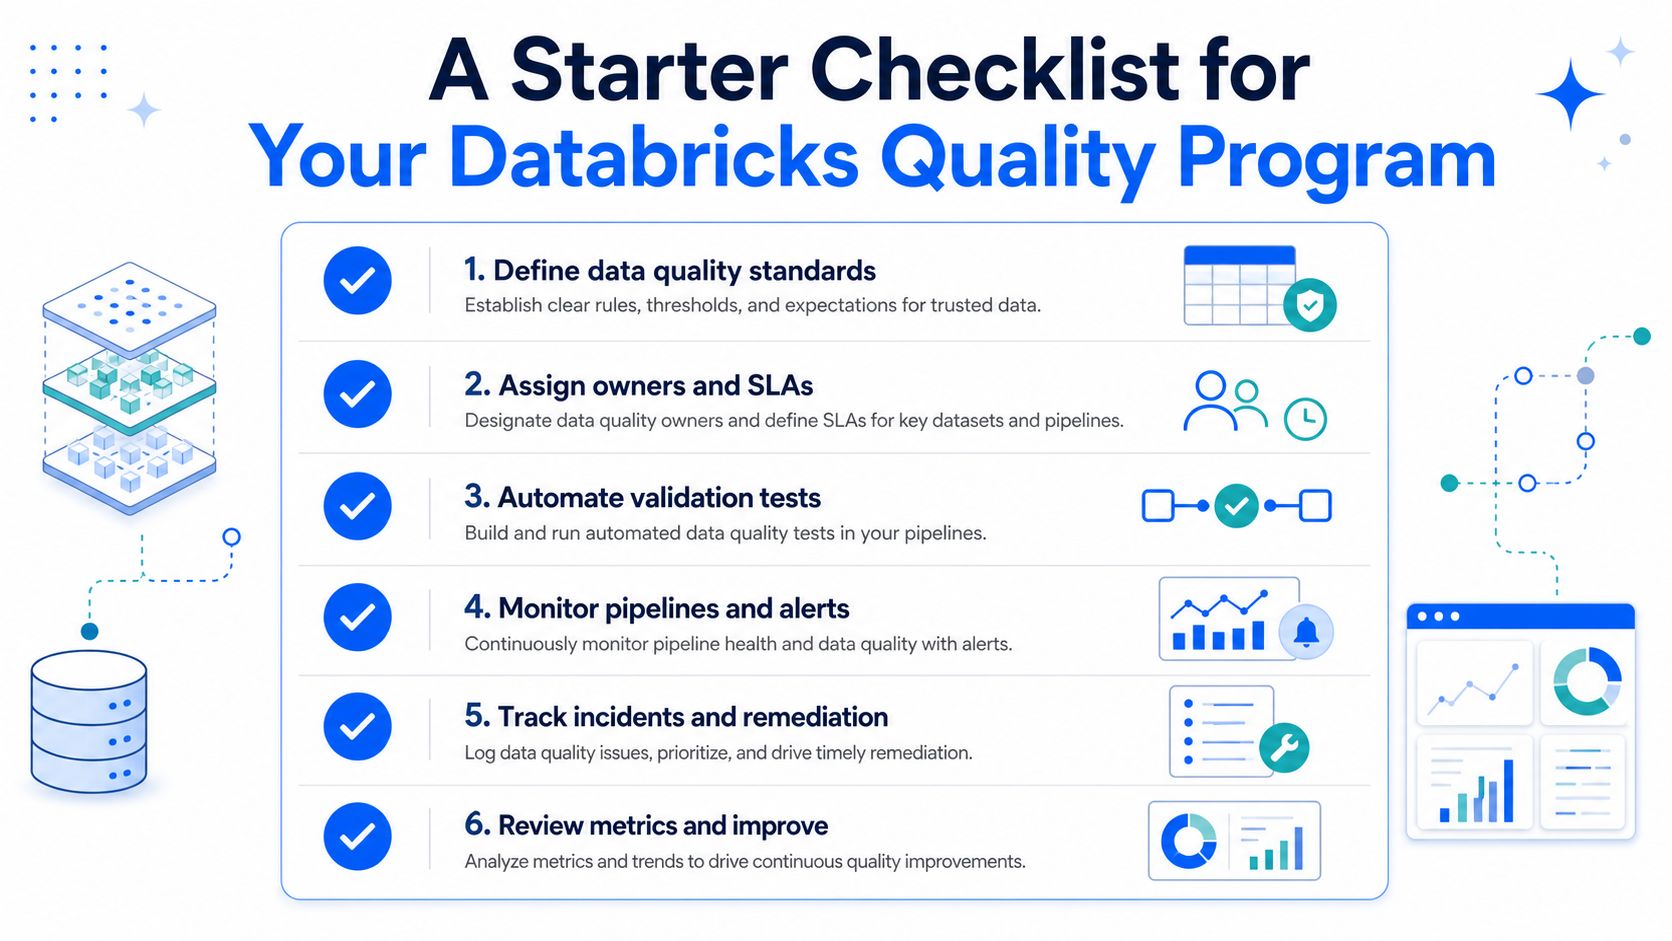
Un programma Databricks utilizzabile parte da una checklist ristretta e cresce da lì. Il primo errore è cercare di monitorare ogni tabella allo stesso modo. La mossa migliore è stratificare i controlli per fase e assegnare la ownership dove i dati cambiano.
Strumentate prima i livelli nativi: attivate il monitoraggio di Unity Catalog per freshness e completezza, definite le expectations di DLT dove le trasformazioni devono applicare regole e aggiungete vincoli Delta per la protezione in fase di scrittura.
Definite l'insieme minimo di metriche per livello: freshness e completezza per le tabelle curate, schema drift per i feed critici e controlli sulle regole di business per le tabelle che alimentano finance, operations o modelli.
Collegate gli alert a flussi di lavoro consapevoli del lineage: assicuratevi che gli incidenti indichino gli asset upstream e downstream interessati, così che chi interviene non debba andare a caccia del raggio d'impatto.
Aggiungete un livello di observability dove finisce la copertura nativa: usate una piattaforma all'interno dell'ambiente quando vi servono visibilità multipiattaforma, un apprendimento della baseline più ricco o una dashboard condivisa per più stakeholder.
Assegnate una ownership chiara: il data engineering è responsabile dei guasti delle pipeline, gli analytics dell'interpretazione dei KPI e la governance delle policy e dei percorsi di escalation.
Il modello che regge non è una configurazione una tantum. È un sistema operativo fatto di controlli in fase di scrittura, expectations in fase di pipeline e monitoraggio continuo, il tutto allineato al modo in cui i vostri dati vengono utilizzati. Se state pianificando la prossima fase del vostro programma di qualità su Databricks, iniziate scegliendo le tabelle più importanti, poi costruite attorno a esse i controlli a più livelli.
Se volete che il monitoraggio della qualità su Databricks regga in produzione, digna è progettato per essere eseguito all'interno del vostro ambiente, sorvegliare le anomalie, validare i record, monitorare la puntualità e far emergere le modifiche agli schemi senza spostare i dati. Visitate digna per scoprire come un livello di observability all'interno dell'ambiente può affiancare i vostri controlli Databricks e aiutare il vostro team a passare da controlli reattivi a una fiducia continua nei dati.
Scoprite come digna lo fa in pratica: data quality su Databricks.
Domande frequenti
Quali strumenti nativi offre Databricks per il monitoraggio della data quality?
Databricks offre tre livelli di controllo più una superficie di monitoraggio. I vincoli di Delta Lake e validate applicano le regole in fase di scrittura, le expectations di Delta Live Tables eseguono controlli dichiarativi durante le pipeline e Unity Catalog Data Quality Monitoring sorveglia continuamente le tabelle. Le system table e Lakehouse Monitoring aggiungono profiling, rilevamento delle derive e contesto operativo.
Quali metriche raccoglie il profiling di Databricks?
Il profiling registra valori nulli, zeri, conteggi, medie, valori minimi e massimi, deviazione standard e fino a 1.000 quantili per colonna. Le metriche di drift confrontano ogni finestra con una baseline o con la finestra precedente. Le system table mostrano anche l'impatto downstream, come le 120 query sulle tabelle interessate in 30 giorni dell'esempio della documentazione.
Quali metriche di data quality conviene monitorare per prime su Databricks?
Partite da cinque famiglie di metriche legate ai guasti più comuni. La freshness intercetta caricamenti in ritardo o mancanti, la completezza ingestion parziali e troncamenti silenziosi, lo schema drift le rotture strutturali, il drift statistico i cambiamenti di comportamento in dati apparentemente validi e le regole di business i guasti di dominio, come un flag critico che diventa nullo.
Come vanno gestiti i dati errati in una pipeline Databricks?
Databricks offre tre opzioni native. Vincoli e validate permettono di fallire subito, la quarantena isola i record errati prima che si diffondano e la segnalazione lascia passare i dati con un marcatore esplicito quando bloccare la pipeline causerebbe più danni. Collegate gli alert risultanti al lineage di Unity Catalog, così chi è di turno vede le tabelle e le dashboard downstream interessate.
Quando ha senso affiancare a Databricks una piattaforma di observability esterna?
È utile quando i controlli nativi diventano un onere di manutenzione su un patrimonio dati esteso. Deequ, expectations di DLT e job Spark personalizzati richiedono soglie tarate a mano e manutenzione del codice, mentre un livello esterno eseguito nell'ambiente del cliente aggiunge baseline apprese, monitoraggio multipiattaforma e un instradamento degli alert più ricco. Funziona come livello aggiuntivo, non come sostituto.


