Migrazione dei dati da sistemi legacy: il playbook 2026
|
7
min di lettura

Circa l'83% dei progetti di migrazione dei dati fallisce del tutto oppure supera il budget e le tempistiche iniziali. Questo dato cambia la prospettiva. La migrazione dei dati da sistemi legacy non è un'attività di riordino di back-office. È un intervento di ingegneria ad alto rischio, in cui scarsa visibilità, validazione manuale e ipotesi non documentate possono trasformare un aggiornamento pianificato in un incidente di produzione.
I team che la portano a termine senza problemi non si affidano all'ottimismo. Integrano l'osservabilità nella migrazione stessa. Stabiliscono una baseline del comportamento della sorgente prima dell'estrazione, tracciano le modifiche allo schema mentre i mapping evolvono, validano i record in modo continuo e trattano il cutover come un'operazione controllata, non come un salto nel buio di una notte.
Indice
Colmare il divario: data mapping e riconciliazione degli schemi
Il motore della migrazione: estrazione, trasformazione e ingestione
Dalla speranza alla prova: automatizzare validazione e monitoraggio
La spinta finale: cutover, rollback e successo post-migrazione
Perché la maggior parte delle migrazioni da sistemi legacy fallisce e come evitare che fallisca la vostra
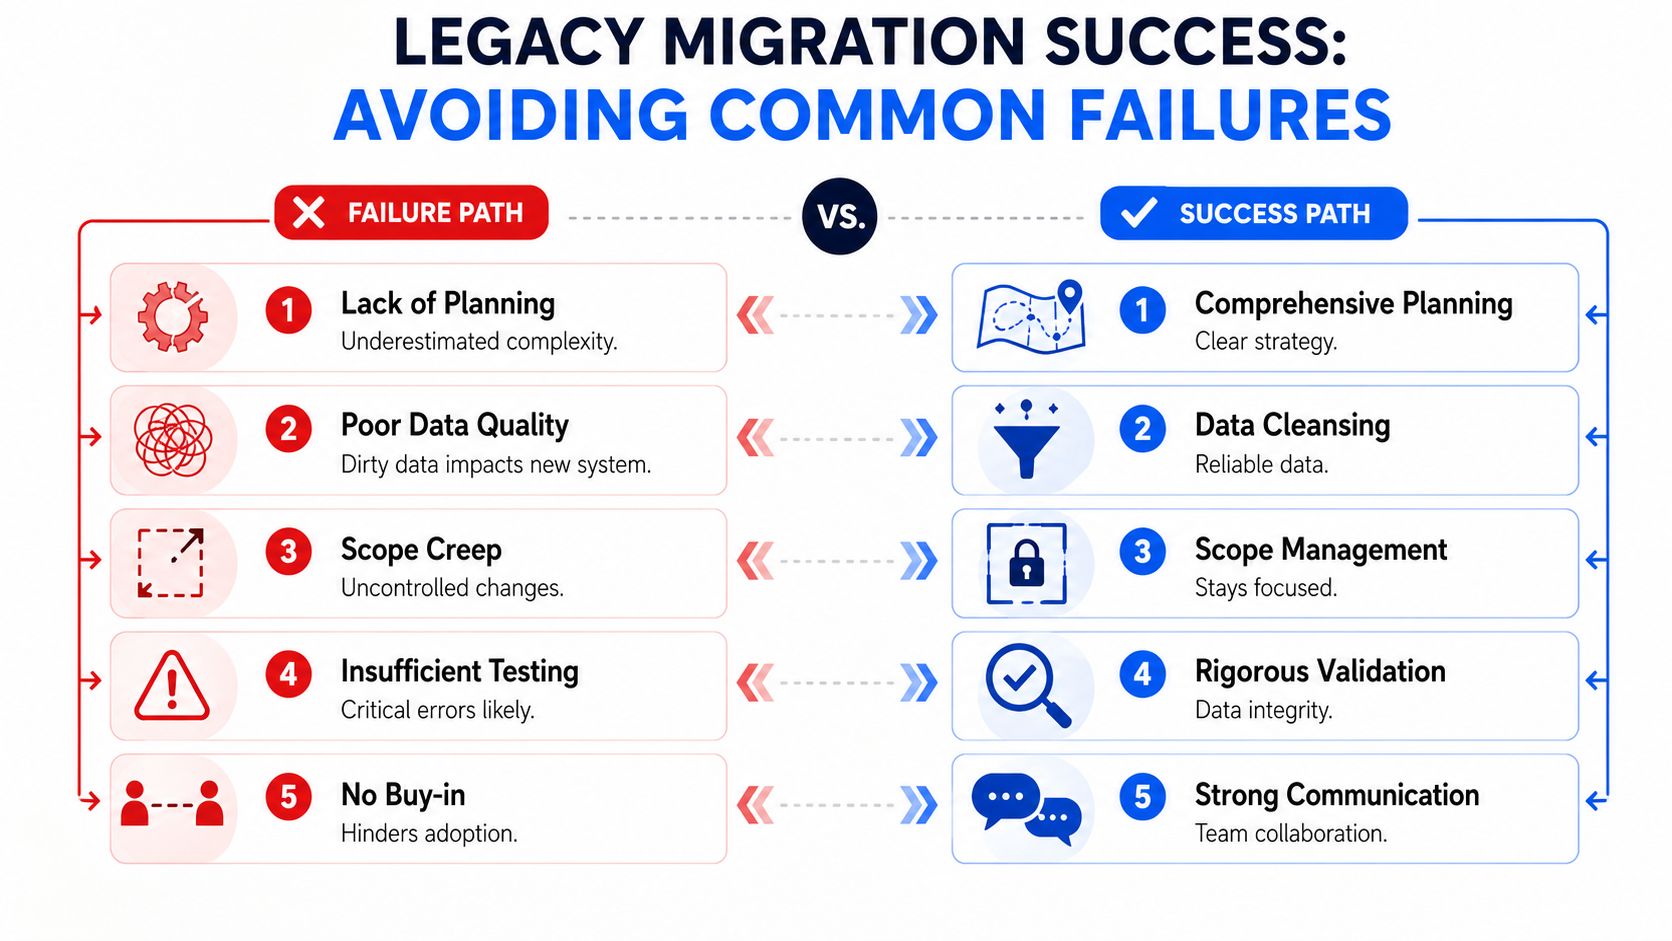
Le migrazioni legacy falliscono molto prima del cutover. Falliscono quando i team trattano la migrazione come un trasferimento una tantum anziché come un programma controllato di discovery, validazione e verifica.
Lo schema è ben noto nei programmi ad alto rischio: l'ETL gira, il numero di righe sembra abbastanza vicino e la fiducia regge finché il sistema di destinazione non inizia a rifiutare record, i report finanziari non quadrano più o un flusso di lavoro di business dipende da un campo che nessuno ha mappato correttamente. Il lavoro di ingegneria raramente è il problema principale. Lo è la visibilità tardiva.
Che cosa va storto di solito
I team spesso sottovalutano quanta logica nascosta si trovi al di fuori del percorso applicativo documentato. Una formula in un report, un export notturno o uno script di gestione delle eccezioni possono contenere regole di business mai entrate nelle specifiche formali. Quando la piattaforma di destinazione applica tipi, vincoli o regole referenziali più rigorosi, queste omissioni si trasformano in caricamenti falliti e processi a valle interrotti.
Tre modalità di fallimento si ripresentano di continuo:
La discovery si ferma allo schema: gli inventari delle tabelle non colgono la logica dei report, i workaround operativi e le dipendenze non documentate.
La validazione è trattata come una fase finale: quando i team cercano i difetti dopo il caricamento, il costo di rilavorazione e rollback è molto più alto.
La responsabilità è frammentata: infrastruttura, application owner, analisti e stakeholder di business validano ciascuno una parte del trasferimento, ma nessuno è responsabile dell'integrità della migrazione end-to-end.
Il controllo manuale peggiora le cose. Campionare qualche record in SQL può confermare che alcune righe sono sopravvissute al viaggio. Non può dirvi se le trasformazioni hanno preservato il significato di business su milioni di record, se sorgente e destinazione si sono disallineate durante una lunga finestra di migrazione o se una modifica a una regola ha introdotto una corruzione silenziosa.
Regola pratica: se la prima validazione seria avviene dopo il caricamento, la migrazione è già in ritardo.
L'approccio più sicuro è integrare l'osservabilità nella migrazione stessa. digna cambia qui il modello operativo. Invece di affidarsi a fogli di calcolo e riconciliazioni ad hoc, i team possono profilare i dati sorgente fin dall'inizio, definire controlli automatici prima che le trasformazioni vengano eseguite e monitorare numero di righe, pattern di valori nulli, modifiche allo schema, freschezza dei dati e violazioni delle regole durante estrazione, trasformazione e ingestione. In questo modo la migrazione passa da un esercizio manuale basato sulla fiducia a un sistema osservabile con gate misurabili.
Questo conta soprattutto nei trasferimenti business-critical, in cui il database è solo una parte del rischio. Per le transizioni ERP e contabili, gli approfondimenti di Receipt Router sulle transizioni finanziarie sono utili perché mostrano come i cambi di sistema incidano su riconciliazioni, flussi documentali e operazioni finanziarie dopo l'arrivo dei dati.
La buona notizia è che i fallimenti delle migrazioni sono di solito prevedibili. Difetti nascosti, schemi non corrispondenti, piani di rollback deboli e test tardivi emergono negli stessi punti in tutti i progetti. I team che cercano un riferimento pratico possono consultare queste insidie comuni della migrazione e relative soluzioni, quindi usare l'osservabilità continua per individuare questi problemi prima del cutover anziché doverli spiegare dopo l'impatto in produzione.
Mappare il vecchio mondo: assessment e discovery
La discovery è la fase in cui i team si guadagnano una migrazione senza intoppi oppure ereditano mesi di rilavorazioni evitabili. Gli ambienti legacy raramente corrispondono alla loro documentazione. La fonte di verità è di solito distribuita tra schemi di database, job batch, logica dei report, file depositati e la memoria dell'unica persona che supporta il sistema da anni.
Iniziate con l'archeologia dei dati
Il primo passaggio deve rispondere a domande basilari ma tutt'altro che banali:
Quali dataset sono critici dal punto di vista operativo?
Quali tabelle sono archivi storici che possono essere dismessi o compressi?
Quali file o export aggirano il percorso applicativo ufficiale?
Quali campi alimentano report, riconciliazioni o processi di compliance?
Un dump dello schema da solo non risponde a queste domande. Gli ingegneri hanno bisogno del contesto dei carichi di lavoro. Osservate i pattern di aggiornamento, le colonne piene di valori nulli, le chiavi duplicate, le vecchie partizioni e i campi che sembrano inattivi ma alimentano le riconciliazioni mensili. Nella pratica, “inutilizzato” spesso significa “usato da un processo doloroso che nessuno vuole toccare”.
Il sistema legacy contiene sempre più logica di business di quanta ne ammetta il team applicativo e più eccezioni di quante ne preveda il team del database.
Costruite una baseline prima di spostare qualsiasi cosa
Una buona discovery non si ferma all'inventario. Misura il comportamento. Rilevate il numero di righe per tabella nella sorgente, i pattern di freschezza dei dati, le distribuzioni di valori più comuni e i casi limite noti. Se un campo di stato cliente contiene valori strani o una colonna di date mescola formati diversi, questo deve entrare presto nel contratto di migrazione.
L'osservabilità automatizzata cambia la qualità della pianificazione. Invece di documentare ipotesi in fogli statici, i team possono stabilire una baseline del comportamento dei dati sorgente nel tempo. Così la validazione successiva diventa concreta anziché soggettiva.
Un backlog di assessment pratico include di solito:
Profilazione dei volumi: individuate tabelle grandi, partizioni sbilanciate e punti di crescita che influiranno sulle finestre di estrazione.
Verifica della completezza: controllate sparsità, chiavi mancanti e campi obbligatori mai imposti nella vecchia piattaforma.
Pattern di freschezza: scoprite quando arrivano i dati, quali feed sono in ritardo e quali dataset si comportano diversamente a chiusura di periodo.
Tracciamento delle dipendenze: mappate report, interfacce e job che dipendono da tabelle o output di file specifici.
Raccolta delle eccezioni: documentate le convenzioni sui valori nulli, i valori segnaposto, i caratteri speciali e le gestioni insolite delle date.
Definite gli obiettivi di validazione subito, non dopo
Il motivo più forte per prendere sul serio la discovery è che il processo di migrazione richiede più livelli di validazione, tra cui corrispondenza del numero di righe, checksum per l'integrità, controlli a campione e validazione delle regole di business, e tutti dipendono da un assessment iniziale approfondito per essere definiti, come descritto nelle linee guida sulla migrazione di RecordPoint.
Se durante la discovery non avete identificato quali regole di business contano, non potrete validarle sotto pressione durante il cutover.
Uno strumento di lavoro utile è una breve tabella decisionale:
Risultato della discovery | Implicazione per la migrazione |
|---|---|
Formati di data misti | Aggiungere trasformazioni esplicite e test di parsing |
Chiavi di business duplicate | Definire regole di survivorship o deduplicazione |
Export di file non tracciati | Includere test paralleli delle interfacce |
Feed sorgente in arrivo in ritardo | Adeguare le tempistiche di estrazione e la sequenza di cutover |
È a questo punto che l'assessment diventa ingegneria. Non state più raccogliendo fatti. State riducendo le incognite che altrimenti emergerebbero in produzione.
Colmare il divario: data mapping e riconciliazione degli schemi
Il mapping non è un lavoro d'ufficio. È una traduzione tra due sistemi che spesso usano le stesse etichette per indicare cose diverse ed etichette diverse per indicare la stessa cosa. Le migrazioni legacy vanno storte qui perché i team confondono l'allineamento dei campi con l'allineamento semantico.

Costruite un vero data dictionary
Un dizionario di migrazione utilizzabile richiede più dei nomi delle colonne sorgente e destinazione. Deve riportare tipo di dato, nullabilità, comportamento predefinito, logica di trasformazione, valori ammessi e team responsabile. Se un campo sorgente memorizza identificativi numerici come testo con zeri a sinistra, questo dettaglio non può restare nel taccuino di qualcuno.
Ho visto team perdere giorni perché un campo chiamato “status” era stato trattato come un semplice enum, mentre l'applicazione legacy lo aveva sovraccaricato per codificare la fase del workflow, lo stato di eccezione e l'override manuale. La mappa sembrava finita. La logica di migrazione no.
Un foglio di mapping rigoroso deve rispondere a queste domande:
A che cosa serve davvero il campo?
Quali valori compaiono nella pratica, non solo nella documentazione?
Quale regola di trasformazione si applica?
Che cosa succede quando la sorgente viola il vincolo della destinazione?
Risolvete direttamente le incongruenze strutturali
Alcuni problemi di traduzione sono di routine. Altri sono sottili.
Condizione nella sorgente | Sfida nella destinazione | Risposta comune |
|---|---|---|
Campo di testo che memorizza numeri | Tipo numerico rigoroso | Pulire, convertire e mettere in quarantena le righe non valide |
Categorie a testo libero | Vocabolario controllato | Standardizzare con regole di mapping esplicite |
Più convenzioni per le date | Un unico parser di date | Normalizzare a monte e testare i valori limite |
Colonne riutilizzate con significato variabile | Modello analitico stabile | Suddividere in campi di destinazione separati |
I casi pericolosi sono quelli che superano il caricamento iniziale ma corrompono la logica a valle. Un errore di conversione da stringa a intero è evidente. Un troncamento silenzioso, uno spostamento di fuso orario o una tabella di codici riutilizzata sono peggio, perché possono sopravvivere abbastanza a lungo da avvelenare report e riconciliazioni.
Lezione dal campo: se una regola di mapping ha bisogno di una nota a piè di pagina, probabilmente ha bisogno di un caso di test e di un responsabile.
Sostituite i fogli di calcolo disallineati con il rilevamento tracciato delle modifiche
Gli esercizi di mapping manuale hanno un punto debole intrinseco. Congelano la struttura in un documento mentre i sistemi sorgente e destinazione reali continuano a cambiare. Durante una lunga migrazione vengono aggiunte colonne, cambiano i tipi di dato e i team di integrazione aggiornano i contratti della destinazione. Se nessuno coglie rapidamente questi cambiamenti, la logica di migrazione si allontana dalla realtà.
Questo rischio è ben documentato. Il tracciamento dello schema durante la migrazione segnala modifiche strutturali come l'aggiunta o la rimozione di colonne e le modifiche ai tipi di dato, che spesso sfuggono negli esercizi di mapping manuale e provocano errori ETL a valle, come osservato nella trattazione di MindBridge sulle tecniche di anomaly detection e sull'integrità dei dati.
Riconciliate il significato di business, non solo la struttura
Il lavoro di mapping più difficile di solito non ha nulla a che fare con i tipi SQL. Risiede nella logica di business:
Un conto “chiuso” nel sistema legacy può includere conti sospesi che la nuova piattaforma tratta separatamente.
I record storici possono usare codici dismessi anni fa ma ancora presenti nei dati archiviati.
I valori predefiniti possono essere stati generati dall'applicazione nel vecchio sistema e ora devono essere resi espliciti.
I team di migrazione hanno bisogno di sessioni di lavoro con i responsabili di operations, finanza, compliance e reporting. Non per la strategia generale. Per le decisioni. Quali valori sono validi, quali vanno rimappati, quali vanno archiviati e quali devono bloccare il caricamento.
Un documento di mapping diventa affidabile solo quando ogni campo ambiguo ha una regola, ogni regola ha una motivazione e ogni motivazione ha un responsabile.
Il motore della migrazione: estrazione, trasformazione e ingestione
Una volta compresa la sorgente e stabilizzati i mapping, l'architettura inizia a contare più della teoria. Il motore della migrazione ha un solo compito: spostare i dati in modo prevedibile entro vincoli operativi reali. Ciò significa estrazione controllata, trasformazione deterministica e pattern di ingestione adeguati alla tolleranza del business verso downtime e rischio.
Cutover big bang o graduale
La decisione progettuale più importante riguarda di solito il pattern di cutover. Entrambe le opzioni funzionano. Entrambe falliscono se scelte per le ragioni sbagliate.
Una migrazione big bang concentra il passaggio in un unico evento. È interessante quando la complessità delle interfacce è bassa, le finestre di modifica sono fisse e il business vuole un taglio netto. Il compromesso è la concentrazione del rischio. Se una dipendenza si comporta diversamente in produzione, avete poco margine per assorbire la sorpresa.
Una migrazione graduale o a flusso continuo riduce il raggio d'impatto spostando domini, entità o intervalli di dati in modo incrementale. Offre ai team più margine per confrontare gli output tra i sistemi e gestire le eccezioni in lotti gestibili. Il prezzo è la complessità operativa. Logica di doppia esecuzione, oneri di riconciliazione e workaround temporanei nei processi possono sfinire i team se il piano si trascina.
Una semplice vista decisionale aiuta:
Pattern | Funziona meglio quando | Attenzione a |
|---|---|---|
Big bang | Il grafo delle dipendenze è compatto e un breve fermo è accettabile | Pressione concentrata sul rollback |
Graduale | I confini dei domini sono chiari e il business tollera la coesistenza | Onere di riconciliazione prolungato |
L'estrazione deve proteggere la sorgente
Le piattaforme legacy sono spesso fragili. Una logica di estrazione che sembra innocua in test può saturare l'I/O, bloccare tabelle o disturbare i job notturni in produzione. La progettazione dell'estrazione conta. Usate finestre delimitate, ordinamenti prevedibili e job riavviabili. Se avete bisogno della change capture, assicuratevi di capire che cosa conta come modifica reale in quel sistema invece di dare per scontato che un timestamp sia affidabile.
Anche la logica di trasformazione deve essere esplicita e testabile. Evitate di nascondere le regole all'interno di un enorme script di pipeline. Suddividetele in fasi con un nome, in modo che gli ingegneri possano isolare gli errori e rieseguire segmenti specifici senza ripetere l'intera esecuzione.
Progettate per retry, quarantena e verificabilità
Le pipeline di migrazione hanno bisogno di meccanismi operativi che i team ETL tradizionali a volte lasciano impliciti:
Progettazione dei retry: i retry devono essere sicuri e idempotenti. Se un batch viene rieseguito, la destinazione non deve duplicare né sovrascrivere parzialmente i record.
Quarantena degli errori: i record errati hanno bisogno di un percorso di attesa con metadati sufficienti per il triage. Non seppelliteli in log generici.
Logging strutturato: ogni evento di estrazione, trasformazione e caricamento deve produrre evidenze che gli ingegneri possano tracciare per dataset e batch.
Regole di ordinamento: i caricamenti padre-figlio, le dipendenze dai dati di riferimento e le correzioni in arrivo tardivo richiedono una sequenza documentata.
Negli ambienti ricchi di documenti, la stessa disciplina vale anche oltre le tabelle. I team che modernizzano archivi di file, documenti scansionati o documenti operativi possono trarre spunto da come la gestione documentale trasforma il business, soprattutto quando la coerenza dei metadati e i pattern di recupero contano quanto il trasferimento grezzo.
Scegliete ETL o ELT in base ai punti di controllo
La scelta tra ETL ed ELT non è ideologica. Riguarda dove volete collocare il controllo delle trasformazioni e la visibilità sugli errori.
Usate l'ETL quando la pulizia della sorgente è consistente, la destinazione ha vincoli di caricamento rigorosi o una logica di trasformazione sensibile deve essere risolta prima che i dati arrivino. Usate l'ELT quando il data warehouse di destinazione è abbastanza potente da assorbire caricamenti grezzi e volete opzioni più ricche di replay e audit all'interno della piattaforma di destinazione.
La scelta sbagliata di solito si rivela in fretta. Se il vostro team continua a esportare dati per un'ispezione manuale perché il comportamento della pipeline non è abbastanza osservabile, alla progettazione del motore mancano i cicli di feedback operativo. Non è solo una questione di strumenti. È una questione architetturale.
Dalla speranza alla prova: automatizzare validazione e monitoraggio
La validazione manuale crea una falsa fiducia. Un team controlla qualche conteggio di righe, verifica a campione una manciata di record, confronta un report e dichiara pulito il batch. Questo metodo può individuare rotture evidenti. Non può dimostrare l'integrità della migrazione su dataset complessi con pattern variabili e regole di business rigorose.

La validazione deve diventare continua
Il cambiamento pratico è semplice. Smettete di trattare la validazione come un checkpoint dopo lo spostamento e iniziate a trattarla come un sistema di controllo durante lo spostamento.
Ciò significa controllare più livelli in parallelo:
Integrità dei record: i campi obbligatori sono presenti, trasformati correttamente e validi rispetto alle regole di business?
Completezza del dataset: i conteggi di sorgente e destinazione si riconciliano alla giusta granularità?
Stabilità strutturale: è cambiato qualcosa nello schema o nel contratto durante l'esecuzione?
Salute operativa: i batch arrivano quando previsto o la pipeline sta scivolando verso il ritardo?
Questo approccio è in linea con una disciplina di migrazione consolidata. Staging dedicato, validazione iterativa, corrispondenza del numero di righe, controlli di integrità, verifica delle regole di business e monitoraggio in tempo reale appartengono tutti al modello operativo, non a un ciclo di test una tantum.
L'anomaly detection individua ciò che le soglie statiche non vedono
Uno dei motivi per cui il monitoraggio delle migrazioni spesso delude è che i team codificano controlli semplicistici. Generano un alert se il volume di righe scende sotto una soglia fissa o se un job supera una stima approssimativa del tempo di esecuzione. Questi controlli sono meglio di niente, ma non colgono le anomalie contestuali.
L'anomaly detection basata sull'AI si affida ad algoritmi di apprendimento non supervisionato per apprendere automaticamente il comportamento normale dei dati, inclusi stagionalità e trend, senza manutenzione manuale delle regole, adattando dinamicamente le soglie al cambiare degli ambienti, secondo la spiegazione di digna sulle tecniche di anomaly detection basate sull'AI.
Questo è importante nella migrazione perché il “normale” raramente è piatto. Picchi di fine mese, job a monte in ritardo e pattern legati al ciclo di business possono rendere gli alert statici rumorosi o ciechi. I modelli non supervisionati possono apprendere questi pattern e segnalare deviazioni come volumi di traffico inattesi, spostamenti temporali o distribuzioni di valori che nessuno ha codificato a mano.
I controlli manuali a campione rispondono alla domanda “questo campione sembrava a posto?”. L'osservabilità automatizzata risponde alla domanda “il sistema si è comportato entro i limiti previsti per l'intera esecuzione?”
Le regole a livello di record contano ancora
L'anomaly detection è potente, ma non sostituisce la validazione esplicita. Servono comunque controlli deterministici per i campi business-critical. Gli identificativi cliente devono essere conformi alle regole della destinazione. I mapping contabili devono finire su conti validi. Le date di decorrenza devono essere interpretate correttamente e rispettare i vincoli della destinazione.
Un pattern efficace combina il monitoraggio basato sull'apprendimento con l'applicazione di regole. Una piattaforma di questa categoria è digna, che supporta anomaly detection, tracciamento dello schema, monitoraggio della tempestività e validazione a livello di record, eseguendo l'analisi all'interno di ambienti controllati dal cliente. Se state progettando i controlli di validazione per una migrazione in corso, questa guida sulle best practice per la validazione dei dati durante le migrazioni è un riferimento pratico.
La visibilità cambia il comportamento degli stakeholder
Il valore ingegneristico è evidente, ma il valore operativo conta altrettanto. Quando la telemetria della migrazione è visibile in un'unica dashboard, le conversazioni migliorano. Invece di “pensiamo che il batch tre sia finito”, il team può vedere in un unico posto record elaborati, tassi di errore, modifiche allo schema e latenza della pipeline.
Il video qui sotto mostra il tipo di esperienza di prodotto che oggi i team si aspettano dagli strumenti di osservabilità durante le operazioni sui dati.
Questa visibilità rende anche più efficace l'escalation. I responsabili di business non hanno bisogno di log grezzi. Hanno bisogno della prova che i domini di dati critici hanno superato i controlli definiti e che le eccezioni sono isolate, comprese e corrette oppure bloccate prima del rilascio.
Monitorare la tempestività fa parte dell'integrità
Una migrazione può essere accurata e fallire comunque sul piano operativo se i dati arrivano così in ritardo da compromettere reporting, riconciliazioni o processi di servizio a valle. La tempestività deve essere monitorata come dimensione a sé, non trattata come effetto collaterale di un caricamento riuscito.
Un setup di monitoraggio maturo osserva i pattern di arrivo attesi, i ritardi di elaborazione e la coerenza del completamento per feed o dominio. Ciò è particolarmente importante nelle migrazioni graduali, in cui le doppie pipeline temporanee creano più occasioni di deriva temporale.
La fiducia nasce dalle evidenze. In una migrazione dei dati da sistemi legacy ad alto rischio, queste evidenze devono essere continue, spiegabili e visibili prima che inizi la riunione di cutover.
La spinta finale: cutover, rollback e successo post-migrazione
Il cutover è il momento in cui la pianificazione diventa operatività. I team spesso si concentrano così tanto su estrazione e trasformazione che il passaggio finale viene trattato come un esercizio di calendario. Non lo è. È un evento di modifica controllato con conseguenze tecniche, di business e di governance che si verificano contemporaneamente.
Preparate il cutover come un piano di risposta agli incidenti
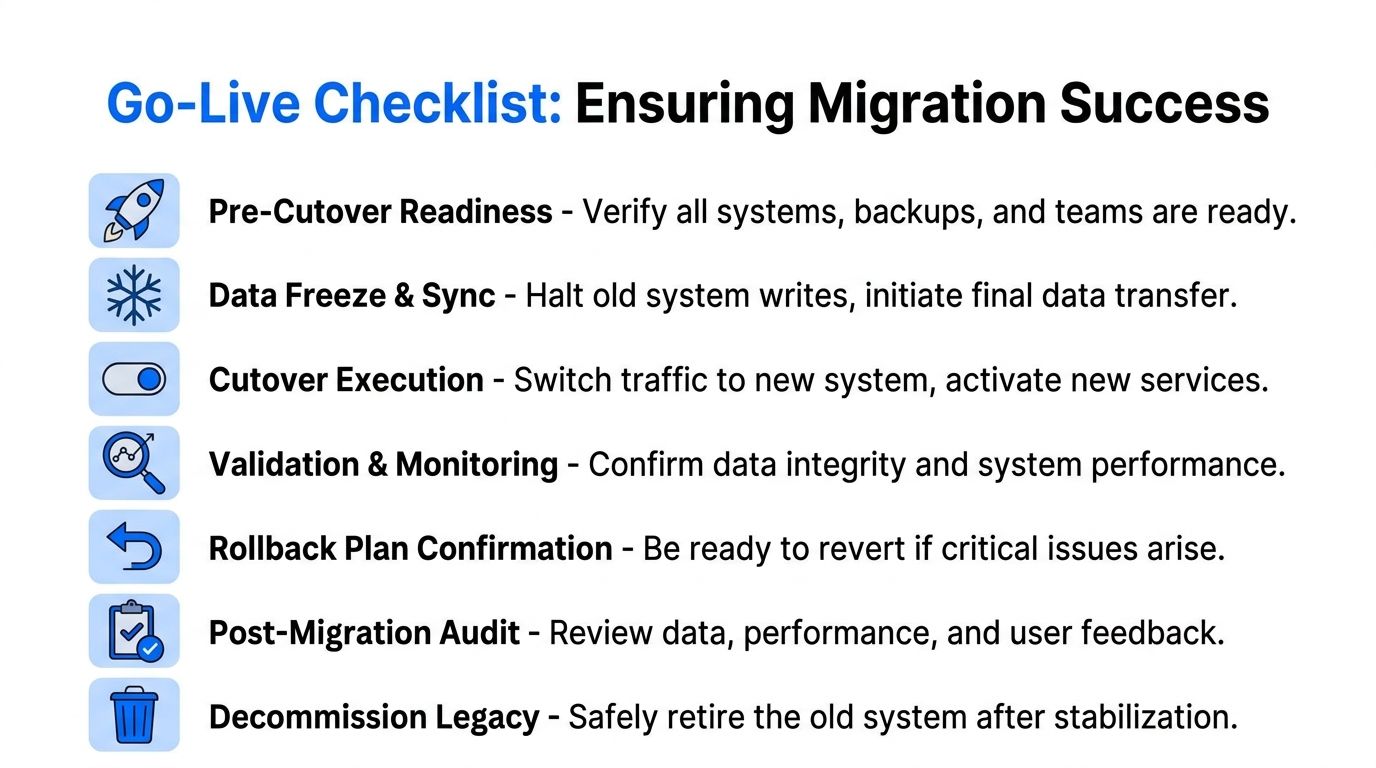
I migliori piani di cutover sono abbastanza specifici da poter essere eseguiti sotto stress da un altro ingegnere. Definiscono tempistiche di freeze, responsabilità, canali di comunicazione, criteri di approvazione e il momento esatto in cui il traffico passa alla nuova piattaforma.
Un runbook solido include:
Regole di freeze del business: quali scritture si interrompono, quando si interrompono e chi approva le eccezioni.
Sequenza di sincronizzazione finale: l'ordine delle ultime estrazioni, dei caricamenti di recupero e degli aggiornamenti a valle.
Gate di validazione: i controlli richiesti prima che gli utenti vengano indirizzati al sistema di destinazione.
Autorità decisionale: chi può approvare il go-live, chi può mettere in pausa e chi può attivare il rollback.
Disciplina del cutover: se il criterio di attivazione del rollback è vago, il team aspetterà troppo a lungo prima di usarlo.
Il rollback non è facoltativo
I piani di rollback falliscono quando esistono solo come diagrammi di architettura. I team hanno bisogno di criteri operativi e di una procedura testata. La regola di fondo è chiara: mantenete backup completi dei sistemi sorgente fino al completamento della validazione, testate in anticipo le procedure di ripristino e definite criteri di attivazione del rollback eseguibili entro la finestra massima di downtime accettabile. Le linee guida di RecordPoint lo sottolineano chiaramente nella metodologia di migrazione citata in precedenza.
La parte più difficile di solito è la governance, non lo scripting. I team esitano perché il rollback sembra un fallimento. Non lo è. Un'inversione controllata è spesso la prova che il processo di migrazione è abbastanza sano da proteggere il business quando le ipotesi crollano.
Il successo post-migrazione è operativo, non cerimoniale
Un progetto non termina quando gli utenti accedono al nuovo sistema. Termina quando il nuovo ambiente produce costantemente output affidabili, i dati pianificati arrivano in tempo e il vecchio sistema può essere dismesso senza ansia.
Una checklist pratica post go-live si presenta così:
Area post-cutover | Che cosa confermare |
|---|---|
Affidabilità dei dati | I report critici e le riconciliazioni corrispondono ai risultati di business attesi |
Salute delle pipeline | I feed arrivano secondo programma e si completano in modo affidabile |
Impatto sugli utenti | I flussi di lavoro di alto valore funzionano senza fogli di calcolo di ripiego |
Dismissione del legacy | Le vecchie integrazioni e gli export possono essere disattivati in sicurezza |
L'ultima trappola è abbandonare l'osservabilità una volta chiuso il progetto. È così che le nuove piattaforme diventano il problema legacy di domani. Gli stessi controlli usati durante la migrazione devono restare attivi anche dopo, per rilevare schema drift, dati in arrivo tardivo, regole violate e degrado della qualità man mano che l'ambiente di destinazione evolve.
Se state pianificando una migrazione dei dati da sistemi legacy e volete una visibilità continua su anomalie, modifiche allo schema, validazione a livello di record e tempestività senza spostare i dati fuori dal vostro ambiente, date un'occhiata a digna - sito ufficiale. È pensato per i team che hanno bisogno di operazioni sui dati osservabili e verificabili in configurazioni private cloud oppure on-premises.
Scoprite come digna lo fa nella pratica: monitoraggio della qualità dei dati per la vostra piattaforma.
Domande frequenti
Perché la maggior parte delle migrazioni dei dati da sistemi legacy fallisce?
Circa l'83% fallisce del tutto oppure sfora budget e tempistiche. La causa ricorrente non è il trasferimento in sé, ma le ipotesi non verificate che lo sostengono: regole di business non documentate, campi riutilizzati per scopi che nessuno ha registrato e obiettivi di riconciliazione definiti solo dopo che i dati sono già stati spostati.
Che cosa bisogna fare prima di spostare qualsiasi dato?
Fate prima l'archeologia. Profilate il sistema legacy per capire che cosa contengono davvero i dati, anziché ciò che afferma la documentazione, quindi rilevate una baseline di conteggi dei record, distribuzioni e totali chiave. Senza questa baseline non potete dimostrare che la migrazione abbia preservato qualcosa.
Come si valida una migrazione dei dati?
Definite gli obiettivi di validazione prima di iniziare, non dopo. Riconciliate conteggi e totali di controllo per entità, confrontate le distribuzioni anziché controllare righe a campione e verificate l'integrità referenziale nella destinazione. L'accordo su che cosa costituisca una migrazione riuscita deve precedere il cutover.
Che cos'è la riconciliazione degli schemi in una migrazione?
Consiste nel risolvere le incongruenze strutturali e semantiche tra vecchio e nuovo: campi che si dividono o si uniscono, tipi che cambiano, codici che si mappano in modo imperfetto. La parte difficile è quella semantica, perché due sistemi possono avere lo stesso nome di colonna e intendere cose diverse.
Come si previene la deriva durante una lunga migrazione?
I sistemi legacy continuano a cambiare mentre costruite la destinazione. Il rilevamento tracciato delle modifiche sulla sorgente è più efficace di un foglio di mapping che invecchia in silenzio, perché vi segnala quando una colonna, un tipo o una distribuzione sono cambiati dopo l'approvazione del vostro mapping.


