Playbook per il miglioramento della qualità dei dati nei team enterprise
|
6
min di lettura

Una dashboard trimestrale dei ricavi può sembrare perfettamente in ordine mentre sovrastima per settimane le prenotazioni dell'area EMEA. Un aggiornamento del fornitore modifica una colonna valuta nel sistema sorgente, iniziano a confluire valori nulli nel warehouse e una trasformazione a valle interpreta in modo errato i valori mancanti. La finanza scopre il problema durante la preparazione del consiglio di amministrazione, quando gli analisti hanno già fatto circolare i report e i dirigenti hanno già preso decisioni sulla base di essi.
Questo incidente non è principalmente un problema di dashboard. È un fallimento del miglioramento della qualità dei dati che riguarda controllo dello schema, tempestività, ownership e risposta agli incidenti. La soluzione non è l'ennesimo acquisto isolato di uno strumento di monitoraggio, ma un modello operativo che definisce cosa significano dati affidabili, assegna la responsabilità ai team che li producono, rileva i difetti vicino alla loro origine e misura quanto rapidamente l'organizzazione ripristina la fiducia.
Indice
Perché la maggior parte dei programmi di qualità dei dati si blocca prima di partire
Lo strumento raramente è il modello operativo
La copertura deve andare oltre la completezza
Valutare lo stato attuale della qualità dei dati
Costruire la baseline da quattro fonti di evidenza
Creare un'istantanea misurabile della maturità
Definire SLA e KPI che reggono davvero
Classificare i dataset in base alle conseguenze
Separare i segnali anticipatori dalle misure di risultato
Controlli di validazione, rilevamento delle anomalie, tempestività e schema
Scegliere il controllo in base al difetto
Esecuzione in-database, integrazione nei workflow e runbook
Instradare i segnali nel lavoro esistente
Rendere il runbook eseguibile
Organizzare team, ownership e cadenza operativa
Separare i ruoli
Trasformare le riunioni in deliverable
Misurare il ROI e i primi 90 giorni
Convertire le perdite operative in un business case
Seguire una sequenza mirata di 90 giorni
Perché la maggior parte dei programmi di qualità dei dati si blocca prima di partire
La prima reazione a un incidente come quello dell'esempio EMEA è spesso prevedibile. Qualcuno propone una piattaforma di qualità dei dati, un altro team costruisce una dashboard dei tassi di valori nulli e un centro di eccellenza pubblica standard che i produttori dei dati non vedono mai. L'organizzazione genera attività visibile senza modificare le condizioni che hanno lasciato passare il difetto.
Lo strumento raramente è il modello operativo
Uno strumento di qualità può calcolare metriche, eseguire regole e inoltrare alert. Non può decidere se il campo valuta appartenga al team finanza o al team dei sistemi commerciali. Né può stabilire se un valore mancante debba bloccare un caricamento, mettere in quarantena i record interessati o generare un avviso mentre l'elaborazione prosegue.
Questa decisione richiede un contratto documentato tra produttori e consumatori dei dati. Senza di esso, i team discutono degli alert dopo l'incidente invece di concordare in anticipo il comportamento accettabile. Un'utile analisi delle cause strutturali si trova in questa analisi sul perché i progetti di qualità dei dati falliscono, in particolare nella distinzione tra sintomi tecnici e cause organizzative.
La copertura deve andare oltre la completezza
I tassi di valori nulli sono utili, ma una tabella può essere completa ed essere comunque sbagliata. Un feed può arrivare in ritardo, contenere uno schema modificato, usare un codice valuta non valido o introdurre chiavi di business duplicate. I team che misurano solo la completezza creano un falso senso di controllo, perché verificano una sola dimensione ignorando la finestra decisionale e il significato dei dati.
Un programma efficace assegna i controlli ai rischi che contano:
Standard: definizioni, valori ammessi, ownership e procedure di modifica.
Responsabilità: produttori e steward designati con l'autorità di risolvere i difetti.
Feedback: alert, ticket, retrospettive e modifiche alle pipeline che prevengono il ripetersi dei problemi.
La qualità ha bisogno anche di una prospettiva economica. La sintesi dell'IBM Institute for Business Value riporta che il 43% dei chief operations officer ha indicato i problemi di qualità dei dati come la propria priorità più importante in materia di dati. Oltre un quarto delle organizzazioni ha dichiarato perdite annue superiori a 5 milioni di dollari, mentre il 7% ha riportato perdite pari o superiori a 25 milioni di dollari. Questi dati spiegano perché la qualità deve rientrare nelle revisioni operative e non solo nei backlog di ingegneria.
L'unità pratica di progresso è il ciclo dall'incidente alla risoluzione. Un programma funziona quando rileva prima i guasti, li inoltra al responsabile giusto, limita l'esposizione a valle e trasforma ogni lezione appresa dopo un incidente in un controllo più solido sulla pipeline.
Valutare lo stato attuale della qualità dei dati
Partite dalle evidenze, non dalla frustrazione degli stakeholder. Spesso le persone dicono di non fidarsi di un dataset, ma questa percezione può riflettere una manciata di incidenti visibili, definizioni poco chiare o difetti misurabili. La vostra baseline dovrebbe catturare tutti e tre gli aspetti.
Costruire la baseline da quattro fonti di evidenza
Primo, fate un'archeologia degli incidenti. Esportate gli ultimi sei mesi di ticket relativi ai dati da Jira o ServiceNow. Raggruppate ogni ticket per dominio, dataset interessato, tipo di difetto, causa radice, tempo di rilevamento, tempo di risoluzione e ricorrenza del problema. Non scartate i ticket “piccoli”: le correzioni manuali ripetute rivelano spesso una debolezza di processo che un guasto importante farà emergere in seguito.
Secondo, profilate automaticamente le tabelle critiche. Esaminate tassi di valori nulli, cardinalità dei valori distinti, valori minimi e massimi, chiavi duplicate, integrità referenziale e variazioni delle distribuzioni. Confrontate i conteggi tra sorgente e target dove opportuno, ma non considerate la corrispondenza nel numero di righe come prova di correttezza: una trasformazione può preservare i volumi corrompendo i valori.
Terzo, intervistate separatamente produttori e consumatori. Chiedete ai produttori di quali campi ritengono di essere responsabili e ai consumatori se i dati sono adeguati alle loro decisioni. Raccogliete punteggi qualitativi di fiducia insieme ai pattern di utilizzo, ai report critici, ai modelli e ai workflow operativi. Un dataset molto utilizzato e con scarsa fiducia merita priorità anche se il suo storico di incidenti è tranquillo.
Quarto, classificate i difetti rispetto alle sei dimensioni. Usate accuratezza, completezza, coerenza, tempestività, validità e unicità come vocabolario condiviso. Il modello di maturità della qualità dei dati può aiutare i team a trasformare osservazioni sparse in una baseline ripetibile anziché in un workshop una tantum.
Creare un'istantanea misurabile della maturità
Assegnate a ogni dimensione un punteggio su una scala da 1 a 5, basandovi su evidenze esplicite. Un punteggio basso può indicare che l'organizzazione non dispone di una definizione condivisa o di una misurazione ripetibile. Un punteggio intermedio può indicare controlli automatizzati ma ownership incoerente. Un punteggio alto dovrebbe richiedere soglie documentate, controlli monitorati, responsabili identificati, storico degli incidenti e miglioramento regolare.
Dimensione | Metrica principale | Approccio di campionamento | Fonte di rilevamento tipica |
|---|---|---|---|
Accuratezza | Corrispondenza con una fonte autorevole o un risultato verificato | Confronto dei campi critici con i record sorgente o con dati di riferimento approvati | Riconciliazione, revisione da parte dei consumatori |
Completezza | Tassi di valori nulli, record mancanti e campi obbligatori | Controlli sull'intera tabella per i campi critici, controlli a campione per gli attributi a minor rischio | Profilazione, test di validazione |
Coerenza | Concordanza tra sistemi, tabelle e definizioni | Confronto di chiavi condivise, unità, etichette e valori calcolati | Riconciliazione tra sistemi |
Tempestività | Arrivo e disponibilità rispetto alla finestra decisionale | Monitoraggio di ogni partizione o evento di consegna atteso | Monitoraggio delle pianificazioni, log delle pipeline |
Validità | Conformità a tipi, intervalli, formati e regole di business | Controlli completi per i campi vincolati, campionamento mirato per i record complessi | Controlli sullo schema, motore di regole |
Unicità | Tasso di duplicati per chiavi di business definite | Scansioni complete delle chiavi o rilevamento incrementale dei duplicati | Vincoli del database, profilazione |
Mantenete la baseline sotto controllo di versione. Un punteggio privo dei test, dei campioni e delle definizioni sottostanti non consente un confronto trimestre su trimestre.
Definire SLA e KPI che reggono davvero
Uno SLA sulla qualità dei dati richiede quattro elementi: un responsabile, una soglia, una finestra di misurazione e un percorso di escalation. Se ne manca anche uno solo, lo SLA diventa un'aspirazione. “Mantenere i dati aggiornati” non è applicabile. “Il feed di rischio deve arrivare entro la finestra decisionale concordata e il responsabile dei dati di rischio viene allertato quando la soglia viene superata” è operativo.
Classificare i dataset in base alle conseguenze
Non applicate la stessa intensità di controllo a ogni tabella. Classificate i dataset come critici, operativi o esplorativi in base a impatto sul business, esposizione normativa, dipendenze a valle e aspettative di ripristino.
I dataset critici supportano reporting finanziario, decisioni di rischio, segnalazioni normative od operazioni essenziali con i clienti. I dataset operativi alimentano workflow ricorrenti e reportistica direzionale. I dataset esplorativi supportano analisi in cui dati in ritardo o imperfetti sono scomodi ma non immediatamente dannosi.
Le soglie dovrebbero riflettere l'uso, non una scorecard universale. Una fact table dei ricavi può richiedere una completezza del 95%, mentre un feed di rischio infragiornaliero può richiedere una freschezza del 98%, ma queste cifre contano solo se ciascuna è legata a un responsabile, a una finestra di misurazione definita e a una risposta esplicita. L'obiettivo è rendere visibile il compromesso di business.
Separare i segnali anticipatori dalle misure di risultato
Conteggi di righe e tassi di valori nulli descrivono lo stato dei dati dopo l'elaborazione. Sono utili indicatori ritardati, ma non vi diranno se il modello operativo sta migliorando. Aggiungete indicatori anticipatori come il tasso di violazione degli SLA, il tempo di presa in carico, il tasso di difetti segnalati dai consumatori, il tasso di incidenti ricorrenti e la percentuale di dataset critici con runbook aggiornati.
Livello | SLA di freschezza | KPI di completezza | KPI di validità | Responsabilità |
|---|---|---|---|---|
Critico | Definito dalla finestra decisionale e monitorato per ogni consegna | Campi obbligatori misurati a ogni caricamento | Le regole di business bloccano o mettono in quarantena gli errori rilevanti | Steward designato, responsabile lato produttore ed escalation on-call |
Operativo | Finestra di consegna concordata con stati di avviso e di violazione | Andamento monitorato rispetto a una soglia approvata | Record non validi inoltrati per la correzione prima dell'utilizzo | Il produttore risolve, lo steward conferma l'idoneità |
Esplorativo | Disponibilità best-effort con stato visibile | Profilazione periodica senza bloccare il lavoro | Avvisi documentati per i limiti noti | Il consumatore accetta o segnala il rischio |
Pubblicate lo SLA dove lavorano i produttori: nel repository del warehouse, nella configurazione della pipeline, nel template delle pull request e nel runbook degli incidenti. Un portale di governance può ospitare la definizione ufficiale, ma non dovrebbe essere l'unico luogo in cui gli ingegneri possono trovare il contratto.
Controlli di validazione, rilevamento delle anomalie, tempestività e schema
Nessun controllo, da solo, intercetta ogni difetto. La validazione basata su regole offre precisione dove il contratto è noto. Il rilevamento basato sull'AI offre una copertura più ampia dove il comportamento normale è difficile da codificare. I controlli di tempestività e di schema affrontano modalità di guasto che i controlli a livello di valore spesso non colgono.
Scegliere il controllo in base al difetto
La validazione deterministica è la scelta giusta per campi obbligatori, unicità, integrità referenziale, insiemi di valori ammessi, tipi di dato e regole di business note a livello di riga. È interpretabile e facile da collegare a un audit trail. Il suo punto debole è la manutenzione: ogni nuova regola richiede scrittura, test e un responsabile, e una regola non può rilevare un guasto che nessuno ha previsto.
Il rilevamento delle anomalie apprende nel tempo distribuzioni, volumi, cardinalità e comportamenti normali. Può far emergere drift silenziosi, variazioni inattese e modifiche ai payload dei fornitori senza una regola per ogni possibilità. Il compromesso è l'interpretabilità: un alert statistico richiede contesto, e i team devono calibrarlo affinché eventi insoliti ma legittimi non generino alert fatigue.
Il monitoraggio della tempestività verifica se i dati arrivano e diventano utilizzabili entro la loro finestra decisionale. Una tabella che esiste ma riflette lo stato di ieri non è in buona salute per un processo infragiornaliero. Le indicazioni sul monitoraggio della tempestività e della validazione dei dati raccomandano soglie di invecchiamento automatizzate, così che i record obsoleti vengano segnalati prima che i workflow a valle li utilizzino.
Il tracciamento dello schema versiona tipi di colonna, nullabilità, strutture annidate e presenza dei campi. Dovrebbe distinguere le modifiche additive da quelle che causano rotture e dal drift semantico. Aggiungere una colonna nullable può essere innocuo per un consumatore e dirompente per un altro, per questo lineage e analisi d'impatto sono importanti.
Controllo | Cosa intercetta | Cosa non coglie | Profilo di costo | Livello più adatto |
|---|---|---|---|---|
Validazione deterministica | Violazioni di regole note e mancato rispetto dei contratti | Pattern nuovi al di fuori delle regole definite | Impegno prevedibile per scrittura e manutenzione | Ingestione, normalizzazione, serving |
Rilevamento delle anomalie basato sull'AI | Variazioni delle distribuzioni, volumi insoliti, drift comportamentale silenzioso | Contesto che richiede una spiegazione di business | Meno regole manuali, maggiore necessità di calibrazione | Monitoraggio ampio sulle pipeline |
Controlli di tempestività | Caricamenti mancati, partizioni in ritardo, dati presenti ma non aggiornati | Valori che arrivano puntuali ma sono errati | Basso, una volta definite pianificazioni e finestre | Confini di ingestione e consegna |
Tracciamento dello schema | Campi e strutture aggiunti, rimossi o con tipo modificato | Cambiamenti di significato senza modifiche strutturali | Impegno moderato su metadati e ownership | Contratti con le sorgenti e confini delle pipeline |
I team che valutano pattern di automazione possono consultare anche gli approfondimenti di Truespeak sull'automazione per un contesto più ampio sui workflow. Il programma di qualità deve comunque decidere quali errori bloccano l'elaborazione, quali mettono in quarantena i record e quali si limitano a notificare i consumatori. Più automazione non è automaticamente meglio se sposta l'incertezza in una coda opaca.
Un approccio a più livelli è più solido della scelta tra regole e AI. Usate regole di validazione dei dati e controlli di qualità continui per gli obblighi noti, poi aggiungete il rilevamento delle anomalie per la coda lunga.
Esecuzione in-database, integrazione nei workflow e runbook
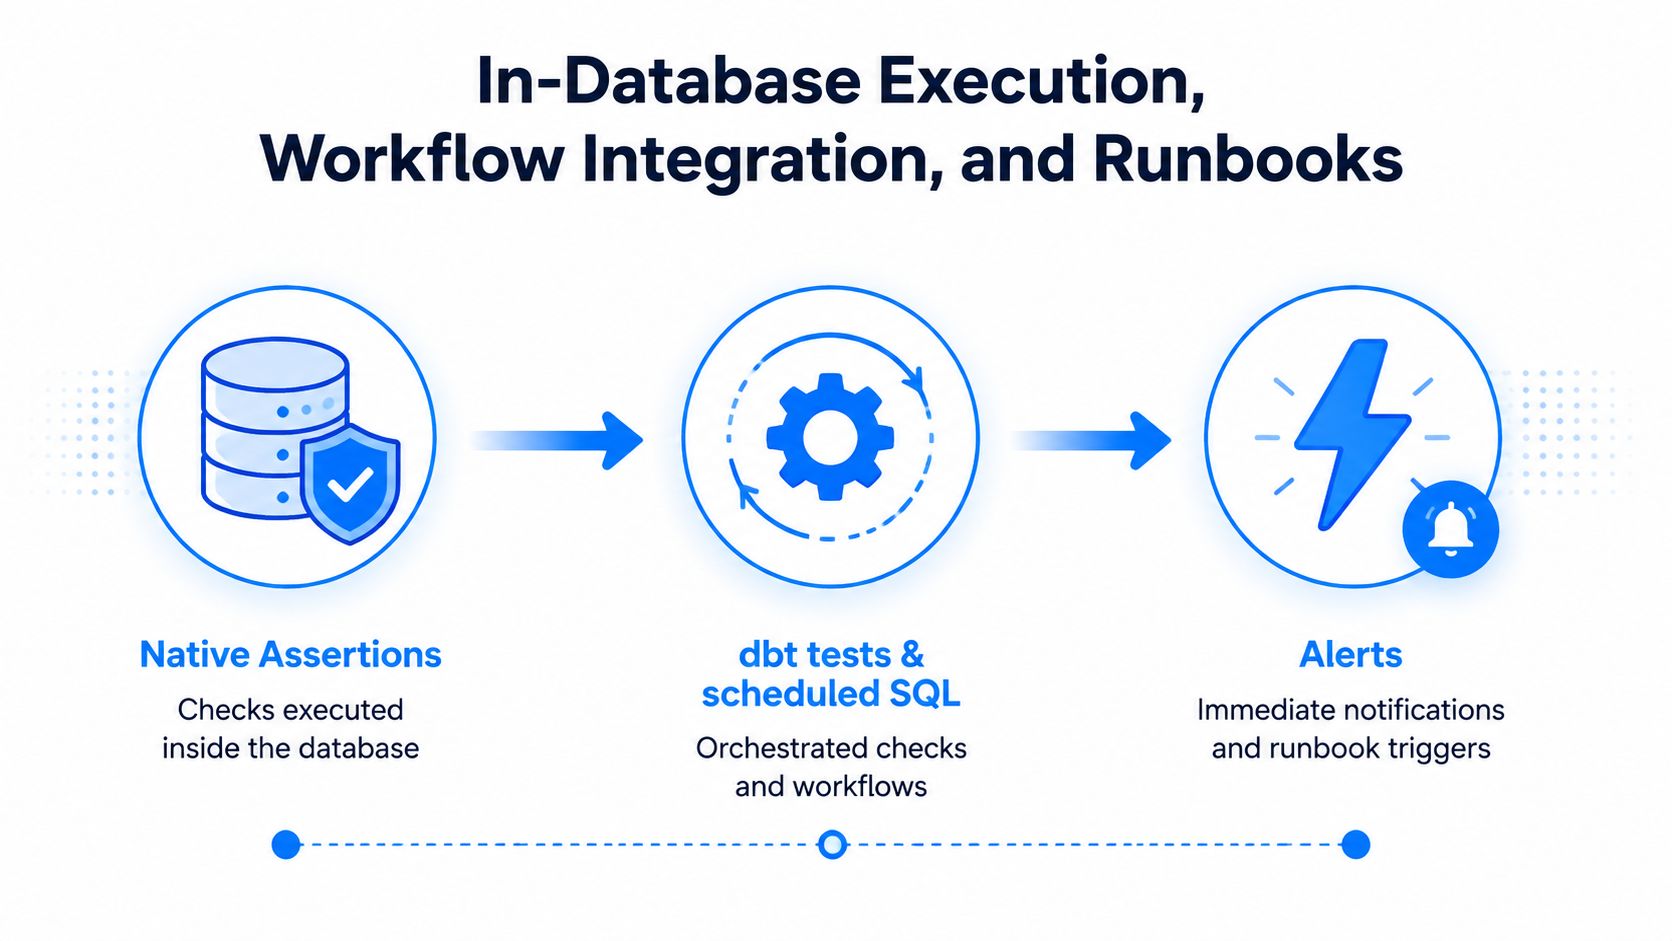
Eseguite i controlli al confine in cui i dati vengono prodotti o trasformati. Asserzioni native, test dbt e SQL pianificato mantengono la validazione vicina alla tabella e rendono più facile associare gli errori a uno specifico caricamento, partizione o trasformazione. Un livello di monitoraggio separato può aggiungere valore, ma non dovrebbe introdurre un lungo ritardo tra la creazione del difetto e il suo rilevamento.
Instradare i segnali nel lavoro esistente
Usate un instradamento basato sulla gravità invece di inviare ogni risultato a ogni canale.
Gravità uno: allertate l'ingegnere on-call tramite PagerDuty quando un dataset critico non è disponibile, è sostanzialmente non valido o è fuori dalla sua finestra decisionale.
Gravità due: aprite un thread Slack con il produttore e lo steward quando i consumatori sono coinvolti ma esiste una soluzione temporanea controllata.
Follow-up: create un ticket Jira per difetti ricorrenti, manutenzione delle regole, documentazione o remediation della pipeline.
Le indicazioni sull'automazione dei workflow di dati sono utili per progettare questi passaggi di consegne, ma il principio è semplice: gli alert devono raggiungere la persona in grado di modificare il processo che produce i dati.
Rendere il runbook eseguibile
Un runbook dovrebbe consentire a un ingegnere di avviare la diagnosi senza dover rintracciare l'autore originale. Includete:
Firma dell'errore: la metrica, la regola o la pianificazione violata.
Raggio d'impatto: tabelle, dashboard, modelli, report e processi di business interessati.
Responsabile probabile: produttore, steward, team di piattaforma o fornitore esterno.
Prime tre query: controlli sui valori sorgente, sull'output della trasformazione e sull'impatto a valle.
Azione di contenimento: rollback, quarantena, sospensione del caricamento o notifica ai consumatori.
Template di comunicazione: cosa è successo, cosa è coinvolto, cosa devono fare gli utenti e quando arriverà il prossimo aggiornamento.
Deduplicate gli alert entro una finestra definita, sopprimete gli alert figli quando il guasto di una pipeline padre li spiega e raggruppate le segnalazioni a bassa gravità in un riepilogo. Prima di dichiarare pronto il processo, eseguite una simulazione di incidente. Verificate che l'alert scatti, che il responsabile sia raggiungibile, che le query funzionino, che il rollback sia sicuro e che il ticket raccolga evidenze sufficienti per una retrospettiva successiva.
Organizzare team, ownership e cadenza operativa
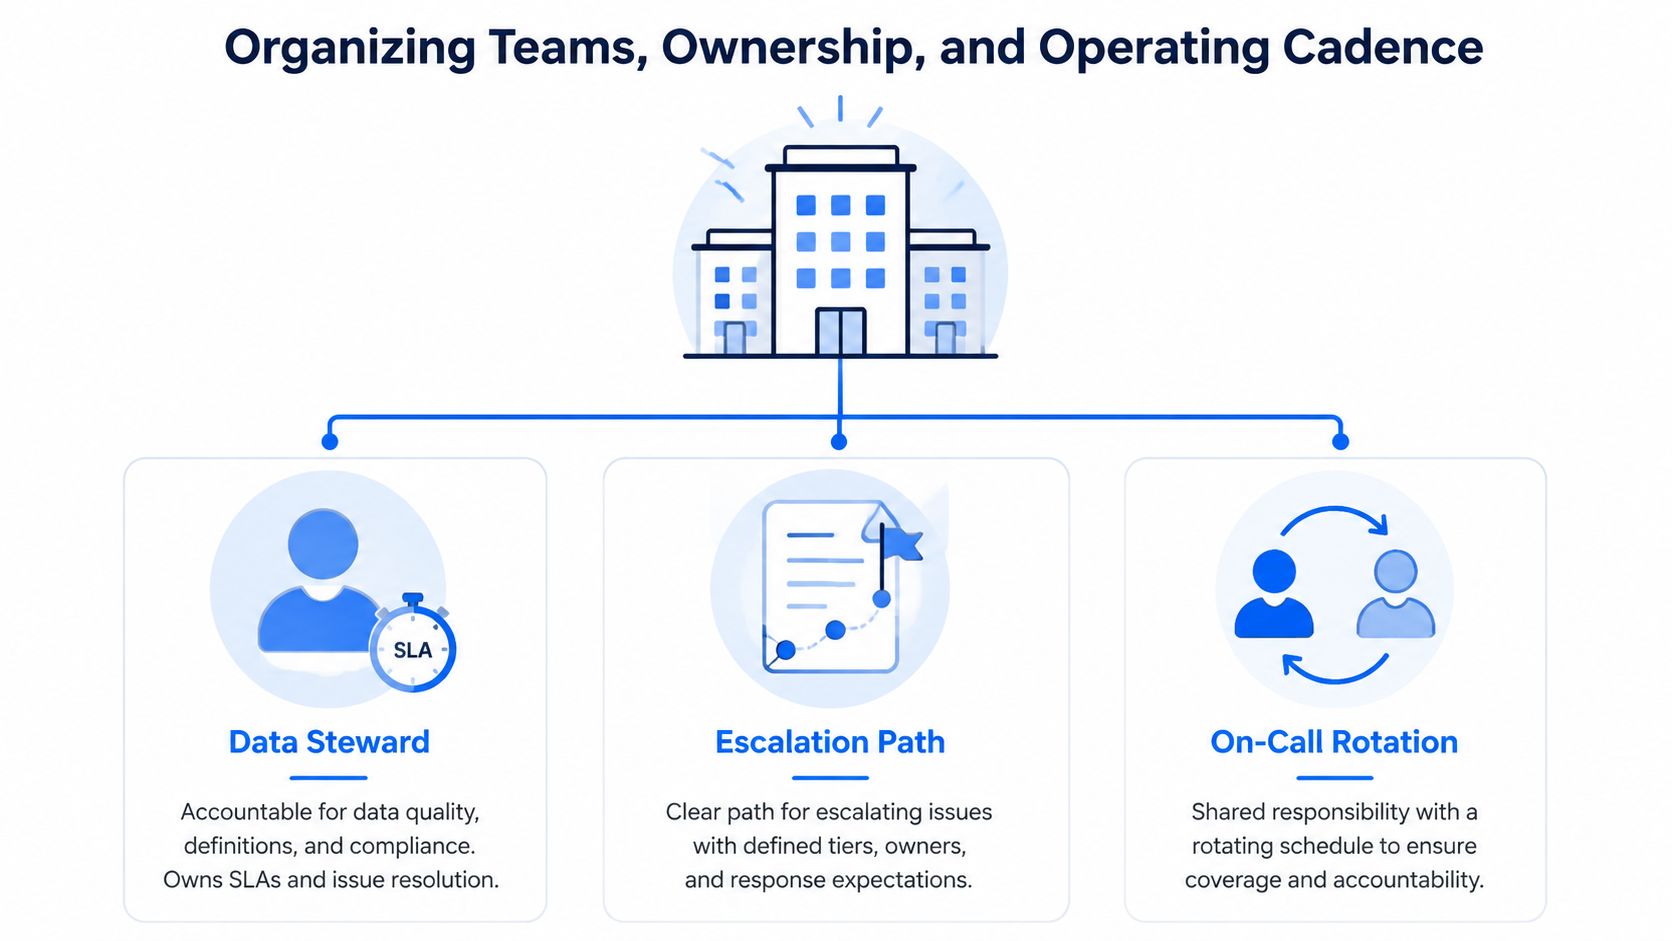
L'ownership diventa chiara quando ogni dataset ha uno steward designato, un produttore, un consumatore e un percorso di escalation. Un centro di eccellenza può fornire pattern e coaching, ma non dovrebbe essere responsabile di un difetto che non può correggere.
Separare i ruoli
Il data producer è responsabile di ingestione, contratti con le sorgenti, modifiche allo schema e comportamento delle pipeline. Il data steward è responsabile di definizioni, aspettative di qualità, interpretazione di business e coordinamento della risoluzione. Il data consumer verifica se il dataset è adeguato a un report, un modello o una decisione operativa e segnala difetti su cui è possibile intervenire.
Gli incidenti trasversali a più domini richiedono un incident lead designato. Se un fornitore è responsabile della sorgente, un team dei sistemi commerciali dell'applicazione e un team di piattaforma del warehouse, il lead coordina il contenimento mentre ogni gruppo gestisce la propria parte dell'indagine.
Trasformare le riunioni in deliverable
Una cadenza utile produce decisioni, non discussioni:
Triage settimanale: esamina le nuove anomalie, assegna i responsabili e chiude o scala gli incidenti.
Revisione mensile dei KPI: confronta prestazioni rispetto agli SLA, difetti ricorrenti, segnalazioni dei consumatori e remediation in ritardo.
Aggiornamento trimestrale dei contratti: rivede definizioni, soglie, lineage, cambiamenti normativi e nuovi consumatori.
Usate una matrice RACI leggera per ogni dataset critico. Il produttore è responsabile dell'implementazione, lo steward risponde dell'idoneità e delle definizioni, i consumatori vengono consultati sull'impatto e il gruppo di piattaforma o di governance viene informato dei cambiamenti sistemici. Adattate le lettere se la vostra organizzazione usa un modello diverso, ma non lasciate la responsabilità condivisa da un comitato senza nome.
Il modello operativo richiede anche turni on-call per le pipeline più critiche. Senza di essi, gli alert arrivano fuori orario e l'organizzazione misura il rilevamento accettando un ripristino lento. L'ownership dovrebbe comparire nel catalogo, nel repository, nel payload degli alert e nel runbook, non solo in un verbale di riunione.
Misurare il ROI e i primi 90 giorni
Il management non ha bisogno dell'ennesimo punteggio di qualità privo di interpretazione finanziaria. Partite dal data downtime, il periodo in cui un dataset è non disponibile, non aggiornato o inaffidabile per l'uso previsto. Una formula pratica è DDT = N × (TDD + TTR), in cui il numero di incidenti viene moltiplicato per la somma del tempo medio di rilevamento e del tempo medio di risoluzione, come descritto in queste indicazioni sulla misurazione del data downtime.
Convertire le perdite operative in un business case
Raccogliete le ore che analisti, ingegneri, personale della finanza e team operativi hanno speso nel trimestre precedente a inseguire dati errati. Moltiplicate queste ore per il relativo costo orario pieno, quindi aggiungete le conseguenze documentate, come previsioni riviste, decisioni ritardate, azioni verso i clienti fallite o interventi di remediation per la compliance.
Monitorate le stesse categorie dopo l'implementazione. Il confronto dovrebbe mostrare meno incidenti, tempi di rilevamento e di risoluzione più brevi, meno rilavorazioni e una minore esposizione a decisioni prese su dati inaffidabili. Non sostenete che ogni incidente evitato sia un ricavo garantito: separate i risparmi concreti dal rischio evitato e rendete visibili le ipotesi.
Per molte imprese il caso è rilevante. IBM riporta che oltre un quarto delle organizzazioni stima perdite annue superiori a 5 milioni di dollari a causa della scarsa qualità dei dati, mentre il 7% stima perdite superiori a 25 milioni di dollari. Usate questi dati come contesto, non come sostituto della vostra baseline.
Seguire una sequenza mirata di 90 giorni
Fase | Giorni | Deliverable principali | Criteri di successo |
|---|---|---|---|
Baseline | Da 1 a 15 | Profilare le cinque tabelle più critiche, definire gli SLA, assegnare i responsabili, registrare il downtime attuale | Ogni dataset prioritario ha un contratto, un responsabile e una misurazione di partenza |
Strumentazione | Da 16 a 45 | Implementare controlli di schema e freschezza in-database, instradare gli alert sui canali on-call, pubblicare i runbook | Le violazioni raggiungono il team responsabile con un contesto diagnostico utilizzabile |
Calibrazione | Da 46 a 75 | Aggiungere il rilevamento delle anomalie, rivedere i falsi positivi, regolare le soglie e documentare le eccezioni | Il volume degli alert è gestibile e i cambiamenti significativi vengono indagati |
Revisione | Da 76 a 90 | Condurre la revisione trimestrale, riportare le variazioni di downtime e di risposta e scegliere la prossima area di copertura | Il management vede l'impatto operativo e approva la successiva espansione |
Il framework per il business case della qualità dei dati può aiutare a strutturare la narrazione finanziaria attorno a costi, rischi e risultati misurabili.
Evitate quattro trappole. Le metriche di vanità premiano il numero di controlli anziché un rilevamento utile. L'alert fatigue nasconde i guasti gravi sotto il rumore. Gli strumenti senza responsabilità producono dashboard invece di remediation. Saltare la retrospettiva del primo incidente garantisce che la stessa classe di difetti si ripresenterà.
Iniziate con cinque tabelle critiche, un responsabile designato per ciascuna e una definizione scritta di cosa significa “disponibile e affidabile”. Poi misurate il primo incidente dal rilevamento alla risoluzione, perché quel ciclo vi dirà sulla maturità del programma più di un punteggio di qualità ben confezionato.
digna offre validazione in-database, rilevamento delle anomalie, monitoraggio della tempestività e tracciamento dello schema all'interno del vostro ambiente, così che i team possano collegare i controlli di qualità alle pipeline e ai dataset che già gestiscono. Visitate digna per valutare un approccio modulare al miglioramento della qualità dei dati in warehouse, data lake e pipeline enterprise.
Domande frequenti
Perché i programmi di qualità dei dati si bloccano prima di partire?
Perché la prima reazione a un incidente è di solito acquistare o configurare uno strumento. Uno strumento di qualità può calcolare metriche, eseguire regole e inoltrare alert, ma non può decidere cosa significa corretto: per questo serve un contratto documentato tra produttori e consumatori dei dati.
Misurare i tassi di valori nulli garantisce una copertura sufficiente?
No. I tassi di valori nulli sono utili, ma una tabella può essere completa ed essere comunque sbagliata. La copertura deve andare oltre la completezza e includere le definizioni, i valori ammessi e le relazioni che determinano se un record completo è anche corretto.
Cosa assegna un programma efficace?
I controlli ai rischi che contano, in tre aree: standard che coprono definizioni, valori ammessi, ownership e procedure di modifica; responsabilità tramite produttori e steward designati con l'autorità di risolvere i difetti; feedback tramite alert, ticket, retrospettive e modifiche alle pipeline che prevengono il ripetersi dei problemi.
Perché la qualità ha bisogno di una prospettiva economica?
Perché senza di essa ogni dataset sembra meritare la stessa attenzione. Collegare i controlli al costo di un guasto è ciò che permette a un team di giustificare dove investire gli sforzi e cosa lasciare per ora monitorato ma non corretto.
Che aspetto ha il guasto tipico?
Una dashboard dei ricavi che sembra perfettamente in ordine mentre per settimane sovrastima le prenotazioni di una regione. L'incidente non è principalmente un problema di dashboard, ed è per questo che sostituire la dashboard o aggiungere un ulteriore controllo raramente previene il successivo.


