Il metodo Monte Carlo di simulazione: una guida pratica
|
9
min di lettura
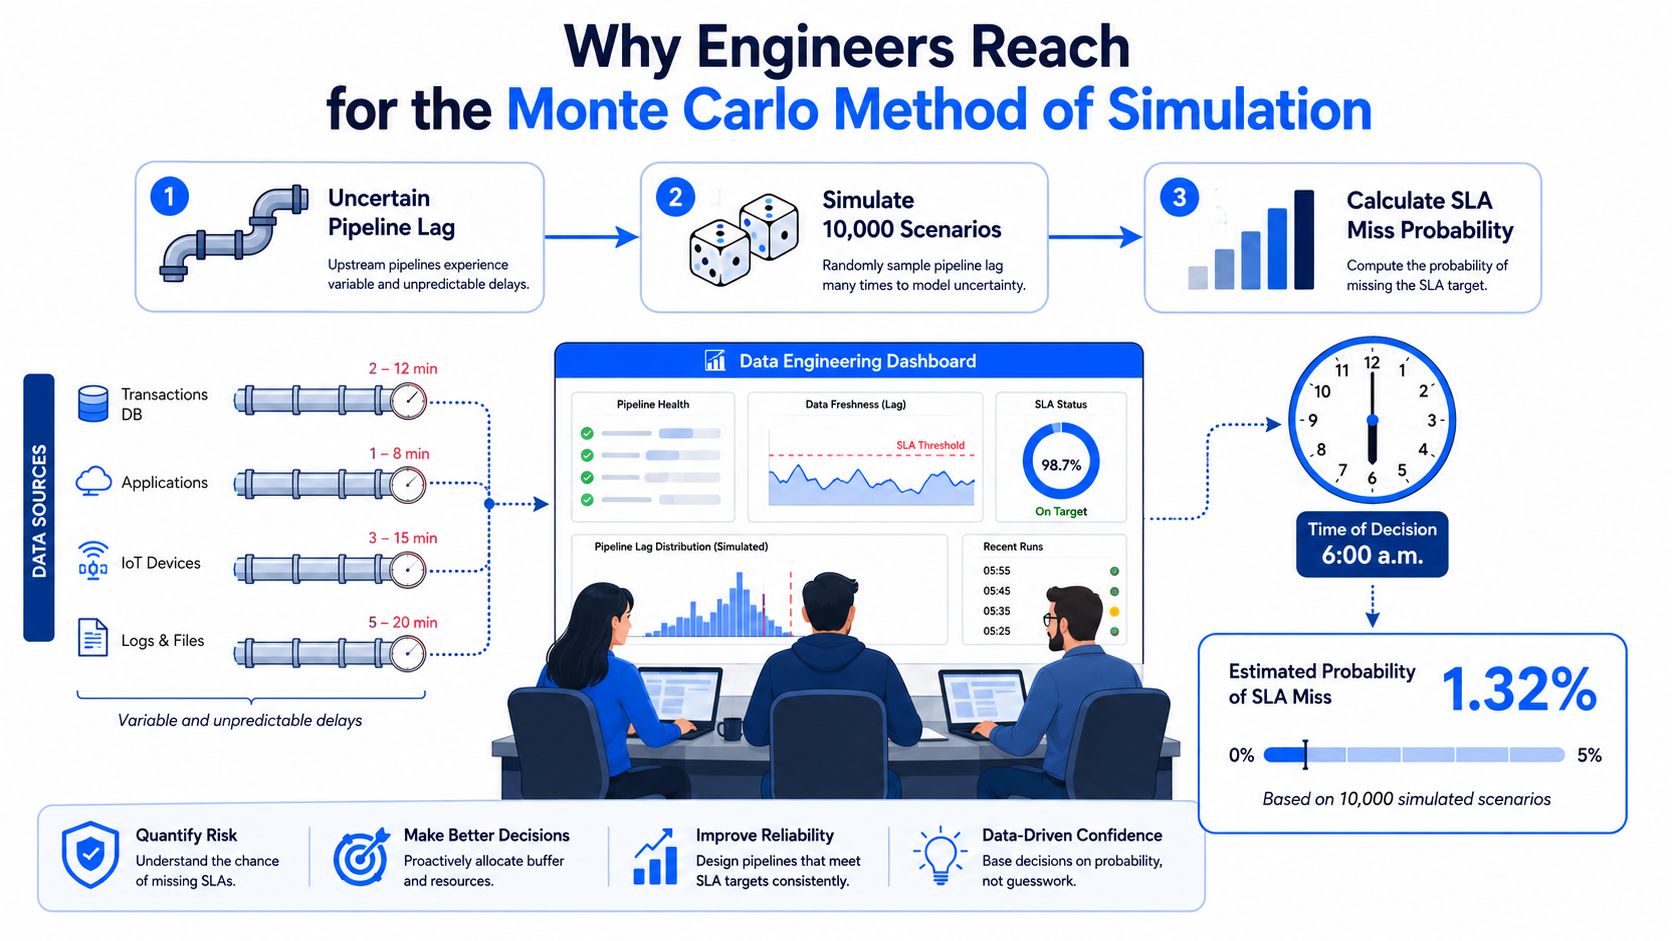
Il vostro team ha un job ETL giornaliero che deve terminare prima della finestra di reporting del mattino. Le pipeline a monte arrivano in orari diversi, alcune tabelle richiedono nuovi tentativi e i volumi di righe cambiano da un'esecuzione all'altra. Qualcuno pone una domanda di business ragionevole: qual è la probabilità che il job non rispetti il suo SLA?
Un foglio di calcolo con un unico valore medio di ritardo non risponderà bene. Le combinazioni possibili si moltiplicano rapidamente e le modalità di errore interagiscono tra loro. Il metodo Monte Carlo di simulazione offre un'alternativa pratica. Trasforma l'incertezza in esperimenti computazionali ripetuti, quindi sintetizza i risultati ottenuti sotto forma di probabilità, intervalli e misure di rischio.
Indice
Perché gli ingegneri ricorrono al metodo Monte Carlo di simulazione
Da un'equazione impossibile a un esperimento gestibile
Le origini del metodo Monte Carlo di simulazione
Perché la tappa dell'ENIAC è importante
I principi fondamentali che fanno funzionare il campionamento casuale
L'algoritmo in quattro fasi
Stimare errore e convergenza con fiducia
Un esempio pratico sulla conversione
Diagnostica della convergenza in produzione
Tecniche di riduzione della varianza da conoscere
Quattro approcci e i loro compromessi
Pseudocodice e pattern di implementazione in-database
Un modello di riferimento in Python
Portare il calcolo accanto ai dati
Applicare il metodo Monte Carlo di simulazione alla qualità dei dati enterprise
Tempestività e aggiornamento delle pipeline
Schema drift e impatto a valle
Monitoraggio adattivo del tasso di valori nulli e delle anomalie
Idee sbagliate comuni e una checklist pratica
Una checklist operativa
Perché gli ingegneri ricorrono al metodo Monte Carlo di simulazione
Un team di data engineering può conoscere il comportamento storico di ogni sorgente a monte e avere comunque difficoltà a calcolare analiticamente la probabilità di mancare una scadenza di consegna fissa. Una sorgente può arrivare in ritardo, un'altra può fallire e ripartire, una terza può consegnare un batch insolitamente grande che allunga i tempi di trasformazione. Ogni ramo modifica il successivo, quindi un'unica formula in forma chiusa diventa difficile da mantenere e ancora più difficile da difendere.
La simulazione Monte Carlo affronta il problema in modo diverso. Il team rappresenta gli input incerti con distribuzioni realistiche, genera esecuzioni sintetiche della pipeline, valuta se ciascuna esecuzione termina prima dello SLA e aggrega i risultati in una stima di probabilità. Il risultato non è la promessa che una determinata esecuzione sarà in ritardo. È una visione basata su evidenze di come si comporta il sistema modellato in molte condizioni plausibili.
Da un'equazione impossibile a un esperimento gestibile
L'attrattiva del metodo non è la casualità fine a sé stessa. È la possibilità di sostituire un problema analitico intrattabile con un esperimento computazionale trattabile. Gli ingegneri possono porsi domande come:
Capacity planning: di quanto margine di elaborazione ha bisogno il carico di lavoro in caso di arrivi ad alto volume?
Valutazione del rischio: con quale frequenza le combinazioni di ritardi a monte e nuovi tentativi causano una violazione dello SLA?
Impegni con gli stakeholder: quanto è difendibile l'orario di consegna proposto quando gli input restano variabili?
Ogni esecuzione della simulazione funziona come una giornata operativa sintetica. Un'esecuzione potrebbe estrarre un breve ritardo a monte e un volume di righe moderato. Un'altra potrebbe combinare diversi arrivi in ritardo con ulteriori tentativi. Il modello registra l'orario di completamento e classifica l'esecuzione come successo o violazione.
Regola pratica: modellate l'incertezza che cambia la decisione. Aggiungere input casuali che non influiscono sullo SLA aumenta solo la complessità.
Se desiderate una spiegazione separata del flusso di lavoro di base, il tutorial di simulazione di Polytreasury offre un utile contesto introduttivo. Per i team dati enterprise, il cambiamento importante è concettuale: smettete di chiedere un unico orario di completamento presumibilmente preciso e iniziate a chiedervi come l'intera gamma di esecuzioni plausibili influisca sul rischio operativo.
Le origini del metodo Monte Carlo di simulazione
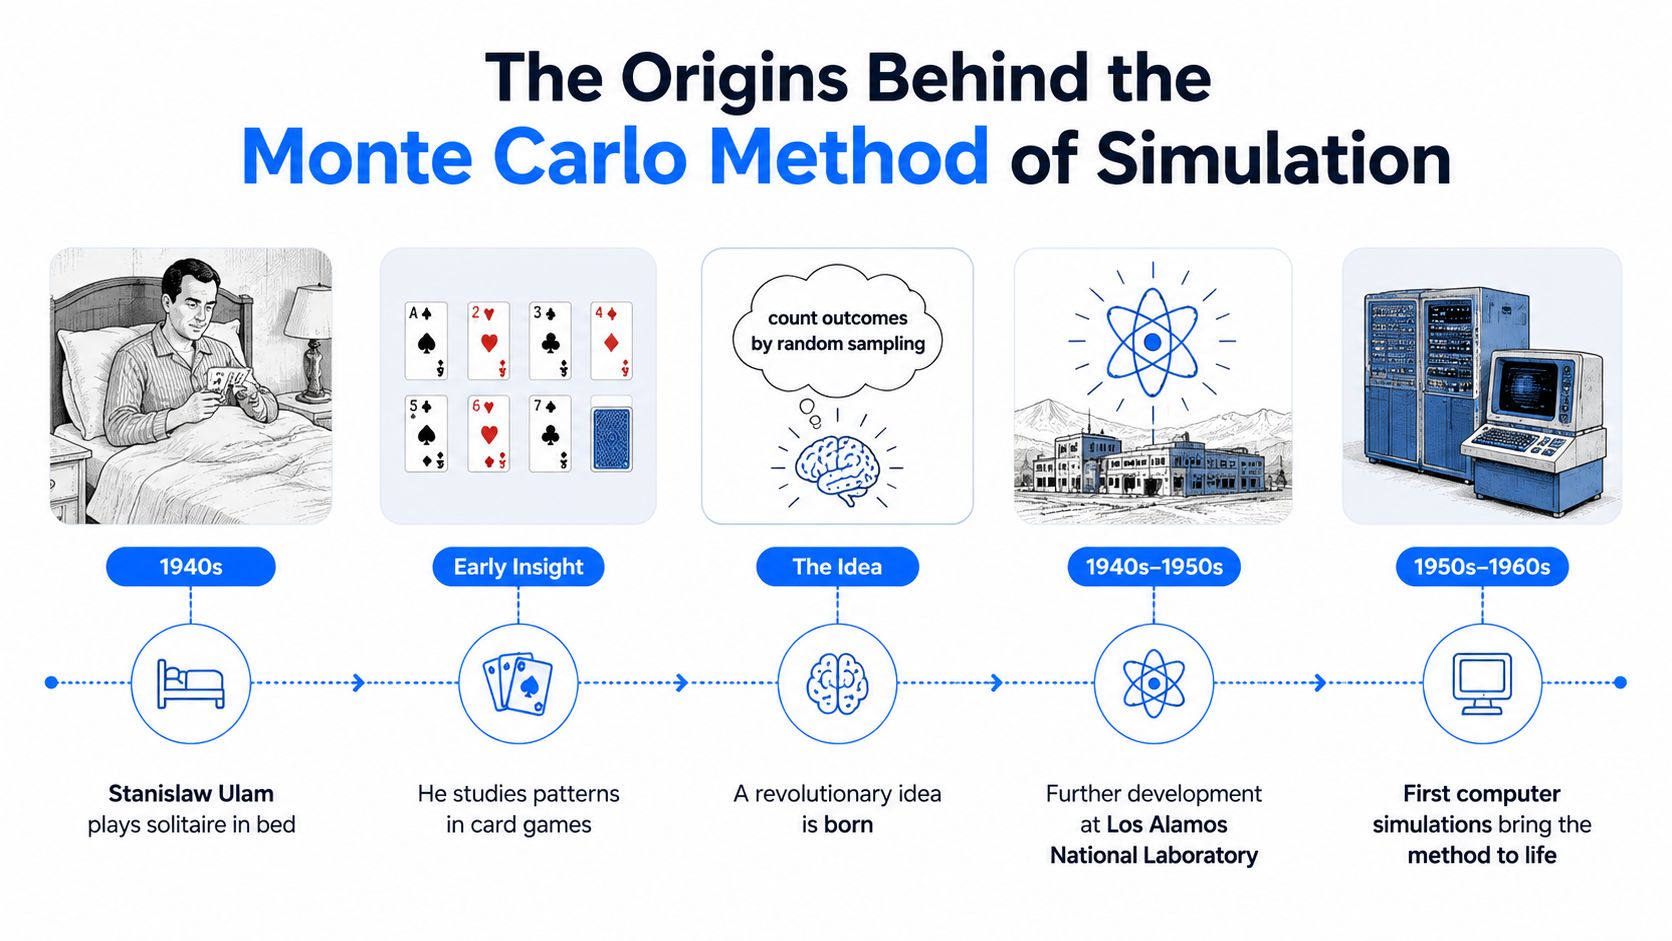
La storia moderna inizia con Stanisław Ulam, che si stava riprendendo da una malattia e pensava al solitario. Si chiese quanto fosse probabile che una particolare disposizione delle carte portasse a una vittoria. Contare analiticamente ogni possibile disposizione sarebbe stato impraticabile, ma distribuire ripetutamente le carte e registrare il risultato era semplice.
Quell'intuizione cambiò la domanda. Invece di enumerare ogni esito, Ulam poteva usare prove casuali per stimare la percentuale di vittorie. La stessa logica poteva applicarsi a sistemi con spazi di stato enormi, in cui il calcolo diretto diventa irrealistico.
Ulam condivise l'idea con John von Neumann a Los Alamos durante il Progetto Manhattan. Von Neumann ne riconobbe la rilevanza per la diffusione dei neutroni e per i calcoli di fisica nucleare correlati. La forma computazionale moderna del metodo fu sviluppata deliberatamente a metà degli anni '40, quando i ricercatori avevano bisogno di un modo per ragionare su comportamenti fisici complessi che resistevano a trattamenti analitici più semplici.
Perché la tappa dell'ENIAC è importante
Una tappa fondamentale arrivò nel 1948, quando von Neumann, Nicholas Metropolis e altri usarono il computer ENIAC per eseguire i primi calcoli Monte Carlo completamente automatizzati. Il primo articolo non classificato seguì nel 1949. Questo passaggio è importante perché portò il metodo dal ragionamento manuale sul caso alla simulazione su larga scala basata su computer.
Metropolis contribuì a dare all'approccio il suo memorabile nome in codice, ispirandosi al carattere probabilistico del casinò di Monte Carlo, nel Principato di Monaco. Il nome è rimasto perché coglie l'intuizione centrale: prove casuali possono rivelare il comportamento di un sistema complicato.
La storia offre una lezione diretta ai data engineer. Il Monte Carlo non è nato come un esercizio accademico slegato dall'operatività. È emerso perché i ricercatori si trovavano di fronte a un problema troppo complicato da risolvere comodamente con l'enumerazione diretta. I team enterprise affrontano lo stesso schema quando centinaia di tabelle, pianificazioni, nuovi tentativi, dipendenze e volumi di dati variabili interagiscono all'interno di una piattaforma di produzione.
I principi fondamentali che fanno funzionare il campionamento casuale
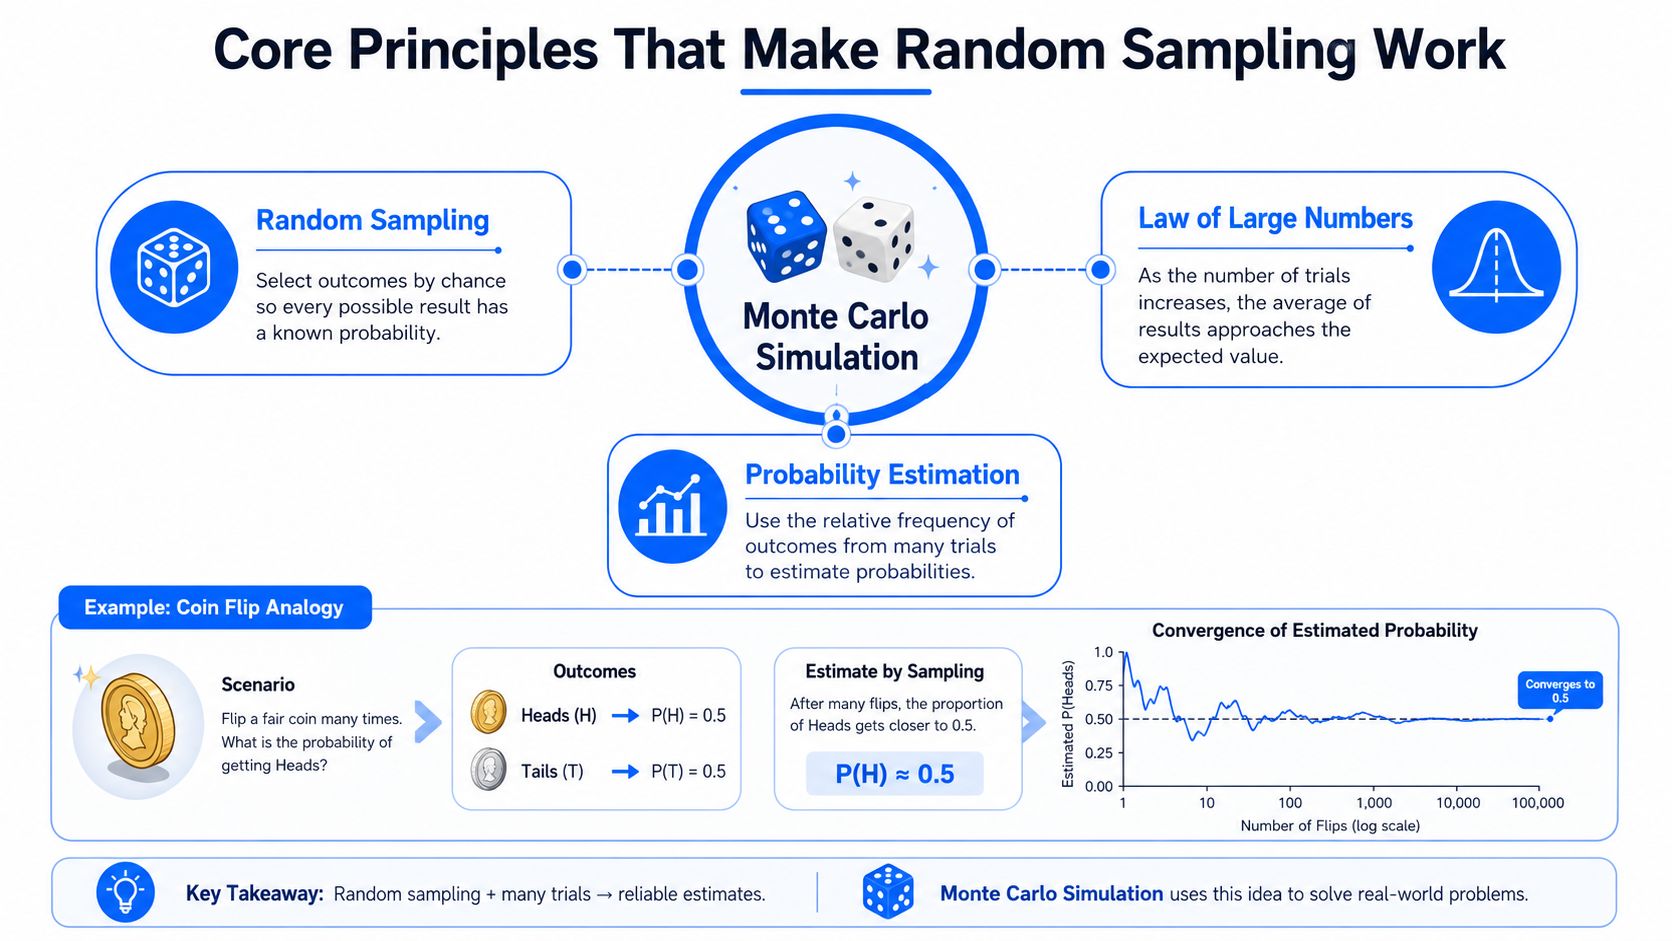
Supponiamo di voler stimare quante volte una moneta equa cade su testa. Potreste ricavare la probabilità matematicamente, oppure lanciare ripetutamente la moneta e calcolare la quota di teste. Il secondo approccio è meno elegante per una semplice moneta, ma vi fornisce il giusto modello mentale per la simulazione Monte Carlo.
Per una pipeline enterprise, la “moneta” diventa un modello del sistema. Ogni prova campiona input incerti, li elabora attraverso il modello e registra un risultato come l'orario di completamento, il numero di validazioni fallite o lo stato dello SLA.
L'algoritmo in quattro fasi
Definire il dominio degli input. Scegliete una distribuzione di probabilità per ogni variabile incerta. Il ritardo a monte potrebbe essere modellato sugli arrivi storici, il numero di tentativi sul comportamento operativo osservato e il numero di righe sulle partizioni recenti.
Generare i campioni. Un generatore pseudocasuale estrae un valore da ciascuna distribuzione di input per ogni iterazione. Con un seed fisso il generatore è deterministico, il che rende un'esecuzione riproducibile.
Valutare il sistema. Inserite i valori campionati nel modello della pipeline. Il modello potrebbe sommare le durate dei task, applicare le regole sui nuovi tentativi, calcolare il consumo di risorse o classificare un'esecuzione come violazione dello SLA.
Aggregare i risultati. Sintetizzate i risultati registrati usando una media, un percentile o una probabilità di coda. Per la domanda sullo SLA, dividete gli esiti di violazione per il totale delle esecuzioni simulate per stimare la probabilità di violazione modellata.
Sia (X_i) il risultato dell'iterazione (i). Il valore atteso è approssimato dalla media campionaria:
[
E[X] \approx \bar{X} = \frac{1}{N}\sum_{i=1}^{N}X_i
]
La varianza campionaria può essere scritta come:
[
Var(X) \approx s^2 = \frac{1}{N-1}\sum_{i=1}^{N}(X_i-\bar{X})^2
]
Queste formule da sole non rendono corretto il modello. Sintetizzano il comportamento prodotto dalle ipotesi che avete fornito. Una distribuzione che non rappresenta gli arrivi stagionali, i ritardi a monte correlati o le rare raffiche di tentativi può produrre un risultato curato ma fuorviante.
Per una base più ampia sulle tecniche statistiche usate nel lavoro sui dati, consultate i metodi statistici per l'analisi dei dati. Il principio centrale resta semplice: il campionamento ripetuto produce una stima e la legge dei grandi numeri afferma che la stima diventa più stabile all'aumentare del numero di simulazioni.
Stimare errore e convergenza con fiducia
Il risultato di un Monte Carlo è una stima, non un oracolo esatto. Due idee spiegano perché la stima migliora con più iterazioni. La legge dei grandi numeri descrive la convergenza della media campionaria verso il vero valore atteso, mentre il teorema del limite centrale descrive come lo stimatore tenda, in condizioni adeguate, a formare una distribuzione a campana attorno a quel valore.
Per la media campionaria, un'approssimazione comune dell'errore standard Monte Carlo è:
[
SE = \frac{\sigma}{\sqrt{N}}
]
Qui (\sigma) rappresenta la deviazione standard del risultato e (N) il numero di iterazioni. La radice quadrata ha un peso operativo. Aumentare il numero di esecuzioni migliora la precisione, ma con rendimenti decrescenti. Raddoppiare le iterazioni riduce l'errore standard di circa la radice quadrata di due, non della metà.
Un esempio pratico sulla conversione
Supponiamo che un team stia stimando il tasso di conversione degli utenti attivi giornalieri con un modello la cui varianza del risultato è nota dagli input modellati. Ogni iterazione campiona un volume plausibile di utenti attivi e un comportamento di conversione, quindi calcola il tasso risultante. Il team non dovrebbe scegliere un numero di iterazioni solo perché sembra grande. Dovrebbe scegliere un'ampiezza dell'intervallo obiettivo adatta alla decisione.
Se il management ha bisogno solo di un intervallo di pianificazione ampio, un errore standard moderato può essere accettabile. Se il risultato determina una decisione costosa su capacità o campagne, il team potrebbe richiedere un intervallo più stretto. Il numero corretto di esecuzioni dipende dalla volatilità del risultato, dalla precisione desiderata e dalle conseguenze di agire su una stima incerta.
Iterazioni (N) | Errore standard (σ/√N) | Riduzione relativa |
|---|---|---|
N | σ/√N | Base di riferimento |
2N | σ/√(2N) | Ridotto di circa la radice quadrata di due |
4N | σ/√(4N) | Circa la metà dell'errore di base |
La tabella esprime la relazione di scala anziché prescrivere un numero universale di esecuzioni. La stima di un evento raro può richiedere più attenzione rispetto a un tasso di conversione medio, in particolare quando solo una piccola parte delle iterazioni produce l'evento di interesse.
Diagnostica della convergenza in produzione
Un grafico della media mobile mostra se la metrica stimata si assesta in una regione stabile. Un trace plot può rivelare schemi nei risultati generati, mentre l'errore standard Monte Carlo fornisce una regola di arresto quantitativa.
Per indicazioni pratiche su come descrivere la forma del risultato, consultate come descrivere la distribuzione dei dati. In produzione, fermatevi quando la stima raggiunge l'obiettivo di precisione predefinito e ulteriori esecuzioni non cambiano più la decisione in modo sostanziale. Questo approccio è più responsabile che scegliere un numero elevato di iterazioni e dare per scontato che il risultato debba essere affidabile.
Tecniche di riduzione della varianza da conoscere
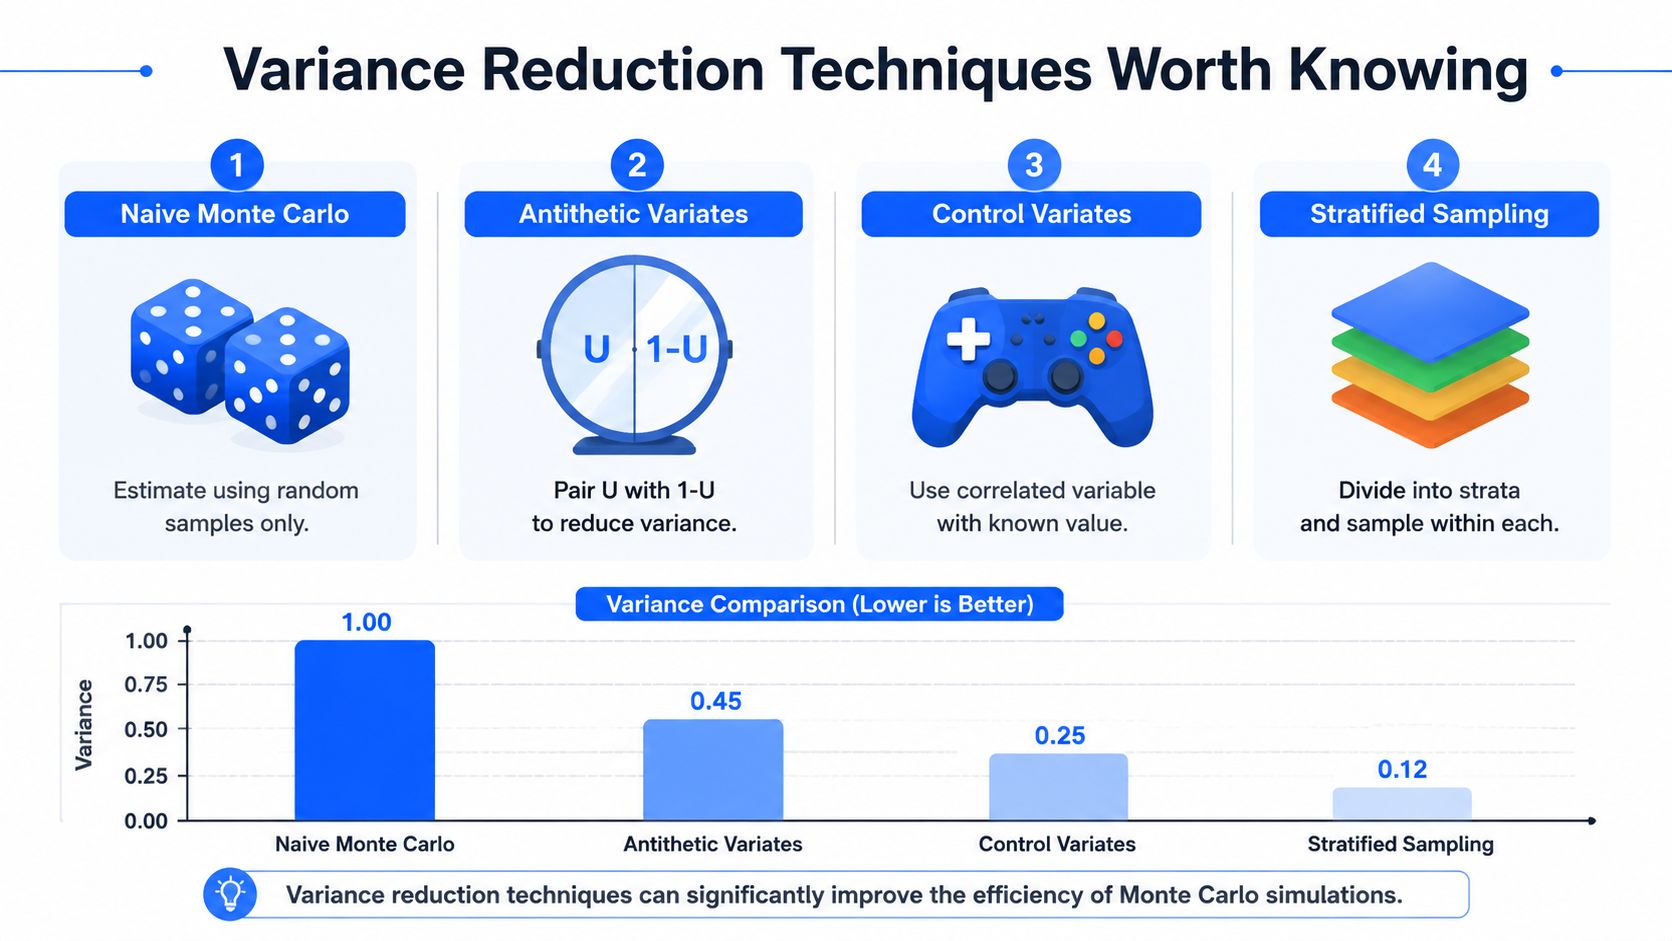
Il campionamento Monte Carlo ingenuo è facile da spiegare e spesso rappresenta una base di riferimento sensata. Può però sprecare risorse di calcolo quando la stima è rumorosa, soprattutto per gli eventi rari. Le tecniche di riduzione della varianza migliorano la precisione organizzando o ponderando i campioni in modo più intelligente, senza aumentare il numero di iterazioni.
Quattro approcci e i loro compromessi
Le variabili antitetiche accoppiano un'estrazione (U) con (1-U). Se il modello risponde in modo monotono all'input campionato, i risultati accoppiati possono muoversi in direzioni opposte e ridurre la varianza. Il costo è una logica di implementazione aggiuntiva e il requisito che l'accoppiamento abbia senso per il modello. Può essere adatto a un modello della durata di una pipeline in cui un input uniforme controlla una componente di ritardo monotona.
Le variabili di controllo usano una grandezza correlata il cui valore atteso è noto analiticamente. La simulazione stima la relazione tra l'obiettivo e la variabile di controllo, quindi sottrae la variazione residua. Questo approccio può essere molto efficace, ma richiede una variabile di controllo utile e una stima accurata dei coefficienti.
Il campionamento stratificato divide il dominio degli input in strati e campiona all'interno di ciascuna regione. Impedisce che la simulazione sottorappresenti accidentalmente una parte importante dell'intervallo. Ad esempio, le previsioni dei percentili di fatturato possono riservare una copertura di campionamento alle regioni di domanda bassa, tipica e alta, anziché affidarsi a estrazioni casuali senza vincoli.
L'importance sampling sposta la distribuzione proposta verso una regione di eventi rari, quindi corregge il risultato con un rapporto di verosimiglianza. È un ottimo candidato per stimare le probabilità di violazione dello SLA quando le violazioni sono rare, ma una ponderazione errata può introdurre errori gravi e oscurare l'interpretazione del risultato.
Giudizio di modellazione: un metodo di riduzione della varianza è utile solo quando le sue ipotesi corrispondono al sistema. Un rumore numerico inferiore non compensa un modello di dipendenze errato.
I team dovrebbero documentare perché hanno scelto una tecnica, quale correzione del bias applica e come hanno validato il risultato rispetto a una base di riferimento ingenua. Per le osservazioni insolite che alimentano il modello di input, i metodi di identificazione degli outlier possono aiutare a separare i comportamenti estremi genuini dagli errori nei dati prima che la simulazione inizi.
Pseudocodice e pattern di implementazione in-database
Un modello di simulazione riutilizzabile parte dalla domanda, non dal generatore casuale. Definite il risultato, individuate gli input incerti, selezionate le distribuzioni, stabilite le dipendenze e decidete come verranno utilizzati i risultati.
Una versione compatta si presenta così:
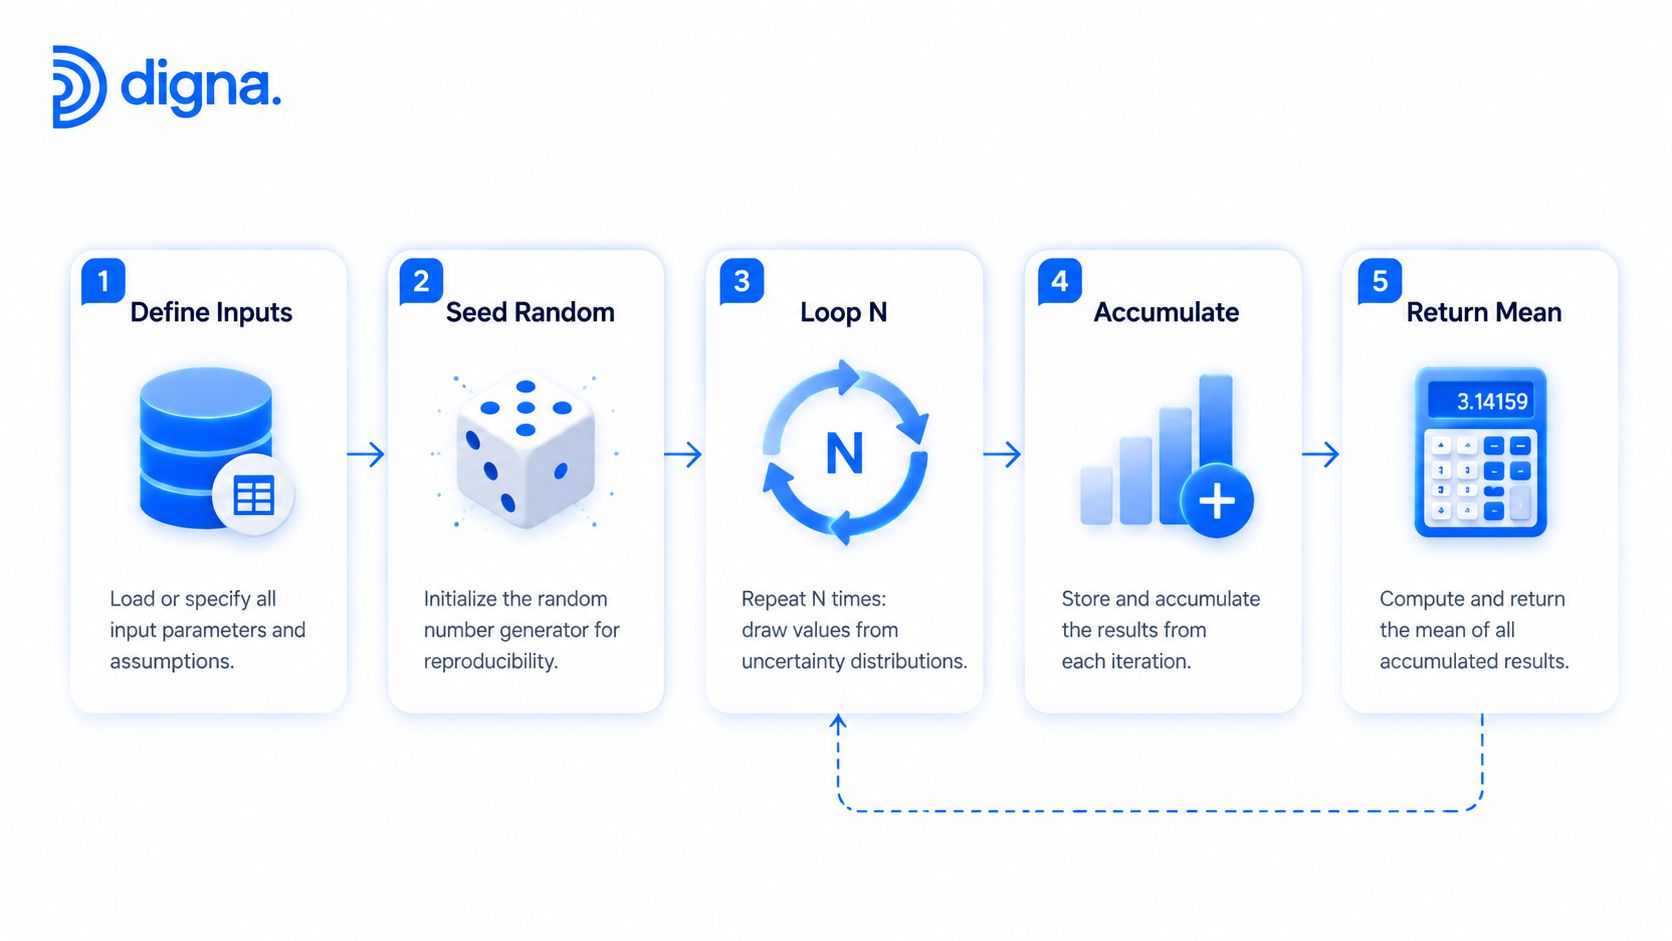
Definire le distribuzioni di input e il risultato obiettivo.
Inizializzare una sorgente pseudocasuale con un seed registrato.
Estrarre un valore da ciascuna distribuzione per ogni iterazione.
Valutare il modello del sistema.
Memorizzare o accumulare il risultato.
Restituire le statistiche di sintesi e i percentili selezionati.
Verificare la convergenza e validare le ipotesi.
Un modello di riferimento in Python
L'esempio seguente stima il value at risk di una distribuzione delle perdite dovute all'abbandono dei clienti. Usa valori segnaposto per i parametri del modello, quindi ciò che conta è lo schema di esecuzione e non un'affermazione su un particolare risultato di business.
Un'implementazione di produzione dovrebbe registrare il seed, i parametri delle distribuzioni, la versione del modello, le partizioni sorgente e il timestamp di esecuzione. Dovrebbe inoltre conservare metadati sufficienti per riprodurre il risultato dopo che i dati sottostanti sono cambiati.
Portare il calcolo accanto ai dati
Python funziona bene quando il modello è complesso, il risultato è granulare o il team ha bisogno di librerie scientifiche specializzate. I team dati enterprise hanno spesso bisogno di uno schema diverso. Vogliono campionare i dati storici del warehouse, fare join con le tabelle di produzione e calcolare metriche di qualità senza esportare record sensibili.
Snowflake, BigQuery e Databricks possono supportare pattern nativi del warehouse usando funzioni SQL random, common table expression, generatori di array o funzioni di tabella definite dall'utente. Un design tipico genera una relazione di iterazioni, campiona i parametri di input per ogni iterazione, li unisce alle metriche storiche aggregate, valuta l'espressione obiettivo e memorizza solo i risultati della simulazione.
Questo schema mantiene i dati sorgente nel warehouse, evita spostamenti non necessari e permette a worker paralleli di gestire il lavoro delle iterazioni tramite il motore di esecuzione della piattaforma. Il team può materializzare tabelle di risultati compatte contenenti medie, deviazioni standard, percentili e indicatori di violazione, invece di trasferire colonne grezze.
Per una trattazione pratica su come mantenere il calcolo della qualità vicino ai dati del warehouse, consultate l'esecuzione in-database dei controlli di qualità dei dati.
Scegliete Python quando il modello richiede librerie specializzate o risultati di simulazione a livello di riga. Scegliete SQL o una funzione nativa del warehouse quando contano soprattutto la residenza dei dati, tabelle sorgente di grandi dimensioni, la governance e una granularità aggregata dei risultati.
Applicare il metodo Monte Carlo di simulazione alla qualità dei dati enterprise
I team di qualità dei dati possono usare la simulazione per trasformare il comportamento storico in rischio operativo quantificato. L'unità utile non è sempre un cliente o una transazione. Può essere una partizione di tabella, un evento di consegna, una versione dello schema o una metrica di business osservata nel tempo.
Tempestività e aggiornamento delle pipeline
Un modello di freshness può campionare il comportamento storico di arrivo delle righe e calcolare la probabilità che un dataset arrivi dopo la finestra di consegna prevista. Invece di usare un'unica soglia statica, il modello può tenere conto della variabilità nei tempi delle sorgenti, nella dimensione dei batch, nelle dipendenze a monte e nella durata dell'elaborazione.
Questo risultato supporta una decisione di alerting più precisa. Un team può distinguere un normale arrivo in ritardo da una combinazione di condizioni che crea un rischio significativo a valle. Può anche usare la distribuzione simulata dei tempi di completamento per supportare il capacity planning e la definizione delle priorità degli incidenti.
Schema drift e impatto a valle
Le simulazioni sugli schemi possono rappresentare possibili modifiche strutturali, come una colonna aggiunta, un campo rimosso o una modifica del tipo di dato. Il modello può quindi valutare se ciascuna modifica entra in conflitto con query, dashboard, regole di validazione o contratti di ingestion a valle.
Il risultato è una visione probabilistica del rischio di modifica. Una modifica dello schema può essere innocua per un consumatore ma dirompente per un altro. Simulare il grafo delle dipendenze aiuta i team a concentrare la revisione dove una modifica strutturale ha più probabilità di compromettere un output critico.
Monitoraggio adattivo del tasso di valori nulli e delle anomalie
Le distribuzioni del tasso di valori nulli possono essere generate da campioni bootstrap delle partizioni recenti. Questi campioni preservano la variabilità osservata e possono aiutare le soglie ad adattarsi al comportamento stagionale invece di affidarsi a fragili limiti statici. Lo stesso approccio può supportare il rilevamento delle anomalie su volumi, tassi di duplicazione, freshness e altre metriche di qualità.
La modellazione della volatilità dei KPI aggiunge un ulteriore livello. Un team può simulare l'andamento dei ricavi con rumore correlato negli input, quindi presentare bande di confidenza che i dirigenti possono interpretare senza scambiare una previsione puntuale per una certezza.
digna combina rilevamento delle anomalie nei dati, monitoraggio della tempestività, validazione, tracciamento degli schemi e monitoraggio del business in una piattaforma in-database. Il suo modello di esecuzione mantiene i dati sensibili delle colonne all'interno dell'ambiente del cliente, producendo al contempo risultati statistici che i team possono usare per le decisioni di observability. L'approccio Monte Carlo alla data observability mostra come la simulazione possa sostituire le congetture con un rischio quantificato per gli alert generati da una piattaforma.
Idee sbagliate comuni e una checklist pratica
La simulazione Monte Carlo non rende affidabile un modello debole. Le estrazioni casuali possono riprodurre la distribuzione sbagliata con una coerenza impressionante, e un ampio insieme di risultati può far sembrare autorevoli ipotesi errate.
Quattro idee sbagliate causano problemi ricorrenti in produzione:
Casuale significa corretto: un generatore pseudocasuale campiona dalla distribuzione che specificate. Non può stabilire se quella distribuzione rifletta il comportamento reale della pipeline.
Più iterazioni eliminano ogni errore: più esecuzioni riducono la varianza di campionamento, ma non eliminano il bias causato da dipendenze mancanti, dati scadenti o un modello specificato male.
Una distribuzione normale va bene per default: i dati operativi possono essere asimmetrici, stagionali, limitati o a coda pesante. La scelta della distribuzione richiede evidenze tratte dal comportamento della sorgente.
La riduzione della varianza è automaticamente migliore: variabili antitetiche, variabili di controllo, campionamento stratificato e importance sampling introducono ciascuno delle ipotesi. Una tecnica adatta a un carico di lavoro può distorcerne un altro.
Le sequenze quasi casuali a volte possono ridurre l'errore di integrazione a parità di budget di calcolo, ma richiedono un ragionamento diverso rispetto al normale campionamento pseudocasuale. Trattatele come una scelta di modellazione da testare, non come un sostituto universale.
Una checklist operativa
Prima di eseguire una simulazione in produzione, verificate quanto segue:
Validate le distribuzioni: confrontate il comportamento storico con quello adattato tramite test come Kolmogorov-Smirnov o Anderson-Darling, quindi rivedete il risultato con un esperto del dominio.
Fissate prima la precisione: definite l'ampiezza desiderata dell'intervallo di confidenza prima di scegliere il numero di iterazioni.
Registrate il seed: memorizzate seed, versione degli input, parametri delle distribuzioni e versione del modello per garantire la riproducibilità.
Tenete vicini i grandi volumi di dati: preferite il campionamento nativo del database quando le righe sorgente sono numerose o sensibili.
Rivedete le dipendenze: verificate se le variabili a monte si muovono insieme invece di presumerne l'indipendenza.
Testate gli eventi rari: confrontate le stime delle code con strategie di campionamento alternative ed esaminatene la ponderazione.
Riesaminate le ipotesi: rivedete le distribuzioni e le scelte di riduzione della varianza con una cadenza operativa regolare.
Un workflow Monte Carlo responsabile è ingegneria statistica, non un pulsante con la scritta “esegui”. Il modello dovrebbe rendere visibile l'incertezza, esplicitare le proprie ipotesi e dare agli operatori un motivo chiaro per fidarsi del risultato o per metterlo in discussione.
digna offre funzionalità in-database di qualità dei dati e observability per rilevamento delle anomalie, tempestività, validazione, tracciamento degli schemi e monitoraggio del business. Usate il metodo Monte Carlo di simulazione per quantificare il rischio di pipeline e KPI là dove i vostri dati si trovano già, quindi visitate digna per esplorare un approccio di implementazione enterprise.
Domande frequenti
Quando gli ingegneri ricorrono al metodo Monte Carlo?
Quando una risposta analitica è fuori portata. Un team può conoscere il comportamento storico di ogni sorgente a monte e non riuscire comunque a calcolare la probabilità di mancare una scadenza di consegna fissa; per questo rappresenta gli input come distribuzioni, genera esecuzioni sintetiche e aggrega i risultati in una probabilità.
Come è nato il metodo?
Con Stanisław Ulam che, mentre si riprendeva da una malattia e pensava al solitario, si rese conto che partite casuali ripetute potevano stimare un esito difficile da calcolare con la combinatoria diretta. Condivise l'idea con John von Neumann a Los Alamos e la forma computazionale moderna fu sviluppata a metà degli anni '40.
Che cosa conta come singola esecuzione di simulazione?
Una giornata operativa sintetica. Ogni esecuzione estrae valori dalle distribuzioni di input, fa avanzare la pipeline e registra se il risultato ha soddisfatto la condizione che vi interessa, ad esempio terminare entro lo SLA. Aggregando migliaia di queste giornate si ottiene la stima di probabilità.
Quali incertezze vale la pena modellare?
Solo quelle che cambiano la decisione. Aggiungere input casuali che non influiscono sullo SLA aumenta solo la complessità senza migliorare la risposta, quindi partite dalla decisione e risalite alle variabili che la influenzano davvero.
A che cosa serve la riduzione della varianza?
A ottenere una stima utilizzabile con meno esecuzioni. Invece di simulare semplicemente di più, le tecniche di riduzione della varianza ristrutturano il campionamento in modo che la stima converga più rapidamente, il che è importante quando ogni esecuzione è costosa o quando la simulazione viene eseguita nel database accanto ai carichi di lavoro di produzione.


