Metodi di identificazione degli outlier: guida pratica per il 2026
|
7
min di lettura

È lunedì mattina, la dashboard dice che il fatturato è zero e nessuno trova un job fallito. Airflow è verde. dbt ha terminato. Il warehouse è attivo. Eppure il numero che il top management sta guardando è ancora sbagliato.
È il momento in cui molti team capiscono che il rilevamento degli outlier non è un esercizio di statistica. È una disciplina operativa. I dati errati raramente si annunciano con uno stack trace. Più spesso passano inosservati come un valore strano, un caricamento di tabella in ritardo, un improvviso spostamento della distribuzione o un record che supera i controlli di schema ma rompe comunque la logica a valle.
La maggior parte delle guide sui metodi di identificazione degli outlier si ferma a z-score e box plot. Va bene per un'aula. Non basta per una pipeline di produzione che alimenta reportistica finanziaria, feature di ML, dashboard operative e workflow soggetti ad audit. Nella pratica, la parte difficile non è elencare i metodi. È scegliere quello giusto per la forma dei dati, eseguirlo su larga scala e fare in modo che gli ingegneri possano agire su ciò che viene segnalato.
Indice
Quando i dati buoni diventano cattivi: l'impatto silenzioso degli outlier
Ampliare la definizione: outlier di valore e outlier operativi
Guida comparativa ai metodi di identificazione degli outlier
Rendere operativo il rilevamento: dalla teoria alla produzione
Integrare il rilevamento nella vostra pipeline di data observability
Conclusione: costruire una fiducia proattiva nei vostri dati
Quando i dati buoni diventano cattivi: l'impatto silenzioso degli outlier
Alle 8 del mattino, una dashboard delle vendite che mostra fatturato zero non sembra un problema di outlier. Sembra una pipeline rotta. Gli ingegneri partono da dove partono sempre. Controllano i log di orchestrazione. Controllano lo stato dei connettori. Controllano la cronologia delle query nel warehouse. Ma a volte ogni sistema dice che l'esecuzione è andata a buon fine.
Il guasto è dentro i dati.
Una sorgente può inviare un file valido con un unico campo corrotto che si propaga a cascata nelle aggregazioni. Una tabella transazionale può arrivare in ritardo, lasciando i modelli a valle tecnicamente aggiornati ma semanticamente obsoleti. Una distribuzione può spostarsi quel tanto che basta perché un modello di forecast continui ad assegnare punteggi ai record producendo risultati privi di senso. Sono questi gli incidenti che fanno perdere tempo, perché nulla sembra palesemente rotto.
I guasti silenziosi sono quelli costosi
I guasti evidenti sono dolorosi, ma almeno sono visibili. Le anomalie silenziose sono peggiori, perché gli analisti continuano a lavorare con output errati finché qualcuno non nota un numero che non torna. A quel punto i team hanno già copiato i dati nelle presentazioni, riaddestrato modelli su dati sospetti o preso decisioni operative basandosi su una dashboard che ritenevano aggiornata.
I dati errati non hanno bisogno di bloccare una pipeline per creare un incidente. Basta che sembrino credibili abbastanza a lungo da essere utilizzati.
Ecco perché i metodi di identificazione degli outlier rientrano nello stesso discorso della reliability engineering. Proteggono la continuità. Offrono ai team un modo per rilevare le deviazioni prima che un analista le noti manualmente o che uno stakeholder di business lanci l'allarme.
Gli outlier non sono solo un problema di data science
Nei sistemi di produzione, la gestione degli outlier tocca più livelli:
Affidabilità della BI: un picco o un calo anomalo può far sembrare rotta una dashboard anche quando l'SQL è corretto.
Qualità degli input di ML: le pipeline di feature spesso tollerano record malformati più a lungo del dovuto.
Audit e compliance: un record può rispettare i vincoli di schema e violare comunque la logica di business.
Carico di reperibilità: gli ingegneri perdono ore a dimostrare che l'infrastruttura è sana quando il problema è in realtà un'anomalia nei dati.
La lezione pratica è semplice. Se la vostra pipeline è importante, il vostro team ha bisogno di un approccio definito per identificare valori insoliti, tempistiche insolite e comportamenti insoliti. Senza di esso, ogni anomalia diventa un'indagine manuale.
Regola pratica: trattate il rilevamento degli outlier come parte della prontezza per la produzione, non come una pulizia a posteriori.
Ampliare la definizione: outlier di valore e outlier operativi
Il rilevamento degli outlier viene spesso introdotto con esempi come un importo di transazione impossibile o la lettura di un sensore ben al di fuori del suo intervallo abituale. Sono problemi reali, ma rappresentano solo una categoria. Nelle piattaforme dati in esercizio, alcuni degli outlier più dannosi non sono valori estremi. Sono pattern di consegna anomali.
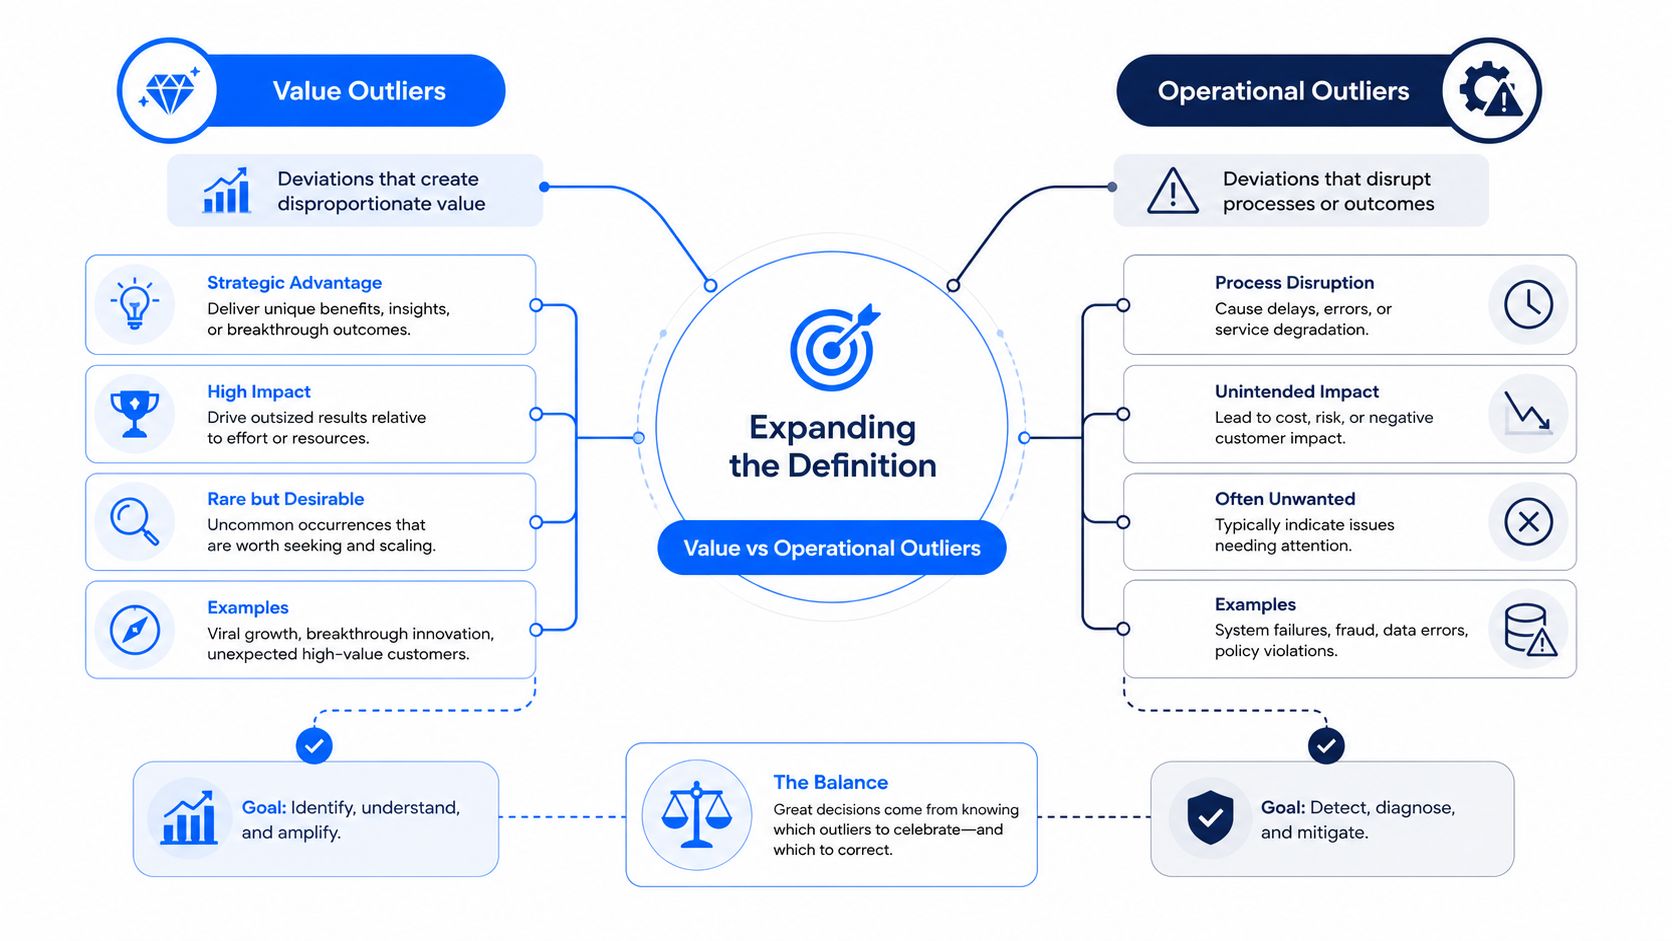
Gli outlier di valore sono solo metà del problema
Un outlier di valore è ciò che insegna la maggior parte dei tutorial di statistica. Pensate a una quantità che non rientra nell'intervallo normale di una metrica, a un campo a livello di record che viola il comportamento atteso o a un pattern in una misura che si discosta nettamente dalle norme storiche.
Questi metodi rispondono a domande come:
Questo valore è insolitamente alto o basso?
La distribuzione di questa metrica si è spostata?
Questo record sembra incoerente rispetto a record simili?
È utile per i segnali di frode, l'integrità dei sensori, la validazione delle feature e il monitoraggio dei KPI di business. Non basta per le data operations.
Gli outlier operativi minano la fiducia più rapidamente
Un outlier operativo è una deviazione nel modo in cui i dati si muovono, arrivano o cambiano forma. I valori possono essere tutti validi. La pipeline può persino segnalare un successo. Ma i dati restano inutilizzabili quando arrivano troppo tardi, arrivano parzialmente o non rispettano il pattern di caricamento previsto.
È proprio in questo vuoto che molti team vengono colti di sorpresa. La lacuna critica nei contenuti esistenti sugli outlier è la mancanza di indicazioni sugli outlier temporali e operativi. La maggior parte dei tutorial si concentra su IQR univariato o z-score, ma i guasti di qualità dei dati nel mondo reale riguardano spesso anomalie di tempestività, in cui i dati sono validi ma in ritardo. Uno studio del 2024 sulla data observability mostra che il 68% dei guasti delle pipeline deriva da latenza o caricamenti mancanti, non da outlier di valore , secondo questa sintesi della lacuna nell'insegnamento tradizionale sugli outlier.
Gli outlier operativi si presentano di solito come:
Arrivi in ritardo: una tabella arriva dopo che i modelli a valle sono già stati eseguiti.
Caricamenti mancanti: nessun errore evidente, solo un'assenza silenziosa dei dati attesi.
Anomalie di volume: un feed consegna molte meno o molte più righe del normale.
Stranezze strutturali: presenza di colonne o cambi di tipo che non sempre causano un errore immediato.
Un team che monitora solo i valori non vedrà questi problemi. Ecco perché i migliori metodi di identificazione degli outlier non sono un singolo algoritmo. Sono un modello di copertura. Servono tecniche per il cosa, il quando e il quanto.
Guida comparativa ai metodi di identificazione degli outlier
La scelta tra i metodi di identificazione degli outlier parte da una domanda. Che tipo di anomalia state cercando di intercettare? Una singola metrica asimmetrica richiede un approccio diverso rispetto a un flusso rumoroso di eventi dei clienti o a una tabella con molte colonne e numerosi attributi correlati.
Metodi statistici
I metodi statistici restano il punto di partenza giusto quando il problema è chiaro e la forma dei dati è gestibile. Sono interpretabili, veloci e facili da rendere operativi.
Lo z-score standard è familiare, ma ha un grave punto debole. Dipende dalla media e dalla deviazione standard, entrambe distorte dai valori estremi. Ciò lo rende fragile nei dataset di business, dove asimmetria, code pesanti e volatilità sono comuni.
Per le distribuzioni asimmetriche, l'opzione predefinita più solida è il Modified Z-Score. Le indicazioni del NIST sui test robusti per gli outlier raccomandano questo approccio basato sulla MAD per i dati asimmetrici. I potenziali outlier vengono segnalati quando il valore assoluto del modified z-score supera 3,5. Sostituisce la media con la mediana e la deviazione standard con la Median Absolute Deviation, rendendo la baseline molto meno sensibile ai punti estremi.
Usate i metodi statistici quando avete bisogno di:
Spiegabilità semplice: analisti e ingegneri possono capire perché un punto è stato segnalato.
Esecuzione rapida nel warehouse: mediana, quantili e metriche di dispersione sono spesso facili da calcolare in SQL.
Monitoraggio univariato stabile: adatto a KPI, conteggi di righe o controlli a livello di campo.
I punti deboli sono altrettanto importanti. Questi metodi non comprendono le interazioni tra le feature, e le varianti classiche producono spesso risultati rumorosi quando le ipotesi non corrispondono ai dati.
Metodi basati su distanza e densità
I metodi basati su distanza e densità sono utili quando la forma dei dati non è lineare e l'anomalia dipende dalla struttura del vicinato più che da una singola metrica.
Questa famiglia comprende approcci di tipo k-NN, LOF e DBSCAN. Sono più adatti ai problemi in cui un record è anomalo solo rispetto ai record vicini, non perché un singolo valore sia estremo.
DBSCAN è particolarmente pratico quando ci si aspettano cluster irregolari e rumore. La panoramica su DBSCAN in questa sintesi orientata ai benchmark lo descrive come un metodo basato sulla densità che identifica le anomalie tramite la divergenza della densità locale anziché tramite una partizione fissa. Questo lo rende utile nelle strutture complesse in cui le semplici soglie di distanza falliscono.
Un punto può essere perfettamente ordinario su ogni singola colonna ed essere comunque anomalo come combinazione.
Usate i metodi di densità quando i vostri dati hanno una forma, non solo una dispersione. Reti di eventi, pattern di produzione industriale e dati comportamentali semi-strutturati rientrano spesso in questa categoria. Il compromesso è la complessità computazionale e lo sforzo di tuning. I parametri di vicinato contano, e la spiegabilità può diventare più difficile per i non specialisti.
Metodi basati su modelli
I metodi basati su modelli comprendono famiglie come Isolation Forest e altri modelli di anomaly detection che apprendono il comportamento normale dai dati, invece di affidarsi a una regola codificata a mano. Sono interessanti quando la normalità cambia nel tempo o quando le interazioni tra le feature sono troppo complesse per soglie costruite manualmente.
Funzionano al meglio quando i team hanno bisogno di adattamento. I pattern stagionali cambiano. Il comportamento dei clienti si sposta. Le pipeline evolvono. Una soglia statica sensata lo scorso trimestre può diventare rapidamente inutile.
Il problema è operativo, non concettuale. I sistemi basati su modelli possono essere più difficili da debuggare. Quando scatta un alert, gli ingegneri devono comunque sapere cosa è cambiato e se il cambiamento è rilevante. In produzione, la spiegabilità determina spesso se i team si fidano abbastanza di un metodo da mantenerlo attivo.
Confronto tra metodi di rilevamento degli outlier
Tipo di metodo | Algoritmi di esempio | Ideale per | Punti di forza | Punti deboli |
|---|---|---|---|---|
Statistico | Z-Score, Modified Z-Score, IQR | Metriche singole, misure di business asimmetriche, monitor semplici | Veloce, interpretabile, facile da eseguire in SQL | Limitato per problemi multivariati e non lineari |
Basato sulla distanza | Approcci di tipo k-NN | Controlli di somiglianza tra record in dimensioni moderate | Logica di vicinato intuitiva | Sensibile a scala e dimensionalità |
Basato sulla densità | DBSCAN, LOF | Cluster irregolari, dataset rumorosi, anomalie locali | Gestisce bene strutture non lineari e rumore | Tuning dei parametri e costo computazionale |
Basato su modelli | Isolation Forest e modelli di anomaly detection correlati | Pattern in evoluzione, rilevamento di anomalie su feature miste | Flessibile, adattivo, utile su larga scala | Più difficile da spiegare e da calibrare in esercizio |
Una nota pratica. Ogni sistema di anomaly detection ha un problema di falsi positivi se i team ottimizzano solo la sensibilità. La stessa logica si ritrova nella sperimentazione. Se cercate un modello mentale utile per la disciplina delle soglie, questo articolo sulla gestione degli errori di tipo I nella sperimentazione merita una lettura, perché il rilevamento degli outlier subisce la stessa penalizzazione operativa quando i team generano alert su troppi segnali deboli.
Gestire dati ad alta dimensionalità e complessi
Molte indicazioni sugli outlier crollano non appena un dataset si allarga. Dieci colonne si possono ancora gestire con un'ispezione manuale. Cinquanta feature correlate di solito no. A quel punto i controlli univariati iniziano a sommergere i team di rumore o, peggio, a non vedere i record che contano.
Perché la logica univariata non regge
La scorciatoia più comune è eseguire z-score o controlli IQR separati su ogni campo. Sembra ragionevole finché le correlazioni non contano. Un record può collocarsi tranquillamente nell'intervallo normale su ogni singola colonna e rappresentare comunque una combinazione insolita nell'insieme della riga.
La nota regola secondo cui il 99,7% dei dati rientra entro 3 deviazioni standard vale solo per le distribuzioni normali. In molti dataset finanziari e sanitari, come osserva la spiegazione di Scribbr sulle ipotesi relative agli outlier , i dati reali sono invece spesso asimmetrici. In questi casi, approcci multivariati robusti come la distanza di Mahalanobis e le tecniche basate sulla MAD sono più adatti alla validazione a livello di record su feature correlate.
Nella pratica, i team si scontrano con la maledizione della dimensionalità. La distanza diventa meno intuitiva. L'ispezione visiva smette di aiutare. Le soglie semplici generano troppi casi limite da mantenere.
Cosa funziona meglio nei dataset con molte colonne
Per tabelle ampie e correlate, un set di strumenti più affidabile è questo:
Distanza di Mahalanobis: utile quando la struttura di correlazione conta e serve un punteggio di anomalia a livello di riga su molti campi.
Validazione basata sulla MAD: migliore della logica classica con media e deviazione standard quando le feature sono asimmetriche o a code pesanti.
Metodi basati sulla densità: più efficaci quando i record formano gruppi irregolari anziché cluster lineari ben definiti.
La scelta dipende dalla domanda a cui dovete rispondere. Se state validando record di clienti, profili di entità o dati a livello di sinistro, i metodi che tengono conto delle correlazioni superano di solito le regole isolate per colonna. Se state monitorando pattern in un feature store o in un grafo di eventi, i metodi di densità tendono a intercettare strutture che i controlli univariati non vedono.
Non chiedetevi se un valore è strano di per sé. Chiedetevi se il record resta plausibile quando si considerano insieme tutte le colonne rilevanti.
Un altro vincolo pratico è l'esecuzione. Il rilevamento ad alta dimensionalità diventa molto più utile quando potete calcolare le metriche dove i dati risiedono già. Estrarre tabelle di produzione ampie in notebook per la post-elaborazione genera latenza, problemi di governance e disallineamenti di versione tra analisi e monitoraggio. Per le pipeline critiche, l'esecuzione in-database è di solito la strada più pulita.
Rendere operativo il rilevamento: dalla teoria alla produzione
Anche i buoni metodi di identificazione degli outlier falliscono in produzione quando i team considerano l'algoritmo come l'intero sistema. L'algoritmo è solo un componente. Il sistema completo comprende gestione delle soglie, collocazione del calcolo, instradamento degli alert, responsabilità e workflow di indagine.
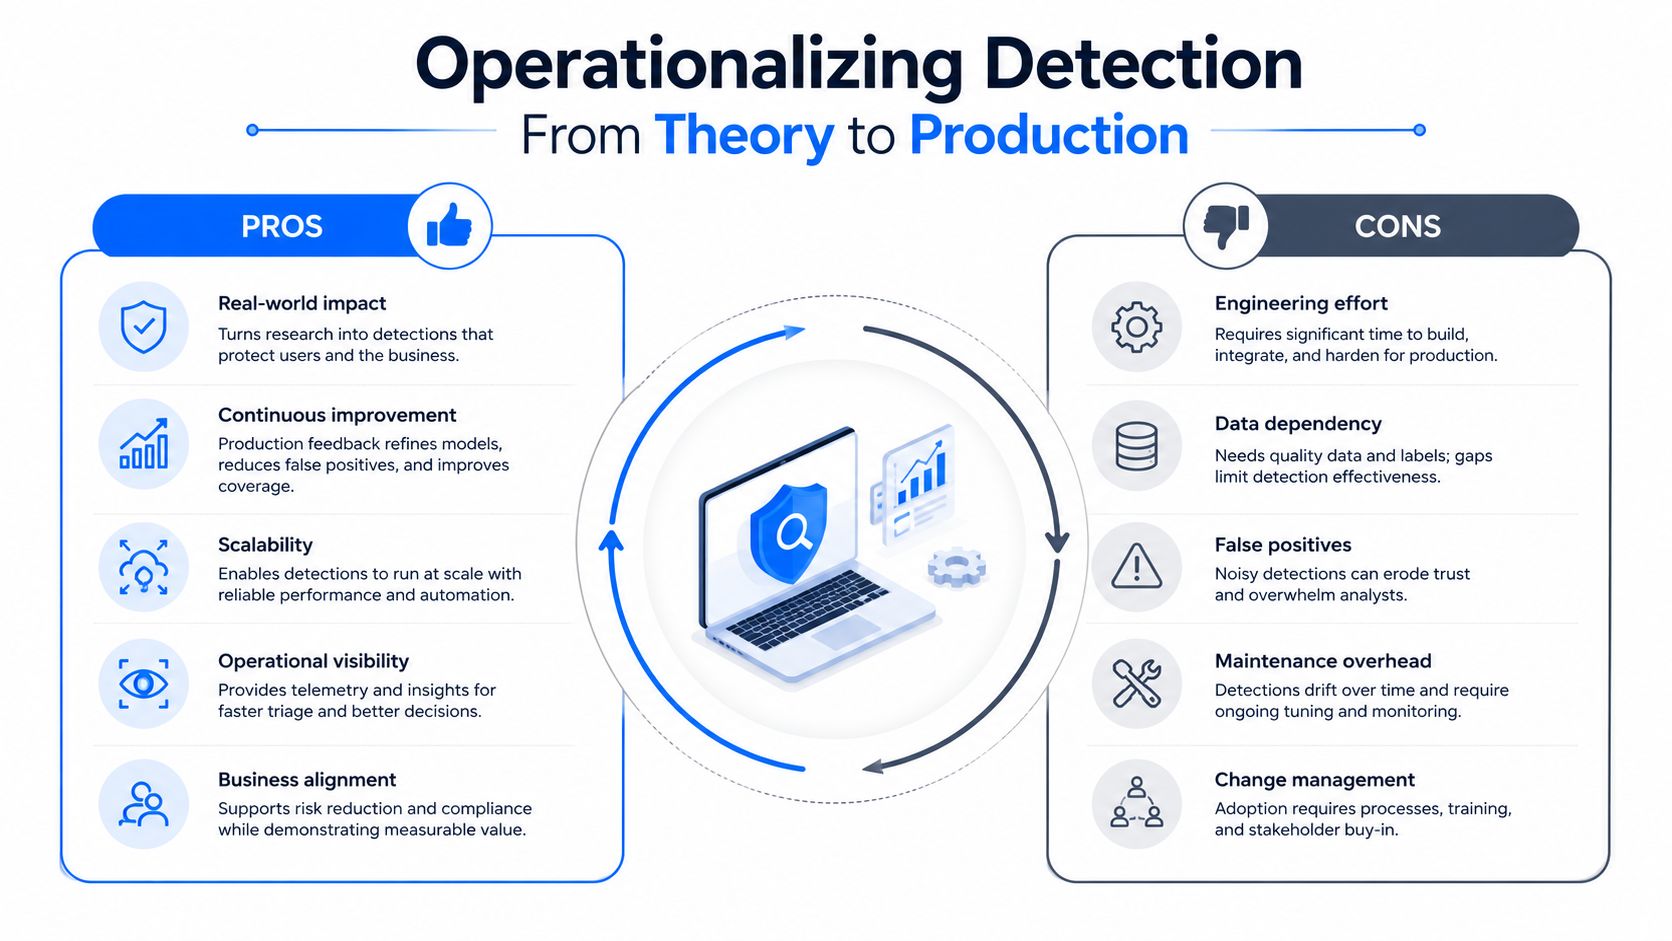
Partite dalla progettazione degli alert, non dalla scelta dell'algoritmo
Un alert che scatta di continuo non è una protezione. È rumore di fondo.
I team hanno bisogno di un metodo deliberato per decidere cosa deve allertare qualcuno, cosa deve aprire un ticket e cosa deve essere registrato per una revisione. I sistemi di anomaly detection basati sull'AI nelle piattaforme dati possono apprendere il comportamento normale dai pattern storici di volume, distribuzione e intervalli di valori, per poi segnalare automaticamente le deviazioni senza dipendere da fragili soglie statiche, come descritto nella panoramica della piattaforma digna.
Questo cambio di approccio è importante perché le soglie statiche invecchiano male. Non gestiscono bene i cambiamenti di trend, la stagionalità o la deriva graduale delle metriche. Le baseline apprese funzionano di solito meglio quando l'ambiente cambia spesso, ma richiedono comunque controlli su sensibilità e instradamento.
Una checklist utile per la produzione:
Definite prima la conseguenza. Un caricamento finanziario in ritardo e un'anomalia minore in staging non devono avere lo stesso percorso di escalation.
Pretendete la spiegabilità. Ogni alert deve dire agli ingegneri cosa è cambiato, dove e rispetto a quale baseline.
Separate le classi di monitor. Volume, tempestività, distribuzione e validazione dei record non devono confluire in un unico segnale indifferenziato.
Più avanti nel rollout, i team hanno di solito bisogno di un playbook di implementazione pratico. Questa guida su come automatizzare il rilevamento delle anomalie nei workflow di dati è un buon punto di riferimento per questo livello operativo.
Ecco una guida pratica utile per i team che riflettono sui pattern di produzione:
Mantenete il calcolo vicino ai dati
Inviare i dati in un altro ambiente per i controlli di anomalia crea spesso un problema di affidabilità a sé stante. Aggiunge spostamenti, ritardi e un ulteriore punto in cui i controlli di accesso possono cedere. Nella pratica, l'esecuzione nativa nel warehouse o in-database è di solito la scelta progettuale più sicura.
Questo approccio aiuta con tre problemi ricorrenti:
Scala: esportare ripetutamente grandi tabelle dei fatti è costoso.
Privacy: i record sensibili restano nell'ambiente controllato.
Coerenza: la logica di rilevamento opera sugli stessi dati usati da dashboard e modelli.
Il rilevamento delle anomalie in produzione dovrebbe essere noioso da gestire. Se richiede di sorvegliare costantemente le soglie, non è ancora pronto per la produzione.
Integrare il rilevamento nella vostra pipeline di data observability
La configurazione più affidabile non è un singolo detector. È una pipeline a livelli in cui diversi metodi di identificazione degli outlier coprono diverse modalità di guasto. È questo che trasforma il rilevamento delle anomalie da esercizio in un notebook a salvaguardia operativa.
Un pattern di monitoraggio a livelli
Una pipeline di observability in produzione dovrebbe di solito funzionare per livelli.
Primo, verificate il comportamento di arrivo. I moduli di monitoraggio della tempestività possono usare orari di arrivo attesi appresi dall'AI insieme a pianificazioni definite dall'utente per rilevare dati in ritardo o mancanti prima che le dashboard ne risentano, e alcune piattaforme supportano ora impostazioni di notifica specifiche per modulo per ridurre l'alert fatigue degli ingegneri, come descritto in questo resoconto sugli aggiornamenti del monitoraggio della tempestività.
Secondo, monitorate il comportamento aggregato. Variazioni di volume, esplosioni di valori null e spostamenti di distribuzione rivelano spesso guasti a monte più rapidamente dei reclami a valle.
Terzo, validate i record. Alcuni guasti non sono né problemi di tempistica né anomalie aggregate. Sono violazioni di business a livello di riga che emergono solo quando si testano i record reali rispetto alle regole di dominio.
Cosa deve offrire un workflow di produzione
Quando i team integrano correttamente il rilevamento, il workflow dovrebbe supportare tutti questi risultati:
Triage rapido: gli ingegneri capiscono se il problema riguarda l'arrivo, la forma, la distribuzione o le regole di business.
Visibilità condivisa: analisti, platform engineer e team di governance possono consultare la stessa cronologia dei segnali.
Spostamenti minimi: il rilevamento viene eseguito dove i dati risiedono già.
Alert mirati: le diverse classi di anomalie vengono instradate alle persone in grado di risolverle.
Se il vostro stack attuale tratta l'observability solo come controlli di freschezza o solo come controlli di schema, la copertura è incompleta. Una configurazione moderna ha bisogno che tutti i livelli lavorino insieme. Per una visione più ampia di questo modello operativo, questa panoramica sulla data observability nella pratica è un'utile lettura complementare.
Un dettaglio conta più di quanto i team si aspettino. L'output deve essere leggibile dal punto di vista operativo. Un alert che dice “anomalia rilevata” non basta. Gli ingegneri hanno bisogno della baseline, della tabella o metrica interessata, del contesto temporale e di un modo per approfondire i record modificati.
Conclusione: costruire una fiducia proattiva nei vostri dati
In definitiva, il rilevamento degli outlier riguarda la fiducia. Non l'eleganza statistica. Non la novità dei modelli. La fiducia che una dashboard rifletta la realtà, che una tabella di feature sia sicura da usare e che una pipeline segnalata come riuscita abbia consegnato dati utilizzabili.
I metodi di identificazione degli outlier giusti dipendono dalla modalità di guasto. I controlli statistici basati sulla MAD sono efficaci per le metriche asimmetriche. I metodi di densità e multivariati sono migliori per i pattern di record complessi. Il monitoraggio della tempestività intercetta una classe di guasti che i normali metodi basati sui valori non vedranno mai. In produzione, l'approccio vincente è quasi sempre a livelli.
I team che lo fanno bene smettono di considerare i dati errati come una sorpresa occasionale. Costruiscono sistemi che si aspettano deriva, ritardi, record strani e baseline in movimento, e fanno emergere questi problemi prima che li scoprano gli utenti di business.
Le piattaforme dati affidabili non nascono perché un warehouse è veloce o un orchestratore è verde. Nascono perché qualcuno le ha progettate per i guasti silenziosi.
Se volete passare da script di anomalia improvvisati a un monitoraggio continuo in-database, digna offre ai team dati un modo pratico per rilevare anomalie, validare record, monitorare la tempestività e indagare sui problemi senza spostare i dati di produzione fuori dal proprio ambiente.
Per l'approccio con baseline apprese che questa guida raccomanda al posto di fragili soglie statiche, applicato a volumi, distribuzioni e valori nel database, consultate digna Data Anomalies.
Domande frequenti
Quali sono i principali metodi di identificazione degli outlier?
L'articolo li raggruppa in quattro famiglie: metodi statistici come z-score, Modified Z-Score e IQR; approcci k-NN basati sulla distanza; metodi basati sulla densità come DBSCAN e LOF; e metodi basati su modelli come Isolation Forest. Ognuno si adatta a una diversa forma dei dati, dalle singole metriche asimmetriche alle tabelle ampie e correlate.
Quando usare il Modified Z-Score invece dello z-score standard?
Usatelo per i dati asimmetrici. Lo z-score standard si basa su media e deviazione standard, che i valori estremi distorcono. Il Modified Z-Score, raccomandato dal NIST, usa invece la mediana e la Median Absolute Deviation e segnala i potenziali outlier quando il punteggio assoluto supera 3,5.
Che cos'è un outlier operativo in una pipeline di dati?
Un outlier operativo è una deviazione nel modo in cui i dati si muovono, arrivano o cambiano forma, anche quando ogni valore è valido. Esempi tipici sono arrivi in ritardo, caricamenti mancanti, anomalie di volume e stranezze strutturali. Uno studio del 2024 citato nell'articolo attribuisce il 68% dei guasti delle pipeline a latenza o caricamenti mancanti.
Come si rilevano gli outlier nei dati ad alta dimensionalità?
I controlli z-score o IQR per colonna non reggono, perché una riga può sembrare normale su ogni colonna ed essere comunque una combinazione insolita. Per tabelle ampie e correlate, l'articolo raccomanda la distanza di Mahalanobis per il punteggio a livello di riga, la validazione basata sulla MAD per le feature asimmetriche e i metodi di densità quando i record formano gruppi irregolari.
Come si riducono i falsi positivi nel rilevamento degli outlier?
Progettate gli alert prima di scegliere un algoritmo. Definite prima la conseguenza, così che un caricamento finanziario in ritardo e un'anomalia minore in staging abbiano escalation diverse, pretendete che ogni alert indichi cosa è cambiato e rispetto a quale baseline, e mantenete come classi separate i monitor di volume, tempestività, distribuzione e validazione dei record.


