Guida all'integrazione della qualità dei dati per le piattaforme enterprise
|
7
min di lettura

Il vostro warehouse dice che il caricamento è andato a buon fine. La dashboard però sembra ancora sbagliata. Il reparto finanza ha già notato il grafico dei ricavi non aggiornato, l'engineering sta inseguendo una modifica di schema che nessuno ha registrato e il team dati fissa alert che continuano ad arrivare molto tempo dopo che qualcuno avrebbe avuto il contesto per intervenire. È questa la forma quotidiana dell'integrazione della qualità dei dati in uno stack moderno, ed è per questo che i controlli aggiunti a posteriori continuano a cedere non appena schemi, sorgenti e regole di business iniziano a cambiare di continuo.
Indice
Perché l'integrazione della qualità dei dati è importante oggi
Spesso i team non falliscono perché mancano i controlli. Falliscono perché i controlli si trovano nel posto sbagliato. Un livello di monitoraggio separato può intercettare i dati errati solo dopo che sono già stati caricati, replicati, trasformati e sono arrivati a una dashboard di cui qualcuno si fida: troppo tardi per una correzione semplice e troppo presto perché il business perdoni l'errore.
Ecco perché oggi la qualità appartiene al livello di integrazione. Il mercato dell'integrazione continua a espandersi: una stima colloca la data integration globale a 14,33 miliardi di dollari nel 2026 e a 22,17 miliardi di dollari entro il 2031, mentre un'altra prevede una crescita da 17,58 miliardi di dollari nel 2025 a 33,24 miliardi di dollari entro il 2030; un segnale che l'integrazione sta diventando il luogo in cui risiedono validazione, controlli di tempestività e tracciamento dello schema, e non solo quello in cui avviene il semplice spostamento dei dati grezzi (statistiche di Peliqan sulla data integration). Nella stessa fonte, il 64% delle organizzazioni indica la qualità dei dati come la principale sfida per l'integrità dei dati, il che spiega perché i team integrano i controlli nelle pipeline invece di chiedere agli analisti di individuare i difetti a valle.
Perché il monitoraggio aggiunto a posteriori continua a fallire
L'alert fatigue è di solito il primo segnale d'allarme. Quando gli operatori sono già sommersi da troppe notifiche, un altro motore di regole aggiunge solo rumore, soprattutto se il sistema non sa distinguere tra un guasto reale e una deviazione innocua dell'attività di business. Il problema più profondo è che le regole statiche invecchiano male quando sorgenti, schemi e pattern di caricamento cambiano insieme.
Il pattern migliore consiste nel calcolare i controlli dove i dati si muovono, non dove le persone li ispezionano in seguito. Questo velocizza la gestione degli incidenti, perché i segnali di lineage, freschezza e validazione puntano allo stesso stadio della pipeline, invece di mandare i team in una caccia al tesoro tra strumenti diversi. Riduce anche il divario di pulizia, poiché i guasti di integrazione sono più facili da isolare prima che si propaghino a BI, ML ed esportazioni operative.
Regola pratica: se il difetto può essere rilevato prima che i dati lascino la pipeline, controllatelo lì per primo.
Architettura di base e dimensioni della qualità
L'architettura giusta dipende da cosa dovete intercettare, da quanto rapidamente dovete farlo e da quanto controllo dovete preservare. L'integrazione della qualità dei dati moderna ricade di solito in uno di tre pattern: calcolo delle metriche in-database, servizi di scansione esterni o controlli integrati nelle pipeline, con i design ibridi che stanno diventando l'opzione più pratica per gli stack enterprise.
La chiave di valutazione comune resta quella delle sei dimensioni: accuratezza, completezza, coerenza, tempestività, validità e unicità (revisione accademica dei flussi di integrazione; framework di qualità dei dati ampiamente utilizzato). Queste dimensioni offrono un modo pulito per confrontare le architetture senza perdersi nel linguaggio dei vendor o in dashboard piene di metriche di facciata. Mantengono inoltre la discussione ancorata a ciò che il business percepisce: record mancanti, arrivi in ritardo, chiavi duplicate e valori incompatibili tra sistemi.
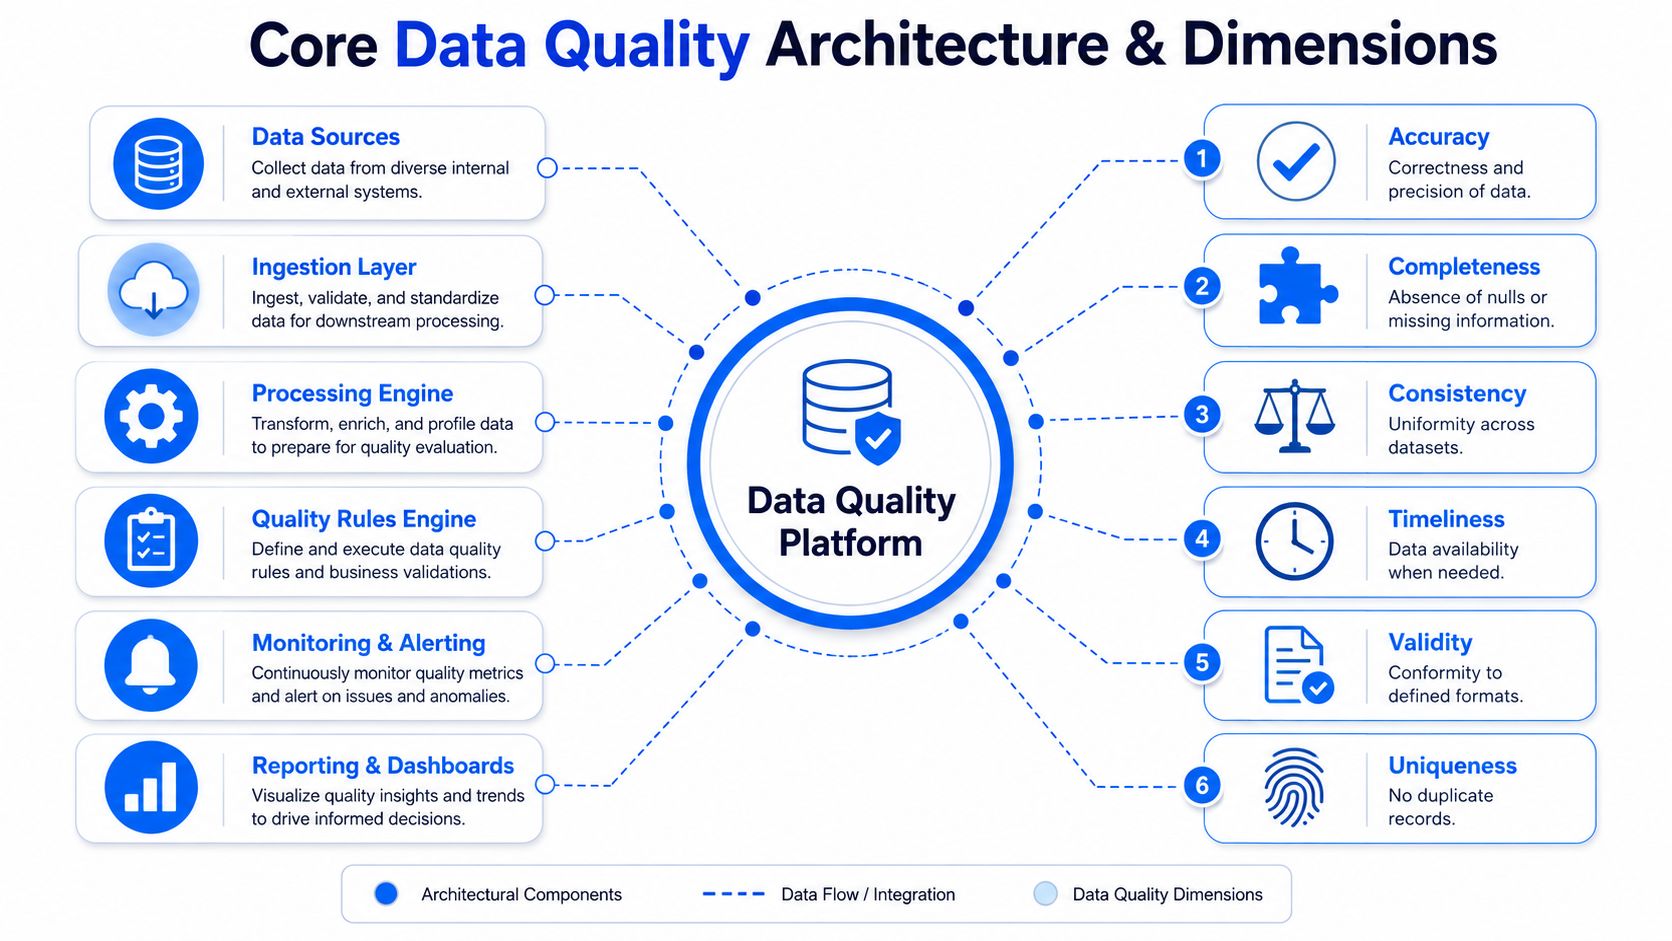
Dove si colloca ciascuna architettura
I controlli in-database funzionano bene quando volete che i dati restino nell'ambiente del cliente ed evitare di spostare record sensibili verso un altro servizio. Questo pattern è ideale per stack sensibili alla privacy, ambienti regolamentati e contesti in cui un rilevamento delle anomalie a bassa latenza conta più della cura dell'interfaccia.
I servizi di scansione esterni hanno senso quando serve una scansione ampia su molte sorgenti e non è un problema inviare metadati o estratti a un servizio separato. Sono spesso più rapidi da introdurre, ma possono diventare una seconda superficie operativa se ogni modifica di schema o aggiornamento delle regole deve essere replicato fuori dal warehouse.
I controlli integrati nelle pipeline sono il modo più diretto per validare i record in fase di ingestione o trasformazione. Sono utili quando la modalità di guasto è evidente, ad esempio per rifiutare payload malformati, ma possono diventare fragili se ogni nuova regola di business si trasforma in un blocco codificato a mano.
In produzione, un modello ibrido è di solito il meno doloroso. Baseline statistiche e rilevamento delle anomalie gestiscono i pattern che cambiano, mentre regole di validazione esplicite coprono la logica di business che interessa agli auditor. È anche qui che il baselining adattivo conta più di una pila di regole statiche, perché un warehouse non resta fermo abbastanza a lungo perché le vecchie soglie restino affidabili per sempre.
Questa guida alle dimensioni della qualità dei dati e alla loro misurazione è un utile complemento se volete associare le sei dimensioni a KPI concreti senza strumentare eccessivamente ogni tabella.
Punto chiave: usate regole statiche per ciò che non deve mai cambiare e baseline per i pattern che derivano naturalmente.
Punti di integrazione tra warehouse, data lake e pipeline
Il lavoro di progettazione inizia quando i controlli di qualità toccano uno stack in produzione. Warehouse, data lake e pipeline orchestrate espongono ciascuno punti di giunzione diversi, e i team migliori agganciano i controlli ai punti di giunzione già esistenti invece di inventare un ulteriore livello di revisione attorno a essi. Di solito questo significa validazione in fase di ingestione, controlli mirati durante la trasformazione e un ulteriore passaggio prima dei modelli semantici o del consumo in BI.
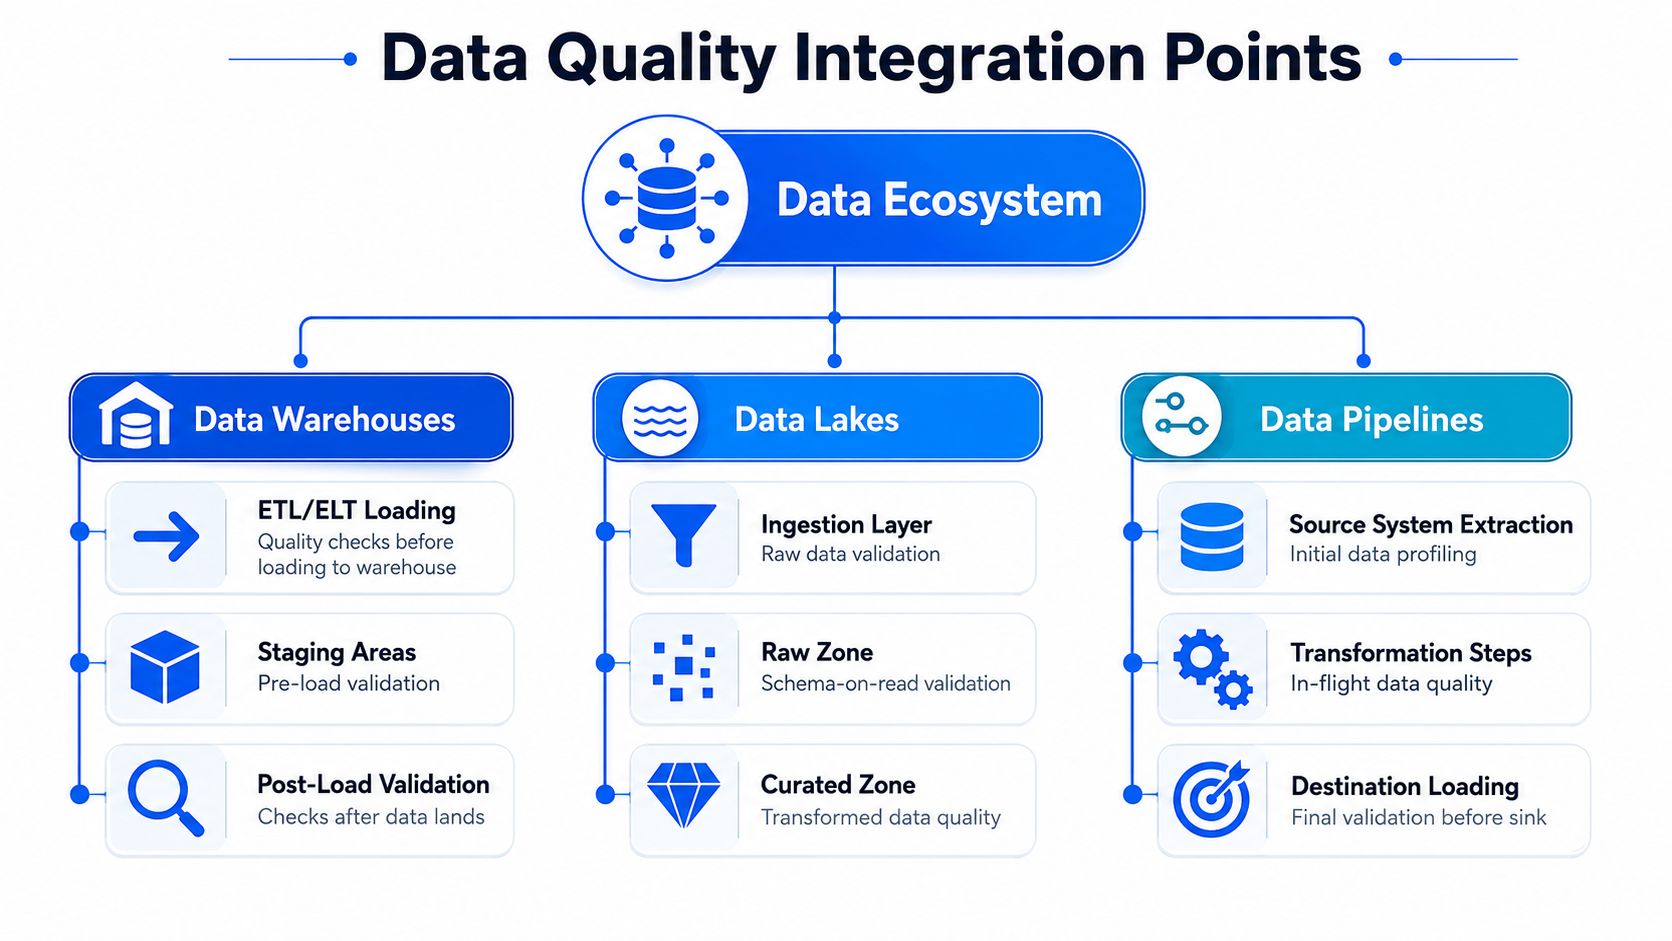
Dove agganciare i controlli
Nei warehouse, i punti di pressione migliori sono il caricamento ETL o ELT, le aree di staging e la validazione post-caricamento. Nei data lake, la suddivisione utile è tra ingestione, raw zone e curated zone, perché i problemi di schema-on-read raramente emergono finché una query non richiede un campo che non si comporta più come il resto del payload. Nelle pipeline, l'estrazione dalla sorgente, le fasi di trasformazione e il caricamento nella destinazione offrono ciascuno un'occasione diversa per intercettare i difetti prima che si accumulino.
Punto di integrazione | Controlli di qualità principali | Modalità di esecuzione |
|---|---|---|
Caricamento ETL o ELT | Controlli di schema, controlli sui valori nulli, conteggio dei record | Batch o quasi in tempo reale |
Aree di staging | Validazione dei tipi, rilevamento dei duplicati, controlli referenziali | Batch |
Validazione post-caricamento | Controlli di freschezza, controlli di anomalie sugli aggregati | Batch più monitoraggio pianificato |
Livello di ingestione | Validazione del payload grezzo, controlli di completezza | Streaming o batch |
Raw zone | Rilevamento dello schema drift, profilazione di base | Batch |
Curated zone | Coerenza tra sistemi, standardizzazione dei valori | Batch |
Estrazione dal sistema sorgente | Profilazione iniziale, completezza dell'estrazione | Pianificata |
Fasi di trasformazione | Controlli sull'inflazione da join, validazione delle regole | Durante l'elaborazione |
Caricamento nella destinazione | Validazione finale prima della destinazione | Batch o quasi in tempo reale |
Se state confrontando le opzioni ELT ed ETL, l'articolo su come ottimizzare le scelte di pipeline dei dati è un riferimento solido per capire come la forma della pipeline cambi il punto in cui dovrebbe trovarsi il controllo. La decisione architetturale è importante perché più lavoro spingete a valle, più diventa difficile spiegare un guasto quando gli utenti di business stanno già consumando l'output.
In pratica, l'esecuzione in-database mantiene i dati nell'ambiente del cliente, alimentando comunque una dashboard unificata. Questo conta per le aziende che non vogliono un'ulteriore copia di dati sensibili in circolazione solo per validare un caricamento. Si adatta anche meglio al tracciamento dello schema, poiché i metadati del warehouse possono essere usati per segnalare colonne aggiunte o rimosse senza riesportare i dati stessi.
Per una visione specifica del warehouse, i pattern di integrazione del data warehouse aiutano a capire come la stessa logica di controllo si comporti diversamente nei livelli di staging, trasformazione e serving.
Esempi di controlli di validazione da eseguire già oggi
I successi più rapidi sono noiosi, ed è un bene. Iniziate con controlli che intercettano i guasti che le persone percepiscono, poi collegate i risultati a ciò che il vostro team usa già per la revisione degli incidenti. Un controllo di validazione è utile solo se indica un difetto su cui qualcuno può intervenire prima che i dati errati si diffondano.
I controlli che intercettano i guasti reali
I controlli su valori nulli e completezza dovrebbero segnalare i campi obbligatori mancanti prima che i join a valle falliscano o che le estrazioni per la compliance risultino vuote. Il trigger è semplice: un campo supera la soglia accettabile di valori mancanti, e l'output dovrebbe indicare quale tabella, colonna e finestra di caricamento hanno subito la deriva. Questo intercetta regressioni nei sistemi sorgente, arricchimenti falliti e passaggi di consegna interrotti dai team a monte.
I controlli di freschezza contano quando il business presume che un feed sia aggiornato. La versione migliore confronta l'arrivo effettivo con il pattern di arrivo appreso o con la pianificazione, quindi segnala il ritardo come un problema dei dati, non solo come un problema del job. Questo intercetta caricamenti in ritardo, connettori bloccati e problemi di orchestrazione che altrimenti emergerebbero come dashboard non aggiornate.
I controlli di unicità e sui duplicati vanno applicati a chiavi di join, chiavi naturali e identificativi di business. Se la stessa entità inizia a comparire più di una volta, volete che l'output mostri lo spazio di chiavi che si è gonfiato, non solo un conteggio generico dei duplicati. Questo intercetta messaggi rielaborati, errori di merge e deduplicazioni fallite lato sorgente.
I controlli sullo schema drift dovrebbero scattare quando il tipo di una colonna cambia, un campo scompare o una nuova colonna compare dove i modelli a valle si aspettano stabilità. L'output deve includere la modifica strutturale esatta, così che il responsabile giusto possa decidere se accettarla, mapparla o bloccarla. È il controllo che evita ai team di passare mezzo sprint a fare il debug di un problema di parsing silenzioso.
Regola pratica: se un controllo non sa dirvi cosa è cambiato, non è pronto per la produzione.
La checklist seguente è quella che inserirei per prima in un runbook:
Validazione dello schema: verificate che la struttura in ingresso corrisponda ancora al contratto.
Controlli sui valori nulli: contate i campi essenziali mancanti prima che raggiungano la logica a valle.
Rilevamento dei record duplicati: segnalate gli identificativi ripetuti prima che distorcano gli aggregati.
Controlli di intervallo e formato: bloccate subito valori impossibili e stringhe malformate.
Integrità referenziale: verificate che i record correlati puntino ancora a record padre validi.
Coerenza tra sistemi: confrontate la stessa entità di business tra i diversi sistemi sorgente.
Freschezza e latenza: monitorate se i dati sono arrivati quando previsto.

Deployment, test e monitoraggio continuo
Il rollout più pulito che abbia visto è partito da un unico dominio ad alto impatto e da un piccolo insieme di metriche legate a problemi reali del business. Il team ha prima profilato le tabelle sorgente, ha raccolto statistiche di baseline su valori mancanti, tipi di dato, lunghezze e pattern ricorrenti, poi le ha trasformate in regole leggibili dalle macchine prima di attivare gli alert. Questa sequenza ha funzionato perché ha dato agli operatori un punto di riferimento prima di iniziare a giudicare un cambiamento come positivo o negativo.
Il rollout prima della scalabilità
Un buon percorso di deployment segue di solito le fasi di audit, definizione delle metriche, profilazione, pulizia o validazione e infine monitoraggio, in linea con le indicazioni pratiche degli step per migliorare la qualità dei dati. La chiave è mantenere un perimetro abbastanza ristretto da poter tracciare ogni alert e spiegare ogni falso positivo. I piani di rollout troppo ampi spesso falliscono perché nessuno dispone di una baseline pulita di come appariva la normalità prima dell'attivazione delle regole.
Una volta pronte le regole, i gate di validazione in stile CI sono utili. I controlli canary su un mirror di produzione intercettano i difetti di trasformazione prima che raggiungano la destinazione attiva, e il rilevamento delle anomalie in shadow mode dà al team il tempo di tarare le soglie senza interrompere la consegna. È a questo punto che la lineage diventa un requisito di primo piano, perché se compare un difetto il team deve sapere dove è entrato e quali asset a valle lo hanno ereditato.
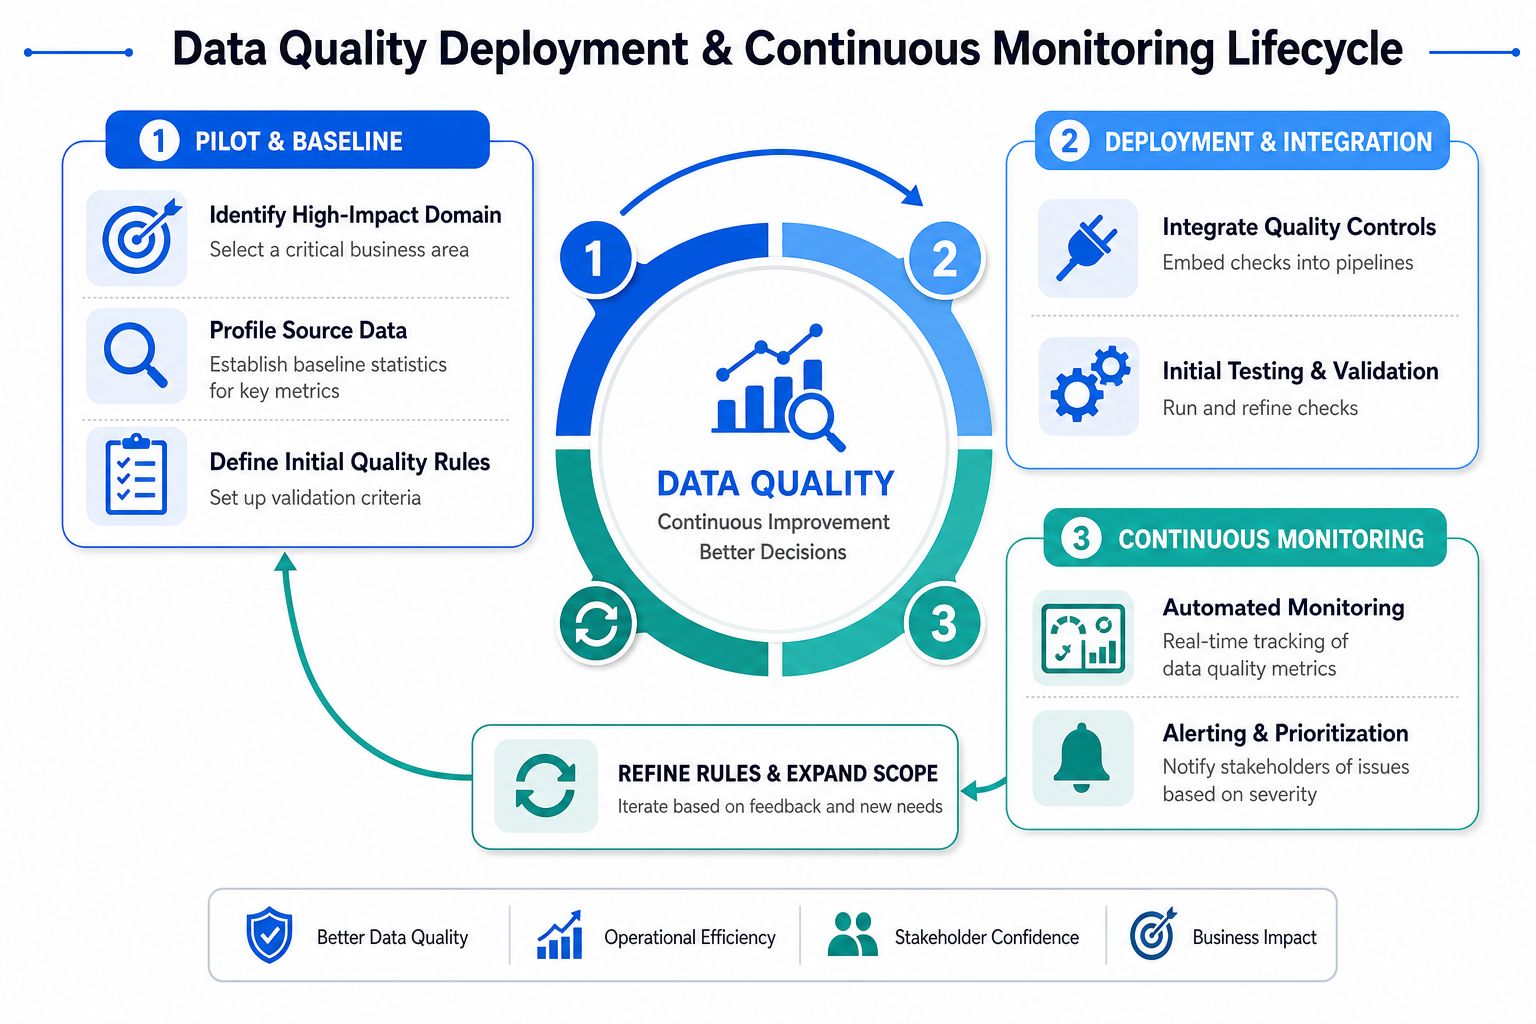
Una sequenza pratica si presenta così.
Prima la profilazione. Misurate lo stato attuale e registrate la baseline.
Strumentate la pipeline. Inserite i controlli nel percorso di ingestione e trasformazione.
Osservate attentamente le prime settimane. Confrontate anomalie, regole non superate ed errori di trasformazione con la baseline.
Affinate le regole. Mantenete ciò che intercetta difetti reali, eliminate ciò che aggiunge solo rumore.
Se volete un esempio di piattaforma, digna esegue le analisi all'interno di database controllati dal cliente e combina rilevamento delle anomalie, controlli di tempestività, tracciamento dello schema e validazione a livello di record senza spostare i dati in un ambiente di esecuzione separato. Questo design è adatto quando il rollout richiede sia monitoraggio operativo sia un'esecuzione compatibile con gli audit.
Alerting, priorità e riduzione del rumore
Rilevare costa poco. È nella definizione delle priorità che i team costruiscono la fiducia o la bruciano. Se ogni picco di valori nulli, ogni piccolo ritardo e ogni nota innocua sullo schema diventa una chiamata di reperibilità, il gruppo on-call smette di considerare la qualità dei dati come qualcosa di operativamente reale e inizia a trattarla come un brusio di sottofondo.
Un instradamento per severità che le persone useranno davvero
Il modello di alert più semplice ha tre livelli: data-down, degradato e informativo. Data-down significa che il processo di business è interrotto o che il consumatore a valle dovrebbe smettere di fidarsi del feed. Degradato significa che la pipeline funziona ancora, ma il segnale di qualità ha superato una soglia che incide sull'interpretazione. Gli alert informativi dovrebbero essere instradati verso dashboard o canali di riepilogo, non verso chiamate in tempo reale.
L'instradamento in base alla responsabilità conta quanto la severità. Inviate l'alert al team responsabile della sorgente, della trasformazione o del livello di consumo in cui è entrato il difetto, e includete nel messaggio il perimetro della tabella o del campo. Anche le finestre di soppressione aiutano, soprattutto quando un incidente noto a monte crea lo stesso sintomo su più controlli a valle.
Non fate scattare una chiamata per ogni sintomo. Fatela scattare per la prima causa principale, poi deduplicate il resto.
Il rilevamento delle anomalie abbinato al monitoraggio della tempestività riduce di solito il rumore meglio di una configurazione con una regola per ogni condizione, perché riduce il numero di eccezioni codificate a mano che richiedono manutenzione costante. Gestisce anche i casi che la logica statica non vede, come un feed che arriva puntuale ma con una distribuzione insolita, o un feed che cambia forma pur arrivando entro la normale finestra del job.
Come soglia pratica, farei scattare una chiamata solo quando un difetto blocca un consumatore, viola un contratto o corrompe un output regolamentato. Userei Slack o Teams per i degradi che richiedono attenzione ma non una risposta immediata, e lascerei i segnali informativi nella dashboard a meno che non si raggruppino ripetutamente in un pattern reale. Questo tipo di instradamento mantiene leggibile il flusso degli alert, ed è la differenza tra un sistema di monitoraggio e una cascata di notifiche.
Best practice di governance per una qualità sostenibile
Un programma duraturo ha bisogno di più dei soli controlli. Ha bisogno di un ciclo di governance che mantenga i controlli allineati con il business, con gli auditor e con i team di engineering che devono convivere con il risultato. La spina dorsale resta semplice: catalogare i dati, profilarli, definire le regole di business, coinvolgere gli stakeholder e monitorare i KPI in modo continuo, così che il programma non decada dopo il primo ciclo di lancio.
È qui che il compromesso diventa concreto. La massima automazione accelera la consegna, ma può erodere la verificabilità se i controlli sono nascosti all'interno di strumenti opachi. Il massimo controllo soddisfa gli auditor, ma rallenta i team di analytics quando ogni modifica di schema diventa una revisione manuale. La risposta migliore è un modello ibrido in cui la validazione avviene vicino ai dati, all'interno di ambienti controllati dal cliente, con un supporto esplicito per data contract, governance dello schema e governance delle versioni.
Se state valutando framework di controllo più ampi, la panoramica sulle migliori soluzioni GRC per le aziende offre un contesto utile su come i programmi di governance collegano rischio, compliance e disciplina operativa. Questa prospettiva più ampia conta perché la qualità dei dati non è solo un'attività tecnica di igiene: fa parte del modo in cui l'azienda dimostra la propria affidabilità nel tempo.
Il modello operativo che regge è semplice. Mantenete i controlli vicini alla sorgente, mantenete visibile l'audit trail e coinvolgete il responsabile di business quando l'insieme delle regole cambia. Questa combinazione vi dà abbastanza automazione per muovervi rapidamente senza rinunciare alla traccia documentale di cui hanno bisogno i team regolamentati.
Se state cercando di evitare che dashboard non aggiornate, schema drift e alert rumorosi diventino la normalità, digna è progettata per eseguire i controlli all'interno dei vostri database e sorvegliare tempestività, modifiche di schema, anomalie e regole di validazione senza spostare i dati in un livello di esecuzione separato. Visitate digna per vedere come questo approccio si adatta al vostro stack di warehouse, data lake o pipeline, poi mappate un dominio critico e iniziate con i controlli che faranno risparmiare più tempo al vostro team la prossima settimana.
Prima di decidere dove agganciare i controlli in-database nel vostro stack di warehouse, data lake o pipeline, verificate a quali database e piattaforme si connette digna.
Domande frequenti
Che cos'è l'integrazione della qualità dei dati?
L'integrazione della qualità dei dati consiste nel calcolare i controlli di qualità dove i dati si muovono, cioè durante ingestione, trasformazione e caricamento, invece che in un livello di monitoraggio separato aggiunto a posteriori. L'articolo riporta che il 64% delle organizzazioni indica la qualità dei dati come principale sfida per l'integrità dei dati, motivo per cui i team integrano validazione, controlli di tempestività e tracciamento dello schema nelle pipeline.
Quali architetture si usano per i controlli di qualità dei dati sulle piattaforme enterprise?
Prevalgono tre pattern: calcolo delle metriche in-database, servizi di scansione esterni e controlli integrati nelle pipeline. L'approccio in-database è adatto a stack regolamentati e sensibili alla privacy perché i dati restano dove sono; gli scanner si introducono rapidamente ma aggiungono una seconda superficie operativa; i controlli integrati rifiutano direttamente i payload malformati. Un ibrido di baseline statistiche e regole esplicite è di solito la soluzione meno dolorosa.
Dove vanno collocati i controlli di qualità dei dati in un data warehouse o in un data lake?
Agganciate i controlli ai punti di giunzione già esistenti. Nei warehouse, ciò significa caricamento ETL o ELT, aree di staging e validazione post-caricamento. Nei data lake, distribuite i controlli tra ingestione, raw zone e curated zone. Nelle pipeline, l'estrazione dalla sorgente, le fasi di trasformazione e il caricamento nella destinazione offrono ciascuno un'occasione distinta per intercettare i difetti.
Quali controlli di validazione dei dati conviene eseguire per primi?
Iniziate con i controlli i cui guasti le persone percepiscono: controlli su valori nulli e completezza, freschezza rispetto ai pattern di arrivo appresi, unicità su chiavi di join e di business e controlli sullo schema drift. La checklist del runbook aggiunge controlli di intervallo e formato, integrità referenziale e coerenza tra sistemi. Ogni controllo dovrebbe indicare esattamente cosa è cambiato, non solo che qualcosa è fallito.
Come si riduce il rumore degli alert sulla qualità dei dati?
Usate tre livelli di severità: data-down, degradato e informativo. Fate scattare una chiamata solo quando un difetto blocca un consumatore, viola un contratto o corrompe un output regolamentato, inviate i degradi su Slack o Teams e lasciate i segnali informativi nelle dashboard. Instradate gli alert al team responsabile, fate scattare la chiamata per la prima causa principale, poi deduplicate il resto.


