Playbook per l'implementazione della data quality per i data team moderni
|
7
min di lettura

Le vostre dashboard sono di nuovo non aggiornate, una pipeline è fallita durante la notte e la prima domanda del mattino è sempre la stessa: “Possiamo fidarci di questo numero?” È una sfida comune per molti team che si occupano di implementazione della data quality quando data warehouse, data lake e livello BI sono già in produzione. La soluzione non è l'ennesimo sprint di pulizia, ma costruire controlli che impediscano ai dati errati di diventare un problema di qualcun altro.
Un programma efficace parte da un'idea semplice: solo una piccola parte dei dati comporta davvero il rischio di business. I team che hanno successo smettono di trattare la qualità come un progetto una tantum e iniziano a trattarla come un'attività operativa, con ownership, soglie e alert integrati nella pipeline che le persone già gestiscono.
Indice
Perché l'implementazione della data quality fallisce senza un sistema di controllo
Identificare i critical data element e definire soglie a livelli
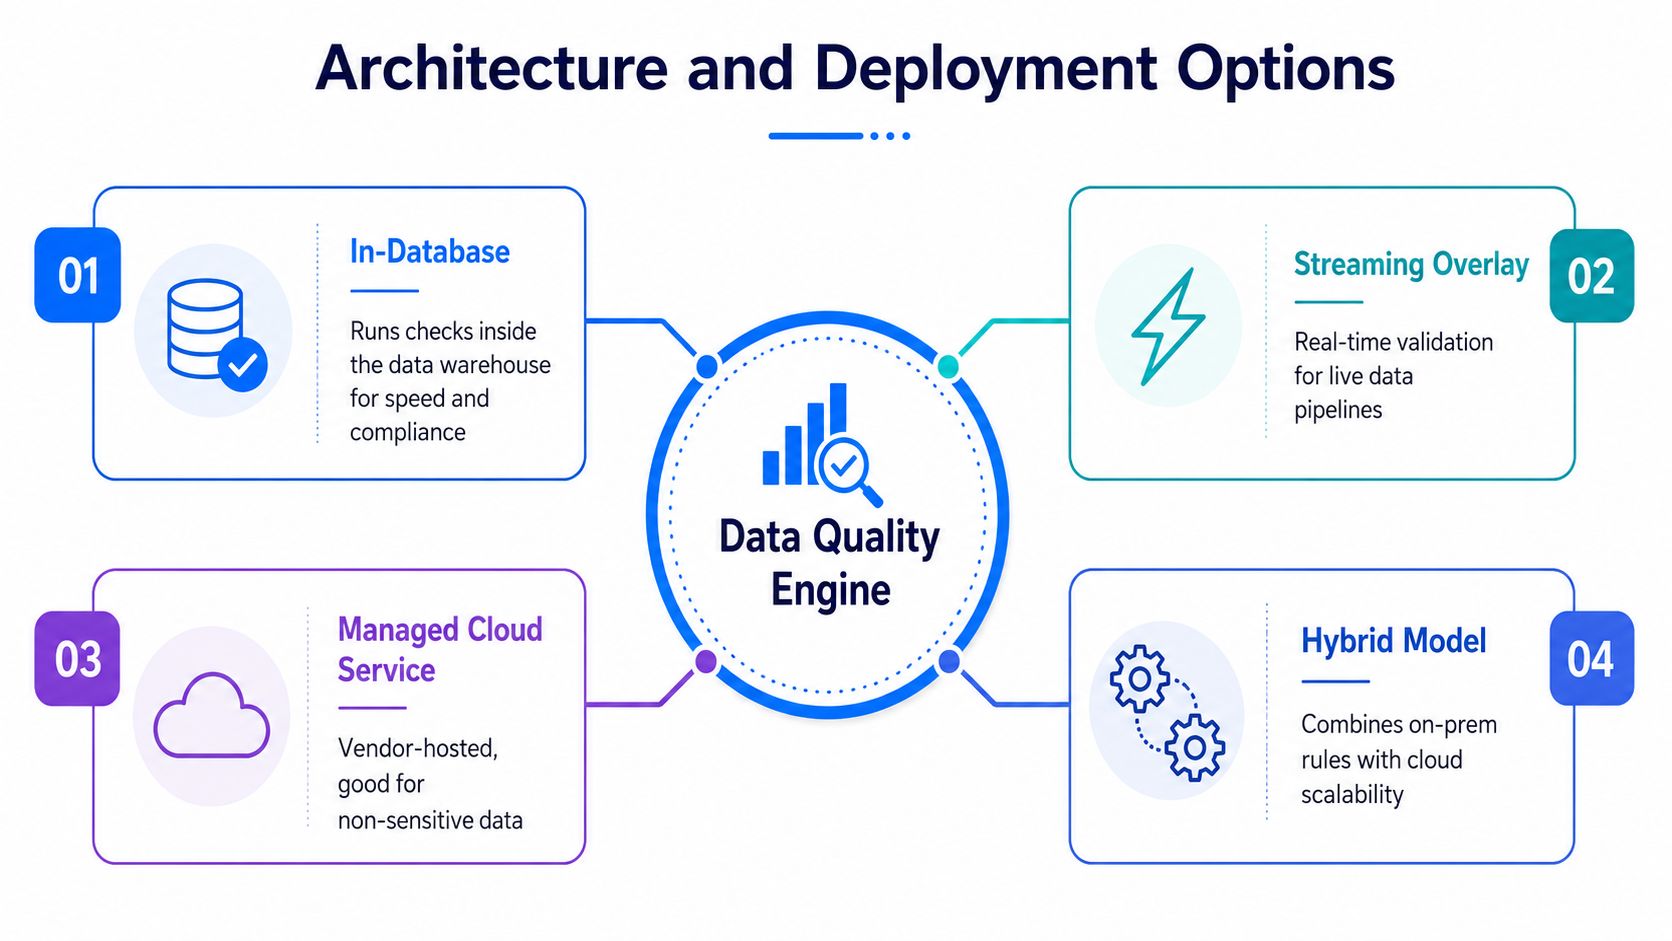
Opzioni di architettura e deployment per ambienti enterprise
Progettare regole di validazione e baseline per il rilevamento delle anomalie
Integrare i controlli di qualità nelle pipeline e nei workflow MLOps
La vostra checklist per il rollout dell'implementazione della data quality
Perché l'implementazione della data quality fallisce senza un sistema di controllo
Dal lavoro di pulizia ai controlli gestiti
Molti data team gestiscono ancora il lavoro sulla qualità come una risposta d'emergenza. Una dashboard va in errore, qualcuno apre un ticket, un analista corregge un modello e lo stesso problema si ripresenta la settimana successiva perché nessuno ha cambiato il comportamento a monte. È proprio per questo che le indicazioni moderne trattano la data quality come un sistema gestito di accuratezza, completezza, coerenza, tempestività, univocità e validità, non come uno sforzo di pulizia una tantum (TechTarget).
I guasti di solito sono banali. Un caricamento in ritardo fa sembrare piatto un report sul fatturato, una chiave mancante fa perdere record nelle join o una modifica allo schema sposta una metrica. Quando un team ha centinaia di caricamenti giornalieri, il lavoro di salvataggio manuale non scala più e il data warehouse inizia ad accumulare piccole crepe nella fiducia che le persone notano molto prima di riuscire a spiegarle.
Regola pratica: se un controllo non ha un responsabile, una soglia e un percorso di correzione, non è un controllo, è un appunto.
Perché gli audit periodici non bastano
Gli audit periodici aiutano, ma sono troppo lenti per le pipeline in esercizio. Le indicazioni attuali dei professionisti mettono ormai tempestività, monitoraggio della latenza, regole di scadenza e sincronizzazione in tempo reale al centro della gestione ordinaria della qualità, perché il primo segnale di un problema sono spesso dati in ritardo o incoerenti, non una corruzione evidente (Lumenalta). Ecco perché il modello di controllo si è spostato verso controlli integrati nelle pipeline, validati rispetto a regole e monitorati nel tempo.
L'altra modalità di fallimento è culturale. I team chiamano questo lavoro “pulizia dei dati”, un'espressione che suona finita, e poi lo organizzano come un progetto con una data di fine. In pratica, il modello migliore è più vicino al release management. Identificate i critical data element, associate le regole di business ai controlli, definite le soglie di accettazione e continuate a sorvegliare dopo il rollout iniziale. Questo approccio è in linea con le indicazioni che danno priorità a data dictionary, provenienza, lineage e recency prima che livelli di governance più profondi possano funzionare efficacemente (TechTarget).
Quando avviene questo cambiamento, la conversazione cambia. Le persone smettono di chiedersi se i dati “sembrano corretti” e iniziano a chiedersi se rientrano nella tolleranza, chi è responsabile dell'eccezione e quale sarebbe il raggio d'impatto a valle se così non fosse.
Identificare i critical data element e definire soglie a livelli
Partite dai campi che comportano rischi
La maggior parte dei programmi fallisce perché cerca di misurare troppo in una volta. Partite dai critical data element legati a fatturato, compliance o operazioni core, poi lasciate stare il resto finché il primo dominio non è stabile. Le indicazioni di Gartner sulla data quality affermano che casi d'uso e risorse di dati dovrebbero essere mappati in base a valore e rischio prima di scegliere dimensioni e metriche (Gartner).
Questo è importante negli ambienti regolamentati, dove il rischio si concentra di solito su un piccolo insieme di campi anziché sull'intero data warehouse. Identificativi, saldi, cartelle cliniche e record simili meritano molta più attenzione delle tabelle di riferimento a basso impatto. Se cercate di strumentare tutto allo stesso modo, il team finisce con una dashboard rumorosa, una prioritizzazione debole e un falso senso di copertura.
Un modo pratico per decidere cosa rientra nel perimetro è porsi tre domande:
Cosa si rompe se questo campo è errato? Riconoscimento dei ricavi, comunicazioni ai clienti, adempimenti di compliance o feature dei modelli spesso forniscono rapidamente la risposta.
Chi percepisce l'errore per primo? I team di finance, operations, supporto e ML fanno spesso emergere modalità di guasto diverse.
Possiamo attribuire l'ownership in modo chiaro? Se la correzione richiede cinque team, probabilmente la regola ha bisogno di un perimetro più ristretto.
Usate questo filtro per definire il primo insieme da monitorare. L'obiettivo non è costruire il programma più grande, ma intercettare gli errori che fanno male. Un utile strumento per definire il perimetro è la prospettiva dei critical data element, perché costringe il team a nominare i campi che contano prima di dedicare tempo a una copertura ampia.
Usate le baseline prima di definire le regole
Prima di scrivere la logica di validazione, profilate la sorgente. Le linee guida di implementazione in ambito pubblico raccomandano di esaminare prima conteggi, tassi di null, valori min/max, tipi di dato e schemi ricorrenti, per poi usare questi risultati per impostare soglie di accettazione come percentuali e controlli misurabili (Oracle). Questa sequenza fa risparmiare molte rilavorazioni perché non dovete tirare a indovinare come sia la normalità.
Le soglie funzionano meglio quando sono a livelli anziché binarie. Un framework pratico usa Gold per un'accuratezza ≥ 99%, Silver per il 95–98% e Bronze sotto il 95%, con correzione obbligatoria (Acceldata). Questa struttura offre a product owner e data steward un linguaggio comune ed evita la falsa precisione di un esito superato/non superato su ogni singola regola.
Il primo passaggio deve restare circoscritto. In un data warehouse enterprise maturo, un insieme monitorato più piccolo con soglie chiare batte di solito una copertura ampia e debole di cui nessuno si fida.
Opzioni di architettura e deployment per ambienti enterprise
Scegliete dove vengono effettivamente eseguiti i controlli
La decisione architetturale non riguarda l'eleganza, ma dove risiedono i dati e chi è autorizzato ad accedervi. Negli ambienti finanziari, sanitari, delle telecomunicazioni e della pubblica amministrazione, spostare i dati di produzione verso un sistema esterno è spesso fuori discussione, quindi l'esecuzione in-database diventa la scelta pratica. In questo modo i dati restano nell'ambiente controllato dal cliente e si riducono gli spostamenti non necessari.
Molte implementazioni falliscono al primo tentativo. I team acquistano un livello di dashboard che fa bella figura nelle demo, poi scoprono di aver ancora bisogno di codice personalizzato ovunque data warehouse, data lake e pipeline divergano. Lo schema più sano è tenere il motore di qualità vicino ai dati ed esporre poi i risultati tramite UI, API o SDK a seconda di chi deve intervenire.
In ogni caso ci sono dei compromessi:
Le dashboard centralizzate aiutano la visibilità tra i team, ma possono diventare un teatro in sola lettura se non sono legate a ownership e applicazione delle regole.
Gli SDK basati su codice danno agli ingegneri il controllo che desiderano, ma richiedono un modello operativo pulito, altrimenti ogni team costruisce la propria interpretazione della stessa regola.
I deployment in private cloud o on-prem preservano il controllo, il che conta quando residenza dei dati e accesso dei fornitori sono temi sensibili.
Le configurazioni ibride possono funzionare quando non tutti i dataset richiedono lo stesso trattamento, ma la suddivisione deve essere intenzionale.
L'architettura migliore è quella che si adatta all'infrastruttura esistente senza imporre una riscrittura del data warehouse o dello stack di orchestrazione.
Tenete la piattaforma vicina ai dati
Le piattaforme moderne hanno di solito bisogno di tre capacità per restare utili negli ambienti enterprise. Primo, l'apprendimento delle baseline, affinché il sistema comprenda gli schemi ricorrenti. Secondo, l'analisi dei trend, per individuare il drift invece di limitarsi a contare i fallimenti. Terzo, il tracciamento dello schema, affinché aggiunte e rimozioni di colonne o cambi di tipo non danneggino i report a valle senza preavviso.
Una piattaforma come digna si adatta a questo schema eseguendo le analisi all'interno dei database del cliente, monitorando la tempestività e tracciando le modifiche allo schema senza che i dati debbano lasciare l'ambiente controllato. È il tipo di modello di deployment di cui i team enterprise hanno di solito bisogno quando l'osservabilità deve coesistere con la privacy e con gli investimenti esistenti nel data warehouse.
Il compromesso principale è la manutenzione. Una piattaforma troppo lontana dai dati richiede più codice di integrazione e più gestione delle eccezioni. Una piattaforma che gira vicino ai dati può essere operativamente più silenziosa, perché osserva direttamente il comportamento della sorgente e non dipende da estrazioni copiate per capire cosa è cambiato.
Progettare regole di validazione e baseline per il rilevamento delle anomalie
Associate i controlli alla giusta modalità di guasto
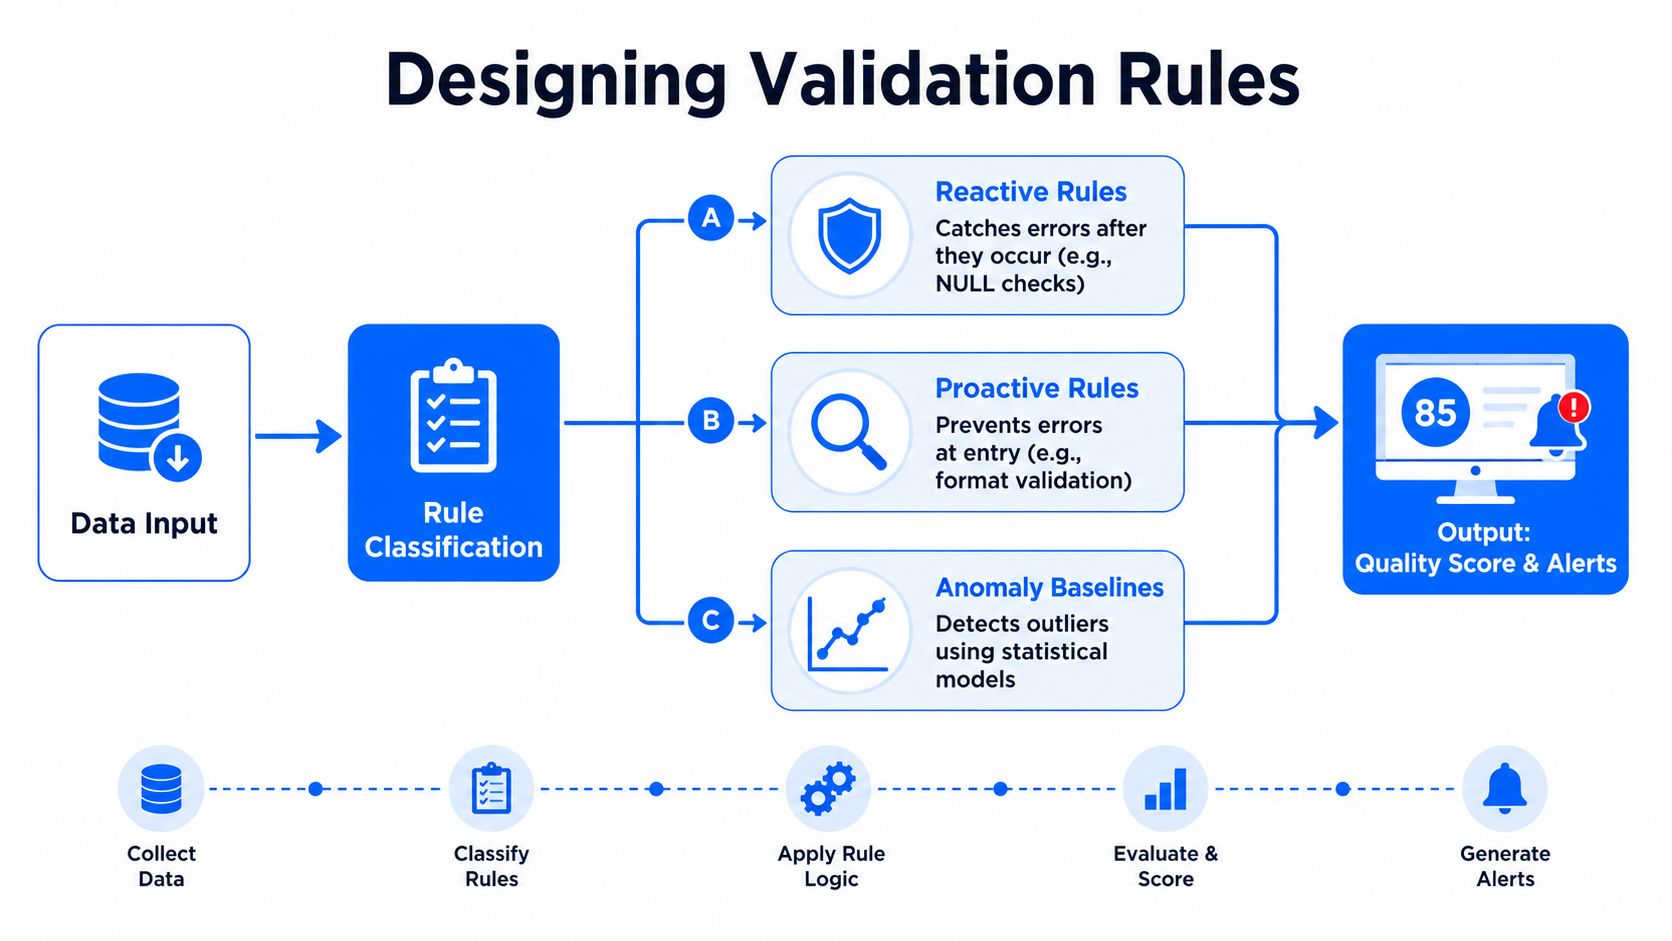
Un modello di controllo pratico combina quattro approcci: reattivo, proattivo, idoneità all'uso e rilevamento delle anomalie (OvalEdge). Questo mix è importante perché guasti diversi richiedono risposte diverse. Un valore mancante è un problema. Un formato errato è un altro. Una lenta deriva in un sistema sorgente richiede un controllo completamente diverso.
Le regole reattive intercettano i problemi dopo che si sono verificati. Le regole proattive bloccano i dati errati in ingresso. I controlli di idoneità all'uso confermano che i dati sono utilizzabili per uno specifico scopo di business. Il rilevamento delle anomalie sorveglia i cambiamenti che non corrispondono allo schema appreso. Questa separazione dà alla piattaforma una struttura chiara ed evita che i team trasformino ogni regola in un blocco rigido e fragile.
Le dimensioni fondamentali restano le stesse: accuratezza, completezza, coerenza, tempestività, validità e univocità. La parte utile è associare ciascuna dimensione al giusto punto di controllo invece di fingere che una sola regola possa coprire tutto.
Una buona regola vi dice cosa è fallito, dove è fallito e chi dovrebbe preoccuparsene. Qualsiasi cosa in meno diventa una decorazione della dashboard.
Lasciate che le baseline gestiscano drift e tempistiche
Il rilevamento delle anomalie ripaga quando la sorgente cambia lentamente. Se il volume, la distribuzione o lo schema temporale di una tabella cambiano in modo significativo, una baseline appresa può segnalarlo prima che un utente di business noti il problema in un report. Questo riduce la necessità di centinaia di controlli costruiti a mano, soprattutto nelle pipeline volatili in cui schema e comportamento della sorgente cambiano spesso.
La tempestività richiede un trattamento specifico. La pratica attuale include come controlli di qualità standard il monitoraggio degli orari di consegna attesi, il rilevamento dei ritardi e le verifiche di arrivo basate sulla pianificazione (Lumenalta). Il ritardo causa spesso una decisione sbagliata prima che scatti qualsiasi altro controllo. Un dataset “corretto” che arriva dopo la riunione non supera comunque il controllo.

Il tracciamento dello schema colma un'altra lacuna comune. Colonne aggiunte, colonne rimosse e modifiche ai tipi di dato possono danneggiare le analisi a valle anche quando la pipeline stessa appare sana. Trattateli come segnali di primo piano, non come note a margine, perché sono spesso il primo avvertimento che un contratto con la sorgente è cambiato.
Integrare i controlli di qualità nelle pipeline e nei workflow MLOps
Rendete i quality gate parte della delivery
La qualità conta solo quando la pipeline la applica automaticamente. Ciò significa che controlli di validazione, rilevamento delle anomalie e monitoraggio della tempestività devono essere eseguiti all'interno dello stesso percorso di delivery che porta i dati nelle dashboard di produzione o nei job di addestramento dei modelli. Se il team ha una CI/CD per il codice, anche il quality gate dei dati deve stare lì.
La sequenza deve essere noiosa. Validate in fase di ingestione, validate dopo le trasformazioni e validate di nuovo prima della pubblicazione. Se un caricamento è pianificato, eseguite i controlli secondo la pianificazione. Se è in streaming, mantenete i controlli in linea. Se alimenta il ML, bloccate il set di feature prima che input errati raggiungano l'addestramento o il serving.
Usate gli alert con parsimonia e con uno scopo preciso. Una sola regola rumorosa può fare più danni del problema dei dati stesso, perché le persone smettono di fidarsi delle notifiche. Gli alert devono essere instradati in base a gravità e impatto sul business, non solo in base a chi è di turno in quel momento.
Indirizzate le eccezioni ai responsabili, non alle caselle di posta
Il motivo per cui l'ownership conta è semplice: i difetti ricorrenti non scompaiono perché qualcuno li ha copiati in un ticket. Scompaiono quando il data steward o il custodian giusto può vedere il guasto, comprenderne la causa principale e correggere il comportamento della sorgente. Ecco perché i framework maturi abbinano i controlli a ownership e percorsi di escalation espliciti, invece di lasciare che gli analisti smistino tutto manualmente (Monte Carlo).
I cicli di feedback mantengono aggiornate le regole. Le sorgenti cambiano, gli obiettivi di business cambiano e il team deve aspettarsi che il modello delle soglie cambi con loro. L'automazione aiuta, perché riduce l'errore umano e rende il programma più facile da sostenere nel tempo. Se il workflow funziona, gli ingegneri passano meno tempo a fare da babysitter alla pipeline e più tempo a migliorarla.
I team che vogliono un workflow gestito valutano spesso strumenti come digna, i test di dbt o i controlli nativi del data warehouse, ma la scelta conta solo se il modello di instradamento è chiaro. Lo strumento deve segnalare il problema, il data steward deve farsi carico della correzione e la cronologia deve mostrare se lo stesso difetto continua a ripresentarsi.
Monitoraggio continuo e misurazione del ROI
Misurate la qualità come un sistema in esercizio
Una pipeline può sembrare sana al mattino e consegnare comunque dati errati entro l'ora di pranzo. I controlli a campione manuali non tengono il passo, quindi il monitoraggio continuo deve far parte del sistema di controllo, sorvegliando ritardi, drift e modifiche allo schema prima che questi problemi influenzino le decisioni. Il cambiamento pratico è il passaggio dalla pulizia occasionale a una misurazione governata, in cui il dataset è sempre sotto osservazione invece di essere ispezionato secondo un calendario.
Definite i criteri di successo in termini operativi, non come una vaga fiducia. I team monitorano di solito fasce di accuratezza, finestre di ritardo monitorate e tassi di eccezione per decidere se il programma sta reggendo. Questi segnali funzionano meglio del semplice fatto che un dataset sembri pulito, perché se ne può seguire l'andamento, si possono confrontare tra sorgenti e ricondurre a responsabili specifici.
Anche l'analisi storica è importante. Quando esaminate gli incidenti passati, lo schema emerge di solito nelle tempistiche di arrivo, nel drift e nelle cause principali ricorrenti che un audit una tantum non coglie. È questo che trasforma il monitoraggio in un sistema di gestione invece che in un mucchio di alert, ed è per questo che il monitoraggio della data quality deve collegare il controllo stesso alla sorgente, al responsabile e al percorso di correzione.
Test utile: se una metrica non vi aiuta a decidere se correggere, scalare o ignorare, appartiene a un report, non a un monitor.
Monitorate i risultati senza vanity metric
Il ROI della data quality si manifesta di solito in meno emergenze, rilevamento più rapido e meno correzioni manuali. Una dashboard di monitoraggio può renderlo visibile quando collega la copertura della qualità all'impatto operativo, non solo all'attività tecnica. La domanda giusta non è quanti controlli esistono, ma se i controlli prevengono decisioni sbagliate e riducono il lavoro ripetuto.
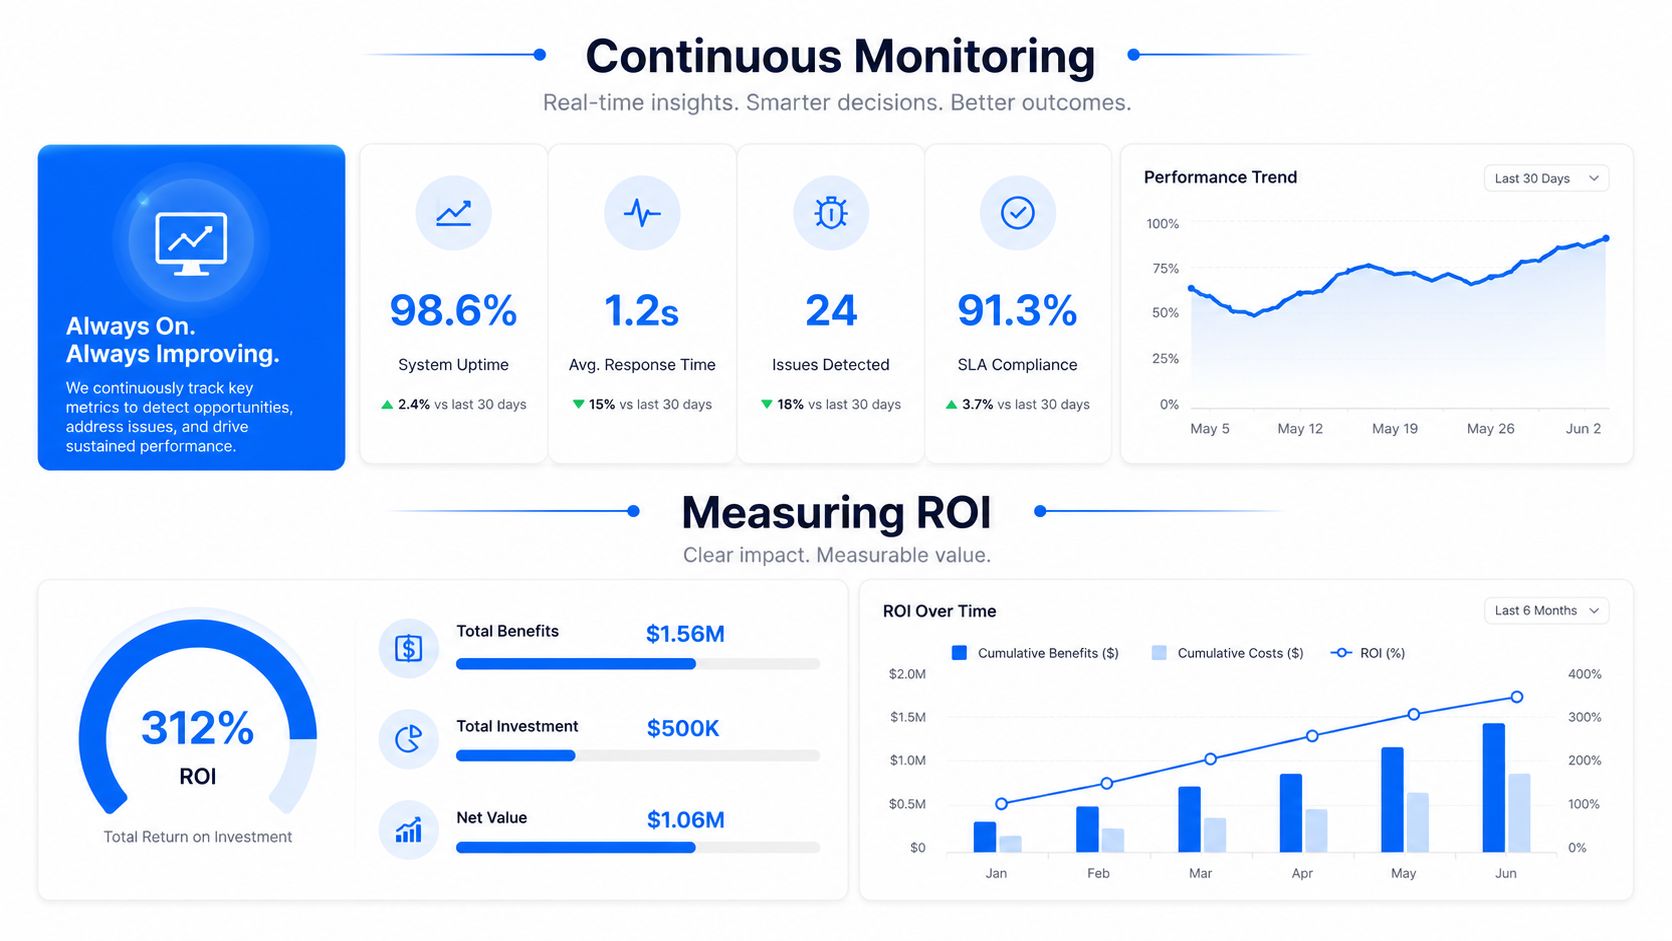
Le rivalutazioni periodiche sono importanti perché sorgenti e obiettivi continuano a cambiare. L'automazione aiuta a mantenere la cadenza, ma il valore nasce dal ciclo: rilevare, assegnare, correggere, confermare e poi adeguare la regola quando il business cambia. Se lo stesso problema continua a ripresentarsi, la soglia, il modello di ownership o il processo a monte devono essere rivisti.
La vostra checklist per il rollout dell'implementazione della data quality
Partite in piccolo ed espandete sulla base dei risultati
Iniziate con uno o due domini che comportano il maggior rischio di business. Profilate la sorgente, definite le regole di business, impostate le soglie e scegliete i responsabili prima di ampliare la copertura. Se i primi rollout non si stabilizzano, ampliare il perimetro non fa che moltiplicare il rumore.
Una sequenza di rollout pratica è la seguente:
Selezionate i critical data element. Concentratevi sui campi legati a fatturato, compliance o operazioni chiave.
Profilate la sorgente. Acquisite baseline per conteggi, tassi di null, intervalli, tipi di dato e schemi comuni.
Definite le fasce di accettazione. Usate soglie misurabili ed esiti a livelli, così il team sa cosa fa scattare la correzione.
Integrate l'automazione. Eseguite i controlli all'interno della pipeline, non tramite ispezione manuale a posteriori.
Assegnate l'ownership. Assicuratevi che ogni difetto ricorrente arrivi a un data steward o custodian in grado di correggere la sorgente.
Rivedete ed espandete. Aggiungete copertura solo dopo che la prima area è stabile.
Tenete sotto stretto controllo l'espansione incontrollata del perimetro. I team cercano spesso di definire troppe metriche prima di aver stabilizzato quelle critiche per il business, oppure dimenticano le sorgenti legacy ed esterne, dove di solito si annidano le stranezze. È così che il programma diventa impressionante sulla carta e fragile in produzione.
Mantenete il rollout focalizzato sull'ownership
La migliore checklist di rollout è abbastanza breve da essere effettivamente usata. Deve coprire l'allineamento degli stakeholder, le fasi di test, i percorsi di escalation e le soglie che stabiliscono se i dati sono idonei alla pubblicazione. Deve anche lasciare spazio alle eccezioni, perché non ogni regola fallita significa che i dati sono errati.
Il test finale è se il programma riduce lo smistamento manuale. Se gli analisti passano ancora le mattine a riconciliare gli stessi input corrotti, i controlli non sono ancora operativi. Se i responsabili possono vedere il problema, la soglia e il percorso di correzione senza bisogno di una riunione, l'implementazione inizia a funzionare.
Se state costruendo o sostituendo un programma di data quality, digna può aiutarvi a monitorare i critical data element, validare i record all'interno del database e tracciare tempestività e modifiche allo schema senza spostare i dati di produzione fuori dal vostro ambiente. Visitate digna per vedere come si inserisce in un vero stack di data warehouse o pipeline.
Per trasformare le regole di business e le soglie a livelli di questo playbook in controlli a livello di record eseguiti all'interno del vostro database, consultate digna Data Validation.
Domande frequenti
Perché le implementazioni della data quality falliscono?
Falliscono quando la qualità viene trattata come un progetto di pulizia con una fine, anziché come un sistema di controllo operativo. Senza responsabili, soglie e percorsi di correzione, gli stessi difetti ritornano ogni settimana. La regola dell'articolo è netta: un controllo senza responsabile, soglia e percorso di correzione non è un controllo, è solo un appunto.
Da dove dovrebbe partire un programma di data quality?
Partite dai critical data element legati a fatturato, compliance o operazioni core e lasciate il resto finché il primo dominio non è stabile. Chiedetevi cosa si rompe se un campo è errato, chi percepisce l'errore per primo e se l'ownership può essere attribuita in modo chiaro. Identificativi e saldi meritano più attenzione delle tabelle di riferimento.
Come si definiscono le soglie di data quality?
Profilate prima la sorgente, esaminando conteggi, tassi di null, valori min/max, tipi di dato e schemi ricorrenti, poi impostate soglie di accettazione misurabili. Le fasce a livelli funzionano meglio di un esito superato/non superato: Gold per un'accuratezza pari o superiore al 99%, Silver dal 95 al 98% e Bronze sotto il 95%, con correzione obbligatoria.
In quale punto della pipeline devono essere eseguiti i controlli di data quality?
I controlli appartengono al percorso di delivery: validate in fase di ingestione, dopo le trasformazioni e di nuovo prima della pubblicazione. I caricamenti pianificati hanno controlli pianificati, lo streaming mantiene i controlli in linea e i flussi ML bloccano i set di feature errati prima dell'addestramento o del serving. Negli ambienti regolamentati, l'esecuzione in-database mantiene i dati di produzione all'interno dell'ambiente controllato dal cliente.
Come si misura il ROI della data quality?
Il ROI si manifesta di solito in meno emergenze, rilevamento più rapido e meno correzioni manuali, non in un numero maggiore di controlli. Monitorate fasce di accuratezza, finestre di ritardo monitorate e tassi di eccezione, poi chiedetevi se i controlli prevengono decisioni sbagliate e lavoro ripetuto. Se gli analisti riconciliano ancora ogni mattina gli stessi input corrotti, i controlli non sono operativi.


