Il Data Mesh garantisce la qualità dei vostri dati?
|
5
min di lettura
Il Data Mesh, un termine che sta facendo molto parlare di sé nel mondo della gestione dei dati, è nato come una necessità, un cambio di paradigma e una strategia importante per affrontare i problemi dei data lake centrali e dei team dati centralizzati, sommersi da richieste di insight provenienti da diverse aree di business con l'aspettativa di prendere decisioni aziendali informate basate sui dati.
I team dati centrali devono sostenere il peso di rispondere a tutte le domande del business con insight basati sui dati, il più rapidamente possibile. In questo breve lasso di tempo devono riparare le pipeline di dati interrotte dopo modifiche ai database operativi, scoprire e comprendere i dati fondamentali dei domini. È da qui che è nato il Data Mesh.
Immaginate una rete distribuita di domini di dati self-service, ciascuno dei quali crea con cura data product su misura per specifiche esigenze di business. Sembra un'utopia dei dati, vero? Decentralizzato, agile e ricco di potenziale. Presentato come un approccio rivoluzionario all'architettura dei dati, il Data Mesh promette di decentralizzare la proprietà e la distribuzione dei dati, inaugurando una nuova era di agilità e scalabilità. Tuttavia, in mezzo a tanto clamore, resta la domanda da un milione di dollari: il Data Mesh garantisce la qualità dei vostri dati?
Che cos'è il Data Mesh?
In sostanza, il Data Mesh è un cambio di paradigma nel modo in cui le organizzazioni affrontano l'architettura dei dati. Ideato da Zhamak Dehghani di ThoughtWorks nel 2019, il Data Mesh propone un approccio decentralizzato alla gestione dei dati, in cui la proprietà e la governance dei dati sono distribuite tra team interfunzionali orientati al dominio. Questo modello decentralizzato mira ad abbattere i silos di dati e a responsabilizzare i team sui propri dati, favorendo una cultura di collaborazione e agilità.
Il framework del Data Mesh si fonda sulla convinzione che i dati debbano essere trattati come un prodotto, con particolare attenzione alla governance decentralizzata orientata al dominio, all'infrastruttura dati self-service e al product thinking su larga scala.
Quali sono i 4 principi del Data Mesh?
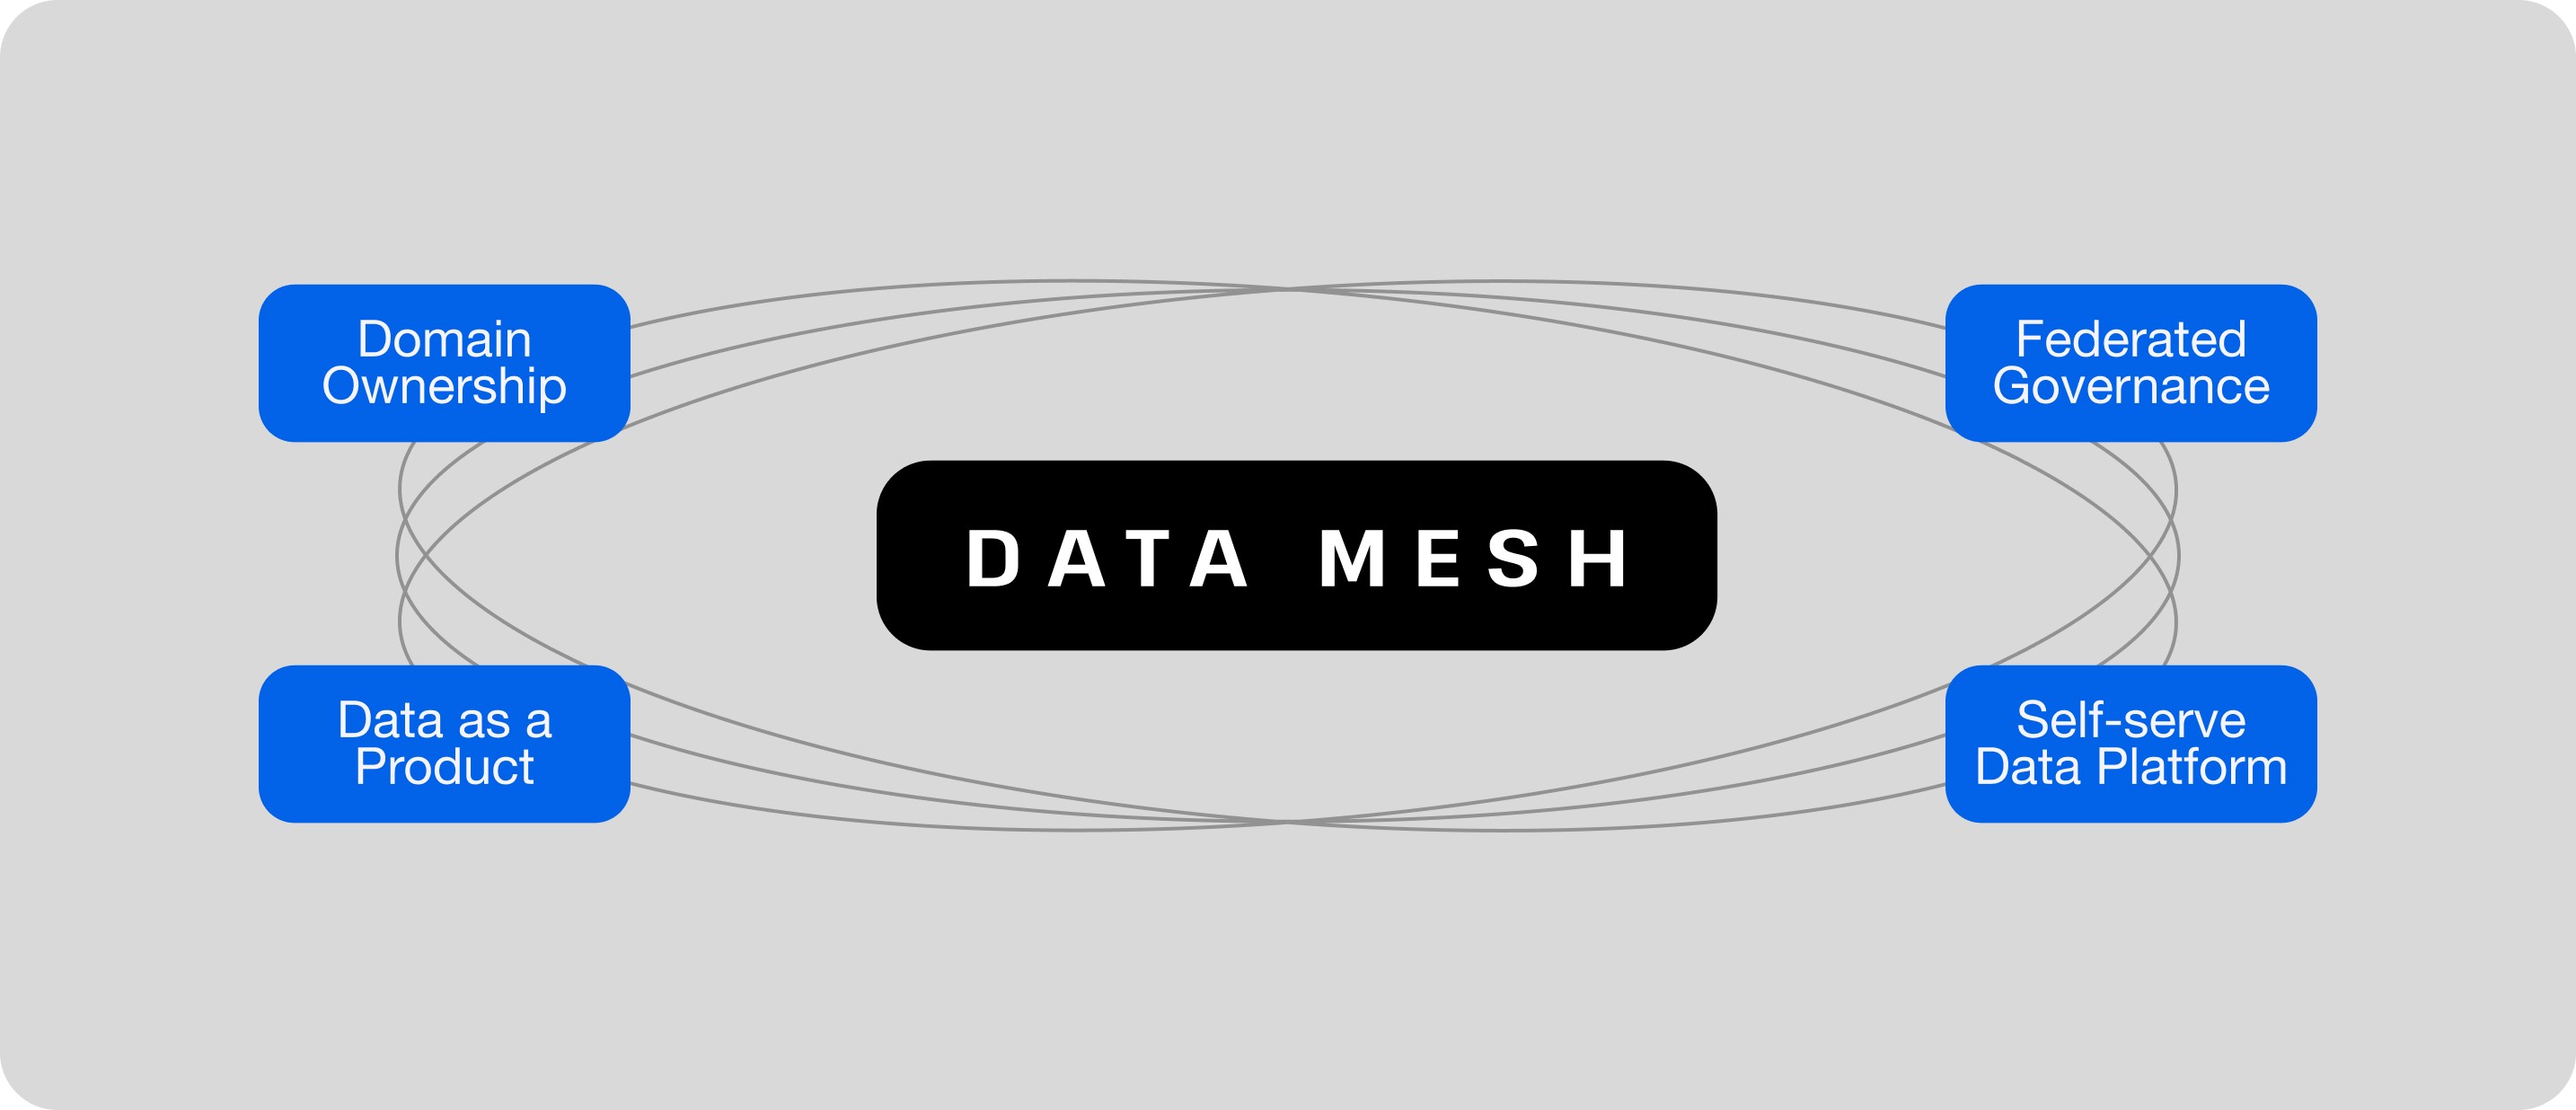
Spesso chiamati anche i 4 pilastri del Data Mesh, analizziamo il fenomeno Data Mesh. Ecco in sintesi i suoi quattro principi guida: proprietà del dominio, dati come prodotto, piattaforme dati self-service e governance federata.
Proprietà dei dati orientata al dominio
I dati sono posseduti e gestiti come un prodotto da team specifici per dominio, favorendo responsabilità e competenza.
I dati come prodotto
Cambiare mentalità per trattare i dati con la stessa cura e la stessa pianificazione strategica di un prodotto commerciale. I dati sono trattati come un prodotto, con una proprietà chiara, standard di qualità e accordi sul livello di servizio (SLA).
Infrastruttura dati self-service
I team hanno accesso self-service all'infrastruttura dati, che consente loro di acquisire, elaborare e analizzare i dati in autonomia, senza colli di bottiglia, aumentando velocità ed efficienza.
Governance computazionale federata
L'architettura è progettata per supportare una data governance decentralizzata, con data product interoperabili e API standardizzate. Una supervisione centralizzata garantisce il rispetto degli standard di qualità dei dati, ma il potere di gestire i dati resta ai domini.
Data warehouse, data lake e Data Mesh a confronto
Per capire quale posto occupi il Data Mesh nell'ecosistema dei dati, è essenziale distinguerlo dagli approcci tradizionali alla gestione dei dati. Mentre data warehouse e data lake centralizzano l'archiviazione e l'elaborazione dei dati, il Data Mesh propone un modello decentralizzato in cui la proprietà e la governance dei dati sono distribuite. Il Data Mesh è più vicino ai principi dei data lake, ma con un'enfasi sulla decentralizzazione e sulla proprietà specifica per dominio.
La differenza tra Data Mesh e Data Fabric
Sebbene entrambi mirino ad affrontare la complessità degli ecosistemi di dati moderni, Data Mesh e Data Fabric affrontano la sfida da prospettive diverse. Il Data Mesh si concentra sul cambiamento organizzativo, promuovendo la proprietà orientata al dominio e la governance decentralizzata. Il Data Fabric, invece, è più incentrato sulla tecnologia: fornisce un livello integrato che collega diversi strumenti e piattaforme di dati in tutta l'azienda, facilitando l'accessibilità e l'interoperabilità dei dati senza necessariamente modificare la struttura organizzativa.
Perché il Data Mesh da solo non basta a garantire la qualità dei dati
Ora immaginate un mercato vivace di data product, in cui ogni dominio è un venditore orgoglioso. Entusiasmante, vero? Ma ecco il problema: il Data Mesh dà autonomia, ma non pulisce né valida i dati per magia. Una virgola fuori posto in un dataset finanziario, il nome di un prodotto scritto male in un record cliente: questi piccoli diavoletti possono comunque fare danni, anche in un paradiso decentralizzato.
L'adozione del Data Mesh rappresenta un passo enorme verso una gestione dei dati reattiva e decentralizzata. Eppure non è una panacea per tutti i mali legati ai dati, soprattutto quando si tratta di problemi di qualità dei dati. Senza solidi processi di qualità dei dati, la proprietà decentralizzata può portare a incoerenze, imprecisioni e inefficienze. Il Data Mesh può aiutare i team a gestire i propri dati in modo più efficace, ma senza un'adeguata supervisione e controlli di qualità il rischio di degrado dei dati rimane. È qui che entrano in gioco le piattaforme moderne per la qualità dei dati.
Ecco digna: il Data Mesh potenziato dalla qualità dei dati basata sull'IA
Addentrandoci nelle complessità della gestione dei dati, appare evidente che, sebbene il Data Mesh offra un framework solido per la decentralizzazione e l'autonomia dei domini, non risolve di per sé la questione cruciale della qualità dei dati. Questa lacuna rappresenta però un'opportunità per soluzioni innovative come digna.
Strumenti moderni per la qualità dei dati come digna, una piattaforma di qualità dei dati basata sull'IA progettata per completare e potenziare la vostra strategia Data Mesh. digna agisce come l'ispettore del controllo qualità nel mercato del vostro Data Mesh. Si assicura che ogni data product sia all'altezza, garantendo l'integrità dei vostri insight.
Con funzionalità come autometrics, modelli di previsione, autothresholds e dashboard di monitoraggio in tempo reale, digna consente alle organizzazioni di mantenere l'integrità e la qualità dei propri dati in un ambiente decentralizzato. Sfruttando la potenza del machine learning e dell'automazione, digna garantisce che i dati restino accurati, coerenti e affidabili, indipendentemente dalla loro proprietà decentralizzata.
digna è pensato per prendere la vostra visione del Data Mesh e darle una marcia in più, proiettandovi verso un futuro in cui i dati alimentano davvero il successo. Lasciate che digna porti al livello successivo le vostre strategie di produttività e decentralizzazione del data mesh, dove la qualità dei dati non è una domanda, ma una garanzia. Guardate la nostra demo per saperne di più oppure contattateci per parlare con il nostro team.
Poiché ogni dominio di un mesh gestisce le proprie pipeline, la qualità va monitorata sull'intera piattaforma anziché un team alla volta: è l'approccio alla base dell'osservabilità della piattaforma dati con digna.
Domande frequenti
Che cos'è il Data Mesh?
Il Data Mesh è un approccio decentralizzato all'architettura dei dati, ideato da Zhamak Dehghani di ThoughtWorks nel 2019. Distribuisce la proprietà e la governance dei dati tra team interfunzionali orientati al dominio e tratta i dati come un prodotto, con l'obiettivo di abbattere i silos e alleggerire i team dati centrali sovraccarichi.
Quali sono i 4 principi del Data Mesh?
I quattro principi sono la proprietà dei dati orientata al dominio, i dati come prodotto, l'infrastruttura dati self-service e la governance computazionale federata. L'articolo spiega che i domini possiedono i propri dati, i prodotti hanno proprietà, standard di qualità e SLA chiari, i team accedono all'infrastruttura in autonomia e una supervisione centrale fissa gli standard di qualità mentre i domini mantengono il controllo.
Qual è la differenza tra Data Mesh e Data Fabric?
Il Data Mesh è soprattutto un cambiamento organizzativo, mentre il Data Fabric è incentrato sulla tecnologia. Secondo l'articolo, il Mesh promuove la proprietà orientata al dominio e la governance decentralizzata, mentre il Fabric fornisce un livello integrato che collega strumenti e piattaforme di dati in tutta l'azienda, migliorando accessibilità e interoperabilità senza necessariamente modificare la struttura organizzativa.
Il Data Mesh garantisce la qualità dei dati?
No, l'articolo sostiene che il Data Mesh dà autonomia ai team ma non pulisce né valida i dati per magia. Una virgola fuori posto in un dataset finanziario o il nome di un prodotto scritto male possono comunque fare danni e, senza controlli di qualità, la proprietà decentralizzata può portare a incoerenze, imprecisioni e inefficienze tra i domini.
Come si può garantire la qualità dei dati in un Data Mesh?
Aggiungendo un livello di qualità dei dati che controlli ogni data product. L'articolo presenta digna come l'ispettore del controllo qualità del mercato del Data Mesh, che utilizza autometrics, modelli di previsione, autothresholds e dashboard di monitoraggio in tempo reale per mantenere i dati accurati, coerenti e affidabili indipendentemente dalla proprietà decentralizzata.


