Eventi di data analytics spiegati: dal tracking alla fiducia
|
7
min di lettura

Avete una dashboard che sembra tranquilla, il team continua a rilasciare, eppure una mattina i numeri non tornano del tutto con ciò che vedono vendite, prodotto e supporto. È il pericolo silenzioso degli eventi di data analytics. Il codice può continuare a scattare, ma se il significato dell'evento deriva, la dashboard può continuare a raccontare una storia che non corrisponde più alla realtà.
Ecco perché eventi affidabili non sono solo una questione di tracking. Sono una questione di data contract, e il contratto deve reggere tra ingegneri, analisti e business. Se il modello degli eventi è vago, ogni funnel, modello di attribuzione e pipeline di feature a valle eredita quell'ambiguità. Se il modello è chiaro, il resto dello stack diventa più facile da considerare affidabile. Leggete anche l'idea correlata dei dati affidabili come dati validi per la mentalità di qualità più ampia alla base di questa fiducia.
Idea chiave: un evento è utile solo quando il suo significato resta abbastanza stabile da permettere a persone e sistemi di farvi affidamento.
Il percorso pratico è semplice, anche se i dettagli richiedono disciplina. Prima, capite che cos'è davvero un evento. Poi progettate il modello in modo che cresca insieme ai cambiamenti del prodotto. Dopodiché eliminate le modalità di errore comuni che corrompono i dati. Infine, continuate a validare il flusso come un contratto vivo, non come una checklist da spuntare una volta sola.
Indice
Introduzione: perché gli eventi di analytics creano o distruggono la fiducia
Che cosa sono davvero gli eventi di data analytics e come funzionano
Le tre parti che contano
Dall'interazione grezza alla pipeline di analytics
Progettare un modello di eventi che cresca con il prodotto
Partite dalle categorie, poi date all'evento un nome chiaro
Decidete quali campi sono obbligatori
Errori comuni che corrompono i dati degli eventi e come evitarli
Pattern sani e pattern problematici
Attenzione agli errori di tempistica e di fuso orario
Validare la qualità degli eventi con contratti e segnali osservabili
Cinque segnali che rivelano tipi diversi di problemi
Con il traffico a picchi, le baseline battono le soglie fisse
Mettere in pratica l'osservabilità degli eventi con digna
Costruire eventi di analytics affidabili nel lungo periodo
Introduzione: perché gli eventi di analytics creano o distruggono la fiducia
Una dashboard può sembrare sana mentre il flusso di eventi sottostante ha già iniziato a derivare. Un product manager vede il grafico delle iscrizioni. Un analista vede lo stesso grafico. Un data engineer controlla la pipeline e non nota nulla di rotto. La trappola è che il sistema può essere tecnicamente «attivo» mentre il significato dell'evento si è spostato quanto basta per distorcere le decisioni.
Ecco perché gli eventi di data analytics sono alla base di quasi tutte le metriche che contano. Alimentano funnel, viste di retention, risultati degli esperimenti, attribuzione di marketing, alert operativi e feature di ML. Quando la definizione di un evento è confusa, ogni team colma le lacune a modo suo, e queste differenze non sempre emergono finché qualcuno non chiede perché due report non concordano.
Il settore in sé ha radici profonde. La IEEE International Conference on Data Science and Advanced Analytics (IEEE DSAA) si presenta come il principale forum di data science, con il sostegno congiunto di IEEE, ACM, ASA e CCF come descritto nella panoramica sull'ecosistema degli eventi di analytics. Un sostegno istituzionale di questo tipo è un segnale forte che gli eventi di analytics non sono un tema marginale, ma parte dell'infrastruttura professionale centrale del settore.
L'altro cambiamento è pratico. Anche i tassi di partecipazione agli eventi in ambito professionale mostrano quanto spesso la partecipazione reale differisca dal numero degli iscritti. In un benchmark del 2026, gli eventi in presenza convertono in genere circa il 60-70% delle conferme in partecipanti effettivi, gli eventi virtuali dal vivo convertono circa il 40-50% delle registrazioni in presenze e le conferenze professionali e accademiche in presenza registrano spesso un tasso di assenza del 30-40% fonte. Lo stesso schema conta nel lavoro di analytics, perché anche i team devono mettere in conto la differenza tra l'intenzione e il comportamento effettivo dei dati.
Che cosa sono davvero gli eventi di data analytics e come funzionano
Un modo utile di pensare a un evento è come a una ricevuta di un'azione. Una ricevuta dice che cosa è successo, quando è successo e fornisce abbastanza contesto per capirlo in seguito. Senza quel contesto, una ricevuta è solo un pezzo di carta. Nell'analytics, un clic, una visualizzazione, un invio o un errore grezzi diventano utili solo dopo essere stati trasformati in dati di evento strutturati.
Le tre parti che contano
Ogni evento solido ha bisogno di tre ingredienti. L'azione dice che cosa è successo, come una visualizzazione di pagina, un clic su un pulsante o l'invio di un modulo. Il contesto dice dove e come è successo, come la pagina, il dispositivo, l'ID utente o la versione dell'app. Il tempo dice quando è successo, ed è importante perché la tempistica spesso cambia il significato dell'evento.
Regola pratica: se non riuscite a spiegare azione, contesto e tempo in parole semplici, l'evento è ancora troppo vago per essere affidabile.
Questa struttura è il motivo per cui l'analytics basata sugli eventi funziona per prodotto, marketing e operations. Un marketer può guardare il traffico di una campagna. Un product analyst può esaminare un funnel. Un ingegnere può tracciare il percorso di un errore. Non si pongono la stessa domanda, ma leggono tutti lo stesso segnale sottostante.
Dall'interazione grezza alla pipeline di analytics
Il percorso di solito inizia con un'interazione grezza in un'app o in un servizio. Questa interazione viene catturata come evento, inviata attraverso un livello di streaming o di raccolta e poi depositata in un warehouse o in un lakehouse, dove analisti e modelli possono usarla. La parte importante non è solo lo spostamento, ma la coerenza del significato a ogni passaggio.
Spesso si confondono gli eventi con le entità o le sessioni. Un'entità è ciò che vi interessa, come un utente o un account. Una sessione è un periodo di attività delimitato. Un evento è un singolo fatto osservato. Se questi concetti si confondono, i team iniziano a sovraccaricare i campi e il modello diventa difficile da estendere.
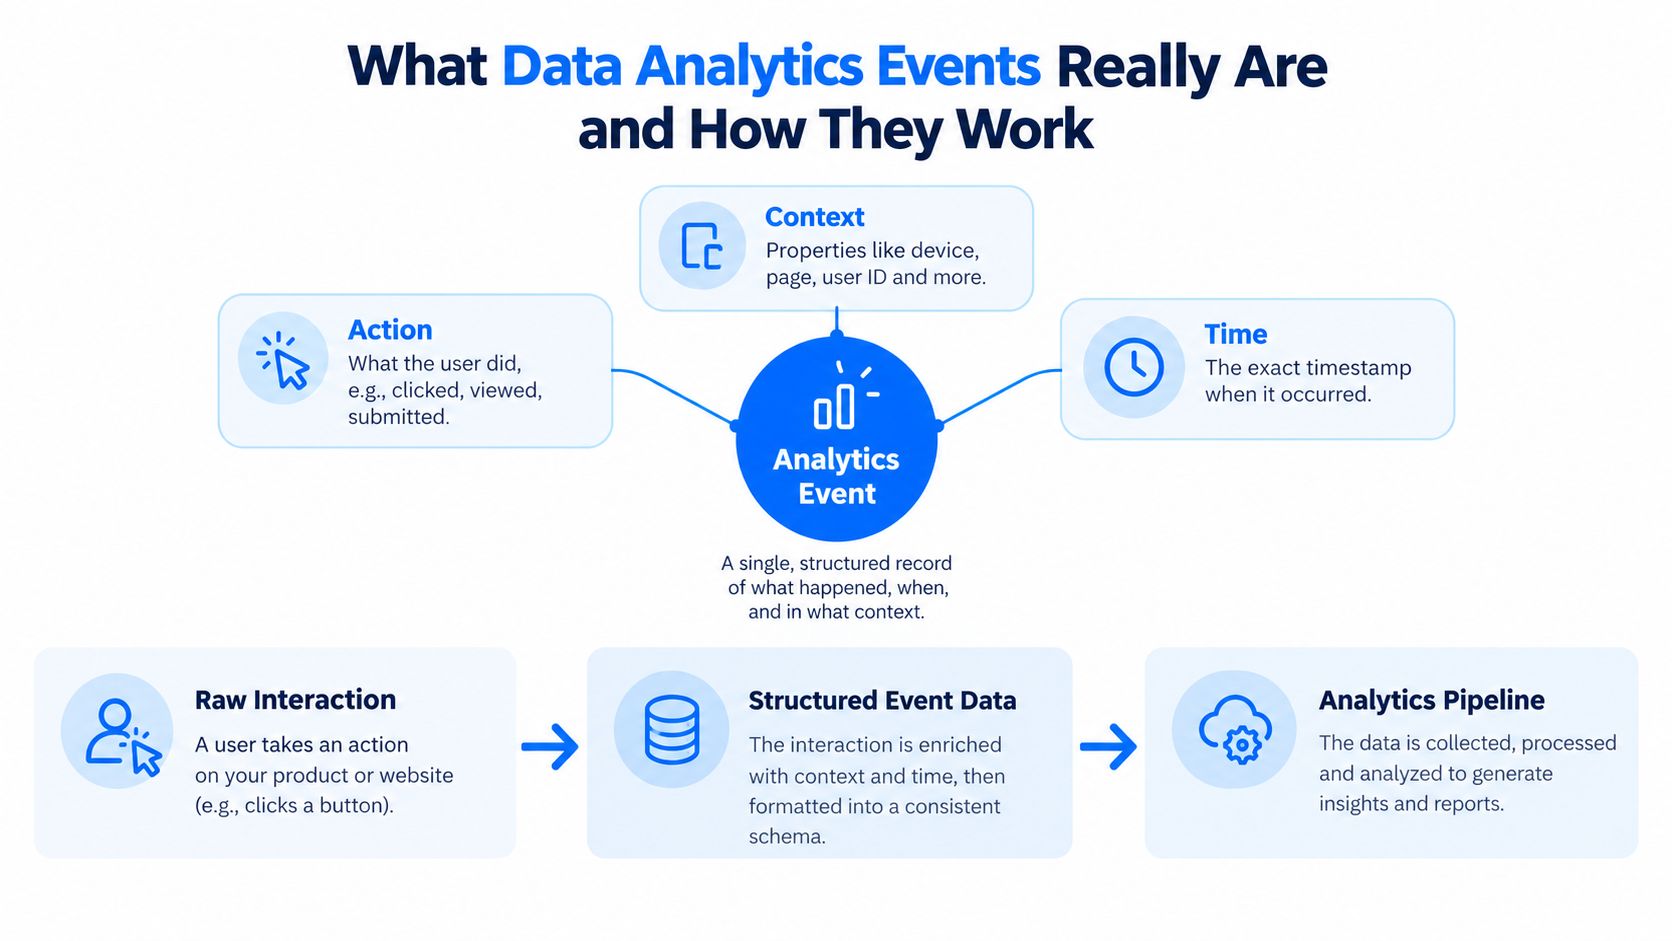
Quando la semantica resta stabile, il lavoro a valle diventa più semplice. I dati degli eventi possono supportare dashboard, esperimenti, feature di raccomandazione e monitoraggio operativo senza che ogni team inventi la propria versione della verità.
Progettare un modello di eventi che cresca con il prodotto
Un modello di eventi scalabile parte dalla sobrietà. I team spesso vogliono strumentare tutto in una volta e finiscono con un catalogo affollato di eventi quasi duplicati che nessuno sa spiegare sei mesi dopo. Un modello migliore mantiene la tassonomia ridotta, assegna nomi chiari e separa ciò che è accaduto dai dettagli che lo circondano.
Partite dalle categorie, poi date all'evento un nome chiaro
Una tassonomia duratura di solito parte da categorie ampie come le azioni degli utenti e gli eventi di sistema. Da lì, la convenzione di denominazione deve restare coerente, spesso nello stile verbo_sostantivo, come user_signed_up o invoice_failed. Questo pattern aiuta sia le persone sia le macchine a leggere l'evento senza dover indovinare quale parte sia l'azione e quale l'oggetto.
La decisione successiva è se un dettaglio debba diventare un nuovo evento o una proprietà. Se l'azione principale è la stessa ma cambia un attributo, mantenetelo come proprietà. Se cambia il significato dell'azione stessa, create un nuovo evento. Questa separazione impedisce al modello di trasformarsi in un lungo elenco di casi particolari.
Decidete quali campi sono obbligatori
Ogni evento dovrebbe avere un breve elenco di campi obbligatori che rendono il record utilizzabile. Identità, timestamp e contesto principale di solito rientrano qui. Le proprietà facoltative possono aggiungere dettagli, ma non dovrebbero essere necessarie per l'interpretazione di base, perché renderebbero la strumentazione fragile.
Anche la risoluzione dell'identità richiede una riflessione ponderata. Un utente può comparire prima come anonimo e poi come autenticato. Se il modello non riesce a collegare questi stati in modo pulito, l'analisi dei funnel e il reporting sul ciclo di vita diventano rumorosi. Lo stesso evento può essere tecnicamente valido pur restando analiticamente incompleto.
Per i team che vogliono una struttura incentrata sul warehouse, l'idea è strettamente legata alla disciplina delle tabelle dei fatti e delle dimensioni. Gli eventi fungono da fatti, mentre i campi di contesto aiutano gli analisti a segmentarli in modo stabile.

I buoni modelli di eventi rendono più facile rispondere alle domande future, non più difficile porle.
La documentazione conta quanto la denominazione. Gli ingegneri hanno bisogno dei dettagli di implementazione e gli analisti di definizioni in linguaggio semplice. Se entrambi i gruppi possono leggere lo stesso contratto, le modifiche al prodotto smettono di generare interpretazioni inattese.
Errori comuni che corrompono i dati degli eventi e come evitarli
La maggior parte dei problemi degli eventi all'inizio non sembra grave. La pipeline continua a girare. La dashboard continua ad aggiornarsi. Il problema è che i dati diventano meno fedeli nel tempo, e la corruzione tende a emergere nelle analisi prima che negli alert.
Pattern sani e pattern problematici
Pattern problematico | Perché è dannoso | Pattern più sano |
|---|---|---|
Denominazione incoerente | Metriche frammentate, join non funzionanti, lettori confusi | Denominazione standardizzata tra i team |
Proprietà mancanti | Gli analisti perdono il contesto e ricorrono a supposizioni | Campi obbligatori per il contesto critico |
Proprietà sovraccariche | Un campo significa troppe cose | Eventi con un unico scopo e proprietà chiare |
Invio duplicato | I funnel sovrastimano, l'attribuzione diventa rumorosa | Deduplicazione in fase di cattura o di ingestion |
Valori predefiniti impliciti | Conversioni silenziose nascondono il comportamento reale | Valori espliciti e regole documentate |
Il problema più difficile di solito non è la cattiva volontà, ma la deriva. Un producer cambia il nome di un campo, elimina una proprietà o inizia a inviare una struttura diversa senza avvisare il team a valle. Ecco perché lo schema drift compromette le pipeline di dati così spesso, e perché il catalogo degli eventi ha bisogno di una ownership attiva.
Attenzione agli errori di tempistica e di fuso orario
Gli errori di tempistica sono facili da non notare perché l'evento arriva comunque. Arriva solo nel bucket sbagliato, nel giorno sbagliato o con un'ipotesi errata sul fuso orario. Per le metriche operative e l'analisi delle coorti, questo può distorcere la storia senza far fallire la query.
Gli eventi duplicati causano un danno di tipo diverso. Un utente fa clic una volta, ma la piattaforma lo registra due volte. Un passaggio del funnel sembra più forte di quanto sia. Una feature del modello risulta gonfiata. La soluzione di solito non sono più dashboard, ma regole di cattura e logiche di validazione più chiare.
Regola pratica: se un campo può significare due cose diverse, separatelo prima che l'ambiguità si propaghi.
L'abitudine di revisione più sicura è seguire ogni evento dal producer alla dashboard e porsi una domanda a ogni passaggio: «Significa ancora la stessa cosa?». Se la risposta cambia, il contratto va sistemato prima che altri consumatori vi facciano affidamento.
Validare la qualità degli eventi con contratti e segnali osservabili
Un evento di data analytics dovrebbe comportarsi come un contratto con un battito cardiaco. L'accordo viene definito prima di qualsiasi rilascio, poi la pipeline continua a verificare se gli eventi reali vi corrispondono ancora in produzione. È attorno a questa mentalità contrattuale che è costruita la guida ai data contract.
Cinque segnali che rivelano tipi diversi di problemi
L'osservabilità moderna di solito traccia freschezza, qualità, volume, schema e lineage come delineato nel modello di osservabilità. La freschezza verifica se i dati sono arrivati quando previsto. La qualità verifica se valori e tipi hanno ancora senso. Il volume controlla se il conteggio appare normale. Lo schema controlla se la struttura è cambiata. La lineage mostra da dove provengono i dati e come si sono spostati.
Ogni segnale indica una diversa modalità di errore. La freschezza intercetta le consegne in ritardo o mancanti prima che le dashboard derivino, ed è per questo che le finestre di consegna dovrebbero corrispondere al modo in cui il business usa i dati come descritto nelle indicazioni sulla tempestività. Il monitoraggio dello schema intercetta campi aggiunti, rimossi, rinominati e cambi di tipo, che è esattamente ciò che il monitoraggio dello schema drift deve far emergere come descritto nella panoramica sul monitoraggio dello schema.
Con il traffico a picchi, le baseline battono le soglie fisse
Il traffico degli eventi raramente resta piatto. Lanci, campagne e cicli di business modificano la forma del flusso. Le baseline mobili e consapevoli della stagionalità funzionano meglio delle soglie fisse per molti flussi di eventi, perché confrontano il comportamento attuale con un periodo omogeneo invece di presumere che ogni giorno debba essere identico come raccomandato nelle pratiche di rilevamento dell'event drift.
La validazione del contratto dovrebbe avvenire il prima possibile, idealmente in fase di ingestion. Le modifiche additive possono essere sicure quando preservano la retrocompatibilità. Le modifiche che causano rotture dovrebbero essere messe in quarantena. I campi grezzi dovrebbero restare disponibili quando una conversione cancellerebbe il significato. Questa disciplina riduce le rotture silenziose e impedisce che il rumore degli alert si diffonda nel team come descritto nelle indicazioni sui contratti per i flussi di eventi.
Segnale | A che cosa risponde | Quale errore può rivelare |
|---|---|---|
Freschezza | È arrivato in tempo? | Caricamenti in ritardo, consegne mancate |
Qualità | I dati sono validi? | Tipi errati, valori non validi |
Volume | Il conteggio è quello atteso? | Batch mancanti, ondate di duplicati |
Schema | La struttura è cambiata? | Campi aggiunti, rimossi, rinominati |
Lineage | Da dove proviene? | Sorgente poco chiara, trasformazione nascosta |
L'obiettivo non è avere più regole. È rendere il comportamento degli eventi abbastanza visibile da permettere ad analisti e ingegneri di fidarsi dei dati senza leggere ogni riga di log.
Mettere in pratica l'osservabilità degli eventi con digna
Rendere operativa la qualità degli eventi significa trattare la pipeline come un sistema vivo, non come un asset statico. I team hanno bisogno di un modo per sorvegliare i tempi di consegna, rilevare le modifiche strutturali e far emergere i comportamenti insoliti senza configurare una regola separata per ogni dataset.
digna lo fa funzionando all'interno dell'ambiente del cliente ed eseguendo i controlli nel database, così i dati restano dove sono. Il suo set di moduli comprende tempestività, tracciamento dello schema, validazione dei dati e anomalie dei dati, con una dashboard condivisa per ingegneri, analisti e stakeholder della governance. Questa impostazione è importante perché lo stesso flusso di eventi deve spesso servire contemporaneamente reporting, alerting e input dei modelli.
Per i team che cercano un riferimento operativo più ampio, la panoramica sulla data observability mostra come questi elementi si integrano negli ambienti di produzione. L'idea di fondo è semplice. I controlli di tempestività verificano le finestre di consegna attese. Il tracciamento dello schema intercetta campi aggiunti o rimossi e cambi di tipo. Il rilevamento delle anomalie può apprendere il comportamento normale e far emergere gli scostamenti senza regole costruite a mano.
Questo mix è particolarmente utile quando i team di prodotto rilasciano spesso. Una modifica che sembra innocua in una pull request può comunque cambiare la forma di un evento, ritardare un feed o alterare i conteggi a valle. Il monitoraggio ne intercetta l'effetto dove conta, sul percorso effettivo dei dati.
Se state confrontando strumenti operativi per sistemi ad alta intensità di eventi, gli strumenti per i prediction market di polybacktest sono un utile riferimento affine per vedere come l'approccio all'osservabilità si ritrova in altri workflow basati sugli eventi. La lezione generale si applica senza difficoltà: i dati degli eventi diventano affidabili quando la qualità viene misurata in modo continuo, non data per scontata dopo il deployment.
Costruire eventi di analytics affidabili nel lungo periodo
Gli eventi affidabili non nascono per caso. Derivano da una catena di decisioni, dalla prima definizione di un'azione fino ai controlli che mantengono quella definizione fedele nel tempo. Se un anello è debole, tutto lo stack di analytics ne risente.
Il modo più semplice per stabilire le priorità è porsi tre domande. Quali eventi guidano le decisioni più importanti? Quali sono più soggetti a derivare man mano che il prodotto cambia? Quali non hanno un responsabile chiaro? Sistemate prima questi, perché sono gli eventi con maggiore probabilità di causare danni analitici silenziosi.
L'ownership conta quanto gli strumenti. Gli ingegneri devono sapere chi approva le modifiche allo schema. Gli analisti devono sapere quali definizioni sono stabili. I team di governance hanno bisogno di visibilità su che cosa è cambiato e quando. Quando questi ruoli sono chiari, la qualità degli eventi smette di essere un problema di tutti e diventa un processo gestito.
Il vantaggio di lungo periodo non sono solo dashboard più pulite. Sono analisi più rapide, meno rilavorazioni e maggiore fiducia quando i team usano l'analytics per guidare il prodotto e i sistemi di AI. Se il vostro catalogo di eventi vi sembra ancora fragile, verificate le definizioni, rafforzate i contratti e mettete l'osservabilità sul percorso critico prima che il prossimo drift silenzioso arrivi in produzione.
Se volete un modo pratico per rendere i dati degli eventi più affidabili, visitate digna e scoprite come la sua validazione nel database, il tracciamento dello schema, il monitoraggio della tempestività e il rilevamento delle anomalie si inseriscono in un unico workflow operativo. È pensato per i team che hanno bisogno che gli eventi di analytics restino affidabili mentre prodotti, pipeline e consumatori continuano a cambiare.
Domande frequenti
Che cos'è un evento di data analytics?
Una ricevuta di un'azione. Ogni evento solido ha bisogno di tre ingredienti: l'azione, il contesto e il tempo. Se non riuscite a spiegare questi tre elementi in parole semplici, l'evento è ancora troppo vago per essere affidabile, qualunque cosa dica il piano di tracking.
In che cosa un evento differisce da un'entità o da una sessione?
Un evento registra che qualcosa è accaduto in un determinato momento, mentre un'entità descrive qualcosa che persiste e una sessione raggruppa l'attività in una finestra temporale. Confonderli è un errore di modellazione comune, ed è il motivo per cui le metriche a valle smettono di concordare tra loro.
Come andrebbero denominati e strutturati gli eventi?
Partite dalla sobrietà. Costruite una tassonomia duratura a partire da categorie ampie come le azioni degli utenti e gli eventi di sistema, poi decidete in modo ponderato se un nuovo dettaglio debba diventare un nuovo evento o una proprietà. Ogni evento ha inoltre bisogno di un breve elenco di campi obbligatori che rendano il record utilizzabile.
Che cosa fa derivare i dati degli eventi?
Il significato cambia più in fretta del codice di tracking. Un evento resta tecnicamente presente mentre la sua semantica cambia sotto la superficie, così le dashboard sembrano tranquille mentre i numeri smettono di corrispondere a ciò che vedono vendite, prodotto e supporto. Un evento è utile solo quando il suo significato resta abbastanza stabile da permettere a persone e sistemi di farvi affidamento.
Perché la risoluzione dell'identità richiede una riflessione ponderata?
Perché determina se gli eventi relativi alla stessa persona si collegano davvero. Stabilite i campi di identità obbligatori quando progettate il modello invece di correggerli in seguito, e documentate la decisione, perché la documentazione conta quanto la denominazione per continuare a poter rispondere alle domande future.


