Dimensioni della qualità dei dati: le 9 metriche fondamentali spiegate
|
10
min di lettura

La qualità dei dati è definita da nove dimensioni standard nel DAMA-DMBOK® 2.0 Revised Edition, non da un unico punteggio universale. Un dataset serve allo scopo previsto solo quando le dimensioni rilevanti, come accuratezza, completezza, coerenza, attualità, integrità, tempestività, unicità, validità e ragionevolezza, soddisfano le esigenze dei suoi utenti.
L'aspetto controintuitivo è che anche dati accurati possono risultare inutilizzabili. Un record cliente può corrispondere alla realtà ma arrivare dopo una decisione sulla campagna, oppure una tabella completa può contraddire i sistemi sorgente su cui fanno affidamento i team di business. La qualità dei dati è la misura di quanto bene i dati servono allo scopo previsto, valutata su più dimensioni distinte anziché con un unico punteggio.
Indice
Definire la qualità dei dati negli stack di dati moderni
La qualità dei dati descrive se i dati sono adatti a uno specifico scopo di business, analitico, operativo o normativo. Un team finanza può richiedere dati sulle transazioni altamente accurati e coerenti per il reporting, mentre un team operativo può tenere di più al fatto che gli eventi arrivino in tempo e che ogni record richiesto sia presente. Nessuno dei due team può definire la qualità indipendentemente dalla decisione che i dati supportano.
Trattare la qualità come un unico numero nasconde queste differenze. Una tabella del warehouse può superare una verifica di accuratezza pur contenendo record mancanti, valori non aggiornati, clienti duplicati o formati non validi. Un unico punteggio aggregato può anche far sparire un guasto grave dietro buone prestazioni in aree non correlate.
Perché un unico punteggio non funziona
La qualità dei dati è un costrutto multidimensionale. Le rassegne della letteratura indicano accuratezza, completezza, coerenza, tempestività e pertinenza tra le dimensioni citate più spesso, mentre framework più ampi includono validità, unicità, credibilità, interpretabilità e sicurezza. La conseguenza pratica è semplice: collegate ogni controllo alla modalità di guasto che deve prevenire, invece di chiedervi se un dataset è “buono” o “cattivo” (rassegna sulle dimensioni della qualità dei dati).
Per un data engineer, ciò significa verificare se i caricamenti richiesti sono arrivati, se i valori rispettano tipi e intervalli e se i record concordano tra i sistemi. Per un analista, può significare confermare che una metrica ha una definizione stabile e un pattern di aggiornamento affidabile. Per un responsabile di business, la domanda centrale è se i dati supportano una decisione senza creare rischi inaccettabili.
Regola pratica: partite dalla decisione, poi definite le dimensioni che possono farla fallire.
Gli stack moderni rendono questo contesto più difficile da gestire, perché i dati attraversano database, API, pipeline ETL ed ELT, warehouse, dashboard e feature store per l'AI. Ogni passaggio può introdurre un difetto diverso. Un sistema sorgente può imporre un campo come obbligatorio mentre una trasformazione a valle lo converte in una colonna nullable, oppure un evento in ritardo può essere tecnicamente valido ma irrilevante per una dashboard con vincoli temporali.
I team che lavorano tra cloud warehouse e integrazioni enterprise possono anche trarre vantaggio dal capire come i partner di implementazione affrontano l'architettura delle piattaforme. Ad esempio, la partnership di Faberwork LLC con Snowflake offre un contesto utile per le organizzazioni che progettano piattaforme dati in cui i controlli di qualità devono operare sui livelli di ingestione, trasformazione e consumo.
Il framework delle 9 dimensioni della qualità dei dati
Quali sono le 9 dimensioni della Data Quality? Il DAMA-DMBOK® 2.0 Revised Edition individua nove dimensioni standard ampiamente condivise: accuratezza, completezza, coerenza, attualità, integrità, tempestività, unicità, validità e ragionevolezza. La revisione aggiunge l'attualità (Currency) al precedente insieme di otto dimensioni e usa il termine Reasonableness al posto di Reasonability (dettagli della revisione DAMA-DMBOK® 2.0).
Usate la tabella come riferimento operativo, non come sostituto del contesto di business. Ogni dimensione descrive un modo diverso in cui i dati possono fallire.
Dimensione | Definizione | Esempio enterprise |
|---|---|---|
Accuratezza | I dati rappresentano correttamente l'entità, l'evento o il valore del mondo reale che descrivono. | L'indirizzo postale di un cliente corrisponde a quello registrato in una fonte operativa attendibile. |
Completezza | Record, campi e valori richiesti sono presenti per l'uso previsto. | Ogni transazione finanziaria approvata include un identificativo di conto, un importo e una data di registrazione. |
Coerenza | I dati non sono in conflitto tra sistemi, tabelle, record o regole di business definite. | Il warehouse e il database di fatturazione classificano lo stesso conto con lo stesso stato cliente. |
Attualità | I dati riflettono lo stato attuale dell'oggetto o del processo reale. | Un record di magazzino riflette l'ultima posizione di stock nota anziché uno stato precedente. |
Integrità | Le relazioni tra gli elementi dei dati restano valide e logicamente coerenti. | Ogni riga d'ordine fa riferimento a un ordine e a un prodotto esistenti tramite relazioni valide. |
Tempestività | I dati diventano disponibili entro il periodo adeguato all'uso previsto. | Una dashboard di rischio riceve il feed di transazioni richiesto prima dell'inizio della revisione di business. |
Unicità | Ogni oggetto reale compare una sola volta laddove la duplicazione distorcerebbe il caso d'uso. | Un'anagrafica clienti contiene un unico record governato per ciascuna entità cliente. |
Validità | I valori sono conformi al tipo, al formato, all'intervallo, al dominio o alla regola definiti. | Lo stato di una transazione appartiene all'insieme di stati ammessi e un importo usa il tipo numerico previsto. |
Ragionevolezza | Valori e relazioni sono plausibili nel contesto e non violano il comportamento di business atteso. | Una quantità venduta è tecnicamente valida ma viene segnalata perché non plausibile per il prodotto e il contesto dell'ordine. |
Le distinzioni contano in fase di diagnosi. Un identificativo cliente mancante è un problema di completezza, mentre un identificativo con un formato non valido è un problema di validità. Un cliente duplicato è un problema di unicità, mentre un cliente collegato al conto sbagliato può indicare un guasto di integrità o di accuratezza.
In fase di implementazione, abbinate a ogni dimensione una metrica e un'azione. Un controllo di completezza può contare i valori obbligatori mancanti, un controllo di unicità può individuare duplicati inattesi e un controllo di validità può verificare tipi di dato, formati, classi e intervalli. I team che cercano ulteriori misure pratiche possono usare questi esempi di metriche di qualità dei dati come punto di partenza per progettare i propri controlli.
Come le dimensioni interagiscono e creano compromessi
Le dimensioni della qualità dei dati non operano in modo indipendente. Migliorarne una può renderne un'altra più difficile da mantenere, soprattutto quando le pipeline hanno finestre di consegna fisse o la qualità delle sorgenti è disomogenea.
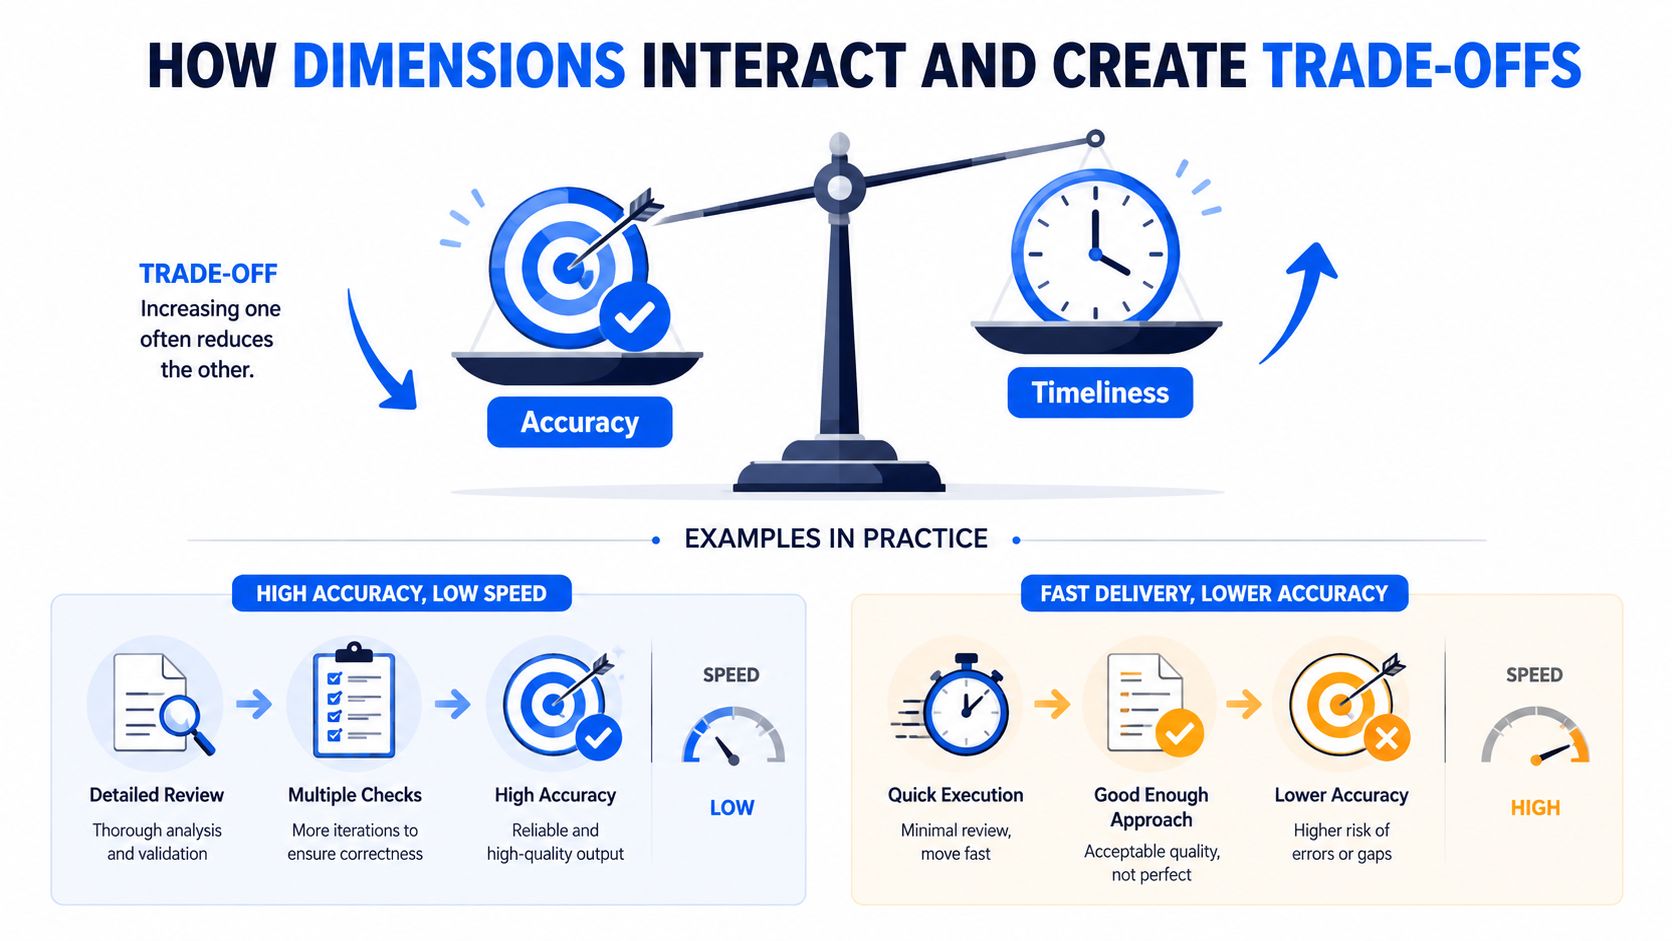
Pensate a un caricamento nel warehouse che riceve transazioni dei clienti durante tutta la giornata. Un team di ingegneria può ritardare la pubblicazione finché la riconciliazione non risolve le discrepanze, migliorando accuratezza e coerenza. Il ritardo può però far mancare a una dashboard la sua finestra decisionale, riducendo tempestività e attualità. Pubblicare subito preserva la freschezza, ma può esporre record incompleti o in conflitto.
Conflitti comuni in produzione
Accuratezza contro tempestività è il compromesso più evidente. Un report normativo può giustificare il trattenimento dei dati fino al termine della riconciliazione, mentre un workflow di monitoraggio delle frodi può aver bisogno di un segnale imperfetto ma immediato. Scegliete in base alle conseguenze dell'attesa e a quelle di agire su dati provvisori.
Validità contro completezza possono entrare in conflitto durante l'ingestione. Una regola rigorosa può scartare valori malformati e proteggere i consumatori a valle da dati non validi. Lo scarto può però lasciare incompleta la tabella di destinazione, a meno che la pipeline non metta i record in quarantena, segnali l'errore e preveda un percorso di correzione.
Coerenza contro autonomia delle sorgenti crea un'ulteriore tensione. Standardizzare lo stato cliente tra CRM, piattaforma di fatturazione e warehouse migliora la coerenza, ma ogni sistema può usare quel campo per uno scopo locale legittimo. Una definizione canonica governata, affiancata da attributi specifici di sistema documentati, può funzionare meglio che imporre l'uniformità ovunque.
Una pipeline nei servizi finanziari darà di solito priorità ad accuratezza, coerenza, completezza e integrità per il reporting critico per il business. Un feed di personalizzazione per l'e-commerce può privilegiare tempestività e attualità, consentendo arricchimenti tardivi controllati. Nessuno dei due insiemi di priorità vale per ogni caso d'uso.
Anche l'architettura modifica il compromesso. Le pipeline batch possono trattenere un'intera consegna per la riconciliazione, mentre i sistemi di streaming spesso pubblicano eventi provvisori e li correggono in seguito. Queste correzioni richiedono che i consumatori comprendano aggiornamenti, ritrattazioni e stato dei record.
Un obiettivo di qualità utile non è il “dato perfetto”. È un dato sufficientemente affidabile per una decisione definita, con eccezioni note e responsabili identificati.
Monitorate le dimensioni separatamente. Un dataset può essere accurato ma in ritardo, oppure completo ma incoerente tra i sistemi sorgente. Un unico punteggio aggregato può nascondere proprio il guasto più importante. Metriche separate mostrano il compromesso invece di annullarlo in una media.
Dalle regole statiche all'osservabilità basata sull'AI
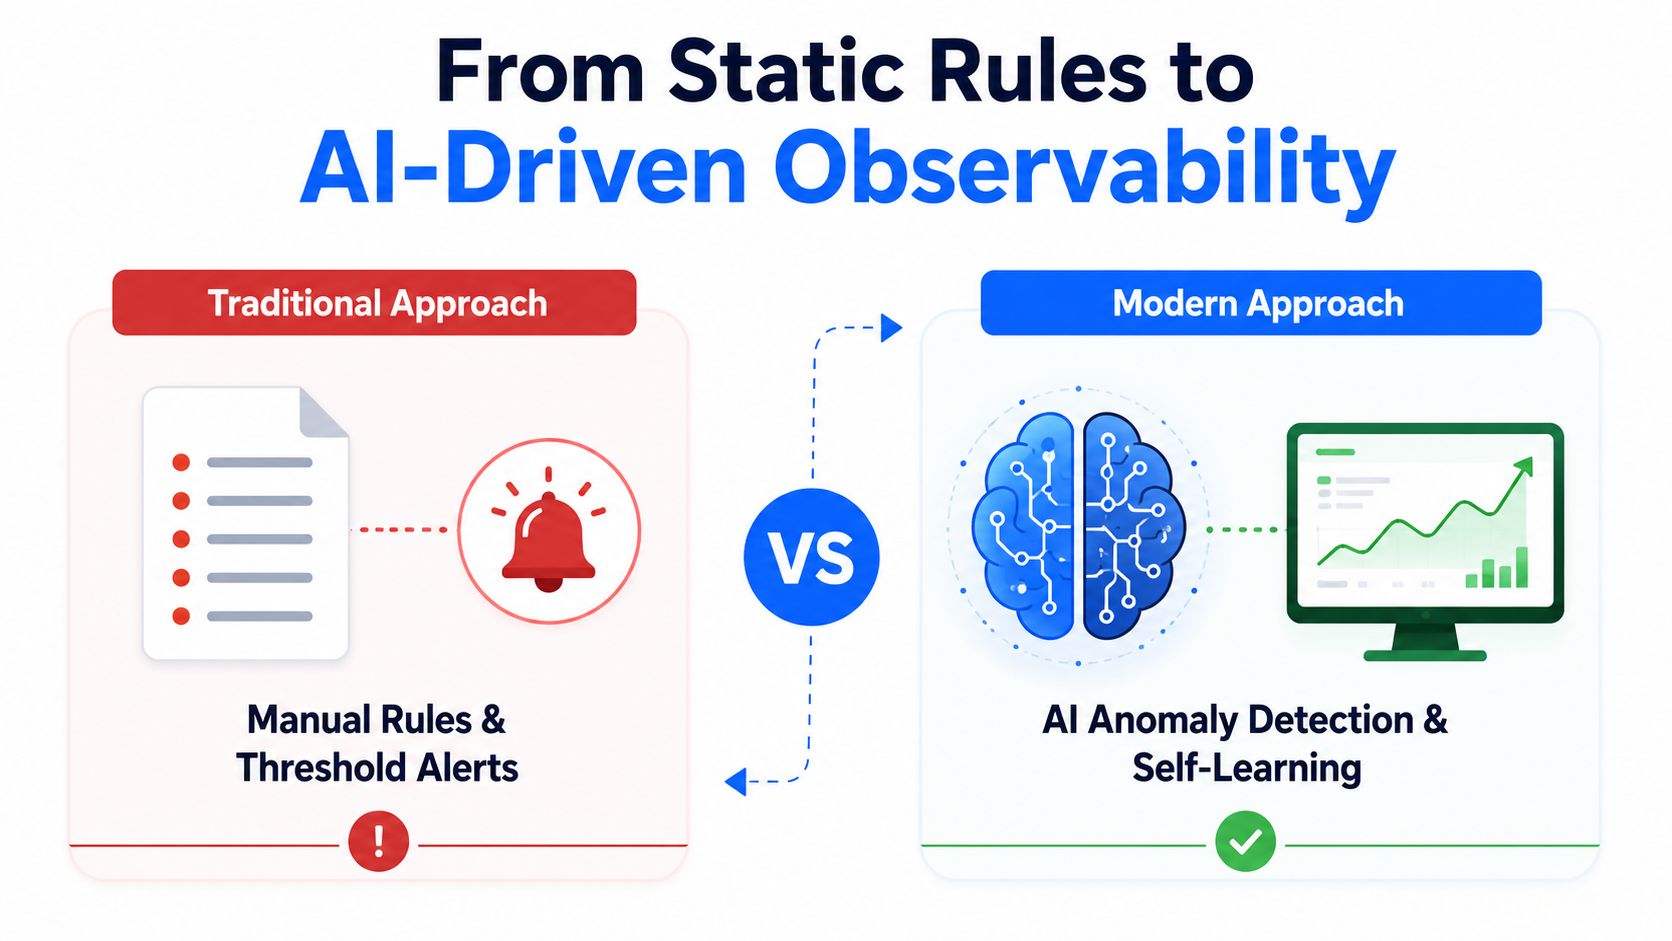
Il monitoraggio tradizionale della qualità dei dati si basa su test SQL scritti a mano, soglie fisse e alert configurati per modalità di guasto note. Questi controlli restano preziosi. Una regola che richiede un identificativo di conto non nullo o scarta uno stato non valido è esplicita, verificabile e facile da spiegare.
Il punto debole emerge su larga scala. Gli ingegneri devono mantenere le regole man mano che cambiano schemi, sorgenti, processi di business e intervalli accettabili. Le soglie fisse possono anche generare alert fatigue quando le normali variazioni stagionali od operative fanno scattare ripetutamente gli avvisi. I controlli basati su regole rilevano ciò che i team avevano previsto, ma possono non cogliere variazioni insolite in distribuzioni, volumi o relazioni che nessuno ha codificato.
Cosa aggiunge l'osservabilità
L'osservabilità moderna combina controlli deterministici con baseline storiche, rilevamento delle anomalie, contesto di lineage e workflow di gestione degli incidenti. Invece di chiedersi soltanto se è stata superata una soglia codificata, la piattaforma può valutare se il comportamento attuale si discosta dal pattern consolidato del dataset.
Questo approccio è particolarmente utile per metriche come numero di righe, distribuzioni dei valori, comportamento dei valori nulli e tempi di consegna. Non elimina le regole di business, ma le integra coprendo comportamenti inattesi che la validazione statica potrebbe non prevedere. I team che esplorano l'osservabilità dell'AI possono consultare anche la spiegazione di Doczen sull'AI observability per un contesto sul monitoraggio dei sistemi di AI e del comportamento dei dati.
Il mercato si sta inoltre estendendo oltre le tabelle strutturate dei warehouse. Uno studio di settore del 2025 ha rilevato che il 62% delle organizzazioni stava esplorando i dati semi-strutturati, il 28% li utilizzava attivamente e il 60% stava valutando i documenti non strutturati (trend della data observability 2025). La stessa fonte riportava una maturità dell'osservabilità dell'88% in Nord America contro il 47% in Europa, a dimostrazione di un'adozione disomogenea tra le regioni.
Log, documenti, flussi di eventi e corpus multimodali per l'AI richiedono interpretazioni diverse di completezza e coerenza. Per una raccolta di documenti, la completezza può riguardare i file attesi, i campi estraibili o il testo utilizzabile. Per un flusso di eventi, la tempestività può dipendere dai pattern di arrivo anziché dall'aggiornamento giornaliero di una tabella.
I team possono usare la panoramica di digna sulla data observability per capire come il monitoraggio continuo si affianchi a validazione, rilevamento delle anomalie, monitoraggio della tempestività e dello schema. Un buon design mantiene regole esplicite per i requisiti noti e usa il comportamento appreso per individuare le deviazioni che meritano un'indagine.
Scegliere le dimensioni giuste per il vostro caso d'uso
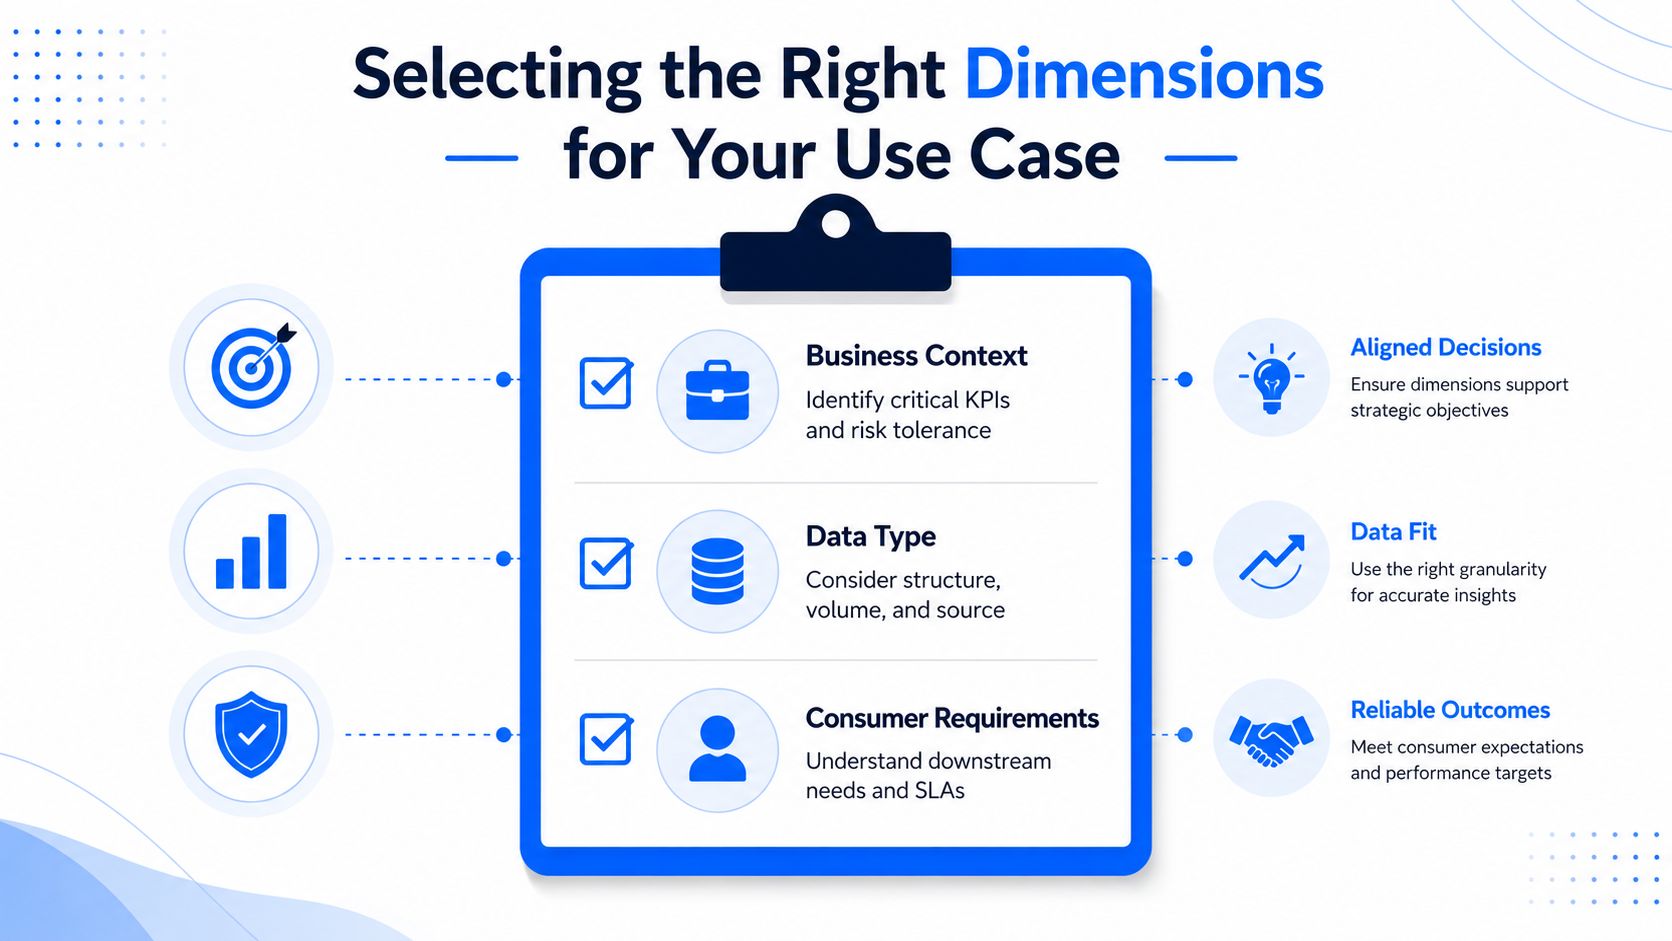
Come dovrebbe scegliere un team tra le dimensioni della qualità dei dati? Partite dalla decisione di business, individuate gli elementi di dati che la influenzano, comprendete come i dati attraversano l'architettura e poi date priorità alle modalità di guasto con le conseguenze operative, normative o finanziarie più gravi.
Un'indagine del 2025 sostiene che il campo è più ampio e più dipendente dal contesto di una checklist statica. Aggiunge dimensioni come accessibilità, conformità, reputazione, portabilità e attualità, sottolineando che le indicazioni pratiche su compromessi e definizione delle priorità restano limitate (indagine sulle dimensioni della qualità dei dati).
Un metodo pratico per stabilire le priorità
Il reporting normativo di solito parte da accuratezza, completezza, coerenza e integrità. Il team dovrebbe identificare il sistema di riferimento, riconciliare i totali chiave, validare i valori ammessi e conservare le evidenze delle eccezioni. La tempestività conta comunque, ma la finestra di consegna accettabile può essere definita dal processo di reporting anziché dalle operazioni in tempo reale.
L'analytics in tempo reale attribuisce più peso a tempestività e attualità. Una dashboard che mostra le condizioni operative correnti può diventare fuorviante quando il feed è in ritardo, anche se ogni record consegnato è accurato. Completezza e coerenza restano importanti, in particolare quando gli utenti confrontano le metriche live con i dati storici del warehouse.
I feature store per AI e machine learning necessitano di controlli solidi su validità, unicità, tempestività e integrità. Valori di feature non validi possono interrompere le trasformazioni o distorcere le previsioni, i duplicati possono sovrappesare determinate entità e le feature non aggiornate possono rappresentare in modo errato il comportamento attuale. I controlli appropriati dovrebbero seguire le definizioni delle feature del modello e le aspettative di serving.
I Critical Data Elements, o CDE, meritano una copertura più ampia rispetto agli attributi a basso rischio. Un CDE può supportare un report normativo, un processo di identificazione dei clienti, un calcolo finanziario o una feature di un modello. Monitorate diverse dimensioni rilevanti per ciascuno, assegnate un responsabile e definite cosa succede quando un controllo fallisce.
Un primo passaggio utile si presenta così:
Mappate il consumatore: individuate chi utilizza i dati e quale decisione ne dipende.
Tracciate il percorso: documentate il database sorgente, le trasformazioni ETL o ELT, le tabelle del warehouse e i prodotti a valle.
Identificate il guasto: scegliete le dimensioni in base a modalità di guasto realistiche, non a una checklist generica.
Definite la risposta: decidete se bloccare, mettere in quarantena, avvisare o registrare un'eccezione.
Estendete gradualmente: iniziate dagli elementi di dati a più alto rischio, poi ampliate il monitoraggio man mano che ownership ed evidenze migliorano.
Per i team che progettano controlli misurabili, le metriche di qualità dei dati di digna offrono un riferimento pertinente per collegare le dimensioni a misurazioni operative.
Implementare il monitoraggio continuo della qualità dei dati
Monitoraggio continuo significa che i controlli di qualità vengono eseguiti mentre i dati si muovono e cambiano, invece di attendere un audit periodico. La distinzione è importante perché un feed in ritardo può influire su una dashboard o su un feature store prima della successiva revisione pianificata. La tempestività è una dimensione tecnica distinta perché i dati perdono valore di business quando non sono disponibili nel momento previsto. Viene comunemente valutata rispetto a pianificazioni di consegna, soglie di latenza o SLA di freschezza, e riguarda il fatto che i dati siano elaborati prontamente, aggiornati e adatti al compito (ricerca sulla tempestività dei dati).
Un'introduzione pratica può iniziare da un singolo dominio di warehouse o database ad alto valore. Profilatene il comportamento normale, osservate i pattern di consegna e individuate quali colonne e tabelle supportano i workflow critici per il business. Da lì, aggiungete controlli adeguati ai rischi invece di tentare di monitorare ogni oggetto contemporaneamente.
Un modello operativo modulare
Una piattaforma come digna è un esempio di approccio modulare. I team possono iniziare con Data Anomalies per l'apprendimento della baseline, quindi aggiungere il monitoraggio Timeliness per caricamenti mancanti o in ritardo, Data Validation per le regole di business a livello di record e Schema Tracker per i campi aggiunti, rimossi o modificati.
L'implementazione dovrebbe mantenere i dati dove già si trovano. L'esecuzione in-database consente alla piattaforma di calcolare le metriche ed eseguire le analisi all'interno dei database del cliente, riducendo gli spostamenti non necessari e supportando ambienti con requisiti di sicurezza rigorosi. Il deployment può avvenire in private cloud o on-premises, a seconda dell'infrastruttura e del modello di governance dell'organizzazione.
Il monitoraggio continuo ha bisogno anche di contesto operativo. Una dashboard condivisa dovrebbe collegare gli alert alla tabella, alla pipeline, al responsabile e al consumatore a valle interessati. Le integrazioni con scheduler, cataloghi e workflow di collaborazione aiutano i team a passare dal rilevamento alla diagnosi senza creare un processo manuale separato.
La decisione progettuale più importante è la policy di risposta. Una regola di validità violata può bloccare un rilascio, mentre una metrica insolita può generare un alert di indagine. Una consegna mancante può far scattare una chiamata all'ingegnere on-call per un feed critico, ma solo una notifica a bassa priorità per un dataset non essenziale. Il monitoraggio funziona quando aiuta le persone ad agire, non quando produce un flusso indiscriminato di avvisi.
Usate le funzionalità di monitoraggio della qualità dei dati di digna come riferimento per capire come rilevamento delle anomalie, validazione, tempestività e controlli sullo schema possano essere combinati in un modello operativo continuativo.
Costruire la vostra strategia per la qualità dei dati
La gestione della qualità dei dati è la pratica continua di definire, misurare, monitorare e migliorare la qualità dei dati in tutta l'organizzazione. Combina controlli tecnici con ownership, definizioni di business, risposta agli incidenti e governance.
Una roadmap pratica è la seguente:
Analizzate lo stato attuale: profilate database prioritari, tabelle del warehouse, pipeline e report a valle.
Individuate i CDE: contrassegnate gli elementi di dati il cui guasto potrebbe incidere su compliance, ricavi, operazioni, clienti o output dell'AI.
Date priorità alle dimensioni: selezionate le dimensioni adatte al caso d'uso e al rischio di ciascun CDE.
Implementate il monitoraggio: combinate la validazione esplicita con il monitoraggio di anomalie, tempestività e schema.
Rivedete e migliorate: usate gli incidenti e il feedback degli stakeholder per affinare regole, soglie, ownership e copertura.
La lezione centrale è semplice: la qualità è multidimensionale, prioritizzata e continua. Le regole manuali hanno ancora un ruolo, ma richiedono contesto, ownership e un monitoraggio in grado di rilevare sia le violazioni note sia i comportamenti inattesi.
digna offre una piattaforma enterprise di qualità e osservabilità dei dati per monitorare il comportamento dei dati, validare i record, tracciare la tempestività, rilevare le modifiche allo schema e analizzare metriche di business e di piattaforma all'interno dell'ambiente del cliente. Visitate digna per esplorare un approccio modulare al monitoraggio continuo di warehouse, data lake, database e pipeline.
Domande frequenti
Quali sono le dimensioni della qualità dei dati?
DAMA-DMBOK 2.0 ne individua nove: accuratezza, completezza, coerenza, attualità, integrità, tempestività, unicità, validità e ragionevolezza. Ognuna risponde a una domanda diversa sull'idoneità allo scopo, ed è per questo che un unico punteggio di qualità composito nasconde più di quanto riveli.
Perché un unico punteggio di qualità dei dati non funziona?
Perché le dimensioni sono in tensione tra loro. Attendere i record in ritardo migliora la completezza ma penalizza la tempestività; una validazione rigorosa migliora la validità ma può scartare casi limite legittimi. Un unico numero annulla queste tensioni in una media e non dice nulla su cosa correggere.
Qual è la differenza tra accuratezza e validità?
Validità significa che un valore è conforme al formato definito e all'intervallo ammesso. Accuratezza significa che descrive correttamente la realtà. Una data di nascita 1899-01-01 può essere perfettamente valida e del tutto inaccurata, ed è per questo che i soli controlli di validità non sono mai sufficienti.
Come si scelgono le dimensioni da misurare?
Partendo a ritroso dalla decisione che i dati supportano. Il reporting normativo privilegia completezza e integrità; l'alerting operativo privilegia tempestività e attualità; il matching dei clienti privilegia l'unicità. Misurare tutte e nove le dimensioni ovunque produce rumore anziché garanzie.
Che rapporto c'è tra le dimensioni e la data observability?
Le dimensioni definiscono cosa significa “buono”; l'osservabilità rileva quando il comportamento se ne discosta senza che sia stata scritta una regola. Le regole statiche coprono le dimensioni che avevate previsto, mentre l'osservabilità copre variazioni di volume, drift delle distribuzioni e modifiche allo schema per cui non era stato scritto alcun controllo.


