Data quality per il machine learning: costruire sistemi ML robusti
|
6
min di lettura

Il mese scorso il vostro modello sembrava a posto. Le curve di validazione erano pulite, la demo aveva colpito gli stakeholder e la pipeline aveva superato tutti gli unit test del vostro team. Poi la produzione ha iniziato a comportarsi come una casa infestata. Le raccomandazioni sono scivolate nell'assurdo. Gli score antifrode sono diventati stranamente piatti. Una dashboard che di solito si aggiorna prima della riunione del mattino ha iniziato a mostrare la verità di ieri con il timestamp di oggi.
Questo tipo di guasto raramente nasce dal modello stesso. Nasce da dati che arrivano in ritardo, arrivano malformati o arrivano con un danno silenzioso appena sufficiente a evitare un crash vero e proprio. Gli incidenti peggiori non fanno rumore. Sono abbastanza sottili da superare il primo giro di controlli e abbastanza costosi da minare la fiducia prima che qualcuno individui il pattern.
La data quality per il machine learning smette di essere un'incombenza di preprocessing e diventa una disciplina operativa. La pulizia in fase di training aiuta, ma il ML in produzione vive o muore in base a ciò che accade dopo il deployment, dentro le pipeline, le tabelle, le feature view e le schedulazioni che alimentano il modello. Per i team che operano in ambienti europei regolamentati, la sfida diventa ancora più impegnativa. Servono un monitoraggio più robusto, una governance più rigorosa e spesso una minore libertà di spostare i dati solo per ispezionarli.
Il fantasma nel modello di machine learning
Un incidente tipico va così. Un modello di ranking inizia a rendere meno sul traffico live, ma nulla di evidente è rotto. Nessun job fallito. Nessuna tabella mancante. Nessun alert dal livello di serving. Il team apre i notebook, confronta le predizioni recenti, controlla la feature importance e inizia a dare la colpa alla frequenza di retraining.
Ore dopo, qualcuno nota che una sorgente a monte ha cambiato il modo in cui popola un singolo campo. Non abbastanza da provocare un errore di schema. Appena abbastanza da spostare il significato di una feature che il modello considerava stabile. La pipeline ha continuato a girare. Il modello ha continuato a produrre score. Gli utenti di business hanno continuato a perdere fiducia.
È questo il fantasma del ML in produzione. Non una corruzione spettacolare, ma un degrado silenzioso.
Ho visto team trattare questa situazione come un problema del modello quando in realtà è un problema di observability. Fanno retraining troppo presto, ritoccano le soglie troppo spesso e aggiungono controlli ad hoc che calmano i nervi per una settimana e creano debito di manutenzione per un anno. Il modello diventa il sospettato perché è visibile. Il danno agli input resta nascosto perché il livello dei dati non è strumentato abbastanza bene.
I modelli guasti nascono spesso da codice sano che legge dati malati.
Succede in tutti i settori. Nel rischio di credito, un singolo caricamento obsoleto può rendere una nuova predizione statisticamente plausibile ma operativamente inutile. Nell'analisi dei dati sanitari, aggiornamenti in ritardo possono lasciare un modello a lavorare su uno stato del paziente incompleto. Nei workflow immobiliari e di underwriting, lo stesso problema si presenta quando gli input delle feature cambiano forma o freschezza senza che nessuno se ne accorga. Se state confrontando strumenti in questo ambito, la guida di PropLab agli strumenti di AI è utile perché mostra quanto rapidamente i sistemi di AI diventino software operativo e non semplici esperimenti.
Perché la pulizia una tantum non funziona
Molti team si comportano ancora come se la data quality finisse quando inizia il training. Pulire il set storico. Sistemare i NULL. Rimuovere i duplicati. Rilasciare il modello. Questa logica appartiene a un laboratorio, non a una piattaforma.
I sistemi in produzione hanno bisogno di qualcosa di più simile a un sistema immunitario:
Rilevamento continuo: osservate gli input dopo il deployment, non solo prima del training.
Consapevolezza del comportamento: sappiate come sono arrivi, volumi e distribuzioni "normali".
Isolamento rapido: distinguete velocemente i problemi del modello da quelli dei dati a monte.
Responsabilità operativa: instradate gli incidenti sui dati alle persone in grado di risolverli.
Quando questi elementi mancano, il decadimento del modello sembra misterioso. Quando sono presenti, la maggior parte dei "fallimenti dell'AI" diventa normale lavoro di ingegneria.
I quattro cavalieri del decadimento dei modelli
Di solito un modello non fallisce per un unico grande motivo. Si indebolisce a causa di una manciata di colpevoli ricorrenti. Imparate a riconoscerne le firme e diagnosticherete i problemi più velocemente dei team che guardano solo le metriche del modello.
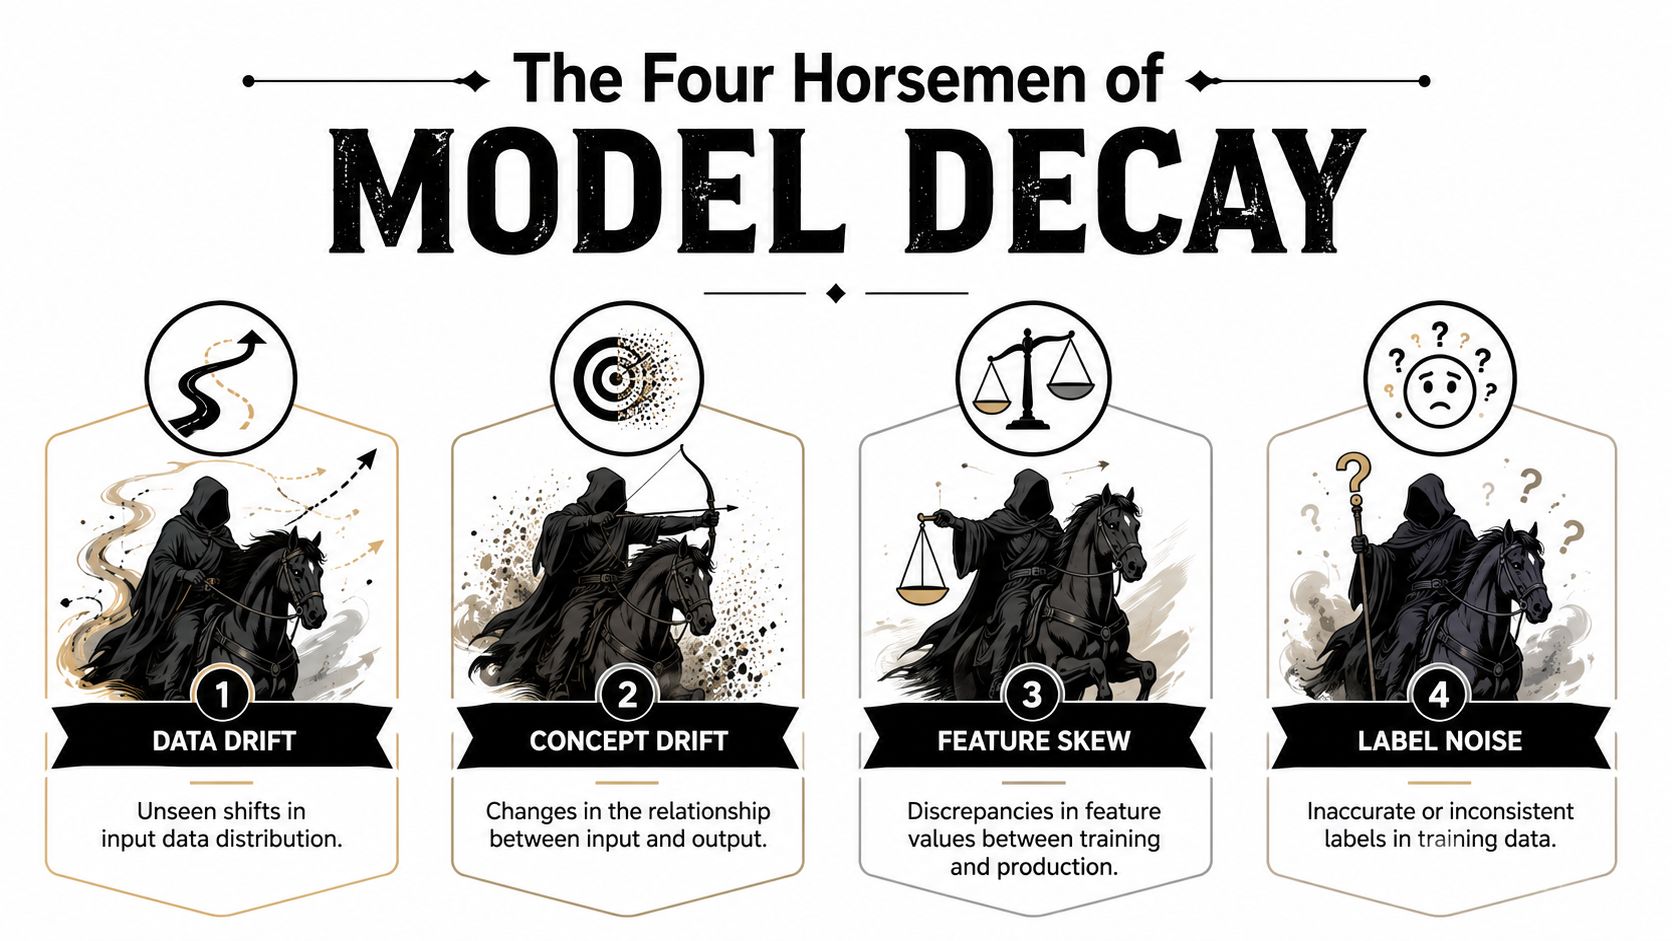
Data drift e concept drift
Il data drift è il fiume che cambia corso mentre il vostro modello usa ancora la mappa dell'anno scorso. La distribuzione degli input si sposta nel tempo. Forse è cambiato il comportamento dei clienti, forse il metodo di raccolta, forse un sistema sorgente ora arrotonda i valori in modo diverso. Il modello continua a ricevere dati con la forma giusta, ma il terreno statistico sottostante si è spostato.
Il concept drift è più insidioso. Cambia la relazione tra input e risultati. Il modello può vedere feature dall'aspetto familiare, ma il mondo che quelle feature descrivono ora si comporta diversamente. Un segnale di frode che un tempo contava può affievolirsi. Una feature di domanda può invertire la direzione dopo un cambio di policy.
L'errore pratico è trattare entrambi solo come problemi di retraining. A volte il retraining aiuta. A volte insegna semplicemente al modello ad adattarsi più in fretta a una logica a monte difettosa.
Se il vostro team sta lavorando su pattern pratici di monitoraggio, la rilevazione del data drift dovrebbe stare accanto al monitoraggio dei modelli, non sotto di esso.
Valori mancanti e feature skew
I valori mancanti meritano più rispetto di quanto ne ricevano di solito. Nell'Unione Europea, il 43% dei professionisti del machine learning indica i valori critici mancanti come la principale sfida di data quality, il che compromette direttamente l'affidabilità e spinge i team verso l'imputazione o una raccolta supplementare, secondo i risultati di un sondaggio tra professionisti UE sui valori critici mancanti.
Questo conta perché in produzione i valori mancanti raramente sono casuali. Un batch può arrivare parzialmente completo perché una sorgente è in ritardo. Una specifica regione può sparire a causa di un problema di un connettore. Un campo può iniziare a essere vuoto per impostazione predefinita dopo l'aggiornamento di un modulo. Se contate i NULL solo a livello globale, vi sfuggirà il problema di fondo.
Il feature skew è un altro sabotatore silenzioso. I valori di training e quelli di produzione divergono, anche quando lo schema corrisponde ancora. Il modello ha imparato su una distribuzione e ora ne valuta un'altra. È così che una feature valida diventa fuorviante.
Label noise e modifiche di schema
Il label noise avvelena lentamente il training. Se la vostra ground truth è incoerente, in ritardo, corretta manualmente in alcuni sistemi ma non in altri, o unita in modo errato, il modello impara la lezione sbagliata con grande sicurezza. Questo problema si nasconde spesso dietro un "il modello non ha mai generalizzato bene", quando il vero problema è che le label non hanno mai rappresentato la realtà in modo coerente.
Le modifiche di schema sono la versione digitale del cambiare progetto a metà costruzione. Le colonne aggiunte sono gestibili. Le colonne rimosse e i cambi di tipo perdonano meno. Valori rinominati, codifiche modificate e conversioni silenziose sono peggio, perché la pipeline può continuare a girare mentre la semantica si rompe.
Una regola semplice aiuta:
Regola pratica: se una modifica può alterare il significato, la tempistica o la completezza di una feature, trattatela come un incidente di produzione anche se nessun job è fallito.
I team che intercettano presto questi quattro problemi restano tranquilli. Quelli che non ci riescono passano la settimana a ridiscutere se il modello sia "ancora buono".
Misurare l'idoneità dei vostri dati per il ML
Non si può portare in produzione la data quality per il machine learning con una manciata di controlli sui NULL e una dashboard piena di conteggi di righe. I dati pronti per il ML richiedono una definizione più ampia di idoneità, e gli standard europei danno a questa definizione una forma concreta.
Uno studio del 2025 di Gómez Plaza et al. descrive le proprietà intrinseche di data quality per il machine learning come accuratezza, completezza, coerenza, credibilità e attualità, e osserva che nei contesti regolamentati le organizzazioni devono documentare esplicitamente le misure per rilevare e mitigare dati mancanti, duplicazione, outlier, bias e drift, come illustrato in questa analisi degli standard europei di data cleaning per il ML. Lo stesso lavoro afferma che lo standard europeo richiede misure di qualità precise per il rilevamento e la mitigazione dei dati mancanti, la duplicazione dei dati e bias, drift e scaling, il che rende la data quality parte della preparazione agli audit e non solo una questione di igiene ingegneristica.
Misurate più di freshness e volume
Le organizzazioni partono spesso da freshness, volume e validità dello schema. È un buon inizio, ma non basta per gli input del ML.
Un set di metriche più solido include:
Stabilità delle distribuzioni: verificate se le feature numeriche e categoriche somigliano ancora alla baseline appresa.
Completezza per segmento: controllate i valori mancanti per segmento di clientela, sorgente, area geografica o canale, non solo sull'intera tabella.
Variazioni di cardinalità: tenete d'occhio l'esplosione o il crollo dei valori univoci in ID, categorie e feature derivate da testo libero.
Attualità: verificate che i record non siano semplicemente presenti, ma abbastanza recenti da rappresentare il processo che il modello cerca di prevedere.
Controlli di credibilità: segnalate combinazioni impossibili, valori predefiniti sospetti o valori delle feature tecnicamente validi ma operativamente assurdi.
Per i team che devono scegliere metriche e pattern di implementazione, le metriche di data quality per i sistemi in produzione sono un buon punto di partenza per confrontare ciò che va misurato automaticamente e ciò che va imposto tramite regole esplicite.
Trasformate le dimensioni della qualità in test eseguibili
Il salto dalla policy alla pratica avviene quando ogni dimensione della qualità diventa un test applicato dalla macchina. Questo significa che ogni tabella, feature set o feed importante riceve un contratto misurabile.
Una configurazione pratica si presenta così:
Dimensione della qualità | Cosa testare nella pratica | Segnale di guasto tipico |
|---|---|---|
Accuratezza | Validità tra campi e conformità ai dati di riferimento | I valori superano i controlli di tipo ma violano la logica di business |
Completezza | NULL, campi vuoti, record parziali, partizioni mancanti | Lacune improvvise nelle feature critiche |
Coerenza | Formati, unità e codifiche categoriche stabili | Lo stesso concetto rappresentato in modo diverso tra le sorgenti |
Credibilità | Intervalli di plausibilità e vincoli di dominio | I dati sono presenti ma non credibili |
Attualità | Tempistica di arrivo e recenza dei record | Feature obsolete che alimentano un modello live |
Il cambiamento utile qui è mentale. Non chiedetevi: "Questa tabella è pulita?". Chiedetevi: "Questo input è adatto alla decisione del modello che supporta?". Una feature può essere accettabile per la BI e restare inaccettabile per il ML.
La data quality per il machine learning consiste nel preservare il significato, non solo nell'evitare i crash.
Tecniche automatizzate di rilevamento delle anomalie
Le soglie manuali funzionano per un po'. Poi l'infrastruttura cresce. Una tabella diventa cinquanta. Cinquanta diventano cinquecento. Qualcuno crea una nuova pipeline specifica per un mercato. Un altro team aggiunge un feature store. La vostra lista di controlli hard-coded, mantenuta con tanta cura, si trasforma in un museo di supposizioni.
È qui che il monitoraggio statistico e il machine learning devono lavorare insieme.
Perché le regole statiche cedono per prime
Il monitoraggio basato su regole è utile quando la modalità di guasto è nota e stabile. "Questa colonna non deve essere NULL." "Questo record deve rispettare un vincolo di business." "Questo campo deve restare uno di questi valori ammessi." Sono ottimi controlli di validazione.
Sono deboli nell'individuare comportamenti emergenti. Se il volume delle righe cambia gradualmente nell'arco di settimane, una soglia fissa può restare silenziosa finché non è troppo tardi. Se una categoria inizia a variare in proporzione ma non in valore assoluto, i limiti semplici non lo rileveranno. Se i dati iniziano ad arrivare più tardi secondo un pattern che varia in base al giorno della settimana, le regole rigide creano alert fatigue oppure punti ciechi.
Cosa aggiunge il rilevamento adattivo
Il rilevamento adattivo delle anomalie apprende il comportamento di base dai dati stessi. Invece di costringere un ingegnere a prevedere in anticipo ogni modalità di guasto, il sistema modella cosa è normale e segnala le deviazioni che meritano un'ispezione: picchi, cali, rotture di trend, correlazioni insolite e cambiamenti di tempistica.
Questo è particolarmente rilevante per infrastrutture estese con carichi di lavoro misti. Un feed di feature retail, un input di scoring finanziario e una tabella di reporting del settore pubblico non si comportano allo stesso modo. E non dovrebbero nemmeno condividere le stesse soglie statiche.
Un paper di ricerca del 2026 propone un framework di machine learning non supervisionato per il rilevamento delle anomalie strutturali nelle statistiche regionali europee, mostrando che l'AI può identificare profili strutturalmente atipici senza manutenzione manuale delle regole e descrivendo il metodo come "fully reproducible, scalable, and compatible with existing validation workflows" (completamente riproducibile, scalabile e compatibile con i workflow di validazione esistenti) nel paper sul rilevamento delle anomalie strutturali per le statistiche europee. È questo il pattern importante: l'automazione diventa utile quando scala senza diventare opaca.
Un'opzione pratica in questa categoria sono le tecniche di rilevamento delle anomalie con AI per le data operations. I sistemi costruiti in questo modo apprendono il comportamento normale direttamente sugli asset di dati configurati, quindi rilevano i cambiamenti imprevisti senza richiedere ai team di definire a mano ogni condizione di alert.
Usate sia le regole sia le baseline apprese
La configurazione matura non è regole contro AI. Sono entrambe.
Usate la validazione a livello di record quando il business sa esattamente cosa deve essere vero. Usate l'apprendimento delle baseline quando il sistema deve rilevare deviazioni di comportamento, struttura o tempistica che nessuno può elencare in anticipo.
Una suddivisione duratura si presenta così:
Usate regole esplicite per campi contrattuali, logica di compliance e vincoli di dominio.
Usate baseline apprese per drift, variazioni di freshness, anomalie di volume e comportamenti insoliti delle feature.
Usate la revisione degli analisti per anomalie ambigue in cui è il contesto a decidere la gravità.
Il modo più rapido per affossare un programma di monitoraggio è costringere le persone a mantenere a mano ogni soglia.
Un buon rilevamento delle anomalie non sostituisce il giudizio ingegneristico. Lo preserva per i casi che meritano l'attenzione di una persona.
Progettare una pipeline di data observability full-stack
Il solo rilevamento non salva la produzione. Molti team sanno rilevare. Meno sanno instradare, spiegare e risolvere senza un'emergenza su Slack che coinvolge sei persone e tre ipotesi.
Una pipeline affidabile si comporta più come una linea di produzione che come una telecamera di sorveglianza. Controlla gli input al loro ingresso, traccia come si muovono, avvisa il responsabile giusto fornendo contesto e reinserisce nel sistema le lezioni apprese da ogni incidente.
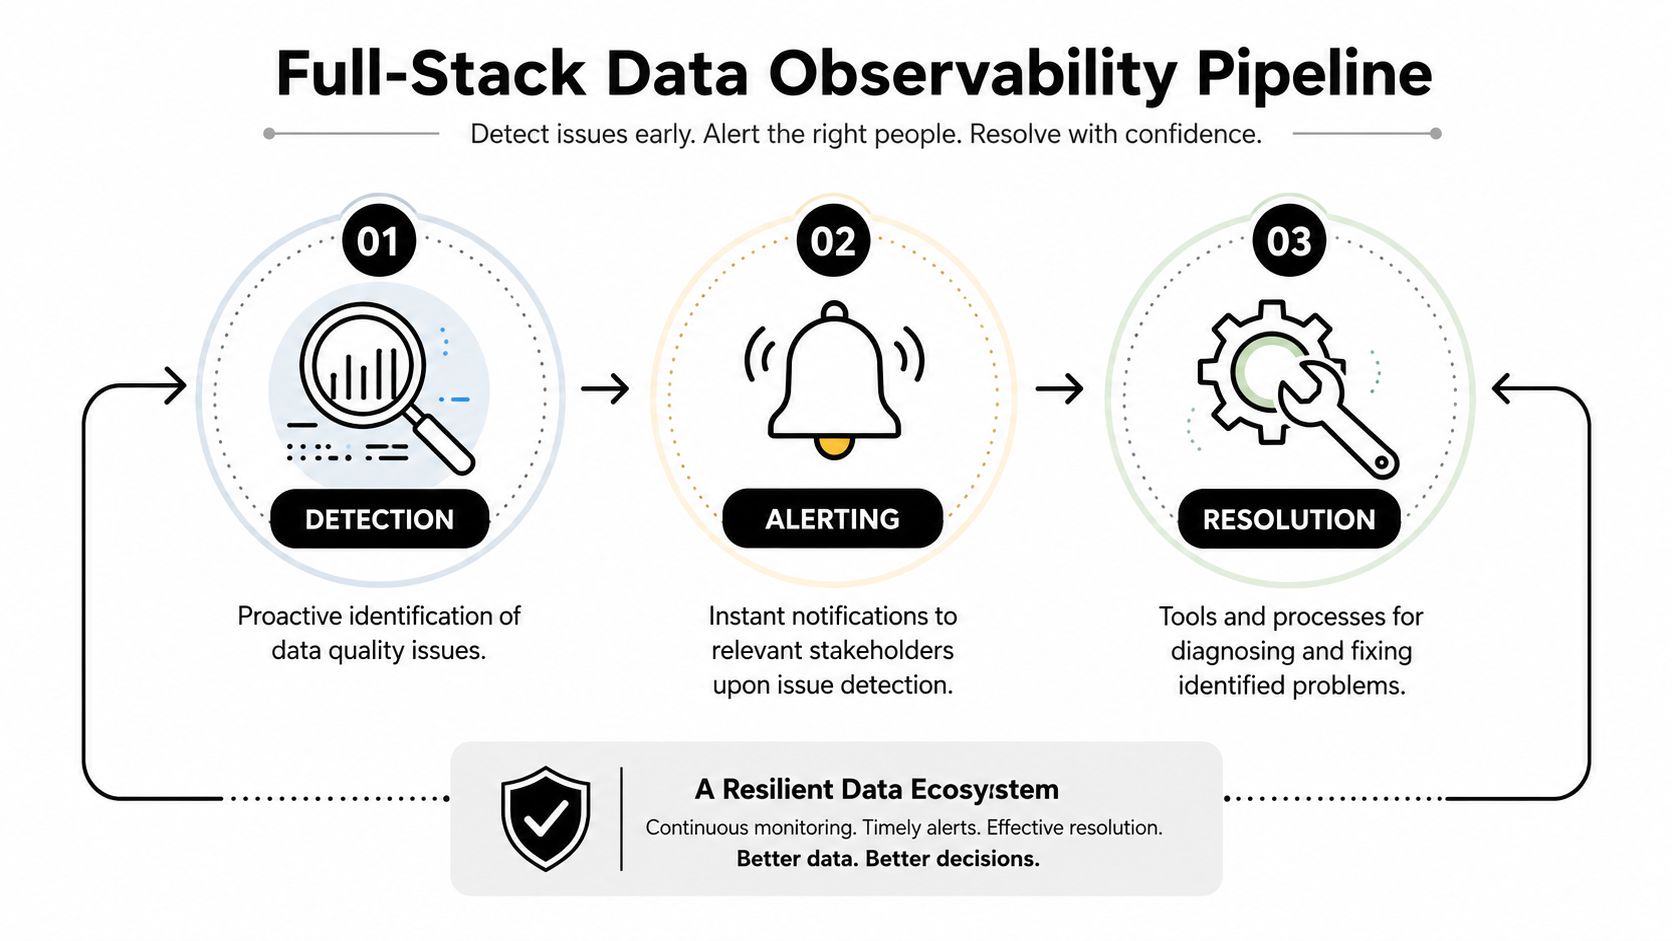
Il rilevamento ha bisogno di contesto
Un alert che dice "anomalia rilevata" è un fastidio, non uno strumento operativo. Il livello di rilevamento deve rispondere immediatamente ad alcune domande di base:
Che cosa è cambiato
Dove è cambiato
Quando è iniziato
Quali asset a valle ne dipendono
Se si tratta di un picco isolato o di una rottura del trend
Ecco perché lineage e storico contano. Se una dashboard si guasta, il team deve poter risalire a ritroso dal problema a una tabella sorgente, a un campo o a un caricamento in ritardo. Se la distribuzione degli score di un modello cambia, gli ingegneri devono capire se la causa principale si trova nell'ingestion, nella trasformazione, nella generazione delle feature o nel serving.
La timeliness non è una metrica di facciata
I dati in ritardo non si limitano a far sembrare obsoleti i report. Cambiano il comportamento del modello. La maggior parte dei contenuti tratta la timeliness come un KPI delle pipeline. È troppo superficiale per il ML live.
I dati della FRA collegano esplicitamente la sottorappresentazione e gli intervalli temporali mancanti al bias, e recenti discussioni europee hanno evidenziato che la maggior parte degli strumenti si concentra ancora sulla pulizia statica anziché su calcoli dinamici dell'arrivo atteso, come sintetizzato nel report del workshop CEN e CENELEC su timeliness e bias nei sistemi di AI. Se una sorgente arriva regolarmente più tardi di quanto il modello si aspetti, non si ottiene solo uno scoring ritardato. Si può ottenere uno scoring distorto su una realtà incompleta.
Ecco perché il tempo di consegna atteso conta. Apprendete i pattern di arrivo normali. Confrontate l'arrivo effettivo con quei pattern. Lanciate un alert prima che una feature obsoleta finisca in una decisione.
La risoluzione va progettata, non improvvisata
Un ciclo di observability full-stack include di solito questi componenti:
Gate di validazione che impediscono ai dati palesemente errati di andare avanti.
Monitor delle anomalie che individuano i cambiamenti di comportamento in tabelle e feed live.
Tracciamento dello schema che cattura le modifiche strutturali prima che causino danni semantici.
Alerting ricco di contesto instradato al team responsabile.
Diagnosi assistita dal lineage, così chi interviene può tracciare rapidamente l'impatto a valle.
Raccolta del feedback, così gli incidenti chiusi migliorano baseline, regole e runbook.
I team che valutano questo livello operativo dovrebbero esaminare gli strumenti di data observability per le pipeline moderne con una domanda in mente: il sistema aiuta le persone a risolvere gli incidenti più velocemente o crea solo più alert?
L'alerting dovrebbe ridurre il tempo di indagine, non spostarlo da SQL all'email.
Quando questa pipeline è operativa, l'affidabilità dei modelli smette di dipendere da interventi eroici.
Il vantaggio in-database per un ML sicuro
Molti consigli sulla data quality presuppongono che si possano esportare i dati per ispezionarli. Per molti team europei, questa ipotesi crolla al primo contatto con la realtà.
Gli ambienti di finanza, sanità, telecomunicazioni e settore pubblico richiedono spesso un controllo più rigoroso su dove restano i dati, chi può accedervi e quanto movimento sia giustificato. In questi contesti, l'architettura di observability diventa una decisione di governance tanto quanto una decisione ingegneristica.

Un sondaggio UE del 2024 tra i professionisti del ML indica tracciabilità e sicurezza come principali preoccupazioni di governance, mentre le linee guida standard indirizzano spesso i team verso strumenti cloud che spostano i dati, lasciando un vuoto per il calcolo delle metriche in-database nel rispetto della sovranità, secondo questa analisi delle preoccupazioni di governance nella pratica della data quality per il ML.
Perché il luogo di esecuzione conta
Quando il monitoraggio viene eseguito fuori dal database, si introducono movimenti aggiuntivi, permessi aggiuntivi, punti di guasto aggiuntivi e ulteriori revisioni di governance. Si crea anche una seconda copia della verità operativa, che tende a invecchiare male.
L'esecuzione in-database cambia il compromesso:
I dati sensibili restano residenti nell'ambiente controllato dal cliente.
Il calcolo delle metriche avviene dove i dati risiedono già, il che semplifica i confini di sicurezza.
La latenza diminuisce perché il sistema ispeziona i dati vicino alla sorgente.
La complessità operativa si riduce perché ci sono meno pipeline di esportazione da mantenere.
Questo è particolarmente utile quando occorre rilevare drift, modifiche di schema o problemi di timeliness in infrastrutture on-prem o private cloud in cui l'accesso SaaS esterno è limitato.
Come si presenta nella pratica
Il pattern in-database funziona al meglio quando un'unica piattaforma può calcolare metriche, apprendere baseline, tracciare lo schema e supportare la validazione senza portare i dati di produzione in un ambiente del vendor. È l'idea architetturale alla base dell'esecuzione in-database della data quality per ambienti sicuri. digna, ad esempio, esegue le analisi all'interno dei database del cliente, supporta il deployment in private cloud o on-prem, traccia timeliness e modifiche di schema e mantiene i dataset di produzione sotto il controllo del cliente.
Questa architettura non riguarda solo la documentazione di compliance. Rende anche il debugging più pulito. Gli stessi team che gestiscono il data warehouse o il data lake possono ispezionare le metriche, tracciare gli incidenti e validare le correzioni senza introdurre uno stack di observability parallelo che vede solo frammenti esportati.
Se la vostra piattaforma ML ha requisiti di governance seri, il luogo in cui eseguite i controlli di data quality può contare quanto i controlli che eseguite.
Checklist della data quality in produzione
Il modo più pulito per rendere operativa la data quality per il machine learning è renderla noiosa. Definite i controlli, assegnate le responsabilità, automatizzate ciò che si ripete e lasciate alle persone le decisioni che richiedono giudizio.
Di seguito trovate una checklist operativa che userei per esaminare qualsiasi configurazione di ML in produzione. Associa le pratiche alle funzionalità della piattaforma, perché "dovremmo monitorare questo" non serve a nulla se lo stack non è in grado di farlo.
Checklist di implementazione della data quality per il ML
Pratica / Controllo | Funzionalità della piattaforma richiesta | Perché conta per il ML |
|---|---|---|
Definire le tabelle di input critiche e le dipendenze delle feature | Inventario degli asset più visibilità del lineage | Non si può proteggere ciò che nessuno ha mappato |
Stabilire data contract per gli input dei modelli | Tracciamento dello schema e validazione dei contratti | Previene modifiche silenziose di presenza, tipo o significato delle colonne |
Monitorare la completezza delle feature ad alto impatto | Metriche a livello di colonna e controlli per segmento | I valori mancanti distorcono lo scoring e possono introdurre bias negli output |
Validare le regole di business a livello di record | Motore di regole per la validazione delle righe | Blocca i record tecnicamente validi ma operativamente errati |
Tracciare freshness e recenza dei dati | Monitoraggio della timeliness | Rileva gli input obsoleti prima che degradino le predizioni live |
Apprendere le finestre di arrivo attese | Apprendimento delle schedulazioni e calcolo della consegna attesa | Intercetta i caricamenti in ritardo che i controlli standard di freshness non rilevano |
Osservare le variazioni di distribuzione nelle feature | Baselining statistico e rilevamento delle anomalie | Fa emergere il drift prima che le metriche del modello crollino |
Confrontare il comportamento delle feature tra training e produzione | Monitoraggio del feature skew | Rivela quando gli input in produzione non somigliano più alle ipotesi di training |
Rilevare automaticamente le anomalie strutturali | Rilevamento delle anomalie non supervisionato | Estende il monitoraggio a molte tabelle senza soglie manuali |
Avvisare il team giusto con il contesto dell'impatto | Instradamento, metadati di ownership e contesto dell'incidente | Riduce il tempo sprecato su alert generici |
Tracciare i problemi a monte e a valle | Data lineage e mappatura delle dipendenze | Velocizza la root cause analysis e la valutazione dell'impatto |
Esaminare i trend storici, non solo gli incidenti | Storico delle metriche e analisi dei trend | Aiuta a distinguere il rumore isolato dal deterioramento graduale |
Mantenere i controlli all'interno di ambienti governati quando necessario | Esecuzione in-database | Supporta i requisiti di sicurezza, tracciabilità e sovranità |
Documentare i controlli per la preparazione agli audit | Cataloghi dei test, log di validazione e storico delle regole | Rende difendibile la governance degli input ML nei contesti regolamentati |
I punti della checklist che i team di solito saltano
Gli elementi trascurati sono di solito quelli che fanno più male in seguito:
Modellazione dell'arrivo atteso: i team scoprono che un feed è in ritardo solo dopo che gli utenti si lamentano.
Monitoraggio semantico dello schema: rilevano le colonne mancanti ma non il significato modificato.
Instradamento verso i responsabili: gli alert finiscono in un canale condiviso e restano lì come bagagli abbandonati.
Analisi dei trend storici: tutti guardano a ieri. Nessuno controlla se le ultime sei settimane stanno andando alla deriva.
Un buon modello mentale viene dagli ambienti operativi che non possono permettersi dati obsoleti o cambiamenti non rilevati. I team che lavorano su pipeline di procurement e di opportunità affrontano pressioni simili su timeliness e feed strutturati, ed è per questo che AI for Government Contracting è un utile esempio affine di quanto rapidamente il valore di un workflow dipenda da input affidabili e aggiornati.
Cosa funziona e cosa no
Cosa funziona:
Partire da un piccolo set di controlli ad alto valore
Responsabilità condivisa tra data engineering e ML engineering
Gestione separata dei fallimenti delle regole rigide e delle anomalie soft
La timeliness trattata come qualità degli input del modello, non solo come igiene delle pipeline
Cosa non funziona:
Un unico, enorme rollout del monitoraggio senza responsabili
Soglie copiate alla cieca tra dataset diversi
Fidarsi delle dashboard senza tracciare i pattern di arrivo a monte
Dare per scontato che il retraining risolva i difetti dei dati
L'obiettivo non è la perfezione. È un rilevamento rapido, una diagnosi accurata e meno sorprese in produzione.
Se il vostro team deve monitorare drift, modifiche di schema, validità dei record e timeliness senza spostare dati sensibili fuori dagli ambienti controllati dal cliente, date un'occhiata a digna. È progettata per la data quality e l'observability in-database, il che la rende una scelta pratica per i team di ML e analytics che operano in infrastrutture private cloud o on-prem.
Per mettere in pratica i controlli sull'arrivo atteso di questa checklist, scoprite come digna Timeliness apprende i pattern di consegna e segnala i caricamenti in ritardo prima che feature obsolete raggiungano un modello.
Domande frequenti
Perché la data quality è importante per il machine learning in produzione?
La maggior parte dei guasti del ML in produzione nasce da dati che arrivano in ritardo, malformati o danneggiati in modo silenzioso, non dal modello stesso. In un incidente tipico, una sorgente a monte ha cambiato il modo in cui popolava un singolo campo, spostando il significato di una feature senza provocare alcun errore di schema. La pipeline ha continuato a girare mentre gli utenti di business perdevano fiducia.
Quali sono le cause del decadimento dei modelli di machine learning?
L'articolo individua quattro colpevoli ricorrenti: data drift e concept drift, valori mancanti e feature skew, label noise e modifiche di schema. I valori mancanti sono particolarmente frequenti: il 43% dei professionisti del machine learning nell'UE indica i valori critici mancanti come la principale sfida di data quality. Conoscere queste firme accelera la diagnosi, al di là dell'osservazione delle metriche del modello.
Quali dimensioni della data quality contano per il machine learning?
Uno studio del 2025 di Gómez Plaza et al. elenca accuratezza, completezza, coerenza, credibilità e attualità come proprietà intrinseche di data quality per il ML. Nella pratica, i team dovrebbero monitorare anche la stabilità delle distribuzioni, la completezza per segmento, le variazioni di cardinalità e la plausibilità, chiedendosi se un input sia adatto alla decisione del modello che supporta.
Per monitorare i dati del ML conviene usare regole o rilevamento delle anomalie?
Entrambi. Le regole esplicite sono adatte a campi contrattuali, logica di compliance e vincoli di dominio, mentre le baseline apprese intercettano drift, variazioni di freshness, anomalie di volume e comportamenti insoliti delle feature che nessuno può elencare in anticipo. Le anomalie ambigue passano alla revisione degli analisti, dove è il contesto a decidere la gravità, così le persone non devono mantenere a mano ogni soglia.
Perché la timeliness è importante per i modelli di machine learning?
I dati in ritardo cambiano il comportamento del modello, non solo la freschezza dei report. Se una sorgente arriva regolarmente più tardi di quanto il modello si aspetti, si può ottenere uno scoring distorto su una realtà incompleta, e la FRA collega gli intervalli temporali mancanti al bias. Il rimedio è apprendere i pattern di arrivo normali e lanciare un alert prima che feature obsolete raggiungano una decisione.


