Come creare dashboard di data quality che funzionano davvero
|
7
min di lettura

Lo schema lo conoscete già. Alle 8:30 una dashboard sembra a posto, qualcuno dà per scontato che il caricamento notturno sia arrivato e, quando la finanza apre i numeri durante la riunione del management, sta guardando i dati della settimana scorsa. Nessuno viene allertato, perché nulla si è “rotto” in un modo che la dashboard potesse spiegare: si sono rotti solo la pipeline, i tempi e la fiducia nel report.
È questo il vero problema di molte dashboard di data quality. Sembrano strumenti di controllo, ma si comportano come elementi decorativi a meno che non siano legate al percorso dei dati, a controlli espliciti e a una chiara responsabilità. Una dashboard utile non si limita a mostrare un punteggio: dice al team cosa è fallito, dove è fallito, chi ne è responsabile e cosa fare dopo.
Indice
Perché la maggior parte delle dashboard di data quality fallisce prima di mezzogiorno
Mappate il percorso dei dati prima di scegliere anche una sola metrica
I sei KPI che ogni dashboard di data quality deve monitorare
Pattern di pannelli per tempestività, anomalie, schema e validazione
Scegliere pattern visivi che portano a una decisione in meno di dieci secondi
Architettura, calcolo in-database e passaggi di consegna alla governance
Perché la maggior parte delle dashboard di data quality fallisce prima di mezzogiorno
Il lunedì mattina di solito mette a nudo i punti deboli. La finanza apre una dashboard, vede i numeri della settimana scorsa e nessuno si accorge che il caricamento notturno è slittato, perché la vista continua a essere visualizzata senza errori. Il report sembra in salute, la riunione del management inizia, e la prima persona a capire che c'è un problema è quella costretta a spiegare perché la dashboard mentiva per omissione.
Questo schema di fallimento è comune perché i team trattano le dashboard come report statici invece che come livelli di controllo operativo. Monitorano i sintomi a valle dopo che i dati sono già stati consumati, il che significa che l'alert arriva dopo l'impatto sul business. Si affidano inoltre a controlli binari superato/fallito, che creano un falso senso di certezza, perché una luce verde nasconde spesso un degrado lento, una freschezza scaduta o una modifica dello schema che non è ancora esplosa.
Regola pratica: se la dashboard non sa dirvi cosa è cambiato, quando è cambiato e chi deve agire, non è un sistema di controllo.
Una dashboard migliore avrebbe segnalato il ritardo non appena la consegna pianificata è slittata, non dopo che la finanza ha aggiornato il report. Avrebbe mostrato che il problema si trovava nel percorso di consegna, non nella logica di business a valle. Questa distinzione conta perché un batch non aggiornato, un join rotto e una colonna mancante richiedono risposte diverse, e un unico punteggio di salute nasconde questa differenza.
Molti team commettono anche lo stesso errore strutturale sulla responsabilità. Raccolgono un muro di metriche, ma nessuno sa quale team debba occuparsi della correzione o quale controllo corrisponda a quale rischio. Il risultato è rumore negli alert, responsabilità diluite e dashboard a cui si dà un'occhiata durante un incidente per poi ignorarle per il resto della settimana.
Mappate il percorso dei dati prima di scegliere anche una sola metrica
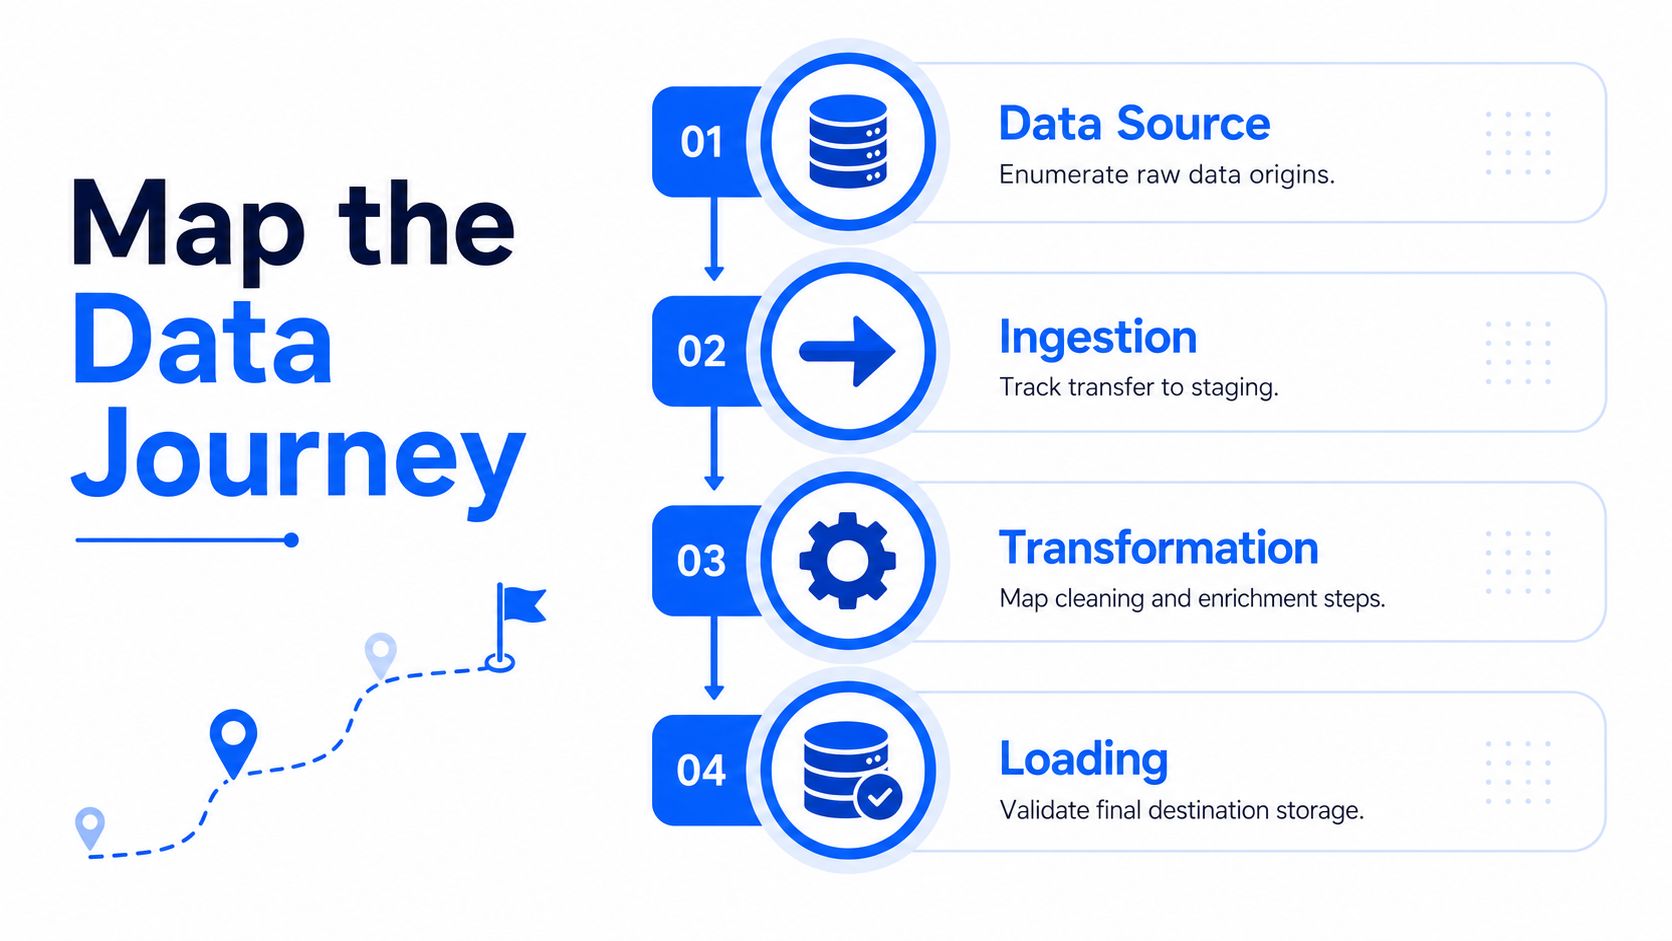
Una dashboard diventa utile solo dopo che la pipeline è stata compresa come una sequenza di passaggi controllabili. Iniziate mappando l'intero percorso dei dati, dalla fonte all'ingestion, alla trasformazione e all'erogazione, e individuate dove può entrare la corruzione in ogni fase. Questa mappatura fa la differenza tra rilevare un risultato compromesso e prevenire la rottura fin dall'inizio, ed è per questo che il contesto di processo conta più del semplice volume di metriche.
Associate i controlli alle modalità di guasto
Ogni rischio dovrebbe avere un controllo nel punto in cui il rischio può verificarsi. In pratica, significa decidere se il controllo è preventivo, investigativo o correttivo, invece di applicare controlli generici alla fine della pipeline sperando per il meglio. Un file di un fornitore in ritardo non è la stessa cosa di un record malformato, e una chiave duplicata nello staging non è la stessa cosa di una tabella di riferimento rotta.
L'unità di progettazione utile è il record di controllo. Per ogni controllo, documentate il rischio, l'impatto se non rilevato, la descrizione del controllo e l'evidenza di esecuzione. Questa struttura rende la dashboard verificabile e dà agli operatori qualcosa su cui agire invece di un vago riquadro rosso.
Una pipeline degli ordini dei clienti è un buon esempio. In fase di ingestion, un controllo preventivo può rifiutare un file malformato prima che arrivi. Durante la trasformazione, un controllo investigativo può segnalare una crescita inattesa dei valori null nello stato dell'ordine. In fase di caricamento, un controllo correttivo può instradare un batch fallito verso una tabella di quarantena e avvisare il data owner.
Non monitorate solo la tabella finale. Se la corruzione entra a monte, il sintomo a valle arriva già troppo tardi per prevenire danni al business.
Una semplice disciplina di mappatura che funziona
Elencate ogni fase. Scrivete dove i dati entrano, si spostano, cambiano forma e diventano utilizzabili.
Date un nome alla modalità di guasto. Pensate a file mancanti, righe duplicate, codici non validi, drift dello schema o caricamenti non aggiornati.
Scegliete il tipo di controllo. Preventivo per fermare i dati errati, investigativo per individuare il drift, correttivo per instradare la remediation.
Registrate la responsabilità. Il controllo è incompleto finché qualcuno non è responsabile della risposta.
Un po' di disciplina in questa fase evita molto monitoraggio rumoroso in seguito. Quando la dashboard è ancorata al percorso dei dati, ogni metrica ha il suo posto e ogni alert indica un rischio operativo reale.
I sei KPI che ogni dashboard di data quality deve monitorare
Le sei dimensioni fondamentali restano la spina dorsale di qualsiasi dashboard di data quality seria, ma funzionano solo se ciascuna è legata a un controllo misurabile. Lo scopo non è dare un punteggio ai dati in astratto. Lo scopo è rilevare se un rischio specifico sta peggiorando, è stabile o sta già compromettendo un processo di business.
Misurate ogni dimensione come un segnale di controllo
L'accuratezza è la corrispondenza tra il dataset e un system of record affidabile. In pratica, può significare una riconciliazione a campione tra record sorgente e destinazione, o un confronto a livello di campo per gli attributi critici.
La completezza si esprime di solito come tasso di null, ma conta anche il drift nel numero di righe. Una tabella può sembrare popolata e mancare comunque di una larga parte dei record attesi.
La coerenza verifica se le relazioni tra tabelle reggono. L'integrità referenziale è l'esempio più ovvio, ma lo è anche la concordanza tra campi, quando una colonna deve essere logicamente allineata a un'altra.
La tempestività richiede più attenzione di un semplice controllo di freschezza. L'orario di arrivo previsto e quello effettivo vi dicono se il ritardo è innocuo o un problema per il business, e questa distinzione è essenziale per le pipeline volatili.
La validità misura se i valori a livello di record rispettano le regole di business, come intervalli ammessi, formati o logiche condizionali.
L'unicità traccia le chiavi duplicate o altri pattern di duplicazione che distorcerebbero conteggi, join o viste cliente a valle.
La metodologia più pratica consiste nel definire prima i critical data element, collegare le regole di business ai controlli tecnici e poi usare soglie a livelli invece di un modello binario superato/fallito. Le linee guida del settore raccomandano di dare priorità ai campi che incidono su compliance, reporting o ricavi, quindi di impostare fasce di severità così che i team possano fare triage invece di trattare ogni errore come ugualmente urgente. La stessa fonte raccomanda anche una rigida soglia bronze sotto il 95% per la remediation immediata, uno schema utile quando un campo è centrale in un flusso regolamentato o in un report sui ricavi. Framework pratico per accuratezza e fiducia
Dimensione | Tipo di controllo | Metrica di esempio | Schema della soglia bronze |
|---|---|---|---|
Accuratezza | Investigativo | Corrispondenza a campione dei record con il system of record | Revisione immediata quando i campi critici divergono |
Completezza | Investigativo | Tasso di null e drift del numero di righe | Sotto la soglia minima rigida per i campi obbligatori |
Coerenza | Investigativo | Violazioni dell'integrità referenziale | Remediation immediata per relazioni interrotte |
Tempestività | Preventivo o investigativo | Arrivo previsto rispetto ad arrivo effettivo | Ritardo oltre la fascia di pianificazione concordata |
Validità | Preventivo o investigativo | Tasso di superamento delle regole nei controlli a livello di campo | Sotto la soglia minima per campi regolamentati o ad alto rischio |
Unicità | Investigativo | Tasso di chiavi duplicate | Indagine immediata per chiavi di identità o di transazione |
Un errore comune è dare lo stesso peso a tutte e sei le dimensioni. Questo disperde l'attenzione e produce alert rumorosi, perché non ogni regola merita la stessa risposta operativa. Un numero ridotto di controlli critici, con fasce chiare e responsabili definiti, batte sempre un'enorme pila di badge verdi e rossi. Per un catalogo di metriche più dettagliato, vale la pena affiancare all'elenco dei vostri critical data element la guida interna sulla pagina di digna dedicata alle metriche di data quality.
Pattern di pannelli per tempestività, anomalie, schema e validazione
La superficie di una dashboard dovrebbe riflettere il tipo di domanda posta, non il contrario. La vista iniziale deve offrire una lettura rapida dello stato di salute della pipeline. Le viste di drill-down devono fornire dettagli sufficienti a spiegare perché non lo è. Questa separazione conta perché un punteggio di salute senza pannelli ispezionabili diventa uno screenshot, non uno strumento di lavoro.
Pannelli di tempestività e anomalie
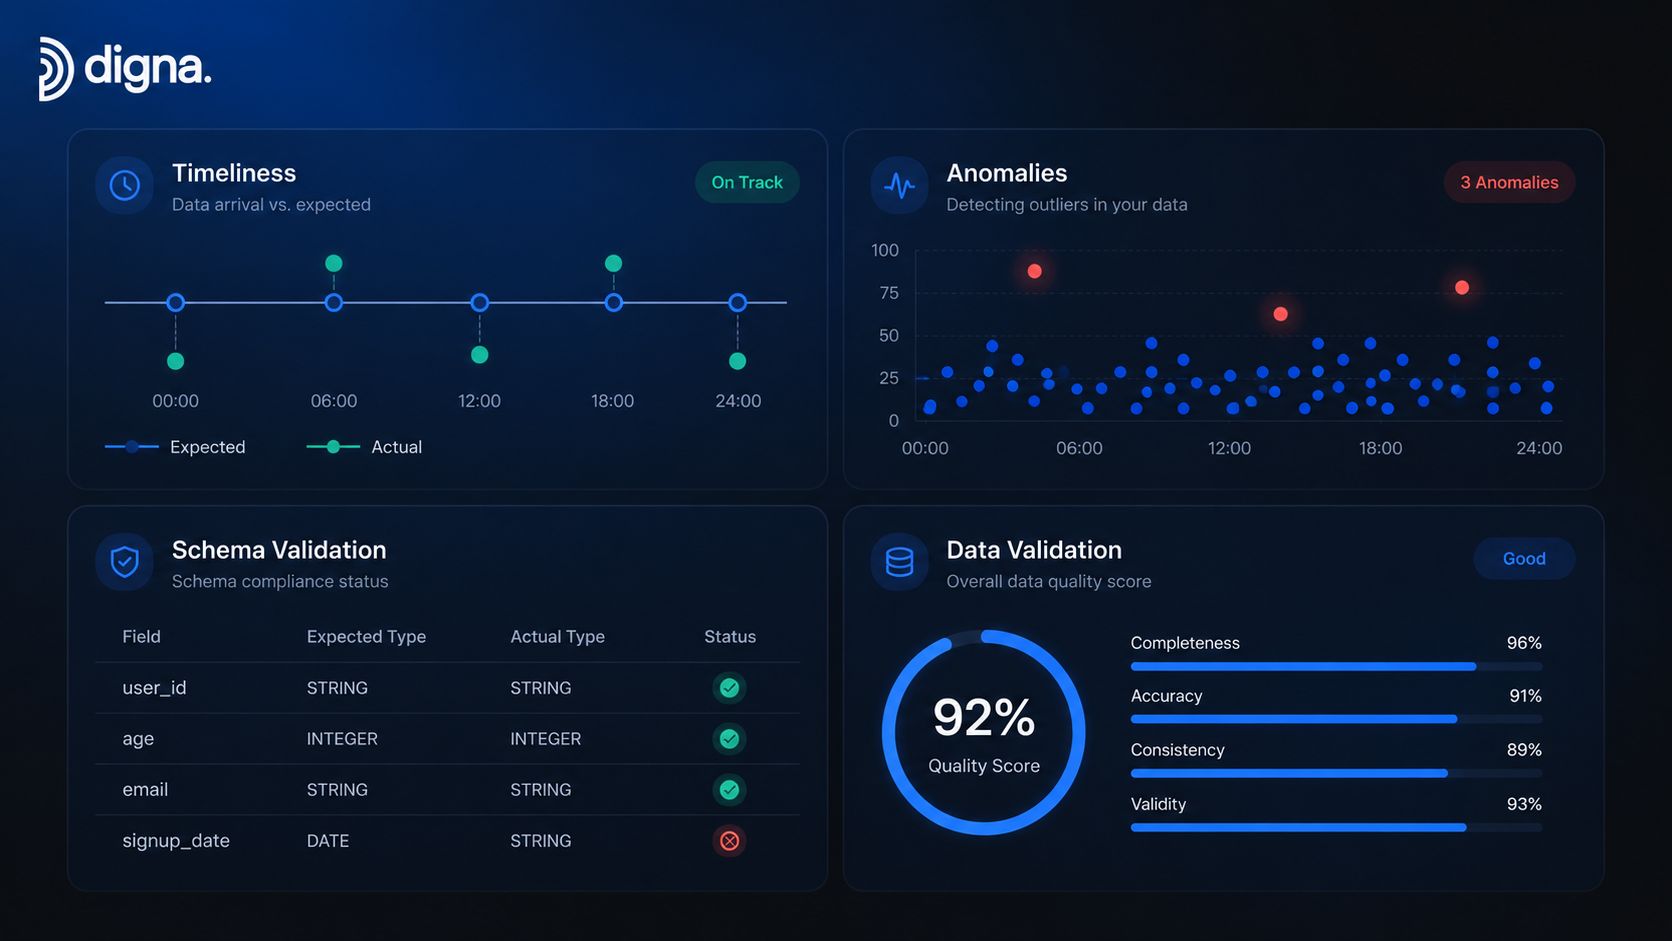
Un pannello di tempestività dovrebbe confrontare l'orario di arrivo previsto con quello effettivo e rendere evidente il ritardo. Se un batch è in ritardo di pochi minuti, la postura operativa è diversa rispetto a un batch che ha mancato del tutto la pianificazione. L'output utile è il ritardo espresso in un'unità concreta, più un indicatore di pianificazione visibile che dica all'operatore se il problema è di routine o fuori dal pattern.
Il pannello delle anomalie dovrebbe mostrare il comportamento di baseline appreso rispetto al valore attuale, poi evidenziare i punti che cadono fuori dalla fascia attesa. Funziona meglio di un singolo numero perché cattura sia il drift graduale sia le rotture improvvise. Anche il contesto storico appartiene a questo pannello, dato che un picco grezzo significa poco senza il pattern precedente che definisce cosa è “normale”.
Pannelli di schema e validazione
Uno schema tracker dovrebbe registrare colonne aggiunte, colonne rimosse e cambi di tipo, con timestamp e oggetti a valle interessati. Questo permette all'ingegneria di vedere il raggio d'impatto prima che un campo rotto raggiunga il reporting o lo scoring dei modelli. Aiuta anche quando una ridenominazione apparentemente innocua si trasforma in un incidente di produzione perché un job a valle si aspetta ancora la vecchia struttura.
Il pannello di validazione dovrebbe elencare le regole a livello di record fallite, record di esempio e l'instradamento ai responsabili. Non dovrebbe nascondere le righe errate effettive dietro un punteggio. Gli operatori devono sapere cosa è fallito, quale dataset è stato colpito e chi è incaricato della correzione.
Una buona pagina iniziale risponde a una sola domanda: c'è qualcosa che sta andando verso la rottura? Tutto il resto sta un clic più in profondità.
Piattaforme come digna organizzano queste superfici attorno a Data Timeliness, Data Anomalies, Schema Tracker e Data Validation. Questa organizzazione corrisponde bene ai pannelli descritti sopra, perché separa il monitoraggio operativo dall'ispezione forense. La nota interna sulle best practice di observability è un utile punto di riferimento quando dovete decidere quanto dettaglio mettere nella prima schermata e quanto nel drill-down.
Scegliere pattern visivi che portano a una decisione in meno di dieci secondi
Ogni grafico di una dashboard di data quality dovrebbe consentire una decisione in meno di dieci secondi. Se non ci riesce, probabilmente occupa spazio che dovrebbe appartenere a una scorecard, a una linea di trend o a una vista di lineage. Il pattern giusto dipende dal fatto che chi guarda debba individuare, confrontare o indagare.

Abbinate il grafico alla decisione
Una scorecard con colori a semaforo funziona meglio quando l'unica domanda è se serve agire subito. È utile per un dirigente che vuole un segnale rapido su diversi dataset critici.
Una linea di trend in pila è più adatta quando il compito è individuare un degrado lento. Gli indicatori a valore singolo sembrano puliti, ma nascondono se una metrica sta derivando settimana dopo settimana o resta stabile con una varianza normale.
Una vista di topologia o di lineage è l'unico modo onesto per mostrare il raggio d'impatto di una modifica dello schema. Se la ridenominazione di una colonna interessa tre job a valle e due dashboard, chi guarda dovrebbe vedere quel percorso, non solo la tabella che fallisce.
Usate viste separate per ruoli diversi
Una vista per il management dovrebbe condensare lo stato del programma in un numero ridotto di decisioni. Una vista per il data steward ha bisogno di responsabilità, eccezioni e stato della remediation. Una vista per l'ingegnere di turno ha bisogno di timestamp, campioni e del controllo specifico che è fallito.
La stessa metrica di base può servire tutti e tre i pubblici, ma non con la stessa presentazione. Un semplice grafico a barre può bastare per stabilire le priorità, mentre un albero di drill-down denso è più adatto all'indagine a posteriori. Gli elementi visivi decorativi sono uno spreco se non accorciano il tempo fino all'azione.
Se un grafico fa colpo ma non cambia la mossa successiva, il suo posto è in una presentazione, non in un sistema di monitoraggio.
La regola pratica è semplice. Usate l'elemento visivo più leggero che risponda ancora alla domanda operativa. Qualunque cosa più complessa aumenta il carico cognitivo senza migliorare la correzione.
Alerting, escalation e riduzione dell'alert fatigue
L'alerting è il punto in cui molte dashboard si guadagnano la fiducia o la perdono per sempre. Se ogni superamento di soglia genera lo stesso tipo di rumore, gli operatori smettono di credere al sistema. Se il sistema invia alert solo per i guasti gravi, si perde il degrado lento che sarebbe stato economico correggere prima.
Progettate gli alert attorno a responsabilità e severità
Gli alert a livelli funzionano meglio di una soglia unica perché corrispondono a percorsi di risposta. Una fascia critica dovrebbe chiamare un responsabile con nome e cognome. Una fascia alta può attivare una revisione urgente. Le fasce più basse dovrebbero registrare, mostrare il trend e attendere l'aggregazione, a meno che non persistano.
Ogni alert ha bisogno di un responsabile nominato e di un link a un runbook. Senza questi elementi, l'alert è solo una lamentela con un timestamp. La mappatura delle responsabilità conta perché chi riceve il segnale dovrebbe già sapere se può risolverlo, reindirizzarlo o fare escalation.
La parte più difficile è la taratura. Un esempio pubblico di ITSV descriveva oltre 140 alert al giorno, la maggior parte dei quali veniva ignorata perché l'inondazione nella casella di posta rendeva impossibile separare il segnale dal rumore. È il costo di un alerting non calibrato, ed è esattamente per questo che l'apprendimento delle baseline e la mappatura delle responsabilità sono importanti. Importanza delle dashboard di data quality e alert fatigue
Riducete il rumore senza nascondere i rischi reali
Le finestre note come sicure dovrebbero essere silenziate. Manutenzioni pianificate, passaggi di batch e backfill programmati non dovrebbero allertare il team se l'evento era previsto e documentato. Fasce orarie di silenzio e finestre di eccezione mantengono la dashboard utilizzabile senza trasformarla in una scappatoia.
La metrica operativa più importante non è il numero grezzo di alert. È se le persone prendono in carico rapidamente gli alert giusti e se il sistema continua a produrre falsi positivi. Se il tasso di presa in carico è basso, probabilmente la soglia è troppo rumorosa, l'instradamento è sbagliato o il responsabile non esiste davvero.
Ho visto team riconquistare la fiducia solo dopo aver ristretto le condizioni che giustificano una chiamata alle poche che minacciano il servizio o la compliance. Tutto il resto viene comunque tracciato, ma non interrompe la notte di nessuno a meno che l'impatto sul business non lo giustifichi. È questo equilibrio a far funzionare una dashboard come un sistema di controllo invece che come una sirena.
Architettura, calcolo in-database e passaggi di consegna alla governance
L'architettura predefinita per una dashboard seria è il calcolo delle metriche in-database. Mantenete le analisi dove i dati vivono già, e preserverete la freschezza, ridurrete i movimenti inutili ed eviterete di copiare record sensibili in un altro sistema solo per misurarli. Questo schema rende anche più facile mantenere analisi dei trend, anomaly detection e schema tracking sullo stesso archivio di metriche senza frammentare la pipeline.
Collegate la dashboard alla governance, non solo al monitoraggio
La dashboard dovrebbe passare il testimone alla governance in modo pulito. I data steward sono responsabili dell'interpretazione di business dei pannelli, l'ingegneria dei controlli operativi, e l'audit ha bisogno di una registrazione tracciabile di cosa è cambiato e cosa è stato fatto. Questo passaggio funziona solo quando la dashboard riporta un contesto sufficiente per la revisione, inclusi lo storico dei controlli e l'evidenza di esecuzione.
La progettazione della piattaforma conta. Un sistema come digna calcola i segnali all'interno dell'ambiente del cliente, il che mantiene la vista operativa allineata al modello di residenza dei dati ed evita copie aggiuntive solo per il monitoraggio. Lo stesso approccio supporta anche i flussi di governance, perché i risultati possono essere collegati a data contract, lineage e processi di revisione senza trasformare la dashboard in un'isola separata.
Il percorso di rollout pulito è semplice:
Mantenete il calcolo vicino ai dati. I segnali di freschezza sono più deboli quando dipendono da movimenti tra sistemi.
Conservate lo storico per ogni esecuzione dei controlli. Una riga per esecuzione vi dà i trend, non solo lo stato attuale.
Instradate i risultati ai responsabili. Un risultato senza responsabile è solo una nota.
Alimentate la governance dallo stesso archivio di metriche. In questo modo stewardship, audit e ingegneria restano allineati.
La dashboard non è il prodotto finale. È il punto di controllo in cui operations, analytics e governance si incontrano. Quando è costruita così, la dashboard aiuta i team a individuare prima il degrado, assegnare la correzione giusta e dimostrare che la correzione ha funzionato.
Se state costruendo o rivedendo le vostre dashboard di data quality, concentratevi su mappatura dei processi, soglie a livelli e responsabilità degli alert prima di rifinire la parte visiva. digna offre monitoraggio in-database per anomalie, tempestività, validazione, modifiche di schema e analisi dei trend, così che i team possano mantenere il ciclo di controllo all'interno del proprio ambiente. Visitate digna se volete una progettazione delle dashboard che colleghi controlli, responsabilità e risposta senza trasformare il monitoraggio nell'ennesima fonte di rumore.
Per i controlli tra arrivo previsto ed effettivo alla base di un pannello di tempestività, scoprite come digna Timeliness segnala i caricamenti in ritardo e mancanti prima che la finanza apra un report non aggiornato.
Domande frequenti
Perché la maggior parte delle dashboard di data quality fallisce?
Vengono trattate come report statici invece che come livelli di controllo operativo. Monitorano i sintomi a valle dopo che i dati sono stati consumati e si affidano a controlli binari superato/fallito, così una luce verde può nascondere caricamenti non aggiornati o una modifica dello schema. Se una dashboard non sa mostrare cosa è cambiato, quando e chi deve agire, non è un sistema di controllo.
Quali KPI dovrebbe monitorare una dashboard di data quality?
Monitorate le sei dimensioni fondamentali, ciascuna legata a un controllo misurabile: accuratezza tramite riconciliazione a campione, completezza tramite tasso di null e drift del numero di righe, coerenza tramite integrità referenziale, tempestività tramite arrivo previsto rispetto ad arrivo effettivo, validità tramite tasso di superamento delle regole e unicità tramite tasso di chiavi duplicate. Usate soglie a livelli invece di un modello binario superato/fallito.
Quali pannelli dovrebbe includere una dashboard di data quality?
Quattro pannelli coprono la maggior parte delle esigenze. Un pannello di tempestività confronta l'orario di arrivo previsto con quello effettivo, un pannello delle anomalie rappresenta la baseline appresa rispetto ai valori attuali, un pannello dello schema registra colonne aggiunte, rimosse e con tipo modificato insieme agli oggetti a valle interessati, e un pannello di validazione elenca le regole fallite con record di esempio e responsabili.
Come si riduce l'alert fatigue nel monitoraggio della data quality?
Usate alert a livelli: una fascia critica chiama un responsabile nominato, una fascia alta attiva una revisione urgente e le fasce più basse registrano e mostrano il trend. Ogni alert ha bisogno di un responsabile e di un link a un runbook, e manutenzioni pianificate o backfill dovrebbero essere silenziati. Un esempio di ITSV descriveva oltre 140 alert al giorno, la maggior parte dei quali ignorata.
Dove dovrebbero essere calcolate le metriche di una dashboard di data quality?
All'interno del database. Il calcolo delle metriche in-database mantiene le analisi dove vivono i dati, preservando la freschezza ed evitando di copiare record sensibili solo per misurarli. L'articolo raccomanda inoltre di conservare una riga di storico per ogni esecuzione dei controlli, instradare i risultati ai responsabili e alimentare la governance dallo stesso archivio di metriche.


