Creare un data set
|
8
min di lettura

Potete rilasciare un data set che sembra pulito in staging, supera ogni unit test e tuttavia, due settimane dopo, manda in crisi il business. L'ho visto accadere quando una silenziosa normalizzazione dei fusi orari ha modificato i totali dei ricavi in una dashboard e un job di marketing ha continuato a importare user ID nulli perché nulla, in fase di build, trattava quel campo come critico. La parte dolorosa è che il team aveva già dichiarato il dataset “finito”.
È l'errore che la maggior parte delle guide non affronta. Creare un data set non è una milestone di consegna, ma il primo passo di un processo di controllo continuo, nello stesso modo in cui il National Institute of Standards and Technology inquadra la data quality come una capacità determinata da accessibilità, pertinenza, tempestività, metadati, documentazione, competenze degli utenti, contesto e costi, in cui generazione, valutazione e miglioramento formano un ciclo anziché un traguardo (documento di prospettiva del NIST). In produzione il dataset non esiste davvero finché qualcuno non ne è responsabile, lo monitora, lo versiona e sa che cosa deve succedere quando subisce un drift.
Indice
Quando un data set finito è solo l'inizio
Il vero errore era nel controllo, non nella costruzione
Progettare lo schema prima di scrivere una sola query
Partire da granularità, chiavi e semantica temporale
Usare nomi che reggono all'uso operativo reale
Acquisire i dati senza perdere la provenienza
Adattare il metodo di acquisizione al caso d'uso
Versionare il contratto, non solo i dati
Controlli di validazione che intercettano i problemi reali
Validare prima a livello di record
Aggiungere controlli su distribuzione e tempestività
Partizionamento, versionamento e schema drift
Scegliere il layout in base all'uso della tabella
Fare del drift un errore di pipeline, non una sorpresa
Governance e reperibilità fin dal primo giorno
Scrivere i metadati minimi prima della pubblicazione
Rendere il riutilizzo sicuro, non casuale
Come capire quando il vostro data set è abbastanza buono
Usare criteri di accettazione legati alla decisione
Promuovere per fasi, non in un unico salto
Quando un data set finito è solo l'inizio
Il team pensava che il dataset degli eventi dei clienti fosse solido. Aveva colonne tipizzate, una build pulita e i consueti controlli sui null, quindi lo ha pubblicato ed è passato ad altro. Due settimane dopo, il reparto finanza ha notato che i totali dei ricavi stavano derivando e il marketing ha scoperto che un job di segmentazione aveva accettato record privi di user ID.
La causa principale non era clamorosa. Una regola di normalizzazione dei fusi orari era cambiata a monte e nessuno l'aveva considerata una breaking change, perché lo schema non era cambiato. Allo stesso tempo, il dataset ammetteva valori null in un campo che gli utenti a valle davano per obbligatorio, quindi i record errati sono passati finché un segmento di campagna non è risultato più grande del dovuto. Questa è la trappola: un dataset può essere sintatticamente corretto e tuttavia operativamente sbagliato.
Il vero errore era nel controllo, non nella costruzione
Un dataset di produzione ha bisogno di più di una build riuscita. Ha bisogno di soglie di accettazione, rilevamento del drift, responsabilità e un percorso di rollback, perché la definizione di “buono” cambia nel momento in cui utenti reali ne dipendono. Questa idea è coerente con la realtà aziendale secondo cui una scarsa data quality è costosa e, secondo ricerche di settore ampiamente citate, solo una piccola parte dei dati aziendali è considerata conforme a standard di qualità di base (dato di Gartner e relativo riepilogo).
Regola pratica: se una dashboard, un modello o un flusso di lavoro a valle può fallire silenziosamente, il dataset non è ancora finito.
Il resto del lavoro consiste nel prevenire esattamente il tipo di guasto che si manifesta dopo il lancio. Un controllo avrebbe intercettato la modifica dei fusi orari. Un altro avrebbe segnalato gli user ID nulli prima che il team marketing ci facesse affidamento. Il resto di questo articolo è il manuale di prevenzione.
Progettare lo schema prima di scrivere una sola query
Gli errori di schema sono costosi perché si consolidano in fretta. Una volta che i team iniziano a caricare dati e a costruire modelli intorno a una tabella, cambiare la granularità o reinterpretare una colonna diventa un progetto di migrazione, non un semplice refactoring. La mossa più sicura è decidere la forma prima della prima estrazione e documentare le scelte, così che nessuno debba ricostruirne l'intento in seguito.
Partire da granularità, chiavi e semantica temporale
Scegliete la granularità in modo esplicito. Se una riga rappresenta un evento utente, dichiaratelo nel documento di design e nella descrizione della tabella, perché questa decisione guida deduplicazione, aggregazione e join a valle. Usate chiavi surrogate dove non sono garantiti identificativi naturali stabili e fissate i timestamp in UTC con un offset di origine documentato, in modo che gli utenti successivi possano ricostruire l'ora locale senza tirare a indovinare.
Una tabella user_events poco curata mostra di solito i suoi problemi nei nomi delle colonne. Si vedono maiuscole e minuscole mescolate, booleani ambigui come is_active, valori di testo libero in event_type che degenerano in quasi-duplicati e timestamp il cui significato cambia a seconda di chi li ha caricati. Una versione disciplinata appare noiosa nel senso migliore del termine, con enum o categorie controllate per i tipi di evento, flag nullable dal significato esplicito e ID stabili che non dipendono da ciò che l'applicazione a monte ha emesso quella settimana.
Usare nomi che reggono all'uso operativo reale
La denominazione nel data warehouse e nel data lake dovrebbe indicare in quale punto della pipeline si trova una tabella. Prefissi come raw_, stg_ e dim_ lo rendono visibile, il che è importante quando qualcuno cerca di capire se una tabella è pronta per l'ingestione, per la trasformazione o per il consumo. Se desiderate una tassonomia più approfondita delle opzioni strutturali, la guida interna sui tipi di schema è un utile punto di riferimento.
Documentate ogni colonna prima che arrivi la prima riga. Un file schema.yml, o i commenti in information_schema, costringono il team a dichiarare tipo, significato, valori ammessi e responsabilità mentre il design è ancora facile da modificare.
Ambito decisionale | Anti-pattern | Pronto per la produzione |
|---|---|---|
Granularità | Implicita, dedotta in seguito | Dichiarata esplicitamente prima della build |
Identificativo primario | Chiave naturale composta da sorgenti instabili | Chiave surrogata o ID stabile e duraturo |
Timestamp | Orari locali misti, nessuna nota sull'offset | UTC con offset di origine documentato |
Booleani |
| Flag nullable con semantica scritta |
Tipi di evento | Stringhe di testo libero | Categorie controllate o valori di tipo enum |
Documentazione | Aggiunta dopo il lancio | Scritta prima del primo caricamento |
Acquisire i dati senza perdere la provenienza
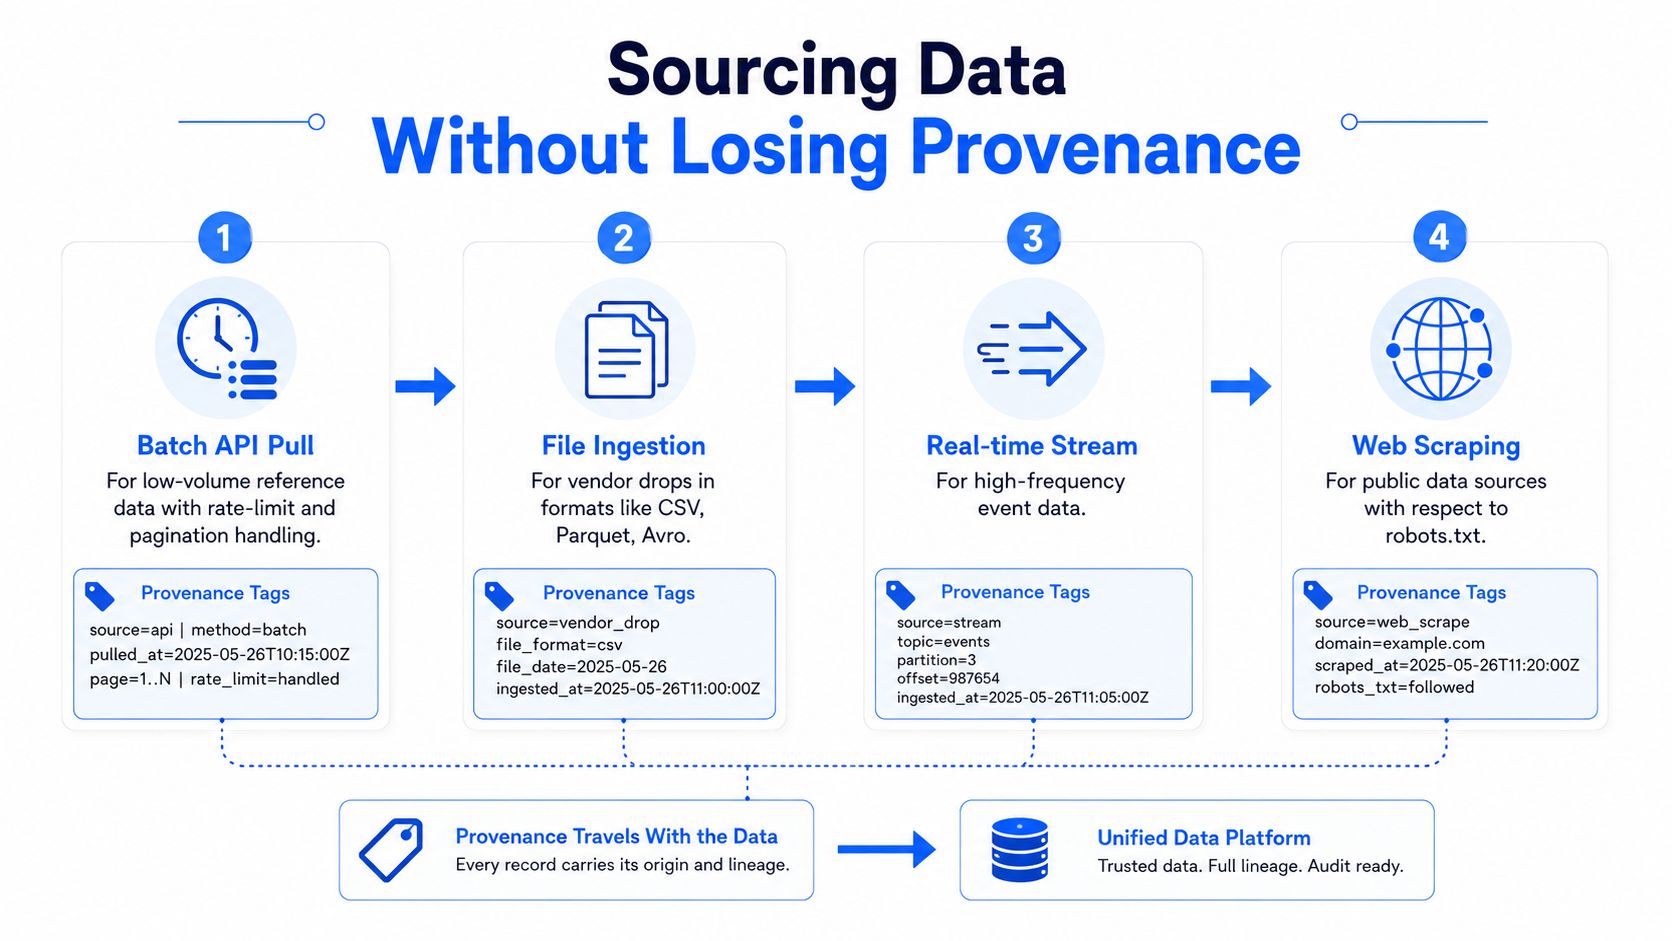
La sorgente conta quanto la forma. Un'estrazione batch da API, un file depositato, la CDC e i dati sintetici risolvono ciascuno un problema diverso e falliscono in modi diversi. Se scegliete il pattern di sorgente sbagliato, passerete mesi a compensare il lineage mancante invece di migliorare il dataset.
Adattare il metodo di acquisizione al caso d'uso
Usate le estrazioni batch da API per i dati di riferimento a basso volume, dove paginazione e limiti di frequenza sono i vincoli principali. Usate l'ingestione di file per i file forniti dai vendor in CSV, Parquet o Avro quando i contratti di schema contano di più, perché i file rendono più semplice ragionare su versionamento e riesecuzione. Usate la change data capture quando avete bisogno di caricamenti quasi in tempo reale nel data warehouse dai database operativi e usate i dati sintetici quando dovete testare le pipeline prima che esistano i feed di produzione.
L'aspetto essenziale è la provenienza. Registrate source_system, source_loaded_at, source_record_hash e ingestion_run_id al momento della lettura, non più tardi nello strato di trasformazione. Il lineage aggiunto a valle è sempre una ricostruzione, ed è proprio nella ricostruzione che i team iniziano a inventare certezze che non hanno mai avuto.
Scrivete la provenienza nel punto di lettura. Qualsiasi altra soluzione si trasforma in un'ipotesi sotto pressione.
Per le fonti web pubbliche o i flussi di scraping vale la stessa regola, e il metodo di acquisizione andrebbe scelto solo dopo aver verificato i vincoli e le modalità di guasto a monte. Una guida pratica su che cosa cercare in un'API ricorda bene che disponibilità, paginazione e comportamento del contratto determinano il dataset tanto quanto le righe. Se vi interessa la distinzione concettuale tra lineage e provenienza, vale la pena tenere a portata di mano l'approfondimento interno su data provenance e data lineage.
Versionare il contratto, non solo i dati
Le API esterne e i feed dei vendor dovrebbero essere trattati come dipendenze. Fissate la versione del contratto, documentate quali campi sono obbligatori e fate in modo che una modifica di schema compaia come una pull request visibile anziché come un guasto silenzioso. In questo modo, quando un fornitore cambia il nome o il tipo di un campo, il team vede le differenze prima che la pipeline le assorba.
Controlli di validazione che intercettano i problemi reali
Un dataset può sembrare completo e fallire comunque nel momento in cui qualcuno lo usa. I controlli sui null intercettano una sola classe di problemi. Riferimenti non validi, valori fuori intervallo, righe in ritardo e chiavi incoerenti possono lasciare una tabella tecnicamente popolata e operativamente inutilizzabile.
Validare prima a livello di record
Iniziate dai controlli che proteggono le ipotesi a valle. Applicate l'unicità agli identificativi naturali dove i duplicati porterebbero a contare due volte i record, l'integrità referenziale tra chiavi delle dimensioni e dei fatti, elenchi di valori approvati per i campi categoriali e regole di precisione per le colonne monetarie. Se un campo di ricavo deve avere sempre due cifre decimali, scrivetelo nella regola invece di confidare che ogni sistema di origine lo rispetti.
Qui sono utili gli insiemi riutilizzabili di valori ammessi, in particolare per paesi, stati e codici di stato. Se costruite una libreria di regole, l'approccio del modulo di data validation di digna segue questo schema, con controlli limitati alla tabella o a un sottoinsieme filtrato secondo necessità. Il punto non è lo strumento, ma rendere esplicite le regole comuni invece di seppellirle in notebook usa e getta.
La parte che non potete saltare è la provenienza. Registrate source_system, source_loaded_at, source_record_hash e ingestion_run_id al momento della lettura, non più tardi nello strato di trasformazione. Se questi campi vengono aggiunti dopo l'ingestione, smettono di essere fatti e diventano ipotesi formulate sotto pressione.
Aggiungere controlli su distribuzione e tempestività
Una volta che le regole a livello di riga sono stabili, osservate la tabella nel suo insieme. Conteggi di righe che si discostano troppo dalla baseline recente, tassi di null che crescono lentamente nei campi critici e drift della cardinalità categoriale indicano tutti problemi che una regola sulla singola riga non coglierebbe. Per la tempestività, fissate un obiettivo di livello di servizio chiaro e legato allo scopo della tabella, ad esempio una breve finestra di ritardo per i feed quasi in tempo reale e una più lunga per i batch.
La parte difficile è la taratura. Le baseline delle anomalie richiedono un periodo di riscaldamento prima di diventare significative, perché un dataset nuovo non ha ancora una forma stabile. Separate gli errori bloccanti dagli avvisi, inoltrate gli avvisi al triage e assicuratevi che ogni controllo abbia un responsabile, un runbook e un percorso di bypass. I controlli senza responsabile degenerano in rumore, e i controlli rumorosi smettono di essere letti.
Trattate le soglie di accettazione come una decisione di governance, non come un dettaglio tecnico. Se un feed può tollerare una piccola quantità di dati opzionali mancanti ma non chiavi non valide, dichiaratelo chiaramente nei controlli e nel processo di approvazione. Questo evita che il team discuta ogni alert come se tutti gli errori avessero lo stesso peso.
Livello di validazione | Controllo di esempio | Soglia suggerita | Responsabile + escalation |
|---|---|---|---|
Integrità dei record | Unicità della chiave naturale | Nessun duplicato ammesso | Data engineering, allerta in caso di violazione |
Integrità delle relazioni | Le chiavi dei fatti corrispondono alle chiavi delle dimensioni | Nessuna riga orfana | Responsabile della pipeline, quarantena del batch errato |
Dominio dei valori | Elenco di paesi, stati o enum | Solo valori approvati | Responsabile del dominio, coda di triage |
Precisione numerica | Scala monetaria | Precisione decimale richiesta | Analytics engineer, blocco della pubblicazione |
Andamento dei volumi | Drift del conteggio delle righe | Entro la baseline normale | Data engineer reperibile, indagine |
Stabilità dei null | Tasso di null delle colonne critiche | Basso e stabile per la tabella | Responsabile del dataset, prima un avviso non bloccante |
Tempestività | Ritardo tra evento e caricamento | Conforme allo SLA del feed | Responsabile della piattaforma, allerta in caso di ritardo |
Per una visione più precisa di come i controlli si integrano lungo il ciclo di vita di un dataset, consultate regole di data validation, controlli e data quality continua.
Partizionamento, versionamento e schema drift
Il partizionamento decide più del semplice layout di archiviazione. Influisce sul costo delle query, sulla velocità dei backfill e sulla facilità con cui si possono applicare le regole di conservazione. Spesso i team scelgono uno schema di partizionamento per velocizzare una dashboard, per poi scoprire in seguito che complica la rielaborazione o nasconde dati storici di cui hanno ancora bisogno.
Scegliere il layout in base all'uso della tabella
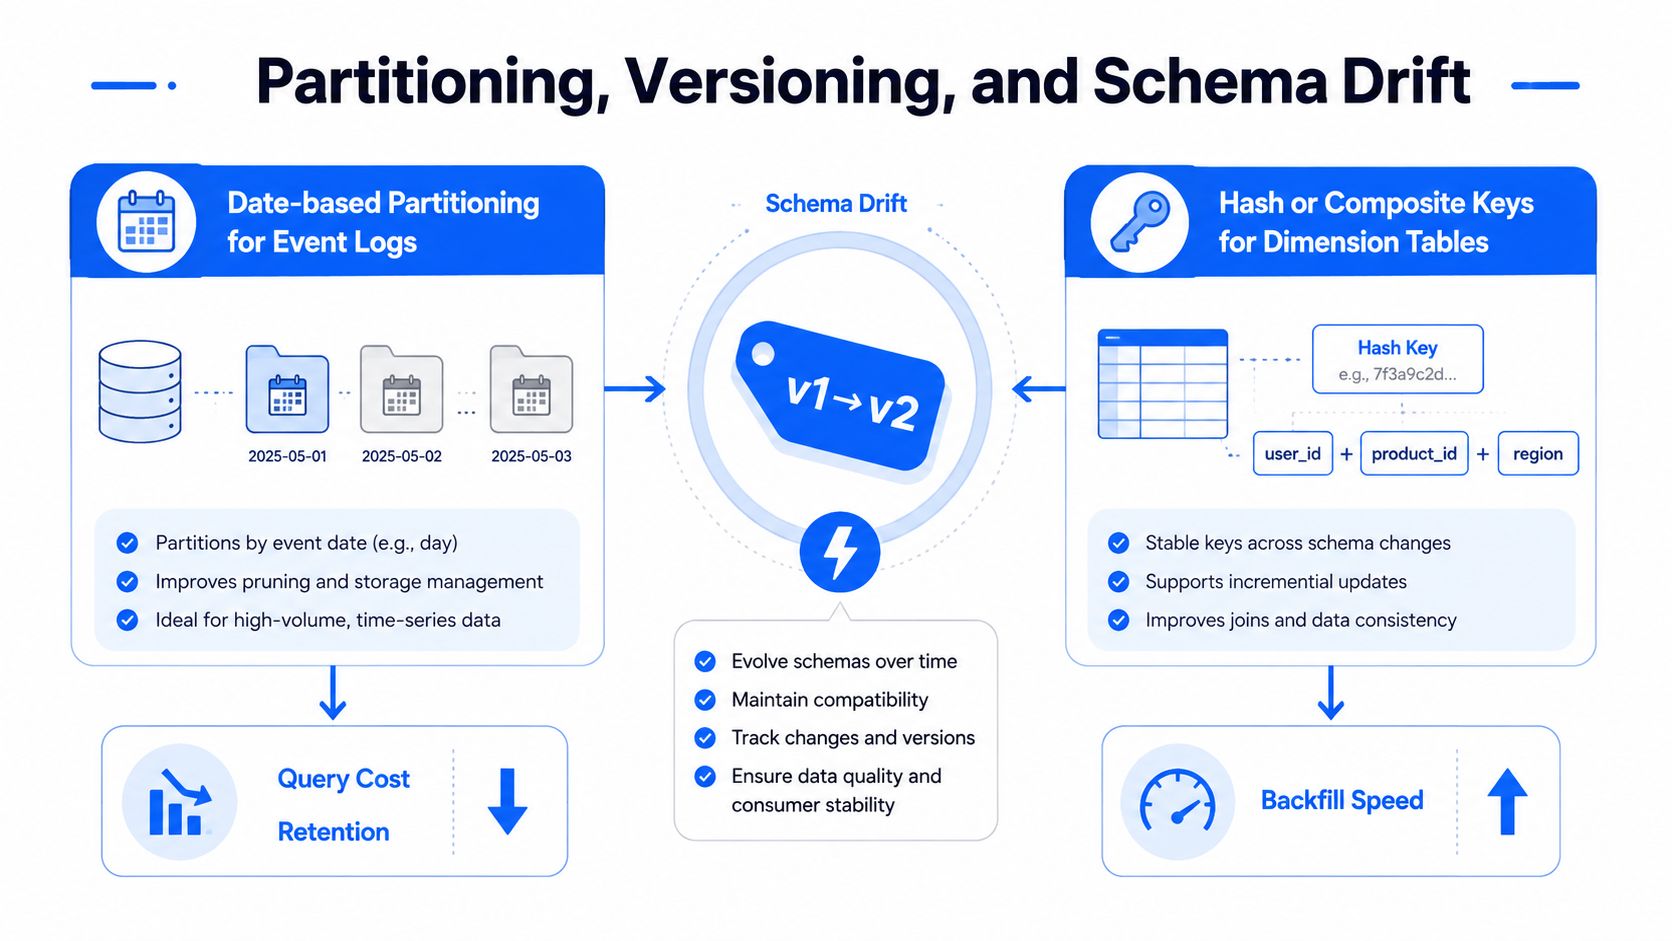
Usate il partizionamento per data per i log di eventi e le fact table con molte operazioni di append. In questo modo ottenete un'unità chiara per la conservazione, i backfill incrementali e le query delimitate nel tempo. Per gli snapshot delle dimensioni o le strutture a variazione lenta, chiavi hash o composte possono rendere più prevedibili ricerche e ricostruzioni, soprattutto quando la tabella non è organizzata naturalmente per tempo. In sistemi come BigQuery, Snowflake e Apache Iceberg la sintassi esatta cambia, ma il principio operativo no.
Trattate il dataset come versionato fin dal primo giorno. Versioni semantiche nei metadati, tag immutabili per ogni release e una finestra di deprecazione per i vecchi utenti evitano che il team finga che ogni release sia intercambiabile. Quando una versione cambia, quella precedente dovrebbe restare disponibile finché gli utenti non hanno migrato, perché il momento peggiore per rimuovere una tabella è quando un report vi è ancora agganciato.
Fare del drift un errore di pipeline, non una sorpresa
Lo schema drift è il killer silenzioso. Compaiono nuove colonne, scompaiono colonne obbligatorie e le dimensioni dei tipi si riducono quanto basta per rompere un join o un cast a valle. Il pattern più pulito prevede un'ingestione permissiva nella landing zone, seguita da profilazione, validazione rigorosa al confine successivo e test di staging che fanno fallire la pipeline se lo schema è cambiato in modo incompatibile.
Questa logica appartiene al codice, non a un commento di revisione in un notebook. Se uno strato di trasformazione può vedere le differenze di schema, può bloccare il rilascio prima che gli utenti abbiano sorprese. Documentazione versionata e un change log chiudono il cerchio, spiegando al prossimo analista perché la tabella attuale ha questo aspetto.
Una guida pratica al controllo di versione per i team di compliance di DPP Grid è utile in questo contesto perché inquadra il versionamento come un problema di governance, non solo come un'abitudine di archiviazione. Se state già affrontando lo schema drift in produzione, l'approfondimento interno su lo schema drift e le modifiche strutturali che rompono le pipeline di dati aiuta a rendere concrete le modalità di guasto.
Governance e reperibilità fin dal primo giorno
La governance viene di solito trattata come una fase di revisione finale, ma in realtà è un problema di reperibilità con implicazioni di conformità. Se le persone non riescono a capire a che cosa serve un dataset, chi ne è responsabile e quali dati contiene, finiranno per usarlo male o per evitarlo. Entrambi gli esiti sono costosi.
Scrivere i metadati minimi prima della pubblicazione
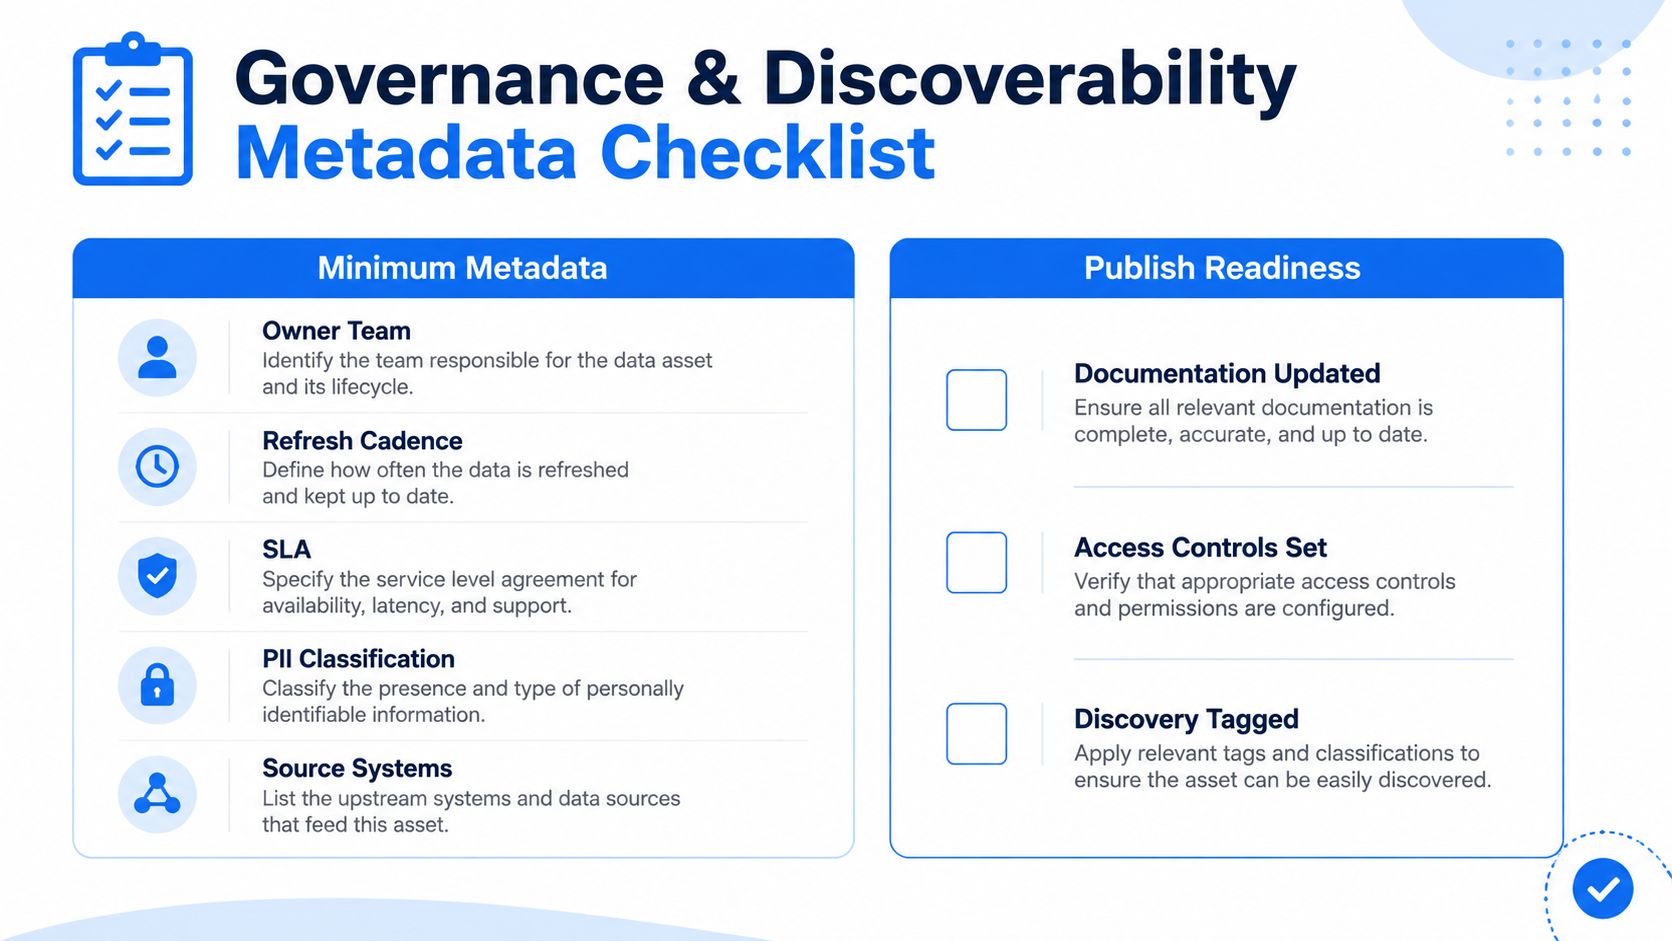
Ogni dataset dovrebbe essere rilasciato con un team responsabile, una cadenza di aggiornamento, uno SLA, una classificazione dei dati personali (PII), i sistemi di origine e una breve dichiarazione dell'uso previsto che indichi anche a che cosa il dataset non è destinato. Questi sei campi sembrano basilari perché lo sono, ed è proprio ciò che è basilare a mantenere la tabella utilizzabile quando arrivano audit, passaggi di consegne e nuovi utenti.
Collegate i controlli di accesso alla classificazione. Mascherate i dati personali riservati, applicate policy a livello di riga dove contano le normative regionali e mantenete separati i ruoli di produzione e di sandbox, in modo che l'accesso esplorativo non sconfini nell'uso operativo. Se il dataset include dati personali, preservate il lineage del consenso collegandolo alla base giuridica e al piano di conservazione che lo disciplinano.
Il catalogo è il luogo in cui tutto questo diventa visibile. La panoramica interna su che cos'è un data catalog ricorda bene che la reperibilità funziona solo quando metadati e policy di accesso sono allineati.
Rendere il riutilizzo sicuro, non casuale
Un dataset facile da trovare ma difficile da considerare affidabile crea più lavoro, non meno. L'obiettivo è che la fase di pubblicazione risulti completa solo quando il dataset è etichettato, documentato e mappato al motore di policy che controlla l'accesso. In questo modo la classificazione non si discosta nel tempo dalle autorizzazioni.
Se la voce di catalogo è vaga, il dataset verrà riutilizzato male.
Ecco perché la checklist pratica è breve: responsabile, classificazione, SLA, uso previsto, aggiornamento e contatto. Compilate questi campi al momento della creazione e risparmierete settimane di scambi con gli auditor in seguito.
Come capire quando il vostro data set è abbastanza buono
“Abbastanza buono” non è una sensazione, è un contratto. L'errore è aspettare una copertura perfetta prima di ammettere il dataset in produzione, perché questo riflesso di solito si trasforma in un rinvio indefinito. Meglio definire il criterio di accettazione e lasciare che i dati se lo guadagnino.
Usare criteri di accettazione legati alla decisione
Un primo criterio utile è la completezza. Se un campo obbligatorio ha un tasso di null elevato, il dataset non è adatto alla decisione che dovrebbe supportare. Un secondo criterio è l'attualità, perché dati obsoleti possono essere puliti e comunque sbagliati per l'uso operativo. Un terzo criterio è la rappresentatività, che verifica se i segmenti chiave sono talmente sbilanciati da distorcere un modello o un report a valle.
I controlli sui bias rientrano in questo terzo criterio. Cercate squilibri tra classi, lacune geografiche, lacune demografiche e survivorship bias nelle sorgenti unite, poi decidete che cosa fare del risultato. Alcuni dataset vanno accettati così come sono, altri andrebbero sovracampionati o integrati, altri dovrebbero escludere determinati usi e altri ancora andrebbero documentati come parziali per scelta progettuale.
Criterio di accettazione | Metrica | Esempio di soglia | Decisione in caso di mancato superamento |
|---|---|---|---|
Completezza | Tasso di null nei campi obbligatori | Sufficientemente basso per il caso d'uso | Bloccare la pubblicazione o eseguire un backfill |
Attualità | Freschezza rispetto alla latenza decisionale | Entro la finestra consentita | Sospendere fino all'aggiornamento |
Rappresentatività | Copertura dei segmenti nei gruppi chiave | Nessuno sbilanciamento critico | Sovracampionare, escludere o documentare |
Stabilità | Risultati di qualità ripetuti nel tempo | Superamento su più cicli | Mantenere in shadow mode |
Promuovere per fasi, non in un unico salto
Il rilascio più pulito è graduale. Prima strumentate le metriche di qualità, poi confrontatele con un dataset di controllo e rendete il nuovo dataset quello predefinito solo dopo che ha retto per più cicli. Questo mantiene il team onesto sul fatto che i dati siano davvero pronti o semplicemente costruiti di recente.
Abbastanza buono significa che il dataset supporta la decisione senza imporre compensazioni nascoste altrove.
Il discorso sulla creazione di un data set riguarda in realtà il controllo, non la raccolta. Se cercate una piattaforma che monitori validazione, tempestività, modifiche di schema e comportamento anomalo all'interno del vostro ambiente, digna lo fa sui dati del data warehouse e delle pipeline senza spostarli dalla loro sede. Visitate digna per scoprire come si inserisce in un ciclo di vita del dataset che richiede responsabilità, soglie e controlli continui, non soltanto un'altra build una tantum.
Domande frequenti
Quando un data set è davvero finito?
Non quando la build va a buon fine. Se una dashboard, un modello o un flusso di lavoro a valle può fallire silenziosamente, il dataset non è ancora finito. Un dataset di produzione ha bisogno di controllo dopo il lancio, non solo di costruzione prima.
Che cosa dovreste decidere prima di scrivere la prima query?
Granularità, chiavi e semantica temporale, perché gli errori di schema si consolidano in fretta e diventano costosi. Scegliete la granularità in modo esplicito invece di lasciarla emergere da sola e usate nomi che reggono all'uso operativo reale, dato che una tabella di eventi poco curata mostra di solito i suoi problemi innanzitutto nei nomi delle colonne.
Perché i dataset si rompono settimane dopo il lancio?
Perché la causa principale di solito riguarda il controllo più che la costruzione. La build ha superato ogni unit test e sembrava pulita in staging, e in seguito non è successo nulla di clamoroso; ciò che mancava era un modo per accorgersi di quando i dati hanno smesso di comportarsi come lo schema lasciava intendere.
Quali controlli servono su un nuovo dataset fin dal primo giorno?
Validazione, disciplina nel partizionamento e contesto di governance, oltre al monitoraggio delle modalità di guasto che restano silenziose. Aggiungerli dopo un incidente costa sempre di più che progettarli fin dall'inizio, perché a quel punto il dataset ha già utenti che prendono decisioni sulla sua base.
Quanti dati aziendali rispettano davvero gli standard di qualità?
Solo una piccola parte, secondo ricerche di settore ampiamente citate, insieme alle stime di Gartner sui costi di una scarsa data quality. La lettura pratica non è che la maggior parte dei dati sia inutilizzabile, ma che la maggior parte dei dati non sia mai stata misurata rispetto a uno standard dichiarato.


