Che cos'è la Data Discovery? Una guida pratica per il 2026
|
5
min di lettura

Una dashboard che ieri sembrava in ordine oggi è piatta. Un report sui ricavi è sbagliato quel tanto che basta per far convocare una riunione. Una feature table di ML esiste ancora, ma il modello che alimenta ha iniziato a produrre risultati senza senso. Di solito la prima reazione è sempre la stessa: aprire il warehouse, controllare i caricamenti recenti, esaminare la lineage, chiedere chi ha cambiato cosa e sperare che la risposta arrivi prima che se ne accorga qualcuno di importante.
Questa corsa contro il tempo è il contesto per capire che cos'è la Data Discovery. Non è una voce di glossario. È la disciplina che aiuta ingegneri, analisti e team di ML a trovare i dati giusti, capire cosa significano e decidere se in questo momento è sicuro usarli. L'ultima parte è la più importante. Un dataset può essere documentato alla perfezione ed essere comunque inutilizzabile dal punto di vista operativo se una colonna ha cambiato tipo durante la notte, un caricamento è arrivato in ritardo o i valori sono usciti dal loro intervallo normale senza far scattare alcun alert.
Indice
La ricerca di risposte in un mare di dati
La maggior parte dei team dati non inizia a interessarsi alla discovery perché ama i metadati. Se ne interessa perché la produzione si rompe in modi difficili da vedere.
Uno scenario tipico è questo: la funzione finance apre una dashboard dei KPI e nota un calo improvviso. L'SQL continua a funzionare. La tabella esiste ancora. Il livello BI non è cambiato. Eppure il risultato è sbagliato. Qualcuno risale all'origine del problema: una pipeline caricata in ritardo, oppure un team sorgente che ha aggiunto un campo modificando le ipotesi a valle. Il catalogo dice che il dataset è disponibile, ma il business sta comunque guardando numeri obsoleti o distorti.
Questo è il divario di observability. Un inventario statico vi dice cosa esisteva quando è stata eseguita la scansione. Non vi dice se i dati sono aggiornati, strutturalmente stabili o se si comportano ancora come l'asset che le persone pensano di utilizzare.
Un dataset individuato non è automaticamente un dataset affidabile.
Questo divario è uno dei motivi per cui la categoria continua a espandersi. Il mercato globale della data discovery era valutato 7,50 miliardi di USD nel 2021 e si prevede che raggiunga i 20,03 miliardi di USD entro il 2030, con un CAGR del 15,60%, secondo Spherical Insights sul mercato della data discovery. Questa evoluzione è significativa perché dimostra che la discovery non è più considerata una documentazione facoltativa. I team la trattano sempre più come parte dell'infrastruttura operativa dei dati.
I metadati statici non risolvono l'incertezza in produzione
Gli strumenti di discovery tradizionali rispondono bene alle domande di base:
Dove si trova il dataset: warehouse, lake, export SaaS o archivio applicativo.
Chi ne è responsabile: almeno sulla carta.
Cosa contiene: colonne, tipi, tag e descrizioni.
Come viene interrogato: se utilizzo e lineage vengono registrati.
Sono risposte utili. Semplicemente non bastano quando il problema è il comportamento del sistema in esecuzione.
Se state ottimizzando le prestazioni durante un incidente, contenuti come l'articolo di Riff Analytics sull'ottimizzazione delle query sono spesso più utili dell'ennesima voce statica di glossario, perché il compito principale è di solito operativo: capire cosa sta rallentando, cosa è cambiato e quale lavoro a valle è ora sospetto.
La discovery riguarda in realtà la sicurezza nelle decisioni
La domanda pratica non è "Abbiamo i dati?", ma "Qualcuno può usare questo dataset per un report, una pipeline di feature o una decisione del management senza imbattersi in un guasto nascosto?"
Questo cambia il modo in cui gli ingegneri dovrebbero pensare alla discovery. Smette di essere uno sprint di documentazione una tantum e diventa una capacità continua legata all'affidabilità. Quando le pipeline subiscono un drift impercettibile, la discovery deve tenere il passo. Altrimenti i team continuano a cercare risposte in sistemi che dall'esterno sembrano ancora integri.
Che cos'è davvero la Data Discovery
La definizione utile più breve è questa: la Data Discovery è il processo continuo di individuazione, comprensione e valutazione degli asset di dati, affinché le persone possano utilizzarli con contesto e fiducia.
Sembra semplice, finché non si considera come la maggior parte delle organizzazioni la mette in pratica. Molte si affidano ancora a un catalogo costruito da scansioni pianificate, descrizioni mantenute manualmente e uno strato di conoscenza tribale che vive nei thread di Slack e nei notebook degli analisti. Questa configurazione funziona finché l'ambiente non cambia più velocemente della documentazione.
Un'analogia migliore è quella dei trasporti. Un catalogo tradizionale è una cartina stradale di carta. Può mostrare strade, nomi e percorsi approssimativi. Ma se c'è traffico, un ponte viene chiuso o iniziano dei lavori, la cartina serve a poco. La discovery moderna dovrebbe comportarsi più come un navigatore GPS in tempo reale. Vi dice ancora dove si trovano le cose, ma vi dice anche se il percorso è praticabile in questo momento.

La definizione pratica utilizzabile dagli ingegneri
In una piattaforma dati in esercizio, la discovery dovrebbe rispondere contemporaneamente a quattro domande:
Cosa esiste
Cosa significa
Come è collegato
Se è affidabile adesso
Le prime tre sono familiari. La quarta è quella su cui le implementazioni deboli falliscono.
Una tabella con descrizioni pulite ma con un comportamento instabile a monte è individuata solo in parte. Un set di feature che gli analisti riescono a trovare ma di cui non possono verificare la freschezza non è pienamente pronto per l'uso in AI o BI. Una buona discovery combina metadati, comprensione dei contenuti, contesto d'uso e condizione operativa attuale.
Cosa rende possibile la Data Discovery
Quando i team chiedono che cos'è la Data Discovery, spesso in realtà stanno chiedendo cosa ne ricavano. In pratica, ottengono uno strato utilizzabile tra lo storage dei dati grezzi e il loro utilizzo da parte del business.
Questo strato supporta attività come:
Selezione più rapida dei dataset: gli analisti smettono di indovinare quale tabella sia aggiornata o canonica.
Riutilizzo più sicuro: gli ingegneri possono esaminare lineage, definizioni e comportamento recente prima di collegare un dataset alla produzione.
Responsabilità più chiare: le persone sanno chi contattare quando una metrica sembra sbagliata.
Meno attriti per AI e analytics: i team passano meno tempo a cercare e più tempo a validare.
Regola pratica: se la discovery non aiuta un utente a decidere se fidarsi oggi di un dataset, non è completa.
Il passaggio dall'inventario all'intelligence operativa
Il vecchio modello trattava la discovery come un artefatto di documentazione. Il modello moderno la tratta come uno strato di intelligence operativa.
È una distinzione importante. L'inventario vi dice che il warehouse contiene un oggetto. L'intelligence operativa vi dice se quell'oggetto è aggiornato, stabile e adatto al compito che avete davanti. Negli ambienti maturi, la discovery non è separata dal lavoro di engineering quotidiano. È integrata nel modo in cui i team valutano la qualità, scelgono le fonti dati, indagano sugli incidenti e proteggono i consumer a valle da ipotesi errate.
Come funziona la Data Discovery moderna
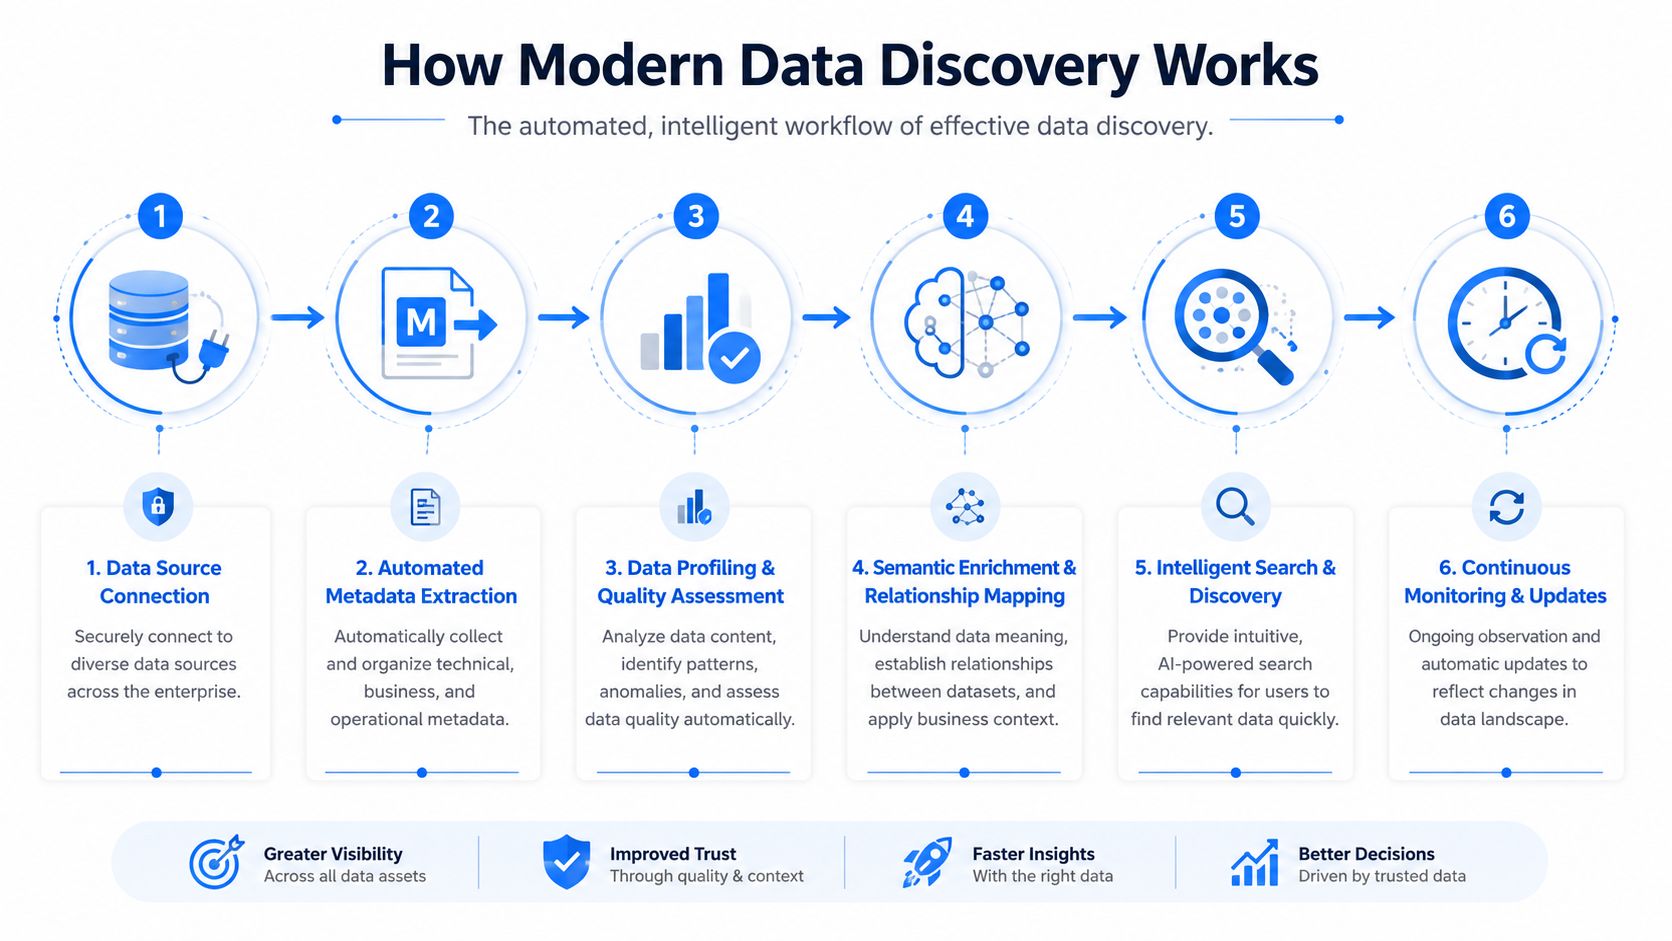
La discovery moderna funziona al meglio quando si comporta come un sistema automatizzato, non come un progetto di ricerca manuale. Gli ingegneri non dovrebbero dover esaminare ogni schema, scrivere a mano ogni regola di qualità e incrociare ogni dipendenza a valle solo per capire se un dataset è utilizzabile.
Il workflow inizia di solito con la connessione e l'estrazione. I sistemi si collegano a warehouse, lake e livelli di pipeline, quindi raccolgono metadati tecnici, dettagli strutturali, segnali di utilizzo e contesto operativo. A partire da qui, la piattaforma costruisce una visione più ricca di cosa siano i dati, di come si comportano e di dove vengono utilizzati.
Il profiling costruisce il primo livello di comprensione
Il profiling è il punto in cui la discovery smette di essere un elenco e inizia a diventare utile. I sistemi automatizzati calcolano statistiche descrittive, esaminano le distribuzioni, fanno emergere i pattern dei valori null e cercano gli outlier. Questo offre ai team un quadro concreto di come si comporta un dataset, invece di come qualcuno lo ha descritto mesi fa.
L'integrità dei dati di produzione è fondamentale, ma spesso viene meno senza che nessuno se ne accorga subito. I valori subiscono un drift. Le distribuzioni delle categorie cambiano. Una sorgente inizia a inviare campi vuoti dove prima inviava ID. Secondo lakeFS sulla data discovery, la data discovery automatizzata che utilizza un profiling basato sull'AI può segnalare il 30-40% in più di problemi silenziosi di data quality prima che influiscano sulle decisioni.
Un utile effetto collaterale è che i team scrivono meno controlli manuali fragili. La piattaforma apprende cosa sia la normalità ed evidenzia le deviazioni, invece di costringere gli ingegneri a mantenere infinite regole basate su soglie.
Classificazione e semantica aggiungono significato di business
Il profiling grezzo non vi dice se un campo contiene identificativi dei clienti, valori legati ai pagamenti o telemetria a basso rischio. È qui che contano la classificazione e l'arricchimento semantico.
Un flusso moderno e pratico include spesso:
Identificazione dei dati sensibili: i sistemi classificano i campi probabilmente regolamentati o ad alto rischio, così che i team possano governarne gli accessi in modo appropriato.
Contesto di entità e dominio: le tabelle vengono collegate a concetti di business, non solo a posizioni di storage.
Mappatura delle relazioni: i grafi di lineage e di dipendenza mostrano da dove proviene un dataset e cosa si rompe se cambia.
Alcune organizzazioni collegano anche i risultati della discovery a sistemi di conoscenza interni. Un buon esempio di questo pattern più ampio è la piattaforma Company Brain di Donely, che riflette la stessa esigenza operativa: collegare informazioni sparse a un contesto utilizzabile, così che i team possano agire più rapidamente.
Il monitoraggio continuo colma il divario
È qui che la discovery moderna si distingue dalla vecchia catalogazione. L'estrazione dei metadati e il profiling creano un'istantanea. Il monitoraggio mantiene viva quell'istantanea.
Uno stack di discovery solido sorveglia elementi come lo schema drift, i caricamenti in ritardo, i movimenti insoliti delle metriche e i cambiamenti nei pattern di arrivo. È lo stesso modello operativo descritto in cosa significa in pratica la Data Observability, dove l'obiettivo non è solo documentare gli asset di dati, ma osservarne continuamente lo stato.
Il dataset che manda in tilt la vostra dashboard di solito non scompare. Resta visibile mentre diventa fuorviante.
Una volta compreso questo, l'architettura diventa più chiara. La discovery non è una scansione seguita da una ricerca. È un ciclo di estrazione, profiling, arricchimento e osservazione che tiene il passo con il patrimonio di dati stesso.
Vantaggi strategici e casi d'uso comuni
La Data Discovery giustifica il proprio budget quando riduce le decisioni sbagliate, accorcia i tempi di risposta agli incidenti e aumenta la fiducia nei sistemi che dipendono dai dati. Il valore non è astratto. Si vede nella capacità dei team di fidarsi dei report, di adottare l'AI in sicurezza e di governare le informazioni sensibili senza trasformare ogni richiesta in una revisione manuale.
Un'AI affidabile dipende da dati individuabili
I programmi di AI spesso falliscono a monte, non nel codice del modello. I team possono perfezionare i prompt, ottimizzare le feature e rivedere i framework di valutazione, ma se gli input sono poco compresi, in ritardo o semanticamente incoerenti, gli output non si stabilizzeranno.
Ecco perché la discovery è diventata più strategica con la crescita dell'adozione. Nel 2024, il 42% delle grandi organizzazioni sta adottando attivamente l'AI, secondo i dati di IBM sull'adozione dell'AI nelle aziende. In pratica, significa che sempre più organizzazioni devono sapere quali dataset sono adatti per training, inferenza, generazione di feature e workflow di retrieval.
Una BI affidabile dipende da un contesto aggiornato
La business intelligence si rompe quando una metrica sembra legittima ma riflette dati obsoleti, incompleti o strutturalmente alterati. La discovery aiuta fornendo contesto ad analisti e sviluppatori BI prima che un grafico errato finisca in una presentazione per il management.
Alcuni casi d'uso comuni spiccano:
Reporting direzionale: i team finance e operations devono verificare che la fonte alla base di un KPI sia quella prevista e che sia ancora aggiornata.
Analytics self-service: gli analisti hanno bisogno di ricerca, lineage, responsabilità e segnali sul comportamento recente prima di riutilizzare una tabella.
Analisi delle cause profonde: i data engineer devono circoscrivere il raggio d'impatto quando una dashboard si discosta dal comportamento atteso.
La governance funziona meglio quando la discovery è integrata
Compliance e governance sono il punto di partenza di molti progetti di catalogo, ma funzionano su larga scala solo se la discovery è attiva anziché passiva.
Una buona discovery aiuta i team a:
Esigenza | Come aiuta la discovery |
|---|---|
Gestione dei dati sensibili | Identifica i campi probabilmente regolamentati e offre agli steward una visione più chiara di dove si trovano |
Revisione degli accessi | Mostra responsabilità, contesto d'uso e finalità del dataset prima che i permessi vengano estesi |
Supporto agli audit | Conserva metadati, lineage e contesto operativo che spiegano come vengono utilizzati i dati |
Se un team non sa dire cosa contiene un dataset, chi ne è responsabile e se è aggiornato, la governance diventa un'ipotesi.
Ecco perché la discovery fa parte della strategia di piattaforma, non solo degli strumenti di governance. Supporta contemporaneamente ingegneri, analisti, professionisti del ML e steward.
Discovery, catalogazione e profiling a confronto
Questi termini vengono confusi di continuo, e questa confusione porta a decisioni architetturali sbagliate. I team acquistano un catalogo e si aspettano una discovery attiva. Eseguono job di profiling e presumono di avere ormai la governance. Documentano alcuni asset chiave e considerano il problema risolto.
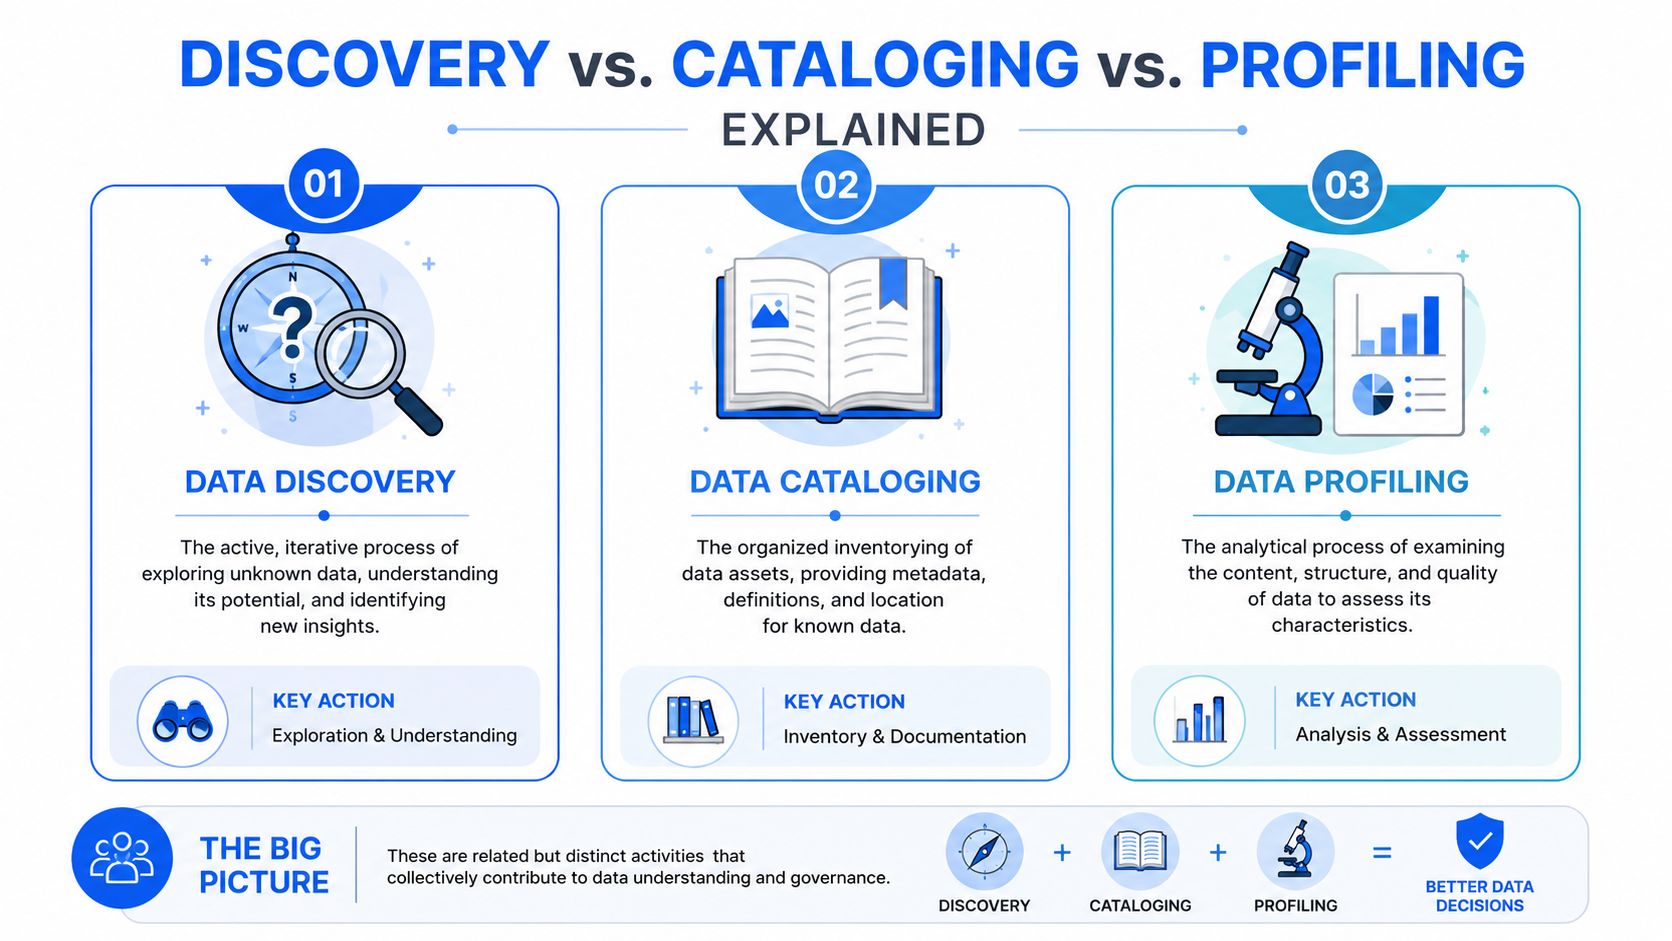
Il modo più chiaro di vederla è questo: il profiling esamina i dati, la catalogazione organizza i metadati e la discovery usa entrambi per aiutare le persone a trovare e valutare i dati per un utilizzo concreto.
Un confronto fianco a fianco
Disciplina | Compito principale | Output tipico | Limite principale se usata da sola |
|---|---|---|---|
Data profiling | Esaminare contenuto e struttura | statistiche, tassi di null, distribuzioni, anomalie | Non organizza gli asset per una discovery estesa |
Catalogazione dei dati | Inventariare e documentare gli asset | metadati, definizioni, responsabilità, tag | Può diventare rapidamente obsoleta se non viene mantenuta aggiornata |
Data discovery | Aiutare gli utenti a trovare, comprendere e valutare i dati | accesso ai dati ricercabile, contestuale e orientato alla fiducia | Per essere efficace richiede le altre discipline |
Questa tabella è importante perché gli strumenti spesso si sovrappongono, ma lo scopo operativo non è lo stesso.
Dove i team di solito sbagliano
Alcuni team considerano il catalogo come il prodotto finito. Non lo è. Un catalogo è un sistema di riferimento. È prezioso, ma non sostituisce una conoscenza aggiornata di comportamento, qualità e prontezza all'uso.
Altri team si concentrano troppo sul profiling. Generano statistiche ricche per le singole tabelle, ma non collegano mai questi risultati a responsabilità, lineage, significato di business o funzioni di ricerca per gli utenti. Il risultato è tecnicamente interessante e operativamente scomodo.
Un approccio più duraturo consiste nel trattare il catalogo come un componente all'interno della discovery. È anche per questo che le risorse su come sbloccare il potenziale aziendale con l'AI tendono a enfatizzare un contesto utilizzabile, non la semplice disponibilità dei dati grezzi. AI e analytics hanno bisogno di più che asset archiviati. Hanno bisogno di asset comprensibili.
Come si integrano nella pratica
Uno stack funzionante si presenta spesso così:
Il profiling fornisce le evidenze: quali valori esistono, come si distribuiscono, se qualcosa non torna.
La catalogazione fornisce la struttura: dove si trovano gli asset, come si chiamano, chi ne è responsabile.
La discovery fornisce l'usabilità: quale asset una persona dovrebbe scegliere, se corrisponde al compito e se ci si può fidare.
Se volete approfondire la distinzione dal punto di vista dei metadati, questa spiegazione di che cos'è un Data Catalog è il concetto adiacente giusto. Il punto operativo importante è che la discovery è più ampia. Include il catalogo, usa il profiling ed estende entrambi in un livello decisionale per gli utenti reali.
Sfide comuni nella Data Discovery
La parte più difficile della discovery non è costruire un indice. È mantenerlo allineato a un patrimonio di dati in continua evoluzione.
Una tabella del warehouse può continuare a esistere con lo stesso nome mentre il suo significato cambia sotto carico. Un team sorgente potrebbe aggiungere colonne senza preavviso. Una pipeline può continuare a girare secondo la pianificazione mentre consegna partizioni vuote o dati in ritardo inatteso. In ogni caso, l'asset resta "individuabile" in senso statico e inaffidabile in senso pratico.
La discovery statica invecchia rapidamente
Una scansione del catalogo cattura i metadati in un determinato momento. Questo diventa un problema nel momento stesso in cui un sistema di produzione cambia.
Tre modalità di guasto si ripresentano di continuo:
Drift silenzioso: le distribuzioni dei valori cambiano abbastanza da alterare report o comportamento dei modelli senza causare un errore bloccante.
Modifiche allo schema: un campo rinominato, una colonna aggiunta o un cambio del tipo di dato rompono le ipotesi a valle.
Drift delle responsabilità: il responsabile indicato ha lasciato il team, e ora nessuno risponde quando la metrica va male.
Nessuna di queste situazioni è insolita. Sono condizioni normali nelle piattaforme dati attive.
La tempestività è spesso sottovalutata
I problemi di freschezza sono particolarmente pericolosi perché i dati possono sembrare validi. La query viene eseguita. Le righe ci sono. I numeri sono in ritardo.
Secondo la spiegazione di Monte Carlo sulle anomalie più comuni nei dati, i dati in ritardo sono una delle otto anomalie più comuni che incidono sulla qualità. Ecco perché il monitoraggio delle consegne attese è così importante negli ambienti di analytics. Se una business review inizia alle 9:00 e la sorgente arriva alle 9:20, il problema non è l'individuabilità nel senso del catalogo. È l'individuabilità della verità attuale.
Dati aggiornati e dati disponibili non sono la stessa cosa.
Scala e frammentazione rendono fragile la discovery manuale
Anche i team meglio organizzati faticano quando i dati sono suddivisi tra warehouse, lake, output di reverse ETL, connettori SaaS e feature store di ML. La cura manuale non riesce a tenere il passo con un ambiente di questo tipo.
I sintomi tipici sono facili da riconoscere:
Gli ingegneri si affidano alla memoria per decidere quale tabella sia canonica.
Gli analisti duplicano i dataset perché non riescono a verificare quelli esistenti.
La revisione degli incidenti inizia con un lavoro investigativo invece che con le evidenze.
I team si fidano delle pipeline verdi mentre i consumer fissano dashboard rotte.
Un approccio "configura e dimentica" non sopravvive a queste condizioni. La discovery deve essere mantenuta come capacità operativa, non archiviata come documentazione.
Una discovery continua con digna
Il divario di observability si colma quando la discovery smette di essere un registro storico e inizia a riflettere il comportamento in tempo reale. È qui che una piattaforma come digna cambia il modello operativo.
Invece di chiedere ai team di mantenere infinite regole basate su soglie, digna utilizza un'anomaly detection basata sull'AI che apprende il comportamento normale e adatta dinamicamente le soglie. Secondo la panoramica di digna sulle tecniche di anomaly detection basate sull'AI, piattaforme come digna utilizzano tecniche come gli Isolation Forest per segnalare le anomalie reali senza la manutenzione manuale delle regole richiesta dai sistemi tradizionali.
Cosa significa nell'operatività quotidiana
In pratica, per funzionare la discovery continua ha bisogno di tre elementi:
Monitoraggio comportamentale: rilevare quando i dati iniziano a comportarsi diversamente, anche se schemi e job sembrano ancora normali.
Consapevolezza strutturale: intercettare colonne aggiunte o rimosse, cambi di tipo e altre variazioni prima che si propaghino a cascata su report o modelli.
Controllo della tempestività: far emergere arrivi in ritardo o mancanti prima che gli utenti consumino output obsoleti.
digna si allinea a questo modello attraverso Data Anomalies, Schema Tracker e Timeliness. Insieme, queste capacità mantengono aggiornata la discovery invece di lasciarla congelata al momento della scansione.
Perché l'architettura conta
Molti prodotti di observability creano attriti perché richiedono un ampio spostamento dei dati o l'accesso da parte del vendor a record di produzione sensibili. L'approccio di digna è diverso. Calcola le metriche in-database e opera in ambienti controllati dal cliente, come deployment in private cloud o on-prem.
Questa architettura è importante per le aziende regolamentate e per qualsiasi team di engineering che non voglia un'ulteriore dipendenza esterna a contatto con i dati di produzione. Rende inoltre la discovery continua più praticabile su larga scala, perché la piattaforma può esaminare trend, comportamento di arrivo atteso e variazioni dello schema senza trasformare ogni analisi in un progetto di esportazione dei dati.
La discovery diventa affidabile quando il sistema sa dirvi non solo cos'è l'asset, ma anche se si comporta ancora come l'asset che pensate che sia.
Se il vostro team ha bisogno di questo tipo di visibilità in tempo reale, digna è pensato proprio per questo. Aiuta data engineer, team di analytics e professionisti del ML a rilevare anomalie, monitorare la tempestività, tracciare le modifiche allo schema e mantenere l'analisi della data quality all'interno del proprio ambiente, così che la discovery resti aggiornata, operativa e affidabile.
Poiché i campi rinominati e i cambi di tipo sono tra i modi più rapidi in cui la discovery diventa obsoleta, guardate come digna Schema Tracker intercetta le modifiche strutturali prima che si propaghino su report o modelli.
Domande frequenti
Che cos'è la data discovery?
La data discovery è il processo continuo di individuazione, comprensione e valutazione degli asset di dati, affinché le persone possano utilizzarli con contesto e fiducia. Dovrebbe rispondere contemporaneamente a quattro domande: cosa esiste, cosa significa, come è collegato e se è affidabile in questo momento. È su quest'ultima domanda che le implementazioni deboli falliscono.
Qual è la differenza tra data discovery, catalogazione dei dati e data profiling?
Il profiling esamina contenuto e struttura dei dati, producendo statistiche, tassi di null e distribuzioni. La catalogazione inventaria e documenta gli asset con metadati, definizioni e responsabilità. La discovery usa entrambi per aiutare le persone a trovare un dataset, comprenderlo e decidere se è affidabile per il compito da svolgere. Da solo, un catalogo diventa rapidamente obsoleto.
Come funziona la data discovery moderna?
Funziona come un ciclo, non come una scansione una tantum. I sistemi si collegano a warehouse, lake e pipeline per estrarre i metadati, poi eseguono il profiling di distribuzioni e pattern dei null, aggiungono classificazione e lineage e continuano a monitorare schema drift, caricamenti in ritardo e movimenti insoliti delle metriche, così che il quadro resti aggiornato.
Perché la tempestività è importante per la data discovery?
I dati in ritardo possono sembrare perfettamente validi: la query viene eseguita e le righe ci sono, ma i numeri sono obsoleti. L'articolo porta l'esempio di una business review che inizia alle 9:00 mentre la sorgente arriva alle 9:20. Il monitoraggio delle consegne attese rende individuabile la verità attuale, non solo il dataset in sé.
In che modo digna supporta la data discovery continua?
digna mantiene aggiornata la discovery attraverso tre moduli: Data Anomalies per il monitoraggio comportamentale, Schema Tracker per le modifiche strutturali e Timeliness per gli arrivi in ritardo o mancanti. Apprende il comportamento normale con un'anomaly detection basata sull'AI, calcola le metriche in-database e opera in ambienti private cloud o on-prem controllati dal cliente.


