Controlli di completezza dei dati: guida pratica per i team moderni
|
6
min di lettura

Potete avere un warehouse che sulla carta sembra sano e consegnare comunque un numero sbagliato alla finanza prima di pranzo. Arriva un caricamento giornaliero, i dashboard si aggiornano e nessuno nota che un campo obbligatorio è improvvisamente vuoto, che una partizione non è arrivata o che una sorgente ha cambiato forma quanto basta per sfuggire a un rapido controllo del numero di righe. È così che la fiducia inizia a disperdersi, molto prima che qualcuno apra una war room.
I controlli di completezza dei dati sono la protezione tra l'ingestione grezza e le decisioni che le persone sono disposte a difendere. Il punto delicato è che la completezza non riguarda solo “ci sono null?”, ma anche “sono arrivati i record giusti, in tempo, nel posto giusto e con i campi di cui il business ha bisogno?”. Ecco perché l'approccio più solido tratta la completezza come una questione di idoneità all'uso, non come una metrica estetica.
Indice
Perché i problemi di completezza minano la fiducia prima che qualcuno se ne accorga
Progettare SLA e alert che distinguano il ritardo dalla perdita
Come una piattaforma di osservabilità nel database cambia il quadro
Una checklist di completezza in una settimana per le vostre pipeline
Perché i problemi di completezza minano la fiducia prima che qualcuno se ne accorga
Qualsiasi team finanziario in un grande ambiente di warehouse conosce bene questo schema. Il dashboard non esplode, semplicemente smette di corrispondere al sistema sorgente dopo un caricamento giornaliero, e il primo indizio è un confronto con i totali della settimana precedente. Qualcuno ricontrolla il modello, qualcun altro riesegue il report, e poi il problema emerge. Una colonna è sparita dal feed, ma la pipeline è comunque “andata a buon fine”.
Questo tipo di errore è esattamente il motivo per cui le linee guida ufficiali sulla qualità statistica trattano la completezza come un controllo di prima linea. Il governo scozzese raccomanda di verificare i valori mancanti, controllare il numero atteso di voci, confermare che tutte le variabili siano presenti e confrontare i totali e le somme di righe o colonne tra loro e con gli anni precedenti prima della pubblicazione, per poi verificare le anomalie rispetto ai dati storici e ad altre fonti pubblicate, così da capire se il cambiamento è reale o solo un errore (linee guida del governo scozzese sulla qualità statistica). In termini di warehouse, si tratta di un lavoro di riconciliazione, non solo di una caccia ai null.
Un team che verifica solo se una colonna contiene null può non accorgersi di una perdita silenziosa di righe, di voci duplicate o di un caricamento in ritardo ma tecnicamente non vuoto. Ecco perché un problema di completezza si manifesta spesso prima come escalation degli stakeholder e solo dopo come indagine sulla causa radice. Quando il report viene ricostruito, il danno è già tanto relazionale quanto tecnico.
Regola pratica: se uno scostamento del dashboard può essere scambiato per un cambiamento del business, servono controlli di completezza sia sul flusso dei record sia sulla presenza dei campi, non solo su uno dei due.
Se state valutando strumenti per questo problema, è utile confrontare come i diversi prodotti gestiscono i controlli sui dati operativi. Un buon punto di partenza è valutare il software per i fornitori della pubblica amministrazione, perché gli ambienti di reportistica del settore pubblico tendono a far emergere gli stessi problemi di completezza dei warehouse aziendali, solo con meno margine di ambiguità.
Cosa verificano i controlli di completezza dei dati
Un utile punto di partenza è la metrica più semplice. La completezza si esprime spesso come quota di valori non mancanti in un campo o in un record, calcolata come Completezza = (Numero di valori non null / Numero totale di valori) × 100%. Questa formula è utile perché rende la completezza confrontabile tra tabelle, sistemi e periodi, e offre un unico linguaggio per un campo, una riga o un intero dataset (definizione della metrica di completezza).
Di solito un team di warehouse percepisce questa metrica solo dopo che qualcosa a valle si è rotto. Un feed giornaliero degli ordini può sembrare sano a livello di colonna, mentre alcune chiavi mancanti fanno fallire i join, falsano i conteggi dei dashboard e interrompono la continuità degli audit trail. Una tabella clienti può essere ancora utilizzabile per la fatturazione anche se un campo di arricchimento è vuoto, perché la fatturazione richiede solo una porzione più ristretta del record. Ecco perché i controlli di completezza riguardano in realtà l'idoneità all'uso, non l'obbligo di riempire ogni cella.
Vista a livello di attributo e a livello di record
La completezza ha almeno due livelli che vale la pena distinguere. La completezza a livello di attributo chiede se una specifica colonna è popolata. La completezza a livello di record chiede se una riga contiene tutti i campi di cui il caso d'uso ha bisogno. Una colonna può sembrare a posto in media e lasciare comunque inutilizzabili a valle alcune righe critiche.
Questa distinzione conta soprattutto durante l'ingestione e il caricamento nel warehouse. Se in una tabella degli ordini manca customer_id, order_date o status, la pipeline può comunque caricare le righe, ma il modello non può più supportare con sicurezza join, dashboard o revisioni di audit. Le indicazioni di IBM sui metodi di test dei dati vanno nella stessa direzione: la completezza dovrebbe concentrarsi sugli elementi di dati critici, perché non tutti i campi hanno lo stesso valore operativo (metodi di test dei dati di IBM).
Una volta definito il caso d'uso, il controllo diventa molto più chiaro. Decidete quali campi sono obbligatori, quali sono arricchimenti facoltativi e quali righe non devono mai arrivare caricate a metà. In pratica, le regole di completezza seguono prima il processo di business e poi lo schema.
Un warehouse può essere incompleto per l'analisi e comunque abbastanza completo per la reportistica di controllo. È questa differenza a trasformare la completezza in una decisione sulla tempestività e sulla copertura degli SLA, soprattutto quando un caricamento in ritardo è più dannoso di uno scarno ma puntuale.
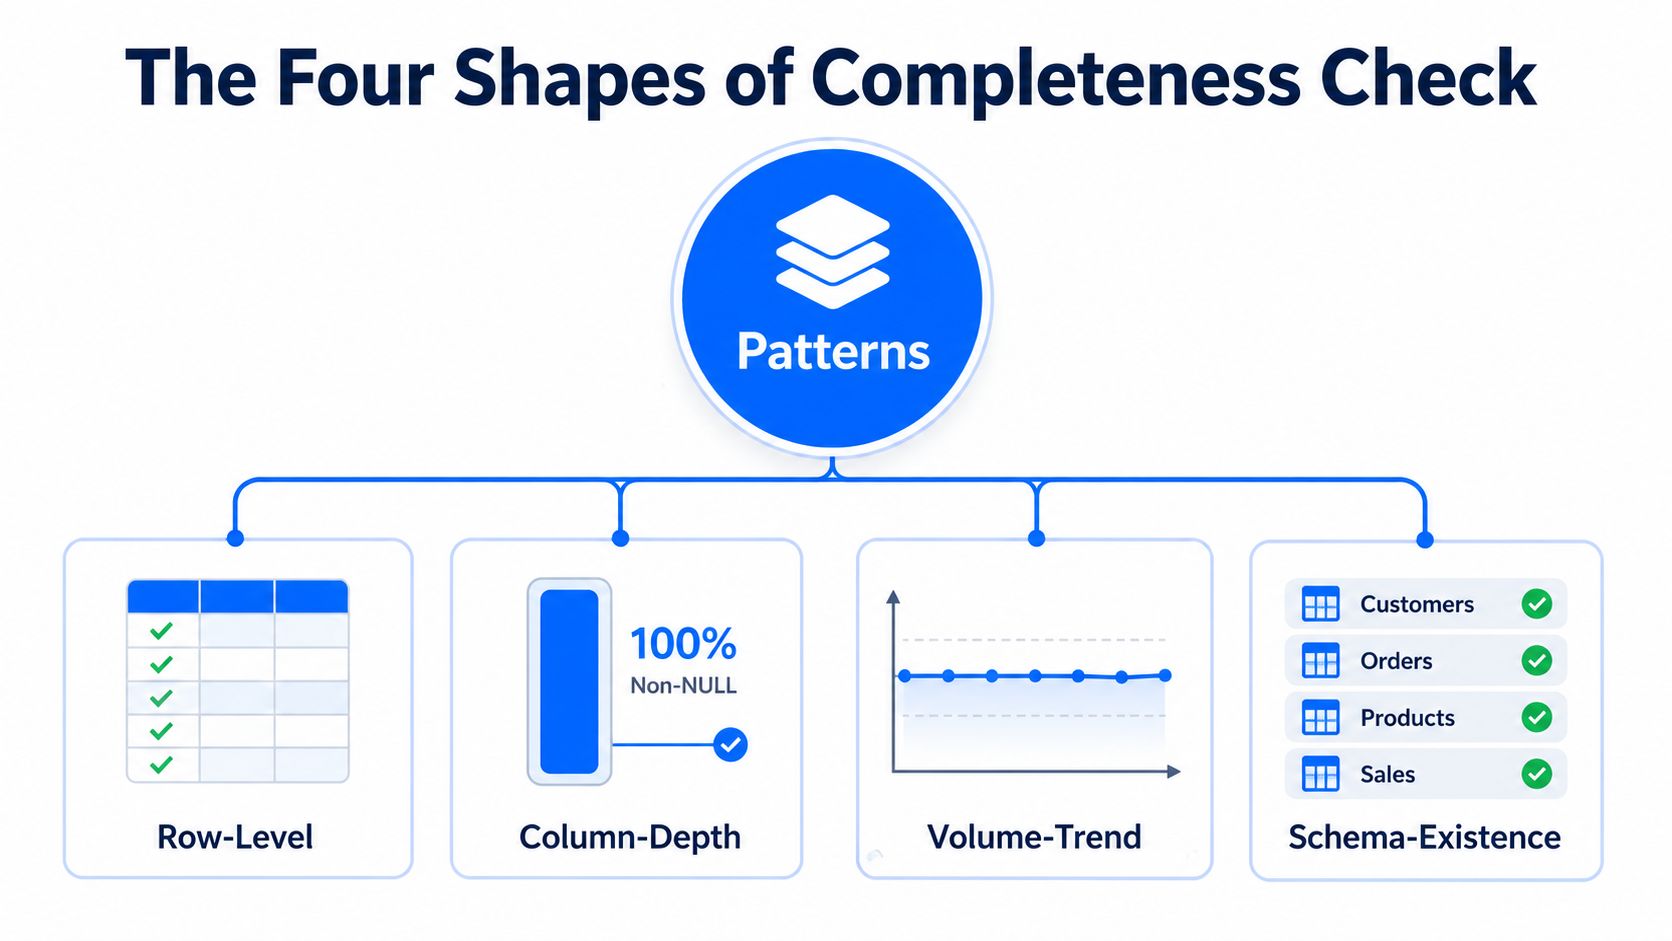
Le quattro forme di controllo di completezza che eseguirete
Un controllo di completezza dovrebbe corrispondere al problema che volete intercettare. Un modello retail con una riga attesa per negozio richiede un controllo diverso da una dimensione clienti con attributi obbligatori, ed entrambi sono diversi da un batch giornaliero mai arrivato. L'errore è trattare un unico pattern come se coprisse ogni lacuna.
Controlli su righe, colonne, batch e relazioni
I controlli a livello di riga verificano che ogni entità attesa sia presente. Se la sorgente indica che deve esserci un record per ogni cliente attivo, il warehouse dovrebbe contenere l'intera popolazione, non un'approssimazione. Questo pattern intercetta la perdita silenziosa di righe e il troncamento dei caricamenti, ma non vi dirà se un campo all'interno di ciascuna riga è vuoto.
I controlli a livello di colonna verificano che gli attributi obbligatori siano popolati. Se in una tabella dei fatti manca customer_id o order_date, la riga può comunque esistere mentre il modello a valle diventa inaffidabile. Questo pattern è efficace per i campi obbligatori, meno per le perdite tra origine e destinazione.
I controlli incrementali o a livello di partizione confrontano un batch con il delta atteso. Sono utili per file giornalieri, stream orari o tabelle partizionate in cui il rischio maggiore è una porzione mancante. Un controllo di partizione intercetta un file saltato, ma non rileverà che una colonna all'interno del file è stata corrotta.
I controlli referenziali confermano che le chiavi esterne si risolvono ancora. Una riga dei fatti con un customer_id che non esiste più nella dimensione è completa nel senso stretto del conteggio delle righe, ma incompleta in senso relazionale. I team di CDC e di warehouse lo scoprono spesso dopo una modifica di schema o un batch di dimensione arrivato in ritardo.
La prospettiva della CDC e dell'osservabilità è importante perché i problemi di completezza si sovrappongono di solito ad altri tipi di guasto. La distinzione di Monte Carlo tra completezza a livello di attributo e a livello di record è utile perché separa le lacune nelle colonne da quelle nelle righe (panoramica di Monte Carlo sulla completezza). Altrettanto pratica è la visione origine-destinazione di Adverity, che tratta la completezza come la verifica che tutti i dati previsti siano passati dall'origine alla destinazione (controllo di completezza di Adverity). Per i team che hanno bisogno di un confronto concreto tra origine e destinazione, la riconciliazione dei dati nel warehouse dà a quel controllo una forma operativa diretta.
Un warehouse può essere incompleto per l'analisi e comunque abbastanza completo per la reportistica di controllo. Ciò rende la completezza una decisione di idoneità all'uso legata alla tempestività e alla copertura degli SLA. Un caricamento in ritardo può fare più danni di uno scarno arrivato in tempo, perché i job a valle potrebbero aver già mancato la loro finestra.
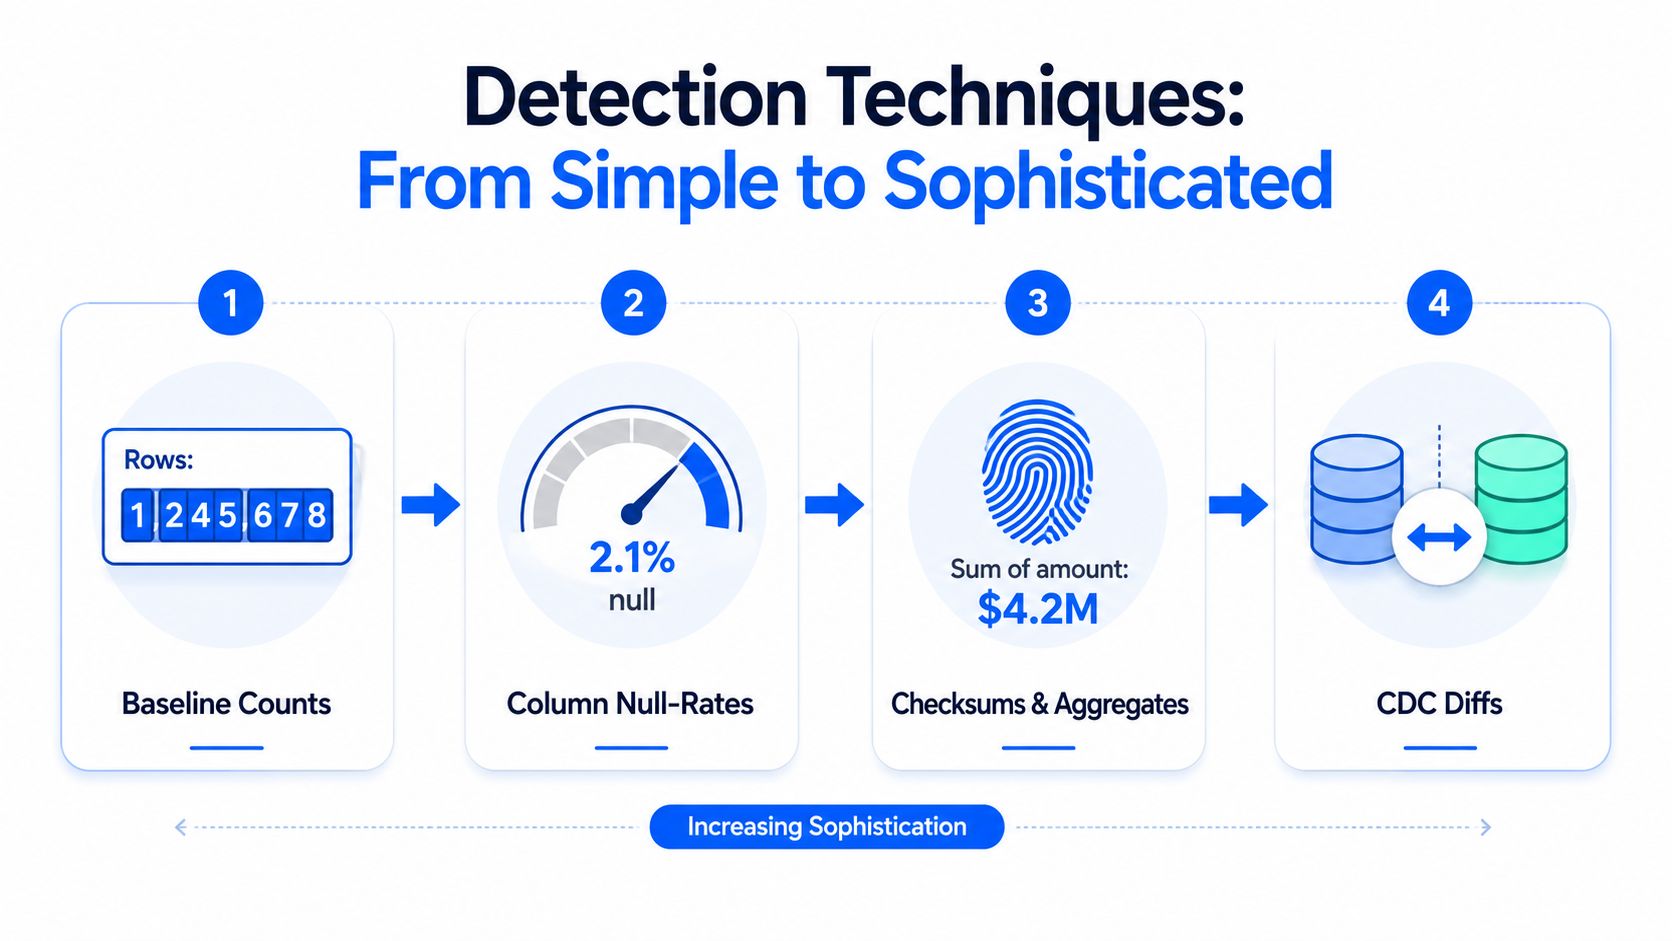
Tecniche di rilevamento: dai semplici conteggi ai diff CDC
Per iniziare non serve un framework enorme. I team partono dal conteggio delle righe e dai tassi di null, poi aggiungono controlli più rigorosi man mano che i dati diventano più preziosi o più fragili. L'obiettivo è sovrapporre le tecniche in modo che ciascuna intercetti una diversa classe di errori.
Partire dalla baseline
Un controllo di baseline è di solito la prima linea di difesa.
Questi controlli sono economici, facili da spiegare e facili da automatizzare. Intercettano le perdite evidenti di record e i campi palesemente mancanti, ed è per questo che vale la pena eseguirli anche nei warehouse più maturi.
Aggiungere aggregati, watermark e diff
Quando il conteggio delle righe è troppo grossolano, aggiungete aggregati e checksum.
Questo pattern intercetta le situazioni in cui il numero di righe sembra corretto ma il contenuto è cambiato durante il trasferimento. Per i modelli incrementali, un watermark è spesso il segnale più eloquente.
Se il watermark smette di avanzare, la pipeline è bloccata anche se i conteggi di ieri sembrano ancora normali. Per i sistemi sorgente che emettono eventi di modifica, i diff CDC sono più efficaci, perché confrontate ciò che è arrivato nel warehouse con ciò che la sorgente ha emesso.
Un utile riferimento interno per questo pattern origine-destinazione è l'articolo sul significato della riconciliazione, perché completezza e riconciliazione sono spesso sorelle sul piano operativo.
Anche la tempestività fa parte di questo insieme. Un dataset può essere strutturalmente presente ma comunque incompleto per una decisione operativa se arriva dopo la finestra dello SLA. Ecco perché i dati in ritardo non vanno trattati come una nota a margine. Spesso sono la stessa classe di guasto con una maschera diversa.
Se il business ha bisogno dei dati entro le 8 del mattino, una tabella perfettamente popolata alle 11 è comunque incompleta per la decisione che doveva supportare.
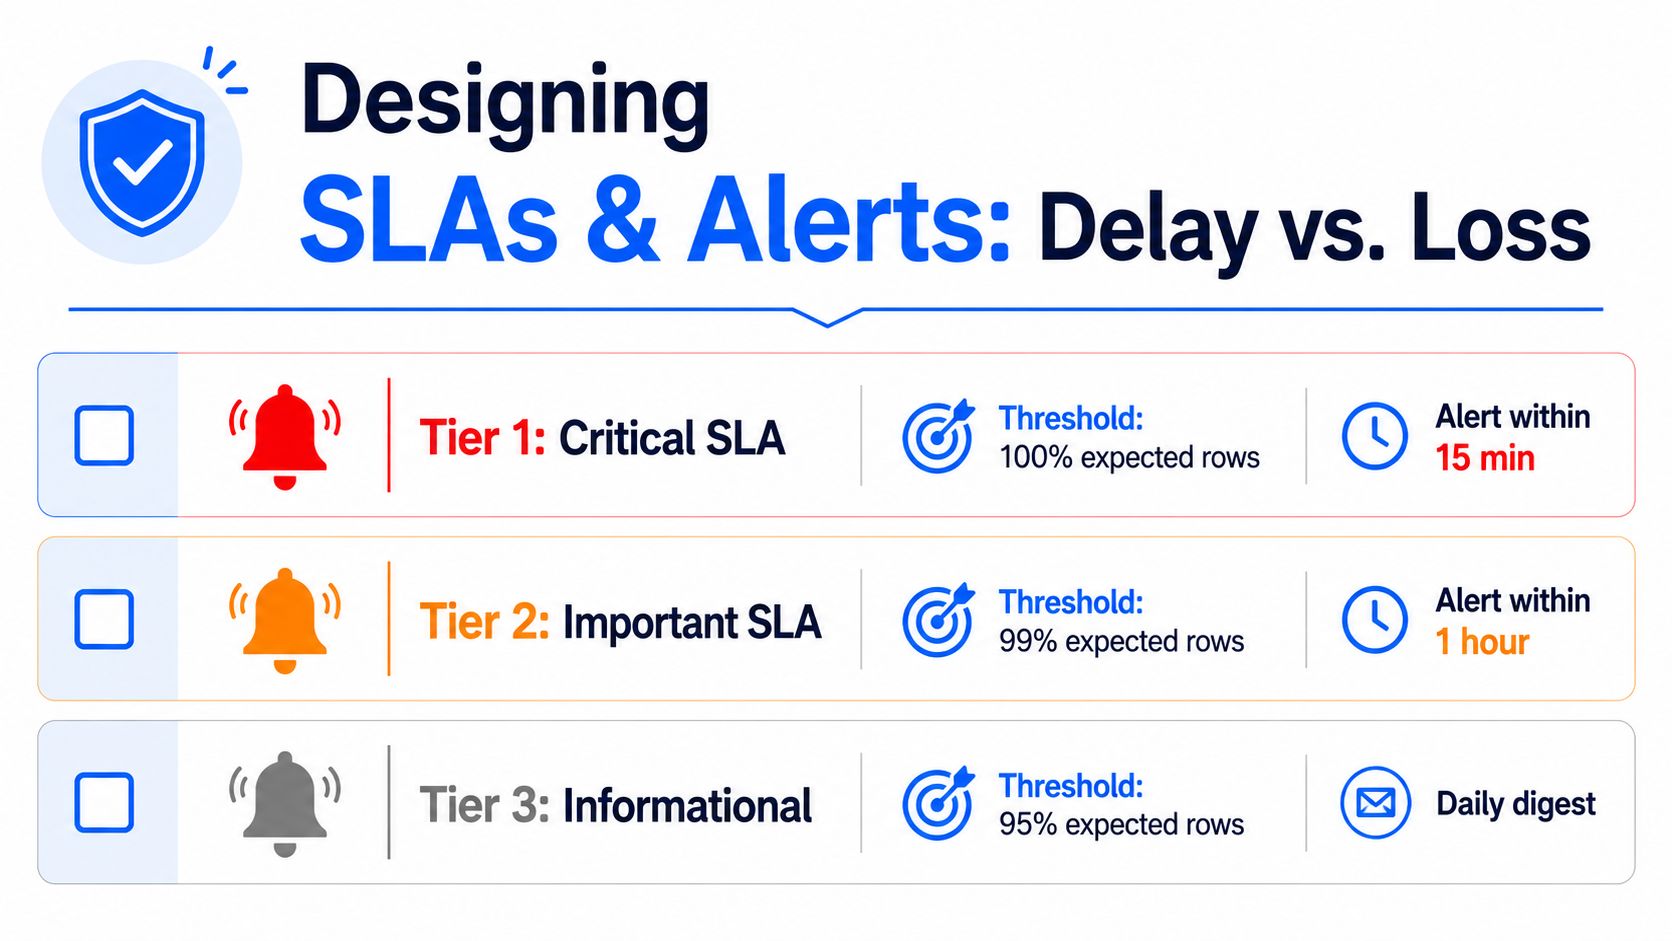
Progettare SLA e alert che distinguano il ritardo dalla perdita
Un warehouse può essere pieno e mancare comunque la sua scadenza. Un batch arriva, il conteggio delle righe sembra sano e il dashboard resta verde, ma il team di business aveva bisogno di quella tabella prima della scadenza del mattino. La progettazione degli SLA deve separare il ritardo dalla perdita prima che un alert arrivi al reperibile, perché questi due guasti richiedono risposte diverse.
La suddivisione in livelli offre un modo pratico per farlo. Il Livello 1 dovrebbe coprire i campi che guidano decisioni importanti, dove i valori mancanti significano che i dati non sono idonei all'uso. Il Livello 2 funziona per le colonne operative in cui una piccola lacuna conta, ma non sempre giustifica una chiamata immediata. Il Livello 3 è adatto ai campi di arricchimento, che è meglio monitorare per la deriva anziché fare escalation a ogni cambiamento. L'approccio a schede di lavoro dei CDC si adatta bene a questo schema, perché parte dagli elementi minimi e fondamentali più importanti per il caso d'uso e si estende ai campi aggiuntivi solo quando influiscono sulla decisione (scheda dei CDC sulla qualità dei dati).
Le baseline devono provenire dalla sorgente stessa. Un calo del volume di eventi può essere normale per un feed e un problema reale per un altro, quindi una soglia valida per l'intero warehouse di solito nasconde più di quanto riveli. Un file notturno stabile da mesi richiede un'aspettativa più rigorosa di un'API che oscilla naturalmente con l'attività degli utenti. Le linee guida del governo scozzese esprimono lo stesso concetto con altre parole: gli analisti dovrebbero confrontare un cambiamento con i pattern precedenti e altri punti di riferimento prima di considerarlo reale (linee guida del governo scozzese sulla qualità statistica).
Un semplice modello di instradamento mantiene la risposta allineata all'impatto sul business.
Tabelle critiche: chiamate subito il responsabile di turno.
Tabelle operative: inviate un alert al canale dati e aprite un ticket.
Tabelle di arricchimento: inviate un riepilogo e analizzate la tendenza nella riunione settimanale di governance.
Conta anche il modello di esecuzione. Se i controlli vengono eseguiti nel database del cliente, il team può confrontare freschezza, schema drift e completezza a livello di record con la stessa fonte di verità, invece di mettere insieme job e dashboard separati. digna offre proprio questo tipo di osservabilità nel database, combinando baseline storiche con validazione e monitoraggio in un'unica interfaccia (panoramica sull'osservabilità di digna). Questa configurazione cambia il quadro operativo, perché un feed in ritardo, una partizione mancante e una vera rottura dello schema possono essere valutati nello stesso posto prima di decidere se chiamare il reperibile, aprire un ticket o attendere.
Indagare e correggere un controllo di completezza fallito
Una tabella dei fatti degli ordini può superare il conteggio delle righe e fallire comunque dove conta. Ho visto questo schema con particolare chiarezza quando la tabella aveva tutte le righe, ma un controllo referenziale sulla dimensione clienti ha iniziato a fallire dopo che un batch arrivato in ritardo aveva aggiornato alcune chiavi. A prima vista i numeri sembravano corretti, ma il join non era più affidabile.
La prima mossa è delimitare il perimetro. Verificate quali partizioni hanno fallito, quali sorgenti a monte le hanno alimentate e se il problema è limitato a un solo giorno o distribuito su una finestra più ampia. Poi confrontate gli orari di arrivo con il pattern di consegna atteso, perché un batch mancante o in ritardo spiega spesso il sintomo più rapidamente di un'analisi approfondita dello schema.
La seconda mossa è separare le lacune transitorie da quelle strutturali. Una lacuna transitoria si presenta come una consegna in ritardo, un ritardo nel backfill o un'interruzione a monte. Una lacuna strutturale indica di solito una modifica di schema, un valore predefinito rotto, un problema di instradamento o una regola di trasformazione che non corrisponde più alla sorgente.
In un incidente, la causa radice era una modifica di schema che aveva introdotto un nuovo codice di stato senza un percorso di gestione predefinito. La correzione non era semplicemente “rieseguire il job”. Il team ha dovuto decidere se fare il backfill dai log CDC, accettare la lacuna con un'eccezione documentata o bloccare i consumatori a valle finché la dimensione clienti non fosse tornata coerente. La risposta giusta dipende dal fatto che la decisione a valle possa tollerare dati parziali.
Un semplice flusso di triage aiuta:
Confermate la forma del guasto. Si tratta di perdita di righe, di campi o referenziale?
Verificate la tempistica a monte. La sorgente è arrivata in ritardo o non è arrivata affatto?
Esaminate il comportamento storico. È insolito per questa sorgente o rientra nella normale variabilità?
Scegliete la correzione. Backfill, soppressione, blocco o documentazione.
Questo flusso è più rapido quando il vostro warehouse memorizza già lineage, freschezza e cronologia dei controlli in un modo che gli operatori possono consultare senza passare da uno strumento all'altro.
Come una piattaforma di osservabilità nel database cambia il quadro
Molti team eseguono ancora i controlli di completezza come SQL pianificato, consultano i risultati nella BI e instradano gli alert tramite chat. Funziona finché il numero di pipeline non cresce e i controlli iniziano a competere con il lavoro sul prodotto. Una piattaforma di osservabilità nel database cambia la forma operativa, perché viene eseguita dove i dati risiedono già e apprende dalle metriche storiche invece di costringere a calibrare a mano ogni controllo.
Questa distinzione conta per due motivi. Primo, i dati del cliente restano nel suo ambiente quando la piattaforma viene eseguita nel database, il che riduce lo spostamento dei dati e mantiene i record sensibili in configurazioni di cloud privato o on-premise. Secondo, la piattaforma può combinare in un unico posto i segnali di osservabilità, come rilevamento delle anomalie, tempestività e tracciamento dello schema, con le regole di validazione della qualità dei dati, invece di chiedere agli ingegneri di mettere insieme strumenti separati per ogni livello.
Il risultato pratico è uno stack di rilevamento più snello. Invece di decine di job pianificati, ottenete un insieme più compatto di ispezioni sempre attive che sorvegliano arrivi mancanti, schema drift e comportamenti inattesi rispetto alle baseline apprese. È la soluzione più adatta quando il warehouse è grande, le sorgenti sono volatili e il business ha bisogno di sapere rapidamente se una lacuna è un ritardo o una perdita reale.
Per i team che vogliono mantenere i controlli vicini ai dati, la panoramica della piattaforma digna mostra chiaramente il modello. Non sostituisce una buona progettazione del warehouse e non salverà un modello di ownership debole, ma riduce la distanza tra rilevamento, triage e risposta.
Una checklist di completezza in una settimana per le vostre pipeline
Partite da due elementi di dati critici per pipeline, quindi definite per ciascuno un controllo a livello di attributo e uno a livello di record. Questo evita il classico errore di monitorare tutti i campi allo stesso modo e perdere di vista quelli che fanno saltare i controlli.
Aggiungete poi un watermark o un diff CDC. Intercetta la perdita silenziosa di batch e i caricamenti incrementali bloccati, che il solo conteggio delle righe può non rilevare. Se la pipeline è basata su batch, confrontate gli orari di arrivo con la pianificazione attesa, così che un feed in ritardo non scateni la stessa risposta di uno mancante.
Dopodiché definite SLA a livelli. Assegnate soglie rigide e instradamento rapido alle tabelle più importanti, quindi mantenete i campi di arricchimento sotto monitoraggio delle tendenze, così da non chiamare le persone per semplice rumore.
Pianificate una revisione settimanale in cui gli operatori analizzano le anomalie, regolano le soglie e documentano le eccezioni. È in quel momento che la completezza diventa un controllo mantenuto anziché una regola una tantum.
Azione | Problema che previene | Implementazione minima |
|---|---|---|
Scegliere due elementi di dati critici | Campi mancanti che fanno saltare i controlli | Un controllo dei null per campo |
Aggiungere la completezza a livello di record | Righe caricate parzialmente | Controllo della presenza dei campi obbligatori |
Aggiungere watermark o diff CDC | Perdita silenziosa di righe | Confrontare il timestamp massimo o le chiavi CDC |
Definire SLA a livelli | Sovraccarico di alert | Instradare separatamente alert critici e informativi |
Revisione settimanale | Soglie obsolete | Breve riunione di revisione delle anomalie |
La completezza non è un numero da raggiungere, ma una decisione di idoneità all'uso che si prende e si rivede.
digna aiuta i team a eseguire controlli di completezza dei dati dove i dati risiedono già, abbinandoli al monitoraggio di anomalie, tempestività e schema in un unico ambiente controllato. Se volete rafforzare la fiducia nel warehouse senza disperdere i controlli tra script e dashboard, visitate digna e scoprite come l'osservabilità nel database può integrarsi nel vostro processo di revisione delle pipeline.
Per trasformare le regole di completezza sui campi obbligatori e a livello di record in controlli eseguiti dove i dati risiedono già, scoprite come digna Data Validation applica le regole all'interno del vostro database.
Domande frequenti
Che cos'è un controllo di completezza dei dati?
Un controllo di completezza dei dati verifica che i record giusti siano arrivati in tempo, nel posto giusto e con i campi di cui il business ha bisogno, non solo che le colonne siano prive di null. La metrica di base è Completezza = (Numero di valori non null / Numero totale di valori) x 100%, che rende i risultati confrontabili tra campi, tabelle e periodi.
Qual è la differenza tra completezza a livello di attributo e a livello di record?
La completezza a livello di attributo chiede se una specifica colonna è popolata, mentre quella a livello di record chiede se una riga contiene tutti i campi di cui il caso d'uso ha bisogno. Una colonna può sembrare a posto in media mentre alcune righe critiche restano inutilizzabili, ad esempio quando in una tabella degli ordini mancano customer_id, order_date o status.
Quali tipi di controlli di completezza dei dati dovrebbe eseguire un team dati?
Quattro forme coprono la maggior parte dei guasti. I controlli a livello di riga confermano che ogni entità attesa sia presente, quelli a livello di colonna che gli attributi obbligatori siano popolati, quelli a livello di partizione confrontano un batch con il delta atteso per intercettare file saltati e quelli referenziali confermano che chiavi esterne come customer_id si risolvano ancora nella dimensione.
Come si rileva la perdita silenziosa di righe nei caricamenti incrementali?
Usate un watermark o un diff CDC, perché il solo conteggio delle righe può non rilevarla. Interrogare max(updated_at) sulla tabella incrementale mostra se l'high-water mark continua ad avanzare; se si ferma, la pipeline è bloccata. Un diff CDC confronta gli eventi di origine e di destinazione per chiave primaria e tipo di operazione.
Come andrebbero instradati gli alert per i controlli di completezza falliti?
Instradateli per livello, così che ritardo e perdita ricevano risposte diverse. Il Livello 1 copre i campi che guidano decisioni importanti, il Livello 2 le colonne operative e il Livello 3 i campi di arricchimento. Per le tabelle critiche si chiama subito il responsabile di turno, per quelle operative si invia un alert al canale dati e si apre un ticket, mentre quelle di arricchimento finiscono in un riepilogo rivisto settimanalmente.


