Controlli di coerenza dei dati: guida completa per il 2026
|
7
min di lettura

Ieri la vostra dashboard sembrava perfetta. Oggi la finanza chiede perché i ricavi sembrano calati, le operations chiedono se un caricamento è fallito e i vostri analisti stanno già confrontando fogli di calcolo perché il data warehouse non concorda con il sistema di origine. In molti team questo tipo di panico non è causato da una logica di reporting errata, ma da una rottura della coerenza passata inosservata.
I controlli di coerenza dei dati sono i controlli che intercettano queste rotture prima che si propaghino a dashboard, previsioni e decisioni operative. Le linee guida ufficiali sulla qualità trattano la coerenza come una disciplina di controllo formale, non come una vaga best practice, con micro-controlli su ordini di grandezza, unità di misura e variazioni tra le risposte, e macro-controlli su additività, plausibilità, variazione temporale e confronto tra fonti (linee guida INSEE sui controlli di qualità dei dati). In pratica, il compito è semplice da descrivere e difficile da svolgere bene, perché le pipeline moderne spostano i dati tra data warehouse, servizi, repliche e livelli semantici che non sempre concordano nello stesso momento.
Ciò che conta è costruire controlli che riflettano il modo in cui i vostri dati si muovono. Una riga può essere sintatticamente valida e comunque non valida per il business. Una metrica può riconciliarsi a livello di tabella e comunque derivare per regione, periodo o segmento di clientela. Una pipeline può essere “verde” e produrre comunque risultati di cui nessuno si fida.
Indice
Perché dashboard affidabili all'improvviso si rompono
Una dashboard raramente crolla perché tutte le tabelle sono vuote. Di solito si rompe perché la pipeline continua a spostare record, ma quei record non descrivono più la stessa realtà di business. Una fonte dice che un cliente è attivo, un'altra che il conto ha cambiato segmento, una terza assegna ancora quel conto alla vecchia regione. Il report viene visualizzato senza errori, eppure la decisione costruita su di esso è già sbagliata.
Un esempio migliore è un registro retail che continua a ricevere ordini, rimborsi e aggiornamenti dei clienti dopo una modifica del sistema di origine. Il numero di righe sembra ancora sano, ma il significato dei campi è cambiato, così i ricavi appaiono stabili mentre le transazioni sottostanti non quadrano più. È esattamente la modalità di guasto che i controlli di coerenza devono intercettare. Non sono un controllo di formattazione dell'ultimo miglio: sono il controllo che vi dice se sistemi separati concordano ancora sugli stessi fatti.
Ecco perché la coerenza merita un posto a sé nella qualità dei dati. La disciplina copre sia la concordanza a livello di record sia il più ampio allineamento tra sistemi, inclusa la deriva che compare quando modifiche a monte alterano il significato dei campi o le relazioni. In pratica, significa verificare se sistemi di origine, data mart e livelli di reporting codificano ancora le stesse regole di business, non solo se un valore è presente o interpretabile. La distinzione è importante perché una pipeline può avere successo dal punto di vista tecnico e produrre comunque una dashboard fuorviante.
Il lavoro storico sui censimenti lo dimostra chiaramente. I controlli di coerenza sono stati usati nei dataset del censimento statunitense IPUMS per il 1850, il 1880 e il 1920 per far emergere errori di inserimento ed incongruenze di rilevazione, lo stesso problema operativo che i team affrontano quando i feed moderni iniziano a non concordare (documentazione IPUMS sulla coerenza dei censimenti).

Un errore comune è considerare la coerenza una questione che riguarda solo il data warehouse. Questa visione trascura i punti in cui di solito iniziano le rotture: servizi replicati, trasformazioni ETL, modelli semantici, consolidamenti finanziari e feature di AI le cui definizioni di origine cambiano nel tempo. Un campo può superare la validazione dello schema e rompere comunque la logica a valle perché il suo significato è cambiato, ed è lì che lo schema drift e le modifiche strutturali diventano un rischio operativo anziché un problema di documentazione.
Il modello mentale giusto è l'applicazione dei contratti lungo l'intero percorso dei dati. Quando i team applicano bene questo modello, smettono di chiedersi se la dashboard si è aggiornata e iniziano a chiedersi se i numeri concordano ancora con i sistemi che li hanno prodotti.
I cinque tipi di controlli di coerenza dei dati
I controlli di coerenza dei dati non sono un unico controllo. Sono un insieme di controlli, e ognuno intercetta un tipo diverso di contraddizione. I team che trattano tutto come una generica fase di validazione di solito mancano la vera modalità di guasto, perché un problema di formattazione, una relazione interrotta e un KPI che deriva richiedono regole, responsabili e percorsi di escalation diversi. Per i team che devono anche separare il lavoro di riconciliazione dagli altri controlli di qualità, la riconciliazione dei dati offre un utile confine operativo.
Coerenza sintattica
La coerenza sintattica verifica se i dati corrispondono alla struttura attesa: formato, tipo, valori ammessi e convenzioni di denominazione. Se un campo data contiene testo libero, o un campo codice usa valori con maiuscole e minuscole miste che un modello a valle non riesce a interpretare, il record può anche esistere, ma non è coerente dal punto di vista operativo.
Un esempio semplice è un campo CAP che deve rispettare il formato del paese a cui appartiene. Se lo stesso campo alterna stringhe numeriche e testo libero, il problema emerge prima ancora che venga eseguita qualsiasi regola di business.
Coerenza semantica
La coerenza semantica verifica se i valori hanno senso nel loro insieme, e qui la logica tra campi è fondamentale. Un record può essere sintatticamente corretto e comunque sbagliato se codici di entità, valute, mappature dei conti o date contraddicono la definizione di business. I team finance vi fanno affidamento perché i record correlati devono avere lo stesso significato tra sistemi, report, libri contabili, sottoconti, master data e output analitici.
Un esempio pratico è un record di ricavo con il tipo numerico giusto ma la valuta sbagliata per la regione. Quel record supererà un controllo di tipo di base e distorcerà comunque il reporting.
Coerenza referenziale
La coerenza referenziale verifica se i record correlati puntano gli uni agli altri. È il classico problema della relazione padre-figlio. La tabella orders può sembrare completa, ma se alcune righe d'ordine fanno riferimento a clienti mancanti, il livello di reporting genera fatti orfani e consolidamenti errati.
Regola pratica: se un record figlio può esistere senza un padre valido, vi serve un controllo referenziale da qualche parte nella pipeline.
Coerenza temporale
La coerenza temporale verifica se eventi, periodi e timestamp sono allineati. Una transazione non può essere registrata in un periodo di reporting non ancora aperto, e un aggregato a valle non dovrebbe dichiarare di includere dati arrivati dopo la scadenza. Il problema è la sequenza, non solo il valore.
Un esempio comune è un rinnovo di abbonamento che compare prima dell'evento di attivazione originale in un sistema che si aspetta dati di ciclo di vita ordinati. Questo tipo di discrepanza può distorcere il reporting sul ciclo di vita anche quando ogni riga, presa singolarmente, sembra valida.
Coerenza statistica
La coerenza statistica cerca valori compatibili con la popolazione circostante e con la baseline storica. Questo tipo di analisi fa emergere derive, outlier e distribuzioni anomale. Un dataset può essere strutturalmente valido e comunque statisticamente impossibile per il contesto di business, ed è per questo che i team spesso combinano regole deterministiche con rilevamento delle anomalie e monitoraggio della baseline. Atlan sulla coerenza dei dati e l'analisi di DataCamp sulla coerenza dei dati riflettono entrambi questa visione operativa più ampia, mentre i metodi di controllo statistico di processo sono utili quando serve una baseline formale per la variabilità.
Un esempio utile è una serie di KPI che cambia improvvisamente forma mentre lo schema di origine resta invariato. La pipeline può essere ancora sana, ma il segnale di business no.
Tipo di controllo | Scopo | Esempio |
|---|---|---|
Sintattico | Confermare formato, tipo e struttura ammessa | Un campo data deve rispettare il formato di data previsto |
Semantico | Confermare che i campi abbiano senso di business nel loro insieme | La valuta corrisponde alla regione e alla mappatura del conto |
Referenziale | Confermare che i record collegati esistano e siano allineati | Un ordine fa riferimento a un cliente reale |
Temporale | Confermare che tempistiche e sequenza siano valide | Una data di registrazione rientra nel periodo corretto |
Statistico | Confermare che i valori rispettino i pattern attesi | Un KPI si discosta dalla sua baseline normale |
La lezione pratica è semplice. I controlli sintattici intercettano forme errate, quelli semantici significati errati, quelli referenziali collegamenti interrotti, quelli temporali tempistiche errate e quelli statistici dati tecnicamente validi ma comunque sbagliati per il business.
Tecniche pratiche di implementazione e pattern SQL
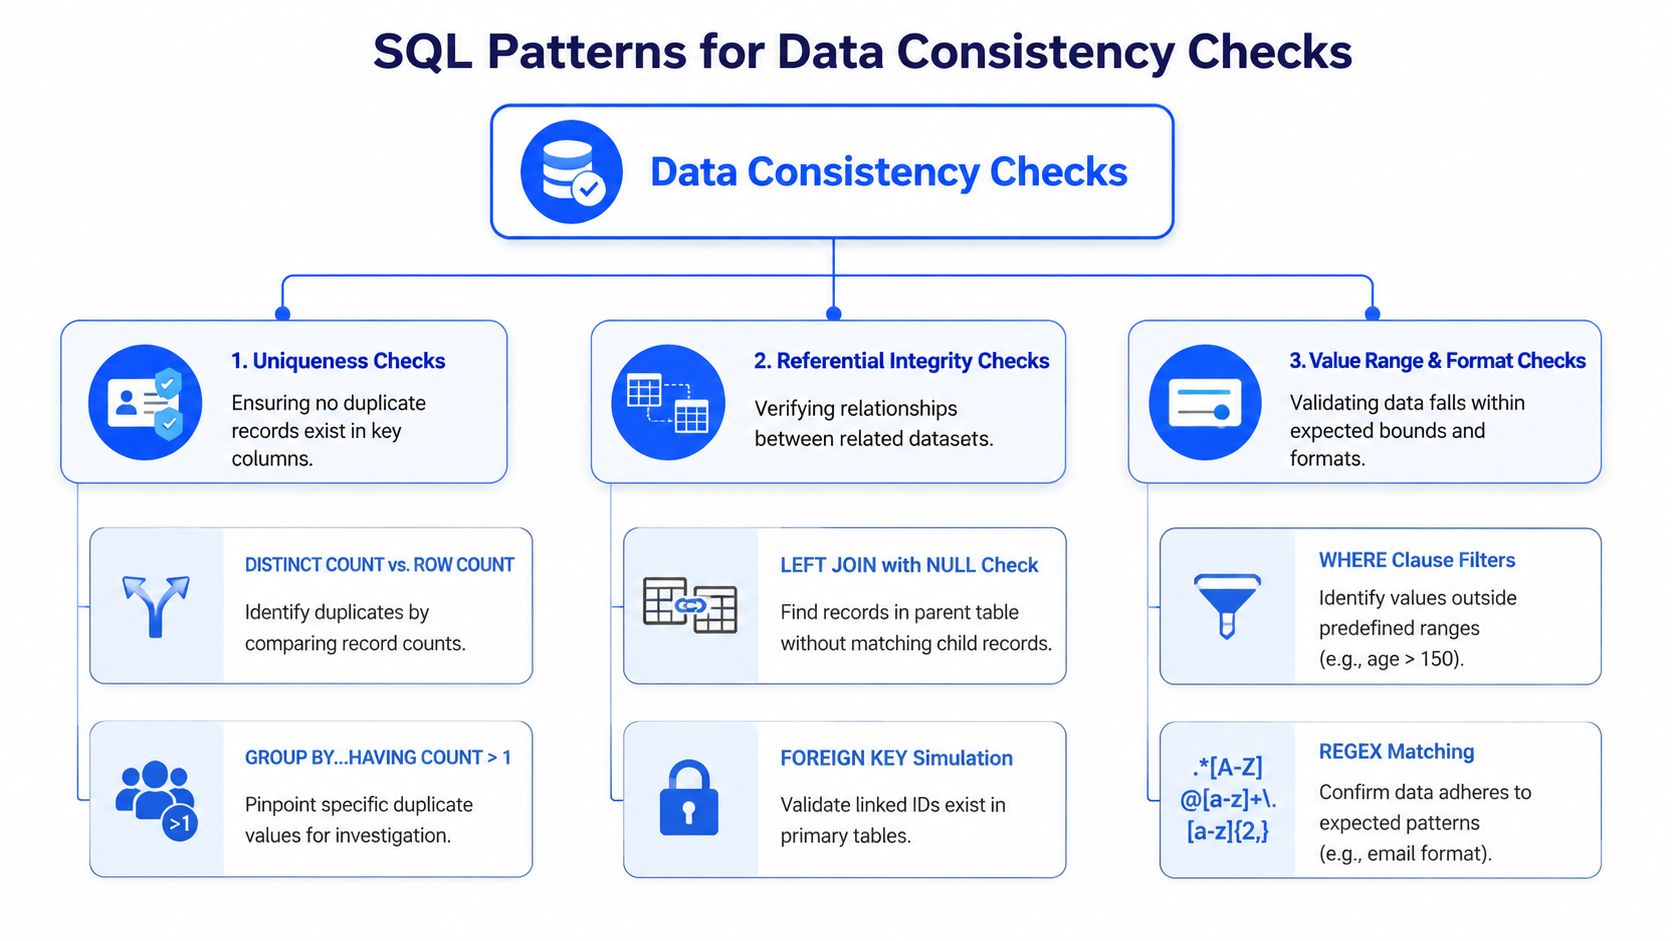
Il modo più rapido per rendere efficaci i controlli di coerenza è collocarli dove i dati già transitano. L'SQL resta il livello di applicazione più diretto, perché può confrontare righe, aggregati e relazioni senza aggiungere un altro sistema da mantenere. Uno stack di validazione pratico combina di solito vincoli del database, controlli di trasformazione e query di riconciliazione, per poi indirizzare i risultati verso un percorso di monitoraggio e reporting chiaro come il monitoraggio e reporting di digna.
Partire da conteggi, chiavi e valori nulli
Le prime query dovrebbero essere dirette. Conteggio dei record, rilevamento dei duplicati, controlli sui valori nulli e verifiche della presenza delle chiavi fanno emergere presto una quantità sorprendente di danni.
Sono query noiose, ed è proprio per questo che funzionano. I playbook di validazione che reggono in produzione partono di solito da corrispondenza del numero di record, controlli sui duplicati, controlli sui valori nulli, validazione dell'integrità referenziale e conformità alle regole di business come controlli fondamentali (metodi di validazione dei dati su LinkedIn). In una demo non fanno grande effetto, ma intercettano i guasti che generano confusione a valle.
Riconciliare tra sistemi, non solo all'interno delle tabelle
Una volta attivati i controlli di base, confrontate i dati di origine e di destinazione sia a livello di record sia a livello aggregato. Significa numero di righe, somme e totali raggruppati, non solo l'uguaglianza puntuale dei singoli campi.
Se questi totali divergono, il problema si trova di solito nella lineage, nella logica di trasformazione o in un disallineamento temporale tra sistemi. Nelle implementazioni in ambito finance, i controlli di coerenza si concentrano spesso sull'allineamento di conti, valute e centri di costo con i master data, e sulla corrispondenza tra date delle transazioni e periodi di reporting in libri contabili e report. Questo tipo di controllo è importante perché i team finance hanno bisogno che lo stesso numero abbia lo stesso significato ovunque, soprattutto in fase di chiusura e di revisione del reporting (KAPC sulla progettazione delle regole di coerenza).
Usare i vincoli per ciò che non deve mai accadere
Alcuni controlli appartengono al database stesso. I vincoli FOREIGN KEY e UNIQUE impediscono ai dati errati di arrivare dove possono fare danni. La logica applicativa aiuta comunque, ma non dovrebbe essere l'unica barriera.
Il pattern di progettazione consiste nel trattare i controlli di coerenza come un sistema a più livelli, non come una singola query. L'applicazione a livello di database, la validazione a livello applicativo e la validazione a livello di interfaccia utente intercettano ciascuna un percorso di guasto diverso, e i team che si affidano a un solo livello di solito scoprono le lacune a proprie spese. Le regole di coerenza funzionano meglio quando sono progettate come parte dell'intera pipeline, dall'inserimento al data warehouse fino al reporting (KAPC sulla progettazione delle regole di coerenza).
Non aspettate che il data warehouse sia l'unico filtro. Se potete, scartate i dati prima.
Strategie efficaci di monitoraggio e alerting
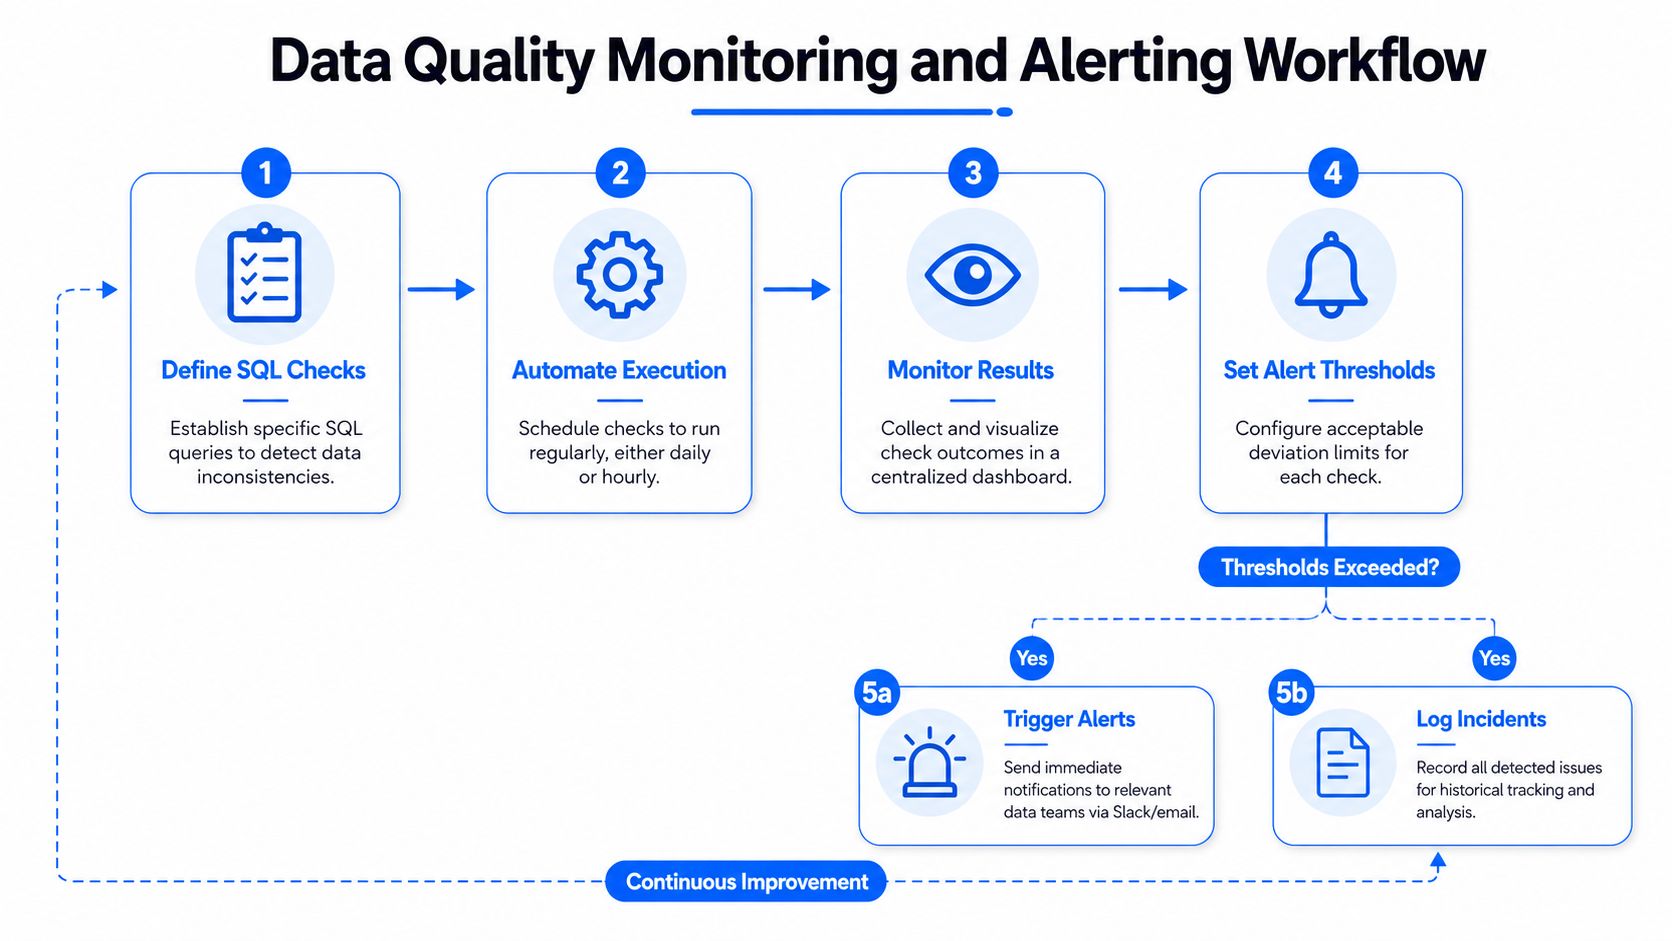
Un controllo che viene eseguito una volta e poi scompare è solo documentazione con un timestamp. I controlli di coerenza acquistano valore quando vengono eseguiti secondo una pianificazione, alimentano un livello di monitoraggio e indirizzano il segnale giusto al team giusto. Questo è particolarmente importante perché un caso di studio nelle ricerche di mercato riporta tassi di errore intorno al 15% prima dei controlli di coerenza sistematici e circa dal 3% al 5% dopo la loro applicazione, un chiaro promemoria del fatto che il controllo operativo cambia i risultati in una pipeline reale (NumberAnalytics sui controlli critici di coerenza dei dati).
Rendere gli alert azionabili
Non tutti i controlli falliti meritano la stessa risposta. Una foreign key critica mancante può giustificare il blocco di un caricamento, mentre una piccola deviazione dalla baseline può richiedere solo un'indagine. I team si mettono nei guai quando indirizzano ogni errore allo stesso canale, perché gli ingegneri smettono di fidarsi degli alert.
Un pattern pratico è classificare i controlli per gravità e impatto sul business, per poi definire la responsabilità prima ancora che l'alert scatti. Gli errori di riconciliazione su ricavi, identità dei clienti e reporting di compliance devono arrivare subito alle persone in grado di intervenire. Le derive meno gravi dovrebbero andare al responsabile dell'analytics o della qualità dei dati, con contesto sufficiente per un triage rapido.
Usare soglie che riflettono il sistema che gestite
Le soglie statiche sono facili da configurare e difficili da considerare affidabili. Una discrepanza di una sola riga nel conteggio può essere catastrofica in un registro regolamentato e irrilevante in un flusso di eventi che ha ancora un ritardo di propagazione. I sistemi distribuiti richiedono un approccio più attento, perché l'eventual consistency può creare divergenze temporanee che non sono veri guasti. Le indicazioni di fonti su sistemi distribuiti e qualità dei dati raccomandano di verificare invarianti contrattuali e una obsolescenza limitata, anziché l'uguaglianza esatta in ogni momento (Slack Engineering sui controlli di coerenza dei dati).
Ecco la sfida di progettazione. Vi servono soglie che distinguano un ritardo accettabile da una vera rottura dell'integrità.
Centralizzare i risultati e conservarne lo storico
Il monitoraggio funziona meglio quando ogni esecuzione viene registrata, confrontata nel tempo e collegata a un workflow di correzione. Un singolo controllo fallito è utile. Uno schema di errori ripetuti è ciò che vi aiuta a risolvere la causa a monte. Conservate insieme risultato, dataset interessato, responsabile, orario e versione della regola, così che le persone possano indagare senza dover ricostruire l'incidente a posteriori.
Per i team che costruiscono workflow di reporting formali, le pratiche di monitoraggio e reporting sulla qualità dei dati sono un utile riferimento per trasformare i controlli in evidenze operative.
Modernizzare i controlli con una piattaforma di data observability
Una pipeline in crescita non si guasta in un unico punto evidente. Si comincia con controlli SQL manuali che perdono la sincronizzazione, poi ci si disperde tra notebook, modelli dbt e script ad hoc finché nessuno sa più quale regola sia quella di riferimento. Le piattaforme di data observability aiutano perché riuniscono validazione deterministica, monitoraggio statistico e storico operativo in un unico piano di controllo.
Usare regole deterministiche per la logica di business nota
Alcuni controlli devono restare espliciti. Se la valuta di un cliente deve corrispondere alla regione, se una foreign key deve esistere nella sorgente referenziata o se un valore derivato deve rispettare una regola di calcolo, deve essere un validatore basato su regole a farlo rispettare. È il ruolo di un modulo Data Validation in una piattaforma come digna, che viene eseguito nell'ambiente del cliente e può supportare controlli delle regole di business a livello di record, validazione referenziale e controlli di coerenza tra colonne.
Il valore sta nella coerenza dell'applicazione. Una volta che le regole risiedono in un unico luogo, i team smettono di riscriverle in SQL ad hoc tra modelli dbt, notebook e script operativi, e la stessa logica viene applicata ogni volta allo stesso modo.
Aggiungere il rilevamento delle anomalie per le derive impreviste
I sistemi basati solo su regole non vedono le derive nuove. Una tabella può ancora soddisfare ogni controllo esplicito mentre la forma di business dei dati cambia in un modo che nessuno si aspettava. Un programma di coerenza pratico combina la validazione deterministica con il rilevamento statistico delle anomalie e l'analisi della baseline storica. Atlan sulla coerenza dei dati descrive questo schema più ampio, ed è la direzione giusta per i team che devono intercettare sia i guasti noti sia i comportamenti che cambiano.
Un approccio basato su piattaforma aiuta perché confronta il comportamento attuale con quello appreso, senza costringere ogni nuovo segnale in una regola costruita a mano. Nel modello di digna questo corrisponde naturalmente a Data Anomalies per l'apprendimento della baseline e il rilevamento continuo delle anomalie, oltre a Data Analytics per l'analisi storica delle metriche di observability. Questa combinazione è importante quando dovete tenere ferme le regole di business rigide continuando a sorvegliare spostamenti lenti che nessun validatore segnalerebbe da solo.
Riunire schema e tempestività nello stesso piano di controllo
Le modifiche dello schema e le consegne in ritardo minano entrambe la fiducia, anche se falliscono in modo diverso. La ridenominazione di una colonna può invalidare un join a valle, mentre i record arrivati in ritardo possono far sembrare corretta una dashboard nel momento sbagliato. Un buon livello di observability affianca alla validazione della coerenza un monitoraggio strutturale in stile Schema Tracker e un monitoraggio della Timeliness, così che gli ingegneri possano capire se il problema deriva da un cambiamento di forma, da una pipeline lenta o dalla violazione di una regola di business.
L'obiettivo operativo è chiaro. Usate controlli deterministici per le regole che non devono mai variare, metodi statistici per le derive che nessuno ha ancora codificato, e mantenete i risultati visibili ai team che devono intervenire. È la differenza tra controlli sparsi e un programma di qualità dei dati capace di tenere il passo della pipeline.
Se il vostro team ha bisogno di persone in grado di lavorare sia sui meccanismi delle pipeline sia sulle definizioni di business, potete anche reclutare professionisti della Data Quality con il giusto mix di esperienza in ingegneria, analytics e governance.
Costruire una cultura proattiva della qualità dei dati
I controlli di coerenza dei dati funzionano meglio quando vengono trattati come infrastruttura di prodotto, non come attività di pulizia. Significa responsabilità chiare, regole esplicite, monitoraggio continuo e la consapevolezza condivisa che la fiducia nei dati è qualcosa che l'organizzazione mantiene, non qualcosa che dà per scontato. I team più solidi combinano controlli strutturali, riconciliazione tra sistemi, validazione delle regole di business e monitoraggio statistico in una difesa a più livelli.
Se state formando il team per un programma di questo tipo, è utile reclutare professionisti della Data Quality che comprendano sia i meccanismi delle pipeline sia le definizioni di business. Il mix di competenze conta, perché un buon controllo della coerenza si colloca all'incrocio tra ingegneria, analytics e governance.
In definitiva, il vantaggio sono decisioni più semplici. Gli analisti smettono di dubitare delle dashboard, i leader di business smettono di chiedersi se i numeri siano reali e i team dati passano meno tempo a spegnere incendi causati da presupposti errati. I controlli di coerenza non proteggono solo i dati, proteggono il ritmo dell'intera organizzazione.
digna offre ai team un modo pratico per monitorare i controlli di coerenza dei dati, validare le regole di business, tracciare le modifiche dello schema e intercettare le derive prima che raggiungano dashboard o modelli. Se cercate una piattaforma che combini validazione, rilevamento delle anomalie, monitoraggio della tempestività ed esecuzione nel database, visitate digna e vedete come si inserisce nel vostro stack di qualità dei dati.
Domande frequenti
Che cosa intercettano i controlli di coerenza dei dati?
Le rotture tra sistemi, prima che si propaghino a dashboard, previsioni e decisioni operative. Una dashboard raramente crolla perché tutte le tabelle sono vuote; è fuorviante perché due feed che dovrebbero concordare hanno smesso silenziosamente di farlo.
Come si presenta un tipico problema di coerenza?
Un registro retail che continua a ricevere ordini, rimborsi e aggiornamenti dei clienti dopo una modifica del sistema di origine. Non smette di arrivare nulla, quindi i controlli su volumi e aggiornamento restano verdi mentre il significato dei record è cambiato sotto la superficie.
Come andrebbero progettati i controlli?
In base al modo in cui i vostri dati si muovono davvero, non in base a un elenco generico. Un controllo che non rispecchia un reale passaggio di consegne tra sistemi tende a risultare superato proprio durante l'incidente che avrebbe dovuto intercettare.
È un problema nuovo?
No. Il lavoro storico sui censimenti lo dimostra: i dataset IPUMS per il 1850, il 1880 e il 1920 sono stati usati per far emergere errori di inserimento e incongruenze di rilevazione, lo stesso problema operativo che i team affrontano quando i feed moderni iniziano a non concordare.
Perché la coerenza merita una dimensione a sé?
Perché le altre dimensioni non riescono a vederla. Un record può essere completo, valido, tempestivo e accurato all'interno del proprio sistema e contraddire comunque la stessa entità registrata altrove, e solo un confronto tra sistemi lo rivela.


