Raggiungere la compliance alla sovranità dei dati nel 2026
|
6
min di lettura

Molti team pensano di essere al sicuro perché i dati dei clienti risiedono a Francoforte, Parigi o Dublino. Poi arriva un ticket di assistenza, un engineer al di fuori della giurisdizione apre una sessione di console e il problema di compliance inizia senza che una sola riga sia stata copiata in un'altra regione di storage.
È questa la trappola. La compliance alla sovranità dei dati non riguarda solo il luogo in cui i dati sono archiviati. Riguarda quale regime giuridico governa quei dati, come vengono elaborati e chi può accedervi durante le operations, l'assistenza, la risposta agli incidenti e la manutenzione da parte dei fornitori. Per le aziende europee regolamentate, questa distinzione conta ogni giorno.
Il rischio pratico è semplice. Potete soddisfare un requisito di residenza dei dati e fallire comunque sulla sovranità. Se la vostra architettura consente accessi amministrativi dall'estero, failover non controllati o elaborazioni transfrontaliere non documentate, la vostra postura di compliance è più debole di quanto suggerisca il diagramma delle regioni cloud.
Indice
Introduzione
Una modalità di guasto comune sembra innocua in superficie. I dati sensibili dei clienti restano archiviati in una regione UE, ma un engineer dell'assistenza al di fuori di quella giurisdizione vi accede per risolvere un problema. Lo storage è rimasto locale. La sovranità no.
Ecco perché i team hanno bisogno di una definizione più rigorosa. La sovranità dei dati impone che i dati raccolti in un determinato Paese restino soggetti al quadro giuridico di quel Paese indipendentemente da dove vengono fisicamente archiviati o elaborati, garantendo l'autorità giurisdizionale sulle condizioni di utilizzo, accesso e trasferimento dei dati. Questa impostazione è importante perché sposta la discussione dalla collocazione dell'infrastruttura al controllo giuridico, all'accesso amministrativo e all'applicazione tecnica, come illustrato in questa prospettiva 2026 su compliance cloud e sovranità.
Per gli engineer, questo cambia l'obiettivo di progettazione. Il compito non è solo mantenere i dati nella regione. Il compito è costruire sistemi in cui l'accesso illecito da altre giurisdizioni sia bloccato dall'architettura, reso visibile dal monitoraggio e governato da controlli operativi ripetibili.
Cosa significa davvero sovranità dei dati
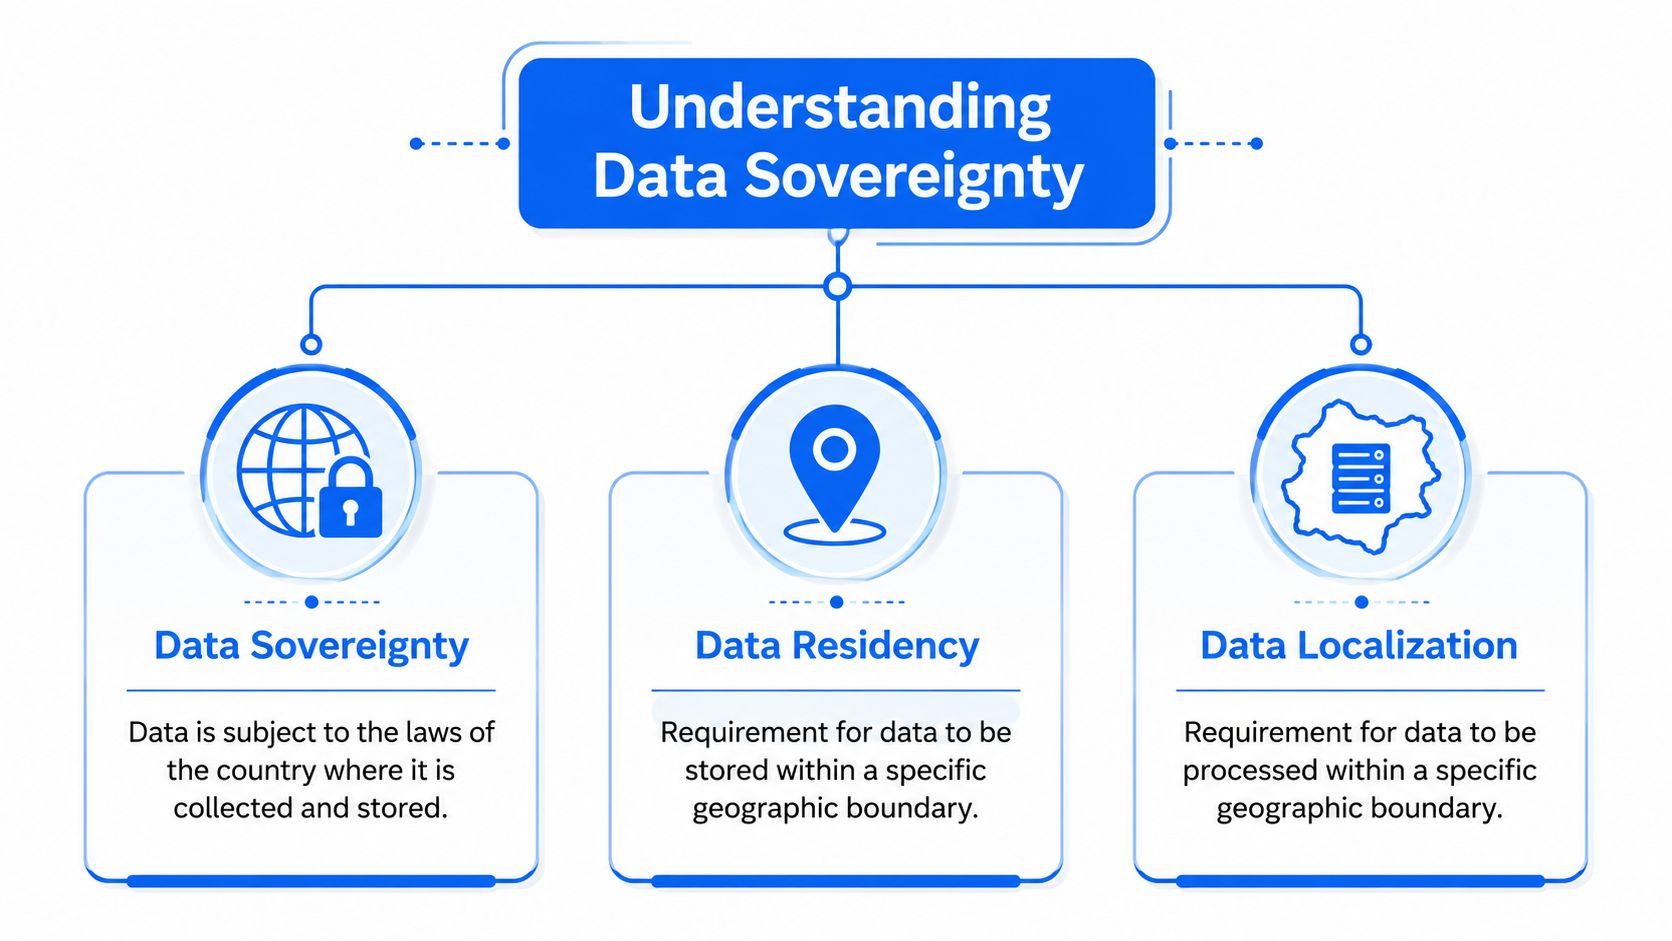
I team confondono spesso sovranità, residenza, privacy e localizzazione dei dati. Questa confusione porta a decisioni architetturali sbagliate, perché ciascun termine risponde a una domanda diversa.
La cassaforte, le regole e la legge che sta sopra entrambe
Una semplice analogia aiuta.
La residenza dei dati è il luogo in cui si trova la cassaforte. La cassaforte è in Germania, quindi i dati sono archiviati entro un confine tedesco.
La localizzazione dei dati è più restrittiva. Significa che la cassaforte non può essere aperta e gestita altrove per l'elaborazione. Sia lo storage sia l'elaborazione devono restare all'interno dell'area geografica definita.
La privacy dei dati sono le regole per usare ciò che c'è nella cassaforte: chi ha una base giuridica per accedervi, quali diritti ha la persona a cui i dati si riferiscono e quali obblighi si applicano alla raccolta e all'utilizzo.
La sovranità dei dati sta al di sopra di tutto questo. È l'autorità giuridica che governa la cassaforte, il suo contenuto e l'accesso a essa. Se la legge stabilisce che l'accesso da un'altra giurisdizione crea un'esposizione, il solo storage locale non risolve il problema.
Regola pratica: se il vostro design di compliance inizia e finisce con la scelta della regione cloud, avete progettato per la residenza, non per la sovranità.
Questa distinzione è importante perché molti diagrammi cloud si fermano alla posizione. Non mostrano chi detiene i privilegi di amministratore, dove si trova il personale di assistenza, dove vengono gestite le chiavi o dove si estende l'elaborazione durante il ripristino.
Perché la sola residenza dei dati fallisce nella pratica
L'equivoco più comune è che un data center locale equivalga alla compliance. Non è così.
Un workload può essere ospitato nel Paese giusto ed essere comunque accessibile a un team di assistenza estero. Una pipeline può elaborare i dati nella regione e instradare comunque metadati, log o copie temporanee attraverso un'altra giurisdizione. Un piano di backup può mantenere conformi i dati primari e fallire comunque durante il disaster recovery, perché la regione secondaria è soggetta a un regime giuridico diverso.
Ecco il test che uso con i team di engineering:
Chiedete chi può amministrare la piattaforma: se l'assistenza globale del fornitore può ispezionare da remoto gli ambienti dei clienti, il rischio per la sovranità rimane.
Chiedete dove si trovano le chiavi: se il provider può decifrare i dati, le promesse contrattuali non sono il vostro controllo più forte.
Chiedete dove vengono eseguiti i job: la posizione dello storage conta poco se le trasformazioni sensibili vengono eseguite altrove.
Chiedete cosa succede in caso di guasto: la gestione delle interruzioni spesso rivela l'architettura che avete costruito, non quella che la vostra policy presuppone.
Un design sovrano non si basa sulle buone intenzioni. Si basa su limiti tecnici.
È anche per questo che i team privacy e i team di piattaforma devono collaborare. I programmi di privacy possono essere maturi e lasciare comunque una lacuna di sovranità se l'infrastruttura e i modelli di accesso dei fornitori non sono progettati per il controllo giurisdizionale.
Mappare il panorama globale della compliance
Uno schema di guasto comune è questo. Il workload viene distribuito a Francoforte, il contratto prevede hosting nell'UE e la revisione architetturale dà il via libera. Sei mesi dopo, un'escalation dell'assistenza consente a un amministratore al di fuori dell'UE di ispezionare il tenant, e l'ufficio legale si ritrova con un problema di trasferimento che il diagramma di deployment non aveva mai mostrato.
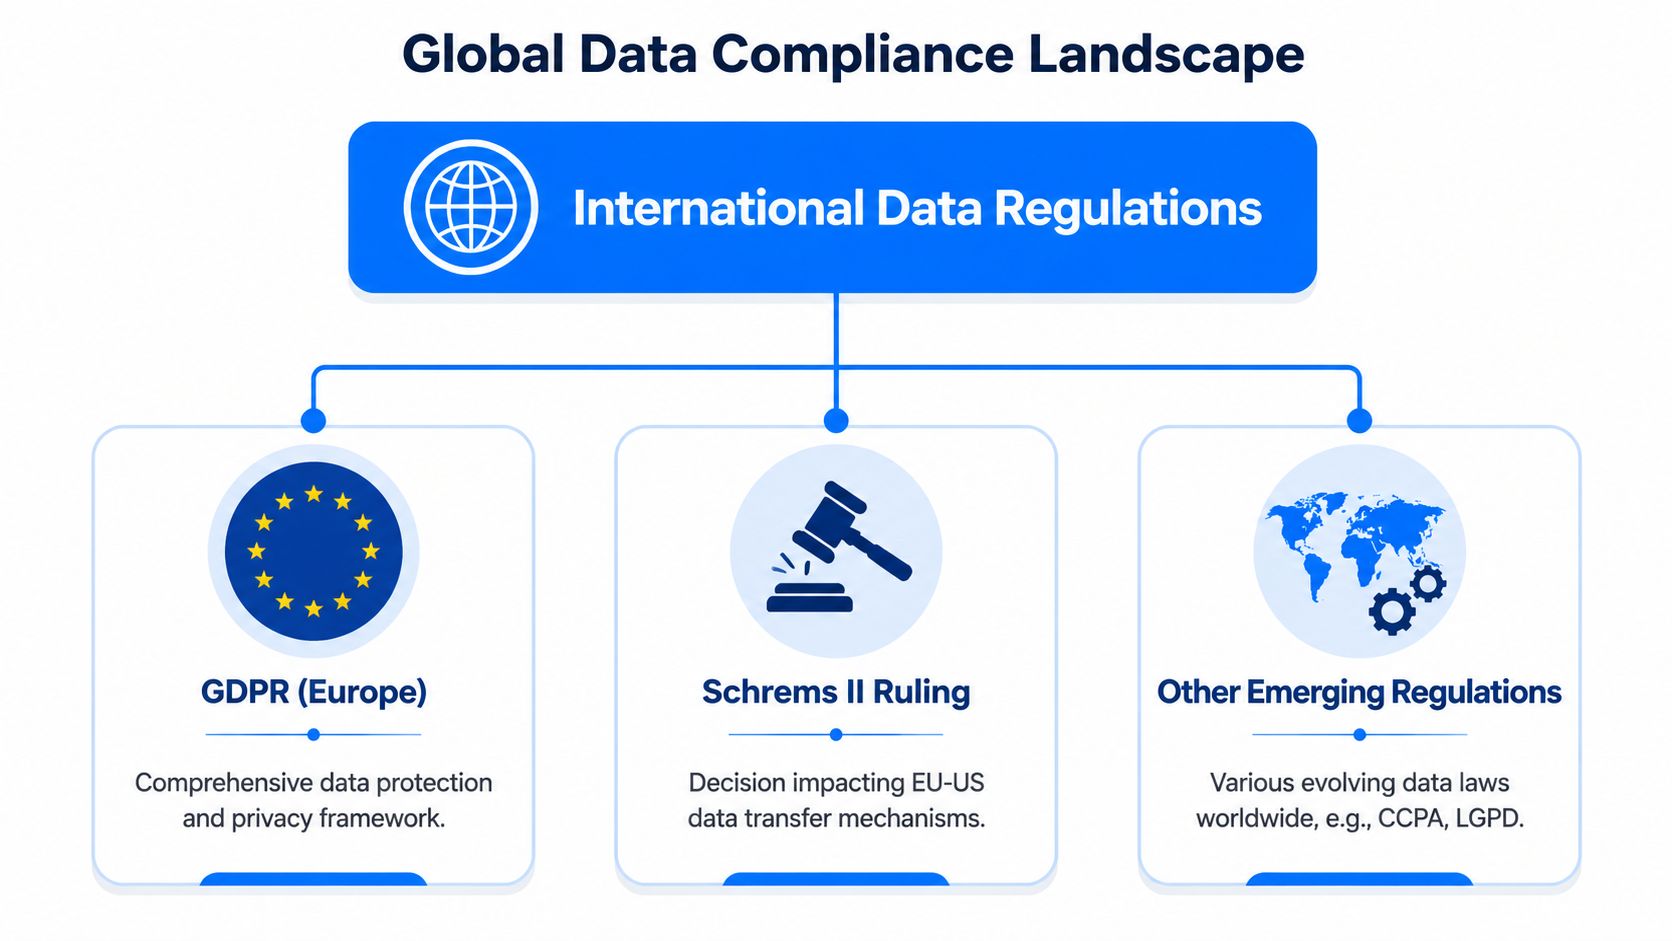
Ecco perché i team di engineering hanno bisogno di un modello operativo dei requisiti legali. Queste regole determinano la scelta delle regioni, il design dei backup, l'assistenza da remoto, la custodia delle chiavi e l'accesso operativo dei fornitori. E continuano a cambiare. Come osservato in questa panoramica delle normative globali sulla sovranità dei dati, molte giurisdizioni applicano oggi leggi sulla privacy e sulla protezione dei dati, e l'EU Data Act estende la discussione oltre i dati personali, ai dati non personali e industriali.
I tre modelli normativi che gli engineer incontrano davvero
Raggruppo i requisiti nazionali in tre pattern, perché portano a decisioni tecniche diverse.
Trasferimento transfrontaliero con condizioni
I dati possono spostarsi, ma solo con garanzie definite, come meccanismi di trasferimento approvati, valutazioni documentate e controlli che reggano nella pratica.Localizzazione per settori o dataset specifici
Alcuni record devono restare nel Paese. Dati sanitari, workload del settore pubblico, dati di pagamento e telemetria delle infrastrutture critiche rientrano spesso in questa categoria.Aspettativa di elaborazione nazionale
Storage, elaborazione, amministrazione e ripristino devono restare all'interno della giurisdizione, con eccezioni limitate.
L'errore è trattarle solo come regole sullo storage. Negli ambienti regolamentati, la domanda più difficile è spesso se un dipendente del provider in un altro Paese possa accedere al sistema per manutenzione, risposta agli incidenti o debugging.
Cosa è cambiato dopo Schrems II
Schrems II ha costretto i team a smettere di considerare le clausole di trasferimento come l'intera risposta. Conta il regime di accesso del Paese di destinazione, e conta anche il modello di assistenza del provider. Se le autorità straniere possono imporre l'accesso, o se il personale del fornitore al di fuori della giurisdizione approvata può raggiungere i sistemi in produzione, un'architettura apparentemente conforme può comunque non superare la revisione.
Questo cambia il modo in cui revisione legale e design della piattaforma interagiscono. Un nuovo connettore SaaS, un servizio di database gestito o un workflow di ripristino tra regioni possono modificare l'esposizione dell'organizzazione anche quando l'archivio dati primario resta locale. Gli engineer non devono diventare avvocati. Devono però capire quali scelte di design creano un trasferimento, quali creano un rischio di accesso remoto e quali richiedono controlli compensativi.
Per i team che costruiscono questo processo di revisione, ho trovato utile confrontare le decisioni di policy interne con riferimenti esterni come le raccomandazioni di LegesGPT sugli strumenti legali, soprattutto quando le operations legali hanno bisogno di un monitoraggio migliore dei requisiti transfrontalieri in evoluzione.
I team hanno bisogno anche di una distinzione chiara tra sovranità e residenza. Questa guida alla residenza dei dati è una buona base, ma la residenza da sola non dice chi può amministrare la piattaforma, da dove partono le sessioni di assistenza o se il fornitore può decifrare i dati dei clienti.
Cosa devono ricavare i team di engineering dai requisiti legali
Le indicazioni pratiche sono chiare.
Lo spostamento dei dati va oltre la replica. Log, snapshot, pacchetti di supporto, telemetria e output temporanei di elaborazione possono tutti creare un'esposizione transfrontaliera.
L'accesso dei fornitori fa parte della superficie di controllo. Una piattaforma ospitata nella regione giusta può comunque violare i requisiti di sovranità se il personale di assistenza all'estero può raggiungere gli ambienti dei clienti.
Il design del ripristino è importante. Regioni secondarie, procedure di emergenza e strumenti di failover richiedono la stessa revisione giurisdizionale della produzione.
L'ambito si sta ampliando. Oggi anche i dati industriali e operativi sono sottoposti a un controllo più attento, non solo i dati personali dei clienti.
Se un'autorità di regolamentazione può interrompere le operazioni a causa di come un sistema viene amministrato o supportato, quel problema appartiene alla revisione architetturale e al design del servizio, non solo alla revisione dei contratti.
Progettare per una vera sovranità
Se la sovranità conta, deve emergere nel design del sistema. Non in un wiki delle policy. Non in una slide del fornitore. Nella meccanica concreta di dove gira il codice, dove si spostano i dati, chi detiene le chiavi e chi può gestire l'ambiente.
Partire dai confini del deployment
La prima decisione riguarda il modello di deployment. Questa scelta fissa il limite massimo di controllo giurisdizionale che potete realisticamente applicare.
Modello di deployment | Controllo sulla posizione dei dati | Controllo sulla posizione dell'elaborazione | Rischio di accesso del fornitore | Ideale per |
|---|---|---|---|---|
On-premises | Massimo | Massimo | Minimo quando l'accesso del fornitore è completamente limitato | Workload altamente regolamentati con requisiti rigorosi di controllo operativo |
Private cloud in un ambiente controllato dal cliente | Elevato | Elevato | Più basso se l'accesso amministrativo è limitato contrattualmente e tecnicamente | Aziende che hanno bisogno della flessibilità del cloud senza rinunciare ai controlli di sovranità |
Public cloud a regione singola | Da moderato a elevato a seconda della configurazione | Da moderato a elevato a seconda del design del servizio | Più alto, a meno che assistenza, controllo delle chiavi e confini amministrativi siano strettamente vincolati | Team in grado di progettare tenendo conto dei limiti della responsabilità condivisa |
Architettura regionale multi-cloud | Elevato per gli obiettivi di residenza | Variabile e facile da configurare in modo errato | Da medio ad alto se i percorsi di assistenza e interconnessione non sono governati in modo coerente | Organizzazioni che bilanciano resilienza e obblighi legati alla posizione |
SaaS gestito | Di solito il più debole | Di solito opaco per il cliente | Il più alto, a meno che il provider offra controlli rigorosi di assenza di accesso e assistenza locale | Casi d'uso a bassa sensibilità o funzioni con esposizione giurisdizionale limitata |
Per gli ambienti europei regolamentati, i pattern private cloud e on-premises rendono di solito il compromesso più chiaro. Perdete un po' di comodità, ma ottenete il controllo diretto sui percorsi dei dati, sui confini amministrativi e sulla raccolta delle prove.
Usare la crittografia come controllo giurisdizionale
Con il GDPR dopo Schrems II, le organizzazioni hanno bisogno di Transfer Impact Assessment documentati e, se il rischio permane, i trasferimenti richiedono misure supplementari come la crittografia lato client, in cui il cliente mantiene il controllo esclusivo delle chiavi, che la fonte descrive come una raccomandazione primaria dell'EDPB in questa analisi dei controlli di sovranità dopo Schrems II.
Questo punto viene frainteso di continuo. Qui la crittografia non è solo una generica best practice di sicurezza. È un controllo giurisdizionale.
Se il provider detiene le chiavi, un obbligo legale straniero rivolto al provider può comunque esporre dati leggibili. Se il cliente mantiene il controllo esclusivo delle chiavi, preferibilmente tramite un modello di sicurezza hardware che il provider non può aggirare, la stessa richiesta produce materiale illeggibile.
Il pattern minimo che mi aspetterei per dati sensibili e regolamentati include:
Chiavi controllate dal cliente: non le impostazioni predefinite gestite dal provider.
Separazione dei compiti: il team che gestisce l'infrastruttura non dovrebbe poter decifrare automaticamente i dati applicativi.
Privilegio minimo: l'accesso amministrativo dovrebbe essere ristretto, basato sui ruoli e limitato nel tempo.
Autenticazione a più fattori e log degli accessi: non sono facoltativi se dovete dimostrare la governance durante un audit.
I contratti aiutano. Il controllo delle chiavi decide cosa è tecnicamente possibile.
Controllare i percorsi di elaborazione, non solo lo storage
Molte architetture falliscono quando i team passano mesi a validare le regioni di storage e poi lasciano che l'elaborazione si espanda senza controllo.
Un design più solido usa calcolo localizzato, servizi containerizzati ed esecuzione in-database ove possibile, così che i dati sensibili non debbano lasciare l'ambiente governato per analytics, validazione o monitoraggio. Il principio è semplice. Meno dati spostate, meno decisioni sulla sovranità dovete difendere.
Questo porta a diversi controlli pratici:
Geofencing imposto tramite policy: limitate esecuzione e accesso alle giurisdizioni approvate.
Deployment single-tenant per i workload regolamentati: i piani condivisi creano maggiore complessità amministrativa.
Microservizi localizzati: mantenete le trasformazioni vicine ai dati su cui operano.
Sub-responsabili limitati: ogni fornitore a valle amplia la superficie di sovranità.
Revisione del design del failover: regioni di backup, ambienti warm standby e runbook di assistenza richiedono tutti una revisione di sovranità prima del go-live.
Alcuni team hanno bisogno anche di controlli avanzati come confidential computing, crittografia omomorfica o federated learning. Non sono risposte predefinite per ogni stack, ma sono utili quando dovete ridurre l'esposizione dei dati grezzi durante il calcolo.
Ciò che conta di più è la mentalità architetturale. Non chiedete solo: “Dov'è il database?”. Chiedete: “Dove sono questi dati, in qualsiasi momento, visibili, decifrabili, elaborabili, assistibili o recuperabili?”
Una checklist operativa per la data governance
Anche una buona architettura deriva nel tempo. Compaiono nuove tabelle. Vengono aggiunti nuovi connettori. Un'eccezione di assistenza viene approvata durante un incidente e non viene mai rimossa. Ecco perché la compliance alla sovranità dei dati si gioca nelle operations.
Costruire prima l'inventario
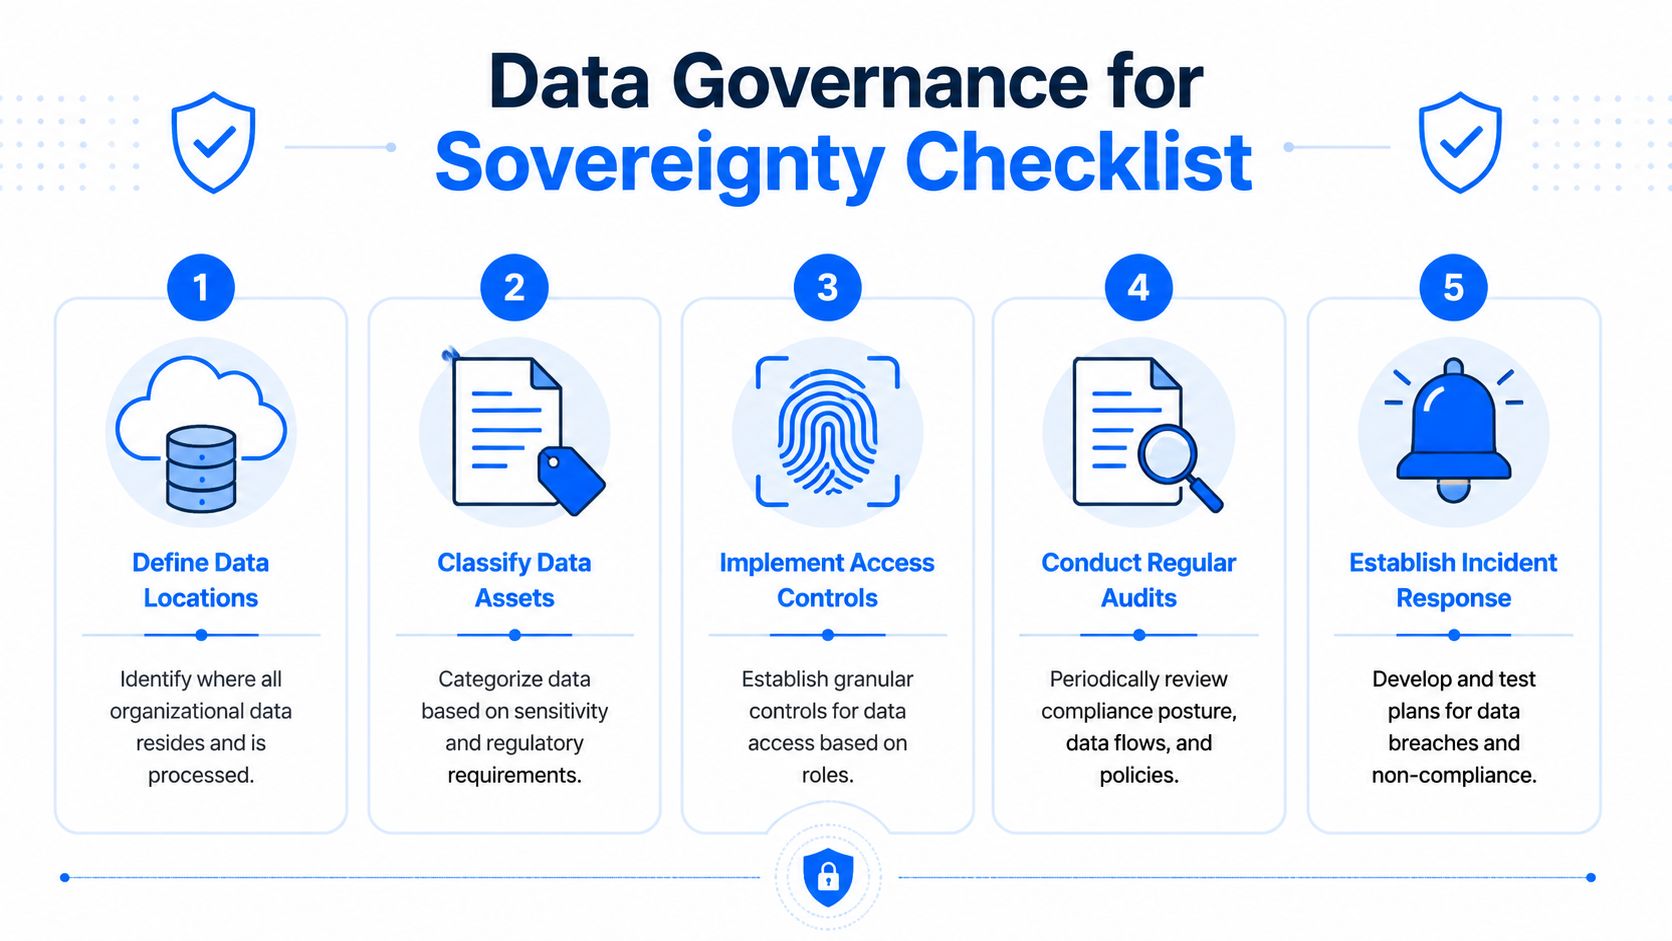
Non potete governare ciò che non avete mappato. Il primo passo operativo è un inventario aggiornato di dataset, posizioni di storage, posizioni di elaborazione, percorsi di trasferimento e punti di contatto con i sub-responsabili.
Manterrei la checklist pratica:
Mappate i flussi di dati end-to-end: includete ingestion, trasformazione, replica, backup e percorsi di accesso dell'assistenza.
Classificate per giurisdizione e sensibilità: dati personali, dati di settori regolamentati e dati industriali non comportano tutti gli stessi obblighi.
Segnalate le dipendenze da trasferimenti leciti: se un flusso dipende da clausole contrattuali o da una specifica valutazione del rischio, registratelo accanto alla pipeline, non in un fascicolo legale separato che nessuno legge.
Tracciate i percorsi di accesso amministrativo: l'accesso umano fa parte del modello dei flussi di dati.
Questo lavoro va aggiornato regolarmente. Gli inventari invecchiano rapidamente, perché i sistemi di engineering cambiano più in fretta della documentazione di governance.
Trattare l'accesso dei fornitori come un punto della revisione di design
Il problema più trascurato è quello che molti team danno per già risolto. Non lo è.
Un data center nel Paese giusto non basta se i team di assistenza di giurisdizioni straniere possono accedere ai dati. Questa scappatoia dell'accesso dei fornitori è un'attenzione crescente delle autorità di regolamentazione, come spiegato in questa analisi delle differenze tra sovranità, privacy e residenza.
Ciò significa che la valutazione dei fornitori non può fermarsi a “In quale regione siete ospitati?”. Dovete anche chiedere:
Quali team di assistenza possono accedere agli ambienti dei clienti, e da dove?
Il fornitore può decifrare i dati dei clienti?
Le sessioni di assistenza sono registrate, approvate e limitate per giurisdizione?
SLA e DPA limitano esplicitamente l'accesso amministrativo dall'estero?
Il prodotto può funzionare in un ambiente controllato dal cliente senza alcun accesso ai dati da parte del fornitore?
Archiviazione locale, elaborazione locale, assistenza locale. Se uno di questi elementi viene meno, la vostra postura di sovranità è più debole di quanto sembri.
Per gli engineer, questo trasforma il linguaggio del procurement in criteri tecnici di accettazione. Se il fornitore non sa spiegare come impedisce l'accesso transfrontaliero dell'assistenza, trattatelo come un rischio di design irrisolto.
Gestire la sovranità come un processo operativo ricorrente
Una volta implementati l'inventario e i controlli sui fornitori, la governance ha bisogno di una cadenza. Non di una bacheca di progetto una tantum.
Un ritmo operativo praticabile di solito include:
Audit periodici dei dati per confermare cosa esiste, dove risiede e come si sposta.
Transfer Impact Assessment per qualsiasi flusso transfrontaliero o nuova dipendenza da un fornitore.
Revisioni degli accessi focalizzate su ruoli privilegiati, account di emergenza e sessioni dei fornitori.
Revisioni contrattuali per DPA, SLA e modifiche ai sub-responsabili.
Aggiornamenti delle policy quando cambiano le normative o i design delle piattaforme.
È anche il momento di rivedere i percorsi di disaster recovery. Un'architettura di failover che attiva automaticamente un'altra giurisdizione non è un caso limite. Fa parte delle operazioni normali non appena qualcosa si rompe.
Come l'osservabilità mantiene e dimostra la compliance
Un design conforme sulla carta non basta. Servono prove che l'ambiente si comporti ancora come le vostre policy dicono che dovrebbe. È qui che l'osservabilità smette di essere una questione riservata agli SRE e diventa parte del compliance engineering.

Cosa monitorare in modo continuo
I problemi di sovranità iniziano spesso come normali modifiche operative. Una nuova colonna compare in una tabella condivisa. Una pipeline inizia a replicare un dataset in un altro ambiente. Un batch arriva in ritardo, viene rielaborato manualmente e qualcuno usa un percorso di assistenza esterno alla regione per esaminare il problema.
Ecco perché un livello di data observability è importante. Se volete una base concisa, questa introduzione alla data observability è un utile punto di riferimento.
In pratica, monitorerei almeno queste categorie:
Modifiche di schema: nuove colonne, cambi di tipo e campi eliminati possono introdurre dati personali o regolamentati in flussi che prima erano innocui.
Scostamenti di puntualità: i job in ritardo spesso innescano soluzioni manuali di ripiego, ed è proprio nelle soluzioni di ripiego che avvengono le violazioni dei confini.
Anomalie nei dati: variazioni insolite di volume, record mancanti o valori inattesi possono indicare modifiche all'elaborazione a monte che alterano il comportamento dei trasferimenti.
Esiti della validazione: i controlli a livello di record aiutano a confermare che i dati restino entro le strutture attese e i vincoli delle policy.
Log di accesso ed esecuzione: serve una visione chiara di chi ha operato su cosa, quando e con quale percorso di approvazione.
Come l'osservabilità trasforma le policy in prove
È qui che una piattaforma di osservabilità dimostra il suo valore. Considerate alcuni esempi concreti.
Una funzionalità di tracciamento dello schema può segnalare il momento in cui un team aggiunge una nuova colonna contenente dati personali a una tabella condivisa del data warehouse. Questo è importante perché un'esportazione a valle o una trasformazione tra regioni accettabile ieri può diventare oggi un problema di sovranità.
Un monitor di puntualità può evidenziare che un job di elaborazione all'interno della giurisdizione non è stato completato nei tempi previsti. Questo dà al team la possibilità di correggere il percorso locale invece di improvvisare un passaggio di ripristino transfrontaliero durante un'interruzione.
Un livello di rilevamento delle anomalie può far emergere pattern di spostamento insoliti nei dataset regolamentati. Forse il numero di righe aumenta inaspettatamente, forse una tabella inizia a cambiare al di fuori della sua pianificazione normale, o forse un consumatore a valle inizia a prelevare dati da un percorso non approvato.
La validazione a livello di record supporta l'auditabilità da un'altra angolazione. Se la policy stabilisce che determinati record non devono mai entrare in una pipeline al servizio di un'altra giurisdizione, le regole di validazione possono far rispettare quel confine prima che la violazione diventi un problema legale.
Una buona osservabilità non rileva solo dati rotti. Rileva presupposti errati su dove dovrebbero trovarsi i dati e su come dovrebbero comportarsi.
Il pattern più solido è l'esecuzione in-database. Quando le analisi di osservabilità vengono eseguite all'interno dell'ambiente controllato dal cliente anziché esportare i dati di produzione verso uno strumento esterno, il carico di compliance diminuisce. Questo modello riduce gli spostamenti, preserva la località e rende più facile difendere l'architettura durante la revisione.
Per i team di governance, il risultato è tangibile. Potete riportare freschezza, frequenza delle modifiche di schema, stato di superamento delle validazioni e comportamenti anomali come prova che i controlli di sovranità vengono monitorati in modo continuo, non solo dichiarati una volta all'anno.
La sovranità come disciplina continua
Il modello mentale sbagliato è “portare a termine il progetto di compliance”. Quello giusto è “gestire un sistema che continua a dimostrare i propri confini”.
Tutto inizia da un cambiamento di base nel modo di pensare dei team. La sovranità non equivale all'hosting locale. È la combinazione di un'architettura consapevole della giurisdizione, di accessi limitati, di un'elaborazione controllata e di prove operative. Se il vostro design dipende ancora da un'ampia fiducia nel fornitore o da eccezioni di assistenza non documentate, il controllo non è abbastanza maturo.
Per le aziende regolamentate, il pattern più efficace è costante. Riducete al minimo lo spostamento dei dati. Mantenete l'elaborazione vicina al dataset governato. Conservate il controllo delle chiavi di crittografia. Limitate l'accesso di fornitori e amministratori per giurisdizione. Rivedete i workflow di failover e di assistenza con lo stesso rigore che applicate al traffico di produzione.
Date priorità alla scappatoia dell'accesso dei fornitori come a un problema di primo piano. Molti ambienti sembrano conformi finché qualcuno non chiede chi può accedere dall'esterno della giurisdizione di hosting. Quella domanda mette a nudo il design sottostante.
Un buon passo successivo è rivedere l'inventario attuale, i percorsi di trasferimento, il modello di assistenza e l'architettura di backup alla luce di questi principi. Le lacune diventano di solito evidenti quando smettete di chiedervi solo dove sono archiviati i dati e iniziate a chiedervi chi può raggiungerli, da dove e secondo quale legge.
Se vi serve un modo pratico per monitorare modifiche ai dati, puntualità, anomalie e validazione all'interno di un ambiente controllato dal cliente, digna è pensato per questo modello operativo. Gira in ambienti private cloud o on-premises, mantiene l'analisi all'interno del vostro database e aiuta i team a conservare le prove per la governance senza esporre i dataset di produzione all'accesso del fornitore.
Se la modifica che più vi serve intercettare per tempo è una nuova colonna con dati personali in una tabella condivisa, vedete come digna Schema Tracker segnala le colonne aggiunte, rimosse e modificate.
Domande frequenti
Qual è la differenza tra sovranità dei dati e residenza dei dati?
La residenza dei dati è il luogo della cassaforte, cioè dove i dati sono archiviati, mentre la sovranità dei dati è l'autorità giuridica che governa la cassaforte, il suo contenuto e l'accesso a essa. Un workload può trovarsi in una regione di Francoforte e fallire comunque sulla sovranità se un engineer dell'assistenza al di fuori della giurisdizione apre una sessione di console.
Archiviare i dati in una regione UE basta per la compliance alla sovranità?
No, una regione UE soddisfa la residenza, non la sovranità. Il test proposto nell'articolo chiede chi può amministrare la piattaforma, dove si trovano le chiavi di crittografia, dove vengono eseguiti i job e cosa succede in caso di guasto, perché l'assistenza di un fornitore estero, un'elaborazione fuori regione o una regione di ripristino secondaria soggetta a un altro regime giuridico possono tutte creare un'esposizione.
In che modo la crittografia aiuta la sovranità dei dati dopo Schrems II?
La crittografia diventa un controllo giurisdizionale quando il cliente mantiene il controllo esclusivo delle chiavi. Dopo Schrems II, i trasferimenti soggetti al GDPR richiedono Transfer Impact Assessment documentati e, dove il rischio permane, misure supplementari come la crittografia lato client, così che una richiesta legale straniera rivolta al provider produca solo materiale illeggibile.
Cosa bisogna chiedere a un fornitore sulla sovranità dei dati?
Andate oltre la regione di hosting. Chiedete quali team di assistenza possono accedere agli ambienti dei clienti e da dove, se il fornitore può decifrare i vostri dati, se le sessioni di assistenza sono registrate e limitate per giurisdizione, se DPA e SLA limitano l'accesso amministrativo dall'estero e se il prodotto può funzionare senza alcun accesso del fornitore ai dati.
In che modo la data observability può supportare la compliance alla sovranità?
L'osservabilità trasforma le policy in prove. Il tracciamento dello schema può segnalare una nuova colonna con dati personali in una tabella condivisa, il monitoraggio della puntualità mostra quando un job all'interno della giurisdizione non rispetta la pianificazione prima che qualcuno improvvisi una soluzione transfrontaliera, e la validazione a livello di record può tenere i record soggetti a restrizioni fuori dalle pipeline al servizio di un'altra giurisdizione.