Come ottimizzare le query SQL: la guida completa
|
8
min di lettura

Avete davanti una dashboard che prima si caricava in un attimo e ora è così lenta che qualcuno chiede se il database è di nuovo giù. Il riflesso è noto: aggiungere un indice, riscrivere un join, magari dare la colpa al warehouse. Di solito le query non hanno bisogno di altri tentativi alla cieca, ma di un ciclo diagnostico rigoroso, di una lettura pulita del piano e di un'analisi seria dei compromessi dietro ogni “correzione”.
Indice
La mentalità dell'ottimizzazione SQL prima di toccare una query
Perché la mentalità conta più della prima correzione
Profilare le query e leggere i piani di esecuzione
Che cosa cercare nel piano
Strategie di indici e di schema che migliorano le prestazioni
Scegliere gli indici in modo consapevole
Come valutare se un indice vale la pena
Pattern di refactoring delle query per guadagni reali di prestazioni
Piccole riscritture che di solito ripagano
Prima e dopo, nella pratica
Pratiche di statistiche e manutenzione che prevengono le regressioni
Che cosa protegge davvero la manutenzione
Una checklist operativa leggera
Consigli specifici per motore e strategie di test affidabili
Come devono cambiare i test a seconda dell'ambiente
Una sequenza di validazione pratica
Mettere tutto insieme in una pratica di ottimizzazione sostenibile
La mentalità dell'ottimizzazione SQL prima di toccare una query
Una query lenta sembra un'urgenza, ma il primo errore è trattare ogni rallentamento come un'emergenza di schema. Partite dalla logica che ha reso possibile la moderna ottimizzazione SQL, il paper del 1979 di IBM System R, Access Path Selection in a Relational Database Management System. Quel lavoro ha introdotto l'ottimizzazione basata sui costi, in cui il database stima la cardinalità a partire dalle statistiche delle tabelle, confronta i piani candidati e sceglie il percorso a costo più basso invece di seguire soltanto regole fisse: una base ancora oggi utilizzata dai principali sistemi (la storia di IBM System R e il modello di ottimizzazione basata sui costi del 1979).
Questa impostazione è importante perché il tuning delle query è un problema di misurazione prima ancora che di correzione. I motori moderni confrontano ancora i costi di CPU, memoria e I/O su disco tra piani alternativi, il che significa che l'optimizer dipende fortemente dalla qualità delle sue statistiche e dalla corrispondenza tra le stime e i dati effettivi. Se gli input sono obsoleti, il piano può sembrare ragionevole sulla carta e comportarsi comunque male in produzione.
Perché la mentalità conta più della prima correzione
Se iniziate ad aggiungere indici prima di sapere che cosa sta facendo il piano, state solo tirando a indovinare più in fretta. La domanda migliore è se l'optimizer stia scegliendo il percorso di accesso sbagliato, l'ordine di join sbagliato o la strategia di scansione sbagliata perché i suoi input sono obsoleti. È anche per questo che il tuning moderno ruota ancora attorno a statistiche, predicati selettivi e ordine dei join, e non solo all'aggiunta di hardware.
Per un ripasso pratico dei fondamenti di SQL prima di dedicarvi al tuning, la guida SQL di Professional Careers Training è una buona base di partenza. Per inserire il lavoro sulle query in un modello operativo più ampio, le best practice di gestione dei database offrono un quadro utile per mantenere le prestazioni senza trasformare ogni modifica in un salvataggio d'emergenza.
Regola pratica: trattate ogni query lenta prima di tutto come un problema di misurazione. Se non sapete spiegare il piano, non dovete ancora modificarlo.
Profilare le query e leggere i piani di esecuzione
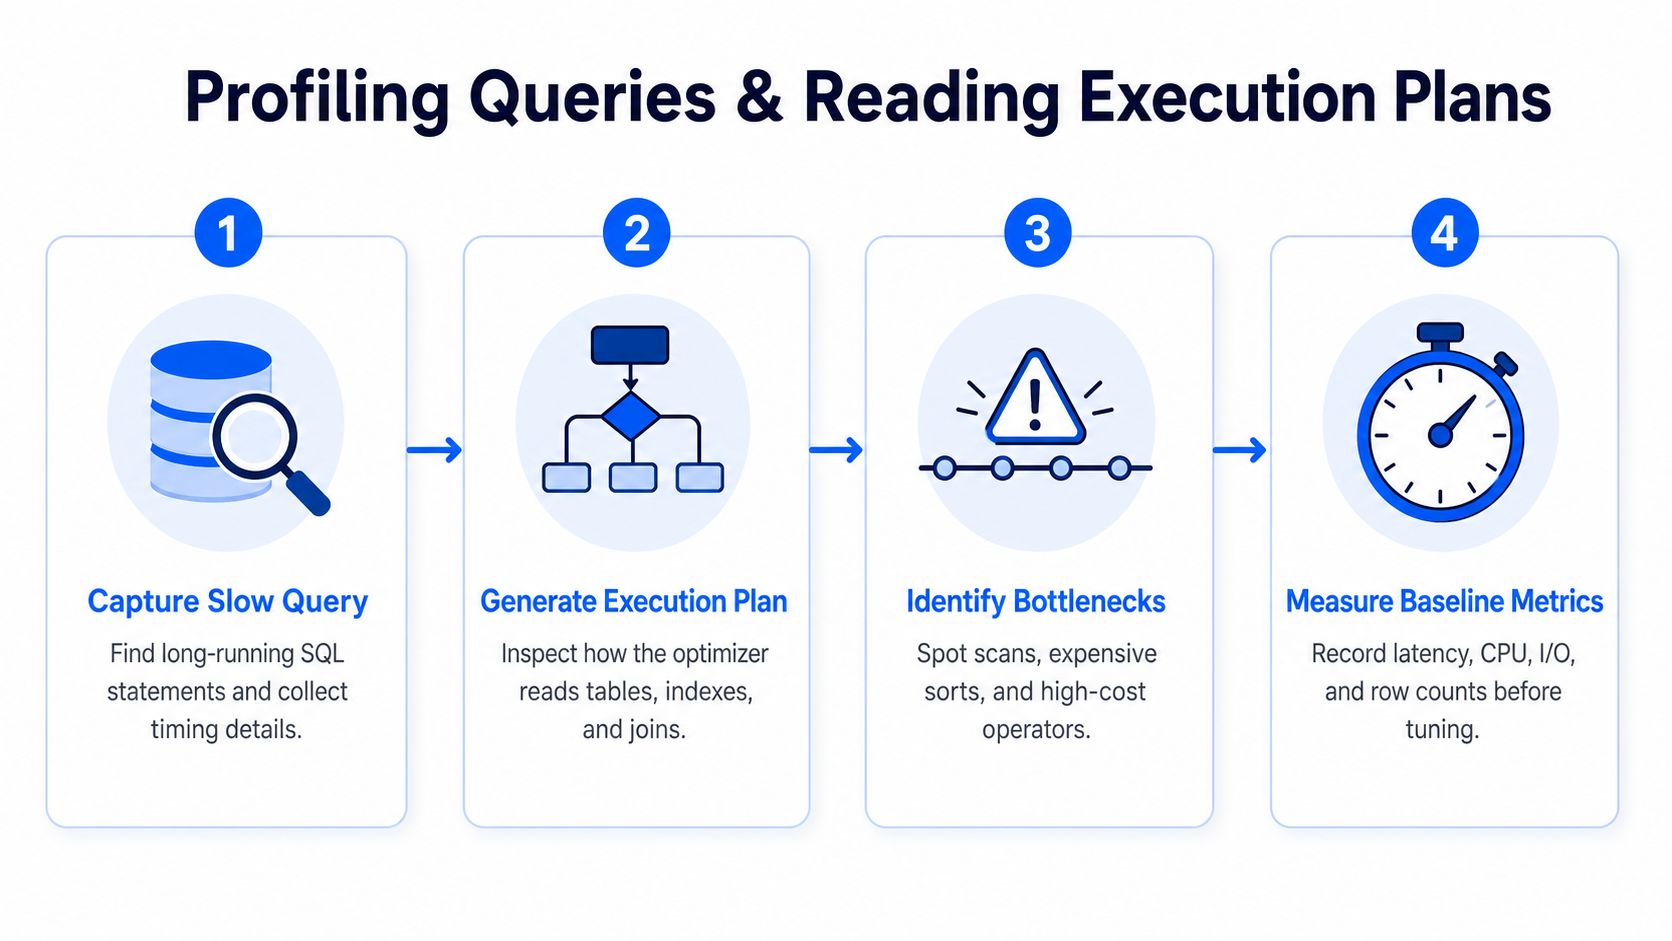
Una query non va mai ottimizzata a memoria. Catturate l'istruzione lenta con i parametri effettivi, poi eseguite EXPLAIN ANALYZE per vedere che cosa ha fatto davvero il motore, non che cosa il testo SQL lascerebbe supporre. I data engineer esperti lavorano di solito in un ciclo serrato: catturano la query, esaminano il piano effettivo, cambiano una sola cosa, aggiornano le statistiche con ANALYZE, quindi rieseguono e confrontano il nuovo piano con quello precedente (workflow pratico di tuning delle query con EXPLAIN ANALYZE e ANALYZE).
La scorciatoia più utile è confrontare nel piano il numero di righe stimato con il numero di righe effettivo. Quando differiscono di circa 10 volte o più, le statistiche obsolete sono spesso il motivo per cui l'optimizer ha scelto un ordine di join o un percorso di accesso sbagliati (indicazioni su discrepanze tra righe stimate ed effettive e statistiche obsolete). Questa discrepanza si manifesta spesso come un Seq Scan su una tabella grande, un Nested Loop con un numero elevato di righe o un Sort su colonne non indicizzate, il che offre un punto concreto su cui intervenire.
Che cosa cercare nel piano
Segnale d'allarme | Che cosa significa | Passo successivo |
|---|---|---|
Seq Scan su una tabella grande | Il motore sta leggendo molti più dati del necessario | Aggiornare le statistiche, poi aggiungere o modificare un indice sulla colonna filtrata |
Nested Loop con un numero elevato di righe | L'ordine o il metodo di join è probabilmente sbagliato | Controllare le stime di cardinalità, poi testare un percorso di join diverso |
Sort su colonne non indicizzate | Il database ordina troppi dati dopo la scansione | Ridurre prima le righe, oppure aggiungere un indice che supporti l'ordinamento |
Righe stimate ed effettive molto divergenti | Il modello dell'optimizer non corrisponde alla realtà | Eseguire |
Confrontate il piano prima e dopo ogni modifica. Se apportate due o tre modifiche contemporaneamente, non saprete quale ha davvero aiutato.
La disciplina chiave è l'isolamento. Apportate esattamente una modifica, poi ripetete il test. In questo modo le osservazioni restano utilizzabili e si evitano “correzioni” che sembravano efficaci solo perché nello stesso momento erano cambiati lo stato della cache, la distribuzione dei dati o un'altra riscrittura non correlata.
Strategie di indici e di schema che migliorano le prestazioni
Gli indici restano la leva di tuning più ovvia, ma anche la più facile da usare male. Il consiglio comune, “aggiungere un indice sulla clausola WHERE”, racconta solo metà della storia. La parte più difficile è capire quando un indice aiuta abbastanza da giustificare la penalizzazione in scrittura, perché troppi indici rallentano le operazioni di INSERT, UPDATE e DELETE, e la maggior parte dei contenuti generici sull'ottimizzazione affronta a malapena questo compromesso (compromessi nei sistemi con molte scritture e il problema del sovraccarico di indici).
Scegliere gli indici in modo consapevole
Un indice su una singola colonna può essere perfetto per un filtro e inutile per un join che dipende da un pattern di accesso diverso. Gli indici compositi aiutano quando i predicati seguono un ordine prevedibile, mentre i covering index possono evitare del tutto che il motore acceda alla tabella di base. Gli indici parziali hanno senso quando solo una porzione della tabella è molto utilizzata, e spesso sono più puliti che indicizzare tutto solo per salvare un report lento.
La progettazione dello schema conta altrettanto. Se una tabella memorizza i dati con il tipo sbagliato, l'optimizer ha meno margine per ragionare in modo efficiente, e se il vostro modello impone scansioni enormi su tabelle mal strutturate, gli indici diventano un cerotto invece di una soluzione. Lo stesso vale per il partizionamento, perché un buon confine di partizione consente al motore di saltare interi blocchi di dati invece di filtrarli dopo la scansione.
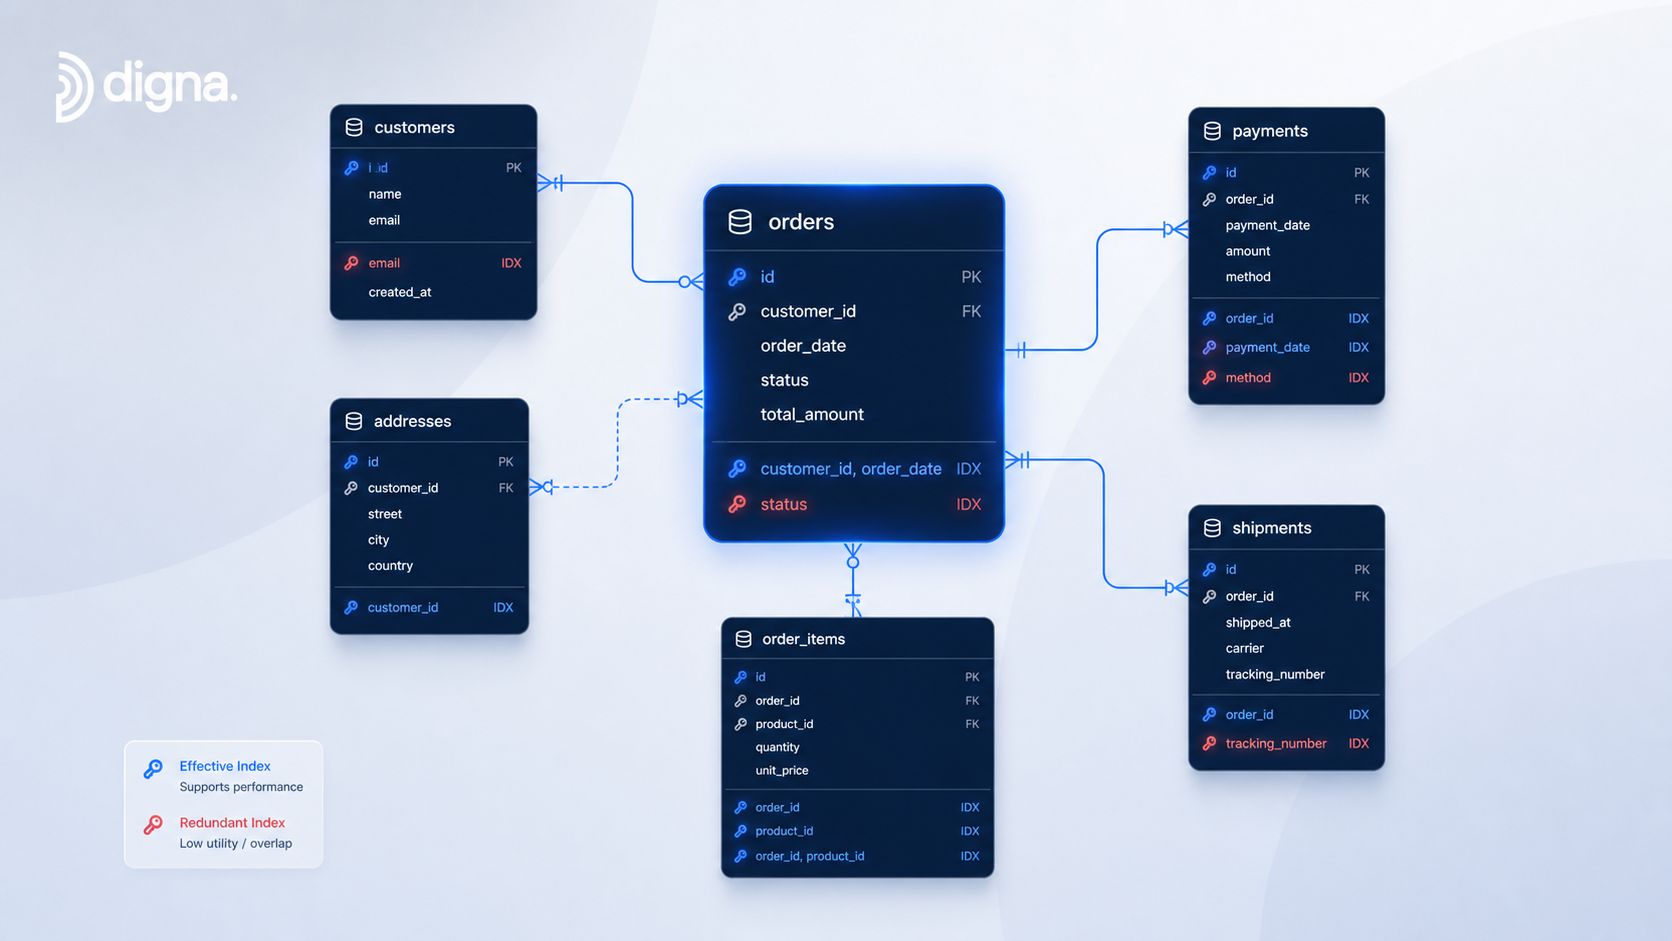
Se la struttura delle tabelle è già disordinata, l'optimizer deve lavorare più del dovuto. I team che pianificano modifiche di schema più ampie prendono spesso spunto dalla modellazione a stella e a fiocco di neve, in cui i pattern di accesso sono più chiari e i join più facili da analizzare. Un utile punto di riferimento è la progettazione di schemi a stella e a fiocco di neve.
Come valutare se un indice vale la pena
Il test non è “La query è diventata più veloce?”. Il test decisivo è se il miglioramento in lettura supera il costo in scrittura sull'intero carico di lavoro che conta. Se una tabella riceve soprattutto inserimenti e viene letta per lo più una sola volta, un nuovo indice può costare poco. Se la stessa tabella subisce aggiornamenti continui, ogni indice in più diventa un lavoro di manutenzione che il database deve pagare a ogni scrittura.
Regola empirica: ottimizzate il percorso di accesso che il carico di lavoro utilizza davvero, non quello che fa la figura migliore nello screenshot di una singola query.
Questo compromesso conta soprattutto nei sistemi di produzione in cui la latenza dei report e il throughput di ingestion competono per le stesse risorse di storage e CPU. Buone scelte di schema riducono la necessità di indicizzazioni d'emergenza in seguito, che di solito è il risultato più pulito.
Pattern di refactoring delle query per guadagni reali di prestazioni
Il guadagno più rapido spesso si ottiene modificando l'SQL stesso. Un punto di partenza concreto è evitare SELECT * e restituire solo le colonne necessarie, perché meno colonne riducono l'I/O, l'uso di memoria e la quantità di dati che il motore deve far passare attraverso il piano (indicazioni di settore sulla riduzione delle colonne selezionate). Sembra banale, ma si vede ancora in query di produzione che trascinano payload enormi attraverso i join solo per scartarne la maggior parte in seguito.
Piccole riscritture che di solito ripagano
L'abitudine successiva è filtrare il prima possibile con WHERE, così che il database riduca l'insieme di lavoro prima di eseguire join, raggruppamenti o ordinamenti (indicazioni sul filtraggio anticipato). Se una condizione può essere applicata prima di un join, applicatela lì. Se una subquery esiste solo per restringere l'insieme di righe, mantenetela ristretta prima che entrino in gioco gli operatori costosi.
Altre riscritture dipendono di più dal contesto, ma sono importanti. Sostituite un join esteso con EXISTS quando vi interessa solo sapere se esiste una corrispondenza. Spostate i predicati all'interno delle subquery quando questo permette al motore di eliminare le righe prima. Evitate OFFSET per la paginazione profonda su dataset di grandi dimensioni, soprattutto nei sistemi di tipo warehouse, dove scorrere le righe significa pagare scansioni di cui non c'era alcun bisogno.
Prima e dopo, nella pratica
Una query come questa:
SELECT * FROM orders o JOIN customers c ON o.customer_id = c.id WHERE c.country = 'DE'
spesso fa più lavoro del necessario. Estrae tutte le colonne e poi costringe il motore a trascinarle attraverso il join.
Una versione più snella è questa:
SELECT o.id, o.order_date, c.id, c.country FROM orders o JOIN customers c ON o.customer_id = c.id WHERE c.country = 'DE'
Non è ancora perfetta, ma riduce subito il payload. Se servono solo gli identificativi degli ordini e il paese, non passate al motore il resto della riga. Se lo stesso risultato viene paginato su larga scala, la keyset pagination di solito batte OFFSET, perché evita che il database debba scorrere righe che salterà comunque.
L'errore più grande in questo caso è mescolare refactoring e modifiche agli indici in modo così stretto da non riuscire più a capire quale intervento abbia fatto la differenza. Mantenete prima semplice la forma dell'SQL, poi decidete se il problema residuo è strutturale o fisico.
Pratiche di statistiche e manutenzione che prevengono le regressioni
Una query può sembrare sana e scivolare comunque in territorio critico quando l'optimizer lavora su statistiche obsolete. L'ottimizzazione basata sui costi si è diffusa nei principali motori perché la stessa logica di base si applica bene a sistemi come SQL Server, Teradata, Oracle e PostgreSQL. L'optimizer può fare una scelta valida solo quando la sua visione della distribuzione dei dati corrisponde ancora alla realtà.
Che cosa protegge davvero la manutenzione
La gestione delle statistiche è facile da trascurare perché la query continua a funzionare, solo più lentamente di prima. È di solito in quel momento che i piani iniziano a derivare. L'optimizer dipende dalla forma attuale dei dati, quindi quando le distribuzioni cambiano e le statistiche restano indietro, può valutare male la selettività, scegliere il percorso di join sbagliato o ripiegare su un piano che sembra sicuro ma offre prestazioni scadenti.
Una cadenza di manutenzione pratica resta semplice, anche se i tempi esatti dipendono dal sistema. Aggiornate le statistiche dopo grandi modifiche ai dati, rivedete i piani dopo i deployment o le modifiche di schema e tenete d'occhio le regressioni dei piani nelle query più importanti. Se una query stabile inizia a mostrare una discrepanza nelle stime delle righe, trattatela come un segnale di manutenzione prima che diventi un incidente visibile agli utenti. Per i team che usano Snowflake in produzione, monitorare insieme utilizzo, costi e comportamento delle query rende più facile individuare queste regressioni prima che si diffondano.
Una checklist operativa leggera
Aggiornate regolarmente le statistiche: fatelo quando la distribuzione dei dati cambia abbastanza da influire sulla selettività, non solo secondo un calendario fisso.
Rivedete i piani dopo le modifiche di schema: nuove colonne, indici eliminati o join riscritti possono cambiare immediatamente la qualità del piano.
Tenete d'occhio la deriva delle stime: se righe effettive e stimate non sono più vicine, il modello dell'optimizer è probabilmente obsoleto.
Documentate i pattern collaudati: annotate quali percorsi di join, filtri e indici proteggono i carichi di lavoro critici.
Ripetete i test dopo la manutenzione: un nuovo
ANALYZEoUPDATE STATISTICSpuò cambiare il piano sia in meglio sia in peggio, quindi verificate il risultato.
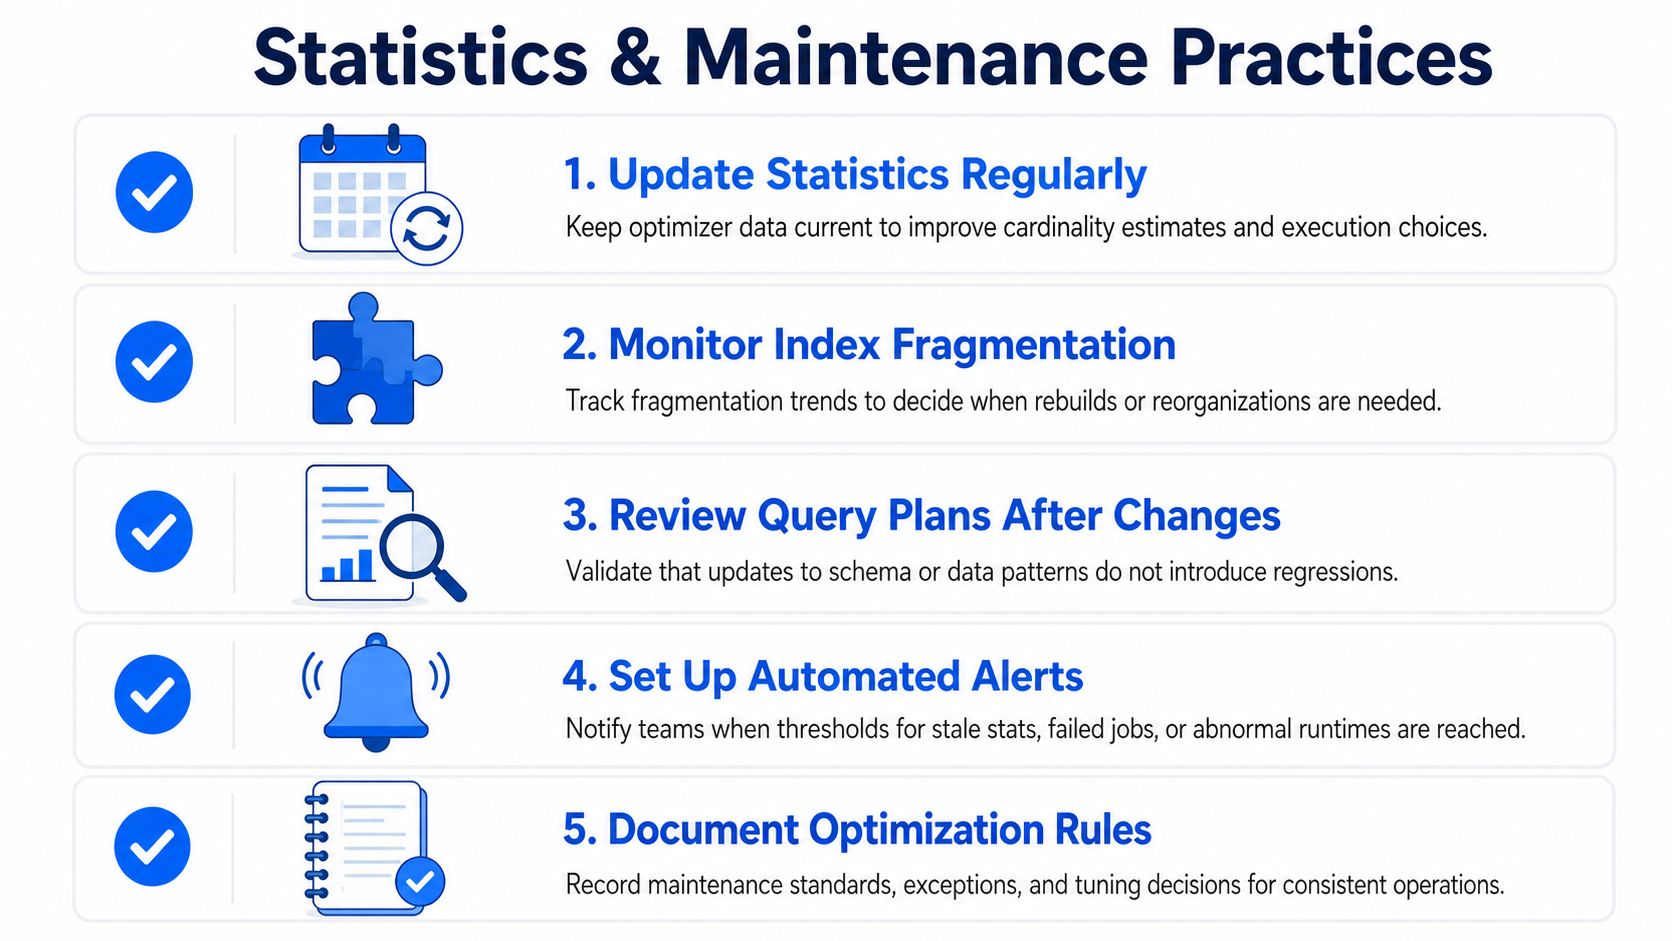
Questo ciclo di manutenzione evita che l'ottimizzazione diventi un lavoro d'emergenza. Rende anche più facile distinguere i problemi di prestazioni da quelli di qualità dei dati, perché si capisce quando è il motore a sbagliare e quando invece è cambiata la forma dei dati.
Consigli specifici per motore e strategie di test affidabili
La prima regola è universale, il secondo livello è specifico per motore. Nei sistemi di tipo warehouse, la priorità si sposta spesso dall'indicizzazione OLTP classica alla riduzione delle scansioni, al partition pruning e a pattern di paginazione che evitano letture a forza bruta. I contenuti recenti dedicati ai warehouse tornano continuamente su alcuni punti: evitare OFFSET, usare UNION ALL quando riduce il lavoro, filtrare presto e sfruttare le funzionalità specifiche della piattaforma, perché costi e latenza vanno bilanciati insieme quando il collo di bottiglia è l'analytics su larga scala e non una singola tabella molto utilizzata (lacune dell'ottimizzazione nei warehouse e focus sul costo delle scansioni).
Come devono cambiare i test a seconda dell'ambiente
Una modifica che sembra brillante in un ambiente di sviluppo con cache calda può deludere in produzione. Per questo la baseline deve essere pulita: una query, un piano, una modifica, poi un nuovo test in condizioni comparabili. Se il motore supporta un vero EXPLAIN o una vista di profiling, usatelo prima di promuovere qualsiasi cosa, poi ricontrollate l'operatore più lento dopo la riscrittura.
I dettagli variano da un motore all'altro. PostgreSQL premia spesso un uso attento dei tipi di indice e l'ispezione dei piani. MySQL può comportarsi in modo molto diverso a seconda della forma degli indici e del pattern di join. SQL Server ha le sue abitudini di lettura dei piani e i suoi hint, ma il punto resta lo stesso: misurate il piano effettivo prima di fidarvi della riscrittura.
Una sequenza di validazione pratica
Catturate la query di base e il contesto di esecuzione.
Registrate il piano di esecuzione.
Cambiate una sola cosa.
Rieseguite nelle stesse condizioni.
Confrontate l'operatore più lento, non solo il tempo totale di esecuzione.
Per i team che lavorano con i moderni cloud warehouse, il confronto dovrebbe includere anche il costo delle scansioni e il volume di dati che attraversa il piano, non solo il tempo trascorso. Nella pratica, significa scegliere forme di query che riducano il lavoro sull'intera tabella prima di raggiungere le parti costose del sistema.
Un'opzione che si inserisce in uno stack di monitoraggio più ampio è il monitoraggio Snowflake di digna per utilizzo, costi e prestazioni, che può aiutare i team a tenere d'occhio il comportamento dei carichi di lavoro durante il tuning. Usate strumenti di questo tipo per osservare il carico di lavoro, ma verificate comunque ogni modifica SQL direttamente nel database.
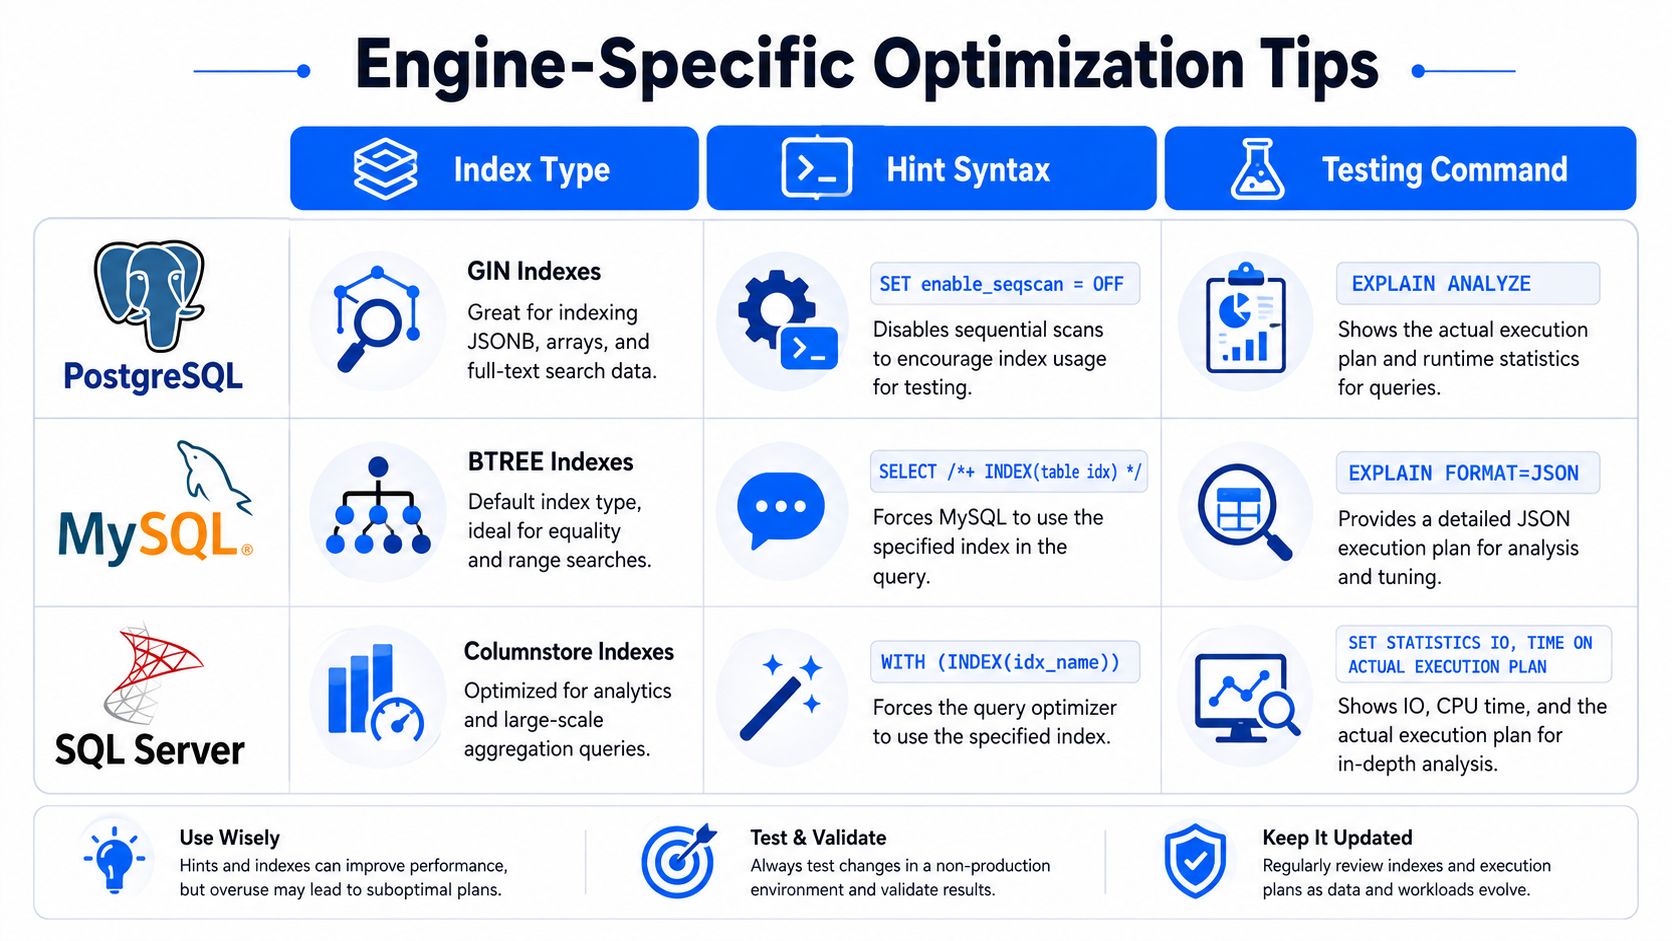
L'obiettivo non è memorizzare ogni peculiarità dei motori, ma costruire un'abitudine di validazione che resista alle differenze tra piattaforme, perché il piano migliore sulla carta non è quello che mettete in produzione: è quello che continua a funzionare bene quando arriva il traffico reale.
Mettere tutto insieme in una pratica di ottimizzazione sostenibile
Il modo più pulito per ottimizzare le query SQL è trattare il tuning come un ciclo, non come un'impresa eroica. Partite dal piano, individuate il collo di bottiglia, apportate una modifica, ripetete il test e poi stabilite se il problema era fisico, logico o statistico. Quando lo fate in modo costante, il lavoro sulle query smette di essere una lotta contro gli incendi e diventa un'operatività di routine.
Il vero valore sta nella prevenzione. Una buona indicizzazione, un refactoring accurato e una manutenzione regolare delle statistiche riducono la probabilità che un piano sbagliato si trasformi in un incidente su una dashboard o in una pipeline in ritardo. I team che mantengono questa disciplina passano meno tempo a tirare a indovinare e più tempo a risolvere la causa reale.
Una pratica sostenibile collega anche la salute delle query all'observability. Un SQL lento si manifesta spesso come dashboard obsolete, report in ritardo o pipeline rallentate, quindi la stessa mentalità operativa che protegge l'affidabilità dei dati protegge anche le prestazioni delle query. Quando queste due aree vengono gestite insieme, l'intero stack di analytics diventa più affidabile.
Se la latenza delle query sta facendo arrivare in ritardo le dashboard o rende meno affidabili le esecuzioni delle pipeline, usate digna per monitorare il comportamento dei dati dietro questi problemi, oltre ai segnali operativi che li circondano. Il suo approccio in-database aiuta i team a sorvegliare tempestività, modifiche di schema, validazione e comportamento della piattaforma senza spostare i dati. Per questo è una soluzione pratica quando i problemi di prestazioni SQL iniziano a incidere sull'affidabilità, non solo sulla velocità delle query.
Quando una query lenta inizia a manifestarsi come un report in ritardo più che come una schermata lenta, digna Timeliness verifica se i dati alla base di quel report arrivano quando previsto.
Domande frequenti
Qual è il primo passo per ottimizzare una query SQL lenta?
Trattatela come un problema di misurazione. Catturate l'istruzione lenta con i suoi parametri effettivi ed eseguite EXPLAIN ANALYZE per vedere che cosa ha fatto davvero il motore. Poi cambiate una sola cosa, aggiornate le statistiche con ANALYZE, rieseguite e confrontate il nuovo piano con quello precedente. Se non sapete spiegare il piano, non modificatelo ancora.
Come si legge un piano di esecuzione per trovare il collo di bottiglia?
Confrontate innanzitutto il numero di righe stimato con quello effettivo. Quando divergono di circa 10 volte o più, spesso le statistiche obsolete hanno indotto l'optimizer a scegliere un ordine di join o un percorso di accesso sbagliati. Altri segnali d'allarme sono un Seq Scan su una tabella grande, un Nested Loop con un numero elevato di righe e un Sort su colonne non indicizzate.
Troppi indici possono rallentare un database?
Sì. Ogni indice in più aggiunge lavoro alle operazioni di INSERT, UPDATE e DELETE, quindi su una tabella aggiornata di continuo diventa un costo di manutenzione pagato a ogni scrittura. Il vero test è se il miglioramento in lettura supera questo costo in scrittura sull'intero carico di lavoro che conta, non se una singola query è diventata più veloce.
Perché evitare SELECT * nelle query SQL?
Restituire solo le colonne necessarie riduce l'I/O, l'uso di memoria e i dati trascinati attraverso i join. L'articolo riscrive una SELECT * FROM orders in join con customers in una query che seleziona solo o.id, o.order_date, c.id e c.country. Filtrare presto con WHERE e usare la keyset pagination al posto di OFFSET riduce ulteriormente il lavoro.
Con quale frequenza vanno aggiornate le statistiche del database?
In base alle modifiche dei dati più che secondo un calendario fisso. Aggiornate le statistiche dopo grandi modifiche ai dati o quando la distribuzione cambia abbastanza da influire sulla selettività, rivedete i piani dopo deployment e modifiche di schema e trattate una nuova discrepanza tra righe stimate ed effettive come un segnale di manutenzione. Dopo aver eseguito ANALYZE o UPDATE STATISTICS, ripetete i test, perché i piani possono cambiare in entrambe le direzioni.


