Come descrivere la distribuzione dei dati: una guida pratica
|
7
min di lettura
Una pipeline ha funzionato senza errori per tutta la settimana. I conteggi delle righe sembravano normali, i controlli di freshness erano superati e nessuno era stato allertato. Poi la dashboard del lunedì ha mostrato numeri senza senso. Il fatturato per regione ha cambiato forma, una feature di ML ha iniziato a concentrarsi attorno a un nuovo picco e gli alert sulla latenza sono arrivati troppo tardi per servire a qualcosa. Nulla si era "rotto" in senso evidente. Era cambiata la distribuzione dei dati.
È la situazione in cui si trovano molti team quando cercano come descrivere la distribuzione dei dati. Non serve loro una definizione da manuale. Serve un modo per spiegare cosa è cambiato, perché è importante e come distinguere la variazione normale dal tipo di spostamento che avvelena in modo sottile i sistemi a valle.
Indice
Perché descrivere la distribuzione dei dati è fondamentale per la data quality
Validare le ipotesi sulla distribuzione con i test statistici
Applicare l'analisi della distribuzione al monitoraggio continuo dei dati
Perché descrivere la distribuzione dei dati è fondamentale per la data quality
La maggior parte degli incidenti sui dati non inizia con un guasto clamoroso. Inizia con un silenzioso cambiamento di comportamento nei dati. Una feature che prima era unimodale diventa bimodale. Una metrica che era molto concentrata sviluppa una lunga coda destra. Un sistema sorgente cambia tipi o valori predefiniti e la tabella a valle continua a caricarsi, ma il significato dei dati si è spostato.
Ecco perché l'analisi della distribuzione è al centro del lavoro sulla data quality. Offre ai team un vocabolario per dire qualcosa di più di "i numeri sembrano strani". Si può dire che il centro si è spostato, che la dispersione si è allargata, che sono comparsi outlier o che la forma è cambiata rispetto a ciò che la pipeline produce di solito. Sono affermazioni operative. Gli ingegneri possono indagarle.
Molti tutorial trascurano questo aspetto operativo. I contenuti esistenti trattano in larghissima parte la descrizione della distribuzione dei dati come un esercizio statico su un singolo dataset, senza affrontare come descrivere le distribuzioni nei contesti di observability delle serie temporali, dove la sfida principale è rilevare gli spostamenti. Le recenti criticità del settore in tema di data quality mostrano che il 73% dei guasti sui dati deriva da drift silenziosi di schema o di distribuzione che le sintesi statiche non colgono (panoramica di Study.com sulla descrizione delle distribuzioni).
Regola pratica: se la vostra descrizione di un dataset non aiuta qualcuno a confrontare la situazione di oggi con la baseline di ieri, non è sufficiente per il monitoraggio in produzione.
I team lo scoprono spesso a proprie spese con metriche che, prese singolarmente, sembravano sane. Un campo normalizzato può comunque andare in drift dopo una modifica lato sorgente, ed è per questo che pulizia e standardizzazione dovrebbero precedere i controlli sulla distribuzione. Se vi serve un rapido ripasso su questa fase di preparazione, una guida pratica alla normalizzazione dei dati offre un contesto utile prima di interpretare qualsiasi distribuzione.
Tre esempi mostrano perché questo conta nella pratica:
Affidabilità delle dashboard: una tabella di KPI può continuare a caricarsi mentre il mix di categorie cambia sotto di essa.
Stabilità delle feature di ML: un modello può ricevere record validi le cui distribuzioni delle feature non corrispondono più al comportamento di training.
Operatività delle pipeline: timeliness, conteggi delle righe, tassi di NULL e intervalli di valori possono andare tutti in drift senza provocare un errore di schema.
Per i team che costruiscono il monitoraggio, è questa la differenza tra validazione statica e observability. I controlli statici rispondono alla domanda se i dati sono conformi a una regola. L'analisi della distribuzione risponde alla domanda se i dati si comportano ancora come il processo che li ha prodotti la settimana scorsa. Nei sistemi live è la domanda più utile, soprattutto quando si definiscono metriche di data quality che devono restare significative con l'evoluzione delle pipeline.
I quattro pilastri per descrivere una distribuzione
Se volete un modo affidabile per descrivere la distribuzione dei dati, partite da SOCS. L'acronimo sta per Shape, Outliers, Center e Spread, cioè forma, outlier, centro e dispersione. Resta il framework più pratico, perché vi obbliga a descrivere un dataset in modo completo invece di saltare subito alla vostra metrica preferita.

La regola di base è semplice. Il framework fondamentale per descrivere la distribuzione dei dati si basa su quattro componenti: forma, outlier, centro e dispersione (SOCS). Per i dati asimmetrici si usa la mediana per rappresentare il centro, mentre lo scarto interquartile (IQR) quantifica la dispersione, perché media e deviazione standard possono essere fuorvianti (guida di Albert sulla descrizione delle distribuzioni).
La forma indica come si comporta il processo
La forma è il pattern della distribuzione. È simmetrica o asimmetrica? Ha un picco, due picchi, molti picchi o nessun picco evidente? Conta perché la forma rivela spesso l'effettiva condizione operativa di un sistema.
Un singolo picco suggerisce spesso un unico processo stabile. Due picchi possono indicare due popolazioni mescolate, come il traffico dei giorni feriali e del weekend, gli utenti mobile e web, oppure due sistemi sorgente che scrivono nella stessa tabella. Una lunga coda destra compare spesso nei dati di latenza, negli importi delle transazioni e nelle durate operative.
Quando la distribuzione ha un'asimmetria positiva, la media supera la mediana. Quando ha un'asimmetria negativa, la media è inferiore alla mediana. Questo solo dettaglio cambia il modo in cui sintetizzate i dati e il modo in cui spiegate cosa è "normale".
Gli outlier indicano dove indagare
Gli outlier sono osservazioni che si trovano lontano dalla massa principale dei dati. A volte sono record errati. A volte sono l'unica prova che avete del degrado di una pipeline, del cambiamento di comportamento di un partner o della comparsa di un pattern di frode.
Non trattate automaticamente gli outlier come rumore. Nei sistemi in produzione sono spesso il primo indizio.
Una descrizione utile della distribuzione non si ferma a "ci sono outlier". Si chiede se si tratti di eventi di coda attesi, di errori nei dati o di segnali di un processo cambiato.
Una buona abitudine è registrare sia la presenza degli outlier sia il loro contesto. Sono comparsi all'improvviso? Sono concentrati in una partizione, in un tenant, in un feed sorgente o in una specifica ora del giorno?
Centro e dispersione indicano cosa è tipico e cosa è stabile
Il centro risponde a una domanda: qual è un valore tipico? La dispersione risponde a un'altra: quanto varia questo processo?
Per il centro, le scelte abituali sono media, mediana e moda:
Media: ideale quando i dati sono simmetrici e non distorti da valori estremi.
Mediana: migliore quando i dati sono asimmetrici, perché resiste alla distorsione delle code.
Moda: utile quando il valore più frequente è di per sé significativo.
Per la dispersione, le scelte più comuni sono campo di variazione, IQR e deviazione standard:
Campo di variazione: rapido da calcolare, approssimativo da interpretare.
IQR: robusto per i dati asimmetrici, perché si concentra sulla metà centrale.
Deviazione standard: utile quando i dati sono vicini alla normalità e vi interessa la dispersione attorno alla media.
La scelta non è accademica. Cambia la qualità degli alert. Se sintetizzate una latenza asimmetrica con media e deviazione standard, potete nascondere proprio il comportamento a cui gli operatori tengono. Mediana e IQR di solito la descrivono in modo più accurato.
Scegliere la misura giusta: tendenza centrale vs. dispersione
Tipo di misura | Statistica | Ideale per questa distribuzione | Perché è adatta |
|---|---|---|---|
Tendenza centrale | Media | Dati simmetrici o approssimativamente normali | Usa tutti i valori e funziona bene quando le code sono bilanciate |
Tendenza centrale | Mediana | Dati asimmetrici | Resiste ai valori estremi e riflette meglio l'osservazione tipica |
Tendenza centrale | Moda | Pattern ripetuti o basati sulla frequenza | Mostra il valore osservato più frequente |
Dispersione | Campo di variazione | Ispezione rapida e approssimativa | Mostra l'intera ampiezza dal minimo al massimo |
Dispersione | IQR | Dati asimmetrici | Cattura il 50% centrale senza essere dominato dalle code |
Dispersione | Deviazione standard | Dati simmetrici o approssimativamente normali | Misura la distanza media dalla media e supporta le regole basate sulla normalità |
Se vi serve una checklist sintetica, usate questa:
Descrivete prima la forma: non scegliete le statistiche di sintesi prima di sapere se i dati sono simmetrici o asimmetrici.
Usate la mediana in caso di asimmetria: di solito rappresenta il valore "tipico" meglio della media quando le code sono lunghe.
Usate l'IQR quando le code sono disordinate: è più difficile che gli outlier lo distorcano.
Tenete in coppia centro e dispersione: la media va con la deviazione standard, la mediana con l'IQR.
Scegliere la visualizzazione giusta per leggere la storia
Il modo più rapido per fraintendere una distribuzione è guardare il grafico sbagliato. I team usano spesso un'unica vista per tutto, di solito un istogramma con le impostazioni predefinite dello strumento. È comodo, ma nasconde differenze importanti tra "mostrami la forma" e "mostrami lo spostamento".
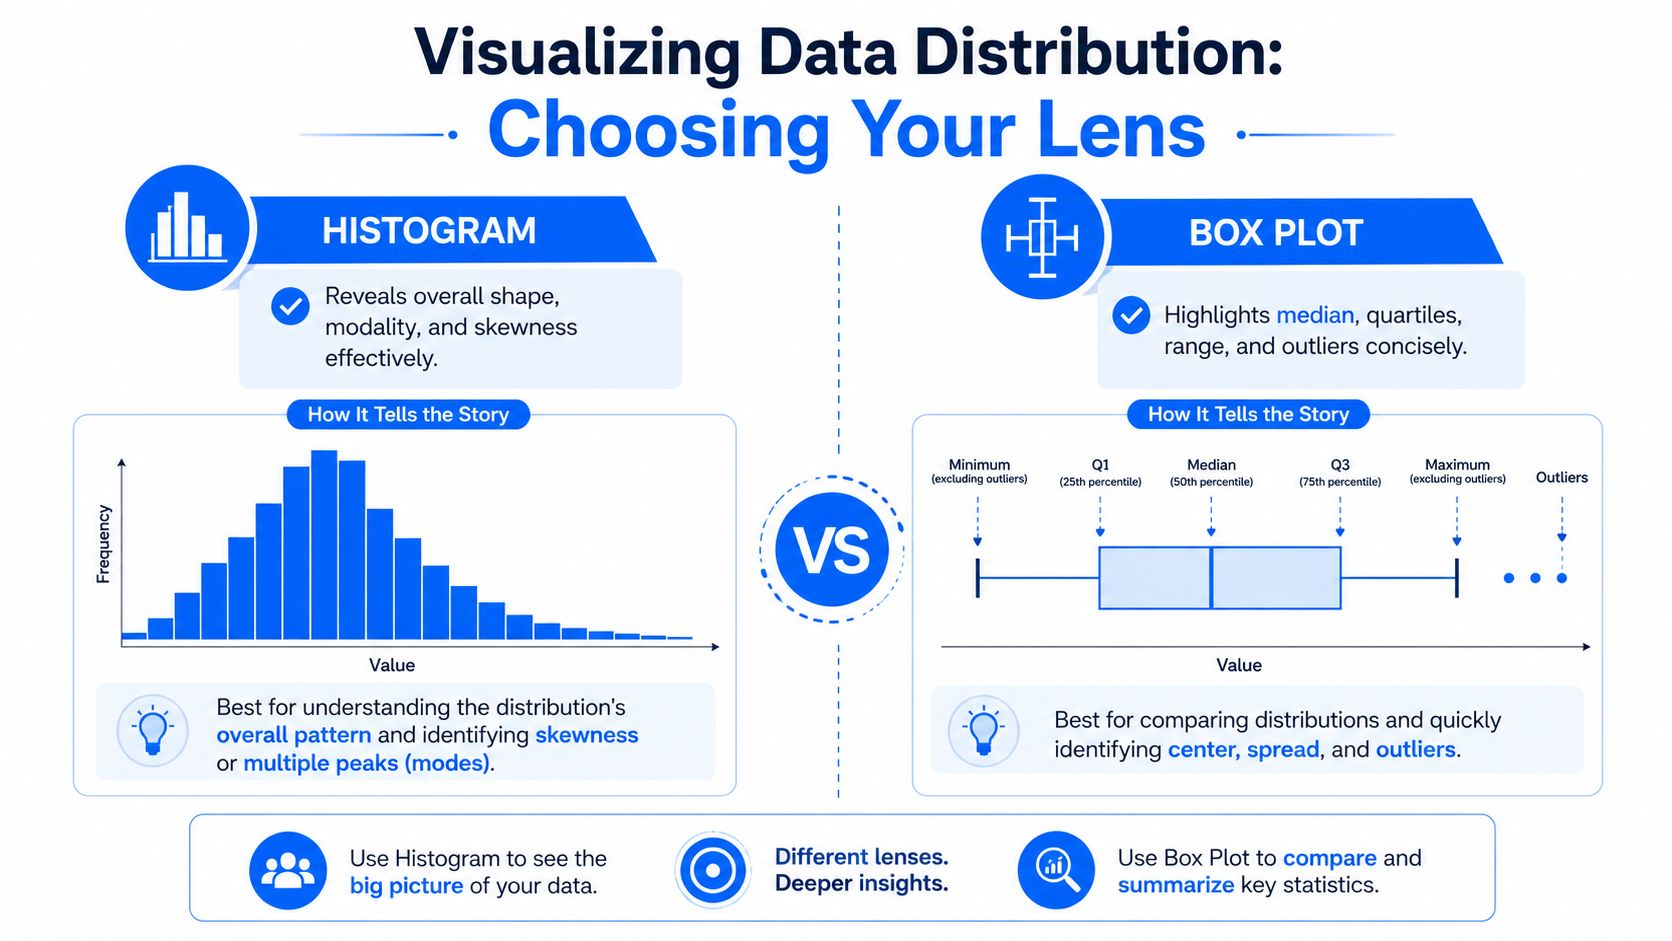
L'approccio migliore è abbinare il grafico alla domanda. Per confrontare più distribuzioni, i box plot sono superiori nel rappresentare le differenze di dispersione e nell'identificare i valori estremi. Un errore statistico comune è applicare in modo scorretto l'ampiezza dei bin dell'istogramma; l'ampiezza ottimale va scelta sperimentalmente per comunicare al meglio la forma della distribuzione, perché un binning inadeguato può mascherare pattern importanti (capitolo dei Pressbooks di Virginia Tech sulle distribuzioni quantitative).
Gli istogrammi mostrano la struttura, ma il binning può ingannare
Gli istogrammi restano lo strumento principale per vedere la forma. Sono efficaci nel rivelare asimmetria, modalità e densità approssimativa. Se dovete capire se un processo è unimodale o se due popolazioni si sono fuse in un'unica metrica, partite da qui.
L'ampiezza dei bin però può cambiare completamente la storia. Troppi pochi bin possono appiattire un pattern bimodale in un'unica gobba. Troppi bin possono far sembrare il rumore casuale una struttura significativa. Nell'analisi operativa, questo porta rapidamente a conclusioni errate.
Un workflow pratico per gli istogrammi:
Partite da una vista predefinita: fatevi un'idea approssimativa di simmetria, code e picchi.
Regolate manualmente i bin: verificate se il pattern apparente resiste ad ampiezze diverse.
Confrontate con un istogramma di baseline: il batch corrente rispetto ai dati storici recenti è spesso più utile di un singolo grafico.
Considerate la dimensione del campione: i dati sparsi appaiono spesso più frastagliati di quanto siano in realtà.
I box plot sono migliori per i confronti
Se la domanda è "Come si confronta oggi con la baseline?", usate un box plot. Comprime la distribuzione in quartili, mediana, dispersione e probabili outlier. È efficiente, soprattutto quando servono confronti affiancati tra tabelle, partizioni, sistemi sorgente o finestre temporali.
Nel monitoraggio di routine i box plot sono più utili degli istogrammi, perché permettono una lettura rapida:
Spostamento della mediana: il centro si è spostato.
Allargamento della scatola: la variabilità è aumentata.
Allungamento dei baffi: le code si sono allargate.
Punti isolati: sono comparsi valori estremi.
Quando i team confrontano distribuzioni attuali e storiche, i box plot di solito fanno emergere la differenza operativa più velocemente degli istogrammi.
Scalano anche meglio quando si confrontano molti gruppi. Cinque istogrammi in fila sono difficili da leggere. Cinque box plot si scorrono facilmente.
Violin plot e grafici di densità aggiungono sfumature
Istogrammi e box plot coprono la maggior parte dei casi di monitoraggio, ma a volte servono più dettagli sulla forma stessa. È lì che aiutano i violin plot e le sovrapposizioni di densità.
Un violin plot è utile quando volete il confronto compatto di un box plot ma anche vedere se i dati hanno più picchi o code pesanti. Le stime di densità kernel possono rendere la modalità più chiara di un istogramma grossolano, soprattutto quando il dataset è abbastanza grande da supportare lo smoothing.
Usateli con attenzione:
Scegliete i violin plot quando confrontate diverse distribuzioni con un possibile comportamento multimodale.
Usate le sovrapposizioni di densità quando volete confrontare direttamente la forma della baseline con quella attuale.
Evitate uno smoothing eccessivo, perché può cancellare picchi significativi.
Nel monitoraggio in produzione, raramente un solo grafico basta. La combinazione pratica è un istogramma per la forma grezza, un box plot per il confronto e una vista di densità o un violin plot quando sospettate una struttura nascosta.
Validare le ipotesi sulla distribuzione con i test statistici
L'ispezione visiva è necessaria, ma non sufficiente. Due analisti possono guardare lo stesso istogramma ed essere in disaccordo sul fatto che i dati siano abbastanza vicini alla normalità, che la coda sia significativa o che l'adattamento sia accettabile per il metodo che vogliono usare. È qui che aiutano i test statistici: impongono una regola decisionale.
I controlli visivi sono necessari ma non sufficienti
Partite dai grafici. Vi aiutano a individuare rapidamente i problemi di forma e colgono cose che un test può nascondere, come una multimodalità evidente o picchi isolati causati da un job a monte non funzionante. Ma quando passate da "descrivere questi dati" a "costruirci sopra una soglia, una carta di controllo o un modello", vi serve una validazione quantitativa.
Il pattern pratico è combinare la valutazione visiva con un controllo formale di bontà dell'adattamento. Per validare quantitativamente una distribuzione, combinate la valutazione visiva con statistiche di bontà dell'adattamento come il test di Anderson-Darling. Un p-value basso in questo test indica che l'ipotesi che i dati seguano la distribuzione specificata è errata, imponendo una rivalutazione del modello (SPC for Excel su come scegliere la distribuzione più adatta ai vostri dati).
Se lavorate in ambienti fortemente basati su fogli di calcolo prima di spostare la logica in un data warehouse o in un workflow basato su notebook, la guida di Breaker all'analisi in Excel è un ponte pratico per i team che validano ancora le ipotesi in Excel.
Usate i test per mettere alla prova le vostre ipotesi
Due test contano molto nella pratica quotidiana.
Shapiro-Wilk è il controllo standard della normalità quando volete sapere se un campione proviene probabilmente da una distribuzione normale. È un utile filtro prima di applicare metodi che presuppongono un comportamento a campana.
Anderson-Darling è più efficace quando volete valutare l'adattamento a una distribuzione specificata e vi interessa il comportamento delle code. Questo lo rende rilevante nel monitoraggio della qualità, dove le code contengono spesso gli incidenti.
Un modo semplice per interpretare il p-value è questo: se il p-value è basso, i dati non supportano abbastanza la vostra ipotesi. Dovreste smettere di forzare il modello e scegliere una descrizione migliore.
Ecco cosa funziona nella pratica:
Usate prima i grafici: istogrammi, box plot e confronti di tipo probabilistico colgono i problemi evidenti.
Usate Shapiro-Wilk per la normalità: ideale quando la domanda principale è "Posso trattarla come normale?"
Usate Anderson-Darling per l'adattamento: migliore quando la scelta della distribuzione determina le soglie o la logica degli alert.
Rivedete le statistiche di sintesi: se la normalità non regge, mediana e IQR diventano spesso la coppia più sicura.
I test statistici non dovrebbero sostituire il giudizio. Dovrebbero impedire ai team di fingere che un'ipotesi comoda sia un'ipotesi valida.
C'è un altro compromesso importante. Un dataset può non superare un test formale di normalità ed essere comunque sufficiente per alcuni usi pratici. La domanda giusta non è "È perfettamente normale?". È "Questa distribuzione è abbastanza vicina da supportare la soglia o il modello che sto per mettere in produzione?". È una domanda di produzione, non da aula universitaria.
Come identificare e interpretare outlier e asimmetria
Outlier e asimmetria sono il punto in cui molte strategie di monitoraggio sbagliano. I team sanno di dover tenere d'occhio le anomalie, ma applicano un'unica regola ovunque. Di solito questo significa usare la deviazione standard su dati che non sono mai stati vicini alla normalità.

Leggete l'asimmetria prima di scegliere una statistica di sintesi
L'asimmetria indica quale lato della distribuzione ha la coda più lunga. Nella pratica, i dati con asimmetria a destra sono comuni negli importi delle transazioni, nei tempi di esecuzione dei job, nella latenza delle API e in molte metriche operative. Un piccolo numero di valori molto grandi allunga la distribuzione.
Questo conta perché le medie possono diventare fuorvianti. Nei dati con asimmetria a destra, la media viene tirata verso l'alto. Nei dati con asimmetria a sinistra, viene tirata verso il basso. La mediana di solito regge meglio come descrizione di ciò che è tipico.
Una rapida guida all'interpretazione:
Asimmetria a destra: coda lunga sul lato alto. La media è superiore alla mediana.
Asimmetria a sinistra: coda lunga sul lato basso. La media è inferiore alla mediana.
Quasi simmetria: media e mediana sono spesso abbastanza vicine da raccontare una storia simile.
Scegliete la regola per gli outlier adatta ai dati
Il metodo efficace per i dati asimmetrici è la regola dell'IQR. Lo scarto interquartile (IQR) viene usato specificamente per identificare gli outlier nelle distribuzioni asimmetriche, dove la deviazione standard non è affidabile; gli outlier sono tipicamente definiti come valori inferiori a Q1 - 1.5×IQR o superiori a Q3 + 1.5×IQR. Questo metodo è più appropriato della regola empirica (68-95-99.7), che presuppone una distribuzione normale (articolo PMC sulla descrizione delle distribuzioni e sul rilevamento degli outlier).
Usate la regola dell'IQR quando:
I dati sono asimmetrici: le code non sono bilanciate, quindi la deviazione standard può trarre in inganno.
Vi aspettate valori estremi occasionali: la metà centrale offre un punto di riferimento più stabile.
Vi interessa un alerting affidabile: riduce i falsi positivi causati da dati con code pesanti.
L'alternativa più nota è la regola dei 3 sigma, adatta ai dati normali. Nel monitoraggio, significa segnalare i valori che si trovano oltre tre deviazioni standard dal centro atteso. È utile, ma solo quando l'ipotesi della curva a campana è difendibile.
Prima di chiedervi se un outlier è "reale", chiedetevi se la vostra regola per gli outlier corrisponde alla forma dei dati.
Nei sistemi live, l'interpretazione conta quanto il rilevamento. Un outlier può indicare un record malformato, un evento di business raro ma legittimo o l'inizio di un drift più ampio. Ecco perché il lavoro sulle anomalie dovrebbe collegare la logica della distribuzione ai workflow di root cause analysis. I team che hanno bisogno di questo livello operativo finiscono di solito per costruire o adottare strumenti dedicati alle anomalie nei dati, non solo report descrittivi statici.
Applicare l'analisi della distribuzione al monitoraggio continuo dei dati
Descrivere un singolo dataset è utile. Descrivere come una distribuzione cambia nel tempo è ciò che mantiene affidabili le pipeline.
In produzione la domanda non è "Qual è il centro e la dispersione di questa colonna?". È "Il centro si è spostato stamattina, la dispersione si è allargata questa settimana, la forma si è rotta rispetto alla baseline appresa?". Questo cambio di mentalità trasforma le statistiche descrittive in segnali di observability.
Trasformate le statistiche descrittive in segnali di monitoraggio
Il modo pratico per rendere operativa l'analisi della distribuzione è tracciare nel tempo il comportamento delle statistiche di sintesi. Invece di un singolo istogramma, mantenete una serie temporale di metriche come centro, dispersione, conteggi e quantili selezionati. Questo vi permette di rilevare gli spostamenti invece di limitarvi a descrivere delle istantanee.
Per le metriche con comportamento normale, una regola comune è semplice. Nel monitoraggio dei dati in serie temporale, una regola comune è segnalare i valori che superano di 3 deviazioni standard (±3σ) la media mobile. Questo copre circa il 99,7% dei punti dati normali in una distribuzione gaussiana, rendendo le deviazioni oltre questo intervallo outlier statisticamente significativi che segnalano un'anomalia (panoramica di digna sul monitoraggio delle anomalie).
Funziona bene per le metriche vicine alla gaussiana. Funziona male quando la metrica è asimmetrica, sparsa o multimodale. In questi casi, sintesi robuste e baseline consapevoli della distribuzione danno risultati migliori di un'unica soglia generica.
Prima la baseline, poi gli alert
Il pattern più solido per il monitoraggio continuo si presenta così:
Apprendete la baseline: capite com'è la variabilità normale per ogni metrica e tabella.
Tracciate il drift nel tempo: osservate i cambiamenti di centro, dispersione, forma e comportamento dei conteggi.
Applicate la regola giusta: usate soglie basate sulla normalità solo dove l'adattamento ha senso.
Esaminate i cambiamenti nel loro contesto: partizione, sistema sorgente, finestra di ingestion e storico dello schema contano tutti.
A questo punto, l'analisi statica della distribuzione diventa una disciplina di monitoraggio. Le stesse idee alla base di SOCS restano valide, ma ora vengono ripetute continuamente su batch, stream e cicli di business. Non state più solo descrivendo i dati. State descrivendo la salute del processo che li produce.
Se volete passare dall'analisi una tantum al monitoraggio continuo, digna - sito ufficiale è pensata per questo livello operativo. Aiuta i team a rilevare spostamenti di distribuzione, anomalie, modifiche di schema e problemi di timeliness all'interno del proprio ambiente, così da poter indagare sul comportamento dei dati prima che dashboard non funzionanti, report obsoleti o modelli instabili impongano di farlo.
Domande frequenti
Come si descrive la distribuzione di un dataset?
Descrivete quattro aspetti: la forma, che mostra come si comporta il processo; il centro, che mostra cosa è tipico; la dispersione, che mostra quanto è stabile; e gli outlier, che mostrano dove indagare. Riportare solo una media significa scartarne tre su quattro.
Quando conviene usare la mediana invece della media?
Usate la mediana quando la distribuzione è asimmetrica o contiene valori estremi, perché la media ne viene attratta. Il fatturato per cliente e i tempi di risposta sono casi classici in cui la media descrive un cliente che non esiste.
Qual è la visualizzazione migliore per mostrare una distribuzione?
Gli istogrammi rivelano la struttura, ma l'ampiezza dei bin scelta può nascondere o inventare mode, quindi variatela prima di fidarvi della forma. I box plot sono migliori per confrontare gruppi. Violin plot e grafici di densità aggiungono sfumature quando la distribuzione è multimodale e un box plot la appiattirebbe.
Perché il monitoraggio della distribuzione è importante per la data quality?
Perché una pipeline può superare ogni controllo a livello di riga mentre la sua distribuzione cambia silenziosamente. I conteggi delle righe sembrano normali e la freshness è a posto, eppure il fatturato per regione cambia forma perché una categoria a monte è stata rimappata. Solo il monitoraggio della distribuzione intercetta questa classe di guasti.
Qual è la differenza tra un outlier e uno spostamento della distribuzione?
Un outlier è un singolo valore lontano dagli altri e può essere legittimo. Uno spostamento della distribuzione è un cambiamento del pattern complessivo, in cui i singoli valori sembrano ancora plausibili. Gli outlier meritano un'ispezione; gli spostamenti indicano di solito che qualcosa è cambiato a monte.


