10 best practice di gestione dei database per il 2026
|
5
min di lettura
Oltre le basi: modernizzare la gestione dei database
Probabilmente i vostri database sono attivi. I backup vengono eseguiti. Gli indici esistono. La replica è attiva. Eppure le persone continuano a mettere in dubbio i numeri nelle dashboard, gli analisti trovano ancora join rotti dopo un rilascio e una pipeline in ritardo trasforma ancora una decisione mattutina in una supposizione. È la situazione tipica della gestione dei database in molte aziende oggi.
Un'infrastruttura stabile è solo il punto di partenza. Il problema più difficile è la fiducia. I team devono sapere che i dati che arrivano nel data warehouse sono completi, strutturalmente coerenti, puntuali e ancora allineati alla logica di business che i sistemi a valle danno per scontata. Quando questa fiducia si incrina, il danno raramente inizia con un'interruzione del servizio. Inizia con una modifica silenziosa dello schema, un caricamento mancante, un record malformato o una metrica che deriva quel tanto che basta per fuorviare un team per giorni.
Le best practice tradizionali di gestione dei database contano ancora. Servono ancora controllo degli accessi, disciplina nei backup, ottimizzazione delle query e pianificazione del ciclo di vita. Ma queste basi non coprono più le modalità di guasto che contano di più negli stack di dati moderni. L'osservabilità è passata da livello accessorio a principio operativo fondamentale.
Per questo i team migliori oggi considerano rilevamento delle anomalie, monitoraggio della puntualità, tracciamento dello schema e validazione a livello di record come parte integrante della gestione dei database, non come strumenti opzionali ai margini. Piattaforme come digna si inseriscono bene in questo cambiamento perché eseguono le analisi all'interno dell'ambiente del cliente, monitorano la qualità in modo continuo e offrono a ingegneri e utenti di business una visione condivisa di cosa è cambiato e perché è importante.
Questa guida si concentra sulle pratiche che mantengono affidabili i dati aziendali in condizioni operative reali.
Indice
1. Implementare il monitoraggio continuo della qualità dei dati
2. Eseguire la logica di qualità dei dati all'interno del database
3. Introdurre il tracciamento e la gestione delle modifiche allo schema
4. Monitorare la puntualità dei dati e i pattern di arrivo delle pipeline
5. Implementare regole di validazione dei dati a livello di record
6. Creare un'osservabilità unificata tra le piattaforme dati
7. Preferire il rilevamento delle anomalie basato sull'AI alle soglie manuali
8. Mantenere baseline di qualità dei dati e analisi storiche
9. Definire una chiara ownership dei dati e la responsabilità sulla qualità
10. Integrare la qualità dei dati nello sviluppo delle pipeline
1. Implementare il monitoraggio continuo della qualità dei dati
I controlli manuali a campione falliscono per lo stesso motivo per cui falliscono le revisioni di sicurezza manuali. Dicono cosa era vero in un dato momento, non cosa è cambiato dopo l'ultimo deployment, l'ultimo aggiornamento del sistema sorgente o l'ultima correzione notturna. Il monitoraggio continuo colma questa lacuna.
In pratica significa osservare costantemente i dataset critici alla ricerca di picchi di valori nulli, cambiamenti inattesi nelle categorie, record duplicati, relazioni interrotte, volumi sospetti e problemi di puntualità. Una banca potrebbe monitorare i flussi di pagamento per individuare comportamenti transazionali insoliti. Un ospedale potrebbe monitorare le cartelle dei pazienti per campi obbligatori mancanti e aggiornamenti in ritardo. Un team e-commerce potrebbe monitorare i feed di inventario affinché la disponibilità dei prodotti non si discosti da ciò che i clienti possono effettivamente acquistare.
Partire da dove i dati errati fanno più danni
Partite dalle tabelle che alimentano il reporting per il management, i sistemi rivolti ai clienti, i flussi di lavoro regolamentati o le feature di machine learning. Se una tabella può cambiare una decisione, innescare un'azione o creare un'esposizione in sede di audit, appartiene alla prima ondata di monitoraggio.
Un errore comune è cercare di monitorare tutto allo stesso modo. Questo genera rumore e indebolisce la disciplina di risposta. digna dà il meglio quando i team configurano rilevamento delle anomalie e validazione prima su un insieme mirato di tabelle ad alto valore, per poi estendere la copertura una volta stabilizzati ownership e schemi di alerting.
Date priorità agli asset critici per il business: monitorate i dataset di finanza, clienti, inventario e compliance prima delle tabelle di staging a basso impatto.
Definite livelli di gravità: un feed di regolamento fallito deve generare subito un alert. Una piccola modifica in una tabella sandbox può aspettare.
Assegnate presto i responsabili della risposta: ogni alert ha bisogno di un team e di un percorso di escalation, non di una casella di posta condivisa.
Rivedete regolarmente le regole: una regola di validazione che rispecchiava il business sei mesi fa oggi potrebbe essere sbagliata.
Regola pratica: se un problema, scoperto manualmente, porterebbe a convocare una riunione, dovrebbe già essere coperto da un monitoraggio automatico.
Il monitoraggio continuo cambia il comportamento dei team. Gli ingegneri smettono di discutere se qualcosa non va e iniziano a indagare quando è cambiato, dove è iniziato e chi deve intervenire.
2. Eseguire la logica di qualità dei dati all'interno del database
Molti programmi di qualità dei dati perdono credibilità perché dipendono dall'esportazione di dati sensibili verso strumenti esterni, dall'esecuzione dei controlli altrove e dal successivo reinserimento dei risultati nei flussi operativi. Questa architettura aggiunge latenza, rischi e punti di guasto.
Eseguire la logica di qualità all'interno del database è spesso l'opzione più pulita. Validazione, controlli sulle anomalie e calcolo delle metriche restano vicini ai dati, sfruttano l'esecuzione nativa ed evitano spostamenti superflui attraverso confini di rete e di sicurezza. Per i team di finanza, sanità, telecomunicazioni o pubblica amministrazione questo conta, perché i requisiti di privacy e di residenza dei dati non sono questioni marginali. Determinano l'architettura.
Ecco il modello visivo verso cui si stanno muovendo molti team:
Tenere la logica vicina ai dati
Quando un team sanitario valida i record protetti interamente all'interno di un data warehouse on-prem, riduce l'esposizione. Quando un operatore di telecomunicazioni valuta la qualità dei dettagli delle chiamate senza copiare i dati in un altro servizio, semplifica la governance. Lo schema è lo stesso: mantenere il calcolo dove il controllo è più forte.
digna è costruita attorno a questo modello. Il suo approccio di esecuzione nel database consente ai team di calcolare baseline, validazioni e controlli sulle anomalie all'interno di ambienti controllati dal cliente. In questo modo è più facile soddisfare i requisiti di sicurezza offrendo comunque agli utenti un'interfaccia operativa per trend, puntualità e problemi. Le ragioni architetturali sono illustrate bene nella guida di digna all'esecuzione della qualità dei dati nel database.
Usate le funzionalità native del database: viste materializzate, query pianificate e funzioni integrate di solito offrono prestazioni migliori rispetto a schemi di estrazione personalizzati.
Pianificate in modo intelligente: collocate i controlli più pesanti al di fuori delle finestre di picco della produzione quando i carichi di lavoro sono in competizione.
Tenete d'occhio l'impatto sulle risorse: l'esecuzione nel database è potente, ma query progettate male possono comunque interferire con i carichi di lavoro principali.
Documentate ogni calcolo: gli auditor e i futuri colleghi devono sapere come funziona un controllo e perché esiste.
Ciò che non funziona è distribuire la logica su cinque punti diversi. Il database applica una regola, la pipeline un'altra, il livello di BI una terza, e nessuno sa quale sia quella autorevole.
3. Introdurre il tracciamento e la gestione delle modifiche allo schema
Lo schema drift intacca la fiducia più rapidamente di quanto si pensi, perché all'inizio spesso sembra innocuo. Il tipo di una colonna cambia. Un team sorgente rinomina un campo. Un flag nullable si modifica. Nulla si blocca subito, ma la logica a valle inizia a comportarsi in modo diverso.
Gli analytics engineer se ne accorgono per primi quando un modello fallisce. Gli sviluppatori BI se ne accorgono quando un campo della dashboard rimane vuoto. I team ML se ne accorgono quando una feature non significa più ciò che il codice di training si aspetta. A quel punto la modifica dello schema è già arrivata in produzione.
Ecco il tipo di visibilità strutturale che dovrebbe essere lo standard:

Trattare lo schema drift come un evento operativo
I team dovrebbero monitorare le modifiche allo schema allo stesso modo in cui monitorano i job falliti. Colonne aggiunte, colonne rimosse, cambi di tipo, modifiche ai vincoli e alle partizioni meritano tutti visibilità quando riguardano asset critici. digna Schema Tracker si inserisce in questo modello operativo segnalando le modifiche strutturali, così che i team possano valutarne l'impatto prima che il problema si diffonda.
Il compromesso principale è tra velocità e controllo. I team di prodotto che si muovono rapidamente vogliono libertà di far evolvere i sistemi sorgente. I consumatori di dati hanno bisogno di prevedibilità. La via di mezzo è semplice: consentire il cambiamento, ma renderlo visibile, attribuibile e verificabile.
Le modifiche silenziose allo schema sono tra i problemi "piccoli" più costosi nei dati aziendali. Fanno perdere tempo agli analisti, creano una falsa sicurezza e rompono i sistemi molto prima che qualcuno apra un ticket.
Un buon modello operativo prevede un processo di approvazione leggero per le tabelle critiche, canali di notifica chiari e la rivalidazione automatica delle regole di qualità a valle quando la struttura cambia. Se un team sorgente aggiunge un nuovo campo di stato o cambia un tipo di dato in una tabella dei pagamenti, i responsabili a valle dovrebbero saperlo immediatamente. Non dopo una chiusura di fine mese fallita, e non quando un modello all'improvviso rende meno del previsto.
4. Monitorare la puntualità dei dati e i pattern di arrivo delle pipeline
Molte organizzazioni dicono di tenere alla freschezza dei dati. Meno sono quelle che definiscono cosa significhi "freschi". Per questo i dati obsoleti continuano a finire nelle dashboard live e nelle decisioni operative.
Monitorare la puntualità non significa solo verificare se un job è stato eseguito. Bisogna sapere quando i dati arrivano normalmente, quali ritardi sono accettabili e quali mettono a rischio il business. Un team retail può tollerare un breve ritardo nell'analisi del merchandising, ma non nei feed di disponibilità delle scorte. Una banca può accettare un caricamento in ritardo in un ambiente sandbox, ma non per i dati di regolamento di fine giornata usati nei flussi regolamentari.
La freschezza è un requisito di business
L'approccio utile è monitorare i pattern di arrivo, non solo le pianificazioni. Le pipeline raramente si comportano con perfetta regolarità. Alcune arrivano in anticipo, altre in ritardo, altre a ondate legate al comportamento dei sistemi a monte. digna Timeliness aiuta i team a tracciare le finestre di consegna attese, rilevare i ritardi e distinguere la variabilità di routine dagli incidenti reali.
Questa distinzione è importante. I team che generano alert per ogni minima deviazione sfiancano chi deve rispondere. I team che ignorano i cambiamenti nei pattern non colgono i primi segnali di colli di bottiglia sistemici.
Definite gli arrivi attesi per ogni dataset: dati finanziari in batch giornalieri, aggiornamenti orari delle vendite e flussi di eventi non dovrebbero condividere la stessa logica di freschezza.
Collegate i ritardi all'impatto sul business: una dashboard direzionale in ritardo è fastidiosa. Un feed antifrode in ritardo è pericoloso dal punto di vista operativo.
Gestite l'escalation in base alla criticità: alcuni problemi di puntualità vanno discussi in chat. Altri richiedono la gestione degli incidenti.
Usate i pattern di ritardo a fini diagnostici: ritardi ripetuti indicano spesso contesa di risorse a monte, deriva delle dipendenze o un'orchestrazione carente.
Uno dei cambiamenti più concreti nelle moderne best practice di gestione dei database è trattare i dati in ritardo come una modalità di guasto a tutti gli effetti. Se gli utenti possono interrogarli, daranno per scontato che siano aggiornati, a meno che non venga detto loro il contrario.
5. Implementare regole di validazione dei dati a livello di record
I controlli sui volumi e il monitoraggio dei trend sono necessari, ma non dicono se ogni singolo record abbia senso. È qui che molti team hanno ancora punti ciechi.
Una tabella può avere il numero corretto di righe ed essere comunque sbagliata in modi che contano. La data di dimissione di un paziente può precedere quella di ricovero. Una polizza può risultare attiva al di fuori del suo periodo di validità. L'importo di una transazione può violare la logica di business consentita senza essere statisticamente anomalo. Non sono problemi di formattazione. Sono errori semantici.
Validare il significato di business, non solo la forma
Le regole di validazione a livello di record codificano la logica che gli utenti di business danno già per vera. Per questo il lavoro dovrebbe essere condiviso. Gli ingegneri conoscono l'implementazione. I team di dominio sanno cosa significa un record valido.
digna Data Validation supporta questo livello applicando regole a livello di record definite dall'utente all'interno dell'ambiente del cliente. Questo la rende particolarmente adatta ai flussi di lavoro sensibili agli audit, in cui i team hanno bisogno di una validazione ripetibile legata alla logica di business e non solo di una profilazione generica.
Una buona regola di validazione è specifica, spiegabile e legata a un'azione. "La data di fine copertura non deve precedere la data di inizio copertura" è utile. "I dati dovrebbero sembrare normali" non lo è.
Documentate la motivazione di business: ogni regola dovrebbe spiegare perché esiste, non solo cosa controlla.
Partite dalle condizioni ad alto impatto: proteggete sinistri, pagamenti, cartelle cliniche e dati contrattuali prima delle dimensioni a basso rischio.
Prevedete eccezioni legittime: regole rigide senza percorsi di eccezione generano falsi errori e malcontento negli utenti.
Riportate i risultati all'ingegneria: gli errori di validazione rivelano spesso problemi di processo a monte, non solo righe errate.
Consiglio dal campo: se un business analyst riesce a spiegare una regola in una frase, di solito dovreste poterla implementare come validazione riutilizzabile.
Ciò che non funziona è tenere questi controlli nascosti in fogli di calcolo, notebook degli analisti o nella memoria collettiva. Se la regola conta, rendetela operativa.
6. Creare un'osservabilità unificata tra le piattaforme dati
I team aziendali raramente gestiscono un solo database e una sola pipeline. Gestiscono data warehouse, data lake, job di streaming, livelli di trasformazione, modelli semantici e archivi operativi. Ogni piattaforma mostra una parte della verità. Nessuna, da sola, offre il quadro completo.
Questa frammentazione rallenta la risposta agli incidenti. Il data engineer controlla i log di orchestrazione. L'analytics engineer controlla gli artefatti dbt. Il team BI controlla la freschezza delle dashboard. Il responsabile della piattaforma controlla lo storico dei caricamenti nel data warehouse. Tutti sono occupati e nessuno ha un contesto condiviso.
Questo è il modello di visibilità di cui i team hanno bisogno:
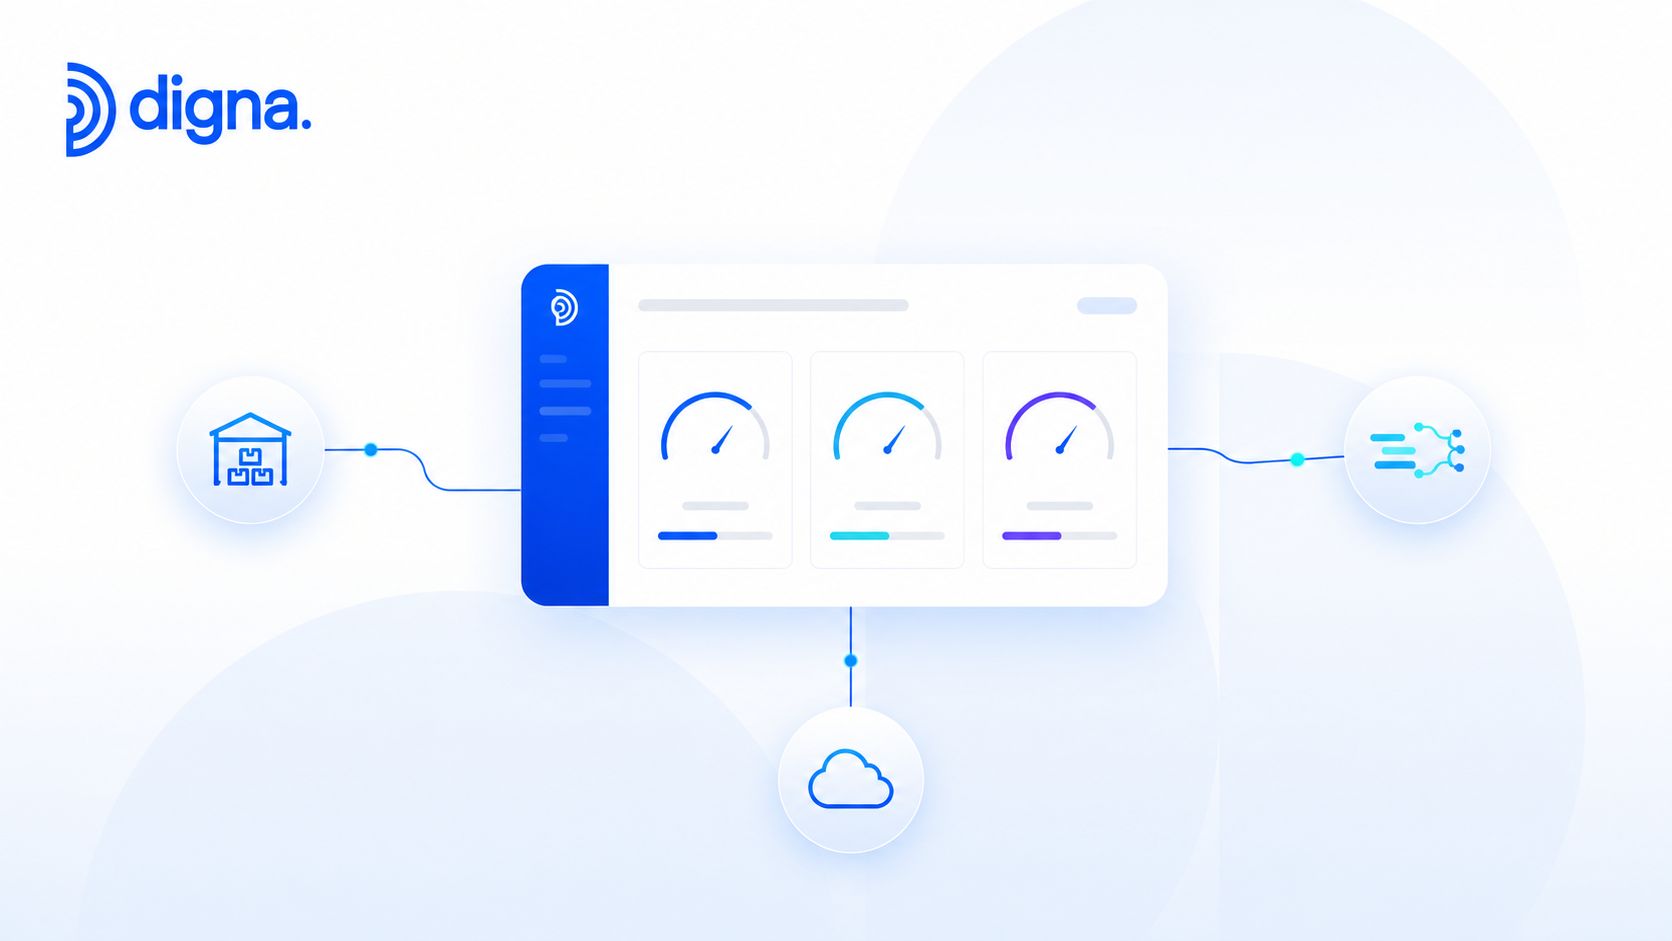
Una vista operativa unica batte cinque viste parziali
L'osservabilità unificata riunisce segnali di qualità, modifiche allo schema, indicatori di puntualità e analisi dei trend in un'unica superficie operativa. digna è progettata per questo ruolo. La sua interfaccia offre a data engineer, analisti e stakeholder una visione condivisa di anomalie, ritardi, validazioni e modifiche strutturali, senza costringere ogni utente a consultare log di sistema di basso livello.
La sfida non è solo l'integrazione tecnica. È la coerenza. Se ogni team assegna nomi diversi ai dataset, definisce la freschezza in modo diverso e usa etichette di gravità diverse, la dashboard diventa un'ulteriore fonte di confusione.
Un modello funzionante di solito prevede viste basate sui ruoli:
Gli ingegneri hanno bisogno di diagnostica: controlli falliti, schemi modificati, tabelle sensibili alle risorse, dipendenze a monte.
Gli analisti hanno bisogno di visibilità sull'impatto: quali dataset sono sicuri da usare, in ritardo o in fase di analisi.
I leader hanno bisogno dello stato operativo: dove la fiducia è solida, dove il rischio cresce e quali domini richiedono investimenti.
L'osservabilità unificata non risolve un'ownership inesistente o processi carenti. Ma elimina una scusa comune. Non si può correggere ciò che non si vede, né coordinarsi attraverso cinque strumenti di monitoraggio scollegati.
7. Preferire il rilevamento delle anomalie basato sull'AI alle soglie manuali
Le soglie statiche sembrano pratiche finché i vostri dati non iniziano a comportarsi come un vero business. Il traffico aumenta nei giorni di lancio. I pattern di pagamento cambiano in prossimità delle festività. L'utilizzo delle telecomunicazioni varia durante i disservizi o gli eventi locali. Una regola di alert codificata che funzionava lo scorso trimestre inizia a scattare di continuo oppure non rileva affatto i guasti più sottili.
Per questo le soglie manuali invecchiano male. Presuppongono che la normalità resti fissa. Non è così.
Ecco dove il rilevamento adattivo diventa utile:
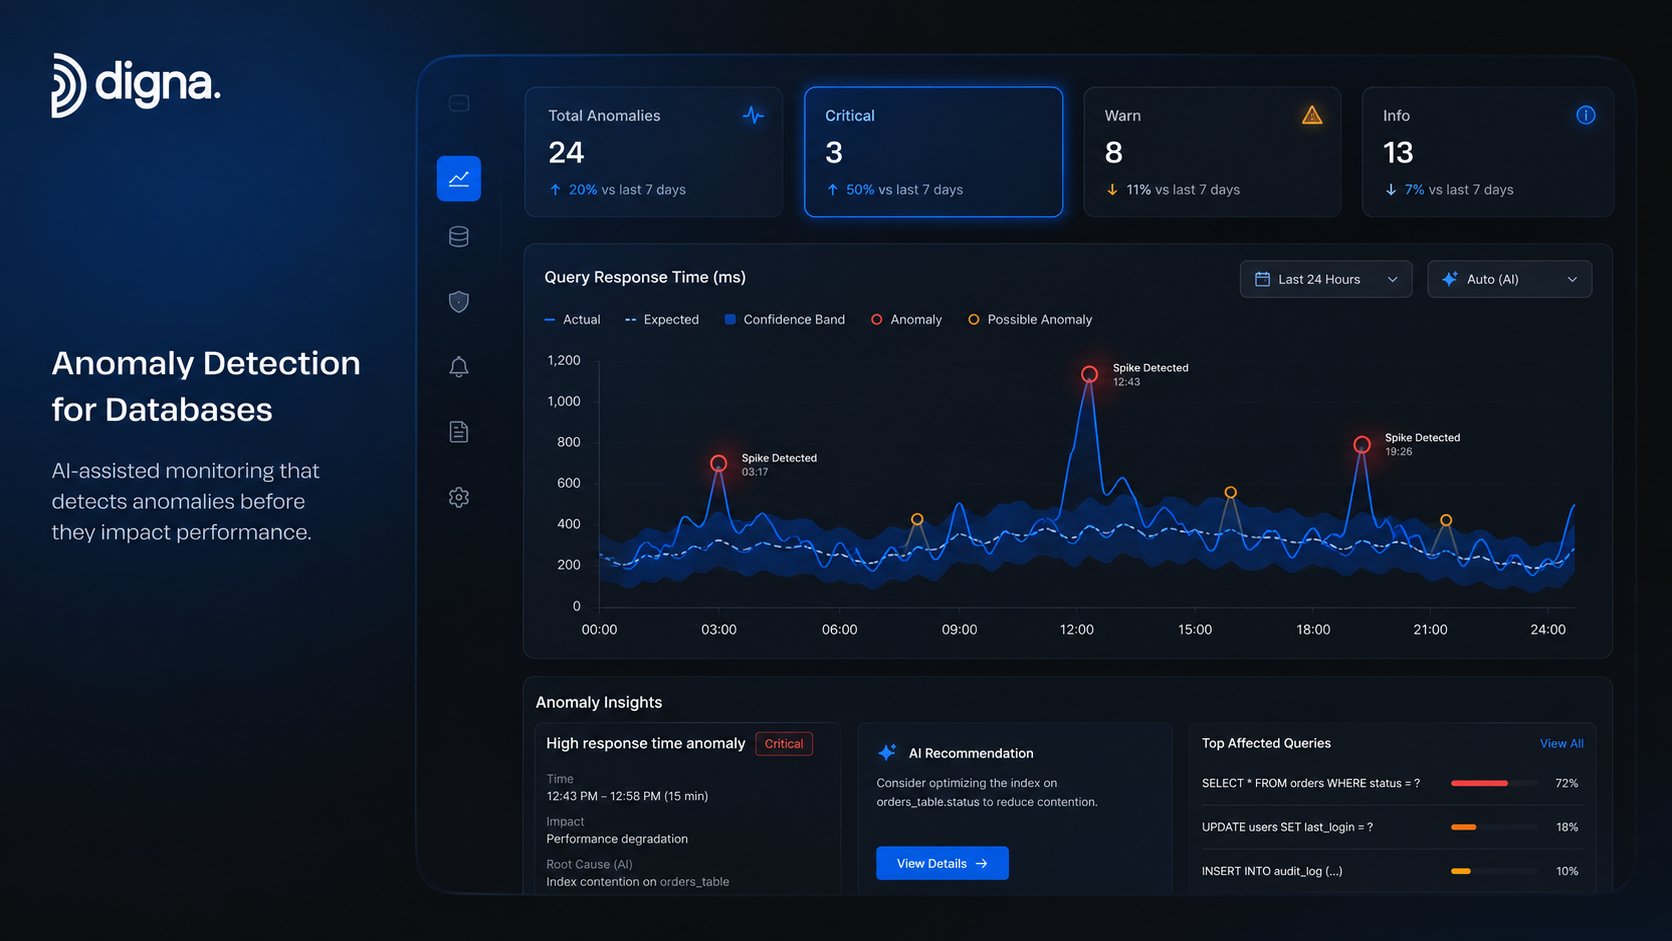
Le soglie statiche cedono nei sistemi dinamici
Il rilevamento delle anomalie basato sull'AI apprende il comportamento dai dati stessi. Riesce a tenere conto di pattern ricorrenti, baseline in movimento e varianza mutevole meglio di una pila di limiti tarati a mano. digna Data Anomalies è costruita attorno a questo approccio e combina il rilevamento basato sull'AI con metodi statistici, così che i team possano individuare cambiamenti inattesi senza mantenere una libreria crescente di regole fragili. Lo schema di implementazione pratica è descritto nell'articolo di digna sul rilevamento delle anomalie nelle serie temporali.
Questo non significa che ogni soglia debba sparire. Le soglie manuali hanno ancora senso per i limiti di business rigidi, come valori impossibili o scadenze contrattuali. Il modello giusto è a più livelli: regole statiche per gli stati non validi noti e rilevamento delle anomalie per i pattern che le persone non riuscirebbero a tarare bene a mano.
Non si sostituisce il giudizio operativo con i modelli. Si danno agli operatori segnali migliori, così che passino meno tempo a tarare gli alert e più tempo a risolvere problemi reali.
Un retailer può usare il rilevamento delle anomalie per intercettare variazioni sospette negli acquisti che potrebbero indicare una frode o un bug nel checkout. Un ospedale può rilevare pattern di ricovero insoliti che meritano un'indagine. Un operatore di telecomunicazioni può individuare deviazioni nelle metriche delle chiamate prima che i clienti segnalino problemi di servizio. Il vantaggio comune è un rilevamento più precoce dei segnali con meno alert fatigue.
8. Mantenere baseline di qualità dei dati e analisi storiche
Senza uno storico, ogni incidente sembra isolato. I team vedono un controllo fallito, indagano la causa immediata e vanno avanti. Così si risolve il problema di oggi, ma si perde il pattern che c'è dietro.
Le baseline forniscono un riferimento per il comportamento normale. L'analisi storica indica se la "normalità" è stabile, in deriva, stagionale o in graduale peggioramento. Questo contesto cambia il modo in cui i team rispondono. Un picco isolato viene gestito diversamente da un trend di qualità che peggiora da settimane.
Lo storico dà contesto agli incidenti
digna Data Analytics supporta questo tipo di analisi mettendo in evidenza trend, segnali in rapido cambiamento e pattern storici di osservabilità. È importante perché molti problemi in produzione non nascono come incidenti. Nascono come segnali deboli, ritardi ricorrenti, tassi di valori nulli in crescita o una varianza che si allarga lentamente senza che nessuno se ne accorga nell'operatività quotidiana.
I team finanziari possono studiare il comportamento delle transazioni nel tempo per individuare variazioni sospette nella qualità o nei processi. I team retail possono confrontare i pattern stagionali dell'inventario con i feed attuali per capire se le anomalie riflettono cicli di domanda o dati di input errati. I team di piattaforma possono esaminare lo storico di osservabilità di lungo periodo per individuare dove i colli di bottiglia continuano a ripresentarsi.
Una strategia di baseline pratica include la segmentazione. I domini dei clienti spesso si comportano in modo diverso. Le aree geografiche si comportano in modo diverso. Le linee di prodotto si comportano in modo diverso. Se si calcola un'unica baseline per tutto, si rischia di nascondere cambiamenti significativi all'interno di una media aggregata.
Conservate lo storico di osservabilità: i dati sui trend sono dati operativi. Trattateli come qualcosa che vale la pena conservare e analizzare.
Segmentate dove il comportamento differisce: separate le baseline per dominio, mercato, regione o carico di lavoro quando i pattern divergono.
Analizzate il deterioramento nel tempo: i lenti cali di qualità spesso contano più degli incidenti eclatanti di un solo giorno.
Usate lo storico per la pianificazione: la crescita di volumi, volatilità o ritardi dovrebbe influenzare le decisioni su architettura e personale.
I team che lo fanno bene smettono di reagire solo ai sintomi. Iniziano a riconoscere le modalità di guasto ricorrenti e a riprogettare il sistema di conseguenza.
9. Definire una chiara ownership dei dati e la responsabilità sulla qualità
La maggior parte dei problemi di dati irrisolti ha una causa tecnica e una causa organizzativa. La causa tecnica viene registrata per prima. Quella organizzativa emerge quando nessuno sa chi deve decidere, approvare, correggere o comunicare.
Un'ownership chiara accelera la risposta più di quanto potrà mai fare un'ulteriore dashboard. Se il ritardo di una pipeline incide sul reporting direzionale, qualcuno dovrebbe già essere responsabile del dataset, delle aspettative di qualità e del percorso di gestione dell'incidente. Se lo schema drift rompe un feature store, il team di ingegneria responsabile dovrebbe essere evidente senza una catena di messaggi inoltrati.
Gli alert hanno bisogno di nomi, non di caselle di posta
L'ownership deve essere visibile dove si svolge il lavoro. Inseritela nei metadati, nelle dashboard, nei runbook degli incidenti e nei payload degli alert. L'interfaccia unificata di digna supporta bene questo stile operativo, perché qualità, puntualità, anomalie e modifiche allo schema possono essere esaminate in un unico punto da chi deve intervenire.
Il compromesso qui è tra controllo centrale e ownership di dominio. Un team centrale di piattaforma dati può definire gli standard, ma non dovrebbe pretendere di comprendere ogni regola di business. I responsabili di dominio conoscono il significato dei dati. I responsabili della piattaforma sanno come monitorare e instradare i problemi. I buoni modelli operativi usano entrambi.
Assegnate esplicitamente i responsabili dei dataset: tabelle e pipeline critiche dovrebbero avere sempre responsabili di business e tecnici con nome e cognome.
Pubblicate l'ownership nelle viste di monitoraggio: chi risponde a un incidente non dovrebbe dover cercare nella documentazione.
Definite le sostituzioni: le persone vanno in ferie. L'ownership deve sopravvivere ai calendari.
Collegate la responsabilità alle routine: revisioni della qualità, incontri di governance e processi di delivery dovrebbero tutti rafforzare l'ownership.
Un modello che fallisce ripetutamente è l'ownership collettiva. Se tutti sono responsabili di un dataset, nessuno sente l'urgenza quando la qualità cala.
10. Integrare la qualità dei dati nello sviluppo delle pipeline
I team generano molte rilavorazioni evitabili quando trattano la qualità come un'attività successiva al deployment. Prima si rilascia la pipeline. La validazione arriva dopo. L'osservabilità arriva dopo il primo incidente. Poi gli ingegneri aggiungono a posteriori i controlli a un sistema che non era mai stato progettato per esporli in modo pulito.
Questo approccio aumenta i costi in ogni fase. I test diventano più difficili. La diagnosi degli incidenti richiede più tempo. Gli utenti di business perdono fiducia più velocemente di quanto l'ingegneria riesca a ricostruirla.
Integrare la qualità nella delivery, non dopo
Lo sviluppo di pipeline attento alla qualità inizia già in fase di progettazione. Data contract, regole di validazione, aspettative di puntualità e metriche di osservabilità dovrebbero stare accanto alla logica di trasformazione e alle definizioni di deployment. Gli analytics engineer che usano dbt, i team di orchestrazione che lavorano con Apache Airflow e i team ML che costruiscono pipeline di feature traggono tutti vantaggio dallo stesso principio: definire cosa significa "dati buoni" prima che sia la produzione a insegnarvi la risposta.
digna si adatta a questo modello perché copre rilevamento delle anomalie, tracciamento dello schema, monitoraggio della puntualità, apprendimento delle baseline e validazione a livello di record in un'unica piattaforma, eseguendo le analisi all'interno di ambienti controllati dal cliente. Ciò rende pratico integrare monitoraggio e aspettative di qualità nelle pipeline aziendali senza dover prima inviare i dati altrove.
Versionate le regole di qualità insieme al codice: se una trasformazione cambia, le aspettative correlate dovrebbero cambiare nello stesso flusso di revisione.
Fissate presto i criteri di accettazione: una pipeline non è pronta se nessuno ha definito i record validi, il comportamento di arrivo atteso e la gestione degli errori.
Automatizzate i test prima del rilascio: le pipeline CI dovrebbero intercettare le ipotesi errate prima che lo facciano i consumatori in produzione.
Create pattern riutilizzabili: librerie di validazione condivise e template di osservabilità standard riducono le divergenze tra i team.
Le migliori best practice di gestione dei database oggi includono la disciplina di sviluppo, non solo il controllo in fase di esecuzione. Se la qualità non fa parte del processo di build, l'operatività ne erediterà il costo in seguito.
Best practice per i database: confronto in 10 punti
Pratica | Complessità di implementazione 🔄 | Risorse necessarie ⚡ | Risultati attesi 📊 | Casi d'uso ideali | Vantaggi principali ⭐ | Consigli 💡 |
|---|---|---|---|---|---|---|
Implementare il monitoraggio continuo della qualità dei dati | Media–alta: infrastruttura, definizione delle regole, taratura continua | Moderate–elevate: piattaforma di monitoraggio, capacità di calcolo, tempo di ingegneria | Rilevamento più rapido dei problemi; minore impatto a valle; audit trail | Dataset mission-critical, ML in tempo reale, sistemi soggetti a compliance | Rilevamento precoce; meno revisioni manuali; osservabilità continua | Partire dalle tabelle critiche; usare alert a livelli e rilevamento delle anomalie con AI |
Eseguire la logica di qualità dei dati all'interno del database | Media: richiede competenze sui database e sviluppo SQL | Basse–moderate all'esterno, ma può aumentare calcolo e storage del DB | Latenza inferiore e minore spostamento dei dati; migliore residenza dei dati | Dati on-prem/regolamentati, PHI, ambienti GDPR/sovranità dei dati | Mantiene i dati al sicuro sul posto; sfrutta le prestazioni native del DB | Usare viste materializzate; pianificare i job pesanti fuori picco; monitorare il carico del DB |
Introdurre il tracciamento e la gestione delle modifiche allo schema | Media: servono flussi di governance e integrazioni | Moderate: strumenti per i metadati, canali di notifica, coordinamento tra sviluppatori | Rilevamento immediato dello schema drift; analisi d'impatto più rapida | Team con molti produttori di dati, utenti dbt, pipeline MLOps | Previene le interruzioni delle pipeline; supporta lineage e verificabilità | Integrare gli alert nei canali degli incidenti; documentare l'impatto sul business |
Monitorare la puntualità dei dati e i pattern di arrivo delle pipeline | Bassa–media: apprendimento delle baseline e configurazione delle pianificazioni | Moderate: pianificazione, alerting, conservazione dello storico | Rileva gli arrivi in ritardo; fa rispettare gli SLA; mantiene aggiornati i report | Reporting di fine giornata, dashboard operative, analisi sensibili ai tempi | Previene i dati obsoleti; fornisce avvisi tempestivi sui ritardi | Definire gli arrivi attesi dallo storico; distinguere i ritardi accettabili |
Implementare regole di validazione dei dati a livello di record | Media–alta: definire e mantenere le regole di business | Moderate: calcolo per la validazione e stesura delle regole | Garantisce la correttezza semantica; supporta compliance e audit | Settori regolamentati, dati transazionali, pipeline di ingestion | Intercetta errori logici che le statistiche non vedono; consente il rifiuto alla fonte | Partire dalle regole ad alto impatto; documentare la logica; prevedere eccezioni flessibili |
Creare un'osservabilità unificata tra le piattaforme dati | Alta: richiede integrazioni e standardizzazione delle metriche | Elevate: dashboard, connettori, impegno di ingegneria e integrazione | Visibilità olistica; triage più rapido; metriche correlate tra sistemi | Grandi aziende con stack eterogenei e molte pipeline | Riduce i cambi di contesto; centralizza la risposta agli incidenti | Creare dashboard basate sui ruoli; standardizzare i nomi delle metriche; integrare strumenti di IM |
Preferire il rilevamento delle anomalie basato sull'AI alle soglie manuali | Media: richiede addestramento e validazione dei modelli | Moderate: calcolo per i modelli, dati di training, competenze ML | Rilevamento adattivo delle anomalie con meno falsi positivi; individua variazioni sottili | Metriche ad alto volume e alta variabilità, casi d'uso antifrode | Si adatta alla stagionalità; riduce la taratura manuale; punteggi di confidenza | Partire dalle metriche ad alto volume; combinare i metodi; garantire la spiegabilità |
Mantenere baseline di qualità dei dati e analisi storiche | Media: modellazione delle baseline e conservazione a lungo termine | Moderate: storage per lo storico e strumenti di analisi | Rilevamento contestuale delle anomalie; individuazione dei trend; alert proattivi | Analisi longitudinali, capacity planning, rilevamento dei trend di frode | Rivela i trend; orienta la pianificazione delle risorse e l'analisi delle cause | Conservare almeno 3–6 mesi di storico; segmentare le baseline per business unit |
Definire una chiara ownership dei dati e la responsabilità sulla qualità | Bassa–media: cambiamenti organizzativi e documentazione | Basse: aggiornamenti di registro/metadati, onere di comunicazione | Risposta agli incidenti più rapida; escalation chiara; SLA allineati | Organizzazioni con responsabilità poco chiare o data product condivisi | Elimina le ambiguità; migliora coordinamento e responsabilità | Documentare i responsabili in modo centralizzato; includere l'ownership in dashboard e revisioni |
Integrare la qualità dei dati nello sviluppo delle pipeline | Media: richiede modifiche ai processi e alla CI/CD | Moderate: framework di test, infrastructure as code, tempo di collaborazione | Meno incidenti in produzione; minore debito tecnico; pipeline riproducibili | Nuove pipeline, progetti di trasformazione, ambienti guidati dalla CI | Intercetta presto i problemi; abilita test automatici e riutilizzo | Versionare le regole di qualità con il codice; aggiungere test CI; creare controlli riutilizzabili |
Dalla gestione alla padronanza: il futuro dei vostri dati
La gestione dei database è cambiata. Il vecchio modello considerava il database un'infrastruttura da mantenere. Il modello moderno lo considera un sistema di fiducia da gestire. È la differenza tra mantenere i dati disponibili e mantenerli utilizzabili.
Le pratiche descritte funzionano perché allontanano i team dalla pulizia reattiva. Il monitoraggio continuo intercetta i problemi vicino al punto di guasto, invece che dopo che si sono diffusi in dashboard, previsioni e modelli. L'esecuzione nel database mantiene i controlli più vicini alla fonte e riduce l'esposizione superflua. Tracciamento dello schema, monitoraggio della puntualità e validazione a livello di record rendono visibili i problemi nascosti prima che gli utenti di business li scoprano a proprie spese.
È anche qui che molti programmi aziendali maturano oppure si arenano. I team spesso investono molto in storage, orchestrazione e trasformazione, e poi investono troppo poco nell'osservabilità. Presumono che la fiducia nasca dalla sola buona igiene ingegneristica. Non è così. La fiducia si costruisce con un monitoraggio esplicito, un'ownership chiara, baseline visibili e cicli di feedback rapidi tra produttori e consumatori di dati.
Per questo l'osservabilità oggi fa parte di qualsiasi discussione seria sulle best practice di gestione dei database. Non è una categoria accessoria per grandi aziende con budget in eccesso. È il modo per gestire una piattaforma dati in modo responsabile quando reporting, automazione, compliance e machine learning dipendono tutti dagli stessi asset sottostanti.
Gli strumenti contano, ma l'architettura conta di più. digna è particolarmente adatta a questo modello operativo moderno perché combina rilevamento delle anomalie, analisi storiche, monitoraggio della puntualità, validazione a livello di record e tracciamento dello schema in un unico ambiente. Il suo approccio nel database è particolarmente rilevante per le organizzazioni che necessitano di un forte controllo su dove restano i dati e su come vengono eseguite le analisi di qualità. Per i team che operano in settori regolamentati o su infrastrutture controllate dal cliente, è un vantaggio concreto, non un dettaglio di marketing.
Il percorso di adozione non deve essere drastico. Partite da una tabella a cui le persone tengono e di cui non si fidano del tutto. Aggiungete il monitoraggio continuo. Definite le aspettative di puntualità. Tracciate le modifiche allo schema. Introducete la validazione a livello di record dove la logica di business conta. Rendete esplicita l'ownership. Poi estendete lo stesso schema al successivo asset critico. È così che crescono i programmi dati maturi nelle aziende reali: un dominio affidabile alla volta.
Se state valutando l'ecosistema più ampio delle operazioni sui dati abilitate dall'AI, l'articolo di Captapi sulle piattaforme dati con AI è un'utile lettura complementare.
I team che lo fanno bene smettono di passare le mattinate a discutere se un numero sia affidabile. Dedicano quel tempo a prendere decisioni con sicurezza. È questo il vero obiettivo. Non database perfetti, ma sistemi di dati affidabili di cui le persone si fidano anche sotto pressione.
digna aiuta i team a trasformare la gestione dei database in un'osservabilità continua all'interno del database. Se avete bisogno di rilevamento delle anomalie, validazione a livello di record, monitoraggio della puntualità, tracciamento dello schema e analisi storica dei trend in un ambiente controllato dal cliente, esplorate digna.
Per mettere in pratica la pratica 3 e trattare lo schema drift come un evento visibile, guardate come digna Schema Tracker rileva colonne aggiunte, rimosse e con tipo modificato.
Domande frequenti
Quali sono le best practice di gestione dei database più importanti per il 2026?
L'articolo ne elenca dieci: monitoraggio continuo della qualità dei dati, logica di qualità nel database, tracciamento delle modifiche allo schema, monitoraggio della puntualità, validazione a livello di record, osservabilità unificata, rilevamento delle anomalie basato sull'AI, baseline storiche, ownership chiara dei dati e qualità integrata nello sviluppo delle pipeline. Backup, controllo degli accessi e ottimizzazione delle query contano ancora, ma non coprono più le principali modalità di guasto.
Quali tabelle del database andrebbero monitorate per prime?
Partite dalle tabelle che alimentano il reporting direzionale, i sistemi rivolti ai clienti, i flussi di lavoro regolamentati o le feature di machine learning. Il criterio dell'articolo è semplice: se una tabella può cambiare una decisione, innescare un'azione o creare un'esposizione in sede di audit, appartiene alla prima ondata di monitoraggio. Monitorare tutto allo stesso modo genera rumore e indebolisce la disciplina di risposta.
Perché eseguire i controlli di qualità dei dati all'interno del database?
L'esecuzione nel database mantiene validazione, controlli sulle anomalie e calcolo delle metriche vicini ai dati, evitando esportazioni attraverso confini di rete e di sicurezza. L'articolo raccomanda funzionalità native come viste materializzate e query pianificate, l'esecuzione dei controlli più pesanti al di fuori delle finestre di picco, il monitoraggio dell'impatto sulle risorse e la documentazione di ogni calcolo per auditor e futuri colleghi.
Come andrebbero gestite le modifiche allo schema nei database di produzione?
Trattate lo schema drift come un evento operativo, monitorato come un job fallito. Colonne aggiunte o rimosse e modifiche a tipi, vincoli o partizioni sugli asset critici dovrebbero essere visibili, attribuibili e verificabili, supportate da un processo di approvazione leggero, canali di notifica chiari e dalla rivalidazione automatica delle regole di qualità a valle ogni volta che la struttura cambia.
Il rilevamento delle anomalie con AI dovrebbe sostituire le soglie statiche?
Non del tutto. L'articolo raccomanda un modello a più livelli: regole statiche per gli stati non validi noti, come valori impossibili o scadenze contrattuali, e rilevamento delle anomalie basato sull'AI per i pattern che le persone non riescono a tarare bene, come il traffico nei giorni di lancio o le variazioni dei pagamenti durante le festività. La sua tabella di confronto suggerisce di conservare da tre a sei mesi di storico o anche di più.