Automazione dei workflow di dati: guida pratica per il 2026
|
6
min di lettura

Circa il 60% delle aziende aveva già implementato l'automazione in almeno un workflow e l'80% delle organizzazioni prevedeva di mantenere o aumentare la spesa per l'automazione. Se le vostre pipeline girano in orario ma consegnano comunque dati errati, in ritardo o con uno schema alterato, il problema non è la pianificazione, è la fiducia.
È la parte che i team avvertono in produzione. Il DAG diventa verde, la dashboard si aggiorna e poi qualcuno in finance, negli analytics o nelle operations nota un numero che non corrisponde alla realtà, perché un feed sorgente è arrivato in ritardo, una colonna ha cambiato forma o una regola di validazione non è mai scattata. L'orchestrazione da sola può far avanzare il lavoro secondo i tempi previsti, ma non può garantire che i dati meritino ancora fiducia quando arrivano.
Indice
Perché l'automazione dei workflow di dati è in realtà una questione di fiducia
Una pipeline può rispettare ogni esecuzione programmata e tradire comunque chi ne dipende. Il guasto classico è silenzioso, non clamoroso: un report si aggiorna, il job termina senza errori e solo più tardi qualcuno scopre che una modifica allo schema, un file sorgente obsoleto o un caricamento parziale hanno spostato i numeri abbastanza da cambiare una decisione.
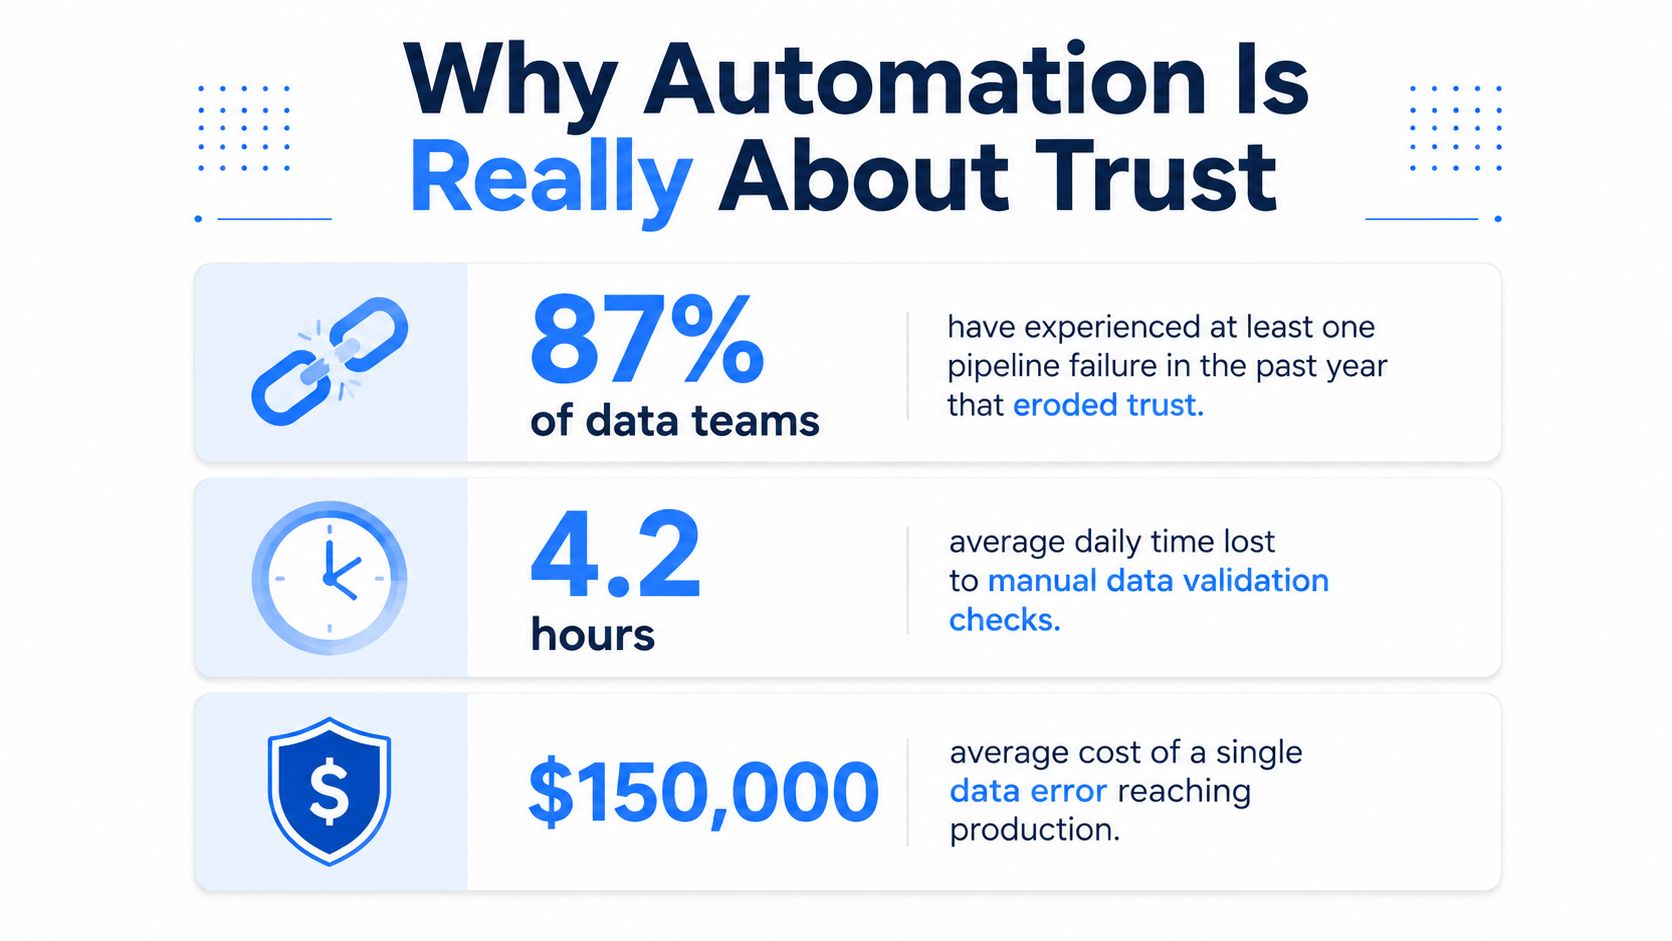
I migliori programmi di automazione non misurano il successo in base a quante poche persone toccano il workflow. Misurano se l'organizzazione riceve meno consegne in ritardo, errate o non affidabili. Questo inquadramento è importante perché il mercato ha chiaramente superato l'automazione amatoriale: l'automazione dei workflow è ormai una categoria strategica e non un espediente di efficienza puntuale, come confermano l'ampia adozione e i piani di spesa sostenuti riportati in un'analisi di settore basata su uno studio della Duke University del 2024 e su stime di mercato della stessa fonte statistiche sull'automazione dei workflow.
Che cosa mina la fiducia in produzione
Il problema nasce di solito da una di tre cose. Un feed arriva in ritardo, un sistema sorgente aggiunge o rimuove un campo, oppure una regola che sembrava ovvia in sviluppo si rivela ambigua nel processo di business.
Regola pratica: se il workflow può avere successo mentre i dati sono ancora sbagliati, non avete ancora automatizzato la cosa giusta.
Ecco perché l'automazione dei workflow di dati deve comprendere più della semplice pianificazione dei task. Le analisi di settore riportano che i processi automatizzati offrono tipicamente aumenti di produttività del 25-30% e una riduzione degli errori del 40-75%, mentre il 60% delle organizzazioni raggiunge il ROI entro 12 mesi statistiche e trend sull'automazione dei workflow. Sono numeri utili, ma in una piattaforma dati seria il vero ritorno è più evidente di un grafico sulla produttività: è l'assenza di danni silenziosi.
Il vero risultato è l'affidabilità
Un team dati che insegue solo la velocità spesso crea una modalità di guasto più raffinata. I job finiscono prima, ma le eccezioni continuano a sfuggire perché il workflow non è stato costruito per notare lacune di freschezza, derive dello schema o regole di business violate.
Le National Academies descrivono i motori di workflow scientifici come software che catturano una pipeline di analisi computazionale e offrono il tracciamento della provenienza, il che rende l'automazione dei workflow verificabile e non semplicemente più veloce la provenienza nei motori di workflow. Questa idea si applica perfettamente alle moderne operations sui dati: se non sapete dire che cosa è stato eseguito, con quali input e in quale ordine, state gestendo movimento, non fiducia.
Valutare i requisiti e mappare le sorgenti dati
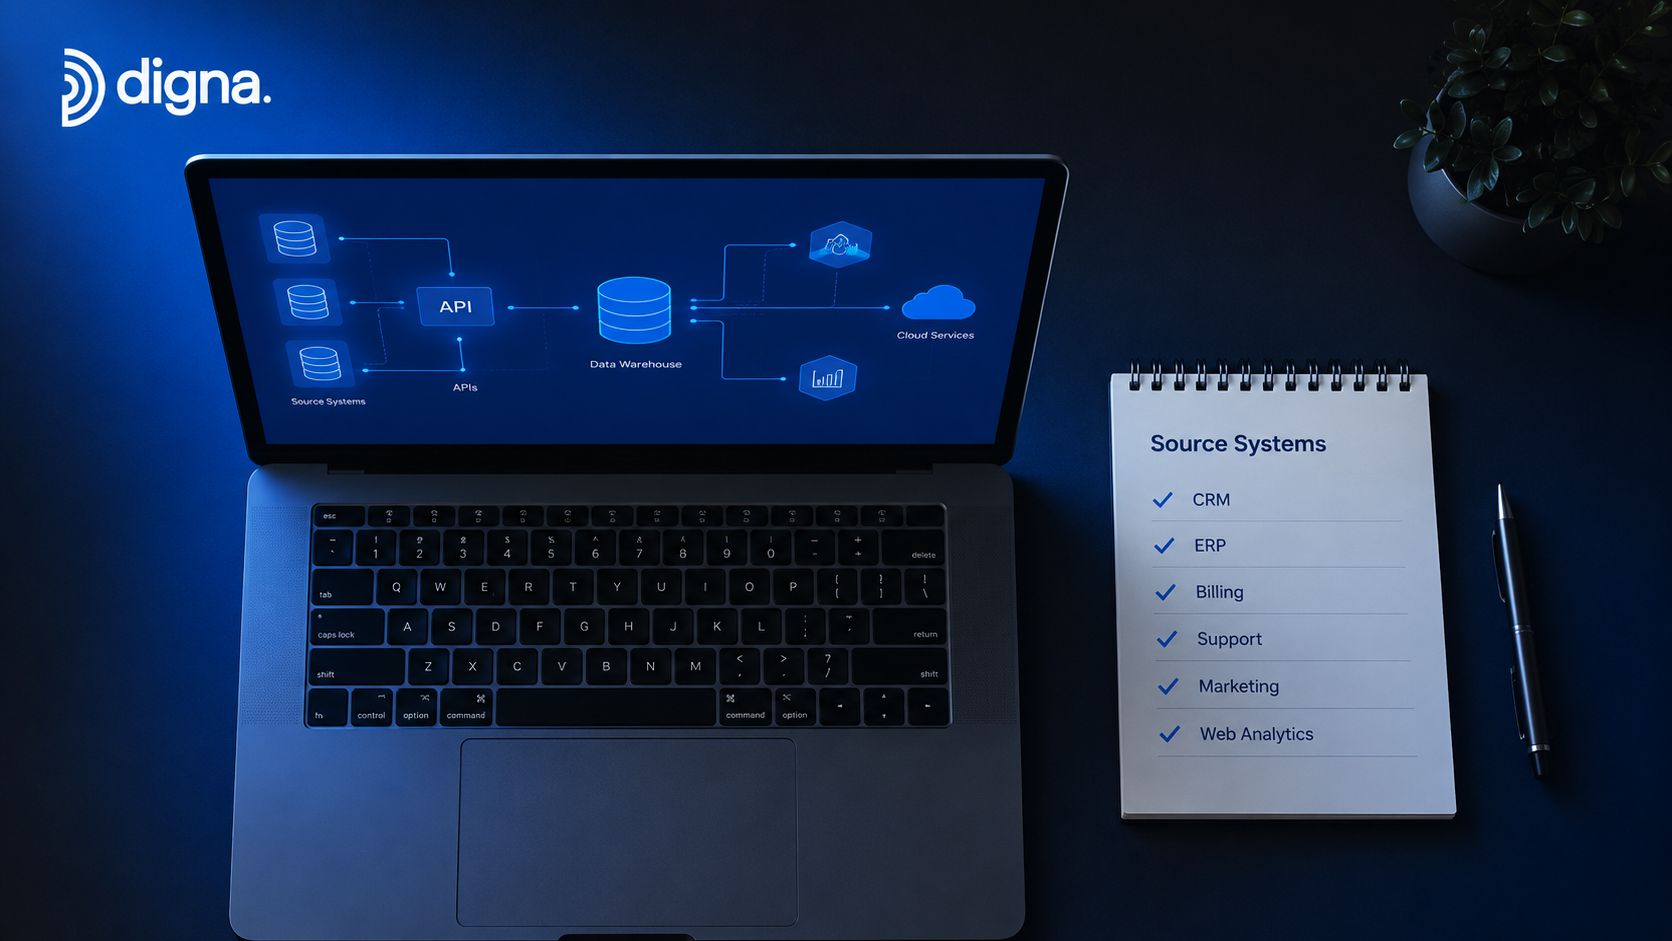
Partite dal workflow, non dalla piattaforma. Se il team non sa indicare i sistemi sorgente, le aspettative di latenza e il risultato di business che la pipeline protegge, l'automazione diventa una decorazione sopra la confusione.
Costruire l'inventario prima del workflow
Mappate ogni sistema sorgente che tocca la pipeline, poi classificate il contributo di ciascuno. Alcune sorgenti sono sensibili alla latenza e alimentano dashboard o decisioni operative. Altre sono più lente e devono solo essere corrette, non istantanee.
Un buon inventario comprende responsabilità, cadenza di aggiornamento, consumer a valle e la modalità di guasto più dannosa. Se un caricamento nel data warehouse manca una finestra di reporting, il problema è diverso da un backfill che arriva in ritardo ma comunque prima del ciclo di business successivo. Queste distinzioni orientano la progettazione dell'automazione più della scelta dello strumento.
Definire il risultato del processo in termini di business
La domanda giusta non è “che cosa possiamo automatizzare?”, ma “quale risultato deve proteggere il workflow?”. Potrebbe essere un report di compliance, una dashboard per i clienti, una chiusura contabile o una tabella di input per un modello.
Filtro utile: automatizzate end-to-end il processo con più attrito prima di disperdere gli sforzi in automazioni lasciate a metà.
Questo approccio è in linea con le indicazioni pratiche che raccomandano di misurare fin dal primo giorno cycle time, tasso di adozione, riduzione degli errori e impatto sui costi, per poi rilasciare un workflow in circa 30 giorni e validare la baseline prima di scalare guida all'automazione dei workflow enterprise. Preferisco vedere un solo workflow completamente strumentato piuttosto che tre automazioni collegate a metà di cui nessuno si fida.
Misurare i KPI che contano
Questi quattro KPI indicano se il workflow sta migliorando le operations o si limita a spostare ticket:
Cycle time: quanto tempo impiega il workflow dall'attivazione al completamento.
Tasso di adozione: se le persone utilizzano il percorso automatizzato.
Riduzione degli errori: se il nuovo workflow elimina i guasti evitabili.
Impatto sui costi: se l'automazione modifica i costi di manodopera, rilavorazione o ritardo.
Se un team non è in grado di misurare questi quattro numeri, non saprà se il workflow sta diventando più sano o soltanto più indaffarato. La fase di inventario impone questa disciplina prima che inizi la prima implementazione.
Scegliere tra orchestrazione ed esecuzione in-database
La decisione architetturale non riguarda se usare l'automazione, ma dove debba avvenire il lavoro: in un control plane che coordina i sistemi o all'interno del data warehouse, dove i dati già risiedono.
Dimensione | Piattaforme di orchestrazione | Esecuzione in-database |
|---|---|---|
Spostamento dei dati | Coordina più sistemi e può spostare dati tra di essi | Mantiene una parte maggiore del lavoro vicino ai dati |
Controllo operativo | Forte su pianificazione, dipendenze, retry e coordinamento tra sistemi | Forte località per trasformazioni e controlli |
Vendor lock-in | Dipende dal design della piattaforma e dalla profondità dell'integrazione | Spesso più legato all'ecosistema del data warehouse |
Gestione dei guasti | Adatta a retry, alerting e dipendenze esterne | Adatta all'esecuzione locale sui dati e alla riduzione degli spostamenti |
Postura di compliance | Può essere solida, ma dipende dal deployment e dal modello di accesso ai dati | Spesso più semplice quando i dati devono restare in sede |
Se il workflow coordina soprattutto più sistemi, l'orchestrazione va al centro. Se il lavoro consiste in gran parte in trasformazioni SQL, validazioni o controlli di qualità sulle tabelle del data warehouse, l'esecuzione in-database può eliminare spostamenti superflui e semplificare alcune modalità di guasto. Le configurazioni più fragili sono quelle che mescolano i due approcci senza un confine chiaro, perché a quel punto nessuno sa dove vivano davvero dipendenze, retry e logging.
Progettare il workflow come un sistema modulare
Un workflow resiliente ha bisogno di trigger espliciti, dipendenze tra task, logging strutturato ed esecuzione idempotente. Senza questi elementi, una riesecuzione fallita può creare scritture duplicate, caricamenti parziali o effetti collaterali confusi che richiedono più tempo per essere sistemati del problema originale.
Ho visto team cercare di nascondere la complessità dietro un unico DAG gigantesco. Sembra ordinato finché una modifica a monte non impone una pulizia manuale su più job a valle.
Scegliere lo schema adatto al vostro ambiente
Domanda decisionale | A favore dell'orchestrazione | A favore dell'esecuzione in-database |
|---|---|---|
Più sistemi devono essere coordinati? | Sì | No |
Il lavoro principale è una trasformazione basata su SQL? | A volte | Sì |
Lo spostamento dei dati è un costo o un rischio? | Forse | Di solito meno |
Il team ha bisogno di un livello di controllo separato? | Sì | A volte no |
Per un confronto dettagliato tra workflow di trasformazione e pipeline fortemente basate sulla pianificazione, leggete dbt e Airflow a confronto nella pratica. Il punto non è incoronare un vincitore, ma mantenere il workflow vicino al grafo delle dipendenze invece di far passare ogni job attraverso la stessa astrazione.
Integrare osservabilità e qualità nel workflow
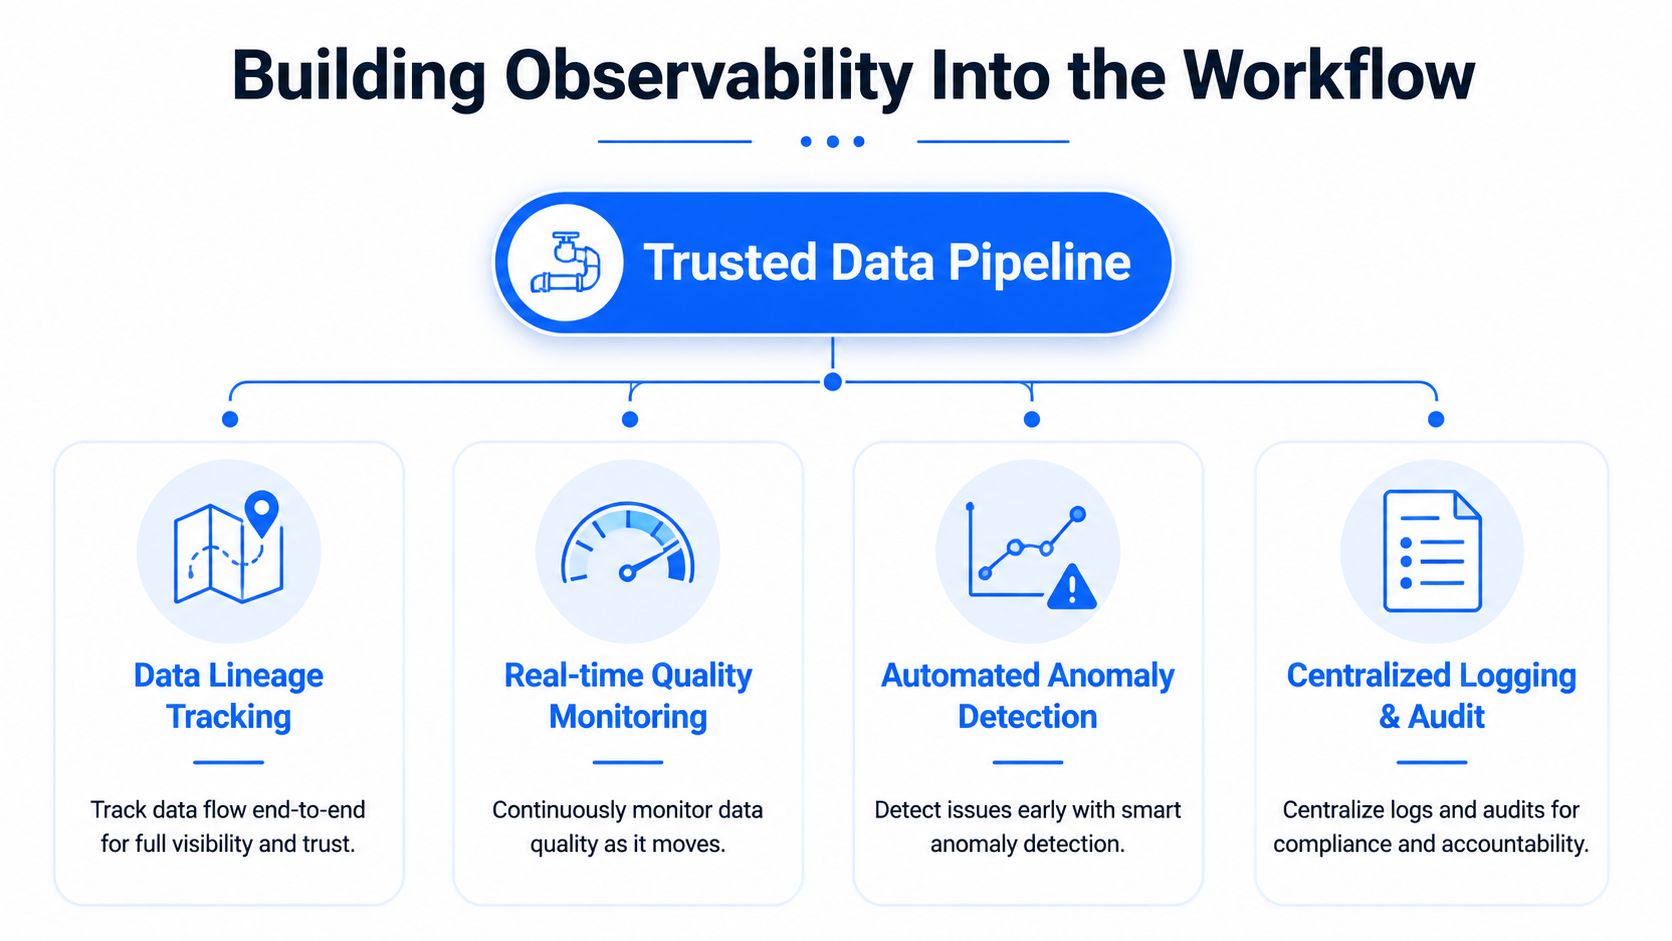
L'osservabilità va dentro il workflow, non accanto. Una pipeline che si limita a dirvi se un task è terminato con successo resta cieca proprio rispetto ai guasti che contano di più nelle operations sui dati.
I quattro segnali che intercettano i guasti reali
L'automazione moderna ha bisogno di quattro controlli diversi, perché intercettano classi di problemi diverse. Il rilevamento delle anomalie cerca derive silenziose nel comportamento, il monitoraggio della tempestività intercetta caricamenti in ritardo o mancanti, il tracciamento dello schema segnala le modifiche strutturali e la validazione a livello di record verifica le regole di business riga per riga.
Un feed sorgente in ritardo può sembrare a posto per l'orchestrazione, perché il task è stato comunque eseguito. È il monitoraggio della tempestività a far emergere il ritardo prima che il report a valle diventi obsoleto. Una modifica allo schema può superare la fase di estrazione e poi rompere una trasformazione più avanti. È il tracciamento dello schema a intercettare quel cambiamento prima che ci si fidi delle colonne sbagliate.
Associare il segnale alla modalità di guasto
In un caricamento nel data warehouse, spesso le modifiche allo schema emergono per prime. In una pipeline di reporting, la freschezza è di solito la prima cosa che gli utenti notano. Per i dati finanziari o di compliance, la validazione a livello di record è spesso l'ultima linea di difesa.
Per i team che vogliono un modello di osservabilità più ampio, conviene ancorare la data observability nelle pipeline di produzione al workflow operativo stesso. La lezione pratica è semplice: se un controllo non aiuta una persona a decidere cosa fare dopo, probabilmente è solo decorativo.
Una pipeline dovrebbe dirvi non solo che è fallita, ma anche se il guasto cambia la fiducia nell'output.
Che cosa intercettano davvero questi controlli
Rilevamento delle anomalie: intercetta spostamenti inattesi nelle distribuzioni che non necessariamente fanno fallire i job.
Monitoraggio della tempestività: intercetta i dati in ritardo che rendono obsolete le dashboard.
Tracciamento dello schema: intercetta campi aggiunti, rimossi o modificati prima che la logica a valle li interpreti male.
Validazione dei record: intercetta le violazioni delle regole di business che emergono solo esaminando direttamente le righe.
La differenza si vede nella velocità di individuazione della causa principale. Senza osservabilità, gli engineer passano il tempo a chiedersi se il problema stia nell'ingestion, nella trasformazione o nella sorgente stessa. Con i segnali giusti, il workflow li indirizza verso la zona di guasto più probabile prima ancora che parta la prima query manuale.
Deployment, sicurezza e residenza dei dati
Un workflow che sembra pulito in staging può comunque fallire sul piano politico o operativo se sicurezza e deployment sono stati trattati come un ripensamento. Negli ambienti regolamentati la domanda non è solo se il workflow funzioni, ma se i dati restino dove è consentito che restino.
Blindare gli accessi prima del rollout
Le credenziali delle pipeline richiedono una gestione chiara di identità e accessi. La proliferazione dei secret è uno dei modi più rapidi per trasformare un'automazione altrimenti solida in un grattacapo durante le revisioni di sicurezza, perché un workflow con accessi ampi può diventare difficile da verificare e ancora più difficile da ruotare in sicurezza.
Conta anche l'isolamento di rete. Se il livello di automazione può raggiungere tutto, tutto può diventare una dipendenza. Un perimetro stretto rende più facile ragionare su guasti e permessi.
Mantenere la residenza allineata all'ambiente
Per finance, sanità, telecomunicazioni e settore pubblico, il deployment in private cloud o on-prem conta spesso quanto la logica del workflow stessa. Se gli ambienti controllati dal cliente sono un requisito, l'architettura deve supportarli fin dall'inizio, non come adattamento successivo.
È anche qui che l'esecuzione in-database può aiutare, perché meno spostamenti di dati significano di solito meno questioni di residenza e meno percorsi esposti per i dataset sensibili. I team hanno comunque bisogno di audit log e change control, ma la posizione di compliance diventa più difendibile quando i dati non lasciano l'ambiente controllato.
Trattare la pre-produzione come un cancello, non come un ostacolo
Prima del rollout, il workflow dovrebbe superare una checklist breve ma seria:
Revisione delle identità: verificate chi può avviare, leggere e modificare la pipeline.
Gestione dei secret: verificate che i secret siano archiviati e ruotati in modo sicuro.
Audit logging: assicuratevi che modifiche ed esecuzioni siano tracciabili.
Isolamento degli ambienti: mantenete reali i confini tra sviluppo, test e produzione.
Verifica della residenza: confermate dove risiedono i dati durante l'esecuzione e l'archiviazione.
Questi cancelli impediscono che la sicurezza diventi una discussione d'emergenza a implementazione conclusa. Rendono inoltre ripetibile il ciclo di vita del workflow, che è ciò di cui i team regolamentati hanno più bisogno.
Alerting, runbook e salvaguardia del giudizio umano
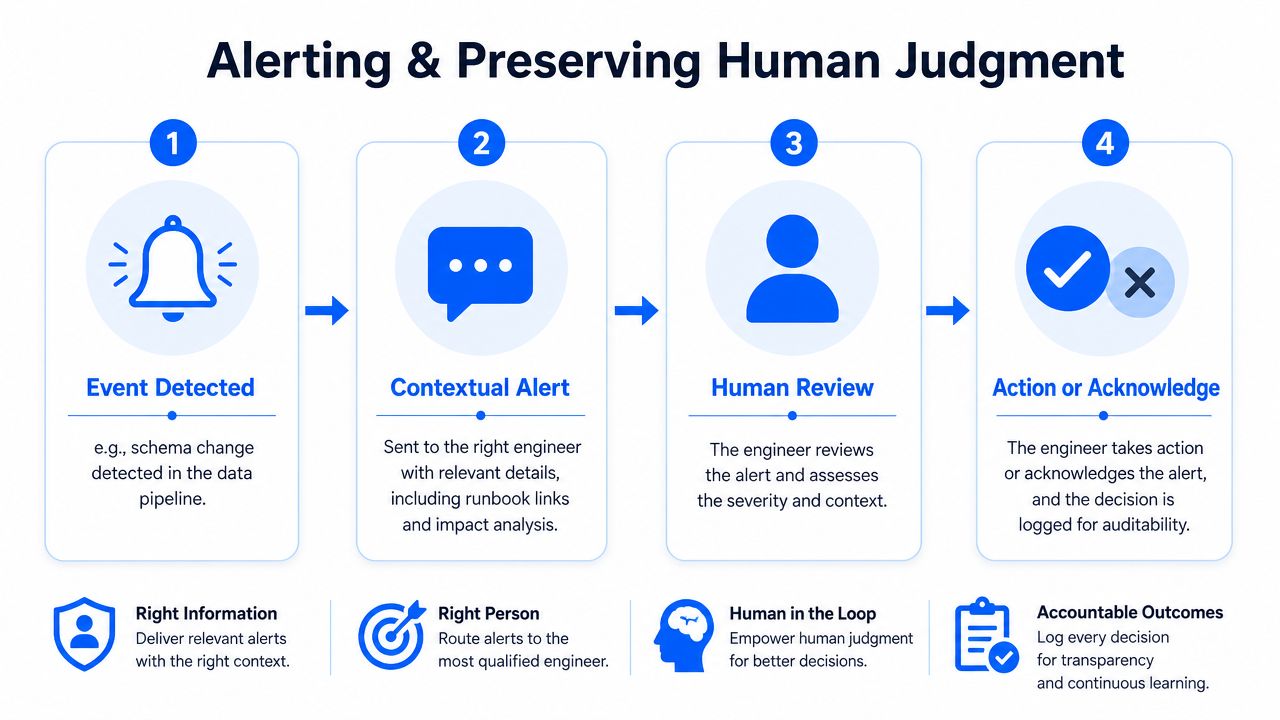
L'alerting fallisce quando tratta ogni task riuscito come un successo per il business. L'alert dovrebbe dire se è cambiata la fiducia nei dati, non solo se un job è terminato senza errori.
Allertare solo quando una persona deve intervenire
Gli alert giusti sono legati a risultati come violazioni della tempestività, rilevamento di modifiche allo schema o correttezza del reporting a valle. Se l'alert non richiede un'azione, di solito andrebbe registrato o instradato verso un canale a priorità più bassa, non spinto nella coda di reperibilità.
Questa distinzione previene la classica modalità di guasto dell'automazione, in cui le persone iniziano a ignorare il sistema perché suona l'allarme troppo spesso. Gli engineer non hanno bisogno di più rumore, ma di meno sorprese rilevanti.
Costruire i runbook attorno alla diagnosi, non solo all'escalation
Un buon runbook è breve, specifico e operativo. Dovrebbe indicare il segnale di rilevamento, le cause probabili, il primo passo diagnostico, il percorso di escalation e l'azione di ripristino.
Usate questa struttura:
Segnale: che cosa è scattato e come è stato rilevato.
Cause probabili: il piccolo insieme di fattori che di solito lo spiegano.
Primo controllo: la query di validazione o la verifica di sistema più rapida.
Percorso di escalation: chi è responsabile della decisione successiva.
Azione di ripristino: che cosa fare una volta confermata la causa.
È molto meglio di un vago avviso che dice “pipeline fallita”. L'engineer che legge l'alert dovrebbe sapere se controllare la sorgente, lo schema, la finestra di freschezza o la trasformazione a valle.
Mantenere le persone nel ciclo dove conta il giudizio
La ricerca sui workflow in ambito sanitario traccia una linea utile. I task frequenti e ben definiti, con regole decisionali semplici, sono buoni candidati all'automazione completa, mentre i task poco frequenti, con responsabilità mutevoli ed elevata complessità cognitiva, sono cattivi candidati il giudizio umano nell'automazione dei workflow. Questa linea è importante nel lavoro sui dati, perché la gestione delle eccezioni è spesso la parte meno deterministica del sistema.
Modifiche allo schema che rompono la compatibilità, controversie sulle regole di business e casi limite arrivati in ritardo dovrebbero mantenere percorsi di escalation espliciti. Se il team automatizza l'eccezione stessa, rischia di eliminare proprio il giudizio che mantiene resiliente la pipeline.
Un piano di rollout in 30 giorni e conclusioni
Scegliete un workflow con molto attrito, definite il risultato che protegge e strumentatelo prima di estendere l'approccio. Poi esaminate cycle time, tasso di adozione, riduzione degli errori e impatto sui costi al trentesimo giorno, perché sono i numeri che mostrano se il workflow ha migliorato l'affidabilità o ha solo cambiato il punto in cui si svolge il lavoro.
Il miglior business case per l'automazione dei workflow di dati è avere meno consegne in ritardo, errate o non affidabili. Non meno job manuali.
digna integra data quality e osservabilità nel workflow stesso, con controlli in-database su anomalie, tempestività, modifiche allo schema e validazione a livello di record. Se volete rendere le pipeline più affidabili senza portare i dati fuori dal vostro ambiente, visitate digna e scoprite come si inserisce in uno stack dati di produzione.
Poiché un feed sorgente in ritardo può lasciare verde il DAG mentre le dashboard diventano obsolete, scoprite come digna Timeliness monitora l'arrivo dei dati rispetto a pattern appresi anziché allo stato dei job.
Domande frequenti
Che cosa conta davvero nell'automazione dei workflow di dati?
Riguarda la fiducia più che la pianificazione. Un DAG può diventare verde mentre i dati sono in ritardo, errati o con uno schema alterato. L'articolo sostiene che il miglior business case sia avere meno consegne in ritardo, errate o non affidabili, non meno job manuali: per questo osservabilità e controlli di qualità vanno integrati nel workflow stesso.
Quando usare l'orchestrazione e quando l'esecuzione in-database?
Usate l'orchestrazione quando il workflow coordina principalmente più sistemi e richiede retry, dipendenze e controllo tra sistemi. Preferite l'esecuzione in-database quando il lavoro principale consiste in trasformazioni SQL, validazioni o controlli di qualità sulle tabelle del data warehouse, perché riduce gli spostamenti di dati. Evitate di mescolare i due approcci senza un confine chiaro per retry e logging.
Quali controlli intercettano i guasti che sfuggono a un'esecuzione riuscita della pipeline?
Quattro segnali: il rilevamento delle anomalie per gli spostamenti silenziosi nelle distribuzioni, il monitoraggio della tempestività per i caricamenti in ritardo o mancanti, il tracciamento dello schema per i campi aggiunti, rimossi o modificati e la validazione a livello di record per le violazioni delle regole di business. Un feed sorgente in ritardo può sembrare a posto per l'orchestrazione perché il task è stato comunque eseguito; il monitoraggio della tempestività fa emergere il ritardo.
Quali KPI monitorare per l'automazione dei workflow di dati?
Monitoratene quattro: il cycle time dall'attivazione al completamento, il tasso di adozione del percorso automatizzato, la riduzione degli errori e l'impatto sui costi di manodopera, rilavorazione o ritardo. L'articolo raccomanda di misurarli fin dal primo giorno, rilasciare un workflow in circa 30 giorni ed esaminarli tutti e quattro al trentesimo giorno prima di scalare.
Che cosa dovrebbe contenere un runbook per una pipeline di dati?
Un buon runbook è breve e costruito attorno alla diagnosi. Elenca cinque elementi: il segnale scattato, le cause probabili, il primo controllo, come la query di validazione più rapida, il percorso di escalation e l'azione di ripristino. In questo modo l'engineer sa se controllare la sorgente, lo schema, la finestra di freschezza o la trasformazione a valle.


