Archiviazione dei dati: la vostra guida 2026
|
7
min di lettura

Il vostro archivio contiene probabilmente già dati che nessuno apre da mesi, forse da anni. Restano su costosi storage primari, rallentano i sistemi operativi e continuano a comparire nelle revisioni di governance come “conservati”, anche se nessuno sa dire con certezza se siano ancora leggibili, completi o comprensibili.
È questo il problema pratico dell'archiviazione dei dati. Molti team sanno spostare i dati fuori dalla produzione. Pochi sanno dimostrare che l'archivio sarà ancora utilizzabile quando l'ufficio legale lo richiederà, un auditor lo contesterà o un team di ML avrà bisogno di recuperare vecchi dati di training con il loro significato originale intatto.
Un buon archivio non è una discarica. È un ciclo di vita gestito, un controllo di compliance e una sfida di affidabilità a lungo termine.
Indice
Che cos'è l'archiviazione dei dati e perché non è un backup
Pensate all'archivio come a un deposito di documenti
Un database attivo è come un ufficio operativo. I team usano i fascicoli ogni giorno, aggiungono nuovi documenti, rivedono quelli vecchi e si aspettano un accesso rapido. Un archivio è invece il deposito documentale sicuro e decentrato. Vi si sposta il materiale perché il lavoro quotidiano non ne dipende più, mentre il suo valore legale, finanziario, analitico o storico rimane.
Questa distinzione è importante perché l'archiviazione dei dati è una decisione sul ciclo di vita, non una semplice operazione di storage. Si identificano i dati inattivi, li si conserva in forma controllata e li si mantiene recuperabili secondo regole definite. L'archivio diventa il luogo in cui i record storici risiedono intenzionalmente.
I backup risolvono un problema diverso. Un backup è una copia di ripristino dei sistemi attivi. Lo si usa quando i dati di produzione vengono cancellati, corrotti o diventano indisponibili. Supporta il ripristino operativo, non la gestione documentale a lungo termine.
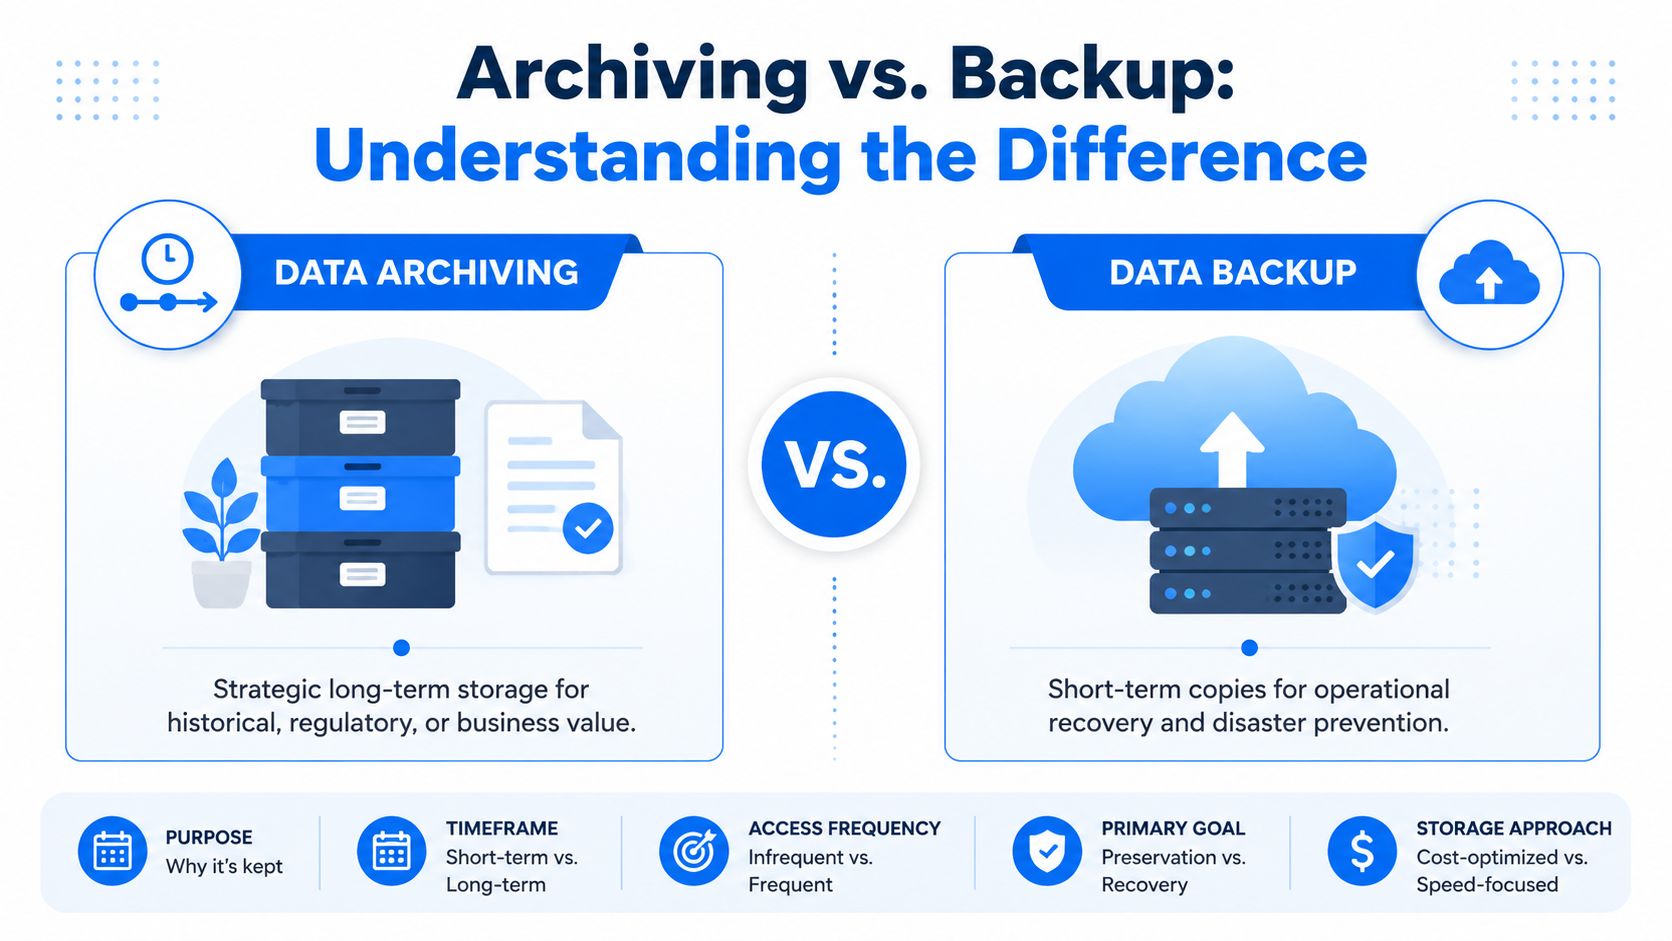
Differenza fondamentale: gli archivi conservano i dati storici come record ufficiale. I backup conservano copie ripristinabili dei sistemi correnti.
Se trattate i backup come archivi, ereditate il modello di conservazione sbagliato, il modello di indicizzazione sbagliato e di solito anche il percorso di accesso sbagliato. Ripristinare un vecchio backup per rispondere a una domanda di compliance è lento, invasivo e difficile da difendere. Se trattate gli archivi come backup, il ripristino vi deluderà, perché gli archivi di norma non sono progettati per il ripristino rapido di interi sistemi.
Dove i team sbagliano
L'errore più comune è chiamare archivio qualsiasi “cold storage”. Non lo è. I dati diventano archiviati solo quando hanno una policy, un responsabile, una logica di conservazione, aspettative di recupero e un motivo documentato per essere conservati.
Un secondo errore è lasciare i dati storici nel sistema transazionale perché “lo storage costa poco”. Lo storage primario non è l'unico costo. Tabelle operative di grandi dimensioni incidono sulle finestre di manutenzione, sul comportamento delle query, sulla crescita degli indici, sulle modifiche allo schema e sull'impegno di migrazione. I dati vecchi complicano anche il lavoro sulla qualità dei dati, perché gli ingegneri perdono tempo a separare i difetti reali dalla storia ormai obsoleta.
Una regola pratica aiuta:
Archiviate quando l'attività di business è conclusa: i dati hanno ancora un valore legale, analitico o storico.
Fate il backup quando conta il ripristino: i dati fanno parte di un sistema attivo che potreste dover ripristinare.
Cancellate quando la conservazione scade: i dati non hanno più un motivo difendibile per esistere.
I team che fanno le cose per bene prendono poi decisioni di progettazione migliori. Scelgono i livelli di storage in base ai pattern di accesso, non all'abitudine. Costruiscono metadati per la ricerca. E smettono di confondere gli strumenti di disaster recovery con la gestione documentale.
Scegliere il livello di storage per l'archivio
Il tiering dello storage decide se l'archiviazione dei dati fa risparmiare o si limita a spostare i costi. Il livello giusto dipende da tre fattori: con quale frequenza i dati verranno recuperati, quanto velocemente qualcuno ne avrà bisogno e quanto costa conservarli lì fino a quel giorno.
Livelli di archiviazione dei dati a confronto
Livello | Caso d'uso tipico | Tempo di recupero | Costo di storage |
|---|---|---|---|
Archivio hot | Dati storici usati regolarmente per analisi, indagini o consultazioni di servizio | Rapido | Il più alto tra i livelli di archivio |
Archivio nearline | Dati conservati per accessi di business occasionali o audit periodici | Moderato | Intermedio |
Archivio cold o deep | Conservazione normativa, record legacy, pratiche chiuse e dataset recuperati di rado | Il più lento | Il più basso |
Sembra semplice, ma il compromesso raramente si riduce a “velocità contro prezzo”. I pattern di recupero orientano a monte le decisioni architetturali. Se l'area finance ha bisogno ogni mese dei record dei periodi precedenti, il deep archive è di solito la risposta sbagliata, anche se il prezzo della capacità sembra interessante. Se l'ufficio legale recupera un piccolo sottoinsieme una volta ogni diversi anni, il cold storage è spesso la scelta più razionale.
Come assegnare i dati al livello giusto
Partite dal comportamento di accesso reale, non da ciò che le persone dicono che potrebbe servire un giorno. La frequenza di recupero futura viene spesso sovrastimata, e questo spinge troppi dati verso livelli costosi.
Un approccio pratico di mappatura è il seguente:
Usate l'archivio hot per la storia vicina all'operatività: ad esempio consultazioni del customer support, confronti BI ricorrenti o transazioni chiuse di recente.
Usate il nearline per recuperi intermittenti: adatto a reportistica dipartimentale, indagini e supporto agli audit programmati.
Usate il cold o deep archive per i dati conservati principalmente per obbligo: ideale per i record conservati soprattutto perché la policy lo richiede.
L'economia del recupero conta quanto quella dello storage. Una capacità economica diventa costosa quando il team sbagliato deve aspettare sul livello sbagliato.
È anche il punto in cui la progettazione della piattaforma incontra l'architettura analitica. Se il vostro team sta ancora decidendo cosa debba stare in un warehouse, in un data mart o in un archivio a lungo termine, questo confronto tra data lake e data mart è utile perché chiarisce quali dataset devono restare analiticamente attivi e quali devono passare ai livelli di archivio.
Due pratiche aiutano a evitare decisioni di tiering sbagliate:
Separate la conservazione legale dall'utilità analitica. Un dataset può essere obbligatorio per legge ma analiticamente morto.
Verificate i percorsi di recupero prima della migrazione. Se ripristinare i dati richiede ticket manuali, script non documentati o un unico ingegnere che conosce la convenzione dei percorsi degli oggetti, il vostro tempo di recupero reale è peggiore di quello dichiarato dal fornitore dello storage.
Un buon tiering non consiste nel mettere la copia più economica da qualche parte lontano. Consiste nell'allineare valore, accesso e attrito operativo. Quando i team lo fanno, gli archivi restano sostenibili nei costi senza diventare invisibili.
Progettare un'architettura di archiviazione resiliente
L'architettura deve applicare le policy anche quando le persone se ne dimenticano. Ciò significa automazione, immutabilità dove serve e una progettazione adatta sia alla compliance sia alla realtà operativa.
Partite dall'automazione del ciclo di vita
Il pattern più solido è una pipeline di archiviazione guidata da policy. I dati inattivi escono dalle piattaforme primarie verso livelli di object storage dedicati, come cold o deep archive. L'immutabilità viene applicata a livello di storage con WORM o object lock. Per molti casi d'uso regolamentati non è un optional.
Una formulazione chiara arriva dalle indicazioni di Scality sulle best practice di archiviazione dei dati guidata da policy: l'archiviazione dei dati richiede un ciclo di vita automatizzato e guidato da policy, in cui i dati inattivi vengono spostati su livelli di object storage dedicati con immutabilità WORM o object lock applicata a livello di storage, per soddisfare obblighi normativi come la SEC Rule 17a-4. Questa architettura riduce i costi dello storage primario del 40–60%, garantendo audit trail a prova di manomissione e il rispetto delle policy di residenza dei dati in più regioni.
Questa frase coglie l'obiettivo centrale della progettazione. Non state semplicemente spostando dei bit. Li state spostando secondo regole di conservazione e immutabilità applicabili.
Costruite un'architettura ibrida in modo consapevole
La maggior parte degli ambienti maturi finisce per diventare ibrida, anche se parte da un semplice archivio cloud.
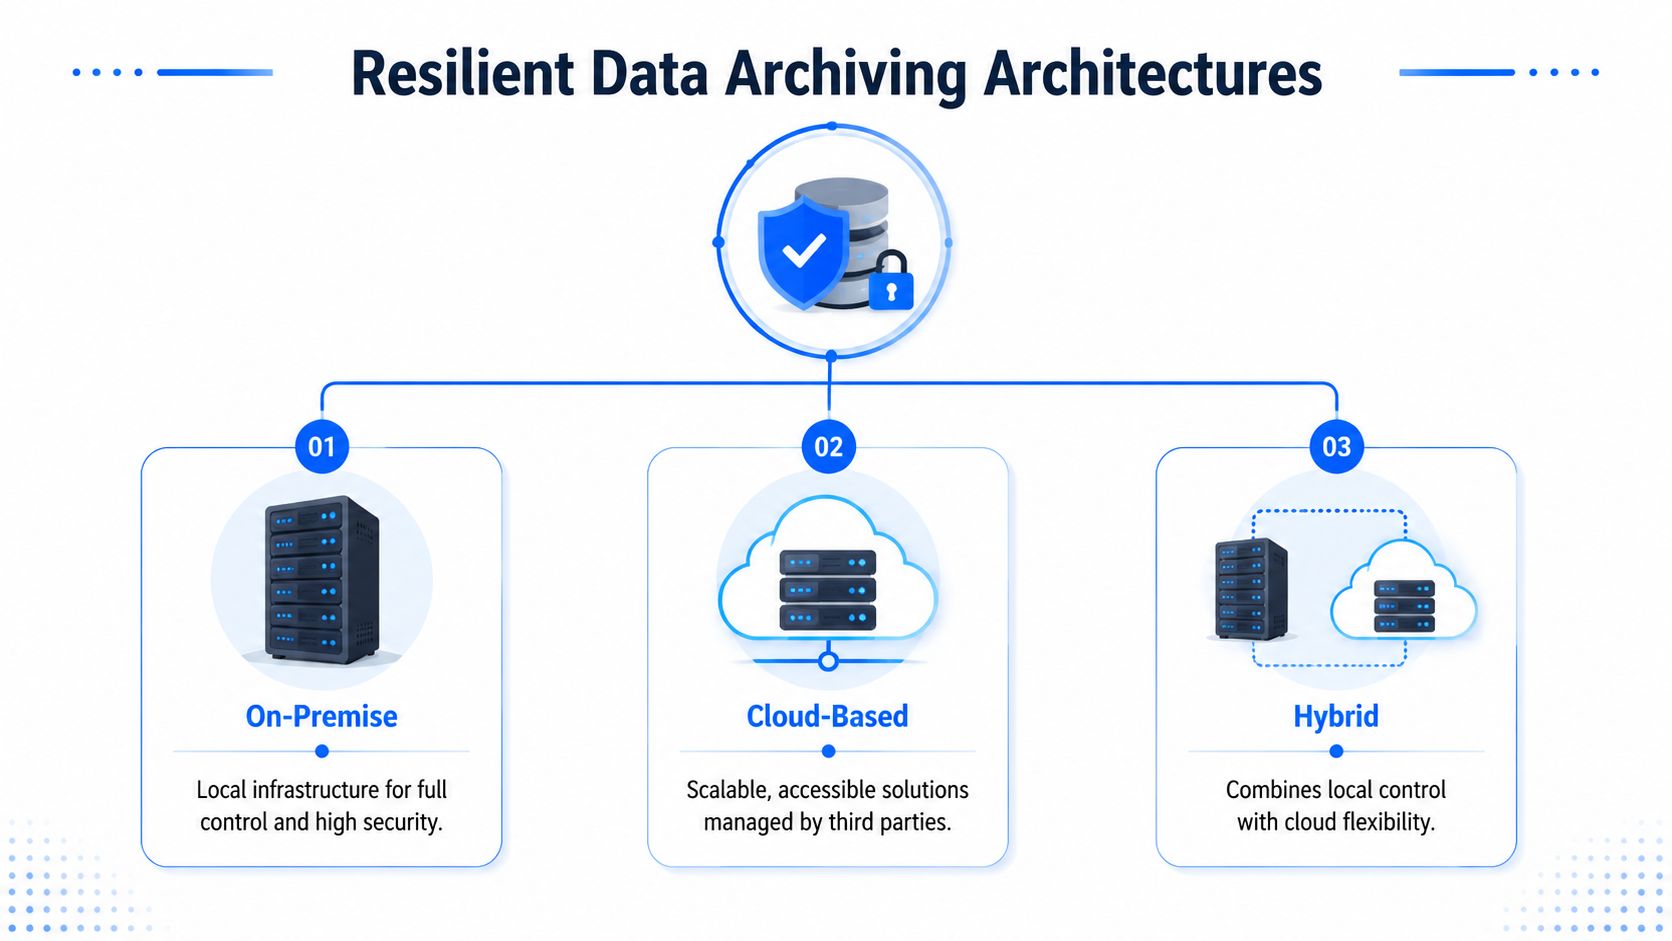
L'archivio on-premise è adatto alle organizzazioni che necessitano di una rigorosa localizzazione, di controllo diretto sull'hardware o di ambienti esclusivamente interni. In alcuni settori compaiono ancora le librerie a nastro. Più spesso, i team usano object storage on-prem dedicati per i carichi di archiviazione.
L'archivio cloud funziona bene quando elasticità di scala, funzionalità di durabilità gestite e posizionamento regionale contano più del controllo dell'infrastruttura. Servizi come AWS Glacier o Azure Archive Storage sono destinazioni comuni.
Anche l'archiviazione in-database rientra nella discussione. Alcune piattaforme consentono di spostare vecchie partizioni, tabelle o record in strutture interne più economiche o in schemi di archivio. Può funzionare per la conservazione specifica di un'applicazione, ma spesso non basta quando i team hanno bisogno di record immutabili, regole di ciclo di vita indipendenti o capacità di ricerca più ampie.
Di solito valgono tre regole di progettazione:
Tenete separate le responsabilità operative e quelle di archiviazione: non lasciate che i database di produzione diventino musei permanenti.
Portate l'immutabilità nei controlli di storage: la sola logica applicativa è troppo facile da aggirare.
Progettate fin dall'inizio per la residenza dei dati: i vincoli di conservazione regionale e di giurisdizione sono costosi da correggere in seguito.
Un archivio resiliente è noioso, nel senso migliore del termine. Le policy scattano automaticamente, la conservazione non può essere modificata con leggerezza e il recupero non dipende da conoscenze tramandate a voce.
Quando i team combinano con attenzione il controllo on-prem, l'economia del cloud e l'archiviazione specifica per applicazione, ottengono i vantaggi di ciascun approccio senza imporre un unico pattern a ogni dataset.
Costruire il framework di compliance e conservazione
Un framework di conservazione non è un foglio di calcolo con delle date. È l'insieme di regole che dice ai vostri sistemi cosa conservare, perché conservarlo, chi ne è responsabile e quando può essere rilasciato o distrutto.
La conservazione è una policy legale e operativa
Partite dalle categorie di record, non dalle piattaforme di storage. Dati finanziari, documenti HR, comunicazioni con i clienti, log applicativi, cartelle cliniche e dataset di training per il ML hanno di solito logiche di conservazione diverse. Se partite dal bucket in cui i dati si trovano per caso, costruirete regole incoerenti per lo stesso record di business.
Per i team che stanno formalizzando il linguaggio delle policy, gli esempi pratici di progettazione delle policy di conservazione nel Regno Unito sono utili perché mostrano come mettere per iscritto in modo difendibile obblighi legali, tempi di cancellazione e responsabilità.
Un framework efficace dovrebbe definire:
Evento di avvio della conservazione: quando parte il conteggio. Data di creazione, fine del contratto, chiusura del conto, chiusura della pratica e cessazione del rapporto di lavoro producono tutti esiti diversi.
Gestione del legal hold: la normale scadenza deve interrompersi quando un contenzioso, un'indagine o un audit richiedono la conservazione.
Workflow di smaltimento: la distruzione deve essere autorizzata, registrata e ripetibile. Non deve dipendere da pulizie manuali improvvisate.
Vincoli di residenza: se i record archiviati devono restare entro specifiche giurisdizioni, la policy deve dirlo esplicitamente. Questa panoramica sui requisiti di residenza dei dati è un buon riferimento per allineare la posizione dell'archivio ai controlli di governance.
Sono i metadati a rendere l'archivio difendibile
I file conservati senza metadati ricchi sono difficili da cercare, da spiegare e da difendere. L'archivio ha bisogno di un proprio contesto operativo.
La panoramica di Atlan sulle best practice di archiviazione dei dati è una delle sintesi più chiare: ogni dataset archiviato deve mantenere il proprio profilo completo di metadati, inclusi etichetta di classificazione, normativa di riferimento, periodo di conservazione, data di scadenza, responsabile originale, data di archiviazione, livello di storage, istruzioni di recupero e data lineage completa, per consentire una e-discovery rapida e difendibile e l'analisi delle cause alla radice. La stessa fonte osserva che il tagging dei metadati e il tiering automatizzato possono garantire una latenza di recupero inferiore del 30% e un TCO ridotto del 25%.
Ecco perché la strategia di indicizzazione è importante. Gli ingegneri si concentrano spesso su dove si trovano i dati archiviati, ma ai team di compliance interessa altrettanto poter trovare un sottoinsieme preciso senza ripristinare un'intera applicazione storica.
Usate i metadati per rispondere rapidamente a queste domande:
Che cos'è questo dataset?
Perché è stato conservato?
Quale normativa o policy lo regola?
Chi ne era responsabile al momento dell'archiviazione?
Come lo recuperiamo e in quale formato?
Quale sistema e quale schema a monte lo hanno prodotto?
Se il vostro archivio non sa rispondere a queste domande, può contenere dei record, ma non supporta ancora una ricerca difendibile.
I rischi nascosti degli archivi a lungo termine
Il settore parla ancora degli archivi come se spostare i dati fuori dallo storage primario risolvesse il problema. Non è così. Gli archivi a lungo termine falliscono senza che nessuno se ne accorga.
Conservato non significa utilizzabile
Un oggetto può esistere nello storage ed essere comunque inutile. I bit possono degradarsi. I file possono diventare illeggibili per gli strumenti attuali. I formati possono sopravvivere al software che un tempo li rendeva comprensibili. Librerie di compressione, export proprietari e dump di database legacy sono frequenti punti critici.
L'analisi di Access Corp sui rischi della conservazione dei dati a lungo termine dà un numero preciso al problema: il 30% degli archivi a lungo termine fallisce entro il settimo anno a causa di integrità non verificata o formati illeggibili. È questa la scomoda verità dietro l'approccio “archivia e dimentica”.
Quando gli ingegneri sentono parlare di “bit rot”, spesso pensano solo alla corruzione dei supporti di storage. Il rischio più ampio è la sostenibilità dell'archivio. Un dataset può superare un controllo di presenza a livello di storage e fallire comunque il test di business: un team riesce a recuperarlo, aprirlo, interpretarlo e fidarsene?
La governance degli archivi si sovrappone alle pratiche di smaltimento e dismissione dell'hardware. Se la vostra organizzazione gestisce anche supporti legacy, questi approfondimenti di Reworx Recycling sulla sicurezza dei dati meritano una lettura, perché evidenziano le implicazioni di sicurezza legate ai vecchi sistemi e agli asset di storage dismessi, che spesso contengono ancora record sensibili.
Come si presenta una validazione attiva
I checksum all'acquisizione sono utili, ma da soli non bastano. Servono una validazione ricorrente nel tempo e un processo di rimedio quando un controllo fallisce.
Una routine pragmatica di validazione dell'archivio comprende:
Verifica periodica dell'integrità: ricalcolate e confrontate gli hash degli oggetti archiviati.
Test di leggibilità dei formati: aprite record campione con gli strumenti attuali, non solo tramite le API di storage.
Esercitazioni di ripristino: dimostrate che le istruzioni di recupero funzionano ancora con i permessi e gli ambienti attuali.
Controlli di aggiornamento del catalogo: verificate che i riferimenti dell'archivio puntino ancora a oggetti e posizioni validi.
Un archivio senza validazione è una tomba digitale. Esiste, ma non saprete se è utilizzabile fino al momento peggiore possibile.
Questo è particolarmente rilevante quando dataset storici obsoleti alimentano analisi a valle o il riaddestramento dei modelli. I team che si confrontano con i dati obsoleti nei workflow di produzione sanno già che la sola età può compromettere la fiducia. Gli archivi aggiungono un ulteriore livello di rischio, perché il deterioramento può restare nascosto fino al momento del recupero.
Preservare il contesto per garantire l'usabilità futura
L'integrità protegge i bit. Il contesto protegge il significato. Perdete il secondo e l'archivio diventa una scatola nera.
Perché i tag statici non bastano
Un file chiamato customer_snapshot_legacy_final_v2 potrebbe essere ancora perfettamente integro tra molti anni. Ciò non significa che qualcuno capirà come è stato generato, quale versione dello schema seguiva o quali regole di business hanno filtrato le righe.
L'articolo di Cloudian sulla strategia di archiviazione dei dati nel 2026 evidenzia direttamente il problema del contesto futuro: uno studio del 2025 ha rilevato che il 45% dei dataset di ricerca archiviati è inutilizzabile perché i metadati originali non sono sufficienti per una nuova interpretazione. Non è un guasto dello storage. È un fallimento della documentazione.
Cosa include un archivio autodescrittivo
Un archivio utilizzabile ha bisogno di un contesto incorporato che viaggi con i dati o sia indissolubilmente collegato a essi. I tag di classificazione statici aiutano, ma non spiegano il significato di business.
Conservate almeno questi elementi di contesto insieme ai dataset archiviati:
Storico dell'evoluzione dello schema: quali colonne sono cambiate, scomparse o hanno cambiato tipo di dato nel tempo.
Logica di validazione: le regole che definivano i record accettabili al momento dell'archiviazione.
Note di lineage: sistemi sorgente a monte, trasformazioni e join principali.
Definizioni di business: spiegazioni comprensibili dei campi importanti e dei valori derivati.
Un moderno data catalog aiuta in questo, perché offre ai team un luogo controllato in cui conservare definizioni, responsabilità e lineage. Ma per la conservazione a lungo termine la best practice va oltre il semplice riferimento esterno. Gli archivi dovrebbero essere sufficientemente autodescrittivi da permettere a futuri analisti, auditor o ML engineer di interpretare correttamente il dataset senza avere accanto il team originale.
Una checklist pratica per l'implementazione
La maggior parte dei progetti di archiviazione riesce o fallisce sulla disciplina di esecuzione. Il pattern che funziona è per fasi: decidere cosa è idoneo, automatizzare lo spostamento e continuare a validare ben oltre la fine della migrazione.
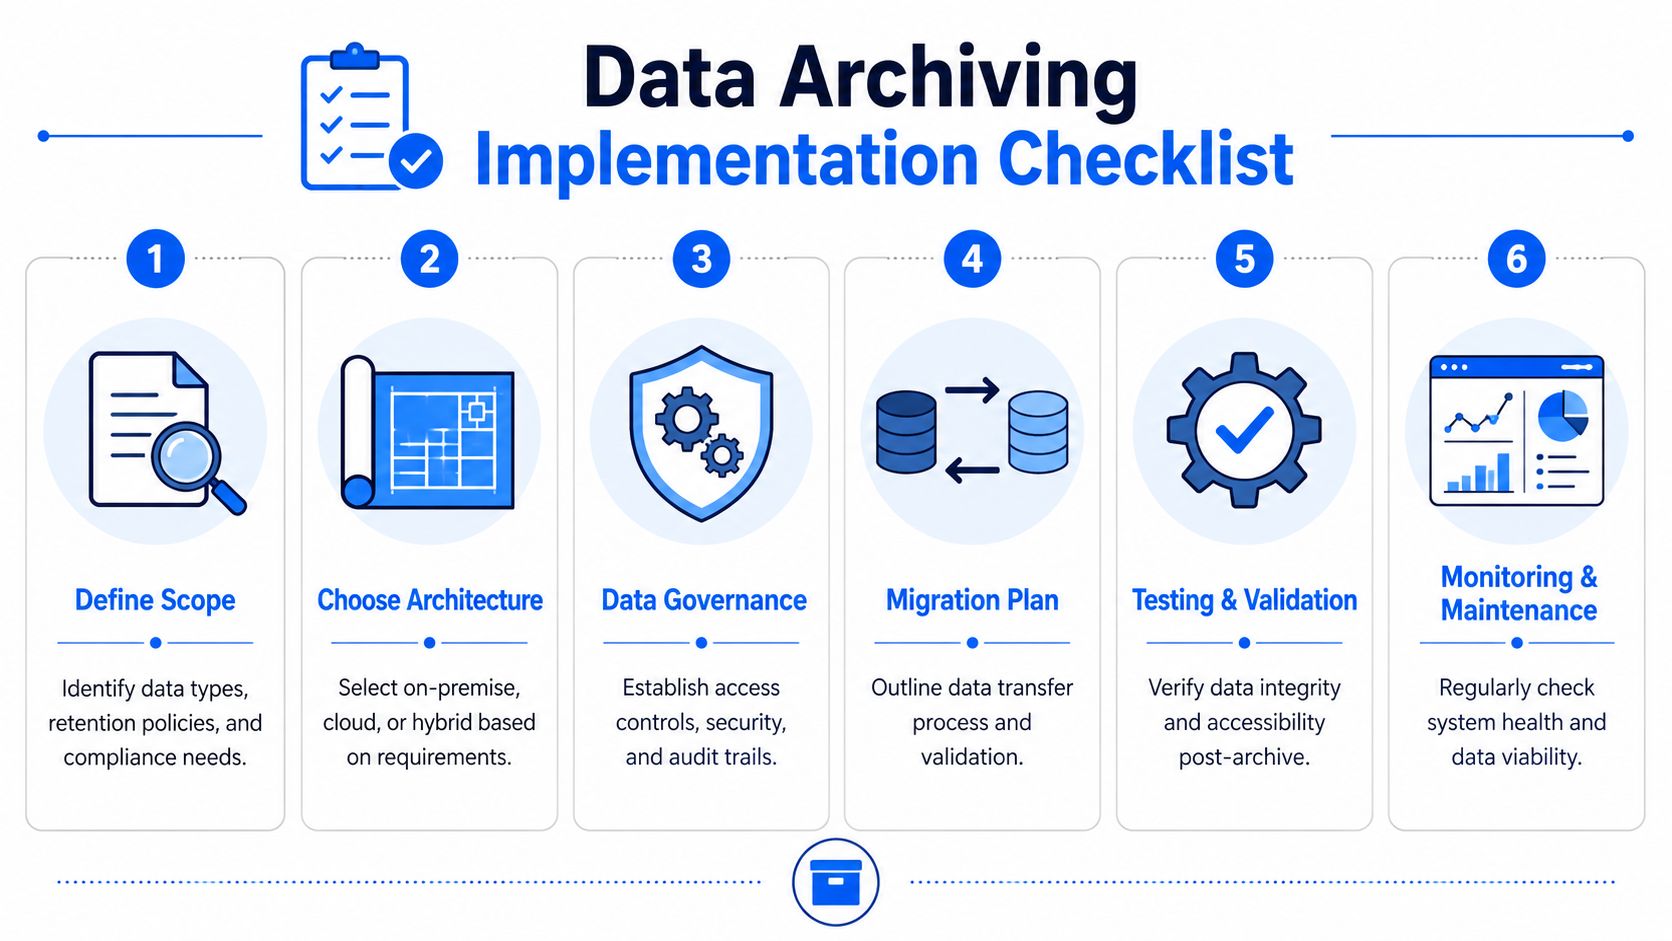
Pianificazione
Iniziate con inventario e classificazione. Individuate i dataset candidati in base a inattività, responsabile di business, obblighi normativi e dipendenze a valle. Non archiviate alla cieca. Alcuni dati “vecchi” supportano ancora riconciliazioni attive, revisioni antifrode o il backtesting dei modelli.
Poi definite le classi di archivio. Raggruppate i dati in base al comportamento di conservazione, non in base al team che li conserva attualmente. Così otterrete regole coerenti tra le applicazioni.
Usate questa checklist di pianificazione:
Definite i candidati all'archiviazione: concentratevi sui dati inattivi con un valore legale, analitico o storico ancora attuale.
Assegnate le responsabilità: ogni classe di archivio ha bisogno di un responsabile di business e di un responsabile tecnico.
Impostate eventi di avvio della conservazione e blocchi: registrate quando inizia la conservazione, cosa interrompe la cancellazione e chi approva il rilascio.
Scegliete le aspettative di recupero: decidete se chi usa i dati ne ha bisogno in minuti, ore o tempi più lunghi.
Esecuzione
Poi viene l'architettura. Scegliete on-premise, cloud o ibrido in base a residenza, immutabilità, scala e idoneità operativa. Quindi automatizzate lo spostamento verso il livello di destinazione acquisendo contemporaneamente i metadati. I job di archiviazione manuali tendono a uscire rapidamente dalla policy.
In fase di esecuzione, pretendete controlli verificabili:
Preservate i metadati durante la migrazione. Se i metadati arrivano dopo, spesso non arrivano mai in modo corretto.
Scrivete le istruzioni di recupero nel record di archivio. I team futuri non dovrebbero dover ricostruire a ritroso i passaggi di ripristino.
Validate l'accessibilità dopo lo spostamento. Non contrassegnate un dataset come archiviato finché non avete dimostrato che può essere trovato e aperto.
Applicate l'immutabilità a livello di storage dove richiesto. Questo controllo non dovrebbe dipendere dalla buona volontà dell'applicazione.
Se lo script di migrazione è l'unico luogo in cui esiste la logica di archiviazione, non avete un framework. Avete un fragile job batch.
Monitoraggio continuo
A questo punto l'archivio ha bisogno di observability. Non la stessa che applicate alle pipeline in streaming, ma una disciplina affine: integrità, accessibilità, completezza del contesto e affidabilità del recupero.
Il monitoraggio assistito dall'AI offre una soluzione. Secondo la panoramica di digna sulle tecniche di rilevamento delle anomalie con l'AI, i sistemi di rilevamento delle anomalie basati sull'AI con soglie adattive riducono i falsi positivi del 45% rispetto ai sistemi statici basati su regole, mantenendo un tasso di individuazione delle anomalie reali del 92% nelle pipeline ad alto volume, grazie all'apprendimento dei pattern di comportamento normale, inclusi stagionalità e trend. La lezione pratica per l'archiviazione è semplice: le soglie fisse mancano troppe anomalie o generano troppi alert quando il comportamento dell'archivio cambia nel tempo.
Gestite l'archivio come un sistema operativo con i propri controlli:
Monitorate i segnali di integrità: rilevate variazioni nei risultati dei checksum, nel numero di oggetti e negli esiti delle validazioni.
Tracciate le anomalie di recupero: tenete d'occhio l'aumento dei ripristini falliti, ritardi imprevisti o percorsi interrotti.
Rilevate lo schema drift nei sistemi sorgente: se gli schemi attivi cambiano, i modelli di contesto archiviati potrebbero dover essere aggiornati prima del prossimo ciclo di archiviazione.
Analizzate i pattern di accesso: se i team continuano a recuperare lo stesso dataset, forse il suo posto è in un livello più caldo.
Una buona archiviazione dei dati non è mai una migrazione una tantum. È un servizio gestito che il vostro team fornisce al business.
Se il vostro team ha bisogno di maggiore visibilità su modifiche agli schemi, problemi di tempestività, rilevamento delle anomalie e monitoraggio dei dati all'interno del proprio ambiente, digna merita un'occhiata. È pensato per i team che vogliono controlli di observability e qualità dei dati senza spostare i dati di produzione fuori dagli ambienti controllati dal cliente.
Il contesto archiviato diventa obsoleto quando i sistemi sorgente cambiano: tracciare colonne aggiunte, rimosse o con tipo modificato con digna Schema Tracker mostra quando lo storico dello schema di un archivio deve essere aggiornato prima del prossimo ciclo di archiviazione.
Domande frequenti
Qual è la differenza tra archiviazione dei dati e backup?
Un archivio conserva i dati storici come record ufficiale, mentre un backup è una copia di ripristino dei sistemi attivi, usata quando i dati di produzione vengono cancellati, corrotti o diventano indisponibili. Ripristinare un vecchio backup per rispondere a una domanda di compliance è lento, invasivo e difficile da difendere, quindi i due non vanno mai considerati intercambiabili.
Come si sceglie il livello di storage giusto per l'archivio?
Allineate il livello alla frequenza con cui i dati vengono recuperati, alla rapidità con cui servono e al costo di conservazione. L'archivio hot è adatto alle consultazioni del support e ai confronti BI ricorrenti, il nearline agli audit periodici, mentre il cold o deep archive ai record conservati per obbligo che l'ufficio legale recupera forse una volta ogni diversi anni.
Di quanto può ridurre i costi di storage un'archiviazione guidata da policy?
Secondo le indicazioni di Scality citate nell'articolo, un ciclo di vita guidato da policy che sposta i dati inattivi su livelli di object storage dedicati con immutabilità WORM o object lock riduce i costi dello storage primario dal 40 al 60 percento, mantenendo audit trail a prova di manomissione per obblighi come la SEC Rule 17a-4.
Quali metadati dovrebbe conservare ogni dataset archiviato?
Ogni dataset archiviato dovrebbe conservare etichetta di classificazione, normativa di riferimento, periodo di conservazione, data di scadenza, responsabile originale, data di archiviazione, livello di storage, istruzioni di recupero e data lineage completa. L'articolo cita Atlan: il tagging dei metadati combinato con il tiering automatizzato può garantire una latenza di recupero inferiore del 30 percento e un costo totale di proprietà ridotto del 25 percento.
Come si verifica che gli archivi a lungo termine siano ancora utilizzabili?
Eseguite una validazione ricorrente invece di affidarvi ai soli checksum all'acquisizione. L'articolo elenca la verifica periodica degli hash, test di leggibilità dei formati con gli strumenti attuali, esercitazioni di ripristino e controlli di aggiornamento del catalogo. È importante perché, secondo Access Corp, il 30 percento degli archivi a lungo termine fallisce entro il settimo anno a causa di integrità non verificata o formati illeggibili.


