Anomaly detection sulle serie temporali: la guida 2026
|
8
min di lettura

La revisione delle dashboard del lunedì è il momento in cui molti team si rendono conto per la prima volta di non fidarsi del proprio monitoraggio. Il grafico dei ricavi sembra stabile, ma un caricamento è arrivato in ritardo, una colonna ha cambiato tipo e il numero “normale” di ieri era già sbagliato quando qualcuno ha aperto il report. È proprio questo il tipo di guasto che l'anomaly detection sulle serie temporali deve intercettare, ed è per questo che un generico controllo sugli outlier non basta più quando i dati iniziano a scorrere attraverso veri job del warehouse, modelli dbt, livelli di BI e feature di ML a valle.
La parte difficile è che i dati non hanno semplicemente avuto un picco. Hanno subito un drift, sono arrivati fuori ordine, hanno cambiato forma o si sono mossi contro uno schema stagionale che una regola statica non ha mai appreso. Se volete un punto di riferimento pratico su ciò che sta cambiando nel mercato degli strumenti di observability e rilevamento, la vetrina curata di nuovi prodotti tecnologici è un buon posto per dare un'occhiata ai prodotti attuali senza trasformare il vostro lavoro in un giro tra i vendor.
Indice
Univariato, multivariato e la maledizione delle dimensioni aggiuntive
Valutazione, soglie e alert di cui le persone si fidano davvero
Rilevamento online e i segnali operativi che la maggior parte dei modelli non coglie
Perché una dashboard sana può improvvisamente mentirvi
Una dashboard può sembrare sana per giorni mentre il sistema sottostante è già andato fuori strada. Un caricamento in ritardo nel warehouse può far apparire stabili i ricavi di ieri finché un analista finanziario non si accorge che il numero “definitivo” è cambiato dopo la riunione. Una modifica al tipo di una colonna può rompere silenziosamente un'aggregazione a valle senza generare un errore evidente, e una pipeline che prima arrivava alle 6 del mattino può slittare alle 9 senza che alcun valore delle metriche superi una soglia fissa.
Ecco perché l'anomaly detection sulle serie temporali è una disciplina a sé. In una serie temporale contano l'ordine, i tempi e la forma attesa dei dati. Un numero insolito di martedì può essere del tutto normale in un weekend festivo, e un punto che sembra innocuo preso da solo può comunque essere il primo segnale di un incidente più ampio.
Le regole statiche si rompono quando la baseline si sposta
I primi sistemi pratici si basavano su baseline locali mobili. Le indicazioni del settore sul Z-score mobile usano i 30 minuti di dati che precedono un timestamp, rimuovono gli outlier, calcolano media e deviazione standard e segnalano un punto quando il suo Z-score supera ±2; un'altra variante comune usa una finestra mobile con una soglia di 3 deviazioni standard. Questi metodi funzionano perché confrontano un valore con il suo contesto recente, non con una media globale congelata. Le indicazioni di Tinybird sull'anomaly detection sono un esempio chiaro di questa mentalità tradizionale incentrata sulla baseline.
Regola pratica: se la vostra metrica ha stagionalità, caricamenti in ritardo o cambi di orario, prima o poi una soglia statica vi mentirà.
Il motivo per cui questo continua a mettere in difficoltà i team è semplice. I dati del warehouse non sono una serie pulita da laboratorio, sono un prodotto operativo. Gli orari cambiano, gli schemi evolvono e i sistemi a monte si comportano in modo diverso il lunedì mattina, alle chiusure di fine mese e dopo il lancio di un prodotto. Un rilevatore che capisce solo “alto” e “basso” non coglie il significato di “in ritardo”, “cambiato” e “inaspettatamente diverso rispetto a questa stessa ora di ieri”.
Il settore è passato dai semplici controlli sugli outlier a modelli che apprendono nel tempo il comportamento normale e poi assegnano un punteggio alle deviazioni da quello schema appreso. Questo cambiamento è importante perché gli incidenti reali raramente sono singoli punti. Sono sequenze, trend e fallimenti di contesto. Una dashboard sana può comunque raccontare una storia falsa se cercate solo i picchi e non vi chiedete mai se i dati sono arrivati in tempo, con la forma giusta e rispetto alla baseline corretta.
I tre volti di un'anomalia nelle serie temporali
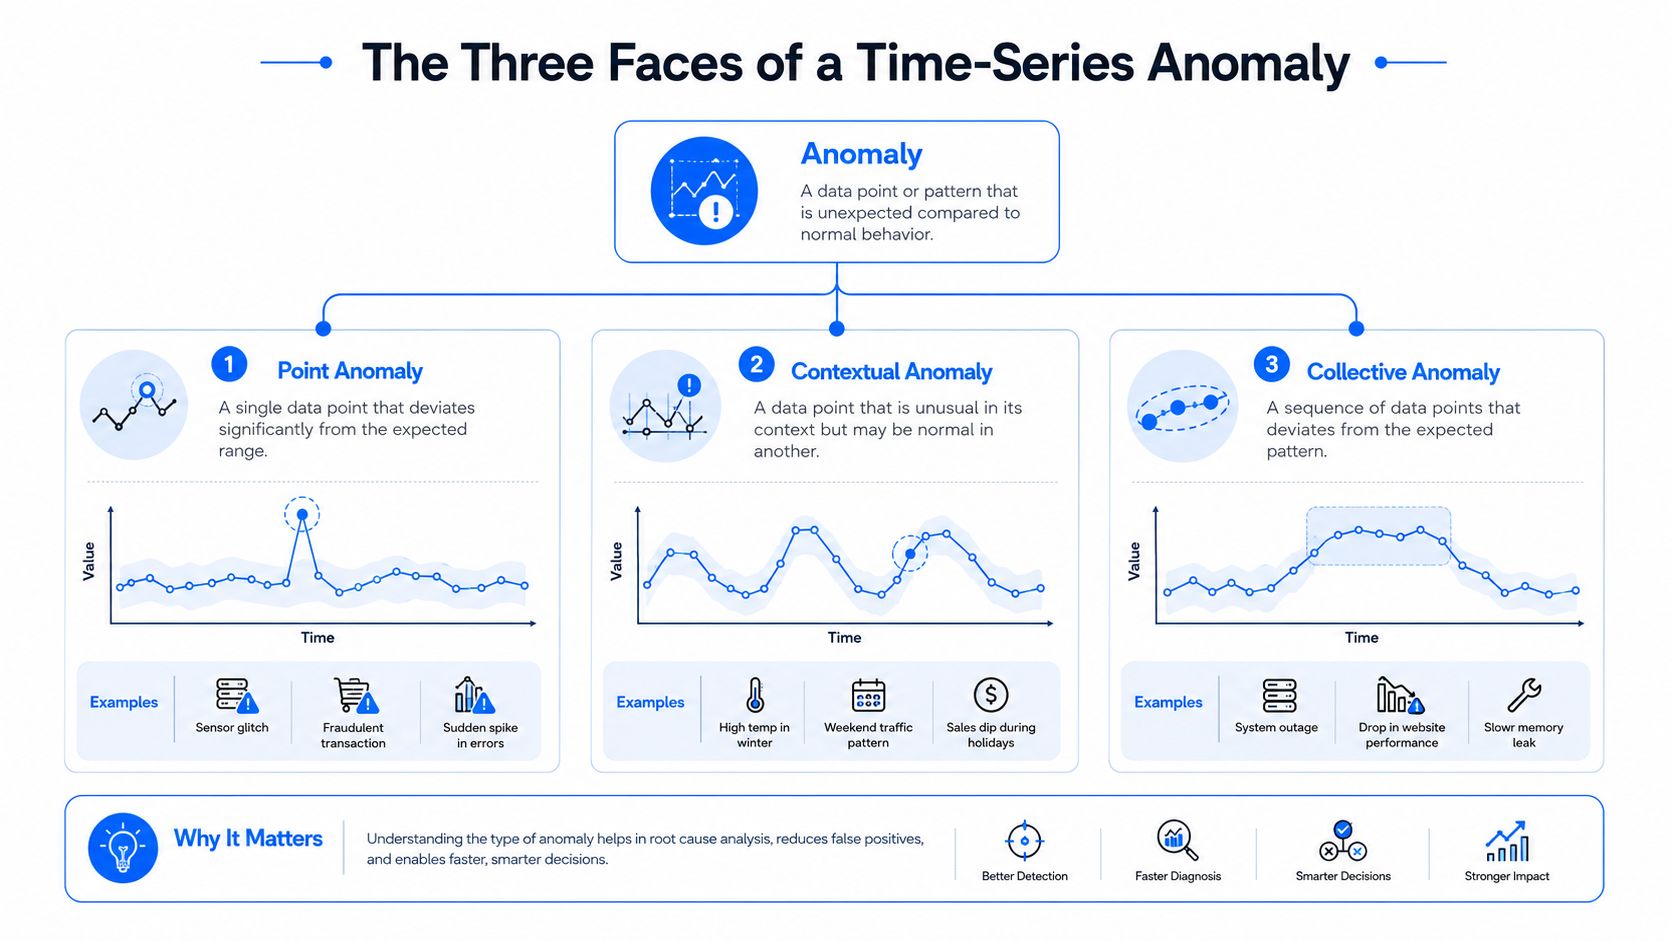
Un modo utile di pensare all'anomaly detection sulle serie temporali è suddividere ciò che state cercando in tre categorie. La terminologia conta perché un modello mentale sbagliato porta al rilevatore sbagliato, e il rilevatore sbagliato crea alert rumorosi di cui nessuno si fida. Una review del 2024 raggruppa le anomalie nei tipi puntuale, contestuale e collettiva, e questa impostazione corrisponde a ciò che si osserva nei warehouse e nelle pipeline. La review sui tipi di anomalia e sulle famiglie di metodi è una tassonomia solida da tenere a mente.
Le anomalie puntuali sono quelle evidenti
Un'anomalia puntuale è un singolo valore anomalo. In un warehouse può essere l'importo di un ordine caricato con uno zero in più, o una lettura di un sensore con un valore assurdo perché il parser a monte ha interpretato male il campo. Sono le più facili da descrivere e di solito le più facili da spiegare agli stakeholder non tecnici.
Le anomalie contestuali dipendono dal momento
Un'anomalia contestuale è un valore che di per sé sembra corretto ma è sbagliato per quel momento. Il numero di transazioni del venerdì sera può essere normale di venerdì e sospetto di domenica. Un calo improvviso del traffico durante una finestra di rilascio pianificata può essere previsto, mentre lo stesso calo in un normale giorno feriale potrebbe indicare un disservizio. È il contesto a dare significato al numero.
Le anomalie collettive si presentano come uno schema
Un'anomalia collettiva è una sequenza che punto per punto sembra accettabile ma ha una forma sbagliata. Un tasso di valori nulli in lento aumento è il classico esempio nel warehouse, perché ogni passo può sembrare piccolo mentre il trend complessivo avvelena i modelli a valle. Anche un drift nella qualità dello schema o uno schema ripetuto di arrivi in ritardo possono essere collettivi, perché l'incidente è la forma, non un singolo punto.
È qui che il vecchio Z-score mobile si guadagna ancora il suo posto. Vi offre un primo modello mentale per la deviazione locale e insegna la disciplina di confrontare ogni valore con una baseline vicina anziché con una regola globale. Sia il materiale didattico universitario sulla statistica sequenziale sia le successive rassegne dei metodi di anomaly detection mostrano la stessa evoluzione: dai punteggi di sospetto e dagli allarmi agli approcci basati su distanza, densità e machine learning, che cercano di apprendere la normalità anziché limitarsi a individuare gli outlier evidenti. Le slide delle lezioni di Berkeley sulla statistica sequenziale descrivono bene questo cambiamento storico.
Dalle statistiche mobili ai modelli deep
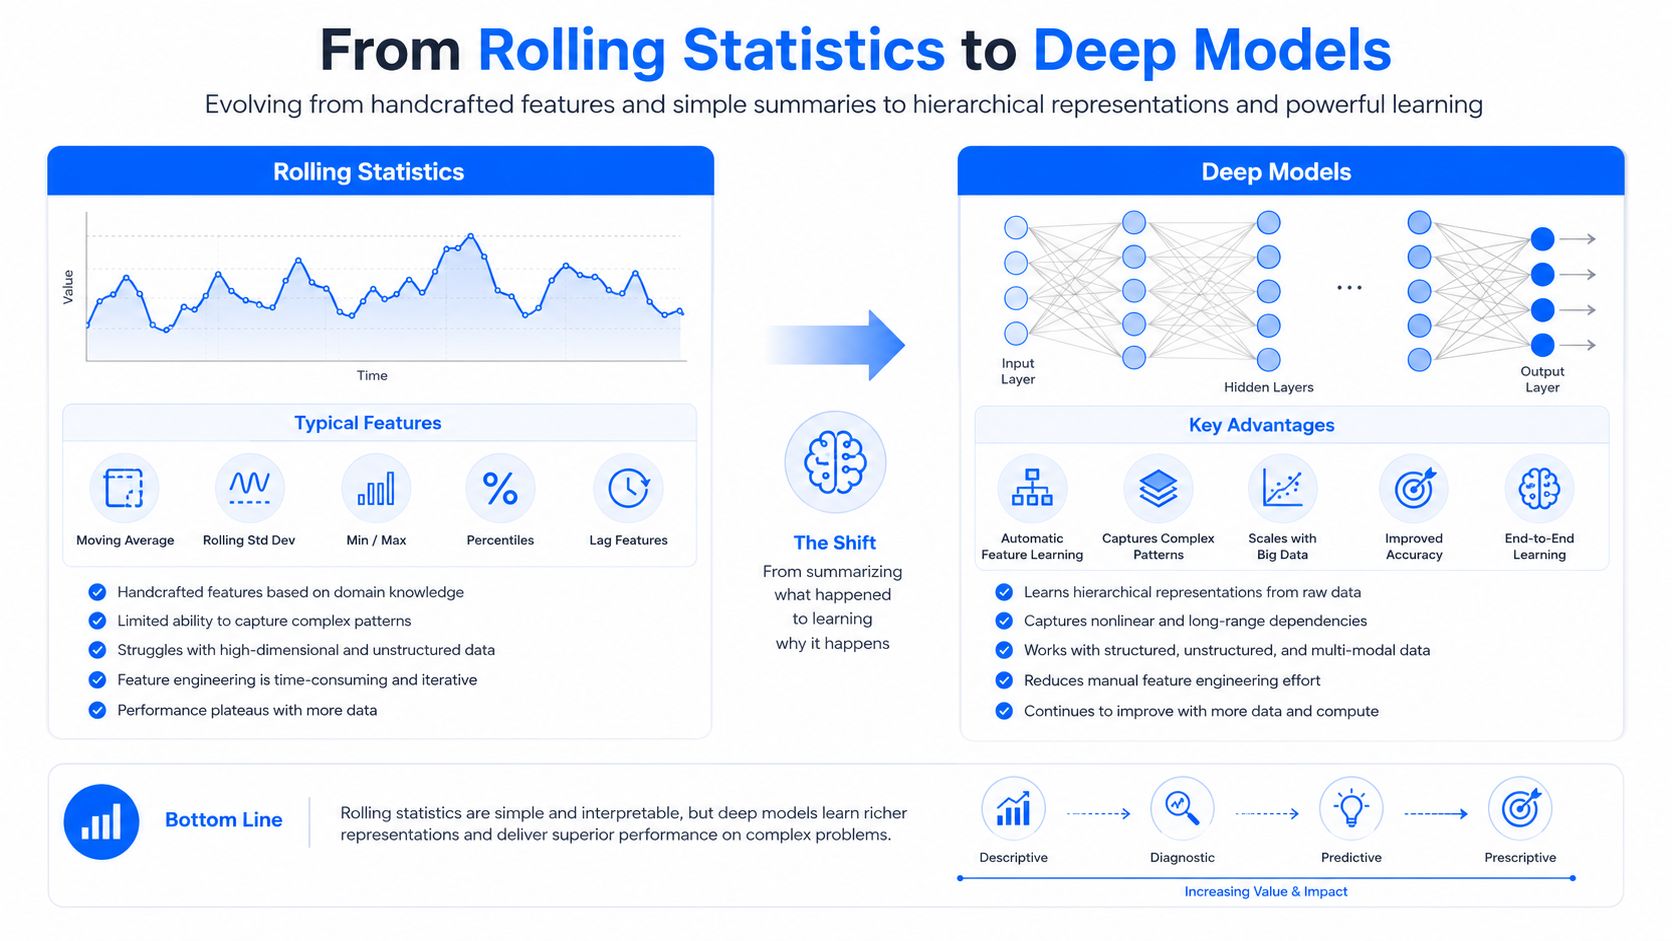
È di solito nella scelta del metodo che i team complicano troppo le cose. Passano a un modello deep quando il problema di fondo è una baseline sbagliata, oppure si aggrappano a una soglia semplice quando i dati richiedono chiaramente una gestione della stagionalità. Uno studio comparativo del 2023 sull'anomaly detection non supervisionata con deep learning suddivide il flusso di lavoro in preprocessing, scoring delle anomalie e definizione delle soglie, un utile promemoria del fatto che il modello è solo una parte del sistema. Lo studio comparativo sull'anomaly detection non supervisionata è un buon riferimento per questa visione a pipeline.
Confronto diretto dei metodi più comuni
Metodo | Ideale per | Compromesso principale |
|---|---|---|
Z-score mobile | Metriche stabili con baseline locali | Facile da spiegare, debole con stagionalità e schemi che cambiano |
Decomposizione STL | Serie con una forte struttura stagionale | Migliore separazione di trend e stagionalità, più tuning |
Matrix profile | Forme ripetute e ricerca di sottosequenze | Efficace sulle anomalie di forma, meno naturale per il contesto di business |
Isolation forest | Insiemi di feature ad alta dimensionalità | Funziona bene su feature tabellari, non sull'intuizione della serie grezza |
Autoencoder | Apprendere il comportamento normale da segnali complessi | Potenti, ma più difficili da spiegare e mantenere |
Predittori LSTM | Dipendenza sequenziale e rilevamento basato su previsioni | Gestiscono gli schemi temporali, ma possono essere fragili di fronte al drift |
Transformer | Dipendenze ricche a lungo raggio | Efficaci su schemi complessi, costo operativo più elevato |
Che cosa vi offre ciascun metodo
Le statistiche mobili sono veloci, comprensibili e spesso sufficienti per semplici metriche di business. La decomposizione STL aiuta quando il ritmo giornaliero è reale ed evidente, ed è per questo che compare in produzione per metriche con forti schemi settimanali od orari. Separa una canzone in melodia e accompagnamento, poi verifica se la melodia è cambiata all'improvviso.
Il matrix profile è utile quando vi interessano le sottosequenze ripetute e i cambiamenti di forma, non solo gli spostamenti di livello. L'isolation forest può funzionare bene dopo aver ricavato delle feature da una serie, quando volete un rilevatore leggero da applicarvi sopra. Autoencoder, rilevatori basati su LSTM e metodi basati su transformer sono la scelta giusta da discutere solo quando il comportamento normale è così complesso che uno scoring più semplice continua a mancare gli stessi incidenti.
Lezione operativa: se un engineer non riesce a spiegare in una frase perché è scattato l'alert, il rilevatore è probabilmente troppo astratto per il monitoraggio di primo livello.
È anche qui che molti team possono trovare un aiuto pratico nei riepiloghi dei metodi come quelli raccolti nei metodi di identificazione degli outlier in un contesto di produzione. La domanda utile non è quale algoritmo sembri più moderno. È quale sopravvive al drift della baseline, può essere tarato senza riaddestramenti settimanali e ha ancora senso quando a un analista BI si chiede di fidarsi dell'alert alle 8 del mattino.
Univariato, multivariato e la maledizione delle dimensioni aggiuntive
Un rilevatore univariato osserva un segnale alla volta, ed è spesso il punto di partenza giusto. Ricavi giornalieri, job falliti, righe in ritardo e tasso di valori nulli funzionano bene come controlli su una singola serie, perché il legame tra la metrica e l'incidente è facile da spiegare. Un rilevatore multivariato osserva più segnali insieme, il che aiuta quando il guasto deriva da una combinazione di cambiamenti che nessuna metrica singola segnalerebbe.
Nella configurazione giusta il vantaggio è evidente. Ricavi, sessioni, spesa di marketing e meteo possono muoversi insieme in un modo che rivela uno spostamento correlato molto prima che una singola linea sembri rotta. Ma le dimensioni aggiuntive portano con sé un bagaglio. Compaiono correlazioni spurie, le soglie diventano instabili e un alert può scattare su un'interazione che è semplicemente un normale comportamento di business.
Aggiungete dimensioni solo quando cambiano la decisione
Aggiungete un secondo o un terzo segnale solo quando risponde a una domanda diversa. Se la metrica aggiuntiva si limita a ripetere la prima, aggiunge rumore. Se aiuta a capire se il cambiamento è operativo, commerciale o ambientale, si guadagna il suo posto.
La correlazione aiuta, ma non risolve tutto il problema
Usate l'analisi della correlazione come filtro, non come garanzia. Le metriche fortemente correlate sono buone candidate per un monitoraggio congiunto, ma la sola correlazione non vi dirà se un picco è previsto, se l'orario è cambiato o se lo schema ha subito un drift. Ecco perché i segnali operativi contano così tanto nei sistemi reali, soprattutto quando un caricamento errato o una partizione in ritardo possono far apparire “anomale” più tabelle a valle per il motivo sbagliato.
Per i team che lavorano sul warehouse questa distinzione conta più della scelta del modello. Un job a monte in ritardo, una partizione mancante o una colonna rinominata possono innescare una cascata di alert a valle che sembrano anomalie di valore anche se il problema di fondo è la tempestività o lo schema drift. In pratica, il rilevatore deve osservare sia la metrica di business sia lo stato della pipeline, perché l'una senza l'altro lascia troppe false piste a chi è di turno.
Regola pratica: se un alert multivariato richiede cinque minuti di spiegazione prima che qualcuno sappia cosa fare, scomponetelo di nuovo in monitor più semplici.
La maledizione delle dimensioni aggiuntive si manifesta anche nella definizione delle soglie. Più input significano di solito più occasioni di scattare su variazioni innocue. Negli ambienti di warehouse questo è pericoloso, perché il vero incidente può essere che i dati sono arrivati in ritardo, lo schema è cambiato o una colonna è stata rinominata, non che la metrica stessa si sia mossa. Un rilevatore concentrato solo sulle variazioni di valore può annegare in un rumore che il segnale operativo avrebbe chiarito.
Alcuni team cercano di risolvere il problema aggiungendo più feature e più controlli di correlazione. Spesso questo rende il modello più difficile da tarare e meno affidabile. Uno schema migliore è mantenere ristretto il rilevatore di valori e affiancarlo a controlli operativi su freschezza, completezza e stabilità dello schema, in modo che l'alert dica all'engineer di turno quale tipo di problema è probabilmente in corso.
Valutazione, soglie e alert di cui le persone si fidano davvero
L'accuratezza è la metrica sbagliata per dati con anomalie rare. Se le anomalie sono poche, un modello può sembrare eccellente pur mancando proprio i guasti che vi interessano, e un punteggio elevato su un benchmark dice poco su come si comporterà il rilevatore quando lo schema cambia in produzione. Per questo la valutazione deve essere costruita attorno all'utilità degli alert, non solo alla matematica della classificazione.
Il flusso di lavoro pratico inizia con la taratura delle soglie su porzioni storiche che riflettono condizioni operative reali. Una soglia che sembra corretta su una finestra di sviluppo pulita può crollare dopo una festività, un cambio di orario o una migrazione dello schema. Il rilevatore va giudicato in base alla sua capacità di generare gli allarmi giusti al momento giusto, con abbastanza contesto perché una persona possa intervenire.
Calibrate lo score prima di metterlo in produzione
Un punteggio di sospetto significa poco per un utente di business se non è ancorato a qualcosa. Ciò può significare confrontare il punteggio con la storia recente, mostrare l'intervallo della baseline o evidenziare quale run, tabella o metrica è cambiata. L'obiettivo non è semplificare la matematica. L'obiettivo è rendere l'output utilizzabile.
Gli alert hanno bisogno di contesto, non solo di colori
Una bandierina rossa non è una diagnosi. Un buon alert indica la metrica, la baseline, la run e il tipo probabile di anomalia. Se l'andamento è stato causato da un problema di tempestività, l'alert dovrebbe dirlo. Se lo schema è cambiato a monte, l'alert dovrebbe dire anche questo. Qualsiasi cosa di meno costringe l'engineer a ripartire da zero ogni volta.
Lo studio del 2023 sull'anomaly detection non supervisionata con deep learning è utile qui perché ricorda ai team che scoring e definizione delle soglie sono fasi separate, non un unico passaggio magico. Quello studio comparativo è anche in linea con la realtà operativa: lo score vale quanto la soglia che siete disposti a mantenere.
Una checklist prima del rilascio
Porzioni storiche: testate su periodi che includono stagionalità, caricamenti in ritardo e modifiche note allo schema.
Stabilità delle soglie: verificate quanto spesso il rilevatore scatta quando la baseline si sposta ma il processo di business non è cambiato.
Contenuto dell'alert: includete il nome della metrica, la finestra temporale e la descrizione della baseline.
Percorso di triage umano: assicuratevi che il destinatario possa capire se il problema riguarda i dati, la pipeline o il comportamento del business.
Tolleranza al rumore: controllate se una sola giornata negativa causa alert fatigue per le due settimane successive.
Un rilevatore che vince sulla carta ma genera notifiche rumorose in produzione non durerà. I team tengono il sistema che li aiuta ad agire rapidamente e scartano quello che migliora solo una slide di benchmark.
Rilevamento online e i segnali operativi che la maggior parte dei modelli non coglie
Le serie temporali operative non sono solo flussi di valori, sono flussi di eventi con schemi di arrivo, struttura dello schema e tempistiche dei job associati. Ecco perché il rilevamento online è importante. Osserva la serie mentre evolve, aggiorna una baseline man mano che arrivano nuovi dati e reagisce prima che il prossimo aggiornamento della dashboard nasconda l'incidente.
Il problema trascurato è che molte “anomalie” nel lavoro sul warehouse non sono affatto anomalie di valore. Una partizione arriva in ritardo. Una tabella a valle cambia forma. Una run che di solito termina prima di colazione slitta a metà della giornata lavorativa. Se monitorate solo i valori, vi sfugge l'evento di business.
Che cosa deve vedere il rilevamento online
Un rilevatore operativo utile ha di solito bisogno di tre viste contemporaneamente. Una vista sui valori per la metrica stessa, una vista sugli arrivi per la tempestività e una vista sulla struttura per le modifiche allo schema o ai campi. È questa combinazione a intercettare gli incidenti che altrimenti emergerebbero solo dopo una dashboard rotta o una previsione errata del modello.
Un caricamento in ritardo non equivale a valori bassi
Un caricamento che arriva in ritardo può far sembrare temporaneamente bassa la metrica anche quando il processo a monte è sano. Se il rilevatore non conosce gli orari previsti, può generare falsi allarmi e abituare il team a ignorarlo. Per questo le pipeline migliori confrontano l'arrivo effettivo con orari appresi o dichiarati, non solo con il valore di ieri.
La ricerca recente sui flussi di dati operativi evidenzia la stessa lacuna: i metodi più recenti si concentrano molto sull'accuratezza del rilevamento, lasciando poco approfonditi tempistiche, drift ed evoluzione dello schema. La review sull'anomaly detection nelle serie temporali operative sottolinea questo scollamento, soprattutto per gli ambienti di warehouse e i deployment privati in cui i dati non possono lasciare il perimetro del cliente.
Regola pratica: un rilevatore che conosce il valore ma non l'orario di consegna risolve solo metà dell'incidente.
Il drift strutturale può invalidare le feature a valle
L'evoluzione dello schema è particolarmente pericolosa perché può rompere una pipeline senza rompere il sistema sorgente. Una modifica al tipo di una colonna, un campo rimosso o un attributo appena aggiunto possono avvelenare feature ed embedding molto prima che qualcuno noti uno spostamento visibile delle metriche. Per questo l'anomaly detection operativa deve includere la struttura, non solo i numeri.
Per i team che vogliono un flusso di lavoro concreto attorno a questa visione più ampia, l'articolo sull'automazione dell'anomaly detection in produzione è un riferimento interno pertinente. La lezione principale, però, è semplice. Un vero monitoraggio deve coprire insieme i valori, lo schema di arrivo e la forma dei dati, altrimenti gli incidenti più costosi passano inosservati.
Errori comuni e argomenti a favore di baseline più semplici
L'errore più comune è ricorrere a un modello complesso prima di aver dimostrato che una baseline più semplice non funziona. I team lo fanno perché il deep learning sembra più sicuro rispetto ai casi limite, ma in pratica la complessità aggiuntiva può rendere un sistema operativo più difficile da tarare, da spiegare e da mantenere stabile quando gli orari cambiano.
I fallimenti si ripetono in modo prevedibile
Una baseline obsoleta dopo una festività può far sembrare tutto rotto. L'alert fatigue cresce quando un punteggio è rumoroso e la soglia è troppo aggressiva. Anomalie puntuali e collettive vengono confuse quando il team usa un unico rilevatore per tutto. E dopo un singolo incidente grave molti team bloccano la soglia in modo troppo conservativo e smettono di intercettare drift più piccoli ma comunque importanti.
Le contromisure dovrebbero essere noiose
Mantenete onesta la finestra della baseline e rivedetela dopo i cambi di orario. Rilevatori separati per valori, tempestività e schema funzionano di solito meglio di un unico enorme monitor che cerca di fare tutto. Conservate un modello semplice e interpretabile anche se nello stack c'è un modello deep, perché quello semplice diventa il controllo di buon senso quando il comportamento in produzione si fa confuso.
La sfumatura controcorrente di una rassegna recente coincide con ciò che ho visto nei sistemi reali: le baseline più semplici restano spesso competitive quando spiegabilità e manutenzione contano più dei numeri dei benchmark. La letteratura continua a basarsi su errore di ricostruzione, incoerenza dei trend e taratura delle soglie, un forte indizio che il settore non ha reso obsoleta l'interpretabilità. La rassegna su etichette scarse e addestramento solo su dati normali coglie bene questa tensione pratica.
Non riaddestrate solo perché il grafico si è mosso
Il riflesso di riaddestrare può nascondere un problema di monitoraggio invece di risolverlo. Se il problema è un orario saltato, un feed in ritardo o una modifica allo schema, altro addestramento non servirà. Il modello potrà diventare più abile a modellare il caos di ieri, ma l'incidente resterà nella pipeline.
Il modello operativo più pulito è partire da baseline interpretabili, aggiungere complessità solo dove la classe di incidenti lo richiede e mantenere un'alternativa di riserva di cui gli engineer possano fidarsi quando il rilevatore sofisticato tace.
Deployment enterprise con digna nel vostro database
La maggior parte dei progetti di anomaly detection non fallisce sugli algoritmi, fallisce sugli attriti di deployment. Residenza dei dati, governance, accesso del vendor e costo dello spostamento di grandi tabelle possono bloccare un buon modello prima ancora che arrivi a una dashboard. È qui che l'esecuzione nel database conta, perché mantiene le analisi accanto ai dati ed evita di trasformare l'observability in un altro problema di ETL.
digna rientra in questo schema come una delle opzioni dello stack enterprise. Il suo modulo Data Anomalies rileva le irregolarità senza scrivere regole manuali, mentre Timeliness, Schema Tracker, Data Validation e Data Analytics coprono i segnali operativi che i rilevatori di soli valori non colgono. La piattaforma gira in ambienti controllati dal cliente, il che è importante quando il warehouse non può uscire dai confini del private cloud o dell'on-prem.
Ciò che rende tutto questo rilevante per l'anomaly detection sulle serie temporali è la combinazione tra tipi di segnale e luogo del deployment. Lo stesso sistema può osservare valori, schemi di arrivo, modifiche allo schema e trend storici senza dover prima spedire altrove i dati grezzi. È il ponte pratico tra la scelta del metodo e la realtà della produzione.
Se state cercando di portare l'anomaly detection fuori dai notebook e dentro un flusso di lavoro nativo del warehouse, partite dai dati che risiedono già nel vostro ambiente e dai segnali che le vostre pipeline espongono già. digna offre ai team un modo, direttamente nel database, per monitorare anomalie, tempestività, modifiche allo schema, validazione e andamento dei trend in un unico posto, così potete intercettare gli incidenti reali senza esportare dati sensibili né aggiungere altri collegamenti fragili.
Se volete un rilevamento a livello di valore che apprenda il comportamento normale senza soglie scritte a mano, guardate come digna Data Anomalies esegue l'anomaly detection all'interno del vostro database.
Domande frequenti
Quali sono i tipi di anomalie nei dati delle serie temporali?
Sono tre: puntuale, contestuale e collettiva. Un'anomalia puntuale è un singolo valore anomalo, come un ordine caricato con uno zero in più. Un'anomalia contestuale sembra corretta da sola ma è sbagliata per il suo momento, mentre un'anomalia collettiva è uno schema sbagliato, come un tasso di valori nulli in lento aumento.
Come rileva le anomalie uno Z-score mobile?
Confronta ogni valore con il suo contesto recente anziché con una media globale. Una versione comune prende i 30 minuti che precedono un timestamp, rimuove gli outlier, calcola media e deviazione standard e segnala un punto il cui Z-score supera più o meno 2; un'altra variante usa una soglia di 3 deviazioni standard.
Quale metodo di anomaly detection per serie temporali conviene usare?
Partite dal più semplice che si adatta al caso. Gli Z-score mobili sono adatti a metriche stabili, la decomposizione STL gestisce una forte stagionalità, il matrix profile individua forme ripetute e l'isolation forest funziona su feature ingegnerizzate. Autoencoder, LSTM e transformer valgono la pena solo quando uno scoring più semplice continua a mancare gli stessi incidenti, perché sono più difficili da spiegare.
Perché l'accuratezza è una metrica inadeguata per l'anomaly detection?
Le anomalie sono rare, quindi un modello può ottenere un'accuratezza elevata pur mancando proprio i guasti che vi interessano. Tarate invece le soglie su porzioni storiche che includono stagionalità, caricamenti in ritardo e modifiche allo schema, e giudicate il rilevatore in base alla capacità di generare alert al momento giusto, con metrica, finestra e baseline allegate.
Perché i caricamenti di dati in ritardo causano falsi alert di anomalia?
Un caricamento in ritardo può far sembrare temporaneamente bassa una metrica anche quando il processo a monte è sano, e un rilevatore che non conosce gli orari previsti genera un falso allarme. L'articolo raccomanda rilevatori separati per valori, tempestività e schema, confrontando l'arrivo effettivo con orari appresi o dichiarati anziché con il valore di ieri.


