Recherche avec caractères génériques : un guide pratique pour 2026
|
9
minute de lecture

La plupart des conseils sur les caractères génériques vous disent de mémoriser les symboles et de passer à autre chose. Ce raccourci échoue en production, car la panne commence généralement lorsque le moteur cesse de traiter votre modèle comme un caractère générique au moment où vous en avez le plus besoin. Le résultat est des correspondances manquées, un rappel bruyant ou une requête qui semble inoffensive mais force une analyse lente de l'ensemble du système.
Table des matières
Pourquoi la recherche par caractères génériques est une décision opérationnelle, et pas seulement une astuce de syntaxe
Les quatre symboles génériques canoniques et leurs correspondances
Séquences de longueur arbitraire
Caractères uniques et classes de caractères
Alternance et structures de type regex
Aperçu de la syntaxe des caractères génériques multiplateformes
Modèles de requêtes réels pour l'exploration et la validation des données
Quelques modèles qui font leurs preuves
Performance, indexation et coût d'un caractère générique en tête
Deux solutions d'atténuation qui aident réellement
Où les caractères génériques cessent de fonctionner et comment le repérer
Des vérifications rapides qui révèlent le mode de défaillance
Une liste de contrôle pratique des caractères génériques avant de lancer l'exécution
Pourquoi la recherche par caractères génériques est une décision opérationnelle, et pas seulement une astuce de syntaxe
Un ingénieur du support tape *error* dans une boîte de recherche, s'attend à ce que toutes les lignes de log bruyantes remontent, et n'obtient rien, ou un délai d'expiration, ou un ensemble de résultats qui ignore complètement le caractère générique. Ce type d'échec est plus fréquent que de nombreuses équipes ne veulent l'admettre, car la gestion des caractères génériques change en fonction de la plateforme, de l'index et du pipeline de l'analyseur. Le même modèle peut se comporter d'une certaine manière en SQL, d'une autre dans un shell, et d'une troisième dans un moteur de recherche.
Il est préférable de traiter la recherche par caractères génériques comme un choix opérationnel, et non comme une fonctionnalité de confort. La documentation de SQL Server de Microsoft montre que % peut se placer au début, au milieu ou à la fin d'un modèle, et que _ correspond exactement à un caractère, tandis que les plages entre crochets comme [a-f] sont également valides dans les modèles LIKE, comme documenté par Microsoft. Les outils d'entreprise maintiennent cette même idée dans la recherche orientée utilisateur, car les correspondances partielles sont utiles lorsque vous ne connaissez pas l'orthographe exacte, mais le compromis est toujours le même : un rappel plus large signifie généralement plus de charge et plus de place pour des erreurs de correspondance silencieuses.
Règle pratique : ne demandez pas si les caractères génériques sont pris en charge. Demandez si la requête se comporte toujours comme un caractère générique après la tokenisation, la mise entre guillemets, l'échappement et la sélection de l'index.
Le reste du problème est plus simple à formuler qu'à résoudre. Vous devez connaître les symboles de base, la façon dont ils diffèrent d'une plateforme à l'autre, les points de rupture des performances et les systèmes qui cessent complètement de développer le modèle. C'est la partie que la plupart des guides sur les caractères génériques ignorent, et c'est celle qui compte lorsque votre éditeur de requêtes est connecté à la production. Pour les équipes qui gèrent la fiabilité des données, c'est le même genre de discipline que celle que vous appliquez aux vérifications de lignage et de fraîcheur, c'est pourquoi un outil comme la plateforme de data observability de digna a toute sa place dans la même discussion, même si le problème de recherche lui-même réside ailleurs.
Les quatre symboles génériques canoniques et leurs correspondances
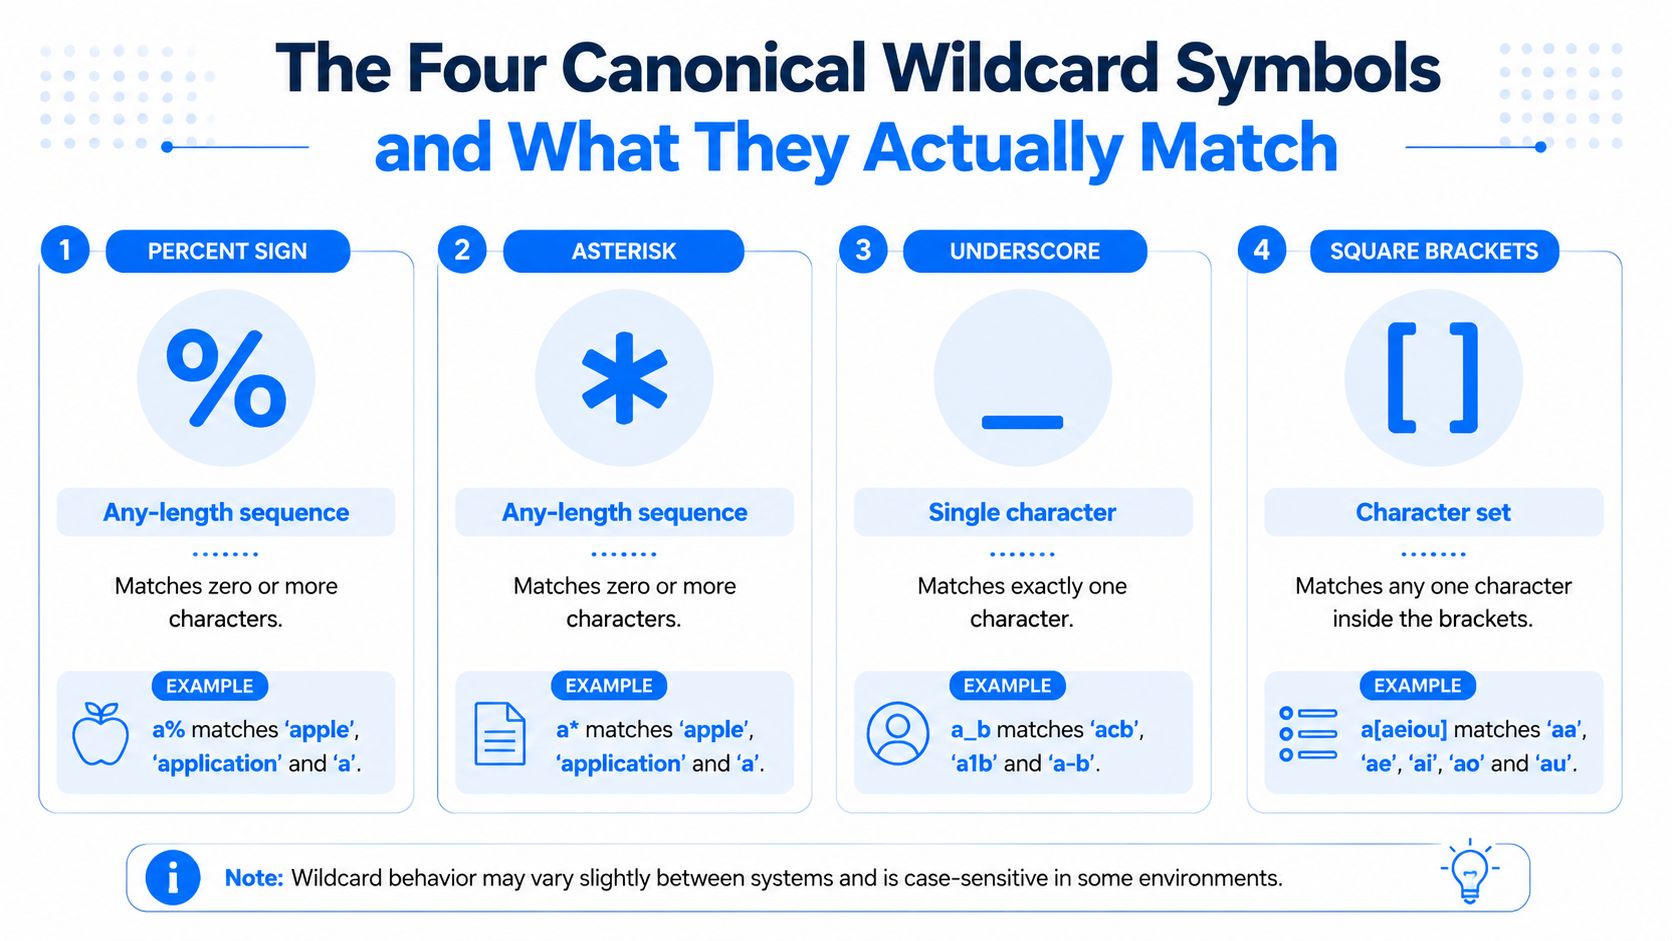
La façon la plus sûre d'aborder la syntaxe des caractères génériques est par le sens, et non par le symbole. Entre SQL, les globs de shell et les moteurs de recherche, la même intention apparaît sous différents caractères, et le moteur peut cesser de traiter ce caractère comme un caractère générique dès lors que la tokenisation, la mise entre guillemets ou l'échappement entrent en jeu.
Séquences de longueur arbitraire
En SQL, % correspond à zéro caractère ou plus. Un modèle comme LIKE 'cust%' correspondra à customer_id, cust et custodian, car la correspondance exige seulement que le texte commence par cust. Dans un shell POSIX, l'intention équivalente est généralement *, donc ls /var/log/*.log sélectionne les fichiers qui se terminent par .log.
Les moteurs de recherche empruntent souvent la même idée avec * ou % selon le langage de requête. La recherche d'historique de SQL Prompt de Redgate utilise * pour zéro caractère ou plus, et le filtre d'historique de Teradata utilise % dans le même rôle, c'est pourquoi la syntaxe des caractères génériques semble familière même lorsque l'interface du produit change, comme l'indique la documentation du filtre de caractères génériques de Teradata.
Caractères uniques et classes de caractères
Le caractère _ en SQL et ? dans les shells et de nombreux outils de recherche correspondent à exactement un caractère. Cela est important lorsque vous connaissez la forme de la valeur mais pas le caractère exact à une position donnée. status_1 et status?1 sont tous deux des outils de précision, pas des outils flous.
Les crochets vous permettent de définir une classe de caractères. SQL Server prend en charge les plages entre crochets comme [a-f], et Teradata prend en charge les ensembles entre crochets tels que [xyz] et [0-5] dans son filtre d'historique, conformément à la documentation sur les caractères génériques de SQL Server de Microsoft.
Alternance et structures de type regex
Les barres verticales apparaissent plus souvent dans les regex que dans la syntaxe pure des caractères génériques. Dans un champ de recherche, status:[active|pending] est un modèle courant pour l'alternance dans les systèmes de type chaîne de requête, tandis qu'un modèle d'e-mail peut s'appuyer sur des ensembles de caractères de type regex lorsque la syntaxe des caractères génériques n'est pas assez expressive. La règle utile est simple : les caractères génériques servent pour la forme, les regex pour la structure.
Utilisez un caractère générique lorsque la partie inconnue est large mais simple. Utilisez une correspondance exacte lorsque vous connaissez la valeur. N'utilisez une regex complète que lorsque vous avez besoin d'alternance, de groupement ou d'une validation qu'un glob ne peut pas exprimer clairement.
Pour une comparaison rapide avant de taper, l'aperçu du profilage des données de digna est un modèle mental utile car il pousse à la même habitude : vérifier la forme avant de faire confiance au résultat.
Aperçu de la syntaxe des caractères génériques multiplateformes
La même intention, faire correspondre des identifiants commençant par INV, se traduit par une syntaxe différente selon la plateforme. Cette différence est importante car une même forme de requête peut produire des caractéristiques de rappel, de classement et de charge très différentes dès lors que l'on passe du SQL aux moteurs de recherche et aux shells.
Plateforme | N'importe quelle chaîne | Caractère unique | Ensemble de caractères | Échappement littéral | Exemple, commence par |
|---|---|---|---|---|---|
SQL Server |
|
|
|
|
|
Filtre d'historique Teradata |
|
|
| Le |
|
Correspondance de modèles PostgreSQL |
|
| classes regex pour la correspondance avancée |
|
|
Chaîne de requête Elasticsearch |
|
| style regex uniquement lors de l'utilisation de requêtes regex | Échapper les caractères réservés de la requête |
|
Caractère générique OpenSearch |
|
| pas de système de classes, utilisez plutôt des regex ou d'autres types de requêtes | Échapper soigneusement les caractères réservés |
|
Splunk SPL | opérateurs de recherche, pas | n/a | fonctions regex ou analyse au moment de la recherche | dépend de la commande de recherche |
|
Shell POSIX |
|
|
| mettre les modèles entre guillemets pour empêcher l'expansion |
|
Les points de friction importent plus que les symboles. Le filtre de Teradata traite les correspondances de caractères génériques comme non sensibles à la casse et prend en charge la gestion du pourcentage littéral dans des exemples documentés tels que %[%]%, ce qui rappelle opportunément que les outils d'entreprise étendent souvent la grammaire au-delà du SQL des manuels. SQL Server conserve LIKE comme modèle de référence, tandis qu'OpenSearch et Elasticsearch réservent * et ? dans la syntaxe de requête et peuvent bloquer par défaut le comportement des caractères génériques en tête. Pour une vue plus large de la manière dont la forme de la requête affecte le coût d'exécution, le guide d'optimisation SQL de digna est une lecture complémentaire utile.
Un caractère générique est portable en tant qu'idée, pas en tant que caractère. Chaque moteur réapplique cette idée à sa frontière, et le mode de défaillance est généralement une requête qui semble correcte mais qui rate des enregistrements ou sollicite l'index beaucoup plus lourdement que prévu.
Modèles de requêtes réels pour l'exploration et la validation des données
Les requêtes les plus rentables ici sont généralement celles que vous écrivez une fois, inspectez, puis supprimez après l'audit. Les meilleures requêtes ici sont volontairement simples et faciles à retirer une fois la validation terminée.
Quelques modèles qui font leurs preuves
Pour la validation d'e-mails dans SQL Server, un modèle entre crochets est souvent suffisant pour un tri rapide, même s'il ne s'agit pas d'un validateur RFC complet. Un exemple pratique ressemble à LIKE '%@[A-Za-z0-9.-]%\.com', ce qui constitue un filtre grossier pour les adresses se terminant par .com et contenant une forme locale et de domaine plausible. Ce n'est pas un substitut à une règle de validation dédiée, mais cela fonctionne bien lorsque vous vérifiez l'absence de corruption évidente dans un chargement.
Pour le travail en shell, le modèle peut rester plus simple. Une vérification d'archive Linux comme find . -type f \( -name "*.csv" -o -name "*.json" \) -mtime +7 isole proprement les fichiers CSV et JSON obsolètes, car le caractère générique gère la sélection du nom de fichier et le filtre de date gère le contrôle du cycle de vie. Cette répartition permet de garder le modèle lisible et l'ensemble de résultats limité.
Dans OpenSearch, une recherche de code produit telle que { "wildcard": { "sku": "*aa*" } } trouve les SKU contenant deux voyelles consécutives au milieu, mais seulement si le champ est mappé d'une manière qui prend en charge la recherche par caractères génériques. C'est un modèle d'audit utile pour vérifier si les systèmes en amont ont introduit des formes de code inattendues.
Règle pratique : utilisez le caractère générique le plus étroit qui prouve ce que vous cherchez. Si vous connaissez déjà le préfixe ou le suffixe, ancrez-le. Si vous n'avez pas besoin de correspondance interne, évitez-la.
Lorsque je vérifie la cohérence du comportement de recherche pour un tableau de bord ou une revue, je cherche la plus petite requête qui expose tout de même le défaut. Cette même discipline se retrouve dans des travaux comme l'amélioration de la visibilité des marques dans l'IA, où la démarche utile consiste à contrôler la forme de la requête avant que le système ne s'éparpille trop largement.
Cas d'usage | SQL LIKE | Glob de shell | Moteur de recherche |
|---|---|---|---|
Audit d'e-mails |
| n/a | regex ou recherche par champ |
Nettoyage de fichiers | n/a |
| requête sur les métadonnées de fichiers indexés |
Vérification de la forme du SKU |
|
|
|
Validation de préfixe |
|
|
|
Les meilleures vérifications ici sont ciblées, temporaires et faciles à supprimer une fois que les données ont passé la revue. C'est le même état d'esprit qui sous-tend le nettoyage de données en SQL de digna, car ces deux tâches fonctionnent mieux lorsque vous confirmez la forme avant d'élargir la recherche.
Performance, Indexation et le Coût d'un Caractère Générique en Tête
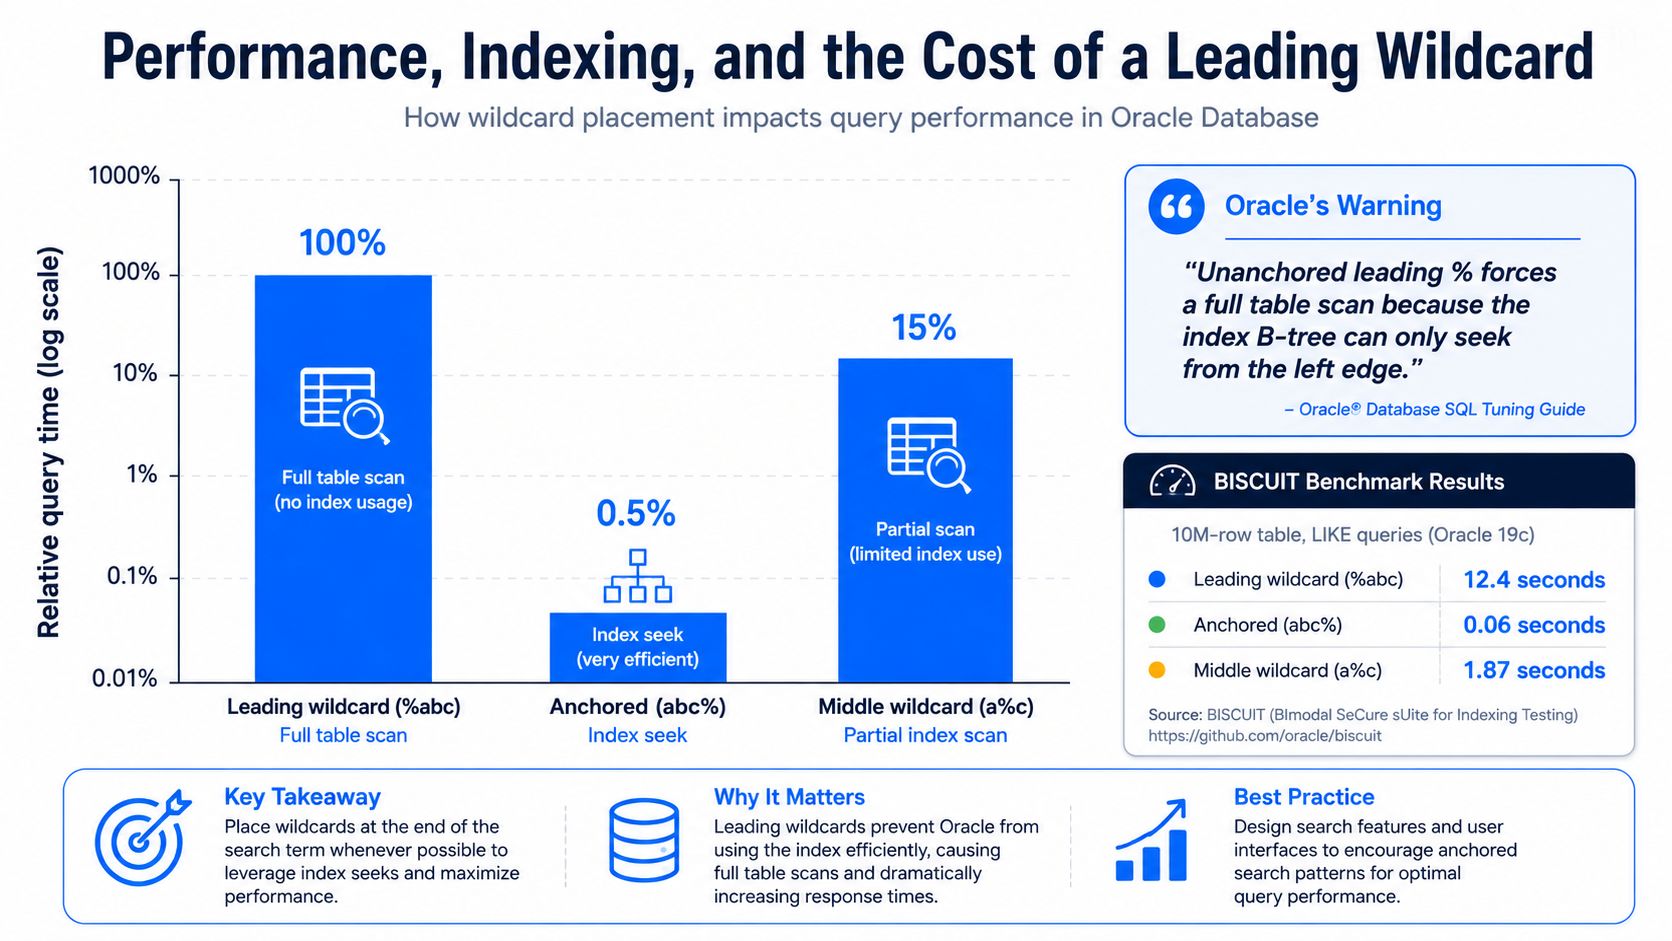
Un caractère générique en tête modifie le chemin d'exécution, et le coût se fait rapidement sentir. Oracle avertit que les recherches telles que a*, ou les requêtes composées uniquement de caractères génériques ou de ponctuation, peuvent prendre un temps considérable, et recommande d'utiliser au moins 2 à 3 caractères non génériques avant l'exécution, d'après les directives d'Oracle sur les caractères génériques.
Le moteur peut effectuer une recherche à partir du bord gauche, de sorte que abc% reste adapté aux index, alors que ce n'est généralement pas le cas pour %abc. Dès que le modèle cesse de fournir un préfixe stable à l'index, la requête passe d'une recherche rapide à un balayage complet. Dans le benchmark BISCUIT, les modèles de caractères génériques de suffixe et d'infixe se sont exécutés en 2,2 à 28,9 ms contre 34,97 à 189,3 ms pour Trigram/B-tree dans le benchmark publié, et la suite rapporte une accélération médiane de 14,4× par rapport à l'indexation B-tree avec 100 % d'exactitude sur 11 400 mesures benchmark BISCUIT. Le compromis réside dans le stockage, car l'index était environ 10× plus grand que Trigram benchmark BISCUIT.
Les moteurs de recherche suivent le même modèle, même si les mécanismes internes diffèrent. Un * en tête élimine le chemin facile ancré à gauche, de sorte que le moteur doit évaluer plus de termes et peut exercer une pression sur les nœuds coordinateurs et les protections d'expansion, comme l'expliquent la documentation sur les caractères génériques d'Elasticsearch et la documentation sur les caractères génériques d'OpenSearch. C'est pourquoi "ajouter simplement un caractère générique" devient une habitude coûteuse sur les grands index.
Deux solutions d'atténuation qui aident réellement
Index trigrammes ou n-grammes : utilisez-les lorsque les correspondances partielles se produisent souvent et à grande échelle. Ils offrent au moteur une structure sur laquelle effectuer la recherche au lieu d'imposer un balayage complet.
Index de champs inversés pour les recherches de suffixes : si les utilisateurs recherchent par la fin, stockez une copie inversée de la chaîne de caractères et ancrez le caractère générique sur le côté gauche du champ inversé. Cela transforme un problème de suffixe en un problème de préfixe.
Un modèle SQL courant pour l'approche par champ inversé est simple :
Pour la correspondance partielle dans PostgreSQL, l'indexation par trigramme est la solution privilégiée :
L'idée clé est simple. Le moteur a besoin d'aide dès que vous vous éloignez du bord gauche. Le guide d'optimisation des requêtes SQL de digna maintient cette discussion ancrée dans le coût d'exécution plutôt que dans la syntaxe des modèles.
Où les caractères génériques cessent de fonctionner et comment le repérer
La syntaxe des caractères génériques peut échouer sans générer d'erreur, ce qui est pire qu'une erreur de syntaxe évidente car la requête semble valide. SharePoint et certains outils de recherche d'entreprise suppriment par défaut les caractères génériques en tête, de sorte qu'une recherche qui semble large peut se transformer en une recherche de préfixe étroite, comme l'explique l'aide produit CAS sur les caractères génériques.
Les expressions entre guillemets sont un autre piège. De nombreux systèmes traitent les caractères génériques à l'intérieur de guillemets doubles comme du texte littéral, de sorte que "apple%" peut rechercher la chaîne exacte apple% au lieu de développer le modèle. Le comportement des caractères génériques de PubMed montre également un problème plus subtil. L'utilisation de caractères génériques peut bloquer le mappage automatique des termes, ce qui modifie le rappel de manières difficiles à détecter tant que l'on ne compare pas les résultats manuellement.
Des vérifications rapides qui révèlent le mode de défaillance
Caractère générique en tête supprimé : lancez
app%et comparez-le avec%app%sur le même corpus. Si le nombre de résultats change à peine, il se peut que la plateforme réécrive votre requête.Caractère générique ignoré entre guillemets : testez
"apple%"par rapport àapple%en dehors des guillemets et comparez l'explication brute de la requête, si la plateforme la propose.Règle du préfixe minimal appliquée : essayez un modèle avec un seul caractère non générique. Certains systèmes exigent au moins 3 caractères non génériques ou limitent à un seul caractère générique par terme.
Expansion plafonnée ou bloquée : certains moteurs de recherche ajoutent des protections qui limitent l'expansion des caractères génériques lorsque le modèle s'éparpillerait trop.
Comportement de la casse différent : une plateforme peut traiter les correspondances de caractères génériques comme insensibles à la casse par défaut, tandis qu'une autre propose ce comportement en option. Une même entrée peut renvoyer des résultats différents d'un système à l'autre.
La plupart des échecs liés aux caractères génériques proviennent d'attentes erronées, et non d'erreurs logiques.
La façon la plus rapide de les détecter est de tester le même modèle sur un ensemble de données minuscule et connu avant de le déployer dans un tableau de bord partagé ou une recherche enregistrée. Un petit ensemble de validation montre si le moteur réécrit la requête, abandonne le caractère générique ou renvoie un ensemble de résultats qui semble plausible mais auquel il manque les enregistrements attendus.
Une liste de contrôle pratique des caractères génériques avant de lancer l'exécution
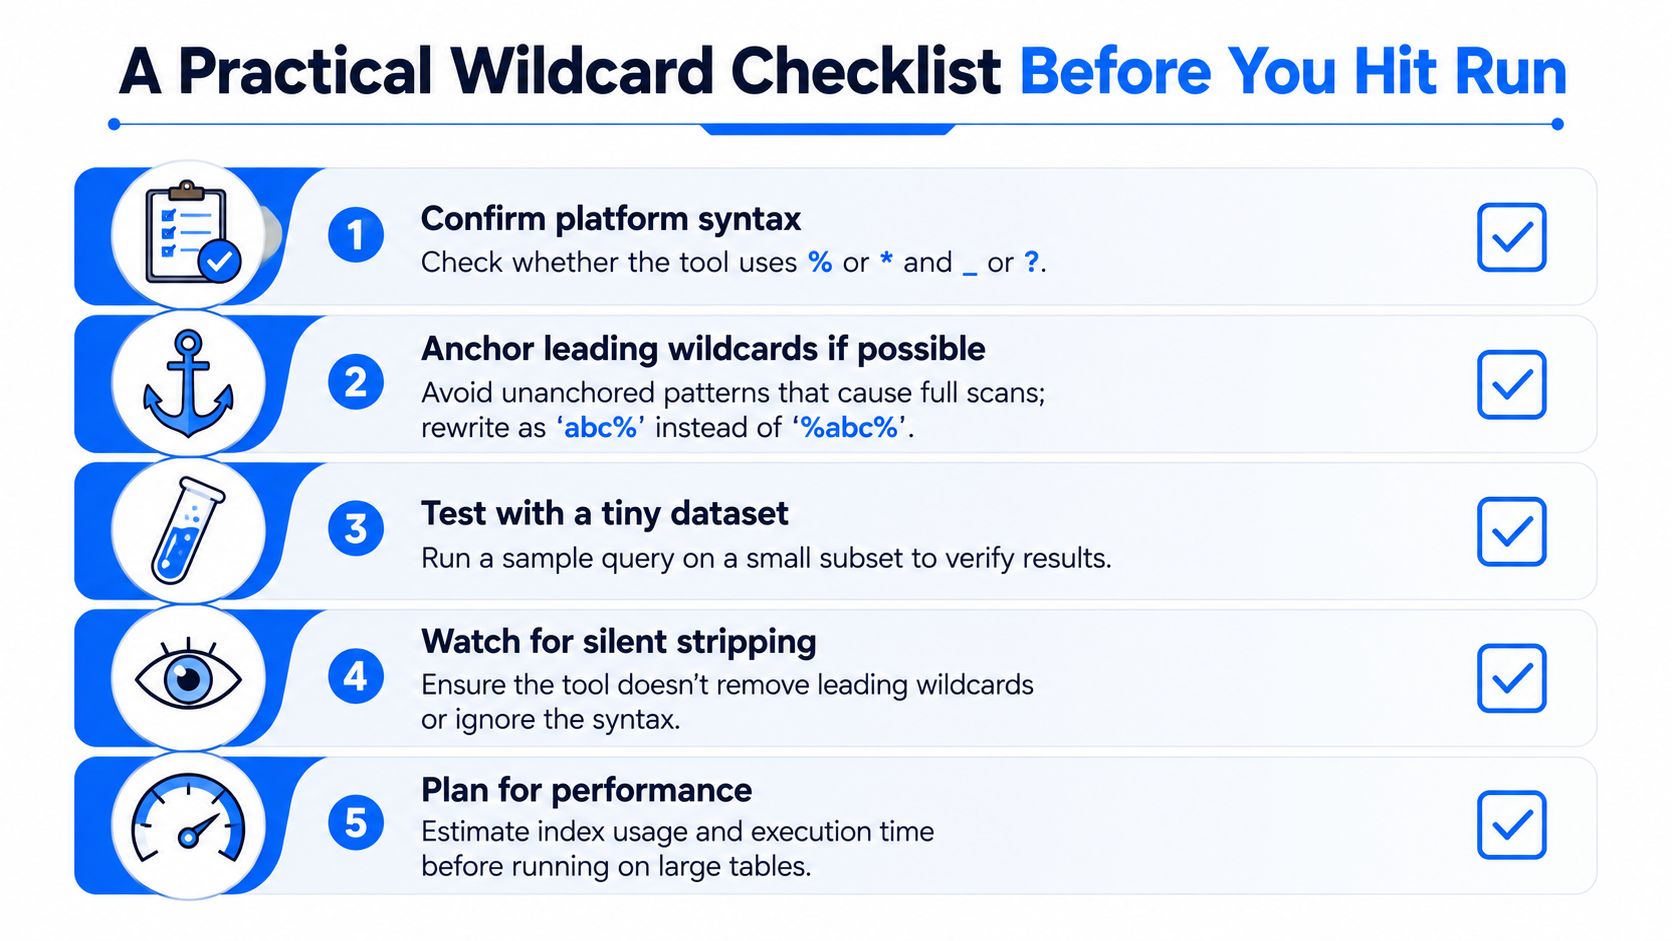
Avant de soumettre une requête avec des caractères génériques, vérifiez d'abord les règles de la plateforme. Regardez si elle utilise % ou *, si _ ou ? correspond à un seul caractère, et si les crochets, les guillemets ou d'autres symboles réservés modifient l'analyse syntaxique.
Ensuite, inspectez le modèle lui-même. Échappez les caractères spéciaux avant qu'ils n'atteignent l'analyseur, et assurez-vous que la requête est suffisamment étroite pour que le moteur puisse la traiter sans effectuer un balayage complet. Si le modèle doit s'exécuter dans un tableau de bord partagé, confirmez que les filtres de date, les limites de lignes et l'éligibilité de l'index s'appliquent toujours.
La gouvernance importe tout autant. Confirmez que la requête est enregistrée dans les logs, validée par rapport au schéma cible et testée pour les risques d'injection si une partie du modèle provient d'une saisie utilisateur. Une requête avec caractères génériques devrait être facile à expliquer à l'ingénieur suivant sans avoir à rouvrir le canal des incidents.
Appliquez cette liste de contrôle à chaque fois. La plupart des échecs de caractères génériques sont détectés avant l'exécution.
Questions fréquentes
Quels sont les quatre symboles génériques canoniques ?
Raisonnez par signification plutôt que par symbole. Les séquences de longueur quelconque utilisent % en SQL ou * dans de nombreux moteurs, les caractères uniques utilisent _ en SQL ou ? ailleurs, et les classes de caractères utilisent des crochets. La quatrième catégorie est le mécanisme d'échappement qui permet de rechercher les symboles eux-mêmes.
Que correspond réellement à % en SQL ?
Zéro caractère ou plus, et il peut se placer au début, au milieu ou à la fin d'un motif. LIKE 'cust%' correspond à customer_id, cust et custodian, car la comparaison exige seulement que le texte commence par cust, quoi qu'il suive.
Les classes de caractères fonctionnent-elles partout pareil ?
Globalement oui, avec des différences produit. SQL Server accepte les plages entre crochets comme [a-f] dans les motifs LIKE, et Teradata accepte des ensembles comme [xyz] et [0-5] dans son filtre d'historique : d'où cette impression de familiarité même quand le produit change.
Pourquoi la recherche par jokers est-elle une décision opérationnelle ?
Parce que la prise en charge des jokers n'est pas la vraie question. Demandez plutôt si la requête se comporte encore comme un joker après tokenisation, mise entre guillemets, échappement et choix d'index. Un joker en tête transforme en particulier un accès indexé en balayage complet, sans erreur de syntaxe.
Pourquoi une recherche par jokers ne renvoie-t-elle rien ou expire-t-elle ?
Le plus souvent parce qu'une de ces couches est intervenue. Taper *error* et ne rien obtenir, subir un délai dépassé ou recevoir un résultat qui ignore le joker sont trois symptômes d'une même cause : le motif a été réécrit ou l'index n'a pas pu le servir.


