Pourquoi la qualité des données est importante pour une organisation
|
8
minute de lecture

Une équipe de direction commence la matinée par une routine familière. La finance consulte le tableau de bord du chiffre d'affaires, les opérations vérifient les volumes traités, les ventes étudient le pipeline et le service client se prépare à la demande du jour. L'après-midi, quelqu'un découvre qu'une source a livré en retard, qu'une autre a changé le nom d'un champ et qu'une troisième contient des enregistrements clients en double. Le tableau de bord semblait précis, mais l'organisation décidait à partir d'une image incomplète.
Le problème est rarement une panne spectaculaire de base de données. C'est un champ manquant, un extrait périmé, une définition incohérente ou un changement de schéma que personne n'a remarqué. Ces défauts voyagent jusqu'aux prévisions, aux rapports réglementaires, aux parcours clients et aux systèmes d'IA avant que quiconque ne remonte à la source d'origine.
C'est pourquoi la question de l'importance de la qualité des données pour une organisation est une question métier, et pas seulement technique. Des données fiables permettent de décider, d'agir, d'expliquer et de se conformer en confiance. Des données défaillantes obligent les équipes à remettre en cause les rapports, à refaire le travail, à reporter des initiatives et à défendre des chiffres qu'elles ne peuvent pas tracer entièrement. Ce guide explique comment la qualité des données crée un contrôle organisationnel sur les décisions, la conformité et le risque lié à l'IA, et comment les dirigeants peuvent en faire une capacité opérationnelle durable. Pour un aperçu concret de sa valeur métier, voir les bénéfices organisationnels de la qualité des données.
Sommaire
Introduction : pourquoi la qualité des données façonne la réussite de l'organisation
Ce que la qualité des données signifie dans une organisation
Le vrai coût d'une mauvaise qualité des données pour les organisations
Comment une mauvaise qualité des données mine les décisions, la confiance et l'IA
Comment les organisations construisent une qualité des données et une observabilité fiables
Exemples concrets de l'impact de la qualité des données selon les secteurs
Introduction : pourquoi la qualité des données façonne la réussite de l'organisation
Une prévision peut échouer même lorsque le calcul est juste. Supposons qu'une équipe de planification anticipe une hausse des commandes et organise stocks, effectifs et transport en conséquence. La prévision utilise un modèle valide, mais un système régional envoie en retard les transactions de la veille et un autre enregistre les retours sous une catégorie modifiée. L'équipe ne regarde pas des absurdités. Elle regarde des données qui ne représentent plus l'entreprise dans son ensemble.
Cette distinction compte. La plupart des décisions d'entreprise dépendent de l'assemblage de plusieurs systèmes : clients, commandes, paiements, stocks, interactions de service, données RH et informations externes. Un défaut dans un flux peut modifier le sens d'un résultat combiné. La finance peut voir un chiffre d'affaires qui ne se réconcilie pas, le service client peut contacter la mauvaise personne, et les dirigeants peuvent passer une réunion à débattre de quel tableur a raison au lieu de décider quoi faire.
Les problèmes de qualité traversent les frontières fonctionnelles
La qualité des données concerne chaque équipe qui consomme de l'information :
La finance s'en sert pour les clôtures, la planification, les contrôles et le reporting.
Les opérations s'appuient sur des enregistrements complets et livrés à temps pour coordonner le travail.
Les ventes et le marketing ont besoin de données clients et comptes cohérentes pour prioriser les opportunités.
Le service client dépend d'identités, d'historiques et de détails de dossiers exacts.
Le risque et la conformité exigent des preuves traçables à l'appui d'obligations formelles.
Les équipes data et IA ont besoin d'entrées fiables pour les tableaux de bord, les modèles et les traitements automatisés.
L'équipe data détecte parfois le défaut, mais c'est souvent le métier qui en supporte les conséquences. Une livraison tardive devient une décision opérationnelle manquée. Un compte en double devient un traitement client incohérent. Une colonne renommée peut conduire un rapport en aval à afficher une mesure vide ou trompeuse sans produire d'erreur visible.
Règle pratique : traitez chaque jeu de données critique comme une partie d'un processus opérationnel, et non comme un actif technique passif.
Les organisations démarrent souvent le travail sur la qualité après un incident visible. Un rapport casse, un régulateur demande des preuves, ou un modèle produit un résultat invraisemblable. Cette réaction est compréhensible, mais elle fait payer aux dirigeants la découverte, l'investigation, la correction et la communication au moment le plus coûteux du cycle de vie.
Une approche plus solide pose les questions plus tôt. À qui appartiennent les données ? Que signifie « complet » pour ce cas d'usage ? Quelle fraîcheur est nécessaire ? Quels changements doivent arrêter un pipeline et lesquels ne justifient qu'une alerte ? Une fois ces réponses explicites, la qualité des données devient pilotable au lieu de rester un sujet de débat.
Ce que la qualité des données signifie dans une organisation
Imaginez les données de l'entreprise comme un réseau d'eau potable. L'information naît de nombreuses sources, passe par des points de traitement et de distribution, puis arrive à un robinet où quelqu'un l'utilise. Un verre d'apparence limpide ne prouve pas que toute la chaîne est saine. L'organisation doit aussi savoir si l'eau est arrivée à temps, si des contaminants sont entrés en amont et si la pression suffit à l'usage prévu.
La qualité des données fonctionne de la même façon. Un jeu de données est adapté à son usage lorsqu'il présente les caractéristiques qu'exigent une décision ou un processus donnés. Un rapport stratégique mensuel tolère peut-être un léger retard, ce qui n'est pas le cas d'un processus antifraude ou d'une alerte opérationnelle. Un jeu d'entraînement pour l'IA peut exiger une traçabilité solide et des libellés cohérents en plus des qualités attendues dans un tableau de bord.
Six contrôles rendent la qualité concrète
Commencez par les dimensions qui indiquent si des données peuvent soutenir un usage en toute sécurité :
L'exactitude signifie que la valeur reflète la réalité qu'elle représente. L'adresse actuelle d'un client doit indiquer où il peut être joint.
La complétude signifie qu'aucune information critique ne manque. Une commande sans identifiant produit peut exister dans le système sans pour autant soutenir une analyse produit fiable.
La cohérence signifie que les systèmes liés utilisent des valeurs et des définitions compatibles. Si une équipe marque un client comme actif et une autre maintient un statut contradictoire, l'enregistrement combiné ne peut pas être interprété avec confiance.
La fraîcheur signifie que l'information arrive et reste à jour au moment où le processus en a besoin. Une valeur correcte livrée après la fenêtre de décision peut rester inutilisable sur le plan opérationnel.
La validité signifie que les données respectent les formats, plages et règles métier exigés. Une date, un identifiant ou une catégorie peuvent être présents et enfreindre malgré tout les règles nécessaires au traitement.
L'unicité signifie que l'organisation ne compte pas plusieurs fois la même entité réelle. Des enregistrements clients ou transactions en double peuvent fausser le volume, la valeur et la priorisation.

L'adéquation compte plus que la perfection
Aucune organisation n'a besoin que chaque champ soit parfait pour fonctionner. La bonne question est de savoir si les données sont assez fiables pour l'usage prévu, avec des limites connues et des responsables identifiés. Un parcours de service client privilégiera l'exactitude et la complétude de l'identité, tandis qu'un rapport de tendance destiné à la direction privilégiera la cohérence et la comparabilité historique.
C'est pourquoi les exigences de qualité doivent être définies avec les utilisateurs métier. Demandez quelle décision les données soutiennent, ce que coûterait une défaillance, en combien de temps un problème doit être détecté et quelles preuves les utilisateurs attendent pour faire confiance au résultat. La signification de la qualité des données devient plus claire quand les équipes relient chaque dimension à un processus réel plutôt qu'à un score abstrait.
Le vrai coût d'une mauvaise qualité des données pour les organisations
Une mauvaise qualité des données crée des pertes visibles, comme des paiements erronés ou des rapports en échec. Son coût le plus lourd apparaît souvent sous forme de frictions accumulées. Les analystes réconcilient des fichiers à la main, les ingénieurs enquêtent sur des changements de pipeline inexpliqués et les responsables reportent des décisions pendant que les équipes vérifient les chiffres. Les équipes commerciales perdent confiance dans des enregistrements censés guider l'action.
IBM cite une étude de Gartner estimant que les organisations perdent en moyenne 12,9 millions USD par an à cause d'une mauvaise qualité des données, comme le rapporte l'analyse d'IBM sur le coût d'une mauvaise qualité des données. La même analyse indique que 43 % des directeurs des opérations classent les problèmes de qualité des données au premier rang de leurs priorités data. Plus d'un quart des organisations estiment leurs pertes annuelles au-delà de 5 millions USD, tandis que 7 % déclarent des pertes de 25 millions USD ou plus.
Ces chiffres décrivent une exposition à l'échelle des grands groupes, mais le mécanisme est familier dans les organisations de toute taille. Un enregistrement défectueux crée de la reprise. La reprise consomme de la capacité, et la capacité perdue retarde des initiatives censées créer de la valeur. Les équipes peuvent aussi estimer leur exposition avec ce calculateur du coût du data downtime.
La facture dépasse la correction
Le mémo dirigeants 2024 d'Anomalo rapporte que 95 % des dirigeants avaient connu un problème de qualité des données ayant un impact direct sur les résultats, d'après le State of Enterprise Data Quality report. Cet impact peut prendre plusieurs formes :
Effort manuel : les équipes comparent des extraits, réparent des enregistrements et expliquent des écarts au lieu d'améliorer les produits ou les services.
Fuite de revenus : une information client, produit ou compte erronée peut empêcher la bonne offre, la bonne facture ou la bonne relance d'atteindre sa cible.
Latence de décision : les dirigeants attendent la réconciliation avant d'approuver des actions, des lancements ou des investissements.
Frein à la transformation : les programmes de modernisation s'enlisent quand d'anciennes définitions et de nouvelles plateformes produisent des résultats contradictoires.
Coûts de contrôle : les équipes conformité et audit passent plus de temps à rassembler des preuves et à instruire des exceptions.
Un rapport 2025 sur la gestion des données CRM a constaté que 76 % des organisations estimaient que moins de la moitié de leurs données CRM étaient exactes et complètes. Le même rapport indique que 37 % voyaient dans la mauvaise qualité des données une cause directe de perte de revenus et que 37 % estimaient qu'elle avait retardé des initiatives clés génératrices de revenus, selon le communiqué de Validity sur le State of CRM Data Management 2025.
Pourquoi les coûts s'accumulent
Les défauts de données restent rarement dans le système où ils apparaissent. Un identifiant manquant peut casser une jointure, fausser une métrique, modifier une prévision et influencer une décision d'effectifs ou d'investissement. Chaque équipe en aval applique alors sa propre correction, multipliant l'effort initial.
Des travaux indépendants cités dans la littérature récente font état de pertes annuelles moyennes d'environ 12,9 millions de dollars par organisation. D'autres études estiment que des données défaillantes peuvent absorber 15 % à 25 % du chiffre d'affaires dans de nombreuses entreprises via la reprise, la correction d'erreurs, les occasions manquées et les décisions erronées, comme le discute la recherche publiée sur les coûts de la qualité des données.
La question de l'investissement dépasse donc le coût d'une plateforme de qualité. Les organisations financent aussi un travail de correction récurrent, des décisions retardées, une activité de contrôle et l'exposition créée lorsque la responsabilité, la fraîcheur ou les changements de schéma passent inaperçus.
Comment une mauvaise qualité des données mine les décisions, la confiance et l'IA
Un tableau de bord financier montre un chiffre d'affaires en hausse, la direction approuve donc des recrutements. Plus tard, l'équipe découvre qu'une table source est arrivée en retard et excluait des transactions récentes. Rien ne paraissait cassé à l'écran. La décision reposait pourtant sur des preuves incomplètes.
Un rapport peut s'afficher normalement alors que son sens a changé. Un champ renommé, un schéma modifié ou une définition métier révisée peut traverser le pipeline sans erreur visible. Le résultat est plus dangereux qu'un rapport vide, car des chiffres familiers incitent à agir avant que quiconque n'enquête.
La confiance s'affaiblit alors dans toute l'organisation. Les dirigeants doutent des métriques officielles, les analystes défendent des chiffres qu'ils n'ont pas produits et les équipes maintiennent des tableurs personnels ou des explications orales pour combler les manques. La qualité des données est devenue un enjeu de contrôle organisationnel, et pas seulement une affaire de tableau de bord.
Les défaillances silencieuses abîment la confiance
Plusieurs chemins de défaillance méritent l'attention :
Des données périmées font passer la situation actuelle pour de l'historique.
La dérive de schéma modifie des champs, des types ou des structures que les utilisateurs en aval peuvent mal interpréter.
Une livraison incomplète retire d'une mesure une partie d'une population ou d'une période de reporting.
Des changements de distribution non observés font que les données se comportent autrement que la ligne de base utilisée par un rapport ou un modèle.
Des définitions incohérentes permettent à deux équipes crédibles de donner des réponses différentes à la même question métier.
La recherche et la littérature sectorielle associent les données défaillantes à une moindre exactitude des décisions, à une confiance réduite dans le reporting et à des réactions plus lentes. Une source fondée sur des enquêtes identifie la qualité des données comme le deuxième obstacle le plus cité à la création de valeur à partir des données et de l'analytique. Une autre rapporte que 91 % des dirigeants estimaient qu'investir dans la qualité des données avait eu un effet positif sur la croissance, comme le résume O'Reilly dans son analyse de la qualité des données.
Ces défaillances créent aussi des lacunes de contrôle. Si personne ne porte une définition, ne surveille la fraîcheur ou ne revoit les changements de schéma, l'organisation peut être incapable d'expliquer pourquoi un chiffre a changé ou de prouver quelles données ont soutenu une décision.
L'IA relève le niveau d'exigence
Les systèmes d'IA réutilisent les données à grande vitesse et à grande échelle. Un modèle peut apprendre à partir d'enregistrements incomplets, un agent peut interroger une colonne renommée et un traitement automatisé peut agir sur un statut périmé. La sortie peut sembler assurée alors que ses preuves sont fausses. Pour une explication concrète de cette dépendance, voir pourquoi les modèles d'IA dépendent de la qualité des données.
L'ISO/IEC 5259-5:2025 présente la gouvernance de la qualité des données comme un cadre organisationnel couvrant tout le cycle de vie de la donnée pour l'analytique et l'apprentissage automatique, comme le décrit la présentation de la norme ISO/IEC 5259-5:2025. La question posée aux dirigeants dépasse donc l'exactitude d'un tableau de bord : qui a gouverné les données, quels contrôles s'appliquaient, et sont-elles restées adaptées à l'entraînement, à l'inférence et à la preuve réglementaire ?
Éclairage gouvernance : le risque lié à l'IA commence en amont, là où les équipes définissent, collectent, transforment, documentent et approuvent les données qu'un système automatisé utilisera.
La qualité joue le rôle d'un plan de contrôle reliant l'exactitude opérationnelle, la confiance dans les décisions, la preuve de conformité et la responsabilité sur l'IA. Surveiller uniquement les sorties des modèles ou la disponibilité des tableaux de bord revient à observer la dernière étape alors que des défaillances antérieures ont pu passer inaperçues.
Comment les organisations construisent une qualité des données et une observabilité fiables
Le nettoyage réactif et l'observabilité proactive résolvent des problèmes différents. Le nettoyage répare des défauts connus après qu'ils ont atteint un consommateur. L'observabilité aide les équipes à comprendre ce qui a changé, quand, quels actifs sont touchés et si le comportement s'écarte d'une ligne de base attendue.
Un programme durable utilise les deux, mais place la prévention et la détection précoce plus près de la source. Le but n'est pas de créer des règles sans fin. Il s'agit d'expliciter les attentes importantes, de les surveiller en continu et d'orienter les défaillances vers ceux qui peuvent les corriger.
Commencer par la responsabilité et la finalité
Désignez un responsable pour chaque domaine de données critique. Ce responsable doit travailler avec les ingénieurs data, les analystes, les équipes risque et les utilisateurs opérationnels pour définir la qualité acceptable des processus qui dépendent des données.
Une fiche de responsabilité utile comprend :
Finalité métier : quelle décision, interaction client, contrôle ou modèle utilise ce jeu de données ?
Attentes de qualité : quels champs doivent être complets, valides, cohérents, uniques, exacts ou à jour ?
Niveau d'impact : que se passe-t-il si le jeu de données est faux ou en retard ?
Chemin de réponse : qui enquête, qui approuve une solution de contournement et qui confirme la résolution ?
Preuves : quels contrôles, éléments de traçabilité et enregistrements d'incidents démontrent la maîtrise ?
Sans responsabilité, la surveillance devient un service de notification. Les alertes arrivent, mais personne n'a l'autorité ni le contexte pour décider si le problème compte.
Comparer le nettoyage réactif et le contrôle continu
Nettoyage réactif | Qualité et observabilité proactives |
|---|---|
Trouve les défauts après qu'un rapport ou un utilisateur les a remarqués | Détecte les comportements inhabituels avant l'usage en aval |
Se concentre sur des enregistrements isolés ou des règles connues | Associe la validation à des signaux de fraîcheur, de volume, de traçabilité et de schéma |
Répare les symptômes en aval | Aide les équipes à corriger les problèmes à la source |
Produit des explications ponctuelles | Construit des preuves reproductibles pour la gouvernance et l'audit |
Mesure les incidents après la perturbation | Suit les tendances et la dégradation dans le temps |
Les contrôles continus doivent couvrir les règles métier au niveau de l'enregistrement, les délais de livraison, le comportement des volumes et les changements structurels. Une exécution dans la base de données permet en outre de garder les données dans l'environnement du client pendant que métriques et analyses s'exécutent là où les données résident déjà.
Utiliser l'observabilité comme couche opérationnelle partagée
digna propose une plateforme modulaire de qualité des données et d'observabilité qui s'exécute dans l'environnement du client. Ses capacités couvrent la détection d'anomalies, l'analyse historique des métriques, la surveillance Timeliness, la validation au niveau de l'enregistrement, le suivi des changements de schéma, l'exécution en base, le déploiement privé ou sur site et un tableau de bord partagé entre ingénieurs data, analystes et parties prenantes. Les équipes peuvent en apprendre davantage sur l'observabilité des données en tant que discipline opérationnelle, puis évaluer quels contrôles conviennent à leur architecture et à leur profil de risque.
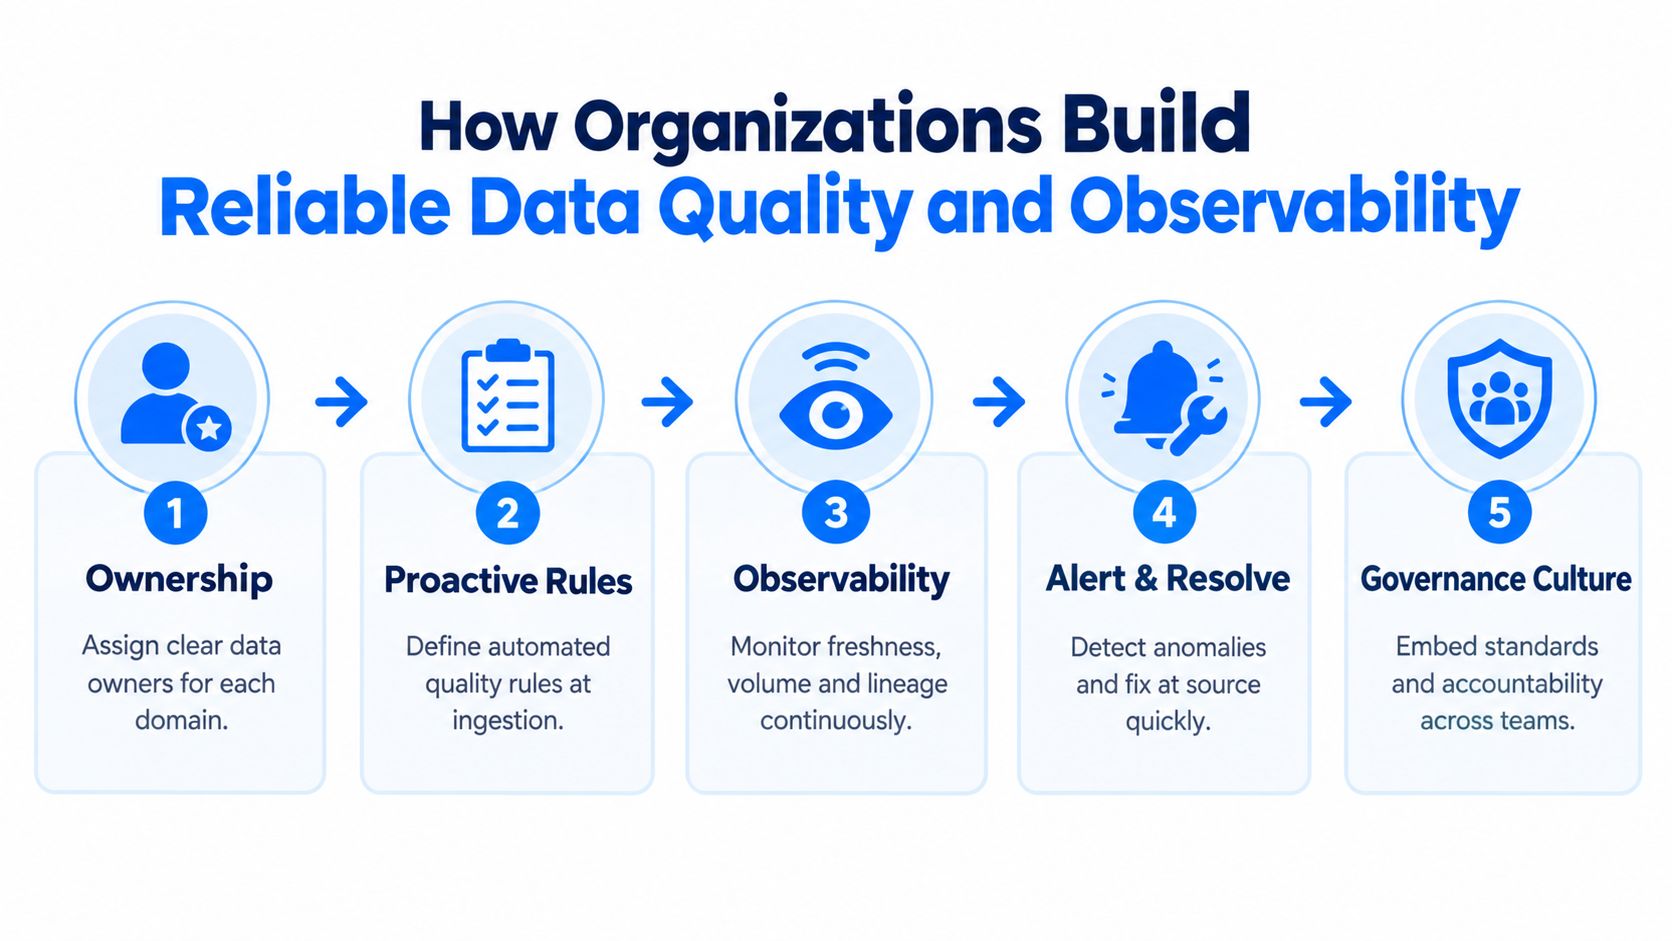
La plateforme n'est qu'une partie du programme. Les dirigeants ont toujours besoin de définitions claires, d'accords de réponse et d'incitations qui récompensent la prévention plutôt que la réparation discrète en aval. L'observabilité donne de la visibilité. La gouvernance donne l'autorité et la responsabilité.
Exemples concrets de l'impact de la qualité des données selon les secteurs
Les mêmes dimensions de qualité créent des risques différents selon le secteur. Un flux de transactions en retard peut affecter le reporting de risque dans la finance, tandis qu'une valeur clinique manquante peut affecter la coordination des soins dans la santé. Le schéma de contrôle reste reconnaissable, mais la conséquence métier et les preuves exigées changent.
Services financiers
Une banque peut dépendre de données de transactions, clients, risque et réglementaires qui traversent plusieurs plateformes. Si un changement de schéma modifie le type d'un champ ou si un flux arrive en retard, les équipes de reporting réconcilient les chiffres à la main pendant que les équipes risque se demandent si elles travaillent sur la même population. Les contrôles de qualité doivent valider les règles métier, suivre les livraisons, détecter les schémas inhabituels et conserver les preuves de ce qui a changé et de la réponse apportée.
Santé
Les organisations de santé combinent des données cliniques, administratives, de facturation et opérationnelles. Des identifiants incohérents peuvent séparer des événements liés, tandis qu'une information incomplète ou retardée complique la compréhension d'un patient ou d'un épisode de soins. Ici, la complétude et la cohérence soutiennent une coordination sûre, tandis que la fraîcheur et la traçabilité soutiennent les processus opérationnels et réglementaires.
Télécommunications
Les équipes télécoms travaillent avec des données clients, réseau, facturation et usage à fort volume. Un changement soudain du volume d'enregistrements peut signaler un incident de pipeline, une modification du système source ou une véritable évolution de l'activité. Surveiller la livraison attendue, les comportements inhabituels et les changements structurels aide à distinguer un mouvement métier d'une défaillance de données avant que rapports ou processus opérationnels ne réagissent de travers.
Secteur public
Les organisations publiques doivent souvent combiner des données entre administrations tout en préservant l'auditabilité et des définitions cohérentes. Une rupture de traçabilité peut rendre difficile l'explication de la production d'un chiffre. La validation, la responsabilité et la preuve comptent, car les décideurs peuvent avoir à justifier non seulement le résultat, mais aussi le processus qui l'a produit.
Principe sectoriel : le bon contrôle qualité est celui qui est rattaché à une décision, une obligation ou un résultat de service réels.
Ces exemples montrent aussi pourquoi un score unique à l'échelle de l'entreprise raconte rarement toute l'histoire. Un jeu de données peut convenir à une analyse de tendance large et être inadapté à un calcul réglementé. Les programmes qualité doivent donc classer les données par usage, risque et réponse attendue plutôt qu'appliquer un seuil universel.
Installer une culture durable de la qualité des données
Un programme de qualité des données qui dure repose sur trois habitudes : la responsabilité, la visibilité continue et la redevabilité métier.
La responsabilité signifie que chaque jeu de données critique a une personne ou une équipe nommée, chargée de sa définition, de son état acceptable et de son chemin de résolution. Cette responsabilité ne doit pas disparaître lorsque les données passent d'un système opérationnel à un entrepôt, un lac, un tableau de bord, un modèle ou un traitement d'IA.
La visibilité continue signifie que les équipes surveillent plus que des règles de réussite ou d'échec. Elles observent la fraîcheur, le volume, la complétude, la validité, les comportements inhabituels et les changements structurels. Elles conservent aussi assez de traçabilité et de contexte d'incident pour expliquer quels consommateurs peuvent être touchés.
La redevabilité métier signifie que les mesures de qualité se rattachent à des résultats. Plutôt que de signaler seulement qu'un contrôle a échoué, les équipes doivent expliquer si l'échec menace un processus client, un contrôle financier, une déclaration réglementaire, une prévision ou un cas d'usage d'IA.
Une liste de démarrage concrète ressemble à ceci :
Choisir les actifs critiques : identifiez les jeux de données qui soutiennent des décisions et des obligations importantes.
Définir l'adéquation : convenez de ce que signifient exact, complet, cohérent, valide, unique et à jour pour chaque usage.
Attribuer la réponse : établissez qui reçoit les alertes et qui peut résoudre les problèmes à la source.
Surveiller en continu : détectez la dégradation avant qu'elle n'atteigne rapports, modèles ou actions automatisées.
Évaluer la valeur : suivez la baisse des reprises, la résolution plus rapide, des preuves plus solides et une confiance accrue dans l'analytique.
La leçon centrale est simple. La qualité des données n'est pas un vernis appliqué avant le reporting. C'est la couche de contrôle qui aide une organisation à décider de façon responsable, à démontrer sa conformité et à utiliser l'IA sans abandonner son jugement à des entrées peu fiables.
digna aide les organisations à surveiller le comportement des données, valider les enregistrements, suivre la Timeliness, détecter les changements de schéma et observer les métriques métier et plateforme dans leur propre environnement. Rendez-vous sur digna pour voir comment sa plateforme modulaire de qualité des données et d'observabilité peut soutenir une base plus fiable pour l'analytique et l'IA.
Pour le modèle opérationnel qui transforme ces attentes en contrôles continus plutôt qu'en nettoyages périodiques, voir la gestion de la qualité des données.
Questions fréquentes
Combien coûte une mauvaise qualité des données à une organisation ?
IBM cite Gartner avec une perte moyenne de 12,9 millions USD par an. Plus d'un quart des organisations estiment leurs pertes annuelles au-delà de 5 millions USD et 7 % déclarent 25 millions ou plus, tandis que 43 % des directeurs des opérations placent la qualité des données au premier rang de leurs priorités.
Pourquoi de petits défauts causent-ils autant de dégâts ?
Parce qu'ils voyagent. Un champ manquant, un extrait périmé, une définition incohérente ou un changement de schéma inaperçu atteint les prévisions, les rapports réglementaires, les parcours clients et les systèmes d'IA avant que quiconque ne remonte à la source. La perte visible, c'est la reprise ; la plus lourde, ce sont les frictions accumulées et les décisions retardées.
La qualité des données et l'observabilité des données sont-elles la même chose ?
Elles répondent à des questions différentes. Le nettoyage répare des défauts connus une fois qu'un consommateur les a vus, tandis que l'observabilité explique ce qui a changé, quand, quels actifs sont touchés et si le comportement s'écarte d'une ligne de base attendue. Un programme durable utilise les deux, mais rapproche prévention et détection de la source.
Par où une organisation doit-elle commencer ?
Par la responsabilité, pas par les règles. Désignez un responsable pour chaque domaine de données critique, puis consignez la finalité métier, les attentes de qualité par champ, le niveau d'impact si les données sont fausses ou tardives, et le chemin de réponse précisant qui enquête, qui approuve un contournement et qui confirme la résolution.
Le risque diffère-t-il selon le secteur ?
Les dimensions de qualité restent les mêmes ; la conséquence, non. Dans la finance, un flux en retard ou un type de champ modifié impose une réconciliation manuelle dans le reporting de risque. Dans la santé, des identifiants incohérents séparent des événements liés et retardent la coordination des soins. Les preuves à conserver dépendent du régulateur, pas du pipeline.



