Data Observability pour les ingénieurs de données : un guide pratique
|
7
minute de lecture

Un pipeline de traitement par lots peut s'achever avec un voyant vert alors que le tableau de bord qu'il alimente est déjà erroné. Le chargement peut ne contenir qu'une partie des données attendues, un système en amont peut avoir ajouté une colonne qui modifie une transformation, ou la dernière partition peut avoir plusieurs heures de retard. La surveillance de l'infrastructure indique une exécution réussie, tandis que les analystes et les systèmes d'apprentissage automatique consomment des résultats obsolètes ou corrompus.
C'est dans cet écart que la data observability pour les ingénieurs de données trouve sa place. Elle examine le comportement des données qui transitent par les entrepôts, les lacs, les flux et les transformations, puis associe les anomalies à leur propriétaire, à leur impact et à la réponse à y apporter. Le défi pratique ne consiste pas à collecter tous les signaux possibles. Il s'agit d'établir une couverture suffisante pour détecter les défaillances significatives sans sortir les données sensibles de votre environnement ni submerger les ingénieurs d'alertes.
Table des matières
Pourquoi les ingénieurs de données ont besoin d'une Observability au-delà de la surveillance des pipelines
Systèmes de surveillance et données de surveillance
Les cinq piliers et leur valeur pratique
L'instrumentation des quatre SLI essentiels dont chaque pipeline a besoin
1. Taux de réussite des tâches
2. Latence de fraîcheur
3. Complétude et volume
4. Conformité du schéma
Résoudre le problème de la fatigue liée aux alertes qui nuit à l'Observability
Concevoir des alertes autour de décisions
Mesurer la qualité de la détection, et non le volume des notifications
Mise en œuvre de l'Observability dans les environnements réglementés et sur site
Une séquence de déploiement qui résiste à l'examen de sécurité
Les parcs hétérogènes ont besoin d'un contrat commun
Choisir la bonne stratégie d'alerte pour votre pile de données
Quand les règles simples l'emportent
Quand les méthodes adaptatives sont utiles
Intégrer l'Observability dans votre architecture de pipeline existante
Placer les contrôles là où ils apportent une réponse à une question
Commencer petit et faire évoluer votre mise en œuvre de l'Observability
Pourquoi les ingénieurs de données ont besoin d'une Observability au-delà de la surveillance des pipelines
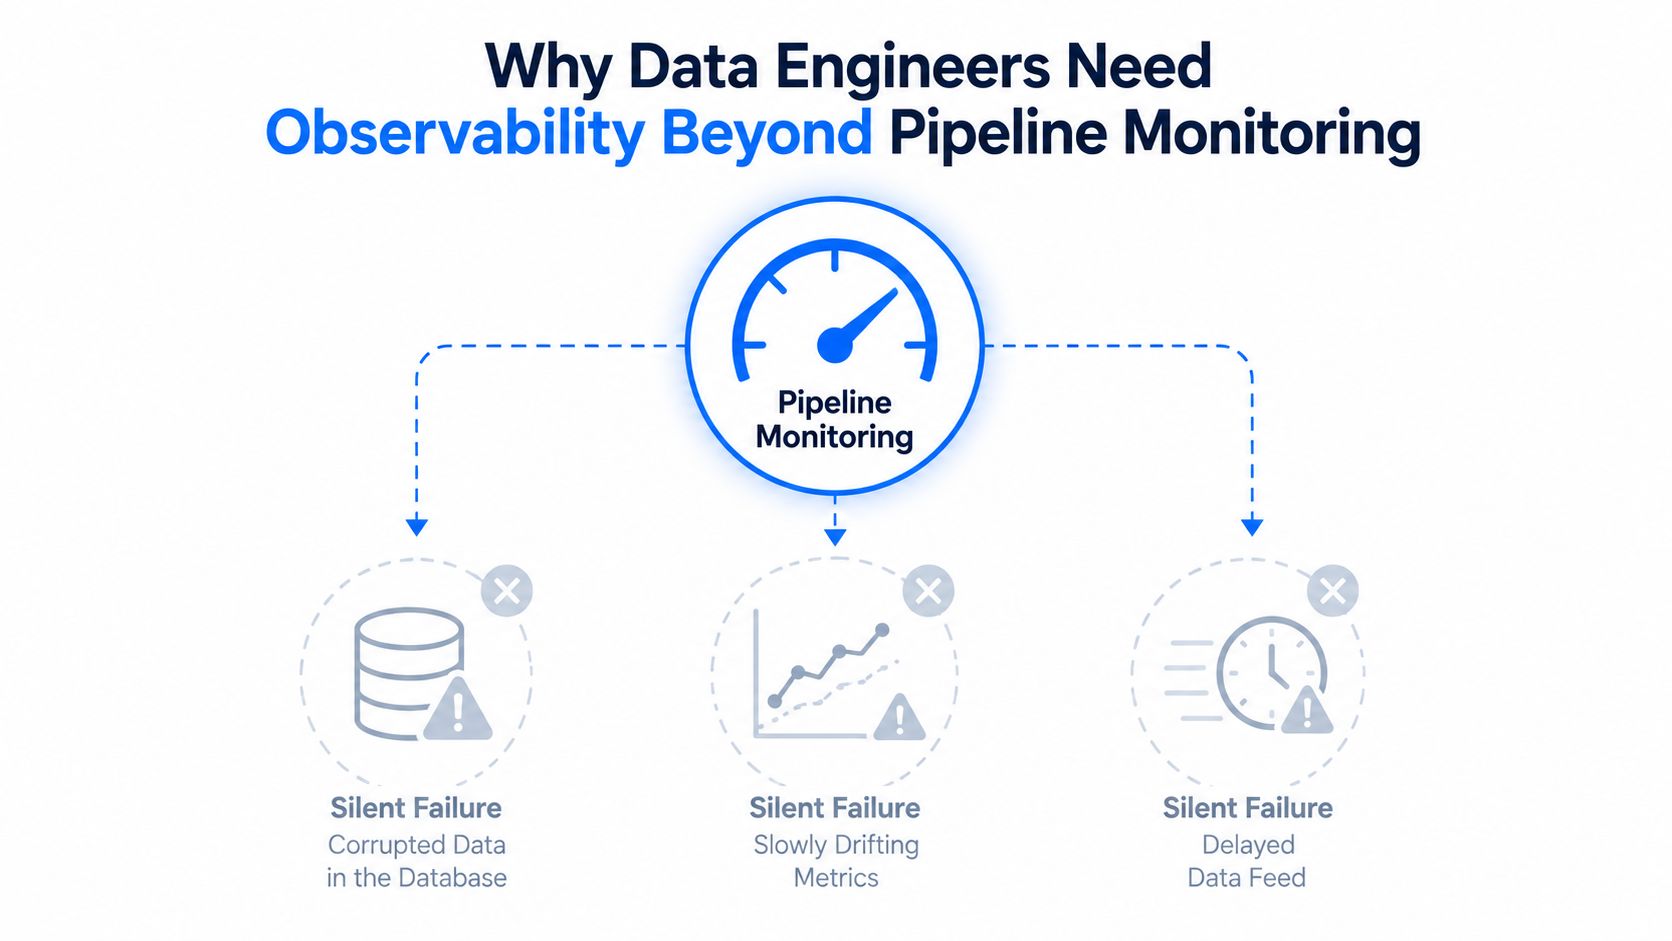
À 9h00, un tableau de bord d'orchestration indique que la tâche nocturne a réussi. La tâche de l'entrepôt s'est terminée, le nombre de tentatives est resté à zéro et le cluster de calcul est resté sain. En fin de matinée, la finance constate qu'un tableau de bord des revenus ne contient pas les transactions récentes. Un modèle entraîné sur la même table a également commencé à produire des résultats instables.
Le pipeline n'a pas échoué au sens classique du terme. Il a livré une partition partielle et a marqué le travail comme terminé. Une jointure en aval a exclu des enregistrements, et la table résultante semblait structurellement assez valide pour que les tableaux de bord se chargent. La surveillance traditionnelle a vu un système disponible. Elle n'a pas vu des données non fiables.
Systèmes de surveillance et données de surveillance
La surveillance des pipelines reste importante. Le taux de réussite des tâches, le comportement face aux tentatives, la durée des tâches, la santé de l'exécuteur et la capacité de l'infrastructure aident les ingénieurs à identifier les défaillances opérationnelles. Mais ces signaux permettent de savoir si un processus s'est exécuté, et non si le résultat est complet, opportun, structurellement cohérent ou s'il se comporte normalement.
La Data Observability ajoute l'inspection des données elles-mêmes. Elle associe des signaux techniques à un contexte tel que le lignage, les propriétaires, les dépendances en aval et la criticité pour l'entreprise. La distinction est semblable à celle qui existe entre vérifier qu'un camion de livraison a quitté l'entrepôt et vérifier si le colis contient les bons articles et s'il est arrivé avant que le client n'en ait besoin.
Un point de départ utile est la comparaison digna entre la data observability et la qualité des données, car les règles de qualité et l'observabilité résolvent des problèmes connexes mais différents. Des tests déterministes imposent des attentes connues. L'observabilité aide à mettre en évidence des changements inattendus que personne n'avait pensé à coder sous forme de test.
Les five pillars et leur valeur pratique
La plupart des modèles de data observability utilisent cinq piliers, la fraîcheur, la distribution, le schéma, le lignage et le volume, comme décrit dans l'aperçu de Databricks sur la data observability.
Fraîcheur : indique si les données sont arrivées dans les délais prévus. Elle est particulièrement importante pour les tableaux de bord opérationnels, les rapports réglementaires et les processus qui dépendent d'enregistrements récents.
Volume : compare la quantité de données avec le comportement normal. Il peut mettre en évidence des chargements incomplets, des ingestions en double, des filtres défectueux et des pannes en amont.
Schéma : suit les colonnes, les types de données et les modifications de structure. Il devient critique lorsque les systèmes sources évoluent indépendamment des consommateurs de l'entrepôt.
Distribution : examine le comportement des valeurs, notamment les modèles de valeurs nulles, les plages, l'unicité et d'autres caractéristiques de l'ensemble de données. Il peut détecter un flux sémantiquement défectueux qui présente pourtant les bonnes colonnes et le bon nombre de lignes.
Lignage : relie un incident aux actifs et aux équipes concernés. Sans lui, les ingénieurs perdent du temps à rechercher les propriétaires et les dépendances en aval.
Un entrepôt réglementé peut donner la priorité au schéma et au lignage, car une modification structurelle non contrôlée peut affecter les éléments de preuve des rapports. Une plateforme de streaming peut mettre l'accent sur la fraîcheur et la distribution, car des événements retardés ou anormaux peuvent rapidement fausser les décisions opérationnelles. Une bonne mise en œuvre ne traite pas chaque pilier de la même manière. Elle offre une couverture plus approfondie aux produits de données dont la défaillance entraîne un impact commercial ou de Compliance plus important.
Pour un contexte sectoriel plus large, la balise d'observabilité sur le commerce électronique est utile pour voir comment les préoccupations de fiabilité apparaissent en dehors de l'ingénierie de la plateforme centrale. La leçon de production est simple : conservez la surveillance de l'infrastructure, puis ajoutez des signaux au niveau des données là où un statut de pipeline vert peut encore masquer un mauvais résultat.
Instrumenting the Four Core SLIs Every Pipeline Needs
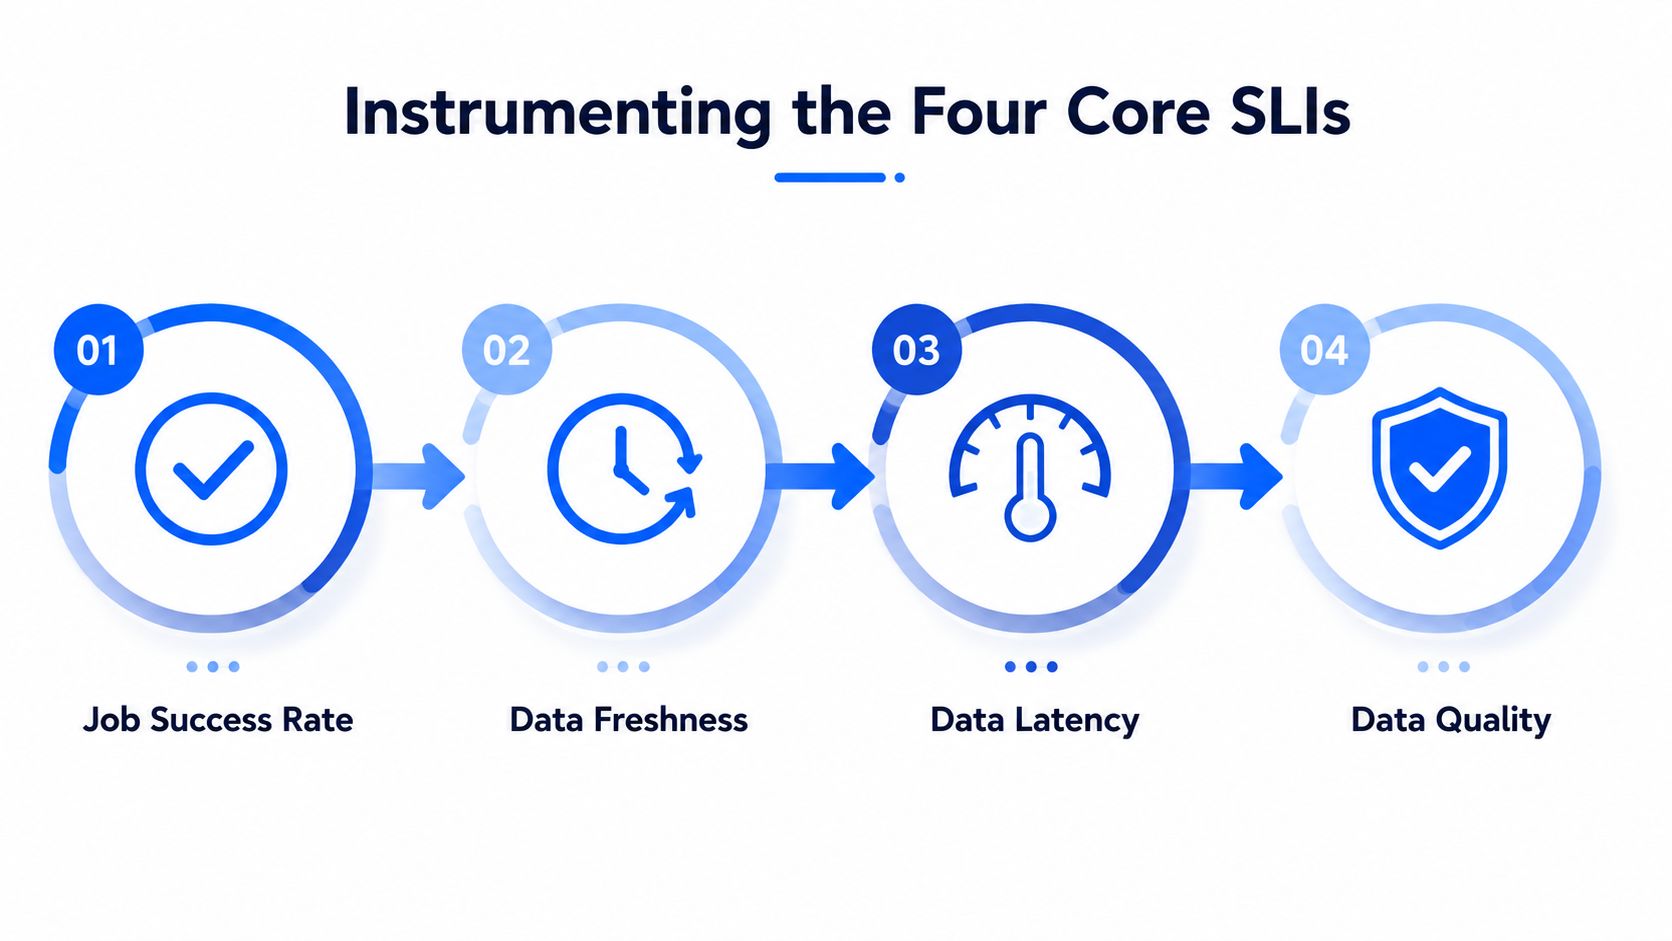
Un déploiement pratique de l'observabilité peut commencer par quatre indicateurs de niveau de service, ou SLI, sur chaque pipeline critique : le taux de réussite des tâches, la latence de fraîcheur, la complétude ou le volume, et la conformité du schéma. Ces signaux couvrent l'exécution, le calendrier, la quantité et la structure sans nécessiter de programme de surveillance complexe dès le premier jour.
1. Taux de réussite des tâches
Suivez les exécutions terminées, échouées, relancées, ignorées et expirées. Un simple ratio de réussite est utile, mais ne vous arrêtez pas à un statut binaire. Enregistrez le chemin d'exécution, la durée, l'état des dépendances et si la tâche a produit le résultat attendu.
Pour les systèmes de traitement par lots, n'émettez un événement de fin de tâche qu'après la validation et la validation de la partition cible. Pour les systèmes de streaming, distinguez l'activité du processus de sa progression réelle. Un consommateur peut rester connecté alors que le décalage augmente ou que les enregistrements malformés s'accumulent.
2. Latence de fraîcheur
La fraîcheur mesure le temps écoulé depuis la dernière mise à jour réussie, ou le délai entre la livraison prévue et la livraison réelle. Pour les ensembles de données critiques, les équipes expriment souvent cette métrique sous la forme d'une latence p95 ou p99, ce qui évite qu'un petit nombre d'enregistrements rapides ne masque une longue traîne d'arrivées tardives. Les conseils de l'industrie sur la surveillance de la fraîcheur cadrent également le contrôle par rapport à la cadence d'ingestion attendue.
Les pipelines de traitement par lots doivent enregistrer l'heure planifiée, l'heure d'arrivée et l'heure de mise à disposition réussie. Les systèmes de streaming doivent suivre séparément le décalage en temps d'événement et le décalage en temps d'ingestion, car un consommateur actif peut toujours traiter des événements tardifs.
Utilisez le comportement historique comme contexte plutôt que d'appliquer un seuil universel unique. Un point de référence pratique compare la même heure de la journée sur les 2 à 4 semaines précédentes, comme indiqué dans les conseils de Streamkap pour l'observabilité du streaming. Pour une alerte critique, le point de départ statistique recommandé est de 3 écarts-types par rapport à la référence, tandis qu'un avertissement peut utiliser 2 écarts-types. Ces valeurs doivent figurer dans une politique qui prend également en compte les engagements de livraison et les conséquences en aval.
3. Complétude et volume
Comparez les volumes d'enregistrements attendus avec les volumes réels, les partitions, les fichiers ou les fenêtres d'événements. Un lot quotidien peut nécessiter une partition attendue et une plage d'enregistrements minimale. Un flux peut avoir besoin de maintenir le débit d'événements et d'éviter les écarts inexpliqués dans les fenêtres temporelles.
Les volumes seuls ne suffisent pas. Associez-les à des contrôles de doublons, à la surveillance du taux de valeurs nulles et à la couverture des partitions afin qu'un chargement dupliqué ne paraisse pas complet. Les anomalies de volume surviennent souvent avant qu'un tableau de bord ne tombe visiblement en panne, ce qui en fait de précieux indicateurs précoces plutôt que de simples diagnostics post-incident.
4. Conformité du schéma
Mesurez le pourcentage de lignes qui passent la validation structurelle, puis suivez les modifications apportées aux noms de colonnes, aux types, à la possibilité de valeurs nulles et à l'imbrication. La dérive de schéma comprend les colonnes ajoutées, les colonnes supprimées et les modifications de type de données, comme documenté dans l'explication d'Ataccama sur le suivi des schémas.
Maintenez le contrôle près de la limite de la source et à nouveau avant les couches de consommation à forte valeur ajoutée. Cet emplacement permet de distinguer un changement de contrat en amont d'un défaut de transformation. Enregistrez la version du schéma observée lors de chaque exécution afin que les intervenants puissent comparer le premier mauvais résultat avec le changement qui l'a précédé.
Règle pratique : Établir d'abord une référence, alerter ensuite. Un seuil sans contexte historique soit manque la dérive progressive, soit crée du bruit pendant les cycles de fonctionnement normaux.
Pour les équipes qui définissent précisément les métriques de livraison, ce guide sur les définitions de la ponctualité des données et les métriques de surveillance fournit un vocabulaire utile pour distinguer les retards d'arrivée, de traitement et de mise à disposition.
Résoudre le problème de la fatigue liée aux alertes qui nuit à l'Observability
Multiplier les contrôles peut nuire à la fiabilité si personne ne fait confiance aux notifications. Un rapport de 2025 sur l'observabilité en entreprise a révélé que seulement 13 % des données de télémétrie étaient utilisées, ce qui signifie que le problème central n'est pas toujours le manque de visibilité. Il peut s'agir d'un excès de signaux qui ne se traduisent jamais par des décisions opérationnelles, comme le rapporte une récente étude sur l'observabilité en entreprise.
L'erreur consiste à traiter chaque écart comme un incident. Une légère modification de la distribution sur une table d'exploration ne devrait pas alerter la même équipe, ni utiliser le même chemin d'escalade, que des données obsolètes alimentant des rapports réglementaires. Les ingénieurs ont besoin d'un moyen de classer les signaux par impact, niveau de confiance et propriété.
Concevoir des alertes autour de décisions
Chaque alerte doit répondre à quatre questions :
Qu'est-ce qui a changé ? Identifiez l'ensemble de données, le champ, la partition ou le pipeline.
À quel point est-ce inhabituel ? Indiquez la référence, la valeur observée et le niveau de confiance.
Qui est responsable de la réponse ? Orientez la notification vers une équipe désignée ou un propriétaire de service.
Qu'est-ce qui pourrait être affecté ? Incluez le lignage et le processus métier qui dépend de l'actif.
Une alerte utile peut indiquer qu'une table critique est arrivée en dehors de son schéma de livraison habituel, identifier la partition manquante, montrer la dépendance des rapports en aval et désigner la tâche d'ingestion responsable. « Anomalie de volume détectée » n'est pas un flux de travail d'incident. C'est une invitation à lancer une enquête manuelle.
Les seuils statistiques aident à réduire les alertes arbitraires. Utilisez 3 écarts-types pour les alertes critiques et 2 pour les alertes d'avertissement lorsque le comportement historique est stable, puis supprimez les notifications en double tant qu'un incident reste ouvert. Pour les données saisonnières, éparses ou changeant rapidement, une référence apprise peut être plus performante qu'une règle fixe, mais elle nécessite toujours un propriétaire et une politique de gravité tenant compte des enjeux de l'entreprise.
Mesurer la qualité de la détection, et non le volume des notifications
Le temps moyen de détection est souvent la mesure de fiabilité la plus révélatrice, car les équipes ne peuvent résoudre un problème qu'après en avoir pris connaissance. Une étude de l'industrie de 2026 a rapporté que les équipes de données comptaient en moyenne 67 incidents par mois, 68 % d'entre elles ayant besoin de plus de 4 heures pour détecter les problèmes et d'une moyenne de 15 heures pour les résoudre, selon la synthèse de l'enquête d'Integrate.io. L'implication opérationnelle est claire : réduire le délai de détection peut créer plus de valeur que d'ajouter un énième tableau de bord.
Suivez les alertes bruyantes qui n'ont nécessité aucune action, les alertes sans propriétaire attribué, les alertes répétées pour une seule cause racine et les incidents découverts en premier par les utilisateurs métier. Ajustez ensuite les seuils, regroupez les signaux associés et supprimez les contrôles qui ne modifient aucune décision.
Un tableau de bord de qualité des données ciblé devrait aider les intervenants à voir les tendances et les incidents non résolus, plutôt que de simplement afficher un grand inventaire de contrôles. Le programme d'observabilité le plus solide n'est pas celui qui contient le plus d'alertes. C'est celui auquel les ingénieurs croient suffisamment pour agir.
Mise en œuvre de l'Observability dans les environnements réglementés et sur site
Une conception axée sur le SaaS suppose souvent que les métadonnées et les échantillons peuvent circuler librement vers un service externe. Cette hypothèse s'effondre dans les services financiers, la santé, les télécommunications et les secteurs publics, où la résidence des données, l'auditabilité, le contrôle des accès et l'examen de sécurité façonnent chaque décision d'architecture.
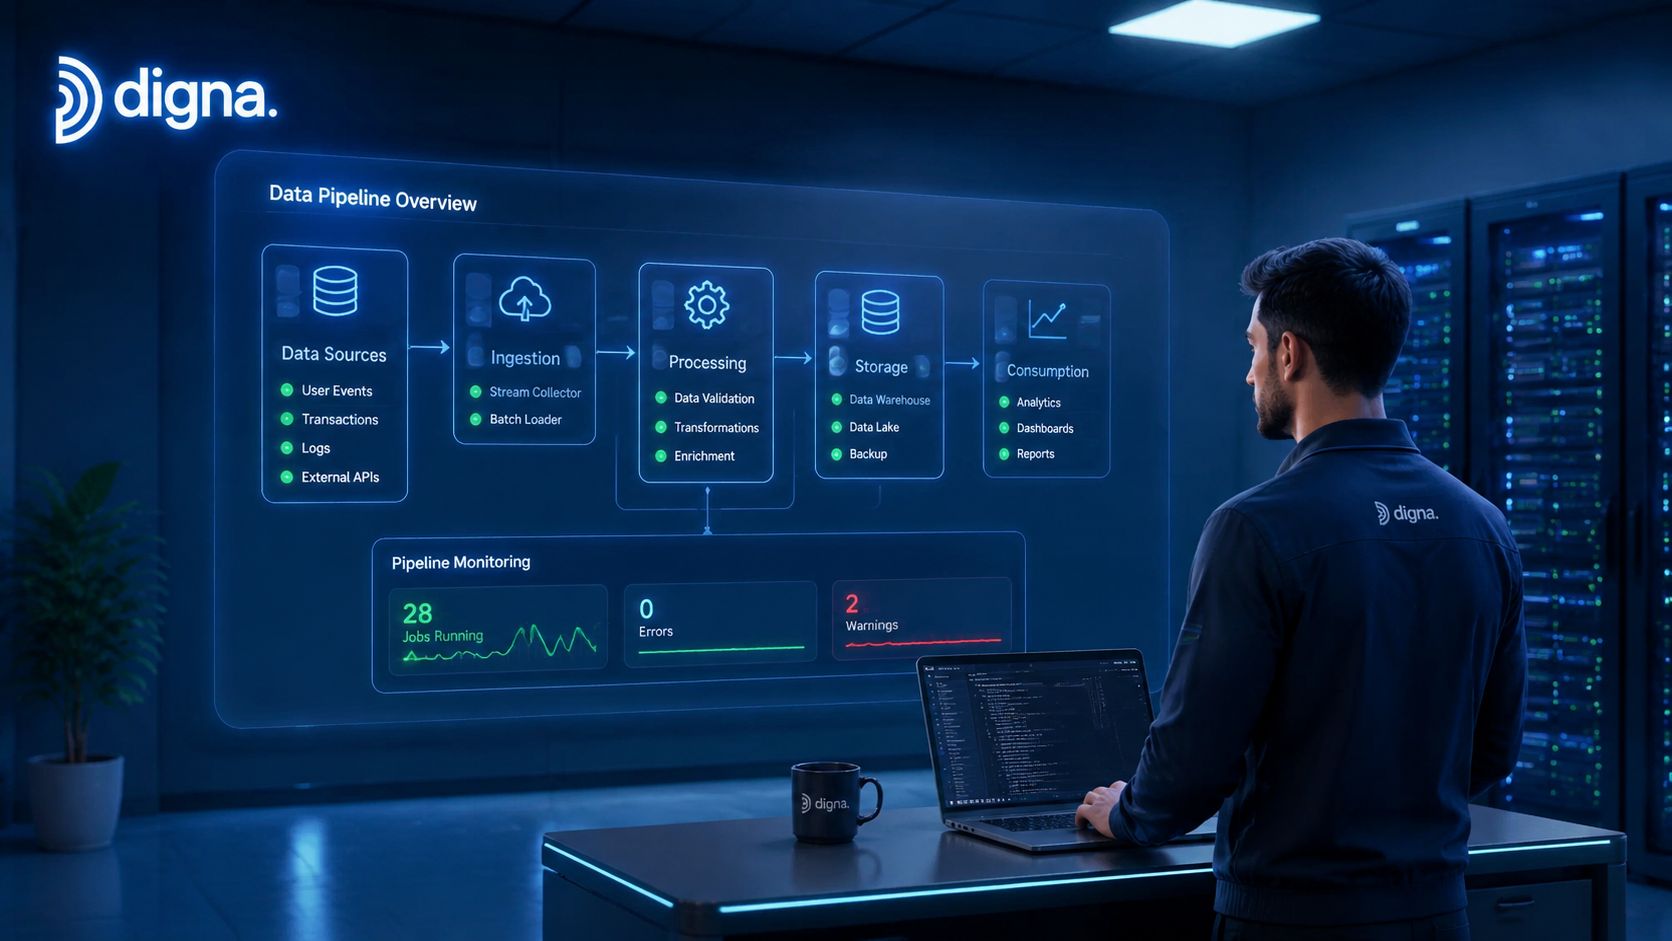
Le modèle de mise en œuvre auquel je fais confiance dans ces environnements maintient les données de production à l'intérieur des limites du client. L'exécution en base de données calcule les métriques là où les données résident déjà, tandis que la couche d'observabilité reçoit les métadonnées autorisées, les résultats des métriques et le contexte de l'incident au lieu d'enregistrements de production non restreints.
Une séquence de déploiement qui résiste à l'examen de sécurité
Commencez par le schéma de flux de données. Documentez l'endroit où les contrôles s'exécutent, ce qui sort de la base de données, quel compte de service les exécute et où les résultats sont stockés. Les équipes de sécurité peuvent examiner un flux spécifique de manière plus efficace qu'une simple promesse qu'un produit est « sécurisé ».
Séparez le calcul des métriques des données d'investigation. Le nombre de lignes, les horodatages de fraîcheur, les empreintes de schéma et les métriques de qualité agrégées peuvent suffire pour la détection. Les échantillons au niveau de l'enregistrement doivent être facultatifs, masqués ou interdits lorsque la politique l'exige.
Utilisez des limites de déploiement privées. Une installation sur un cloud privé ou sur site peut s'exécuter à l'intérieur du VPC du client, de son compte cloud ou de son centre de données. Maintenez les connecteurs, les planificateurs, les magasins de métadonnées et les interfaces utilisateur au sein de zones réseau approuvées.
Faites des preuves d'audit un élément de la conception. Enregistrez les définitions des contrôles, les heures d'exécution, les résultats observés, les accusés de réception, les changements de propriété et l'historique des corrections. Les auditeurs ont généralement besoin d'établir ce qui a été contrôlé, quand cela s'est exécuté, ce qui s'est passé et qui a répondu.
Les équipes doivent également documenter explicitement les décisions relatives à la résidence des données. Le guide des exigences en matière de résidence des données est une référence utile pour décider quelles métadonnées peuvent franchir les frontières régionales ou organisationnelles.
Les parcs hétérogènes ont besoin d'un contrat commun
Les bases de données existantes, les plateformes d'entrepôt, le stockage en lac, les sujets Kafka et les outils de transformation exposent rarement des métadonnées identiques. Standardisez les résultats de l'observabilité plutôt que de contraindre chaque source à utiliser la même méthode d'instrumentation. Chaque intégration doit publier l'identité de l'actif, l'heure de mise à jour, le résultat de volume ou de complétude, l'état du schéma, le statut du contrôle, le propriétaire et les références de lignage.
Des comptes de service dotés du moindre privilège, un accès en lecture seule dans la mesure du possible, des identifiants masqués et des informations d'identification distinctes par environnement réduisent la zone d'impact du système de surveillance lui-même. Testez le déploiement face à des scénarios de sauvegarde, de basculement et de réseau déconnecté avant le déploiement en production.
Le compromis est réel. Les contrôles en base de données peuvent consommer des ressources d'entrepôt, tandis que l'analyse externe peut simplifier l'intégration mais créer des frictions en matière de governance. Mesurez le coût des requêtes, planifiez le profilage coûteux en dehors des heures de pointe et utilisez des contrôles de métadonnées légers en continu avec une validation plus approfondie sur les actifs critiques.
Choisir la bonne stratégie d'alerte pour votre pile de données
La stratégie d'alerte doit suivre le comportement des données, et non la mode des outils. Les seuils statiques sont faciles à expliquer et à auditer. Les références statistiques s'adaptent aux variations normales. L'apprentissage automatique peut réduire la création manuelle de règles, mais il introduit un comportement de modèle que les équipes de conformité et de plateforme peuvent vouloir inspecter. La validation déterministe reste essentielle partout où une règle métier doit être appliquée de manière exacte.
Stratégie | Idéal pour | Limites | Complexité de mise en œuvre |
|---|---|---|---|
Seuils statiques | Volumes prévisibles, limites strictes, fenêtres de livraison contractuelles | Échouent face à la saisonnalité, à la croissance et à la dérive progressive | Faible |
Références statistiques | Comportement de volume, de fraîcheur et de distribution propre à l'ensemble de données | Nécessitent un contexte historique suffisant et un ajustement minutieux | Moyenne |
Détection d'anomalies par apprentissage automatique | Modèles complexes, comportement changeant et large couverture | Nécessite une explicabilité, une governance et un examen des faux positifs | Moyenne à élevée |
Validation déterministe des enregistrements | Contrôles réglementaires, règles métier et exigences exactes au niveau de la ligne | Ne peut pas identifier de modèles inconnus sans règles définies | Moyenne |
Quand les règles simples l'emportent
Utilisez une règle statique lorsque la condition de défaillance est sans ambiguïté. Une partition requise qui n'est pas arrivée, un type de données interdit ou un champ qui doit satisfaire à une contrainte métier définie doit produire un résultat déterministe. Ces contrôles sont plus faciles à tester, à expliquer aux auditeurs et à reproduire lors de l'examen des incidents.
Les seuils statiques fonctionnent également bien pour les flux stables à volume élevé dotés de limites opérationnelles claires. Ils deviennent fragiles lorsque le comportement normal change selon l'heure, la saison, le segment de clientèle ou le cycle de vie du produit. Un seuil global unique crée souvent des faux positifs lors des pics légitimes et manque les dégradations lentes.
Quand les méthodes adaptatives sont utiles
Les références statistiques sont utiles lorsque chaque ensemble de données a son propre rythme. Comparez ce qui est comparable, comme la même heure ou la même fenêtre de livraison, et préservez le contexte historique qui a conduit à l'alerte. L'apprentissage automatique peut étendre cette approche à de nombreux actifs, mais les ingénieurs doivent tout de même exiger un code de motif, une visualisation de référence et un processus de contournement.
La conception la plus robuste combine les méthodes. Utilisez la détection d'anomalies pour une large couverture de la fraîcheur, du volume et des distributions. Ajoutez des contrôles déterministes pour les champs réglementaires, les exigences contractuelles et la logique des enregistrements critiques pour l'entreprise. Orientez les deux vers le même flux de travail d'incident afin que les intervenants n'aient pas à concilier des systèmes d'alerte distincts.
Une couche de surveillance et de rapport doit non seulement indiquer si un contrôle a échoué, mais aussi sa tendance, son propriétaire, sa gravité et sa pertinence en aval. Les capacités de surveillance et de rapport de digna représentent un exemple de ce modèle opérationnel combiné, aux côtés d'outils articulés autour de tests dbt, d'assertions d'entrepôt ou de contrôles d'orchestration personnalisés.
Intégrer l'Observability dans votre architecture de pipeline existante
L'Observability ne devrait pas nécessiter de reconstruction. Le modèle le plus sûr consiste à ajouter des mesures aux limites qui existent déjà, puis à envoyer les résultats à un flux de travail d'incident et de métadonnées partagé sans bloquer chaque tâche sur chaque contrôle.

Dans Airflow, émettez des métadonnées d'exécution et de fin de tâche à partir des tâches DAG, puis exécutez des contrôles de fraîcheur et de complétude une fois la partition cible validée. Dans dbt, conservez les résultats des tests et le timing des modèles en tant qu'événements d'observabilité de premier ordre. Les tâches Spark peuvent publier les nombres d'entrées et de sorties, les nombres d'enregistrements rejetés, les empreintes de schémas et les détails des partitions. Les consommateurs Kafka doivent exposer le décalage, le retard en temps d'événement, les taux d'enregistrements malformés et le comportement du volume au niveau du sujet.
Placer les contrôles là où ils apportent une réponse à une question
Utilisez des contrôles synchrones lorsque la poursuite de l'exécution présenterait un risque inacceptable en aval. Un contrôle de conformité de schéma avant de publier un contrat partagé ou un contrôle de complétude avant de diffuser un ensemble de données réglementaires peut légitimement bloquer l'étape suivante.
Utilisez des contrôles asynchrones pour un profilage plus large et une analyse des tendances. Les métriques de distribution, les statistiques de colonnes et les comparaisons historiques peuvent s'exécuter à côté du chemin critique, à condition que l'alerte qui en résulte bénéficie d'un processus de confinement clair. Cela évite de transformer chaque contrôle analytique en goulot d'étranglement pour le pipeline.
La gestion des schémas mérite une politique explicite. Classez les colonnes ajoutées, les colonnes supprimées et les modifications de type de données comme compatibles, nécessitant un examen ou bloquantes. N'échouez pas automatiquement à chaque changement additif, mais n'acceptez pas une modification de type de données sans examen, car elle peut modifier la manière dont les consommateurs en aval interprètent les valeurs.
Le lignage doit être capturé aux limites des transformations, et non reconstruit lors d'un incident. Stockez les relations source-cible pour les tâches Airflow, les modèles dbt, les transformations Spark et les sujets de streaming, puis associez les contrôles aux actifs qu'ils décrivent.
Principe de conception : L'Observability doit faciliter le fonctionnement du pipeline, et non devenir une autre dépendance susceptible de l'arrêter inutilement.
Enfin, utilisez les résultats de l'observabilité pour améliorer l'architecture. Des retards de fraîcheur répétés peuvent révéler une fenêtre d'extraction surchargée. Des anomalies de volume persistantes peuvent indiquer des contrats sources fragiles. Un schéma d'incidents liés aux schémas peut justifier des interfaces versionnées plutôt que de multiplier les alertes.
Commencer petit et faire évoluer votre mise en œuvre de l'Observability
Tout surveiller dès le premier jour crée un catalogue de contrôles avant même que l'équipe ne sache quels signaux importent. Commencez par un pipeline critique, de préférence un actif qui alimente les rapports de la direction, les opérations clients, les travaux réglementaires ou un modèle de production. Classez les candidats par impact commercial, historique des incidents, profondeur des dépendances et difficulté à détecter manuellement une défaillance.
Un déploiement progressif est plus facile à défendre car chaque phase produit des preuves opérationnelles.
Jours 1 à 30 : Cartographiez le pipeline sélectionné, identifiez les propriétaires et les consommateurs en aval, établissez les SLI de fraîcheur, de réussite des tâches, de complétude et de schéma, et enregistrez la référence.
Jours 31 à 60 : Ajoutez une validation de la distribution ou au niveau de l'enregistrement là où la première phase révèle un risque. Ajustez les seuils d'avertissement et critiques, orientez les alertes vers les équipes responsables et documentez le flux de travail de réponse.
Jours 61 à 90 : Examinez les incidents et les quasi-incidents, supprimez les contrôles bruyants, ajoutez le contexte de lignage, mesurez le temps moyen de détection et sélectionnez le pipeline suivant sur la base d'un risque démontré plutôt que par enthousiasme.
Mesurez les résultats qui influencent les décisions d'ingénierie. Le temps moyen de détection montre si l'équipe est informée plus tôt des défaillances. Le volume des incidents et les causes racines répétées révèlent si la surveillance réduit la charge opérationnelle. Les défaillances évitées en aval démontrent de la valeur aux analystes, aux parties prenantes de la conformité et aux propriétaires d'entreprise.
L'adoption dépend également de l'appropriation. Attribuez un propriétaire technique à chaque ensemble de données critique, définissez qui peut accuser réception ou supprimer une alerte, et exigez un motif lorsqu'un contrôle est désactivé. Examinez les faux positifs après les incidents, et non pas seulement lors d'un exercice annuel sur les outils.
digna peut soutenir ce modèle progressif grâce à l'exécution en base de données, au déploiement sur cloud privé ou sur site, à la détection d'anomalies, à la surveillance de la ponctualité, à la validation au niveau des enregistrements et au suivi des schémas. Si votre environnement ne peut pas transférer les données de production vers une plateforme SaaS, évaluez si l'architecture préserve cette limite tout en fournissant aux ingénieurs un contexte d'incident exploitable.
Utilisez les 90 premiers jours pour instrumenter un pipeline critique pour l'entreprise, établir des références fiables et mesurer la qualité de la détection avant d'étendre la couverture. Pour évaluer une approche intégrée à l'environnement pour vos entrepôts, lacs et flux de données réglementés, visitez digna et découvrez comment sa plateforme d'observabilité modulaire peut s'intégrer dans votre architecture existante.


