Observabilité de la qualité des données : guide pratique pour les équipes data
|
8
minute de lecture

Vous connaissez ce sentiment. À 6 h 45, un dashboard semble en parfait état, puis à 8 h les chiffres sont faux, le VP demande pourquoi le chiffre d'affaires a bougé pendant la nuit, et l'équipe data épluche les logs du pipeline pendant que tout le monde attend une réponse. C'est le data downtime, et c'est l'un des moyens les plus rapides de transformer une couche de reporting fiable en passif.
L'observabilité de la qualité des données change cette posture. Au lieu d'attendre que les dashboards cassent, elle surveille le comportement des données pendant qu'elles circulent, afin que les équipes repèrent les retards de fraîcheur, le schema drift, les variations de volume et les échecs de validation avant qu'ils ne contaminent les décisions. L'objectif n'est pas d'avoir plus d'alertes. C'est un signal plus précoce, un triage plus propre et moins de temps passé à expliquer pourquoi on ne peut pas se fier aux chiffres.
Table des matières
Le coût caché des données défaillantes
Un incident du lundi matin commence rarement de façon spectaculaire. Il commence par une table obsolète, un chargement manquant ou un changement de schéma discret que personne n'a remarqué à temps. Au moment où le problème apparaît, les dégâts ont déjà dépassé le data warehouse et atteint le métier.
L'ampleur du problème est facile à sous-estimer. Une enquête Wakefield Research de 2023 commandée par Monte Carlo a révélé que les incidents de données mensuels sont passés de 59 en 2022 à 67 en 2023, soit une hausse de 1,89x du data downtime, et que 68 % des répondants avaient besoin de quatre heures ou plus pour détecter les incidents. La même enquête indiquait un temps de résolution moyen de 15 heures par incident, et plus de la moitié des répondants déclaraient qu'au moins 25 % du chiffre d'affaires était exposé à des problèmes de qualité des données, la part moyenne du chiffre d'affaires impacté passant de 26 % à 31 % en un an, autant de chiffres repris dans une vue d'ensemble de la catégorie dans le rapport sur le marché de la data observability.
Ce que cela donne en pratique
Un analyste financier actualise une présentation pour le conseil d'administration et remarque un chiffre qui ne correspond pas à l'export de la veille. Un data engineer consulte les logs d'orchestration et constate que le pipeline s'est terminé correctement, ce qui est pire, pas mieux, car le problème se cache désormais dans le contenu et non dans le statut du job. L'équipe commence à comparer les nombres de lignes, à chercher des changements de schéma et à contacter des responsables qui ne savent peut-être même pas qu'ils ont provoqué la panne.
Règle pratique : si le premier signe d'un problème est la question d'un utilisateur métier, la couche de monitoring est déjà trop loin en aval.
C'est pour cela que l'observabilité compte. Elle ne remplace pas l'analyse des causes racines et ne rend pas les données correctes par magie. Elle vous alerte plus tôt, pour que l'équipe cesse de traiter chaque incident comme une surprise et commence à le traiter comme un risque opérationnel maîtrisable.

Les meilleures équipes avec lesquelles j'ai travaillé ont cessé de demander « Pourquoi ce dashboard a-t-il cassé ? » pour demander « Qu'est-ce qui a changé avant que le dashboard ne casse ? ». Tout est là. L'observabilité de la qualité des données vous donne un moyen de répondre à cette question avant que le métier n'en paie le prix.
Comprendre l'observabilité de la qualité des données
Un dashboard peut sembler sain alors que le pipeline qui l'alimente dérive. Une table source peut encore se charger à l'heure, alors que son schéma change en dessous, qu'une transformation commence à remodeler les valeurs et que les rapports en aval restent faux jusqu'à ce que quelqu'un repère l'écart. L'observabilité de la qualité des données se concentre sur ces signaux système, et pas seulement sur le résultat final au niveau des lignes.
Passer des règles aux signaux
Les contrôles basés sur des règles restent importants. Ils sont précis, auditables et utiles lorsque la logique métier doit être appliquée au niveau de chaque enregistrement. Mais ils passent aussi à côté de beaucoup de choses, car ils ne détectent que ce que vous vous attendiez déjà à voir casser. L'observabilité s'appuie sur des signaux externes comme la fraîcheur, le volume, le schéma, la distribution et le lineage, puis utilise ces tendances pour montrer si le pipeline se comporte normalement, comme le définissent les guides pratiques sur l'observabilité.
Ce changement compte surtout quand le schema drift entre en jeu. Si une source ajoute, supprime, renomme ou change le type d'une colonne, une transformation fragile peut échouer sans prévenir ou envoyer des valeurs mal formées vers l'analytique en aval avant que quiconque ne s'en aperçoive, le schema drift est un signal central de l'observabilité. L'observabilité détecte le changement structurel lui-même, au lieu d'attendre que le mauvais résultat fasse surface.
La fatigue d'alerte est le revers de la médaille. Les règles statiques peuvent produire un long flux d'alertes de faible valeur, surtout lorsque les variations des données sont normales pour le métier. Le monitoring comportemental réduit ce bruit en se demandant si le schéma de comportement a changé de façon significative, ce qui convient mieux aux pipelines modernes et à la manière dont les équipes analysent les incidents.
L'observabilité est la plus efficace lorsqu'elle surveille le comportement des données, et pas seulement si une ligne respecte une règle.
Quoi surveiller en premier
Commencez par les signaux qui vous disent si le pipeline est vivant et cohérent.
Fraîcheur : des données en retard sont souvent le premier signe d'un pipeline bloqué ou dégradé.
Volume : des pics ou des chutes soudains peuvent révéler des problèmes d'ingestion, des doublons ou des chargements partiels.
Schéma : des modifications de champs inattendues sont souvent le chemin le plus court vers des transformations cassées.
Distribution : des glissements dans la répartition des valeurs peuvent révéler une corruption silencieuse qui semble encore valide au niveau de la table.
Lineage : savoir d'où viennent les données et où elles vont vous aide à retracer l'impact au lieu de deviner.
L'objectif pratique est simple. Si les contrôles de qualité des données vous disent si un enregistrement est acceptable, l'observabilité vous dit si l'ensemble du flux se comporte d'une manière digne de confiance. Pour une présentation plus complète de la façon dont les signaux comportementaux remplacent les règles statiques, consultez la présentation de la data observability.
Signaux clés pour surveiller la santé des données
Le monitoring fonctionne le mieux lorsque chaque signal correspond à un mode de défaillance et à une conséquence métier. Les contrôles traditionnels basés sur des règles restent utiles, mais ils traitent souvent chaque écart comme également urgent. L'observabilité pilotée par l'IA ajoute des baselines comportementales, ce qui aide les équipes à distinguer une variation attendue d'un schéma qui menace la disponibilité des données, le reporting en aval ou les décisions opérationnelles. L'objectif : moins d'alertes de faible valeur et une attention plus rapide au data downtime.
Fraîcheur, volume, schéma et validation fonctionnent ensemble
La Timeliness est souvent le premier signe qu'un pipeline est bloqué ou dégradé. Les implémentations modernes apprennent la cadence de livraison d'un dataset, calculent quand le prochain chargement doit arriver et alertent lorsqu'il est en retard ou manquant, comme le décrivent les guides de monitoring opérationnel. La logique de Timeliness peut aussi repérer les livraisons qui arrivent plus tôt que prévu, ce qui compte lorsqu'une source s'écarte de son rythme habituel, un modèle basé sur la cadence également abordé dans la documentation des plateformes.
La détection d'anomalies apporte du contexte à un simple seuil. Un pic dans une table d'activité client peut refléter une campagne légitime, ou indiquer un flux dupliqué qui rejoue des enregistrements. Un modèle comportemental ne peut pas déterminer seul l'explication métier, mais il peut signaler un changement significatif avant que les analystes ne s'appuient sur les données concernées.
Le suivi des schémas limite les défaillances structurelles en aval. Un flux financier peut ajouter un champ nullable, ou un extrait de données de santé peut changer une définition de type sans montrer de problème évident à la source. La panne peut apparaître plus tard dans une transformation, un modèle ou un dashboard, là où le diagnostic coûte plus de temps.
La validation relie l'observabilité aux règles métier. Les contrôles au niveau des lignes comparent les valeurs aux formats, longueurs et indicateurs de qualité attendus. Ils soutiennent le travail de conformité, la constitution de preuves d'audit et la revue ciblée des enregistrements à haut risque, la validation au niveau des lignes étant décrite dans la littérature sur la vérification.
Un guide des métriques de data observability peut aider à associer chaque métrique au mode de défaillance qu'elle est censée révéler.
Signal | Ce qu'il détecte | Ce qu'il ne détecte pas |
|---|---|---|
Fraîcheur | Chargements en retard ou manquants | Signification métier incorrecte |
Volume | Données manquantes, doublons, flux rejoués | Erreurs fines au niveau des lignes |
Schéma | Champs ajoutés, supprimés, renommés ou retypés | Erreurs sémantiques dans des colonnes valides |
Validation | Violations de règles au niveau des enregistrements | Comportements inattendus hors du jeu de règles |
Le périmètre compte plus que la couverture
Le principal coût n'est pas de choisir les signaux. C'est de les appliquer sans discernement sur de vastes parcs de données, plusieurs stacks et de nombreuses tables. Une couverture plus large augmente la charge de calcul, de métadonnées et d'alerting, un avertissement pratique mis en avant par Databricks. L'excès d'alertes crée aussi une fatigue opérationnelle. Une fois que les ingénieurs ne font plus confiance aux notifications, une véritable panne de données peut rester bloquée derrière des variations de routine.
Donnez la priorité aux pipelines dont la défaillance affecterait le chiffre d'affaires, le reporting, la conformité ou les opérations client. La détection pilotée par l'IA peut réduire les alertes de seuil répétitives, tandis que la validation explicite reste adaptée aux règles connues. Utilisées ensemble, ces approches produisent un flux d'alertes plus calme, avec des responsabilités plus claires et une réponse aux incidents plus rapide.
Modèles d'architecture pour l'observabilité
La plupart des échecs d'observabilité viennent de choix d'architecture, et non du signal de monitoring lui-même. Soit les équipes déplacent trop de données vers un outil séparé, soit elles greffent des contrôles après coup en espérant que les compromis de latence et de sécurité ne poseront pas problème. En pratique, l'architecture doit respecter l'endroit où les données se trouvent déjà.
Garder les contrôles au plus près des données
Le modèle le plus solide est l'exécution in-database. La logique de monitoring s'exécute à l'intérieur du data warehouse ou du data lake, de sorte que les données restent en place et que l'équipe évite les déplacements inutiles entre systèmes. C'est important à la fois pour la sécurité et pour la performance, surtout lorsque la plateforme gère déjà des datasets sensibles ou des charges de travail lourdes.
C'est aussi là que la modularité prouve sa valeur. Une stack d'observabilité monolithique peut être difficile à adopter, car elle impose aux équipes un déploiement large avant d'avoir démontré sa valeur. Une approche modulaire vous permet de commencer par un seul problème, comme le schema drift ou la ponctualité des données, puis d'étendre à la validation ou au monitoring métier une fois que le premier signal fonctionne.
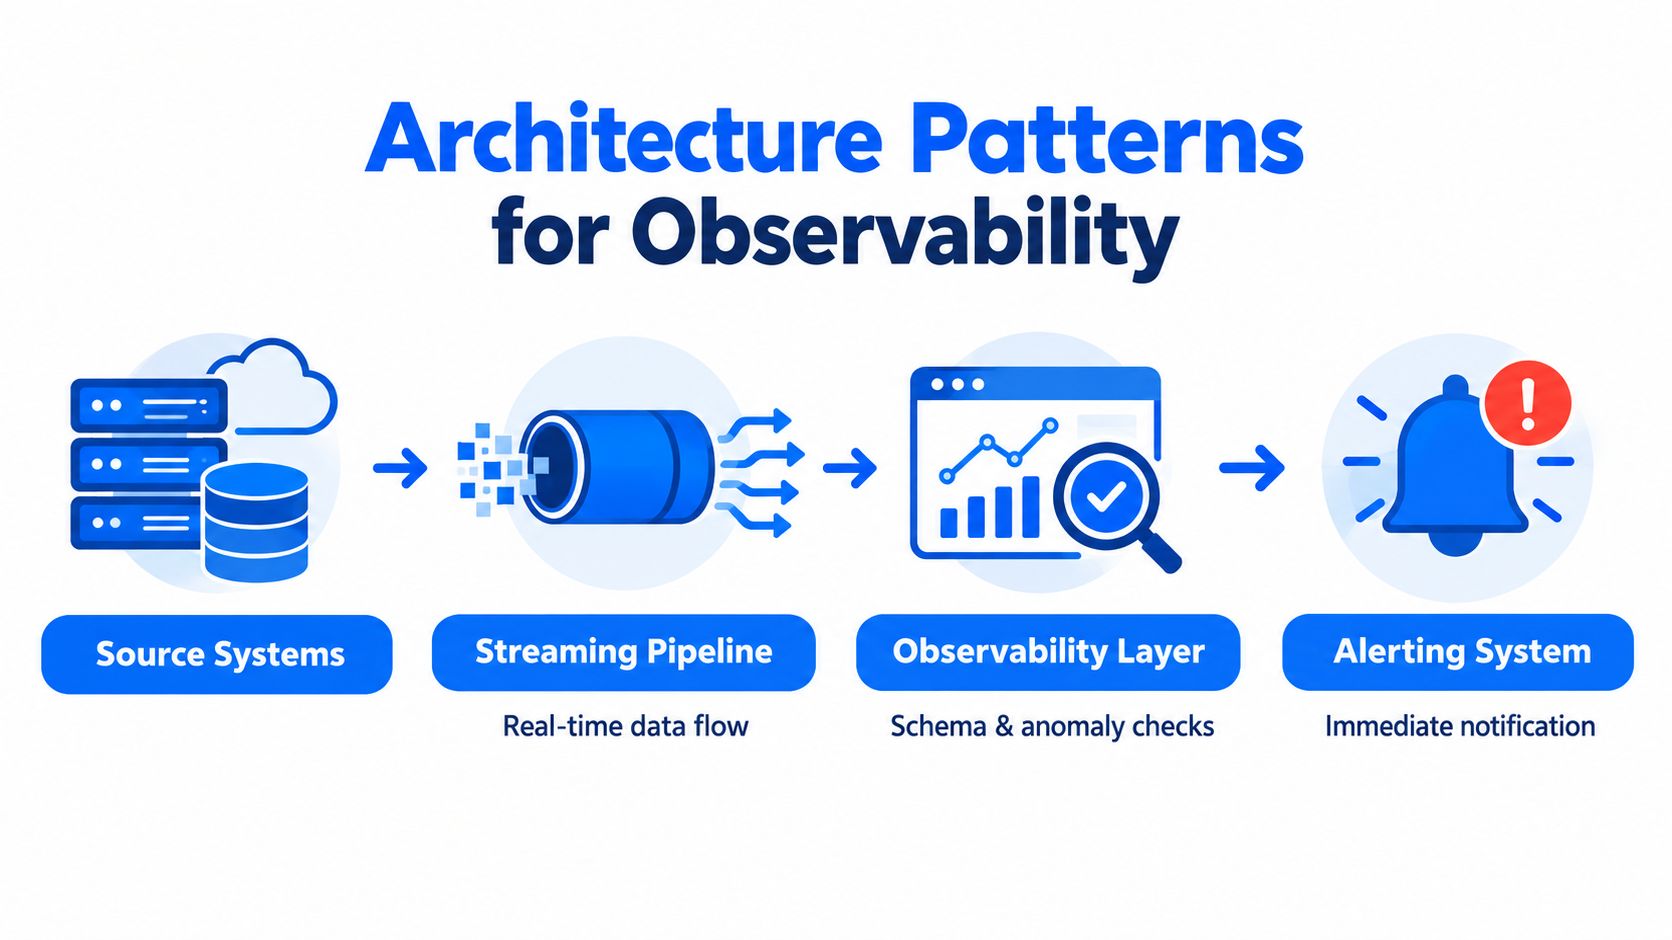
Une architecture propre suit généralement cette séquence :
Les systèmes sources émettent des données opérationnelles ou analytiques.
Les pipelines streaming ou batch acheminent les données vers l'environnement gouverné.
Une couche d'observabilité évalue les signaux de fraîcheur, de schéma et d'anomalie là où se trouvent déjà les données.
Un système d'alerting n'achemine que les incidents significatifs vers le bon responsable.
Pourquoi les plateformes modulaires sont plus faciles à opérationnaliser
Une plateforme modulaire limite le rayon d'impact lorsque vous introduisez l'observabilité dans une stack mature. Vous pouvez d'abord la diriger vers les tables les plus importantes, puis l'étendre à mesure que l'équipe fait confiance à la qualité du signal. Le déploiement est aussi plus simple pour les équipes de data engineering, car la logique de monitoring évolue avec les pipelines au lieu d'imposer un modèle opérationnel séparé.
Le guide d'architecture d'observabilité de digna s'inscrit bien dans ce modèle modulaire, notamment pour les équipes qui veulent garder le monitoring près du data warehouse ou du data lake plutôt que de construire une couche détachée coûteuse à maintenir.
L'enjeu n'est pas l'architecture pour elle-même. Il s'agit de réduire les frictions, de limiter les déplacements de données et de s'assurer que la couche de monitoring ne devient pas une nouvelle source de bruit opérationnel.
Le rôle de l'observabilité dans l'analytique et l'IA
L'analytique comme l'IA échouent vite lorsque les données d'entrée dérivent. Un dashboard peut être faux parce qu'un flux est en retard. Un modèle peut devenir peu fiable parce que les valeurs des features changent. Dans les deux cas, le problème reste souvent invisible jusqu'à ce que le métier en constate l'effet.
Pourquoi l'IA place la barre plus haut
Une source de 2025 sur le marché et l'écart d'adoption indiquait que 48 % des répondants considèrent la faible qualité des données comme le principal frein à la préparation à l'IA, tandis qu'une autre enquête montrait que 74 % des organisations jugent important de surveiller les processus métier critiques et que, pour 54 %, la qualité de détection des alertes est ce qui influence le plus le ROI de l'observabilité, comme le résume l'analyse des acteurs du marché. Ce ne sont pas des chiffres abstraits. Ils montrent que les équipes ne traitent plus l'observabilité comme un sujet d'ingénierie de niche, mais comme une condition préalable à l'IA et au reporting de direction.
C'est important, car les pipelines d'IA ne dépendent pas seulement d'enregistrements propres. Ils dépendent d'entrées stables, d'un comportement prévisible des features et de signaux en aval fiables. Si les données qui alimentent le modèle changent de forme, le modèle peut encore renvoyer un résultat, mais ce résultat peut perdre de sa valeur sans le moindre signal d'échec évident.
Les indicateurs métier méritent la même discipline
L'observabilité est aussi passée du monitoring classique des pipelines au monitoring des processus métier. Ce changement est important, car la direction ne s'intéresse pas à un diff de schéma. Elle veut savoir si le churn client, le volume de commandes, le traitement des sinistres ou d'autres KPI métier sont sortis de la plage attendue. Surveiller ces indicateurs sur les données sous-jacentes donne aux équipes un moyen plus précoce de voir une dérive opérationnelle, sans attendre que la couche de reporting la révèle.
Le guide de digna sur la préparation à l'IA rejoint cette vision plus large, car l'observabilité ne concerne plus seulement la santé technique. Il s'agit de prouver que le socle de données peut soutenir l'analytique, l'automatisation et l'IA sans créer d'angles morts.
Quand les équipes y parviennent, elles cessent de se demander si le dashboard fonctionne. Elles commencent à se demander si les signaux derrière le dashboard méritent encore leur confiance.
Plateformes modulaires et exemples concrets
L'avantage de l'observabilité modulaire est qu'elle permet aux équipes de résoudre un problème de fiabilité précis sans adopter un tout nouveau modèle opérationnel. C'est essentiel dans les environnements d'entreprise, où les équipes de la finance, de la santé, des télécoms et du secteur public font face à des modes de défaillance différents et à des niveaux de tolérance au bruit différents.
Où l'observabilité modulaire trouve sa place
Une équipe de services financiers se soucie généralement des délais, de l'intégrité des transactions et du reporting en aval. Si un flux réglementaire arrive en retard, le problème n'est pas seulement opérationnel. Il affecte la confiance dans le reporting et peut entraîner des échéances manquées en cascade. Une plateforme modulaire peut d'abord se concentrer sur la ponctualité et la détection d'anomalies pour les flux critiques, puis ajouter le suivi des schémas et la validation là où les règles métier comptent le plus.
Une équipe du secteur de la santé a d'autres contraintes. Les datasets cliniques et opérationnels exigent souvent de la validation, une stabilité structurelle et une traçabilité entre les systèmes sources. Les changements de schéma dans un pipeline de dossier patient informatisé peuvent être aussi perturbateurs qu'une livraison tardive, car ils peuvent casser l'analytique ou les workflows de reporting en aval même lorsque le système source semble fonctionner normalement.
Pourquoi une seule plateforme peut rester ciblée
digna est une option dans cette catégorie, et son approche modulaire combine détection d'anomalies pilotée par l'IA, monitoring de la ponctualité, suivi des schémas et validation au niveau des enregistrements dans l'environnement du client. Ce modèle est utile lorsque les équipes veulent garder les données en place et ajouter de l'observabilité sans transférer les données de production vers un service externe distinct.
La page de cas d'usage de digna convient bien aux équipes qui comparent la façon dont ces modules répondent à différents besoins opérationnels. L'important n'est cependant pas la marque. C'est le principe de conception : commencer par les signaux qui correspondent à vos pipelines les plus à risque, puis n'étendre que là où le monitoring renforce la confiance plus qu'il n'ajoute de charge.
Si une plateforme ne sait pas expliquer pourquoi une alerte compte pour le métier, elle n'est pas encore aboutie.
Ce principe vaut dans tous les secteurs. Le meilleur déploiement de l'observabilité est généralement celui qui démarre petit, prouve sa valeur, puis ne s'étend que là où l'équipe peut garder un signal propre.
Remettre en question les idées reçues
La plus grande idée reçue est que l'observabilité n'est qu'une façon plus élégante de trouver les mauvais enregistrements. Ce n'est pas le cas. La qualité des enregistrements compte toujours, mais le problème le plus difficile est de décider ce qui mérite l'attention, car chaque nouvelle table surveillée ajoute du coût, des métadonnées et de la charge d'alerting.
Plus de monitoring ne signifie pas toujours plus de confiance
Un flux d'alertes bruyant peut faire baisser la confiance plus vite que l'absence totale de monitoring. Quand le moindre écart déclenche une astreinte, les ingénieurs commencent à ignorer les avertissements et le système perd sa crédibilité. C'est pourquoi la maîtrise du périmètre est si importante, surtout dans les grands parcs de données où tout surveiller de la même façon est à la fois coûteux et source de distraction.
Une autre erreur courante consiste à croire que l'observabilité est réservée aux grandes entreprises. Les petites équipes en profitent aussi, mais seulement si elles se concentrent sur les pipelines les plus importants. Si une équipe data de trois personnes surveille chaque table de faible valeur du data warehouse, elle se noiera sous un travail dont elle n'a pas besoin.
Utiliser l'observabilité là où le métier ressent la douleur
La règle pratique est simple. Surveillez d'abord les actifs pour lesquels un retard, une dérive ou une défaillance affecterait le reporting, l'expérience client, la conformité ou la qualité des modèles. Une fois ceux-ci stabilisés, étendez la démarche aux datasets voisins avec la même discipline.
Une bonne observabilité réduit l'incertitude. Une mauvaise observabilité ne fait que créer une version plus soignée de la fatigue d'alerte.
C'est le compromis central. Davantage de détection n'est utile que si l'équipe peut agir en conséquence, et assez vite pour que cela compte. Sinon, la couche de monitoring devient une nouvelle source de friction.
Construire votre stratégie de Data Observability
Une stratégie viable commence par les pipelines dont la défaillance ferait le plus mal. Cela paraît évident, mais beaucoup d'équipes commencent encore par instrumenter le dataset le plus simple plutôt que le plus important. Résultat : un dashboard impeccable sur une table à faible risque, et aucune vraie protection là où le métier est réellement exposé.
Commencer par les chemins critiques, pas par une large couverture
Identifiez les tables, les flux et les rapports en aval qui pilotent la finance, les opérations, l'expérience client ou les workloads d'IA. Définissez ensuite les signaux les plus importants pour chacun. Un chargement tardif peut être l'enjeu principal d'un pipeline, tandis que les changements de schéma ou les glissements de distribution comptent davantage dans un autre.
À partir de là, utilisez l'observabilité pour réduire la création manuelle de règles. Cela ne signifie pas abandonner la validation. Il s'agit de réserver les contrôles approfondis au niveau des enregistrements aux actifs où l'exactitude métier compte le plus, tout en laissant le monitoring comportemental couvrir le reste du parc. Cet équilibre garde le système pragmatique.
Construire pour agir, pas seulement pour détecter
L'alerting doit mener à la prise en charge, au triage et à la résolution. Si la plateforme ne peut pas acheminer un incident vers l'équipe propriétaire des données, le signal ne se transformera pas en correctif. Si l'alerte ne montre pas l'impact probable en aval, les ingénieurs passeront trop de temps à reconstituer le rayon d'impact à la main.
Vous obtiendrez de meilleurs résultats si vous faites ces trois choix tôt :
Choisissez d'abord les pipelines à fort impact : surveillez les données dont la défaillance changerait les décisions métier.
Séparez le signal du bruit : ajustez les alertes pour que l'équipe voie les écarts significatifs, et non chaque petite fluctuation.
Gardez un modèle opérationnel simple : utilisez des capacités modulaires pour que l'observabilité grandisse avec la stack au lieu de la submerger.
L'objectif à long terme est la confiance, pas l'outillage. Lorsque le monitoring fait partie de la façon dont l'équipe livre des données fiables, les équipes analytiques avancent plus vite, les utilisateurs métier posent moins de questions défensives et le data engineering cesse de passer sa semaine à réparer des incidents évitables.
Si vous renforcez votre stratégie d'observabilité de la qualité des données, digna offre aux équipes la détection d'anomalies, le contrôle de la ponctualité, le suivi des schémas et la validation de manière modulaire, au sein de leur propre environnement. Rendez-vous sur digna pour découvrir comment cette approche peut soutenir une analytique et une IA fiables sans déplacement de données inutile ni bruit opérationnel.
Pour voir à quoi ressemble cette approche modulaire et in-database à l'échelle d'une plateforme entière, de la fraîcheur et des changements de schéma jusqu'aux anomalies et à la validation, notre page observabilité de la plateforme de données montre comment digna surveille ces signaux sans faire sortir les données de votre environnement.
Questions fréquentes
Qu'est-ce que l'observabilité de la qualité des données ?
L'observabilité de la qualité des données surveille le comportement des données à mesure qu'elles traversent les pipelines, à l'aide de signaux comme la fraîcheur, le volume, le schéma, la distribution et le lineage. Au lieu d'attendre qu'un dashboard casse, elle signale tôt les chargements tardifs, le schema drift ou les variations de volume, afin que les équipes se demandent ce qui a changé avant la panne plutôt que pourquoi le dashboard a cassé.
En quoi la data observability diffère-t-elle des contrôles de qualité des données basés sur des règles ?
Les contrôles basés sur des règles ne détectent que les problèmes déjà anticipés, tandis que l'observabilité apprend le comportement normal et signale les changements significatifs. Les règles restent précieuses pour une logique précise et auditable au niveau des enregistrements, mais elles manquent les pannes inattendues et peuvent submerger les équipes d'alertes de faible valeur. L'article recommande de garder la validation pour les règles connues et de laisser le monitoring comportemental couvrir le reste.
Quels signaux de data observability faut-il surveiller en premier ?
Commencez par la fraîcheur, le volume, le schéma, la distribution et le lineage, car ils montrent si un pipeline est vivant et cohérent. Chacun correspond à un mode de défaillance : la fraîcheur détecte les chargements tardifs ou manquants, le volume les doublons et les flux rejoués, et le schéma les champs ajoutés, supprimés, renommés ou retypés, même si aucun d'eux ne détecte à lui seul les erreurs sémantiques.
Combien de temps faut-il pour détecter un incident de données ?
Souvent plus longtemps que les équipes ne le pensent : dans une enquête Wakefield Research de 2023, 68 % des répondants avaient besoin de quatre heures ou plus pour détecter les incidents de données. La résolution prenait en moyenne 15 heures par incident, et les incidents mensuels sont passés de 59 à 67 d'une année sur l'autre, d'où l'importance d'un signal précoce plutôt que d'une lutte plus rapide contre les incendies.
Les contrôles d'observabilité doivent-ils s'exécuter dans le data warehouse ?
Oui, l'exécution in-database est le modèle d'architecture le plus solide, car la logique de monitoring s'exécute là où se trouvent déjà les données au lieu de les copier dans un outil séparé. Cela améliore la sécurité et la performance pour les charges sensibles ou lourdes, et une approche modulaire permet aux équipes de commencer par un seul problème, comme le schema drift, avant d'étendre la démarche.



