Qu'est-ce que la gestion de la qualité des données dans la santé
|
8
minute de lecture

Un clinicien ouvre un tableau de bord avant la visite du matin et y voit une tendance rassurante. Le dernier résultat de laboratoire semble normal, mais le flux est arrivé après la fenêtre de reporting. Ailleurs, un code diagnostique contredit l'historique du patient, parce qu'un système source a mappé la valeur différemment lors de l'échange. L'enregistrement existe, mais il n'est pas adapté à la décision à prendre.
Voilà ce que signifie concrètement la gestion de la qualité des données dans la santé. Il s'agit de la discipline continue qui consiste à vérifier que les données cliniques, opérationnelles, de santé publique, de recherche et réglementaires sont complètes, exactes, cohérentes, porteuses de sens et disponibles au moment où l'on en a besoin. Le travail va des contrôles au point de collecte jusqu'à la validation des échanges, la détection d'anomalies, la remédiation, le lignage et la gouvernance.
Table des matières
Les enjeux critiques de l'intégrité des données cliniques
Où les défaillances deviennent visibles
Définir les dimensions essentielles de la qualité des données de santé
Quatre questions pour un même jeu de données
Transformer les dimensions en contrôles
Les pièges courants de la validation des données de santé
Trois modes de défaillance à distinguer
Pourquoi les scores agrégés masquent le risque
Des audits statiques à l'observabilité continue
Contrôles d'audit ou observabilité
Ce que la surveillance continue doit faire remonter
Garantir l'interopérabilité et la conformité réglementaire
Conformité structurelle n'est pas accord sémantique
Des données propres peuvent encore produire une IA dangereuse
Mettre en place un cadre de qualité des données évolutif
Construire le plan de contrôle par couches
Réduire les déplacements de données et le bruit des alertes
Pérenniser les stratégies de données de santé
Les enjeux critiques de l'intégrité des données cliniques
Un résultat en retard peut être aussi perturbateur qu'un résultat erroné. Si un entrepôt de données cliniques reçoit une valeur de laboratoire après que l'équipe soignante a déjà évalué l'état d'un patient, la donnée peut être techniquement correcte mais opérationnellement dangereuse. Il en va de même pour une allergie manquante, une identité patient dupliquée, une liste de médicaments obsolète ou un diagnostic dont le sens a changé d'un système à l'autre.
Les équipes de santé prennent leurs décisions à travers des systèmes interconnectés. Dossiers patients informatisés, plateformes de laboratoire, systèmes d'imagerie, registres, environnements de facturation et entrepôts de reporting apportent chacun une partie de l'histoire du patient. Lorsqu'un composant défaille, le personnel peut répéter des examens, rapprocher les dossiers à la main, retarder le reporting ou agir sur une vision incomplète.
L'ampleur des échanges fait de la disponibilité une exigence de qualité, et non un simple confort. En 2021, 88 % des hôpitaux américains ont envoyé ou obtenu électroniquement des informations de santé sur les patients, par requête ou par réception électronique de résumés de soins, selon la note de données sur l'interopérabilité de l'Office of the National Coordinator for Health IT. Une donnée introuvable, ininterprétable ou inutilisable au point de soins manque son objectif, même si elle reste stockée quelque part.
Où les défaillances deviennent visibles
Une mauvaise qualité des données crée plusieurs types d'exposition opérationnelle :
Risque clinique : des informations manquantes ou contradictoires peuvent fausser le diagnostic, la conciliation médicamenteuse et les décisions thérapeutiques.
Risque de reporting : des événements incomplets ou des dénominateurs instables peuvent faire paraître les indicateurs de qualité meilleurs ou pires qu'en réalité.
Risque pour la recherche : un codage et une provenance incohérents affaiblissent la reproductibilité et rendent les définitions de cohortes plus difficiles à défendre.
Risque de conformité : les équipes peuvent être incapables de montrer quels enregistrements ont été vérifiés, quelle règle a échoué et comment la remédiation a eu lieu.
Risque de confiance : cliniciens et analystes cessent de se fier aux tableaux de bord lorsqu'ils y trouvent régulièrement des écarts.
Un projet de nettoyage ponctuel ne règle pas ces situations. Le temps qu'un audit repère une interface en retard, un mapping cassé ou un chargement d'établissement manquant, les rapports et modèles en aval ont peut-être déjà consommé les données. La vraie question n'est pas de savoir si une organisation a des erreurs : tout environnement de santé complexe en a. La question est de savoir si elle peut identifier tôt les défaillances significatives, en déterminer la cause et conserver la preuve de sa réponse.
Pour une vision concrète de l'impact de ces défaillances sur les soins, consultez cinq incidents graves causés par une mauvaise qualité des données de santé. La leçon centrale est simple : l'intégrité des données fait partie de la sécurité clinique et du contrôle opérationnel, et ne relève pas uniquement du backlog de l'ingénierie des données.
Définir les dimensions essentielles de la qualité des données de santé
Le cadre Data Quality Review de l'Organisation mondiale de la santé offre aux équipes de santé une base utile. Il définit la qualité à travers la complétude, la cohérence interne, la comparaison externe et la cohérence externe des données de population, comme décrit dans le guide de l'OMS sur le cadre et les métriques.
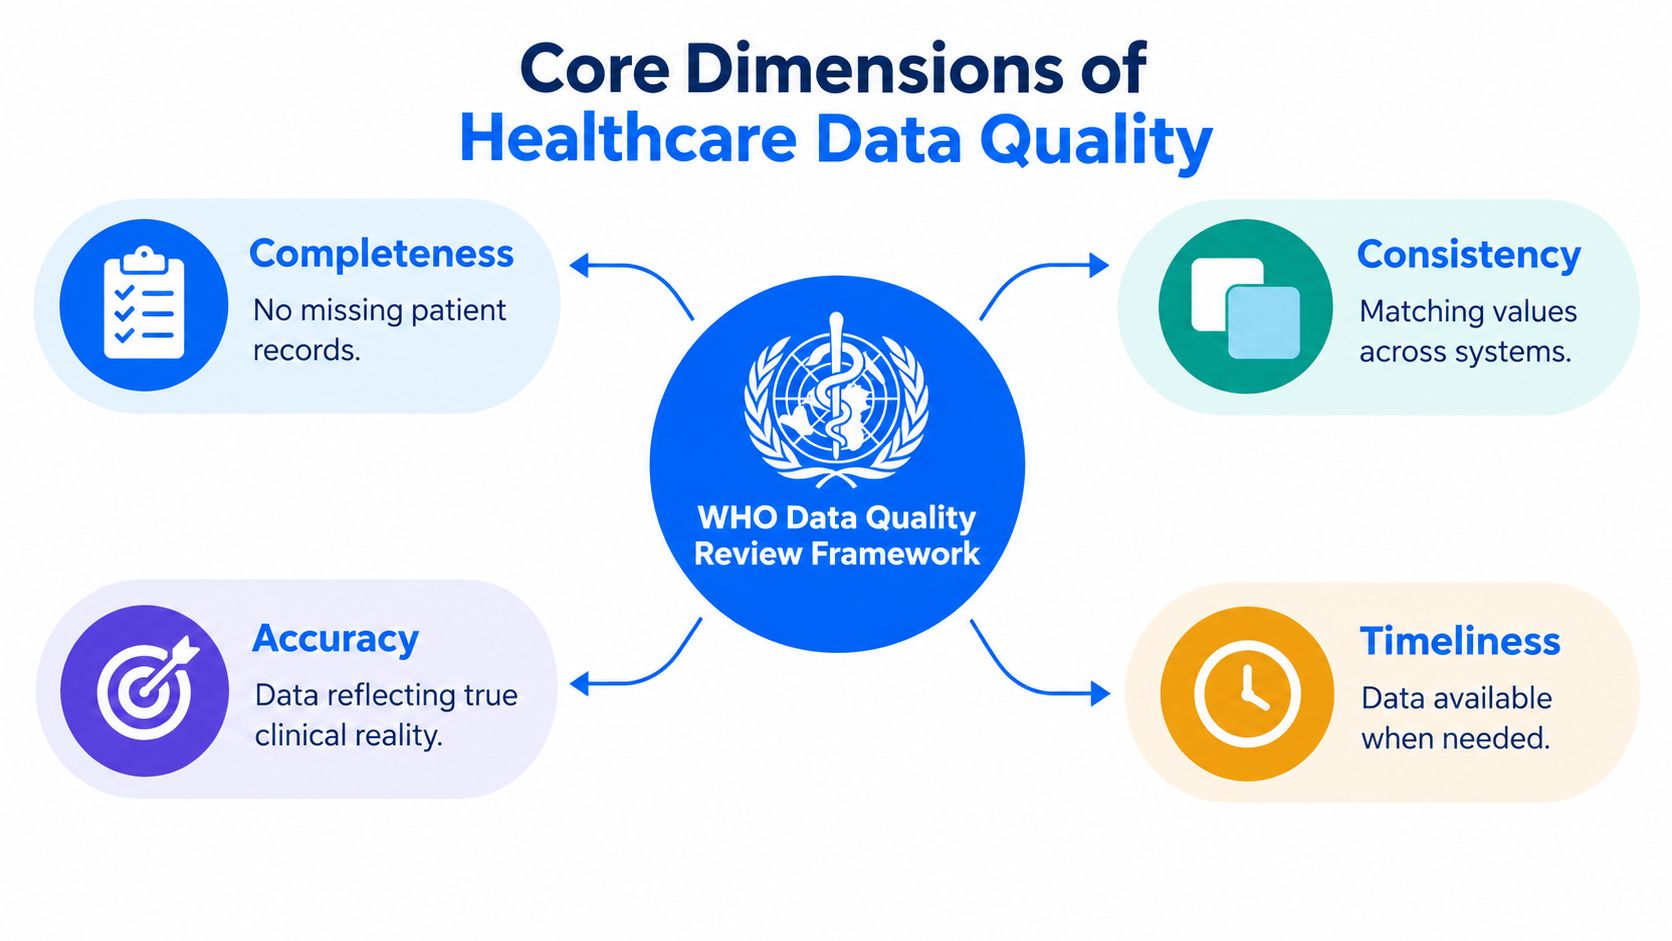
Ces dimensions fournissent un vocabulaire pour évaluer si les données sont adaptées à un usage défini. Elles ne doivent pas devenir une checklist déconnectée du contexte des processus.
Quatre questions pour un même jeu de données
La complétude vérifie que les enregistrements, champs, événements et unités déclarantes requis sont présents. Un établissement peut transmettre les séjours mais omettre les événements de sortie, ou renseigner les données démographiques en laissant vides des champs cliniquement importants. La complétude inclut aussi le comportement de livraison : un fichier complet qui arrive après une échéance de reporting peut rester inutilisable pour cet usage.
La cohérence interne vérifie que les valeurs liées concordent. Les dates doivent suivre des séquences valides, les enregistrements liés doivent référencer des entités existantes et les valeurs doivent respecter les règles cliniques ou métier. L'âge d'un patient, la date de séjour, le diagnostic et l'historique des actes peuvent chacun sembler valides isolément tout en formant ensemble une combinaison impossible.
La comparaison externe confronte les totaux à une source indépendante. L'activité d'un établissement peut être comparée à un registre, une application source, un système de laboratoire ou un registre de reporting. Cela aide à repérer une sous-déclaration systématique que les contrôles au niveau de l'enregistrement peuvent manquer.
La cohérence externe des données de population examine si les dénominateurs et les estimations de population donnent du sens aux taux publiés. Un taux de vaccination, un taux d'admission ou un indicateur de maladie peut être calculé correctement et pourtant induire les décideurs en erreur si l'estimation de population sous-jacente est obsolète ou inadaptée.
Le cadre soutient aussi des attentes pratiques en matière d'exactitude, de fiabilité et d'actualité. L'exactitude porte sur la fidélité d'une valeur à la prestation réelle ou à la réalité clinique. La fiabilité porte sur la stabilité et la solidité de mesures répétées. L'actualité porte sur la disponibilité de l'information dans la fenêtre exigée par l'usage prévu.
Transformer les dimensions en contrôles
Un programme qualité doit définir des seuils par jeu de données et par processus, plutôt que publier un score unique pour toute l'organisation. Parmi les contrôles utiles :
Vérification de la couverture des champs obligatoires et des événements.
Validation des plages, des jeux de codes et des règles conditionnelles.
Rapprochement inter-systèmes des totaux et des identifiants.
Surveillance des chargements retardés, manquants ou anormalement petits.
Documentation des exceptions, des responsabilités, de la remédiation et des preuves.
Les dimensions de la qualité des données comptent parce qu'un jeu de données peut être complet mais inexact, cohérent mais périmé, ou structurellement valide mais sémantiquement trompeur. La gestion de la qualité commence lorsque les équipes relient chaque dimension à la décision que les données doivent soutenir.
Les pièges courants de la validation des données de santé
L'erreur de validation la plus fréquente consiste à considérer des champs renseignés comme une preuve de qualité. Une valeur peut être présente, correctement typée, et pourtant fausse pour le patient, pour l'épisode de soins ou dans son sens après l'échange. Les équipes de santé ont besoin de contrôles distincts pour la complétude, l'exactitude, la validité, la cohérence, l'unicité et l'actualité.
La distinction est opérationnelle. La méthodologie qualité du gouvernement britannique pour les infections associées aux soins définit l'exactitude comme la proximité avec la réalité, la complétude comme la présence des enregistrements attendus et des valeurs essentielles, et l'actualité comme la fraîcheur et la disponibilité pour la période représentée. Elle souligne aussi un point essentiel : complétude ne veut pas dire exactitude.
Trois modes de défaillance à distinguer
Données manquantes : le séjour, l'observation, le dénominateur ou le champ obligatoire attendu n'arrive jamais. La réponse consiste à examiner la collecte, la livraison par l'interface et l'ingestion.
Données incorrectes : l'enregistrement arrive, mais sa valeur contredit une source de référence, une plage ou une règle clinique. La réponse passe par la comparaison, la validation et la correction.
Données en retard ou périmées : la valeur est correcte mais indisponible quand le processus en a besoin. La réponse passe par des références de livraison et une surveillance de l'actualité.
Une quatrième catégorie mérite autant d'attention : la défaillance sémantique. Deux systèmes peuvent échanger un code syntaxiquement valide tout en lui attribuant des sens différents. Une transformation peut préserver le format mais perdre le contexte, les unités, la provenance ou la relation avec une autre ressource.
Pourquoi les scores agrégés masquent le risque
Une étude multicentrique de 2025 menée dans 19 hôpitaux a montré que 17,7 % des problèmes de qualité des données identifiés avaient un impact important, touchant au moins la moitié des enregistrements concernés, et qu'une analyse incomplète des causes d'erreur laissait passer des failles systémiques critiques, selon l'étude publiée dans le Journal of the American Medical Informatics Association. L'étude a relevé des erreurs d'abstraction de dossiers, des différences entre systèmes sources et des erreurs d'extraction, ce qui montre pourquoi les équipes doivent rechercher les causes au lieu de s'arrêter à un pourcentage d'exactitude.
Une séquence de validation utile :
Valider la structure : vérifier les types de données, les éléments obligatoires, les valeurs autorisées et l'intégrité référentielle.
Valider le sens : appliquer des règles cliniques, opérationnelles et inter-champs.
Valider la livraison : comparer l'heure d'arrivée, le volume, les taux de valeurs nulles et les distributions au comportement attendu.
Valider l'impact : identifier les rapports, indicateurs, modèles, établissements et groupes de patients concernés.
Tracer la remédiation : conserver la règle, la source, l'horodatage, le nombre d'enregistrements touchés, le responsable et le statut.
Cette approche traite la validation comme un système de contrôle plutôt que comme un nettoyage ponctuel. La validation des données de santé à grande échelle doit aider les équipes à localiser la couche défaillante et à prioriser les défauts susceptibles de modifier une issue clinique ou réglementaire.
Des audits statiques à l'observabilité continue
Les audits périodiques gardent leur rôle. Ils apportent une assurance indépendante, testent la gouvernance et vérifient que les contrôles fonctionnent comme prévu. Mais ils ne suffisent pas comme principal mécanisme de détection pour des données cliniques qui évoluent vite.
Une revue de documents cliniques électroniques a révélé que 86,3 % des documents échantillonnés contenaient des erreurs, avec une moyenne de 4,9 erreurs par document, selon cette revue à comité de lecture des documents cliniques électroniques. La même revue distinguait les alertes de complétude des alertes de syntaxe, ce qui illustre pourquoi un fichier bien arrivé peut encore contenir des défauts qui compromettent son usage en aval.
Contrôles d'audit ou observabilité
Modèle opérationnel | Points forts | Limites |
|---|---|---|
Audit manuel périodique | Apporte une analyse approfondie et des preuves de gouvernance | Détecte les défaillances après la propagation des données |
Bibliothèque de règles fixes | Applique des exigences métier et cliniques explicites | Exige de la maintenance et peut générer du bruit d'alertes |
Observabilité continue | Détecte les changements de comportement, les chargements manquants et les dérives de livraison | Nécessite une conception des références, des responsables et une escalade raisonnée |
Investigation humaine | Interprète le contexte et confirme la cause racine | Ne passe pas à l'échelle comme premier filtre pour chaque enregistrement |
Un vaste ensemble de règles écrites à la main peut sembler rigoureux tout en devenant difficile à maintenir. Les équipes finissent par ignorer les alertes lorsque les seuils sont fragiles, que les doublons sont fréquents ou que chaque petit changement de distribution reçoit la même priorité. À l'inverse, un système sans règles déterministes peut détecter un comportement inhabituel sans comprendre si ce changement enfreint une exigence clinique.
Le modèle pragmatique combine les deux approches. La validation déterministe gère les contraintes connues, comme les champs obligatoires, les codes valides, les relations de référence et la logique clinique conditionnelle. La surveillance comportementale apprend les schémas attendus pour les volumes d'enregistrements, les taux de valeurs nulles, les heures de livraison, les distributions de valeurs et l'activité, puis signale les écarts qui méritent une investigation.
Ce que la surveillance continue doit faire remonter
Une couche d'observabilité utile peut identifier :
Un chargement d'établissement manquant ou une baisse inattendue du nombre d'enregistrements.
Un changement de schéma qui ajoute, supprime ou modifie une colonne.
Un changement brutal dans la distribution des codes ou les taux de valeurs nulles.
Un flux qui arrive plus tard que son schéma de livraison appris.
Un indicateur métier qui sort de sa plage habituelle.
Un échec de validation récurrent concentré sur une source ou une interface.
La valeur ne réside pas dans l'alerte elle-même, mais dans le contexte : quel jeu de données a changé, quand, quelle source l'a produit, combien d'enregistrements sont touchés et quels produits en aval en dépendent. L'observabilité de la qualité des données traduit ce passage du nettoyage réactif à une surveillance continue de la fiabilité.
Garantir l'interopérabilité et la conformité réglementaire
L'interopérabilité est souvent réduite à la capacité des systèmes à échanger des messages. Cette définition est trop faible pour le travail clinique. Un système récepteur doit pouvoir analyser, interpréter, relier et utiliser l'information dans la fenêtre de temps requise.
L'United States Core Data for Interoperability, ou USCDI, définit les classes et éléments de données essentiels que les systèmes informatiques de santé certifiés doivent prendre en charge. Les spécifications applicables incluent HL7 FHIR US Core et la Consolidated Clinical Document Architecture. Les exigences HL7 Patient Information Quality Improvement décrivent aussi des mécanismes d'évaluation des données structurées, notamment les champs obligatoires, les liaisons terminologiques, la structure des documents et les relations entre ressources échangées.
Conformité structurelle n'est pas accord sémantique
La validation FHIR peut vérifier les types de données, la cardinalité, les expressions, la terminologie et les références. Ces contrôles sont nécessaires, mais ils ne garantissent pas que deux organisations utilisent un concept dans le même contexte opérationnel. Un désalignement sémantique entre des standards comme HL7 FHIR et SNOMED CT peut laisser des données techniquement interopérables avec un sens incohérent.
Les standards évoluent aussi. L'USCDI et les spécifications d'échange associées sont mises à jour chaque année : les organisations ont donc besoin d'un suivi des changements plutôt que d'un projet de conformité ponctuel. Un élément, une liaison terminologique, un profil ou une structure de document modifiés peuvent affecter l'ingestion, le reporting, l'analytique et les modèles en aval.
Règle pratique : traitez chaque frontière d'échange comme une frontière de qualité. Validez ce qui est arrivé, ce que cela signifie, quand c'est arrivé et comment cela se rapporte aux données sources de référence.
Des données propres peuvent encore produire une IA dangereuse
Un jeu de données peut passer les contrôles de schéma et de complétude tout en restant non représentatif. Les données manquantes peuvent se concentrer sur une population, les pratiques de codage varier selon les établissements et les maladies rares être sous-enregistrées. Ces schémas affectent non seulement l'analytique descriptive, mais aussi le développement et la surveillance des modèles.
Une revue des National Academies de 2025 a souligné que disponibilité, qualité et biais des données sont étroitement liés dans l'IA en santé, en avertissant que les systèmes automatisés peuvent amplifier les faiblesses sémantiques et de qualité des données au lieu de les corriger, comme le résume la revue des National Academies. La question de la qualité passe alors de « La table est-elle propre ? » à « Qui est représenté, quelles données manquent et comment la performance varie-t-elle selon les contextes et les groupes ? »
Un programme défendable relie les contrôles techniques à la gouvernance :
Préserver le lignage de la collecte jusqu'à la transformation.
Tracer la provenance et les mappings sémantiques.
Surveiller la complétude par sous-groupe et les dérives de distribution.
Suivre les changements de codage et les comportements propres à chaque source.
Examiner les résultats en aval, pas seulement les taux de réussite des validations.
Escalader toute dégradation inexpliquée auprès des responsables cliniques et de gouvernance.
La conformité des données de santé exige donc plus que des contrôles de format. Elle exige la preuve que les données restent compréhensibles, traçables, à jour et adaptées à la décision ou à l'usage réglementé.
Mettre en place un cadre de qualité des données évolutif
Un cadre évolutif part de l'usage, pas de l'outillage. Identifiez les décisions cliniques, opérationnelles et réglementaires qui dépendent de chaque jeu de données, puis définissez ce qu'est une défaillance pour cet usage. Un flux de laboratoire peut exiger une surveillance stricte de la livraison, tandis qu'un jeu de données de recherche historique peut tolérer un délai mais demander une documentation plus solide sur la provenance et la complétude.
Construire le plan de contrôle par couches
Commencez par un inventaire des données qui relie sources, tables, pipelines, responsables, produits en aval et usages prévus. Priorisez les jeux de données à fort impact au lieu de tenter de tout surveiller d'un coup.
Établissez ensuite quatre couches de contrôle complémentaires :
Validation des enregistrements : appliquer des contrôles de champs obligatoires, de jeux de codes, de plages, d'intégrité référentielle et des règles métier conditionnelles.
Surveillance des jeux de données : suivre les volumes, les taux de valeurs nulles, les doublons, les distributions et la volatilité inattendue par source et par établissement.
Surveillance de la livraison : apprendre le comportement d'arrivée attendu et signaler les chargements manquants, les retards et les horaires de livraison inhabituels.
Surveillance structurelle : détecter les colonnes ajoutées ou supprimées, les types de données modifiés et toute autre dérive de schéma avant que les consommateurs ne cessent de fonctionner de manière inattendue.
Gardez les preuves au plus près du contrôle. Chaque incident doit conserver le jeu de données, la règle ou le signal, l'horodatage, la source, le nombre d'enregistrements touchés, la gravité, le responsable, le statut de remédiation et les notes de résolution. Ce registre soutient la gouvernance et aide les ingénieurs à distinguer un problème local de documentation d'une défaillance d'interface en amont.
Réduire les déplacements de données et le bruit des alertes
Les environnements de santé imposent des limites strictes au déplacement des données sensibles. L'exécution dans la base de données permet aux équipes de calculer les métriques et de mener les analyses au sein de l'entrepôt ou de la plateforme du client, ce qui réduit les copies inutiles tout en préservant les contrôles d'accès existants. Les déploiements en cloud privé et sur site conviennent aux environnements où les données de production doivent rester dans le cloud, le réseau privé virtuel ou le data center de l'organisation.
La conception des alertes compte autant que la détection. Ne transmettez que les écarts actionnables, regroupez les défaillances liées, montrez l'impact probable et permettez aux équipes de mettre en sourdine les maintenances connues sans masquer de nouveaux comportements. Une plateforme modulaire comme digna peut combiner détection d'anomalies, validation au niveau des enregistrements, surveillance de l'actualité, suivi des schémas et revue partagée des incidents, tout en gardant les calculs dans l'environnement du client.
L'objectif de la mise en œuvre n'est pas un score parfait, mais une boucle opérationnelle reproductible : détecter, trier, investiguer, remédier, vérifier et apprendre.
Pérenniser les stratégies de données de santé
Les données de santé continueront d'arriver de toujours plus de contextes, d'appareils, d'applications et de canaux d'échange. Télémédecine, objets connectés, recherche génomique et informations produites par les patients apportent des signaux utiles, mais aussi des modes de collecte, des unités, des schémas de données manquantes et des exigences de provenance différents. Une stratégie résiliente part du principe que la qualité évoluera avec l'environnement.
L'approche la plus durable intègre les contrôles tout au long du cycle de vie :
À la collecte : rendre explicite le contexte requis et empêcher les saisies ambiguës lorsque c'est possible.
À l'ingestion : valider la structure, la terminologie, les relations et l'identité de la source.
Pendant la transformation : préserver le lignage, les unités, la provenance et les choix sémantiques.
En production : surveiller la livraison, les distributions, le comportement des schémas et l'impact métier.
Après les incidents : documenter la cause racine et transformer les défaillances récurrentes en contrôles préventifs.
Des kits de développement logiciel programmatiques peuvent placer les contrôles qualité directement dans les pipelines de données et les applications. Cela réduit l'écart entre le moment où un ingénieur modifie une transformation et celui où une équipe de gouvernance en découvre les conséquences. Les contrôles doivent néanmoins rester observables, versionnés, testables et rattachés à des responsables.
La qualité des données devient durable lorsque les équipes la traitent comme une propriété opérationnelle de chaque pipeline, et non comme une inspection finale avant publication.
Les programmes de santé les plus solides refusent aussi une définition étroite de « propre ». Ils surveillent la complétude par sous-groupe et par contexte, distinguent les valeurs valides des valeurs porteuses de sens, testent l'actualité au regard des délais cliniques et vérifient si les modèles ou rapports se comportent différemment après des changements de source. L'amélioration continue consiste à affiner les seuils, retirer les contrôles trop bruyants, étendre le lignage et impliquer les acteurs cliniques lorsque des anomalies techniques pourraient affecter les soins.
Qu'est-ce donc que la gestion de la qualité des données dans la santé ? C'est la pratique continue qui consiste à maintenir l'information adaptée à son usage clinique, opérationnel, de recherche, de santé publique et réglementaire. Les organisations qui intègrent cette discipline dans la collecte, les échanges, les pipelines et les systèmes de décision peuvent faire des données un actif maîtrisé plutôt qu'une source récurrente d'incertitude.
digna apporte la qualité et l'observabilité des données directement dans la base de données pour les jeux de données de santé, avec détection d'anomalies, validation au niveau des enregistrements, surveillance de l'actualité et suivi des schémas au sein de votre propre environnement. Rendez-vous sur digna pour évaluer une approche modulaire qui rend les données cliniques, opérationnelles et réglementaires plus fiables.
Les identités patient dupliquées et les séjours qui pointent vers des enregistrements qui n'existent plus sont des défaillances de relation autant que des erreurs de valeur. Pour savoir comment tester ces liens entre DPI, laboratoire et systèmes de reporting, consultez l'intégrité référentielle des données de santé.
Questions fréquentes
Qu'est-ce que la gestion de la qualité des données dans la santé ?
C'est la discipline continue qui consiste à vérifier que les données cliniques, opérationnelles, de recherche, de santé publique et réglementaires sont complètes, exactes, cohérentes, porteuses de sens et disponibles au moment voulu. Le travail va des contrôles au point de collecte à la validation des échanges, à la détection d'anomalies et à la remédiation, jusqu'au lignage et à la gouvernance, plutôt que de se limiter à un projet de nettoyage ponctuel.
Quelles dimensions l'OMS utilise-t-elle pour évaluer la qualité des données de santé ?
Le cadre Data Quality Review de l'OMS s'appuie sur la complétude, la cohérence interne, la comparaison externe avec une source indépendante et la cohérence externe des données de population, comme les dénominateurs. Il soutient aussi des attentes en matière d'exactitude, de fiabilité et d'actualité. Les équipes doivent traduire chaque dimension en seuils propres à un jeu de données et à un processus, plutôt qu'en un score unique pour toute l'organisation.
Pourquoi un dossier complet ne prouve-t-il pas la qualité des données de santé ?
Complétude ne veut pas dire exactitude. Une valeur peut être présente et correctement typée, mais fausse pour le patient, pour l'épisode de soins ou dans son sens après l'échange. Données manquantes, incorrectes, en retard ou sémantiquement désalignées sont des modes de défaillance distincts, et chacun exige son propre contrôle, des vérifications d'interface aux références de livraison en passant par le mapping terminologique.
Pourquoi les audits périodiques ne suffisent-ils pas pour les données cliniques ?
Les audits ne détectent les défaillances qu'une fois les données parvenues dans les rapports et les modèles. Une revue a relevé des erreurs dans 86,3 % des documents cliniques électroniques échantillonnés. L'observabilité continue complète les audits en signalant les chargements d'établissement manquants, les flux en retard, les changements de schéma et les variations des taux de valeurs nulles ou des distributions de codes tant qu'il est encore temps d'agir.
Comment construire un cadre de qualité des données de santé évolutif ?
Partez des décisions que chaque jeu de données soutient, puis superposez les contrôles : validation des enregistrements, surveillance des volumes et distributions des jeux de données, surveillance de la livraison par rapport aux schémas d'arrivée appris et surveillance structurelle des dérives de schéma. Exécuter les contrôles dans la base de données limite le déplacement des données sensibles, et chaque incident doit conserver son responsable, les enregistrements touchés et le statut de remédiation.


