Le format de table ouvert Iceberg expliqué simplement
|
8
minute de lecture

Votre tableau de bord annonce une baisse du chiffre d'affaires d'hier, mais le problème est moins évident. Un moteur a lu un répertoire avant qu'un nouveau lot soit pleinement validé, un autre a interprété une partition différemment, et un troisième voit encore un schéma plus ancien. Les fichiers existent, et pourtant la table ne peut pas fournir une réponse fiable.
C'est le problème que traite le format de table ouvert Iceberg. Il ajoute une couche structurée de métadonnées et de transactions au-dessus de données stockées en fichiers ouverts, tout en laissant les équipes libres d'utiliser des moteurs comme Spark, Flink, Trino ou Hive. La décision importante en 2026 n'est toutefois pas seulement de savoir si Iceberg est un bon format de table. C'est quel catalogue contrôle les métadonnées, les politiques et le chemin d'accès entre ces moteurs.
Sommaire
Introduction aux formats de table modernes et pourquoi ils comptent
Ce qu'est un format de table ouvert et comment il fonctionne
Garanties transactionnelles, évolution du schéma et stratégies de partitionnement
Intégrations de l'écosystème, schémas de migration et exemples de flux
Bonnes pratiques, réglage des performances et diagnostic en production
Introduction aux formats de table modernes et pourquoi ils comptent
Un lac de données classique commence souvent par un job d'ingestion qui écrit des fichiers Parquet dans le stockage objet, un metastore qui enregistre l'emplacement de la table, et un moteur de requête qui découvre les fichiers en parcourant des dossiers. Cette approche peut fonctionner pour des données en ajout seul, mais la pression opérationnelle arrive vite.
Un producteur peut écrire dans le mauvais répertoire de date. Un job de réparation peut modifier des fichiers pendant qu'une requête de tableau de bord s'exécute. Un analyste peut lire un mélange d'anciens et de nouveaux fichiers. Si la disposition des partitions change, tous les producteurs et consommateurs peuvent devoir comprendre le changement manuellement. Le lac se comporte alors moins comme une base de données que comme un dossier partagé aux règles non écrites.
Les formats de table ouverts améliorent cet arrangement en plaçant une abstraction de table au-dessus des fichiers. Ils suivent schémas, instantanés, métadonnées de fichiers et commits pour que les moteurs comprennent quels fichiers appartiennent à une version cohérente de la table. Les données restent dans des formats de stockage ouverts, mais les utilisateurs gagnent un comportement digne d'une base de données.
Pour les clients de digna et des équipes d'entreprise comparables, la fiabilité dépasse la réussite des requêtes. Une table de reporting doit arriver à l'heure, conserver la structure attendue, passer les validations métier et exposer assez d'historique pour instruire un incident. Iceberg aide à poser les fondations transactionnelles et structurelles de la table. L'observabilité doit encore opérer autour de ces fondations, en vérifiant si les données sont arrivées, si des valeurs ont changé de façon inattendue et si les consommateurs en aval restent compatibles. Les équipes qui explorent le concept plus large peuvent utiliser cette présentation des formats de table ouverts comme contexte supplémentaire.
Règle pratique : traitez un format de table ouvert comme une couche de fiabilité pour des fichiers, pas comme une plateforme de gouvernance complète.
Apache Iceberg a été créé chez Netflix en 2017 pour traiter des problèmes d'échelle et de cohérence dans les tables de style Hive. Netflix l'a donné à l'Apache Software Foundation en novembre 2018, et le projet a atteint le statut de premier niveau chez Apache en mai 2020. Sa spécification s'est poursuivie avec la version stable 1.0.0 en octobre 2022 et la 1.6.1 en août 2024, selon l'historique du projet Apache Iceberg.
Ce guide part du modèle de table de base, puis parcourt l'architecture de métadonnées d'Iceberg, son comportement transactionnel, les comparaisons de formats, les schémas de migration et l'exploitation en production. Le point final porte sur la gouvernance, car la spécification de fichier n'est qu'une partie d'une plateforme de données d'entreprise.
Ce qu'est un format de table ouvert et comment il fonctionne
Imaginez un lac de données brut comme un entrepôt rempli de cartons étiquetés. Les fichiers Parquet sont les cartons, les dossiers des zones de rangement approximatives, et un moteur de requête un employé cherchant les cartons susceptibles de contenir une réponse. Sans inventaire fiable, il peut chercher trop longtemps, manquer des fichiers pertinents ou mélanger des cartons de livraisons incompatibles.
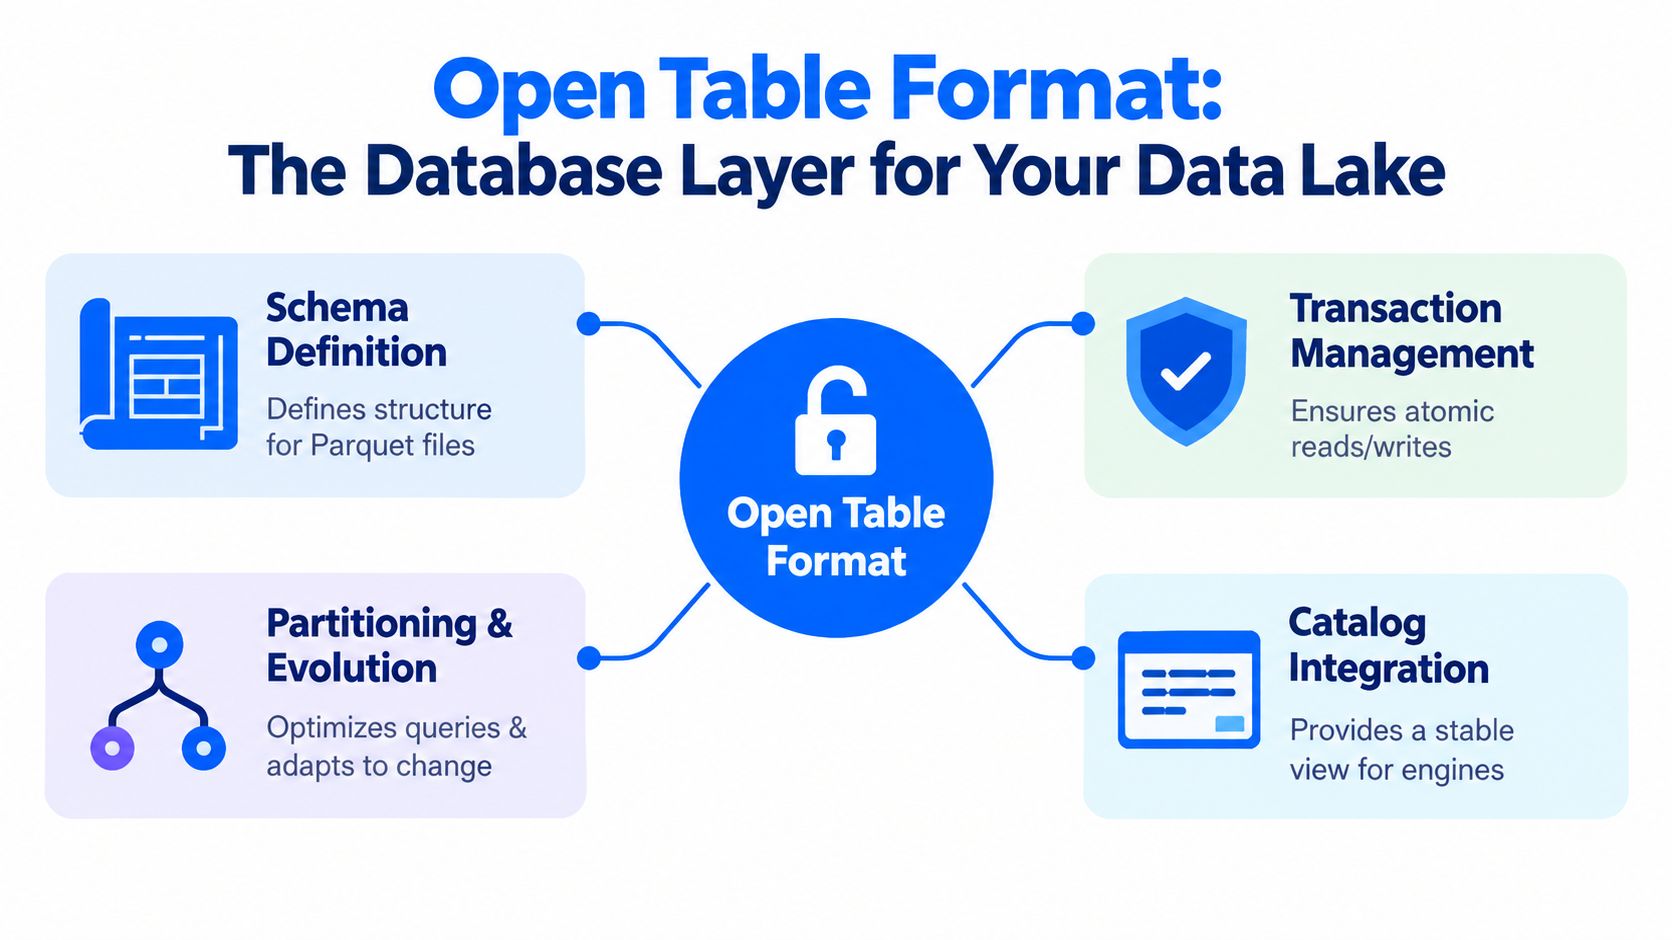
Un format de table ouvert ajoute cet inventaire et un jeu de règles. Il comporte généralement trois couches liées :
Les fichiers de données contiennent les enregistrements réels, souvent dans des formats en colonnes comme Parquet.
Les métadonnées de table décrivent schémas, instantanés, fichiers, statistiques et informations de partition.
Un catalogue donne aux moteurs un moyen stable de trouver les métadonnées courantes et d'appliquer les politiques d'accès.
Cette troisième couche est facile à sous-estimer. Le format définit comment l'état de la table est représenté, tandis que le catalogue définit comment les moteurs localisent cet état. Un job Spark, une pipeline Flink et une requête Trino ne peuvent travailler sur la même table que s'ils peuvent la résoudre via un catalogue compatible et interpréter la version de format concernée.
Des fichiers à une table gérée
Supposons qu'une pipeline reçoive des enregistrements de ventes. Elle écrit des fichiers Parquet dans le stockage objet, mais ne les place pas dans un dossier de date en espérant que chaque lecteur comprenne la disposition. Iceberg consigne les fichiers dans des manifestes, les associe à un instantané de table et publie un nouvel état de métadonnées via le catalogue.
Un lecteur découvre d'abord l'état courant de la table. Il utilise ensuite les métadonnées pour planifier l'analyse, en ne retenant que les fichiers susceptibles de contenir des enregistrements correspondants. C'est différent de demander au moteur de lister chaque objet et d'inspecter chaque fichier.
Le mot ouvert désigne plus que du code open source. Un format de table ouvert vise à fournir une spécification documentée que plusieurs moteurs peuvent implémenter. La spécification d'Iceberg a progressé par versions formelles. La documentation Apache indique que les versions 1, 2 et 3 sont complètes et adoptées par la communauté, tandis que la version 4 reste en développement actif. La documentation mentionne aussi la 1.11.0 comme version de documentation la plus récente en 2026, signe d'un investissement continu dans la spécification et la documentation Iceberg.
L'ouverture réduit la dépendance à un seul moteur, mais n'élimine pas automatiquement les comportements propres à un éditeur. Lecteurs et écrivains ont toujours besoin d'un support de fonctionnalités compatible, et le catalogue peut appliquer ses propres politiques, identifiants ou règles de gouvernance. Cette distinction devient centrale dès que plusieurs moteurs partagent des tables de production.
Au cœur de l'architecture du format de table ouvert Iceberg
L'architecture d'Iceberg se comprend le mieux en partant du catalogue. Le catalogue pointe vers le fichier de métadonnées courant. Ces métadonnées identifient l'instantané actif et relient la table à une ou plusieurs listes de manifestes. Les listes de manifestes pointent vers des fichiers manifestes, et les manifestes décrivent les fichiers de données disponibles pour l'instantané.

Suivre une lecture de table
Une lecture simplifiée ressemble à ceci :
Le moteur demande au catalogue l'emplacement des métadonnées courantes de la table.
Le fichier de métadonnées identifie l'instantané courant.
L'instantané référence une liste de manifestes.
La liste de manifestes identifie des fichiers manifestes.
Le moteur évalue les entrées de manifestes et lit les fichiers de données éligibles.
Les données elles-mêmes restent dans des fichiers tels que Parquet. Pour une explication séparée du format de stockage sous-jacent, ce guide Parquet apporte un contexte utile. L'apport d'Iceberg est l'organisation au niveau table autour de ces fichiers.
Les manifestes stockent les valeurs de partition des fichiers de données. Quand une requête contient un prédicat, le moteur peut le comparer aux tuples de partition et écarter les fichiers qui ne peuvent correspondre. C'est l'élagage piloté par les métadonnées. Le moteur dépense moins d'effort à ouvrir des fichiers inutiles, et la planification ne dépend pas d'une interprétation manuelle des noms de répertoires.
Iceberg prend aussi en charge le partitionnement caché. Un producteur peut écrire un horodatage pendant que la table applique en interne une transformation de partition, par exemple extraire une date ou tronquer une valeur. Producteurs et consommateurs n'ont pas à gérer directement une colonne de partition séparée, ce qui réduit les erreurs dues à des expressions de partition incohérentes.
Pourquoi les instantanés comptent
Chaque écriture crée un nouvel instantané. Un lecteur résout un instantané et planifie contre cet état cohérent, plutôt que d'observer la table pendant que des fichiers sont ajoutés ou retirés. Cette conception soutient l'isolation par instantanés et des changements de table sérialisables et atomiques, si bien que les lecteurs ne voient pas d'écritures partielles ou non validées.
Le modèle d'instantanés permet aussi le voyage dans le temps. Un analyste qui enquête sur un écart de tableau de bord peut interroger un état antérieur de la table, à condition que les instantanés et fichiers concernés soient encore disponibles. L'investigation historique devient plus précise que de s'appuyer sur des extraits copiés ou des dossiers conservés à la main.
La documentation de performance d'Apache Iceberg note que l'architecture de métadonnées peut permettre de lire des tables de plusieurs pétaoctets depuis un seul nœud, sans exiger un moteur SQL distribué rien que pour trier les métadonnées. La même documentation cite des cas produisant une amélioration de performance d'un facteur 10, comme décrit dans la documentation de performance Iceberg. La leçon pratique est que la conception des métadonnées peut peser sur le coût de planification autant que la disposition des fichiers pèse sur le coût d'analyse.
Garanties transactionnelles, évolution du schéma et stratégies de partitionnement
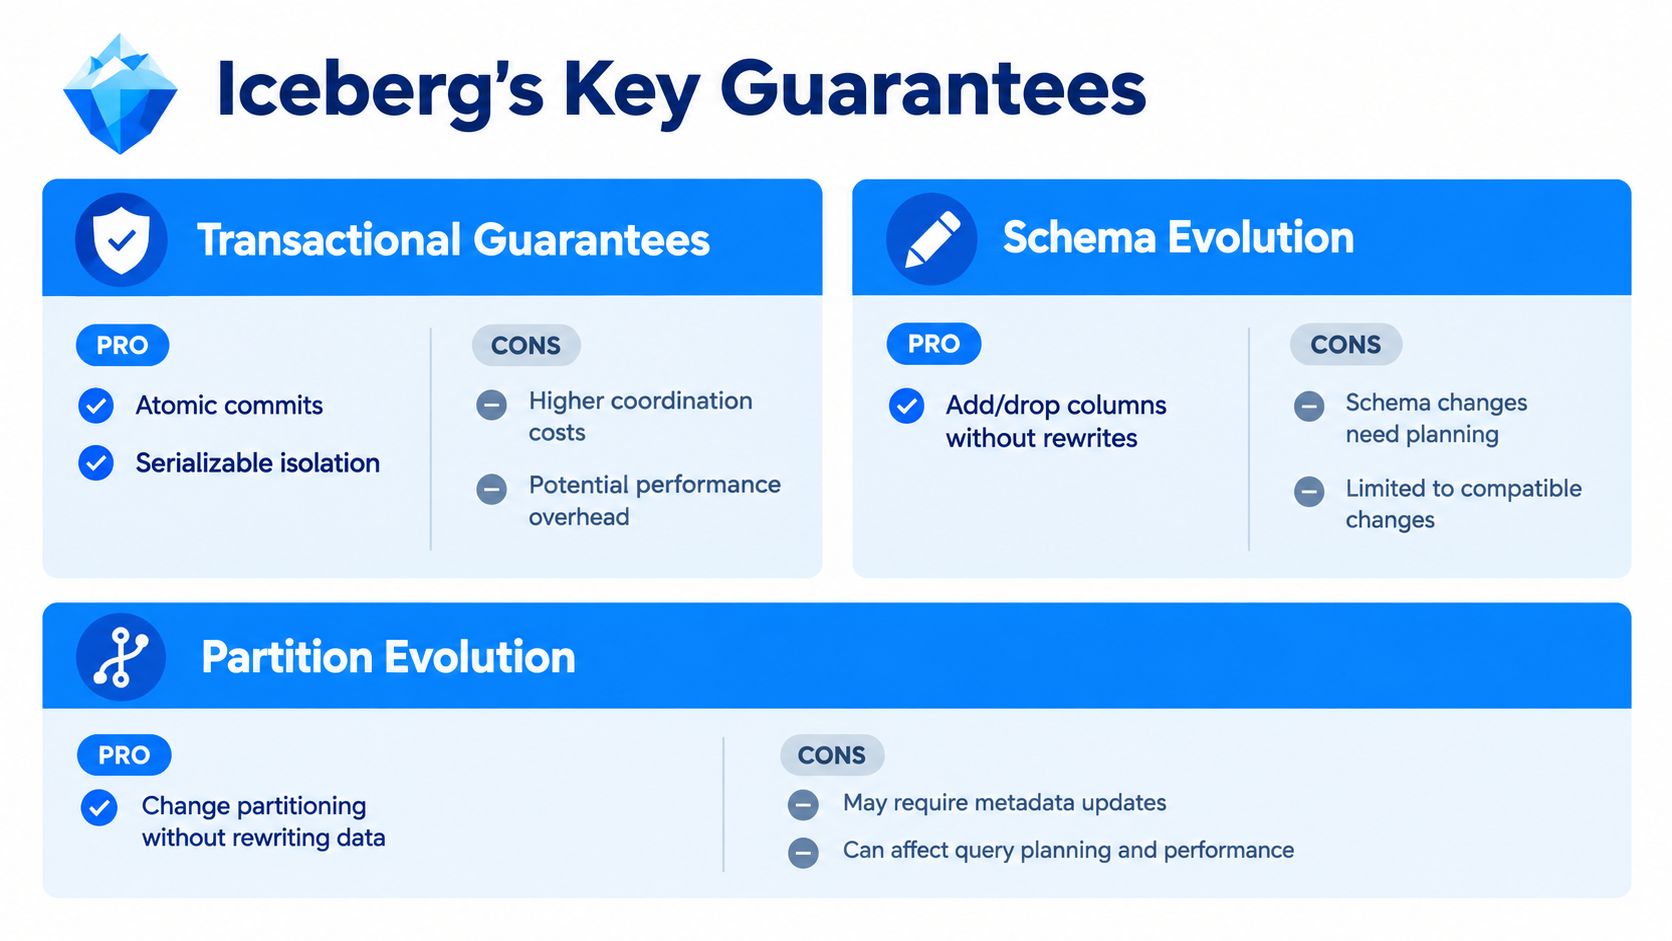
La valeur d'Iceberg apparaît plus clairement quand une table change alors que des personnes et des pipelines continuent de l'utiliser. Un écrivain ne publie pas un état de table à moitié fait. Il prépare un nouvel instantané et valide cet état de façon atomique. Les lecteurs continuent de voir l'instantané validé précédent jusqu'à ce que le nouveau devienne visible.
Cela donne aux équipes l'isolation par instantanés et des changements de table sérialisables. Les écrivains concurrents ont toujours besoin d'une stratégie de conflit, et un commit échoué peut exiger une logique de reprise, mais les lecteurs ne combineront pas par accident une écriture incomplète avec un état plus ancien.
Des changements sans réécriture des données
Iceberg prend en charge des opérations d'évolution de schéma telles qu'ajouter, supprimer, renommer et réordonner des colonnes sans réécrire les fichiers de données existants. Les métadonnées suivent le schéma logique, si bien qu'un renommage de colonne n'implique pas forcément de réécrire physiquement chaque fichier historique.
Cette capacité ne supprime pas le besoin de discipline. Un champ renommé peut encore désorienter des outils en aval qui identifient les colonnes par leur nom, et un champ supprimé peut affecter rapports ou modèles. Les contrôles de compatibilité de schéma et les notifications aux consommateurs restent importants, surtout quand différents moteurs prennent en charge les fonctionnalités du format à des degrés divers. Un système de suivi comme digna Schema Tracker peut se placer à côté de la table et repérer les changements structurels avant qu'ils ne deviennent des incidents en aval.
L'évolution des partitions suit un principe voisin. Iceberg traite un changement de spécification de partition comme une opération de métadonnées. Les anciens fichiers restent dans leur disposition existante, tandis que les nouveaux utilisent la spécification mise à jour. Les équipes peuvent adapter le partitionnement à de nouveaux usages sans réécrire toute la table historique ni la mettre hors service.
Choisir le partitionnement caché avec discernement
Le partitionnement caché est utile quand les équipes veulent une organisation physique sans exposer la mécanique de partition à chaque producteur. Un champ d'horodatage peut soutenir l'élagage par date sans exiger que chaque job d'ingestion renseigne correctement une colonne de partition équivalente.
Il y a un compromis. Après une évolution de partitions, une table peut contenir des fichiers écrits sous des spécifications différentes. Iceberg sait planifier à travers cet historique, mais les exploitants doivent tout de même surveiller si ancienne et nouvelle disposition produisent un comportement d'analyse inégal. Les changements de partition devraient suivre les usages observés, non remplacer la compréhension de la charge.
Suppressions au niveau ligne
Le format Iceberg v2 prend en charge les suppressions au niveau ligne via des fichiers de suppression séparés plutôt que la réécriture de fichiers de données complets. Les suppressions positionnelles identifient une ligne par son chemin de fichier et sa position. Les suppressions par égalité identifient des lignes par correspondance de valeurs de colonnes, ce qui peut soutenir des flux de mise à jour et de suppression avec une amplification d'écriture moindre, comme le décrit cette explication des suppressions au niveau ligne dans Iceberg.
Les fichiers de suppression introduisent des considérations de maintenance. Les requêtes peuvent devoir fusionner données de base et informations de suppression, et des opérations de compaction ou de réécriture peuvent ensuite consolider la disposition. Le format réduit la charge immédiate de réécriture, mais n'élimine pas la gestion du cycle de vie.
Comparer Iceberg, Delta Lake et Hudi pour votre lakehouse
Iceberg, Delta Lake et Hudi traitent tous l'écart entre des fichiers de données non gérés et un comportement de table digne d'une base de données. Le bon choix dépend de la charge, des moteurs, de la stratégie de catalogue et des services d'exploitation que votre équipe est prête à faire tourner.
Critères | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Adéquation principale | Tables analytiques multi-moteurs et interopérabilité ouverte | Fort alignement avec l'écosystème Databricks | Charges lakehouse riches en mises à jour et orientées streaming |
Modèle de métadonnées | Architecture instantané, liste de manifestes et manifeste | Conception centrée sur un journal de transactions | Conception orientée chronologie et services de table |
Évolution du schéma | Prend en charge ajout, suppression, renommage et réordonnancement | Prend en charge l'évolution du schéma, avec un comportement dépendant du runtime et des fonctionnalités | Prend en charge de larges capacités d'évolution du schéma |
Stratégie de partition | Partitionnement caché et évolution de partitions par métadonnées seules | La gestion des partitions dépend de la configuration de table et de plateforme | Utilise partitionnement, clustering et services de table |
Changements de lignes | Fichiers de suppression v2, positionnels et par égalité | Mises à jour et suppressions via les opérations Delta | Fort soutien des upserts, suppressions et flux incrémentaux |
Choix du moteur | Conçu pour une large interopérabilité entre moteurs | Particulièrement naturel au sein des déploiements Databricks | Forte intégration Spark et streaming, avec un soutien plus large de l'écosystème |
Question du catalogue | Le catalogue est central pour la découverte et la gouvernance | Catalogue et services de plateforme influencent fortement l'ouverture | Le catalogue peut être moins central pour l'exploitation de base, mais la gouvernance exige toujours des services autour |
Ces descriptions sont une orientation architecturale, non un benchmark universel. La vitesse des requêtes dépend de la taille des fichiers, de la distribution des données, de l'ordre de tri, de la compaction, des versions de moteurs, de la forme de la charge et de l'implémentation du catalogue. Une équipe plateforme devrait tester des lectures et écritures représentatives plutôt que de choisir sur des cases à cocher.
Aligner le format sur le modèle d'exploitation
Choisissez Iceberg quand plusieurs moteurs doivent partager des tables et que l'équipe valorise une couche de table largement spécifiée, avec partitionnement caché et évolution indépendante. Choisissez Delta Lake quand une intégration profonde à Databricks, des services natifs de plateforme et un modèle d'exploitation unifié pèsent plus que le besoin de neutralité de catalogue.
Hudi mérite considération quand mises à jour fréquentes, capture de changements, traitement incrémental ou ingestion en streaming dictent la conception. Son approche inclut des capacités de moteur de stockage et de gestion de tables qui peuvent façonner la manière dont la plateforme gère indexation, compaction et ingestion.
La question la plus importante se situe souvent hors de la spécification de fichier. Une équipe de gouvernance a besoin d'un endroit unique pour gérer espaces de noms, propriété, classification, permissions et historique d'audit. Iceberg fournit transactions de table et métadonnées, mais n'offre pas à lui seul un système de politiques complet entre moteurs. Les équipes évaluant Iceberg aux côtés de charges Databricks peuvent aussi passer en revue les considérations de qualité des données sur Databricks, notamment là où contrôles de plateforme et processus de fiabilité se rejoignent.
Intégrations de l'écosystème, schémas de migration et exemples de flux
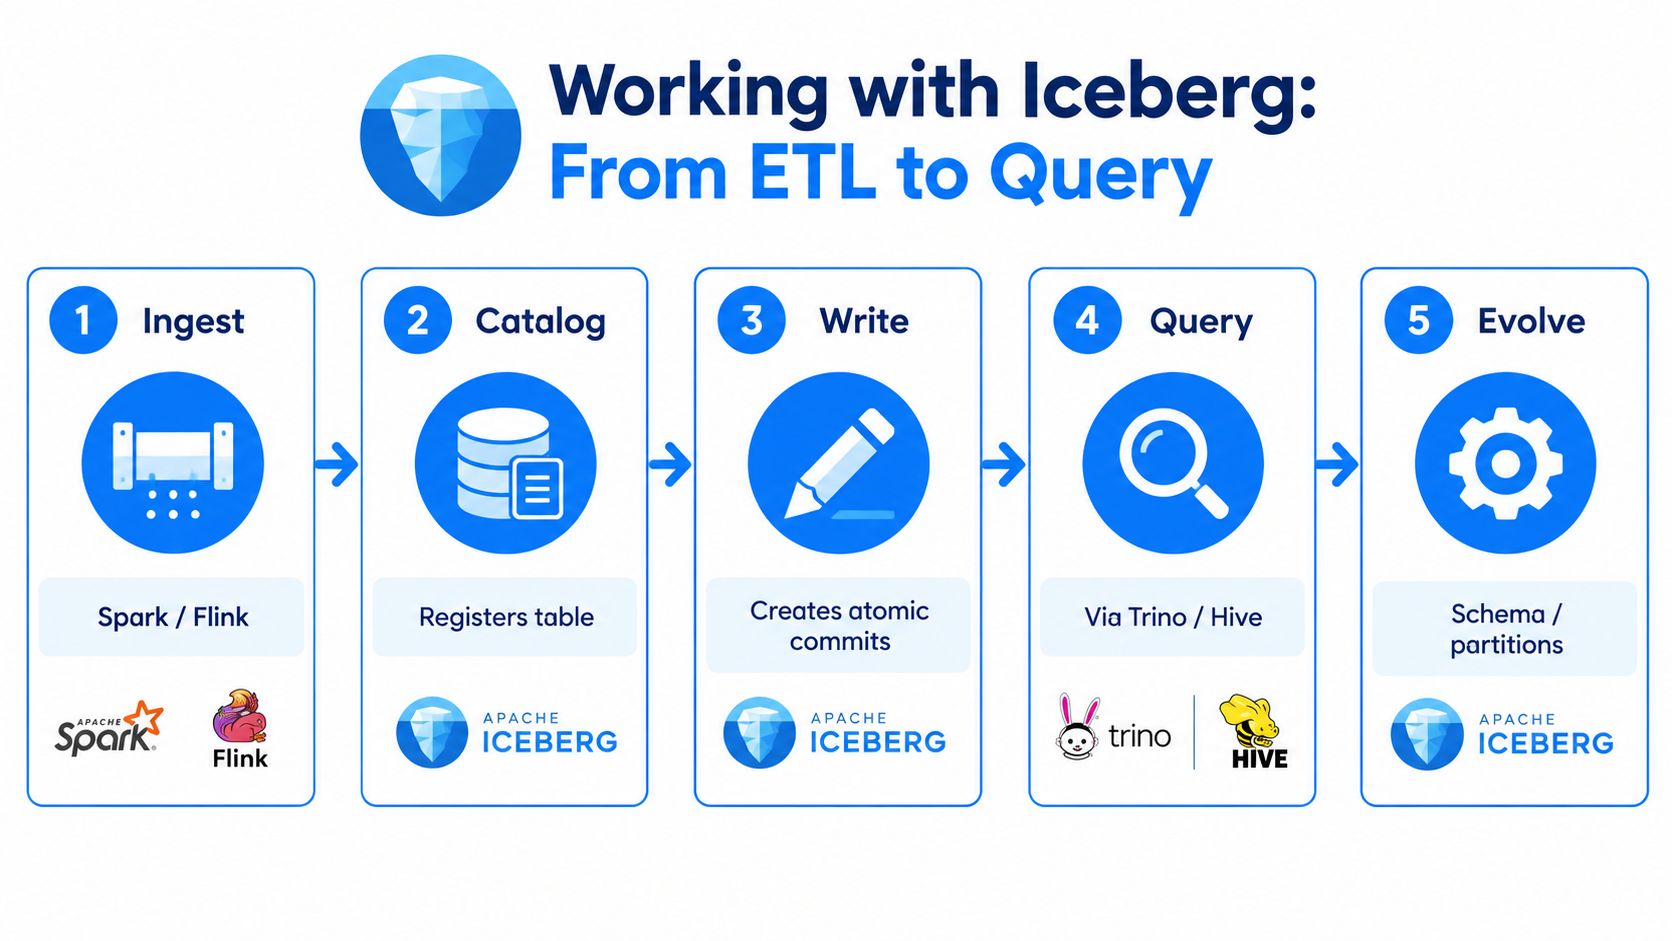
Iceberg s'insère dans un lakehouse par deux interfaces : le stockage et le catalogue. Spark ou Flink peuvent produire les données, Trino ou Hive les interroger, et le stockage objet héberger les fichiers. Le catalogue relie ces activités à une identité de table unique et expose les métadonnées dont chaque moteur compatible a besoin.
Un flux représentatif ressemble à ceci :
Ingestion : Spark ou Flink reçoit des enregistrements en lot ou en streaming.
Catalogue : la table est enregistrée via un catalogue tel que Hive Metastore, AWS Glue Catalog ou un catalogue REST Iceberg.
Écriture : le moteur crée des fichiers de données et publie un instantané atomique.
Requête : Trino, Hive, Spark ou un autre moteur compatible résout la table via le catalogue.
Évolution : la personne responsable modifie le schéma ou la spécification de partition à mesure que la charge évolue.
La syntaxe exacte varie selon le moteur, mais les concepts restent stables. Un flux SQL pourrait créer une table avec un schéma explicite, insérer des enregistrements, modifier une colonne et interroger un instantané antérieur. Un job Spark pourrait utiliser l'interface DataFrameWriterV2 d'Iceberg, tandis que Flink emploie son sink Iceberg et sa configuration de catalogue.
Migrer sans perdre le contrôle
Une migration de Hive vers Iceberg peut suivre plusieurs voies. Les équipes peuvent convertir les données existantes et les enregistrer via les métadonnées Iceberg, ou réécrire les fichiers pour améliorer la disposition, normaliser les schémas et supprimer les hypothèses de partition héritées. La conversion de métadonnées peut réduire les perturbations, tandis qu'une réécriture offre l'occasion d'optimiser les fichiers. Le choix dépend de l'état de la table existante et de la tolérance au travail de migration.
Une migration de Delta vers Iceberg exige le même soin, avec une attention accrue à l'historique de transactions, aux fonctionnalités non prises en charge, aux suppressions, aux colonnes générées et aux dépendances en aval. Un plan de migration devrait inventorier lecteurs et écrivains avant de changer la propriété de la table. Le guide de planification des migrations de données peut aider à organiser dépendances, validation et décisions de déploiement.
L'observabilité autour de la table
Les instantanés d'Iceberg vous disent quel état de table a été validé. Ils ne disent pas si une source a livré les enregistrements attendus, si les valeurs métier sont plausibles, ou si un indicateur clé de tableau de bord est sorti de son comportement normal. Ces contrôles relèvent du système de fiabilité environnant.
Par exemple, une équipe peut valider des règles d'enregistrement après un commit d'instantané, suivre l'heure d'arrivée de chaque chargement attendu, comparer les indicateurs courants au comportement historique et signaler des changements de schéma avant que les modèles BI ne tombent. Les contrôles peuvent s'exécuter sur la table en place, sans copier les données sous-jacentes dans un magasin de supervision séparé.
Bonnes pratiques, réglage des performances et diagnostic en production
L'exploitation d'Iceberg en production consiste à garder métadonnées, fichiers, instantanés et politiques en bonne santé ensemble. Une table peut rester transactionnellement correcte tout en devenant coûteuse à interroger parce qu'elle contient trop de petits fichiers, des instantanés périmés ou des dispositions qui se chevauchent issues de plusieurs spécifications de partition.
Commencez par la gestion des fichiers. Surveillez la création de petits fichiers, compactez les fichiers compatibles et choisissez des réglages d'écriture produisant des tailles praticables pour les moteurs servant la table. La compaction doit suivre les observations de la charge. Une table utilisée pour des lectures incrémentales fréquentes peut réclamer un autre rythme de maintenance qu'une table servant des analyses occasionnelles.
Les métadonnées méritent leur propre supervision. Suivez la croissance des manifestes, la latence de planification, l'accumulation d'instantanés et les schémas de commits en échec. Expirez les instantanés selon les exigences de reprise et d'audit, puis nettoyez les fichiers orphelins seulement après avoir confirmé qu'aucun instantané actif ni processus externe n'en dépend encore.
Règle d'exploitation : la maintenance n'est pas du ménage. Elle fait partie de la conception de requête et de reprise de la table.
Le diagnostic devient plus systématique quand les symptômes se rattachent à des couches :
Planification lente : inspectez le nombre de manifestes, la croissance des métadonnées et le temps de réponse du catalogue avant d'accuser le moteur.
Analyses lentes : vérifiez l'efficacité de l'élagage, la taille des fichiers, la distribution des données et si des spécifications de partition évoluées créent des dispositions inégales.
Enregistrements manquants : comparez la fenêtre d'ingestion attendue à l'instantané validé et validez la livraison source séparément.
Échecs de schéma : identifiez l'écrivain qui a changé le schéma, puis vérifiez la compatibilité des lecteurs et les hypothèses en aval.
Conflits de commit : examinez les écrivains concurrents, le comportement de reprise et les jobs de maintenance qui peuvent se disputer la même table.
Croissance inattendue du stockage : examinez instantanés conservés, fichiers de suppression, écritures échouées et fichiers de données orphelins.
Les montées de version du format demandent un plan de déploiement. Les changements de version Iceberg se font table par table sur décision, si bien que des tables anciennes peuvent coexister avec des plus récentes. L'enquête 2025 sur l'écosystème Apache Iceberg rapporte que 78,6 % des répondants utilisent Iceberg exclusivement parmi les formats de table ouverts, tandis qu'une étude d'entreprise indépendante indique 58 % utilisant Iceberg pour l'analytique critique, 95 % l'utilisant ou prévoyant de l'utiliser pour l'IA et le ML, et 79 % migrant ou prévoyant de migrer le reste de leurs données vers Iceberg sous douze mois. Ces chiffres proviennent du résumé de l'enquête State of the Apache Iceberg Ecosystem 2025, et signalent une dynamique, non la preuve que chaque organisation a réglé l'exploitation en versions mixtes.
Le prochain sujet de planification est Iceberg v3, avec des capacités telles que la traçabilité des lignes, les vecteurs de suppression et de nouveaux types logiques. Testez lecteurs et écrivains ensemble, définissez des seuils de compatibilité et mettez à jour des tables représentatives avant un déploiement large. Le format a beau être ouvert, un parc peut accumuler une dette de fiabilité invisible si catalogues, moteurs et politiques de gouvernance avancent à des rythmes différents.
Le catalogue mérite le même soin. Iceberg apporte comportement ACID, évolution du schéma et voyage dans le temps, tandis que lignage, classification, contrôle d'accès et pistes d'audit unifiées dépendent du catalogue et de la pile de gouvernance. Databricks a annoncé Managed Iceberg, Iceberg v3 et Foreign Iceberg en disponibilité générale dans Unity Catalog le 28 mai 2026, tandis que Snowflake a intégré Polaris dans Horizon Catalog pour l'interopérabilité REST d'Iceberg, comme le décrivent les documents de spécification Apache Iceberg. Ces mouvements de l'écosystème renforcent la décision centrale : l'ouverture entre moteurs ne dépend pas seulement des fichiers de table, mais aussi de qui contrôle l'accès aux métadonnées et l'application des politiques.
digna s'exécute dans votre propre environnement et combine suivi de schéma, surveillance de la Timeliness, validation en base, détection d'anomalies et observabilité de plateforme autour des tables et pipelines critiques. Rendez-vous sur digna pour voir comment votre équipe peut surveiller une analytique fondée sur Iceberg sans déplacer les données de production.
La plupart des incidents Iceberg en production se révèlent être des problèmes de valeurs déguisés en métadonnées : prévoyez donc la gestion de la qualité des données en parallèle de la migration.
Questions fréquentes
Quel problème Iceberg résout-il ?
Il empêche des moteurs différents de diverger sur le contenu d'une table. Sans format de table, un moteur peut lire un répertoire avant qu'un lot soit pleinement validé, un autre interpréter une partition différemment, et un troisième voir encore un schéma plus ancien, alors que chaque fichier impliqué est parfaitement valide.
Comment une table Iceberg est-elle structurée ?
Iceberg tient une chaîne de métadonnées : une entrée de catalogue pointe vers un fichier de métadonnées décrivant l'instantané courant, cet instantané pointe vers une liste de manifestes, et les manifestes énumèrent les fichiers de données avec leurs statistiques. Chaque commit écrit de nouvelles métadonnées plutôt que de modifier les anciennes, ce qui rend le retour arrière peu coûteux.
Iceberg prend-il en charge les écrivains concurrents ?
Oui, par concurrence optimiste. Chaque écrivain prépare ses changements puis tente d'échanger le pointeur de métadonnées de la table ; si un autre commit est arrivé avant, il réessaie contre le nouvel état. Les écritures en conflit sur les mêmes fichiers échouent bruyamment au lieu de s'écraser en silence.
Quels moteurs fonctionnent avec Iceberg ?
Spark, Trino, Flink, Dremio, Snowflake et BigQuery, entre autres, lisent Iceberg, même si la couverture fonctionnelle diffère : certains moteurs lisent sans écrire, et les capacités récentes arrivent de façon inégale. Vérifiez que les opérations précises dont vous avez besoin sont prises en charge par chaque moteur de votre pile, pas seulement par celui avec lequel vous testez.
Qu'est-ce qui tourne mal avec Iceberg en production ?
Les petits fichiers et les instantanés non expirés, dans cet ordre. Le streaming ou des écritures par lots fréquentes produisent beaucoup de petits fichiers et une longue chaîne de métadonnées, ce qui ralentit la planification jusqu'à ce que compaction et expiration tournent régulièrement. Ni l'un ni l'autre ne dégrade l'exactitude, si bien que le symptôme apparaît comme une latence de requête qui grimpe peu à peu.



