Format de table ouvert : le guide complet 2026
|
8
minute de lecture

Apache Iceberg est utilisé par 58 % des organisations pour l'analytique critique, tandis que 95 % l'utilisent ou prévoient de l'utiliser pour des charges d'IA et d'apprentissage automatique. Un format de table ouvert est une couche de spécification posée sur des fichiers en colonnes, qui donne aux moteurs une vue unique et versionnée des fichiers, du schéma et des partitions d'une table, afin que différents outils lisent et écrivent les mêmes données avec des garanties transactionnelles.
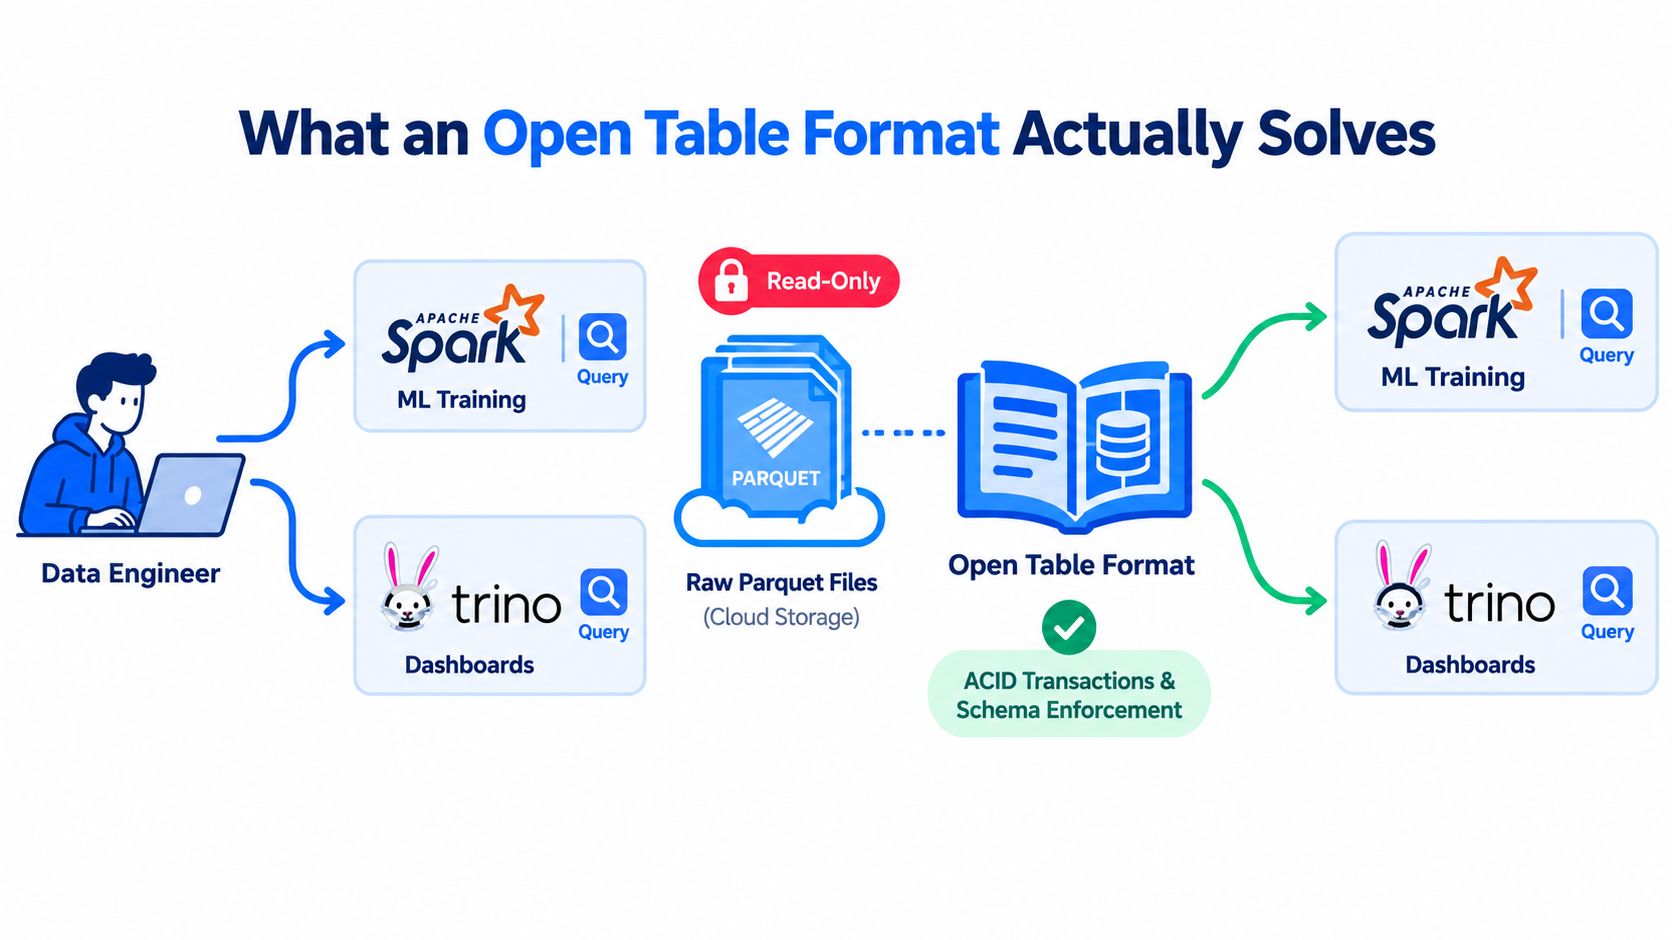
Vous êtes peut-être déjà au cœur de ce problème. Un jeu de données de ventes réside dans le stockage objet en tant que fichiers Parquet. Spark en a besoin pour l'entraînement de modèles, Trino pour les tableaux de bord, et un pipeline écrit encore de nouvelles partitions pendant que les analystes interrogent les données de la veille. Les fichiers sont peu coûteux et lisibles, mais la table elle-même n'a aucun contrat partagé fiable tant que vous n'en ajoutez pas un.
Ce contrat, c'est le format de table ouvert. Il ne remplace ni Parquet ni vos moteurs de requête. Il ajoute les métadonnées, la gestion des transactions, les règles de schéma et l'historique de table nécessaires pour qu'un stockage analytique fondé sur des fichiers se comporte comme une table gérée.
Table des matières
Ce qu'un format de table ouvert résout réellement
Le contrat manquant
Ce qu'il ne résout pas
Les concepts clés derrière la spécification
Les métadonnées transactionnelles comme index maître
Le partitionnement comme règle de regroupement du catalogue
L'évolution de schéma comme historique du catalogue
Les snapshots comme éditions à un instant donné
Comment Iceberg, Delta Lake et Hudi abordent le même problème
Bénéfices, compromis et choix guidé par la charge de travail
Où les bénéfices apparaissent
Où les compromis demeurent
Bonnes pratiques pour exploiter les formats de table ouverts à l'échelle de l'entreprise
Traiter le catalogue comme une infrastructure de production
Faire en sorte que le partitionnement réponde à de vraies questions
Poser des limites aux snapshots
Émettre des signaux opérationnels au moment de l'écriture
Observabilité et schémas d'intégration pour les lakehouses en production
Quatre signaux à relier
Détails d'intégration et de déploiement
Déploiement et exploitation en environnements réglementés
Contrôles à trancher avant la production
Une liste de contrôle concrète avant de standardiser un format
Ce qu'un format de table ouvert résout réellement
Une ingénieure de données peut déposer des données de ventes partitionnées dans le stockage objet et pointer Spark vers le répertoire. Trino peut souvent lire les mêmes fichiers Parquet. La première requête peut fonctionner, mais le modèle d'exploitation devient fragile dès que plusieurs écrivains, des schémas changeants et des lecteurs concurrents entrent en scène.
Les fichiers bruts n'indiquent pas à chaque moteur quels fichiers appartiennent à la table logique. Un nom de répertoire peut suggérer une identité de table, mais il n'enregistre pas de façon fiable si un fichier est courant, remplacé, incomplet ou créé par un processus étranger. Les dossiers de partition ne fournissent pas non plus d'historique universel des changements d'agencement de la table.
Le contrat manquant
Un format de table ouvert se place à côté des fichiers de données et consigne les informations sur lesquelles les moteurs doivent s'accorder :
Identité de la table : la table logique possède une définition stable, indépendante d'un moteur particulier ou d'un parcours de répertoire.
Inventaire des fichiers : les métadonnées identifient les fichiers de données qui appartiennent à la table et ceux qui ne doivent plus être lus.
Agencement des partitions : la table consigne l'organisation des lignes, ce qui permet aux moteurs d'écarter les données non pertinentes.
Historique de schéma : les ajouts, suppressions, renommages et changements compatibles de colonnes deviennent partie intégrante de la définition gérée de la table.
Snapshots atomiques : les lecteurs peuvent choisir une version cohérente pendant qu'un écrivain valide une nouvelle version.
Le résultat est une spécification partagée. Spark peut utiliser la table pour la préparation ML, Trino peut servir du SQL interactif, et les deux résolvent le même état logique au lieu de le deviner séparément à partir d'une arborescence.
Ce qu'il ne résout pas
Un format de table ouvert ne crée pas automatiquement de bons modèles de données, des partitions pertinentes, des requêtes rapides ou des valeurs métier fiables. Il peut protéger la cohérence au niveau de la table, mais les équipes doivent toujours décider comment les données sont écrites, validées, compactées, gouvernées et surveillées.
Cette distinction évite une erreur d'architecture fréquente. Le format est la fondation sous le modèle d'exploitation, pas le modèle d'exploitation lui-même.
Les concepts clés derrière la spécification
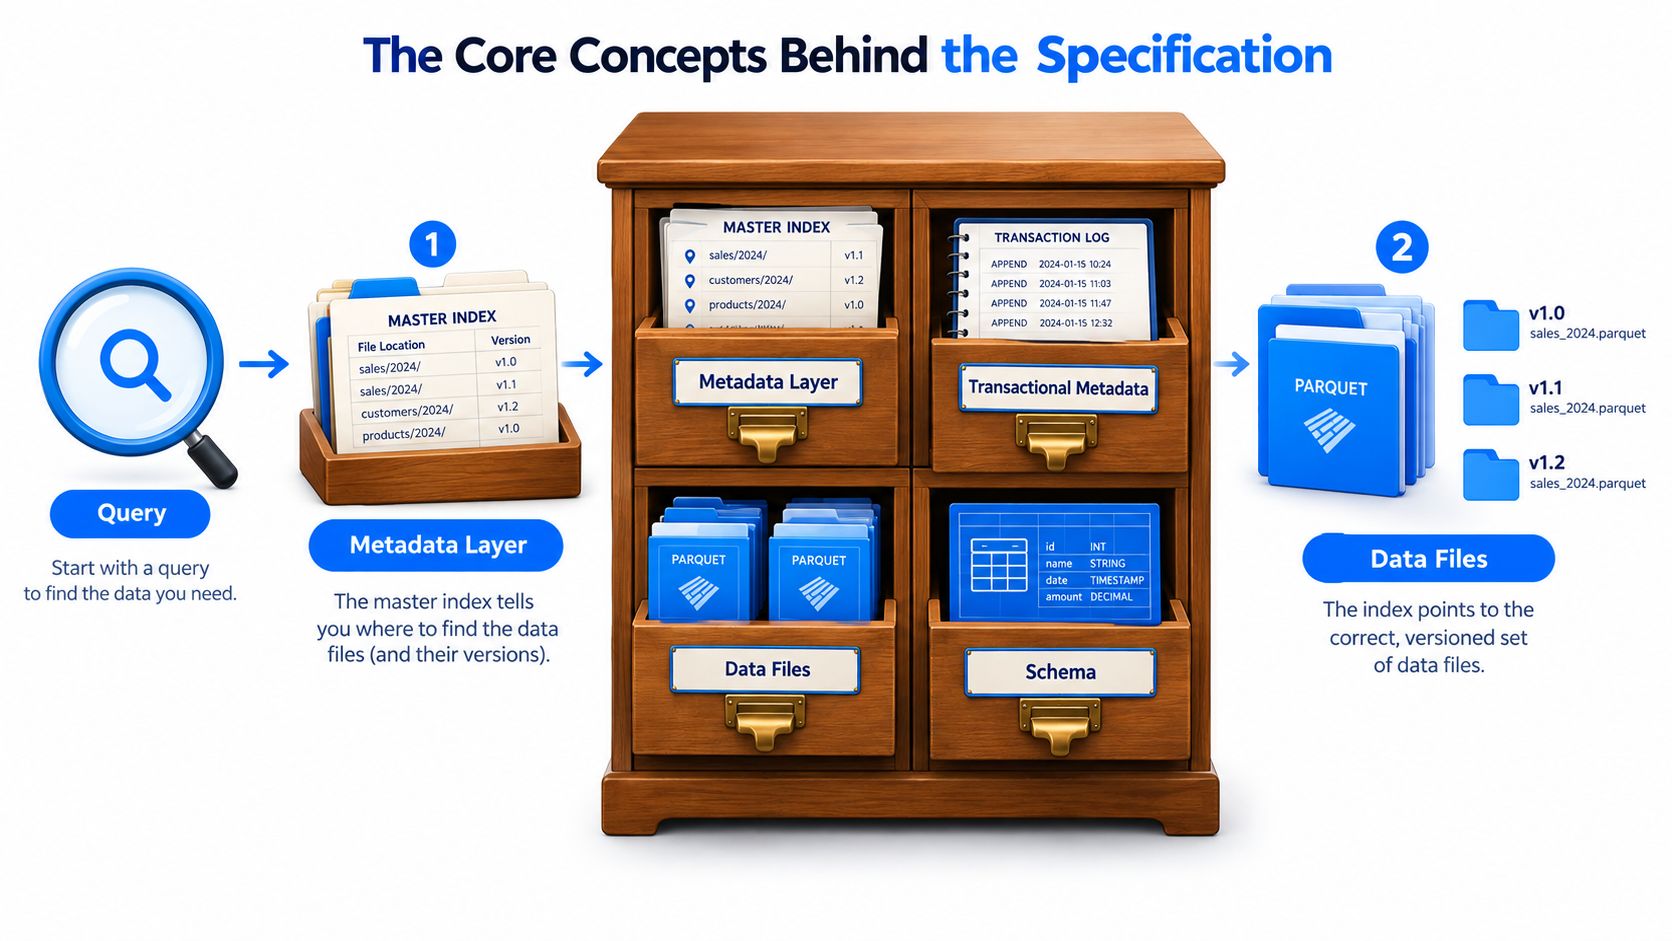
Un fichier de bibliothèque rend la couche de métadonnées plus concrète. Les livres sont vos fichiers de données Parquet. Le fichier est la spécification de la table. Le lecteur consulte d'abord les fiches, puis se dirige vers les rayons contenant les ouvrages demandés.
Les métadonnées transactionnelles comme index maître
La couche de métadonnées consigne quels fichiers appartiennent à la table et comment ces fichiers se rattachent à un snapshot. Plutôt que de demander à Spark ou Trino d'inspecter chaque chemin du stockage objet, le moteur suit l'index géré de la table.
Imaginez une fiche indiquant : « Ces rayons contiennent l'édition courante de la collection des ventes. » Si un écrivain remplace d'anciens fichiers par des fichiers fraîchement compactés, le catalogue change l'inventaire actif en un seul commit. Les lecteurs n'ont pas à deviner s'ils ont vu une mise à jour complète.
C'est là l'utilité concrète de la gestion des métadonnées. Les métadonnées ne sont pas une documentation décorative. Elles guident la planification, soutiennent des lectures cohérentes et donnent aux exploitants une trace de l'évolution de la table.
Le partitionnement comme règle de regroupement du catalogue
Une règle de partition regroupe les données apparentées afin qu'un moteur évite de scanner des fichiers sans rapport. Si les données de ventes sont organisées selon un motif d'accès temporel ou régional, une requête dotée d'un filtre correspondant peut restreindre son périmètre de scan.
La règle doit correspondre à des charges réelles. Une conception de partitions qui reflète la façon dont les tableaux de bord filtrent peut réduire les lectures inutiles, tandis qu'une conception fondée sur un attribut inadapté ou trop granulaire peut créer une surcharge d'exploitation et de nombreux petits fichiers.
L'évolution de schéma comme historique du catalogue
Un schéma est la description, par le catalogue, de ce que contient chaque livre. Quand un pipeline ajoute une colonne, en renomme une ou change un type, le format de table peut consigner ce changement au lieu de laisser chaque moteur le découvrir seul.
Cet historique compte lorsque anciens et nouveaux fichiers coexistent. Un lecteur a besoin de règles pour interpréter les deux versions, et un pipeline a besoin d'un mode d'échec clair quand un changement est incompatible. L'évolution de schéma réduit les désaccords silencieux, mais elle ne décide pas si une nouvelle colonne est sémantiquement correcte.
Les snapshots comme éditions à un instant donné
Un snapshot est une version cohérente de la table. Il relie les métadonnées de la table à l'ensemble des fichiers de données que les lecteurs doivent utiliser à cet instant. La documentation d'Apache Iceberg décrit le voyage dans le temps comme un moyen d'exécuter des requêtes reproductibles sur un snapshot précis, tandis que sa spécification stocke les snapshots dans le JSON de métadonnées de la table, plutôt que comme des objets sérialisés distincts. Voir la documentation Apache Iceberg et la spécification Iceberg pour le modèle sous-jacent.
Ensemble, ces quatre concepts permettent à Spark et Trino de travailler à partir de la même collection cataloguée. Un moteur peut écrire une nouvelle édition pendant qu'un autre lit une édition antérieure stable, selon le comportement transactionnel du format et de l'implémentation du catalogue.
Comment Iceberg, Delta Lake et Hudi abordent le même problème
Apache Iceberg, Delta Lake et Apache Hudi ajoutent tous la gestion de tables au stockage analytique fondé sur des fichiers, mais leur histoire de conception influence leur usage. Iceberg a démarré chez Netflix en 2017, a été donné à l'Apache Software Foundation en 2018 et est devenu projet Apache de premier plan en mai 2020. Sa conception met l'accent sur des métadonnées de table neutres vis-à-vis du moteur et sur une large interopérabilité avec des systèmes comme Spark, Trino, Flink, Hive et Impala, comme le décrit le projet Apache Iceberg.
Delta Lake utilise des fichiers de données Parquet aux côtés d'un journal de transactions dans le répertoire _delta_log. Le journal contient des enregistrements JSON ordonnés et des checkpoints Parquet périodiques, et un snapshot de table s'obtient en lisant le journal jusqu'à une version choisie, selon l'article de recherche sur Delta Lake. Ce modèle fait du journal de transactions l'autorité centrale sur l'état de la table.
Hudi est particulièrement associé à l'ingestion incrémentale, aux upserts, aux suppressions et aux pipelines de données quasi temps réel. Ses approches copy-on-write et merge-on-read traduisent des compromis différents entre simplicité de lecture et comportement d'écriture ou d'ingestion. Hudi met aussi davantage l'accent sur les schémas d'indexation au niveau des enregistrements pour orienter les mises à jour.
Dimension | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Centre de gravité | Tables analytiques neutres vis-à-vis du moteur et métadonnées portables | Tables Parquet transactionnelles centrées sur un journal ordonné | Écritures incrémentales, upserts, suppressions et ingestion en streaming |
État de la table | Les métadonnées pointent vers des snapshots, manifestes et fichiers de données |
| La chronologie et les structures de métadonnées suivent les commits et les groupes de fichiers |
Partitionnement | Prend en charge l'évolution de l'agencement des partitions à mesure que changent les motifs de requête | Utilise des données partitionnées avec des options d'optimisation propres au moteur | Utilise le partitionnement avec l'indexation et le choix du mode d'écriture |
Évolution de schéma | Gérée via les métadonnées de table et les identifiants de schéma | Gérée via les règles de table et du journal de transactions | Gérée via les métadonnées de table et la configuration de l'écrivain |
Isolation par snapshot | Les lecteurs résolvent un snapshot de métadonnées cohérent | Les lecteurs résolvent une version de table depuis le journal de transactions | Les lecteurs utilisent la chronologie Hudi et l'état de commit choisi |
Force typique | Accès analytique multi-moteurs | Flux de lakehouse transactionnel centrés sur Databricks | Changements incrémentaux fréquents et ingestion au niveau des enregistrements |
Accent opérationnel | Catalogue, manifestes, planification et entretien des métadonnées | Rétention du journal, checkpoints, compactage et intégration de plateforme | Compactage, indexation, clustering et gestion des modes d'écriture |
La comparaison n'est pas une liste de fonctionnalités. C'est un indice sur le style d'exploitation. Iceberg convient souvent à une plateforme où plusieurs moteurs doivent partager des tables. Delta peut être le choix naturel quand les flux orientés Databricks et Spark dominent. Hudi mérite un examen attentif quand les upserts continus et le traitement incrémental comptent plus qu'une large interopérabilité en lecture.
Quel que soit votre choix, la qualité des données reste une responsabilité distincte. Une plateforme peut gérer les commits et les règles de schéma tout en acceptant des valeurs incorrectes, aussi les pratiques de qualité des données sur Databricks relèvent-elles de la revue d'architecture plutôt que de l'après-déploiement.
Bénéfices, compromis et choix guidé par la charge de travail
Le choix du format devrait partir de la charge de travail, non d'une préférence universelle. Dans une comparaison de type TPC-DS, Iceberg et Delta étaient proches sur plusieurs requêtes à forte lecture tandis que Hudi était plus lent sur les mêmes charges. La requête interactive 19 s'est exécutée en 1,45 seconde sur Iceberg, 1,38 seconde sur Delta et 2,92 secondes sur Hudi, tandis que la requête de reporting 27 a pris 8,70 secondes sur Iceberg, 8,45 secondes sur Delta et 12,10 secondes sur Hudi. Pour l'analytique approfondie, la requête 64 a pris 184,20 secondes sur Iceberg, 181,90 secondes sur Delta et 210,50 secondes sur Hudi, d'après ce benchmark des formats de table ouverts.
Ces résultats n'établissent pas de vainqueur permanent. Ils montrent pourquoi des tableaux de bord, jointures, filtres, écritures et opérations de maintenance représentatifs comptent davantage qu'un chiffre de benchmark isolé.
Motif de charge de travail | Format recommandé | Facteur décisif |
|---|---|---|
Upserts fréquents en streaming et changements incrémentaux | Apache Hudi | Comportement d'ingestion au niveau des enregistrements, gestion des mises à jour et choix entre merge-on-read et copy-on-write |
Lectures analytiques multi-moteurs | Apache Iceberg | Portabilité entre moteurs et intégration au catalogue |
Flux de lakehouse centrés sur Databricks | Delta Lake | Intégration du journal de transactions et alignement étroit avec la plateforme |
BI interactive et tableaux de bord SQL | Iceberg ou Delta après tests | Efficacité du chemin de lecture, coût de planification et comportement réel des tableaux de bord |
Jeux de données IA et ML partagés entre outils | Dépend de la charge de travail | Compatibilité des moteurs, gouvernance, reproductibilité et motifs d'accès à l'entraînement |
Où les bénéfices apparaissent
L'interopérabilité permet aux équipes d'exploiter un seul jeu de données gouverné depuis plusieurs moteurs au lieu de maintenir des copies pour chaque consommateur. Les commits transactionnels protègent les lecteurs des écritures partielles et aident les pipelines à publier des états de table complets. Les métadonnées de catalogue soutiennent les permissions, la découvrabilité, le lignage et les flux d'audit lorsque le catalogue est traité comme un véritable service de plateforme.
Les tables ouvertes peuvent aussi soutenir la préparation à l'IA. Les pipelines d'entraînement en profitent quand les états historiques sont reproductibles et quand les mêmes données gouvernées sont disponibles pour la préparation, l'évaluation et les charges analytiques.
Où les compromis demeurent
La dépendance au catalogue crée un mode de défaillance réel. Si le catalogue ou le service de métadonnées est indisponible, les lectures et écritures peuvent s'arrêter même si les fichiers sous-jacents restent dans le stockage objet. Les transactions inter-tables et le comportement des clés étrangères n'équivalent pas à ceux d'une base relationnelle classique, et les publications récentes soulignent que les garanties ACID se limitent généralement à des tables individuelles.
L'exploitation se poursuit aussi après la première écriture réussie. Compactage, expiration des snapshots, nettoyage des fichiers orphelins, entretien des partitions et revue de schéma exigent tous un responsable. Le format réduit l'ambiguïté, mais il ne supprime pas le travail de plateforme et n'impose pas l'exactitude métier.
Bonnes pratiques pour exploiter les formats de table ouverts à l'échelle de l'entreprise
La spécification vous donne un vocabulaire fiable pour l'état de la table. Elle ne fournit pas la discipline d'exploitation nécessaire pour maintenir cet état en bonne santé. Quatre pratiques méritent un responsable explicite avant l'arrivée des charges de production.
Traiter le catalogue comme une infrastructure de production
Le metastore, le catalogue REST ou le catalogue de gouvernance unifiée est un plan de contrôle. Donnez-lui des objectifs de disponibilité, des revues d'accès, des pistes d'audit, des procédures de sauvegarde et un runbook d'incident. Une table peut vivre dans le stockage objet, mais les moteurs dépendent toujours du catalogue pour résoudre son identité, ses métadonnées, ses permissions et son état courant.
Règle pratique : si une panne de catalogue arrêtait le travail analytique, surveillez-le et rétablissez-le comme un plan de contrôle de base de données, pas comme un fichier de configuration.
Faire en sorte que le partitionnement réponde à de vraies questions
Choisissez les partitions à partir des filtres de requête observés et du comportement d'écriture. Iceberg prend en charge l'évolution de l'agencement des partitions, si bien que les équipes peuvent le modifier quand le volume de données ou les motifs de requête changent, mais une fonction d'évolution n'efface pas le coût de mauvais choix initiaux.
Vérifiez la création de petits fichiers après chaque changement majeur de pipeline. Des clés de partition à forte cardinalité peuvent disperser les données sur de nombreux fichiers, tandis que des partitions trop larges peuvent forcer les moteurs à scanner plus de données que nécessaire. Le tri et le compactage peuvent améliorer la localité, mais ils ajoutent du travail de maintenance.
Poser des limites aux snapshots
Les snapshots historiques aident à la reproductibilité, au rollback et au débogage. Une rétention illimitée crée davantage de métadonnées à planifier et d'objets à gérer ; définissez donc une politique fondée sur les besoins de reprise, les exigences d'audit et les règles de cycle de vie du stockage.
Associez l'expiration des snapshots au nettoyage des fichiers orphelins. Retirer des références de métadonnées sans identifier sûrement les données non référencées peut créer une autre défaillance ; le nettoyage doit donc être délibéré, observable et testé.
Émettre des signaux opérationnels au moment de l'écriture
Les écrivains savent quand un commit commence, combien de fichiers ils créent, combien de temps le commit dure et si un compactage a eu lieu. Capturez ces faits sous forme d'événements structurés au lieu de tenter de les reconstituer plus tard à partir de journaux épars.

Suivez le nombre de fichiers, leur taille, la latence des commits, l'âge des snapshots, les commits échoués et la santé du compactage. Ces signaux relient les opérations du format aux symptômes que les utilisateurs remarquent : tableaux de bord lents, jeux de données périmés et chargements incomplets.
La maturité opérationnelle détermine si un lakehouse se comporte de façon fiable. La spécification ouverte est nécessaire à une sémantique partagée, mais ce sont vos politiques de catalogue, vos travaux de maintenance, votre routage d'alertes et votre modèle de responsabilité qui décident si cette sémantique résiste à la pression de production.
Observabilité et schémas d'intégration pour les lakehouses en production
Une table peut être transactionnellement valide et pourtant opérationnellement fausse. Elle peut comporter une colonne nouvelle qui casse un modèle en aval, un commit réussi arrivé trop tard pour une échéance de reporting, ou un ensemble de fichiers valide dont le volume d'enregistrements diffère nettement de sa ligne de base établie.
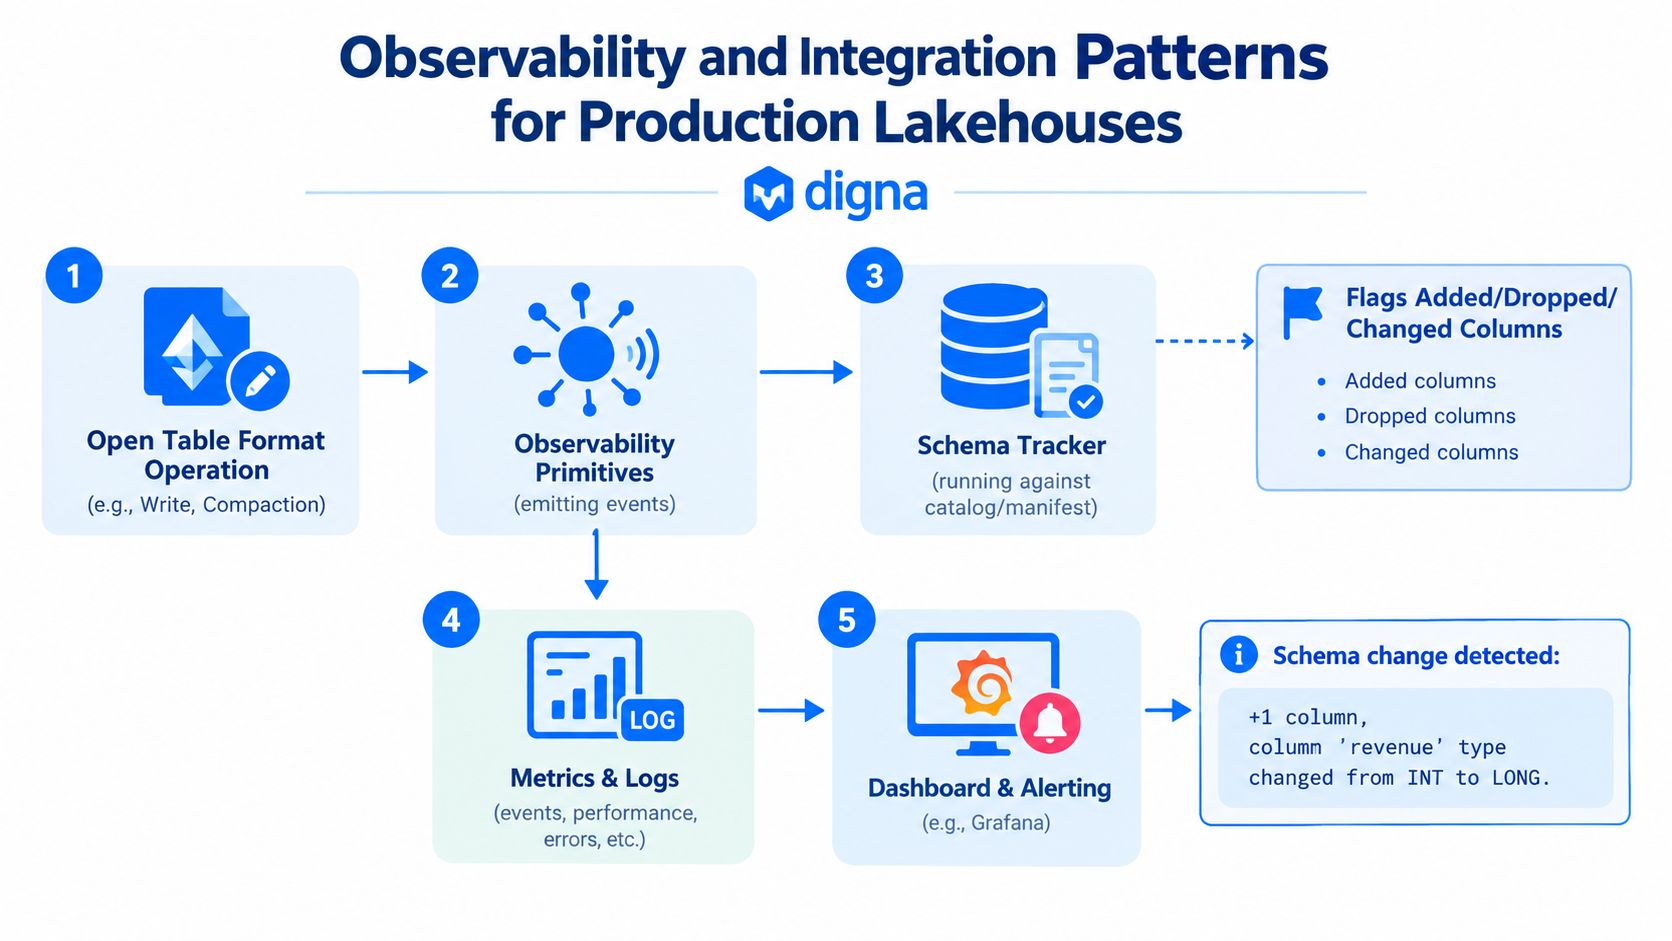
L'observabilité devrait se rattacher directement aux opérations de table. Le suivi de schéma inspecte les métadonnées de catalogue ou les informations de manifeste pour repérer les colonnes ajoutées, supprimées ou dont le type a changé. Les contrôles exécutés dans la base évaluent les enregistrements là où ils résident déjà, ce qui évite d'exporter des échantillons et permet aux équipes de tester le nombre de lignes, le comportement des valeurs nulles, les règles métier et certaines relations.
Quatre signaux à relier
Détection des changements de schéma : signalez une colonne ajoutée, supprimée ou dont le type a changé avant qu'un consommateur en aval n'échoue ou ne convertisse des valeurs.
Validation des données : exécutez des assertions sur la table pour les champs obligatoires, les valeurs acceptées, les règles métier au niveau des enregistrements et les conditions d'intégrité.
Lignes de base d'anomalies : comparez le nombre d'enregistrements par partition, la taille des fichiers, le comportement des commits et d'autres métriques à l'historique du jeu de données.
Surveillance de Timeliness : comparez la création des snapshots et l'arrivée des données au calendrier de livraison attendu, afin qu'un pipeline techniquement réussi ne masque pas un incident de fraîcheur.
L'unité de surveillance utile n'est pas seulement le job. C'est l'état de la table que lisent les consommateurs. Une tâche réussie peut malgré tout publier une période métier incomplète, introduire un schéma incompatible ou créer un agencement de fichiers pathologique.
Détails d'intégration et de déploiement
Une plateforme d'observabilité peut se connecter aux API Iceberg REST ou Unity Catalog pour accéder au schéma et aux métadonnées, ingérer des événements d'écriture structurés pour l'analyse d'anomalies et envoyer des alertes vers les mêmes canaux d'incident que la surveillance de l'entrepôt. Le placement des agents compte aussi. Les équipes doivent décider si les composants de surveillance s'exécutent à côté de l'environnement de calcul, au sein d'un réseau privé ou dans une autre frontière de service contrôlée.
Les permissions doivent s'aligner sur le RBAC du catalogue. La surveillance devrait voir assez de métadonnées et de contenu de table pour calculer les signaux requis sans contourner la couche de gouvernance. Une plateforme telle que la solution d'observabilité des données de digna peut convenir comme option, avec des capacités de suivi de schéma, de validation dans la base, de détection d'anomalies et de surveillance de la ponctualité au sein de l'environnement du client.
Le principe général est simple : chaque commit devrait produire des preuves sur ce qui a changé, quand cela est arrivé et si son comportement reste dans une ligne de base acceptée.
Déploiement et exploitation en environnements réglementés
Choisir Iceberg, Delta Lake ou Hudi est rarement la décision la plus difficile en environnement réglementé. Les questions ardues portent sur l'endroit où tourne le catalogue, la façon dont les moteurs s'authentifient, la correspondance des permissions avec les colonnes sensibles et la manière dont les opérations de métadonnées apparaissent dans une piste d'audit.
Un déploiement bring-your-own-cloud garde le stockage, les services de catalogue, le calcul et la surveillance dans la frontière cloud de l'organisation. L'équipe contrôle les chemins réseau et la rétention, mais elle assume aussi la disponibilité, les mises à niveau, la gestion des clés et les tests de reprise. Une conception multirégion ajoute des décisions de réplication et de résidence. Les exploitants doivent définir quelles métadonnées et quels snapshots se répliquent, comment le lignage traverse les régions et quelle procédure de rollback s'applique quand les régions divergent.
Un déploiement sur site isolé du réseau change encore les contraintes. Les services managés externes peuvent être indisponibles, si bien que les mises à niveau de catalogue, les tests de compatibilité de format, l'observabilité et les preuves d'incident doivent fonctionner à l'intérieur de l'environnement isolé.

Contrôles à trancher avant la production
Emplacement du catalogue : choisissez un service managé, un catalogue auto-hébergé ou une plateforme de gouvernance unifiée selon les exigences de reprise, de résidence et d'audit.
Identité et accès : faites correspondre les permissions du catalogue aux politiques RBAC ou ABAC existantes, y compris les identités de service utilisées par l'ingestion et la surveillance.
Traitement des données sensibles : étiquetez et gouvernez les données personnelles aux niveaux du catalogue et de la plateforme plutôt que de supposer que le format de fichier applique la politique.
Assurance à l'exécution : vérifiez en continu la fraîcheur, la compatibilité de schéma, le comportement des données et les événements d'accès, au lieu de vous fier à une validation ponctuelle.
Les équipes devraient documenter ces choix aux côtés des exigences de résidence des données. Le format peut rendre l'historique de table et l'état des fichiers plus explicites, mais c'est la maturité opérationnelle qui détermine si le lakehouse peut fournir des preuves d'audit durables.
Une liste de contrôle concrète avant de standardiser un format
Utilisez ces phrases lors de votre prochaine revue d'architecture :
Adéquation du catalogue : vérifiez que le catalogue prend en charge vos moteurs, votre modèle d'identité, vos exigences d'audit et votre conception de reprise.
Compatibilité des moteurs : testez les combinaisons réelles de Spark, Trino, Flink, entrepôt et BI qui liront ou écriront les tables.
Stratégie de partitionnement : alignez partitionnement et tri sur les motifs d'accès observés et le comportement d'écriture.
Politique de snapshots : définissez les procédures de rétention, de rollback, de compactage et de nettoyage des fichiers orphelins avant l'usage en production.
Contrôle d'accès : confirmez que les colonnes sensibles, les identités de service et les permissions de surveillance suivent les politiques de gouvernance existantes.
Alertes de schéma : surveillez les colonnes ajoutées, supprimées, renommées et dont le type a changé avant que les consommateurs en aval ne cassent.
SLA de fraîcheur : comparez l'arrivée des snapshots aux délais de livraison attendus pour les consommateurs batch et streaming.
Lignes de base d'anomalies : suivez dans le temps le nombre de fichiers, les volumes d'enregistrements, la latence des commits et le comportement des partitions.
Procédure de rollback : testez comment les exploitants identifient un snapshot défectueux et restaurent un état de table sûr.
Reprenez la liste après chaque mise à niveau majeure de moteur, changement réglementaire ou refonte de pipeline. Un format de table ouvert réduit l'ambiguïté, mais il n'élimine pas la responsabilité opérationnelle.
digna aide les équipes de données à surveiller les changements de schéma, à valider les enregistrements dans la base, à détecter les comportements de table anormaux et à suivre la ponctualité au sein de leur propre cloud ou centre de données. Rendez-vous sur digna pour relier ces contrôles aux opérations de format de table ouvert dont votre lakehouse dépend déjà.
Standardiser un format règle l'endroit où vivent les métadonnées de table ; cela ne règle pas la justesse des valeurs qu'elles décrivent, et c'est là que commence la gestion de la qualité des données.
Questions fréquentes
Que résout réellement un format de table ouvert ?
Le contrat manquant entre les fichiers et les moteurs. Les fichiers bruts n'indiquent pas à chaque moteur quels fichiers appartiennent à la table logique ; un format de table ouvert se place donc à côté des données et consigne ce sur quoi les moteurs doivent s'accorder.
Que consigne ce contrat ?
Cinq choses : une identité de table indépendante de tout moteur, un inventaire nommant les fichiers qui appartiennent à la table et ceux qui ne doivent plus être lus, l'agencement des partitions pour permettre l'élagage, l'historique de schéma couvrant ajouts, suppressions et renommages, et des snapshots atomiques pour que les lecteurs obtiennent une version cohérente pendant qu'un écrivain valide.
Quelle est l'ampleur de l'adoption d'Iceberg ?
Apache Iceberg est utilisé par 58 % des organisations pour l'analytique critique, tandis que 95 % l'utilisent ou prévoient de l'utiliser pour des charges d'IA et d'apprentissage automatique. Ces deux chiffres expliquent pourquoi le choix du format est devenu une décision de plateforme plutôt qu'un détail de stockage.
Iceberg, Delta Lake et Hudi résolvent-ils des problèmes différents ?
Ils abordent le même problème différemment plutôt que de résoudre des problèmes distincts. Tous trois fournissent le contrat de table ; ils divergent sur les motifs d'écriture, le traitement des suppressions et le couplage à l'écosystème, raison pour laquelle le choix devrait suivre la charge de travail plutôt que la marque.
Que faut-il confirmer avant d'en standardiser un ?
Qu'il survive à votre déploiement réglementé, pas seulement à votre benchmark. L'exploitation à l'échelle de l'entreprise apporte une hygiène des métadonnées, une coordination entre moteurs et des contraintes de déploiement qu'une preuve de concept sur un seul moteur ne fera pas apparaître.



