Données prêtes pour l'IA : des entrées brutes à l'IA fiable
|
8
minute de lecture

Un projet d'IA paraît souvent en bonne santé jusqu'au moment où il touche les données de production.
L'équipe a une idée de modèle, un budget, un environnement cloud et des gens qui savent construire des pipelines. Puis le travail ralentit. Les champs ne veulent pas dire la même chose d'un système à l'autre. Le changement de schéma d'hier a cassé une table de variables. Les étiquettes viennent d'un processus manuel auquel personne ne se fie tout à fait. Les données existent, mais personne ne peut dire avec assurance si elles sont sûres pour la recherche, la prédiction ou l'action automatisée.
C'est là que beaucoup d'équipes comprennent que ce n'était pas le choix du modèle qui les bloquait. C'était la maturité des données.
Une enquête mondiale de 2024 a saisi cet écart clairement. Seules 12 % des organisations ont déclaré que leurs données avaient une qualité et une accessibilité suffisantes pour une mise en œuvre efficace de l'IA, alors même que 60 % affirmaient que l'IA était devenue une influence clé sur les programmes de données, en hausse de 46 % par rapport à 2023. La même enquête a montré que 64 % désignaient la qualité des données comme leur principal défi d'intégrité, tandis que 77 % jugeaient leur qualité de données moyenne ou pire (recherche mondiale sur la maturité face à l'IA).
Table des matières
Introduction : pourquoi les projets d'IA calent avant le modèle
Comment l'observabilité garde les données prêtes pour l'IA à l'exécution
Conclusion : votre chemin vers des données fiables prêtes pour l'IA
Introduction : pourquoi les projets d'IA calent avant le modèle
Un schéma familier se répète dans beaucoup d'équipes de données. Le produit veut un copilote de support. Le risque veut de la détection d'anomalies. L'exploitation veut des prévisions. L'ingénierie assemble la pile assez vite, mais le premier test sérieux révèle le problème. Personne ne s'accorde sur la table qui fait foi, sur le fait que le dernier chargement soit complet, ni sur le fait que les étiquettes reflètent le résultat métier que le modèle est censé apprendre.
C'est pourquoi données prêtes pour l'IA est une formule plus utile que « données propres ». La propreté évoque une tâche d'hygiène ponctuelle. La maturité est plus exigeante. Elle demande si un jeu de données convient à une tâche d'IA précise, dans les conditions d'exploitation actuelles, avec assez de confiance pour porter des décisions.
Si vous avez vu des expériences de modèle briller dans un notebook et échouer une fois branchées sur des systèmes vivants, vous connaissez déjà ce problème. L'échec n'a en général rien de mystérieux. Il tient à des entités dupliquées, des entrées périmées, des transformations non documentées ou des passations fragiles entre équipes. Une base pratique commence par comprendre pourquoi la qualité des données compte pour une organisation, mais l'IA relève l'exigence, car les données doivent fonctionner pour les humains comme pour les machines.
Le blocage commence le plus souvent en amont
Beaucoup d'équipes ne posent pas la mauvaise question. Elles en posent une trop large : « Nos données sont-elles prêtes pour l'IA ? » Cela paraît sensé, mais cela masque les détails importants. Prêtes pour la recherche documentaire n'est pas prêtes pour la prévision de la demande. Prêtes pour un assistant avec humain dans la boucle n'est pas prêtes pour un agent qui déclenche des actions.
Les projets d'IA calent rarement par absence de données. Ils calent parce que les données disponibles ne sont pas assez fiables pour le flux exact que l'on construit.
Cette distinction change la façon d'évaluer la maturité. Vous cessez de prendre le volume pour une preuve. Vous vous mettez à vérifier l'adéquation, la traçabilité et la sûreté à l'exécution.
La confiance doit survivre au contact des systèmes vivants
Les contrôles de qualité historiques comptent, mais ne suffisent pas. Un jeu d'entraînement peut sembler bien préparé et devenir dangereux dès que les schémas changent, que les chargements arrivent en retard ou que la logique amont bouge sans prévenir. En pratique, la maturité pour l'IA vit à deux endroits à la fois :
La qualité de préparation signifie que le jeu de données est défini, validé et documenté assez pour être utilisé.
La confiance à l'exécution signifie que vous savez détecter quand ce statut ne tient plus.
Voilà la bonne grille de lecture. Non pas « avons-nous beaucoup de données ? », mais « ces données peuvent-elles porter ce comportement d'IA, aujourd'hui, avec des contrôles qui détectent la dérive avant que le modèle n'agisse ? ».
Ce que signifient vraiment des données prêtes pour l'IA
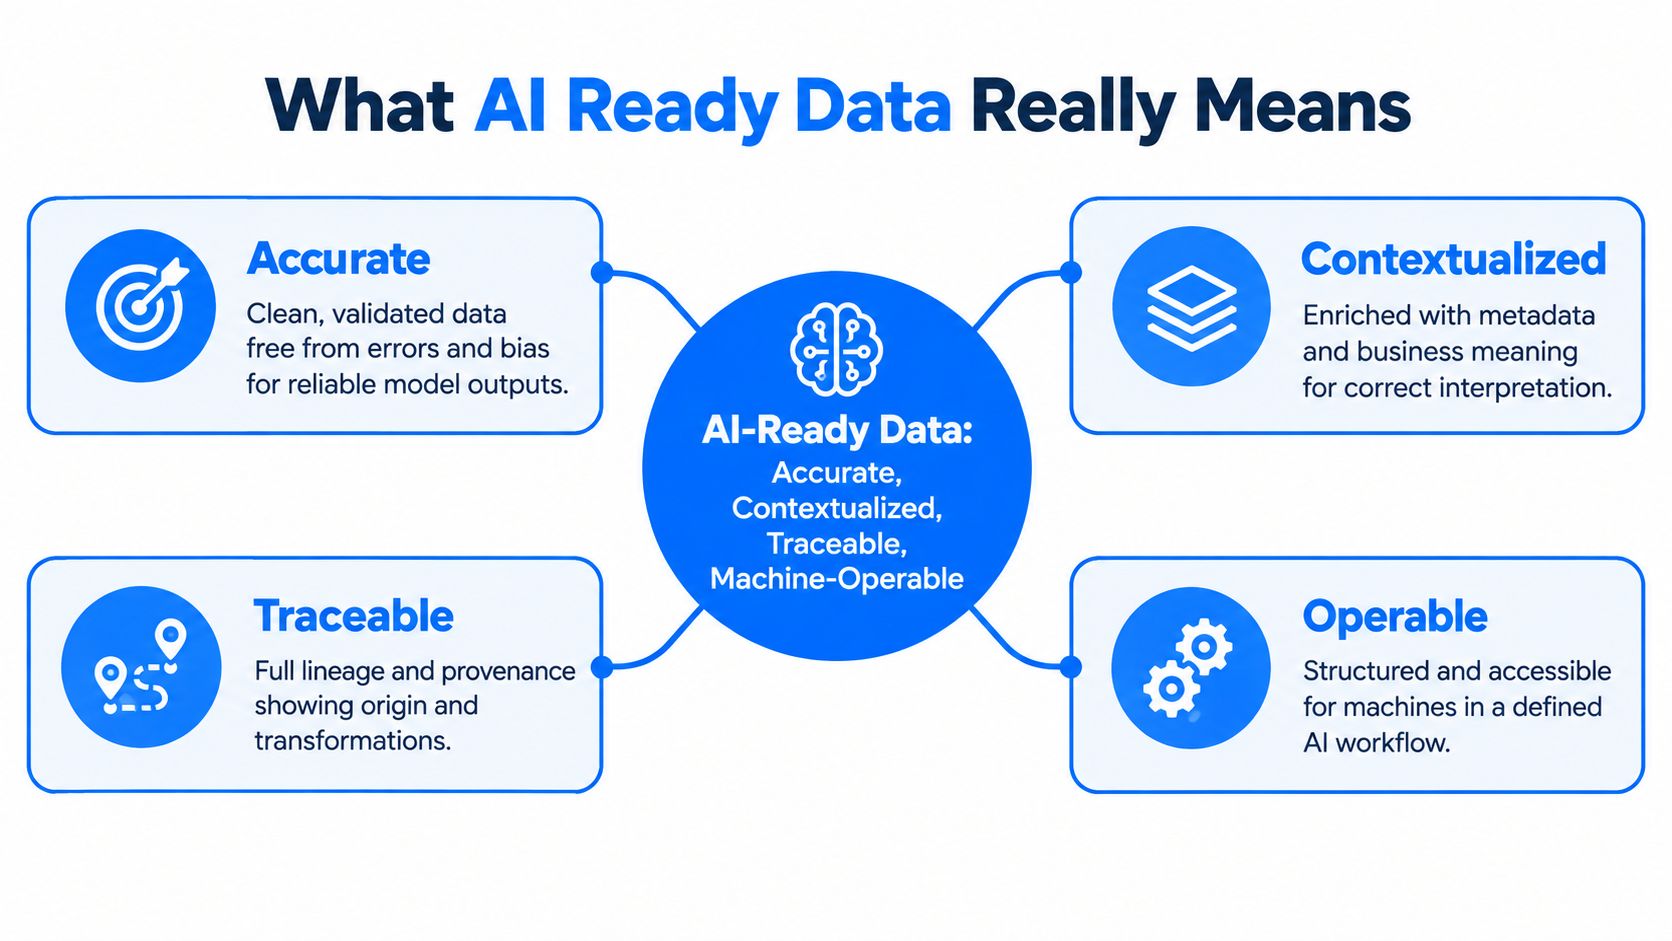
Des données prêtes pour l'IA ne sont pas simplement des données avec moins de valeurs nulles et des valeurs plus propres. Ce sont des données qu'une machine peut interpréter, tracer et utiliser correctement pour un flux défini.
Une analogie de cuisine aide. Des ingrédients bruts dans un réfrigérateur ne valent pas des ingrédients préparés pour une recette. Vous avez peut-être des oignons, des tomates et des épices, mais le dîner n'est pas prêt pour autant. Quelqu'un doit encore laver, couper, doser, étiqueter et organiser le tout pour le plat exact que l'on cuisine. Les données fonctionnent pareil. Le stockage n'est pas la maturité. La maturité signifie que le jeu de données a été préparé pour un type de calcul précis.
L'exactitude n'est que la première couche
Commencez par la qualité des valeurs, et c'est justifié. De mauvaises valeurs cassent les modèles de façon évidente. Des horodatages erronés faussent les variables séquentielles. Des clients dupliqués gonflent l'exposition. Des étiquettes incohérentes empoisonnent les cibles d'entraînement. S'il vous faut un rappel solide sur les composantes en jeu, les dimensions de la qualité des données sont la bonne fondation.
Mais l'exactitude seule ne rend pas des données prêtes pour l'IA. Une colonne parfaitement valide échoue quand même si le modèle ne peut pas savoir ce qu'elle signifie, d'où elle vient, ou si elle s'applique à la tâche du moment.
Le contexte transforme des valeurs en signal exploitable
Les données gagnent en utilité quand elles portent des métadonnées que les machines peuvent analyser, pas seulement des commentaires que les humains peuvent lire. Des recommandations indépendantes de la communauté statistique des Nations unies et du gouvernement britannique soulignent que les jeux de données prêts pour l'IA ont besoin de métadonnées lisibles par machine, d'assurance qualité, de formats interopérables et de contrôles de gouvernance. Le cadre de l'ONU met en avant des métadonnées actionnables par machine, le contrôle qualité, les licences ouvertes, un accès responsable assisté par l'IA et une collaboration structurée. Les recommandations britanniques de 2026 précisent qu'un jeu de données prêt pour l'IA doit satisfaire des normes d'optimisation technique, d'exactitude, de complétude, de cohérence, de métadonnées, de surveillance qualité en continu et de conformité juridique (recommandations ONU et Royaume-Uni sur les données prêtes pour l'IA).
Cela paraît abstrait jusqu'à ce qu'on le traduise en travail d'ingénierie :
Le sens métier indique à l'équipe de modélisation ce que représente un champ.
Les métadonnées techniques indiquent aux systèmes comment l'analyser et le joindre.
Le contexte d'usage indique aux utilisateurs en aval quand il est approprié de l'utiliser.
Traçable et exploitable par la machine signifie sûr en production
Un article d'expert de 2026 décrit les données prêtes pour l'IA comme des données adossées à des métadonnées structurées qui permettent la découverte automatisée, l'alignement sémantique, le suivi de provenance et un usage calculatoire reproductible. Il note aussi que les métadonnées au niveau du jeu de données doivent être attachées et analysables par les machines, car l'interopérabilité et la traçabilité en dépendent (discussion experte sur métadonnées structurées et provenance).
Règle pratique : traitez métadonnées, lignage et provenance comme une partie du contrat d'entrée du modèle, pas comme de la paperasse de gouvernance facultative.
C'est la définition centrale que j'utilise en travail de plateforme : des données prêtes pour l'IA sont exactes, contextualisées, traçables et exploitables par la machine pour une tâche d'IA précise. Si l'une de ces pièces manque, le modèle tournera peut-être quand même. Il ne sera simplement pas fiable.
Les six piliers qui rendent les données prêtes pour l'IA
Une liste pratique dépasse le « propre et gouverné ». Six piliers sont utiles car ils couvrent à la fois la performance du modèle et la confiance opérationnelle.
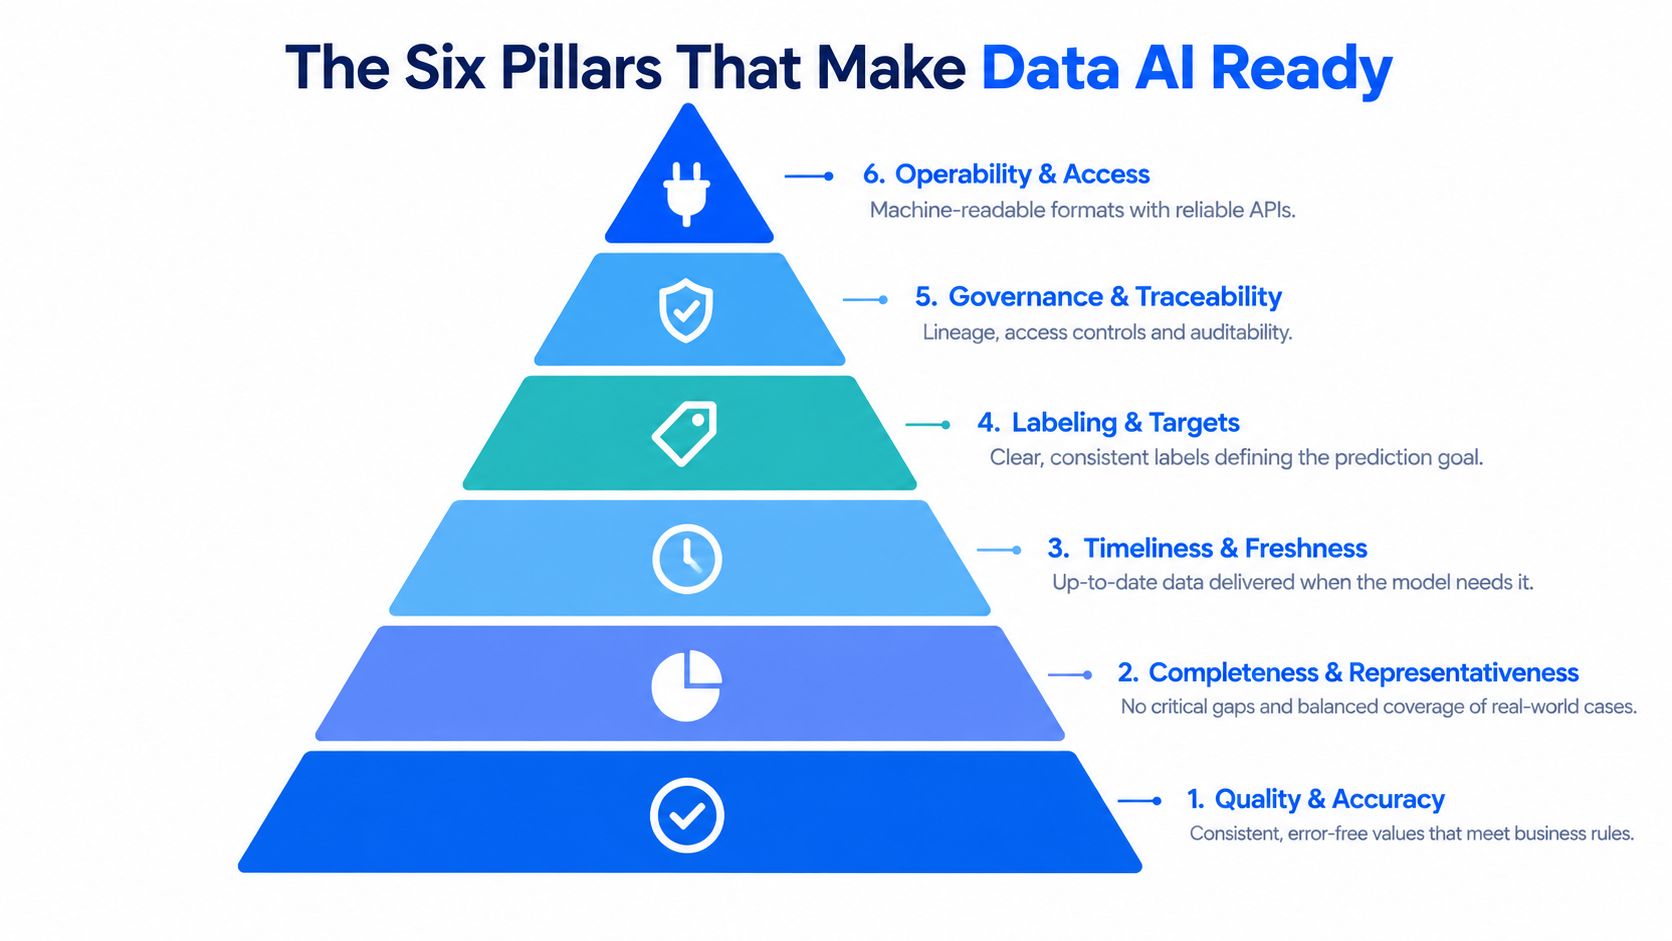
Qualité et exactitude
Commencez par les valeurs elles-mêmes. Les enregistrements sont-ils valides ? Les formats sont-ils cohérents ? Les dates, identifiants et champs catégoriels respectent-ils les règles métier ?
Ce n'est pas seulement de l'orthodoxie de gestion des données. Des recherches empiriques ont examiné six dimensions de qualité des données sur 19 algorithmes d'apprentissage automatique répandus pour la classification, la régression et le partitionnement, précisément pour expliquer la performance par la qualité des données. Un article ultérieur d'IA centrée sur les données a repris six dimensions : représentation cohérente, complétude, exactitude des variables, exactitude de la cible, unicité et équilibre des classes cibles (recherche sur les dimensions de qualité et les résultats de ML).
L'implication pratique est simple. Doublons, cibles mal étiquetées et représentations incohérentes modifient le comportement du modèle.
Complétude et représentativité
Un jeu de données complet peut tout de même ne pas représenter le monde auquel votre modèle fera face. C'est là que les équipes trébuchent souvent. Elles valident le nombre de lignes et les taux de valeurs nulles, puis découvrent que le modèle est faible sur des cas rares mais importants.
La représentativité demande si les données incluent les événements, utilisateurs, cas limites et conditions d'exploitation que le système d'IA doit gérer. Si vous entraînez un classifieur de support sur des tickets bien formés alors que la production contient abréviations, journaux collés et texte multilingue, votre échantillon propre n'est pas assez représentatif.
Une liste utile en entreprise inclut souvent :
La couverture des cas limites qui comptent pour le métier, pas seulement du chemin courant
Des exemples équilibrés quand un déséquilibre de classes fausserait l'entraînement
La diversité des sources quand la même entité apparaît dans des systèmes fragmentés
Timeliness et fraîcheur
Certaines données sont correctes et pourtant inutilisables parce qu'elles arrivent en retard. Cela compte pour l'IA plus que bien des équipes ne l'imaginent.
Un modèle de recommandation fondé sur le stock d'hier peut proposer des articles indisponibles. Un signal de fraude bâti sur des transactions retardées perd son utilité précisément quand la vitesse compte. Pour les systèmes de recherche, une connaissance périmée peut être plus dangereuse qu'une connaissance absente, car la sortie garde un ton assuré.
La fraîcheur n'est pas une note de bas de page du SLA. Pour beaucoup de flux d'IA, elle fait partie de la justesse.
Étiquetage et intégrité de la cible
Les étiquettes d'entraînement méritent leur propre pilier car elles définissent ce que le modèle apprend à optimiser. Si les équipes ne s'accordent pas sur ce que veut dire « résilié », « approuvé » ou « risque élevé », le modèle encodera cette ambiguïté.
Un bon étiquetage ne se résume pas à la cohérence. Il s'agit aussi d'alignement opérationnel. La cible doit refléter la décision que le métier veut soutenir. Sinon le modèle devient excellent à prédire un substitut que personne ne devrait utiliser.
Gouvernance et traçabilité
Quand une sortie de modèle demande explication, les équipes ont besoin du lignage vite. Quel système source a fourni la valeur ? Quelles transformations l'ont modifiée ? Qui a approuvé ce jeu de données pour cet usage ?
Un cadre de qualité des données en entreprise est utile ici, car la gouvernance devient concrète quand elle s'attache à des contrôles précis : propriété, règles d'accès, preuves de validation et historique de lignage. Sans traçabilité, même un jeu de données solide est difficile à auditer et difficile à croire.
Exploitabilité et accès
Le dernier pilier est souvent sous-estimé. Des données peuvent être de grande qualité et échouer quand même parce qu'elles sont prises dans des formats peu commodes, des schémas de stockage mal documentés ou des passations fragiles.
L'exploitabilité signifie que les données sont disponibles dans des formats lisibles par machine, accessibles via des interfaces stables et structurées pour que les pipelines les consomment de façon fiable. En production, schémas, API, tables et services de métadonnées cessent d'être de la plomberie et deviennent une part de la maturité pour l'IA.
Prêtes pour quoi ? Définir l'adéquation à votre cas d'usage
Une liste de maturité générique s'effondre dès qu'on compare des tâches d'IA différentes.
Un système de recherche a besoin de documents indexables, d'une stratégie de découpage, de balises de métadonnées et de provenance. Un modèle de prévision a besoin de séries temporelles stables, d'une granularité cohérente et d'horodatages fiables. Un flux autonome demande des contrôles encore plus forts, puisqu'il peut agir sur les données sans revue humaine.
Gartner le dit directement. Les dirigeants doivent d'abord définir ce qui compte comme données prêtes pour l'IA, et ces données doivent être représentatives du cas d'usage, y compris les cas limites, valeurs aberrantes et motifs inattendus nécessaires pour entraîner ou exécuter le modèle. La même discussion note que les organisations confondent souvent l'échelle avec une qualité de signal adaptée à l'usage, tandis que les recommandations actuelles insistent sur des données recherchables, contextuelles et fiables à travers les actifs structurés, non structurés et en flux (Gartner sur la définition des données prêtes pour l'IA par cas d'usage).
Plus de données ne répond pas à la bonne question
Les équipes disent souvent : « Nous avons beaucoup de données. » Ce peut être vrai et sans intérêt.
La meilleure question est : quelle défaillance ferait le plus de mal à ce système d'IA ? S'il résume des documents de politique, les versions périmées sont un risque majeur. S'il note des événements de crédit, la provenance et le statut d'approbation comptent plus que le volume de texte. S'il fait tourner un agent opérationnel, la fraîcheur à l'exécution et les limites de permissions passent au centre.
Cas d'usage IA | Critères de maturité les plus critiques | Défaillance fréquente en leur absence |
|---|---|---|
Recherche sur documents | Métadonnées recherchables, provenance, versionnage, contrôles d'accès | Le système retrouve du contenu périmé ou pauvre en contexte |
Modélisation prédictive | Couverture représentative, intégrité de la cible, cohérence, complétude | Le modèle apprend des motifs déformés et rate des cas importants |
Aide à la décision en temps réel | Fraîcheur, Timeliness, schémas stables, accès à faible latence | La sortie reflète des événements tardifs ou incomplets |
Flux autonomes | Gouvernance, traçabilité, contrôles de politique, détection de changements | Le système engage des actions risquées sur des entrées peu fiables |
Utiliser les éléments de données critiques pour pondérer la liste
Beaucoup d'équipes gagnent à définir des éléments de données critiques avant de commencer à régler des modèles. Tous les champs ne méritent pas les mêmes contrôles. L'identifiant client dans un flux de dédoublonnage ne pèse pas comme un champ de commentaire descriptif dans une recherche sémantique.
Une façon pratique de noter l'adéquation est de poser trois questions :
Quelle décision ou sortie précise dépend de ces données ?
Quel mode de défaillance est le moins acceptable ?
Quels champs, métadonnées et chemins de mise à jour portent ce risque ?
Une fois ces réponses posées, la maturité cesse d'être un slogan et devient une spécification d'ingénierie.
Comment préparer les données pour l'IA en pratique
La préparation fonctionne mieux comme un flux relié que comme un tas de tâches de nettoyage isolées. L'ordre compte, car les choix de conception initiaux déterminent la confiance que vous pourrez préserver ensuite.
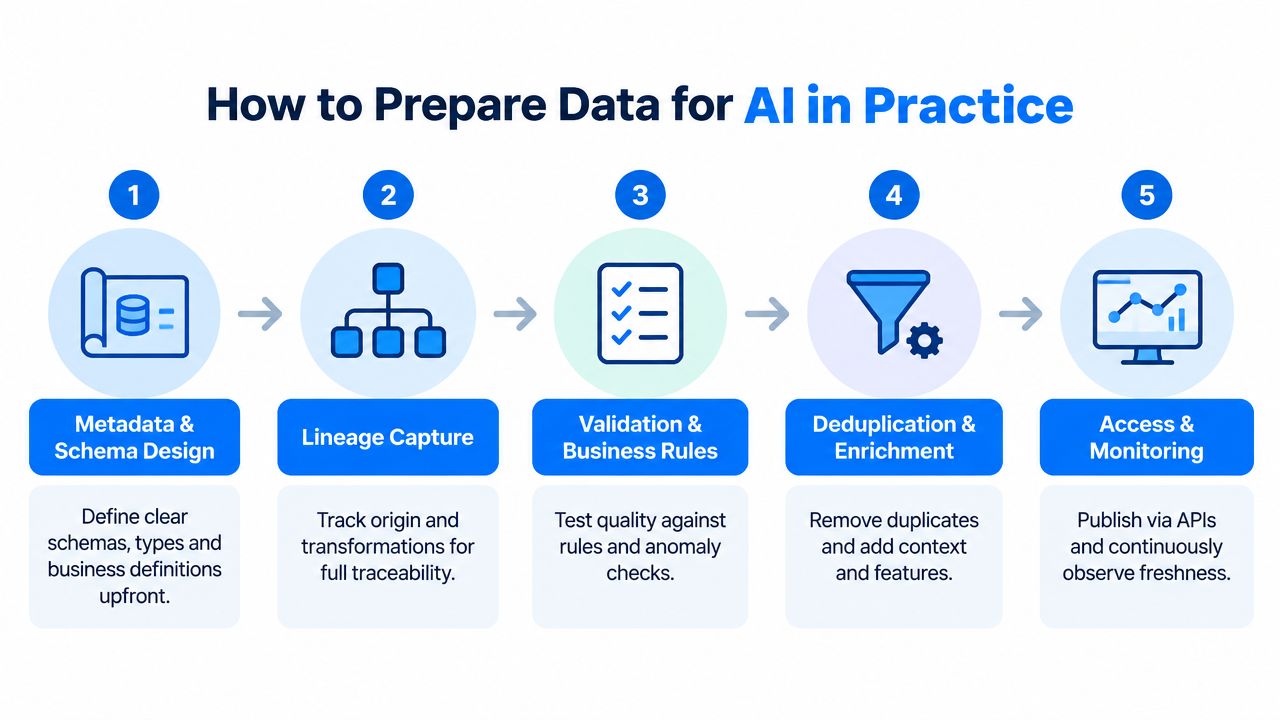
Commencez par les schémas et les métadonnées
Avant de valider des valeurs, définissez ce que le jeu de données est censé être. Cela veut dire noms de champs, types, définitions métier, propriété, usage approuvé et attentes de rafraîchissement. Si un champ change de sens sans changer de nom, chaque modèle en aval opère désormais avec un risque silencieux.
De bonnes métadonnées doivent répondre aux questions humaines comme aux questions machines. Une personne doit comprendre le sens métier. Un pipeline doit pouvoir analyser automatiquement la structure, les relations et les contraintes d'usage.
Capturez le lignage pendant que les transformations sont visibles
Le lignage se consigne le plus facilement au moment où les données bougent, pas des mois plus tard lors d'un audit. Suivez d'où viennent les données, quelles jointures et quels filtres les ont touchées, et quel traitement ou quelle personne les a promues vers une couche de service pour l'IA.
Le moyen le plus rapide de perdre confiance en un modèle est de découvrir une sortie suspecte sans chemin propre pour remonter aux enregistrements source.
Cela n'exige pas un immense programme de gouvernance. Cela exige de la discipline dans la conception des pipelines, la journalisation des transformations et l'enregistrement des jeux de données.
Validez les règles métier avant de passer l'entraînement à l'échelle
Une fois les définitions et le lignage en place, appliquez des contrôles par règles. Validez les identifiants, imposez les plages autorisées, confirmez l'intégrité référentielle et confrontez les étiquettes à la vérité source quand c'est possible.
Traitez ensuite les problèmes qui pèsent souvent de façon démesurée sur les modèles :
Dédoublonnage : supprimez ou réconciliez les enregistrements qui décrivent la même entité de façons contradictoires.
Revue des manquants : distinguez les valeurs nulles acceptables de celles qui signalent un flux cassé.
Vérification des étiquettes : vérifiez si les valeurs cibles correspondent au résultat opérationnel qui vous importe.
Revue de l'équilibre des classes : regardez si des catégories importantes sont absentes, rares ou biaisées.
Enrichissez le jeu de données sans masquer la vérité source
L'enrichissement de variables est utile, mais il peut brouiller la provenance si les équipes n'étiquettent pas clairement les champs dérivés. Gardez distincts les champs bruts, les champs normalisés et les variables construites. Cela facilite le débogage quand le comportement du modèle devient difficile à expliquer.
Publiez les chemins d'accès et les points de surveillance
Un jeu de données préparé doit être découvrable et consommable. Cela signifie en général une table stable, une API ou un chemin de service documenté avec une propriété claire.
Cela signifie aussi instrumenter le jeu de données avant le déploiement, pas après le premier incident. Si vous ne pouvez pas observer les changements de Timeliness, de structure ou de comportement des valeurs, le jeu de données n'est pas prêt pour de l'IA en production.
Comment l'observabilité garde les données prêtes pour l'IA à l'exécution
La préparation amène un jeu de données sur la ligne de départ. L'observabilité l'y maintient.
Cela compte surtout dans les environnements réglementés ou sensibles à la vie privée, où les équipes ne peuvent pas exporter de données vers des outils d'IA externes. La couverture sectorielle indépendante présente de plus en plus les données prêtes pour l'IA comme des données découvrables, gouvernées, sécurisées et utilisables à travers des systèmes fragmentés, la confiance à l'exécution devenant centrale pour passer l'IA d'entreprise à l'échelle, en particulier dans la finance, la santé, les télécoms et le secteur public (IBM sur des données prêtes pour l'IA fiables et gouvernées).

À quoi ressemble la confiance à l'exécution
À l'exécution, vous ne demandez plus si le jeu de données historique paraissait bon lors de la préparation. Vous demandez si l'entrée du jour correspond encore aux conditions dans lesquelles le modèle ou l'agent est jugé sûr.
Cela demande en général plusieurs contrôles agissant ensemble :
Surveillance de la fraîcheur pour repérer les chargements tardifs, manquants ou étonnamment précoces
Suivi de schéma pour repérer les changements structurels avant que les systèmes en aval ne cassent
Contrôles de validation pour imposer les règles métier sur les enregistrements en production
Surveillance du comportement pour repérer des décalages inhabituels dans les distributions de valeurs ou les motifs de lignes
Une plateforme telle que le logiciel d'observabilité des données de digna illustre ce schéma. Elle s'exécute dans l'environnement du client, calcule les contrôles dans la base et combine détection d'anomalies, surveillance de la Timeliness, validation et suivi de schéma sans que l'éditeur accède aux données de production. Ce modèle de déploiement compte quand les données ne peuvent pas quitter l'infrastructure de l'organisation.
Les métriques d'exploitation sont concrètes
La dérive de schéma n'est pas une inquiétude vague. Une conception de référence définit un compteur de changements de schéma par table, incluant ajout, suppression, renommage, changement de type et de nullabilité de colonnes, et l'associe à des signaux statistiques de dérive comme le taux de valeurs nulles et le nombre de valeurs distinctes, afin de séparer le changement structurel du changement de distribution (métriques de dérive de schéma et d'attributs).
La fraîcheur se mesure aussi. Une conception d'observabilité suit la latence de détection de dérive comme le temps moyen entre la survenue d'un changement de schéma et sa détection par le système. Elle suit également le taux de perte de données et le taux d'échec des pipelines en pourcentages d'enregistrements malformés ou perdus, ou de traitements échoués (surveillance de la latence de dérive et des signaux de qualité des pipelines).
La surveillance assistée par IA réduit le travail manuel sur les seuils
Les seuils manuels passent mal l'échelle sur des centaines de jeux de données. Bigeye indique que sa détection d'anomalies apprend le comportement historique d'un jeu de données et détermine automatiquement des seuils pour chaque attribut de qualité, en utilisant des seuils d'écart type fondés sur la moyenne historique pour générer des alertes sans effort manuel (approche de détection d'anomalies de Bigeye).
Databricks décrit une orientation d'entreprise similaire. Sa surveillance analyse automatiquement les motifs historiques pour détecter des anomalies de fraîcheur et de complétude des tables, tout en suivant les tendances statistiques et les anomalies dans le temps au sein d'un système unifié (surveillance lakehouse de Databricks).
La propreté historique aide à l'entraînement. L'observabilité à l'exécution décide si les sorties d'IA en production restent dignes de confiance.
C'est le basculement que beaucoup d'équipes opèrent aujourd'hui. La maturité pour l'IA n'est plus seulement un jalon de préparation des données. C'est une condition d'exploitation.
Conclusion : votre chemin vers des données fiables prêtes pour l'IA
Des données prêtes pour l'IA, ce n'est pas un tas d'enregistrements plus gros. Ce sont des données adaptées à un cas d'usage précis et encore dignes de confiance quand les systèmes vivants se mettent à changer autour d'elles.
Cela suppose la rencontre de deux disciplines. D'abord, préparer les jeux de données pour qu'ils soient exacts, contextualisés, traçables et exploitables par la machine. Ensuite, maintenir ce statut par des contrôles à l'exécution qui repèrent entrées périmées, changements de schéma, enregistrements manquants et anomalies de comportement avant qu'ils n'atteignent un modèle, un agent ou un flux de décision.
Si vous évaluez votre propre environnement, gardez la première passe concrète :
Définissez clairement le cas d'usage : recherche, prédiction, aide à la décision ou action autonome
Identifiez les champs et étiquettes critiques : surtout ceux liés au risque métier
Vérifiez doublons, manquants et intégrité des étiquettes : ils cassent souvent la qualité du modèle plus vite que prévu
Contrôlez fraîcheur et stabilité de schéma : en particulier pour les systèmes en direct ou quasi temps réel
Exigez lignage et métadonnées lisibles par machine : pour que les équipes puissent croire et auditer ce que le modèle consomme
Préférez une observabilité dans l'environnement quand les données ne peuvent pas bouger : surtout en contexte réglementé
La plus grosse erreur est de traiter la maturité comme un projet de nettoyage ponctuel. Elle tient davantage de l'ingénierie de fiabilité. Vous établissez des contrôles, définissez des conditions d'exploitation acceptables et continuez de regarder. C'est ainsi que des entrées brutes deviennent une IA digne de confiance.
digna fournit une plateforme d'entreprise de qualité et d'observabilité des données qui aide les équipes à garder fiables les données d'IA dans leur propre environnement, avec des contrôles dans la base pour les anomalies, la Timeliness, la validation et les changements de schéma. Si vos charges d'IA dépendent autant de la confiance à l'exécution que de la préparation initiale, rendez-vous sur digna pour voir comment ce modèle d'exploitation fonctionne en pratique.
La maturité est une cible mouvante, pas un certificat — la gestion de la qualité des données est ce qui garde un jeu de données adapté au modèle qui en dépend déjà.
Questions fréquentes
Que signifient réellement des données prêtes pour l'IA ?
L'exactitude n'est que la première couche. Des données sont prêtes pour l'IA quand elles portent aussi le contexte qui transforme les valeurs en signal exploitable, et quand elles sont traçables et exploitables par la machine, c'est-à-dire qu'un modèle peut les consommer en production sans qu'un humain les assemble d'abord. Des données exactes mais sans contexte bloquent quand même un projet.
Quels sont les piliers de la maturité pour l'IA ?
Six : qualité et exactitude, complétude et représentativité, Timeliness et fraîcheur, étiquetage et intégrité de la cible, gouvernance et traçabilité, exploitabilité et accès. L'intégrité de l'étiquetage est celle que les équipes sautent le plus souvent, et une colonne cible corrompue invalide tout ce qui a été entraîné dessus.
Pourquoi des projets d'IA calent-ils après avoir paru sains ?
Parce que le blocage commence en amont, pas dans le modèle. Un projet semble aller bien jusqu'à ce qu'il touche les données de production et que la confiance doive survivre au contact des systèmes vivants : flux tardifs, schémas dérivés, échantillons peu représentatifs. Le modèle est rarement l'endroit où le problème naît.
Plus de données est-il la réponse à la maturité pour l'IA ?
Non. Plus de données ne répond pas à la bonne question. La maturité est l'adéquation à un cas d'usage précis : le geste utile est d'identifier les éléments de données critiques et de pondérer la liste vers eux, plutôt que d'étendre le volume sur des champs qu'aucun modèle ne consomme.
Comment garder des données prêtes pour l'IA à l'exécution ?
La maturité se dégrade : elle demande une surveillance plutôt qu'une certification unique. Surveillez en continu la fraîcheur par rapport à la fenêtre promise, la stabilité du schéma, le décalage des distributions et l'intégrité des étiquettes. La surveillance assistée par IA aide ici, car elle réduit le réglage manuel des seuils qui rend les règles statiques obsolètes.



