Définition de l'évaluation de la qualité des données : guide pratique
|
7
minute de lecture

Une évaluation de la qualité des données est un processus systématique qui mesure l'adéquation à l'usage (fitness for use) selon plusieurs dimensions, notamment l'exactitude, la complétude, la fraîcheur, la cohérence et le lignage, plutôt qu'au moyen d'un simple contrôle d'exactitude. L'idée moderne est née de la définition de 1996 de la « fitness for use » et intègre aujourd'hui des cadres structurés comme le modèle d'évaluation en six parties du FMI.
Le conseil habituel consiste à nettoyer les données, compter les valeurs nulles et passer à autre chose. Cette approche s'effondre dès qu'un jeu de données techniquement valide arrive en retard, repose sur des définitions métier contradictoires ou perd sa traçabilité avant d'atteindre une charge de travail analytique ou de machine learning.
Table des matières
Repenser la définition de l'évaluation de la qualité des données
Étude de cas - la transformation de la qualité des données chez ITSV
Repenser la définition de l'évaluation de la qualité des données
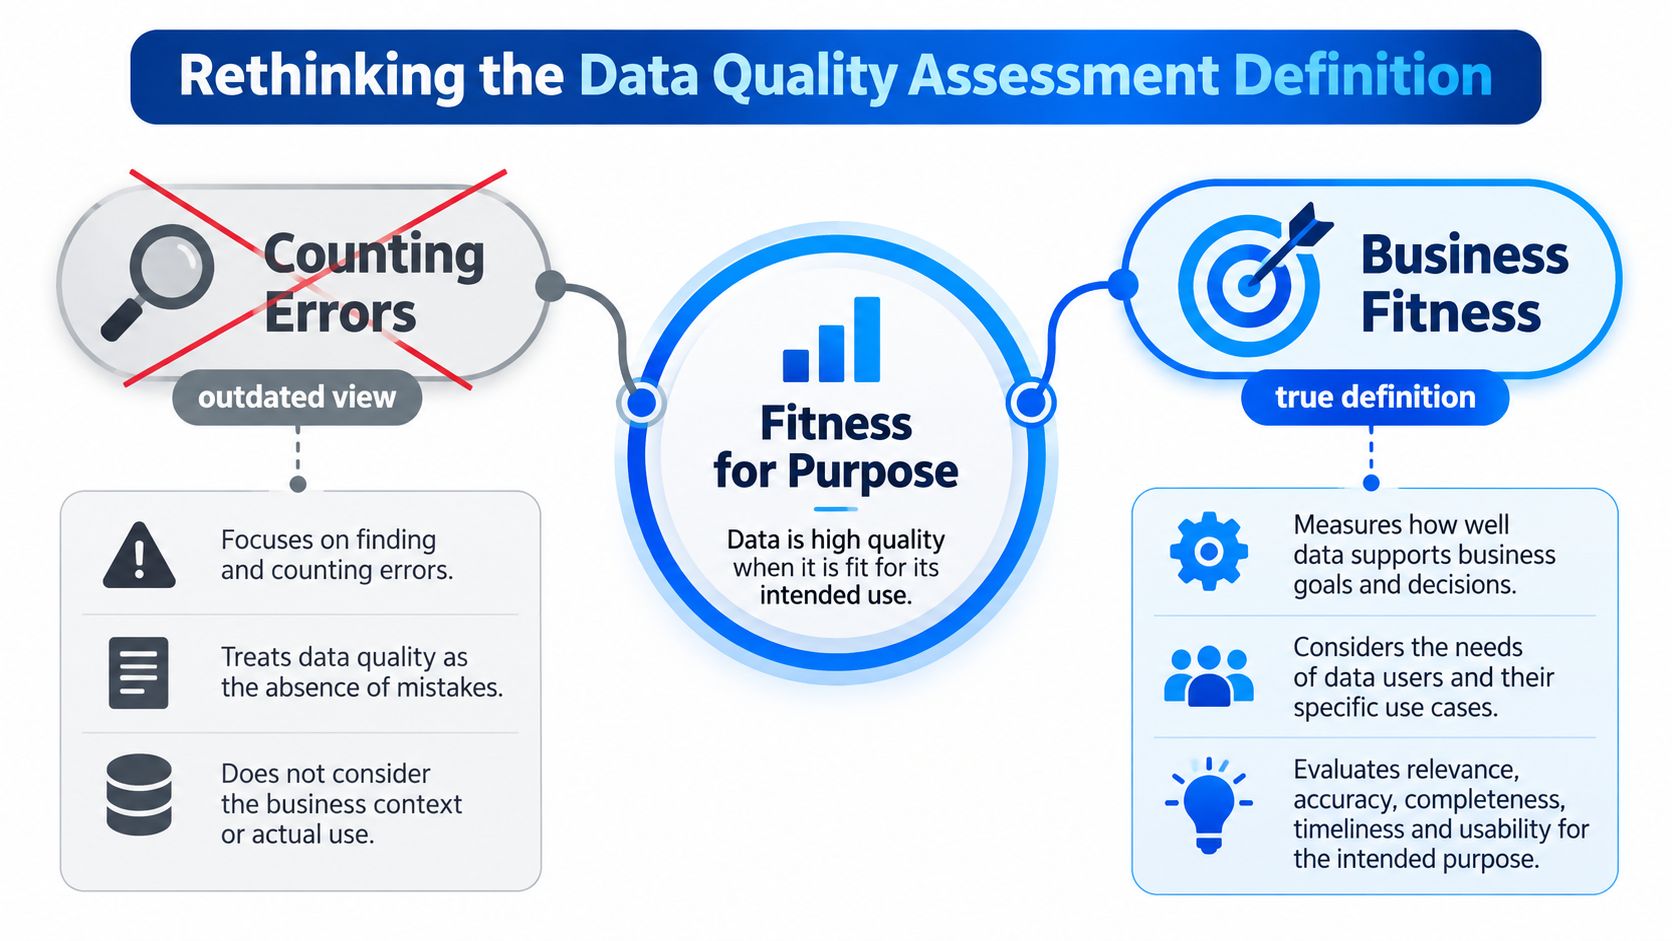
Un jeu de données propre peut tout de même produire un résultat peu fiable. L'évaluation de la qualité des données ne consiste pas à vérifier si les valeurs contiennent des erreurs. C'est un processus fondé sur des normes qui profile les données, mesure les dimensions pertinentes pour leur usage et vérifie si le résultat sert un objectif opérationnel, analytique, réglementaire ou de machine learning.
Une table techniquement valide peut quand même échouer en production. Les enregistrements d'hier peuvent être exacts mais arriver trop tard pour une décision opérationnelle. Un champ renseigné peut masquer une couverture manquante parce qu'un segment de clientèle entier n'est jamais entré dans le jeu de données. Deux systèmes peuvent être cohérents en interne tout en donnant des sens différents à « client actif ». Pour l'analytique et l'IA, ces conflits sémantiques peuvent créer des features qui semblent cohérentes mais représentent des concepts métier différents.
L'approche dite de l'adéquation à l'usage (fitness for use) est apparue dans la recherche académique sur la qualité des données au cours des années 1990. Wang et Strong ont défini en 1996 la qualité des données comme « fitness for use », déplaçant l'attention du nombre d'erreurs vers les besoins des consommateurs de données, comme le documente cette revue de l'histoire de l'évaluation de la qualité des données.
Pourquoi un seul score ne suffit pas
Un score d'exactitude unique ne peut pas montrer si les définitions, le lignage, la fraîcheur et la couverture de la population permettent de prendre une décision. Une évaluation reproductible relie chaque mesure à un objectif documenté et identifie les risques qui comptent pour cette charge de travail.
Usage opérationnel : Le pipeline peut-il livrer des données exploitables au moment où les processus en aval en ont besoin ?
Usage analytique : Les définitions, les jointures et la couverture permettent-elles une conclusion défendable ?
Usage réglementaire : L'organisation peut-elle expliquer la source, les contrôles, les transformations et les preuves derrière le résultat ?
Usage IA : Les données d'entraînement et les features représentent-elles les concepts métier visés de manière suffisamment cohérente pour l'évaluation et le déploiement ?
Statistique Canada décrit la qualité dans sa trousse d'outils sur la qualité des données à travers des caractéristiques telles que la pertinence, la couverture, la granularité, l'exactitude, la fiabilité, la normalisation, l'actualité, la ponctualité, la reproductibilité et la crédibilité. Cette étendue explique pourquoi l'évaluation est un contrôle opérationnel et non un verdict ponctuel. Les schémas, les sources, les définitions, les utilisateurs et les exigences évoluent, si bien que les contrôles et les responsabilités doivent évoluer avec eux.
Pour une introduction plus générale, consultez ce guide sur ce que signifie la qualité des données. La question pratique est de savoir si les bons utilisateurs peuvent s'appuyer sur les données pour une décision précise, et si l'organisation peut démontrer pourquoi.
Les cinq dimensions fondamentales de la qualité des données
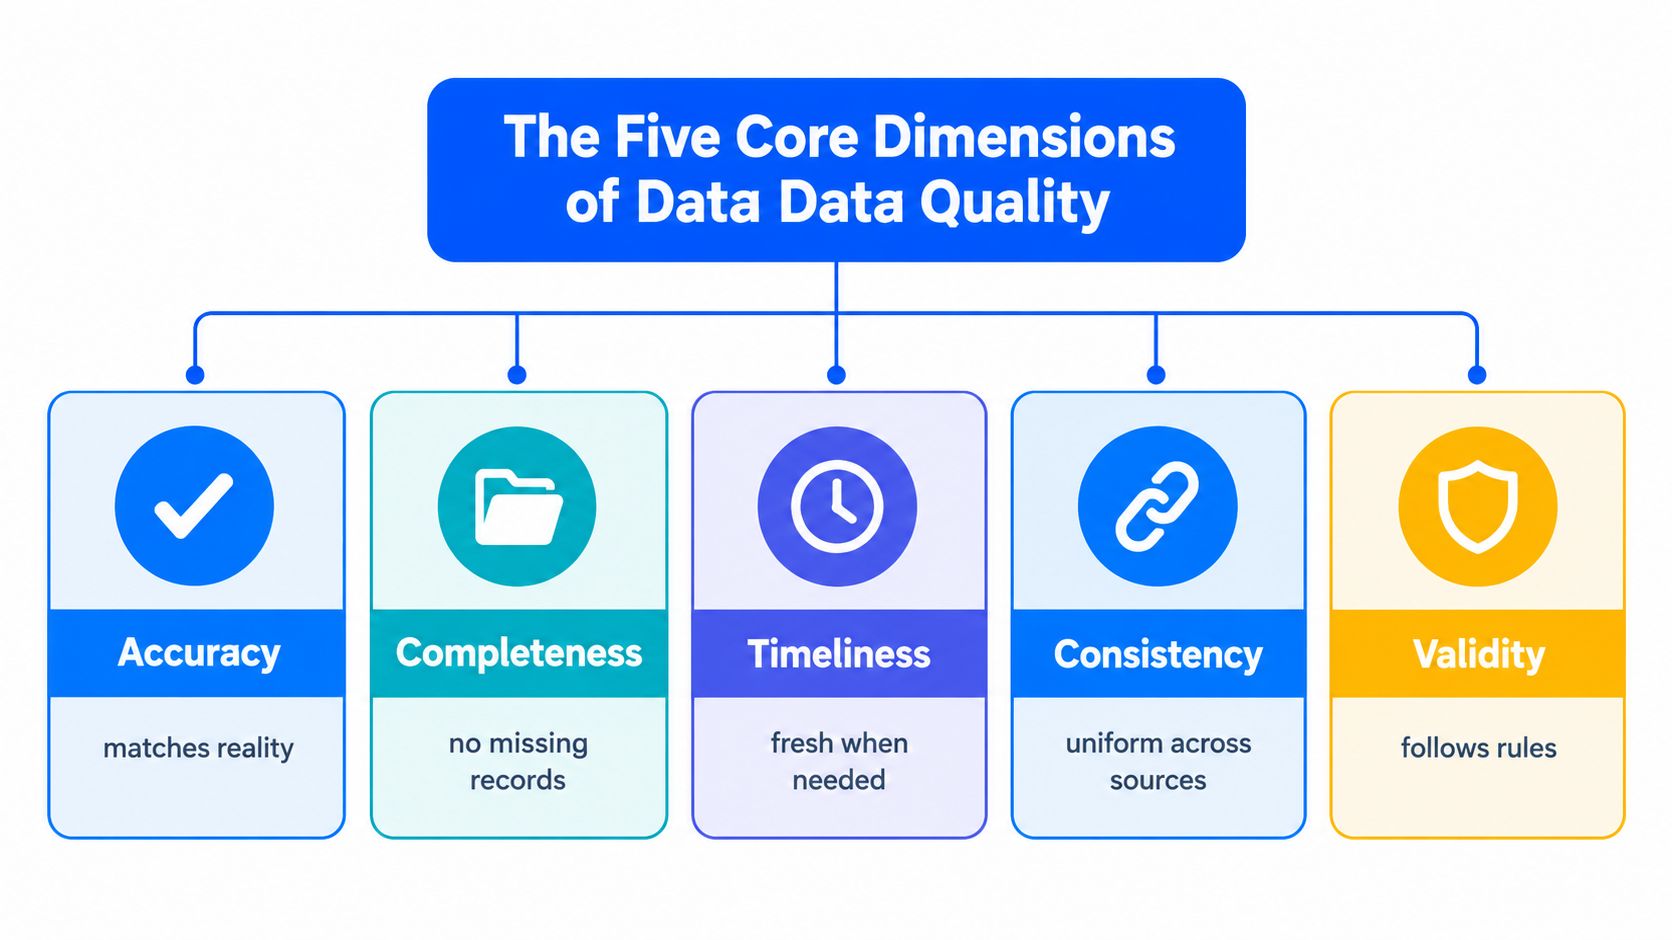
Une évaluation exploitable a besoin d'un petit ensemble de dimensions que les équipes peuvent mesurer de façon répétée et interpréter en contexte. Ces dimensions révèlent des modes de défaillance différents. Un jeu de données peut passer les contrôles de format tout en restant peu fiable pour l'analytique ou le machine learning lorsque ses valeurs portent le mauvais sens métier. Utilisez cette vue d'ensemble des dimensions de la qualité des données comme modèle de mesure, puis adaptez les règles à la charge de travail.
Exactitude : les données reflètent-elles la réalité ou une source faisant autorité ? Une date peut respecter le format requis et être fausse malgré tout. Les contrôles en production peuvent comparer les enregistrements aux systèmes sources, aux données de référence, aux totaux de rapprochement ou aux faits métier validés. En machine learning, des labels ou des features inexacts peuvent produire un modèle aux performances régulières, mais fondé sur des entrées erronées.
Complétude : les enregistrements et attributs requis sont-ils présents ? Distinguez une valeur nulle autorisée d'une valeur manquante qui bloque un processus, une analyse ou une feature de modèle. La couverture compte aussi. Vérifiez les systèmes, les populations et les périodes pertinentes, plutôt que de juger la complétude sur les seules colonnes renseignées.
Fraîcheur : les données arrivent-elles suffisamment à jour pour leur usage prévu ? Un rapport mensuel, une alerte opérationnelle et une feature de modèle peuvent avoir des exigences de fraîcheur différentes. Définissez des fenêtres de livraison acceptables et évaluez la conséquence d'un retard, au lieu de traiter chaque retard comme également grave.
Cohérence : les valeurs, relations et définitions équivalentes concordent-elles entre systèmes et transformations ? Cela inclut les formats et les codes, mais révèle aussi des conflits sémantiques. Deux départements peuvent calculer le même indicateur différemment, laissant des données d'apparence propre qui ne permettent ni une comparaison fiable ni la constitution d'un jeu d'entraînement fiable.
Validité : les valeurs respectent-elles les règles, formats, listes de référence et attentes structurelles déclarés ? Une règle peut confirmer qu'un statut appartient à un ensemble approuvé. Les règles inter-champs vérifient si des attributs liés ont un sens métier ensemble, ce qui détecte des erreurs que la validation au niveau des colonnes ne voit pas.
Ajouter la traçabilité au modèle
Le lignage n'est pas un pilier distinct du modèle visuel, mais les équipes de production en ont besoin pour interpréter chaque résultat. Lorsqu'une règle échoue, les ingénieurs doivent pouvoir identifier la source, la transformation, la table, le rapport ou le modèle concernés. Sans ce chemin, un score décrit un symptôme sans montrer où la remédiation doit avoir lieu.
Les recommandations liées à l'ISO distinguent la qualité syntaxique, la qualité sémantique et la qualité pragmatique. La syntaxe couvre la structure déclarée, la sémantique le sens visé et la pragmatique l'objectif de l'utilisateur, comme l'explique cette présentation des concepts de qualité de l'ISO 8000. Cette distinction évite aux équipes de considérer des données techniquement propres comme automatiquement adaptées à l'analytique ou à l'IA.
Chaque dimension a besoin d'un responsable, d'une règle ou d'un indicateur, d'un seuil acceptable et d'un chemin d'escalade. Des contrôles continus rendent ces mécanismes exploitables au lieu de laisser le modèle à l'état de checklist.
Contexte historique et normes
La définition de l'évaluation de la qualité des données s'est construite par étapes. Les travaux académiques des années 1990 ont élargi la qualité, de la simple exactitude vers la notion d'adéquation à l'usage. La normalisation formelle a suivi, l'ISO publiant sa norme sur la qualité des données en 2011, comme le rappelle la revue historique citée plus haut. Ce glissement reste important, car une valeur peut être proprement formatée et techniquement valide tout en portant le mauvais sens métier pour un analyste ou un modèle de machine learning.
Le FMI a élaboré son Data Quality Assessment Framework après une discussion de son conseil d'administration en décembre 1997. Un document a été présenté en juillet 2001 et le cadre a été décrit publiquement en 2003. Sa structure comprend six parties, en commençant par les conditions préalables de la qualité, puis en examinant cinq dimensions supplémentaires. Le Data Quality Assessment Framework du FMI sépare les conditions favorables, dont la gouvernance et les dispositions institutionnelles, de la qualité des produits et processus statistiques.
Cette séparation met en lumière un échec courant en entreprise. Une équipe peut produire des enregistrements techniquement corrects via un processus non documenté, ou maintenir une gouvernance formelle alors que ses données restent incomplètes. Aucun de ces résultats n'est fiable pour le reporting, les prévisions ou l'entraînement de l'IA. Une évaluation doit donc examiner les responsabilités, les conditions juridiques, la documentation, la capacité des processus et le sens attribué à chaque champ, et pas seulement les valeurs stockées.
La norme ISO sur le profilage des données considère le profilage comme le fondement de l'évaluation. Le profilage fournit des analyses de colonnes et des statistiques sur les jeux de données, mais les ingénieurs doivent encore rapprocher ces observations des exigences métier et des dimensions de qualité. L'ISO 8000-61 relie également la gestion de la qualité des données à la capacité des processus et à la maturité organisationnelle.
Les normes transforment les opinions en preuves
Les normes ne suppriment pas le jugement. Elles le rendent explicite et reproductible. Une équipe soumise à la réglementation peut documenter pourquoi un seuil de fraîcheur existe, quels enregistrements sont concernés, comment un échec est calculé et qui accepte le risque résiduel.
Cette piste d'audit rend les recommandations publiques utiles aussi dans un contexte commercial. L'approche de l'EPA en matière d'évaluation de la qualité des données la présente comme une évaluation scientifique et statistique visant à déterminer si les données ont le bon type, la bonne qualité et la bonne quantité pour leur usage prévu. Le même principe s'applique à la finance, à la santé et à l'analytique du secteur public.
Les équipes qui recherchent un contexte de gouvernance plus large peuvent associer les normes aux recommandations du DAMA DMBOK. Le test pratique est simple : un cadre mérite sa place lorsque les ingénieurs et les responsables des données peuvent s'en servir pour prendre des décisions cohérentes sur le risque sémantique, l'adéquation des modèles et la remédiation.
Les risques opérationnels d'une évaluation insuffisante
Une évaluation insuffisante échoue rarement avec un signal d'alerte rouge évident. Le plus souvent, un pipeline réussit techniquement tout en livrant des données qui ne soutiennent plus la décision qui en dépend.
Un tableau de bord obsolète est un échec de fraîcheur. Une colonne source renommée qui traverse une transformation non surveillée est un échec de schéma et de lignage. Un rapport qui combine deux mesures valides mais définies différemment est un échec de cohérence et de sémantique. Chacun de ces problèmes peut rester invisible tant que les équipes ne surveillent que les valeurs nulles, les formats ou la validité au niveau des lignes.
Ce qui casse en premier
L'incident visible se situe souvent en aval du défaut de qualité :
Les tableaux de bord perdent leur crédibilité : les analystes trouvent des chiffres contradictoires et commencent à rapprocher des extractions à la main.
Les pipelines masquent les retards : un statut de job réussi peut cacher un fichier arrivé en retard ou ne contenant qu'un chargement partiel.
Les schémas dérivent sans prévenir : des colonnes ajoutées, supprimées ou dont le type change peuvent modifier le comportement en aval sans produire d'erreur applicative.
Les modèles héritent de l'ambiguïté : un workflow de machine learning peut traiter des définitions contradictoires comme des features comparables parce que les valeurs semblent structurellement valides.
La remédiation ralentit : sans lignage ni responsabilités définies, les équipes débattent de l'origine du problème au lieu de corriger le processus en cause.
Le coût ne se limite pas aux reprises. Les utilisateurs peuvent cesser de faire confiance aux jeux de données gouvernés et créer des tableurs privés ou des requêtes parallèles. Les ingénieurs doivent alors maintenir plusieurs versions non officielles du même indicateur, ce qui complique les évaluations futures.
Règle pratique : évaluez les modes de défaillance qui peuvent invalider la décision, pas seulement les défauts les plus faciles à compter.
L'évaluation continue répond à cette réalité opérationnelle. Les équipes peuvent profiler les données lors de l'onboarding, mais la surveillance en production doit suivre dans le temps le comportement de livraison, les distributions, les changements structurels, les résultats de validation et les indicateurs métier. L'objectif n'est pas d'éliminer toutes les anomalies. Il s'agit d'identifier tôt les changements significatifs, de les relier aux consommateurs concernés et de donner à un responsable suffisamment d'éléments pour agir.
Règles manuelles ou observabilité continue
Les règles écrites à la main ont toujours leur place. Elles fonctionnent bien lorsqu'une exigence est explicite, stable et importante sur le plan juridique ou opérationnel. Un champ obligatoire, un code de statut approuvé ou une condition d'intégrité référentielle doivent rester déterministes, car l'organisation a besoin d'une décision claire de type réussite ou échec.
Les difficultés commencent quand les équipes utilisent des règles manuelles pour chaque cas de figure possible. Les bibliothèques de règles grossissent plus vite que leurs responsables ne peuvent les relire, et une règle pertinente pour le schéma de l'an dernier peut devenir obsolète après une migration. Les contrôles statiques ont aussi tendance à détecter les défauts connus tout en manquant des changements inhabituels mais valides de volume, de calendrier, de distribution ou de comportement.
Approche d'évaluation | Scalabilité | Maintenance | Capacité de détection |
|---|---|---|---|
Règles déterministes manuelles | Solide pour des contrôles ciblés et bien définis | Exige des responsables, des revues et des mises à jour à mesure que les exigences évoluent | Efficace pour les conditions connues et les contraintes métier |
Profilage périodique | Utile pour explorer des jeux de données inconnus | Faible continuité opérationnelle entre deux évaluations | Repère motifs, valeurs nulles, distributions et valeurs aberrantes au moment de la revue |
Observabilité continue | Passe à l'échelle sur des pipelines changeants lorsque les baselines et les responsabilités sont gérées | Exige réglage, tri des incidents et discipline de gouvernance | Détecte les écarts de comportement, de fraîcheur, de structure et de tendances de qualité |
Évaluation hybride | Combine surveillance large et contrôles précis | Équilibre la maintenance entre les types de règles | Couvre à la fois les exigences explicites et les anomalies jusque-là inconnues |
Trouver le bon équilibre
Les règles manuelles conviennent lorsque le métier peut formuler l'exigence précisément et expliquer pourquoi une violation compte. La détection continue est plus utile pour les comportements qui varient naturellement, comme les délais de livraison ou les distributions des jeux de données. Les méthodes statistiques et de machine learning peuvent établir des schémas attendus, mais elles ne remplacent pas le contexte métier. Un résultat inhabituel peut être un défaut, une variation saisonnière légitime ou un changement planifié.
En production, le modèle qui fonctionne le mieux associe généralement validation déterministe et surveillance adaptative. L'une impose ce qui doit toujours être vrai. L'autre surveille les changements que personne n'a pensé à coder à l'avance.
Les équipes qui évaluent ce compromis peuvent aussi consulter cette discussion sur les règles techniques de qualité des données maintenues manuellement. La décision de conception importante n'est pas de savoir si les règles ou l'observabilité l'emportent. Il s'agit de déterminer quelles preuves exigent une politique fixe et quels comportements méritent une comparaison continue avec une baseline qui évolue.
Réaliser une évaluation de la qualité des données
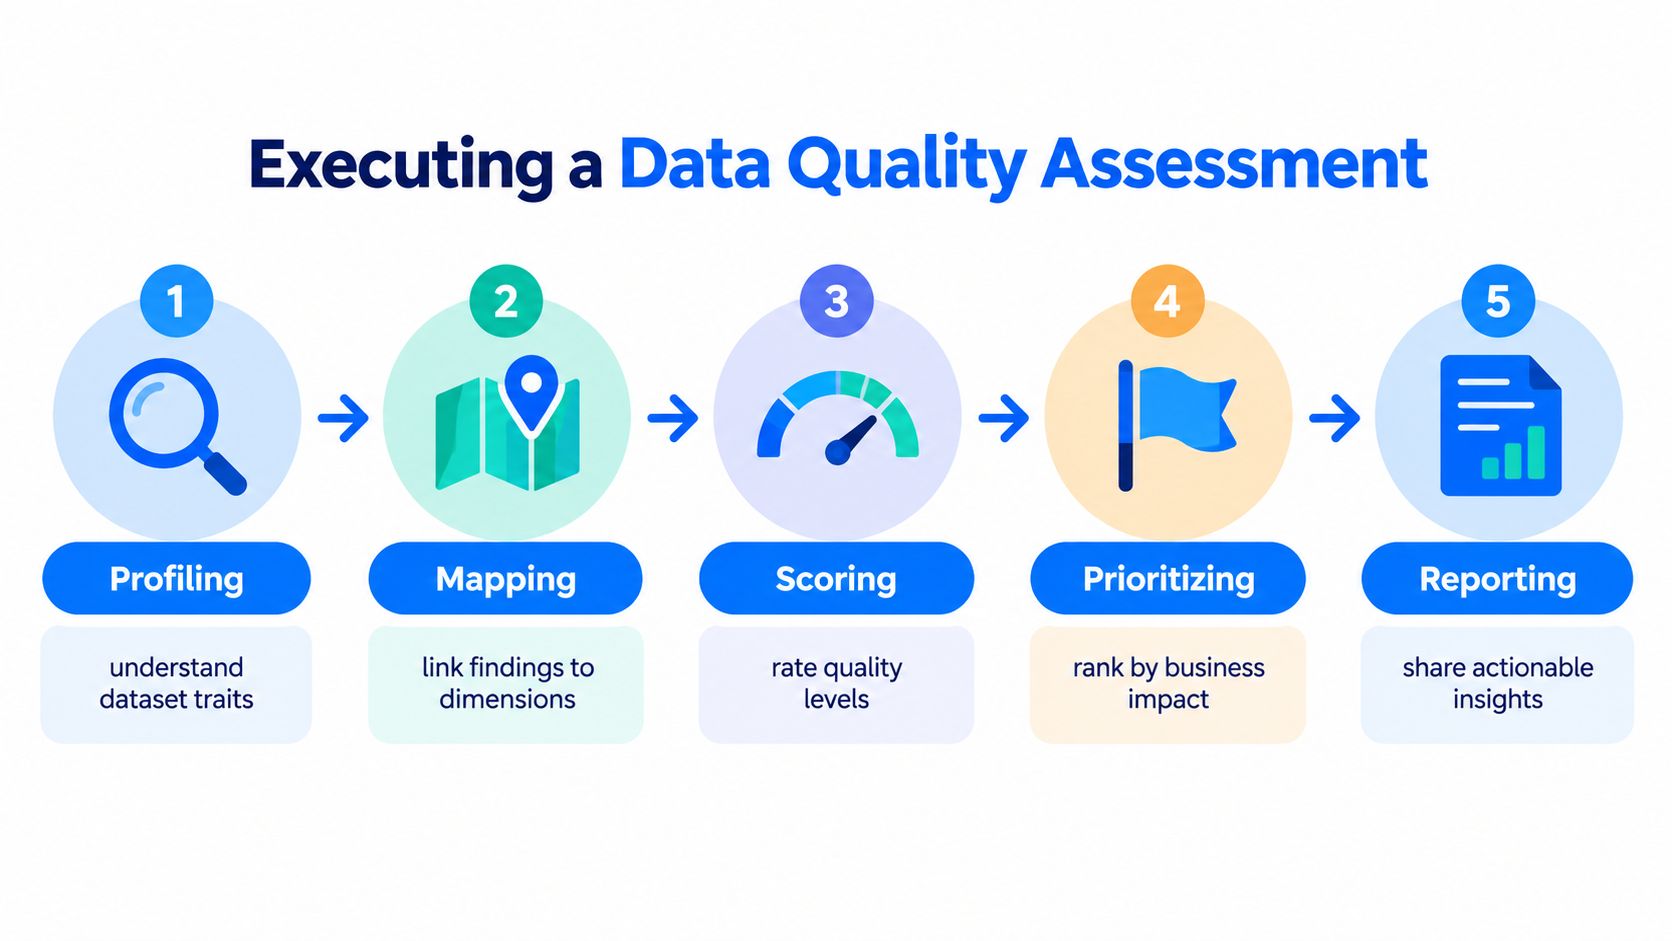
Une évaluation utile transforme les observations en décisions. Le workflow suivant maintient le lien entre profilage, mesure, contexte métier et remédiation.
Commencer par le profilage
Commencez par examiner la structure et le comportement du jeu de données. Consignez les colonnes, les types, les motifs de valeurs, les valeurs nulles, l'unicité, les distributions, les relations, l'historique de livraison et les métadonnées disponibles. Le profilage relève de la découverte, pas de l'évaluation finale. Il vous dit ce qui semble se passer, mais ne décide pas si ce comportement est acceptable.
Rapprocher les constats de l'usage prévu
Ensuite, identifiez les consommateurs et la décision que les données soutiennent. Rattachez chaque constat à des dimensions telles que l'exactitude, la complétude, la fraîcheur, la cohérence, la validité et le lignage. Puis consignez les exigences sémantiques que le profilage technique ne peut pas déduire, notamment les définitions métier, le périmètre, les responsabilités et la source faisant autorité.
Une valeur manquante peut être acceptable dans un workflow et rédhibitoire dans un autre. Un changement de distribution peut signaler une dérive des données, ou refléter un événement métier légitime. C'est le contexte qui détermine l'interprétation.
Définir des seuils
Fixez des attentes mesurables par jeu de données plutôt que d'appliquer des valeurs par défaut à toute l'organisation. Parmi les contrôles utiles figurent les champs obligatoires et facultatifs, les taux de valeurs nulles acceptables, les limites de fraîcheur, la détection des changements de schéma, les volumes de lignes attendus, les valeurs autorisées et les conditions de rapprochement. Des recommandations de qualité fondées sur des normes insistent sur des dimensions explicites et des exigences documentées, ce qui rend les résultats plus reproductibles.
Valider et prioriser
Appliquez des règles métier au niveau des enregistrements en parallèle d'une surveillance au niveau des jeux de données. Classez ensuite les échecs selon leur impact métier, les consommateurs concernés, l'exposition réglementaire et l'effort de remédiation. Un petit défaut dans un champ réglementaire critique peut mériter une action plus rapide qu'un défaut plus important dans un attribut inutilisé.
Le modèle de mesure orienté secteur public propose un schéma pratique : identifier des assertions liées aux politiques, les relier à l'impact métier, catégoriser les défauts, quantifier leur contribution à la conformité et présenter les résultats dans un format qui permet d'explorer le détail.
Rendre compte et industrialiser
Enfin, publiez le résultat avec les preuves, les responsables, les actifs concernés et la prochaine action. Intégrez les contrôles au pipeline ou à la couche d'observabilité afin que la même évaluation s'exécute à chaque changement des données, et pas seulement quand quelqu'un pense à lancer un audit.
Un workflow d'audit de la qualité des données pratique doit conserver l'historique. Suivez les résultats dans le temps, consignez les exceptions acceptées et vérifiez la remédiation. Sans preuves historiques, les équipes ne peuvent pas distinguer un nouvel incident d'un défaut récurrent.
Étude de cas - la transformation de la qualité des données chez ITSV
ITSV, l'épine dorsale informatique de la sécurité sociale autrichienne, faisait face à la charge de maintenance d'une vaste collection de règles de qualité écrites à la main. L'organisation a remplacé 9 000 règles créées manuellement par digna Data Anomalies et Data Timeliness, passant d'un modèle centré sur la maintenance de règles à une observabilité continue.
La valeur de ce changement ne tenait pas seulement à la réduction du nombre de règles. ITSV avait besoin d'une approche de surveillance capable d'accompagner la croissance de son environnement de données sans exiger des spécialistes qu'ils se souviennent de chaque comportement attendu. La détection continue des anomalies a contribué à réduire le bruit des alertes, tandis que la surveillance de la fraîcheur concentrait l'attention sur l'arrivée des données conformément au comportement opérationnel attendu.

Ce que montre l'exemple
Cette transformation illustre trois leçons pratiques :
Le volume de règles n'est pas la maturité de la qualité : des milliers de contrôles peuvent créer une lourde charge de maintenance sans couvrir la dérive sémantique ni les comportements inattendus.
La surveillance adaptative préserve l'attention : réduire les alertes inutiles laisse aux ingénieurs plus de temps pour examiner les changements significatifs.
Le savoir doit vivre dans le système : un processus de surveillance qui dépend de la mémoire individuelle devient fragile quand des personnes changent de poste ou partent.
L'exemple d'ITSV ne rend pas les règles déterministes obsolètes. Les exigences métier critiques ont toujours besoin d'une validation explicite. Il montre pourquoi les équipes ont intérêt à combiner ces contrôles avec une surveillance qui apprend le comportement normal des jeux de données et signale les écarts pour examen.
Le modèle opérationnel le plus solide attribue aussi des responsabilités après la détection. Une anomalie sans contexte, sans lignage et sans responsable devient un ticket de plus dans un backlog. Une anomalie reliée à un processus concerné et à un décideur clairement identifié peut devenir un workflow de remédiation maîtrisé.
Considérations pour une mise en œuvre en entreprise
L'adoption en entreprise réussit lorsque l'architecture d'évaluation respecte la sécurité, la gouvernance et la façon dont les équipes travaillent déjà. Déplacer les données vers un service de surveillance distinct peut créer une exposition, une duplication et des frictions d'approbation inutiles. L'exécution in-database garde le calcul et l'analyse des métriques dans les bases de données du client : les données restent en place et les équipes reçoivent tout de même des preuves de qualité.
La flexibilité du déploiement compte tout autant. Une installation en cloud privé ou on-premises convient aux organisations qui ont besoin de contrôles dans leur propre cloud, leur cloud privé virtuel ou leur data center. Le bon choix dépend de la politique de sécurité, de l'architecture réseau, de la responsabilité opérationnelle et de la rapidité avec laquelle la plateforme doit se connecter aux entrepôts de données et pipelines existants.
Concevoir pour une responsabilité partagée
Un data engineer a besoin des détails de l'incident et du lignage. Un analytics engineer doit comprendre le comportement des métriques. Un acteur métier a besoin d'un statut clair et d'une description de l'impact. Un tableau de bord centré sur l'utilisateur doit servir ces trois publics sans obliger chaque groupe à construire sa propre interprétation.
Recherchez une mise en œuvre qui inclut dès le départ les fondamentaux opérationnels :
Calcul in-database : conservez les données sources dans l'environnement contrôlé par le client.
Adoption modulaire : commencez par la capacité qui traite le risque le plus urgent, puis élargissez à mesure que les responsabilités et la mesure gagnent en maturité.
Planification intégrée : exécutez les évaluations de manière cohérente au lieu de dépendre de scripts ad hoc.
Catalogue et collaboration : reliez les constats aux actifs, aux responsables, aux incidents et aux décisions.
Logique commerciale transparente : comprenez comment les tables actives, les modules, les environnements et le support influencent le modèle de coûts.
La surveillance pilotée par l'IA peut réduire la maintenance manuelle, mais elle a toujours besoin de gouvernance. Les équipes doivent revoir les baselines, expliquer les exceptions, protéger les données sensibles et décider quels constats bloquent l'usage en aval. L'automatisation doit supprimer le travail répétitif de détection et de routage, pas la responsabilité.
La meilleure mise en œuvre n'est donc ni un gigantesque projet d'écriture de règles ni une couche opaque de machine learning. C'est un système maîtrisé qui combine des règles métier explicites, une détection adaptative des anomalies, le lignage, la surveillance de la fraîcheur, la prise en compte des schémas et des responsabilités visibles.
digna fournit une plateforme de qualité des données et d'observabilité pour les entreprises, qui s'exécute dans l'environnement du client, avec détection des anomalies, surveillance de la fraîcheur, validation au niveau des enregistrements, suivi des schémas, exécution in-database et tableaux de bord partagés pour les équipes data et les parties prenantes. Rendez-vous sur digna pour découvrir comment une évaluation continue peut rendre les données plus fiables pour l'analytique et l'IA.
Les règles couvrent les défaillances que vous pouvez prévoir ; pour les autres, digna Data Anomalies apprend le volume, la distribution et le comportement normaux de chaque table et signale les écarts qu'aucune règle écrite à la main n'avait anticipés.
Questions fréquentes
Qu'est-ce qu'une évaluation de la qualité des données ?
Une évaluation de la qualité des données est un processus fondé sur des normes qui profile les données, mesure les dimensions pertinentes pour leur usage et vérifie si elles servent un objectif opérationnel, analytique, réglementaire ou de machine learning. Elle va au-delà du simple comptage d'erreurs, car une table techniquement valide peut tout de même arriver trop tard ou porter le mauvais sens métier.
Quelles sont les dimensions de l'évaluation de la qualité des données ?
L'article retient cinq dimensions fondamentales : l'exactitude, la complétude, la fraîcheur, la cohérence et la validité, complétées par le lignage pour la traçabilité. Le lignage n'est pas un pilier distinct, mais il permet aux ingénieurs de remonter d'une règle en échec jusqu'à la source, la transformation, la table, le rapport ou le modèle concernés, afin que la remédiation intervienne au bon endroit.
Qui a défini la qualité des données comme l'adéquation à l'usage ?
Wang et Strong ont défini en 1996 la qualité des données comme l'adéquation à l'usage (fitness for use), déplaçant l'attention du nombre d'erreurs vers les besoins des consommateurs de données. La normalisation formelle a suivi avec la publication par l'ISO de sa norme sur la qualité des données en 2011, et le FMI a décrit publiquement son Data Quality Assessment Framework en six parties en 2003.
Comment réaliser une évaluation de la qualité des données étape par étape ?
Commencez par profiler la structure, les valeurs nulles, les distributions et l'historique de livraison, puis rattachez les constats à l'usage prévu et à ses consommateurs. Fixez ensuite des seuils par jeu de données, comme des limites de fraîcheur et des taux de valeurs nulles acceptables, classez les échecs selon leur impact métier et intégrez enfin les contrôles au pipeline pour que l'évaluation se relance à chaque changement des données.
Les contrôles de qualité des données doivent-ils reposer sur des règles manuelles ou sur une surveillance automatisée ?
La plupart des équipes ont besoin des deux : des règles déterministes pour les exigences qui doivent toujours être respectées, et une surveillance adaptative pour les comportements que personne n'a codés à l'avance. ITSV, l'épine dorsale informatique de la sécurité sociale autrichienne, a remplacé 9 000 règles écrites à la main par digna Data Anomalies et Data Timeliness, tout en conservant une validation explicite pour les exigences métier critiques.



