Contrôle qualité des données en recherche : guide pratique
|
6
minute de lecture
On découvre rarement les problèmes de qualité des données tant que le jeu de données est encore tout frais de la collecte. On les découvre après qu’un tableur a été copié, qu’un fichier a été fusionné, qu’un nom de champ a changé, et que quelqu’un demande pourquoi une ligne affiche désormais une date impossible ou un suivi manquant que personne n’a signalé à temps. Voilà à quoi ressemble le contrôle qualité des données en recherche : ce n’est pas une checklist bien rangée en fin de parcours, c’est une chaîne de contrôles qui doit résister à chaque passage de relais.
Table des matières
Pourquoi le contrôle qualité des données en recherche échoue en silence
Une équipe de recherche peut passer des semaines à collecter des enregistrements d’apparence propre et hériter malgré tout d’un désordre. Les défaillances restent souvent invisibles, car la transcription, le transfert, les mises à jour et les enregistrements sont autant d’occasions de dérive silencieuse, et beaucoup d’équipes ne contrôlent la qualité qu’au moment de la collecte. Lorsque quelqu’un remarque enfin une valeur aberrante ou une variable manquante, le formulaire source est peut-être enfoui, le schéma a peut-être évolué, et le nettoyage se transforme en reconstruction.
C’est pourquoi les systèmes les plus solides traitent la qualité comme une obligation tout au long du cycle de vie, et non comme un audit ponctuel. Un bon point de départ consiste à examiner les raisons structurelles pour lesquelles les projets échouent et à corriger le processus qui les entoure, pas seulement les symptômes, comme l’explique cette note pratique sur les raisons de l’échec des projets de qualité des données.
Règle pratique : si un enregistrement peut changer de mains, il peut perdre son intégrité.
La suite de ce guide s’appuie sur cinq éléments qui tiennent sous la pression : la validation à chaque étape de manipulation, des seuils mesurables, la provenance et la documentation, la reproductibilité et les pistes d’audit. Cette combinaison compte, car les erreurs les plus graves ne sont pas spectaculaires : elles sont banales, et ce sont précisément les erreurs banales qui échappent aux équipes qui ne contrôlent qu’à la ligne d’arrivée.
Les cinq dimensions de la qualité des données
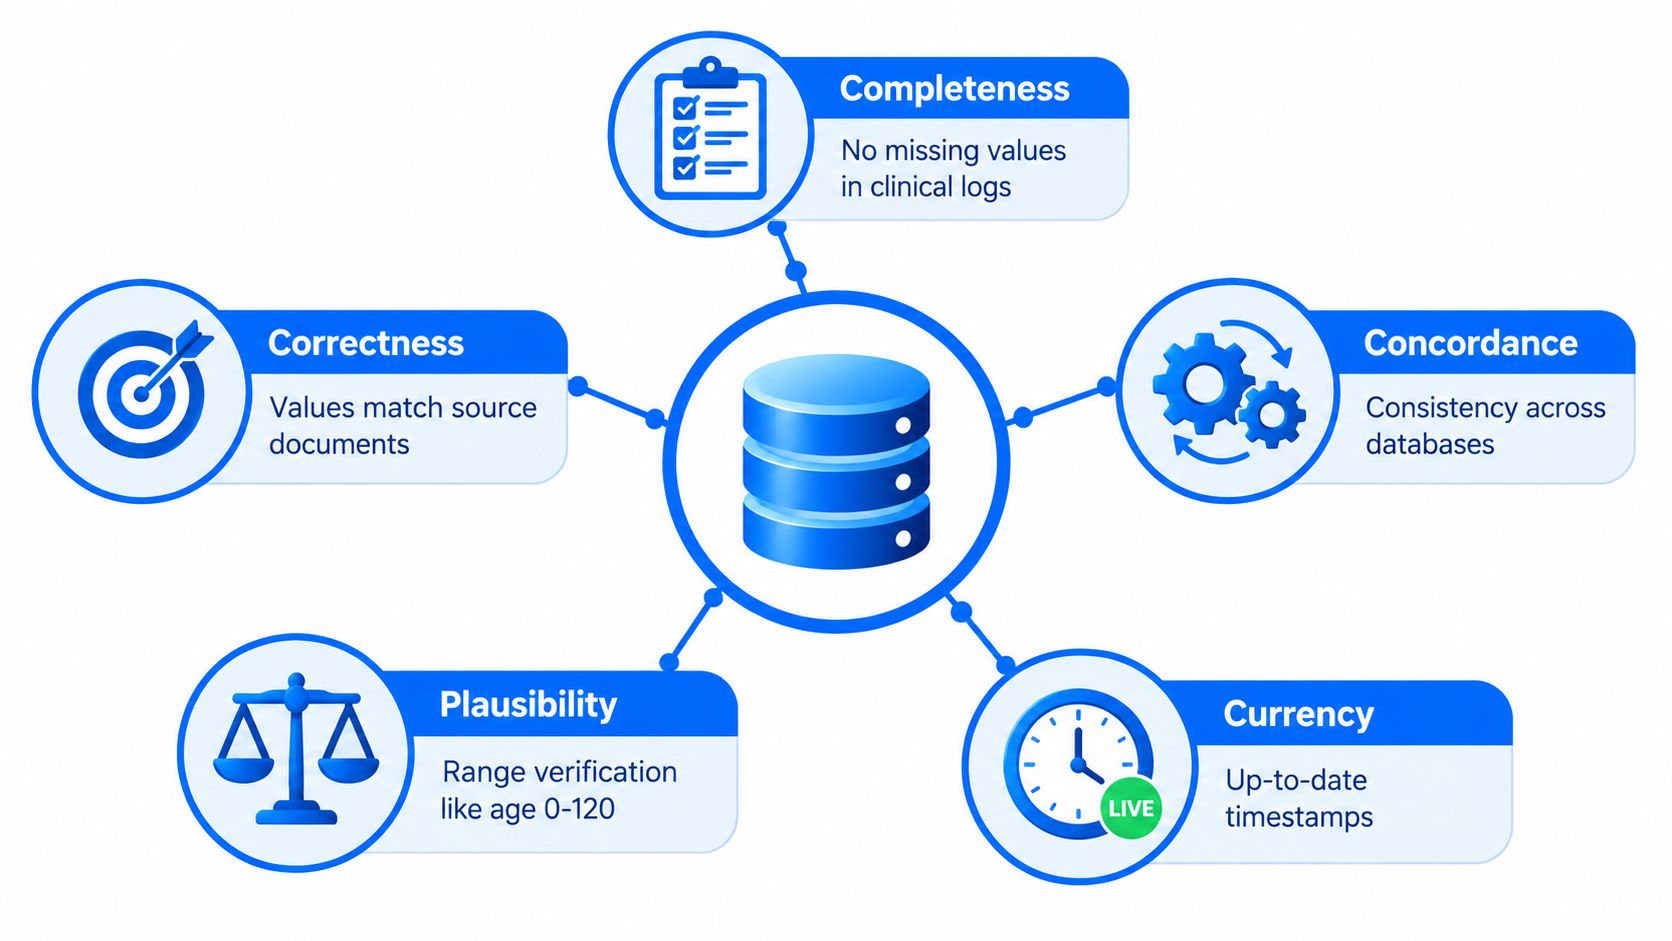
Un bon contrôle qualité commence par un langage commun. Quand une équipe dit « les données ont l’air correctes » sans préciser ce qu’elle a vérifié, ses membres ne parlent généralement pas de la même chose. Les cinq dimensions, l’exhaustivité, l’exactitude, la concordance, la plausibilité et l’actualité, permettent à l’équipe de distinguer les données manquantes des contradictions, et les données obsolètes des valeurs impossibles.
Ce que détecte chaque dimension
L’exhaustivité concerne les lacunes. Une visite de suivi manquante, un champ de laboratoire vide ou une date de consentement omise relèvent de cette dimension, et ce n’est pas le même problème que des valeurs erronées. Un simple rapport hebdomadaire d’exhaustivité sur les champs clés suffit à révéler où se concentrent les trous.
L’exactitude consiste à vérifier qu’une valeur correspond à la source. Si une date de naissance est mal saisie ou si un résultat de laboratoire est copié depuis la mauvaise ligne, le nombre peut être parfaitement formaté tout en étant faux. Un contrôle pratique consiste à comparer de manière ciblée avec les documents sources un petit échantillon des enregistrements les plus importants.
La concordance désigne la cohérence entre systèmes. Deux bases de données qui ne s’accordent pas sur le statut d’inclusion d’un même participant génèrent plus tard un travail de rapprochement ; comparez donc tôt les identifiants, les dates de visite et les indicateurs de statut entre systèmes. C’est là que de nombreuses équipes accordent une confiance excessive à la table « maître » et oublient qu’elle n’est que le dernier endroit où l’erreur a atterri.
La plausibilité détecte les valeurs techniquement valides mais peu crédibles. Un âge de 0 dans une cohorte d’adultes, une date de sortie antérieure à la date d’admission ou une séquence d’horodatages invraisemblable doivent déclencher une revue, même si le champ passe les contrôles de format. C’est généralement là que les équipes ont besoin d’alertes fondées sur des règles, et pas seulement d’une inspection humaine.
L’actualité correspond à la fraîcheur des données. Un enregistrement peut être exact et pourtant trop ancien pour être exploité, en particulier dans les études longitudinales où les changements de statut comptent. Un horodatage périmé ou une mise à jour tardive mérite son propre contrôle, car les données obsolètes se font souvent passer pour des données complètes.
L’article sur les dimensions de la qualité des données est utile si votre équipe a besoin d’un vocabulaire commun avant de rédiger des règles. Les équipes surpondèrent souvent l’exactitude et contrôlent trop peu la plausibilité et l’actualité, précisément là où se cachent les défaillances silencieuses.
Test d’utilité : si un contrôle ne peut pas vous dire quel type de problème il a trouvé, il n’est pas encore assez précis.
Associer une validation à chaque étape de manipulation
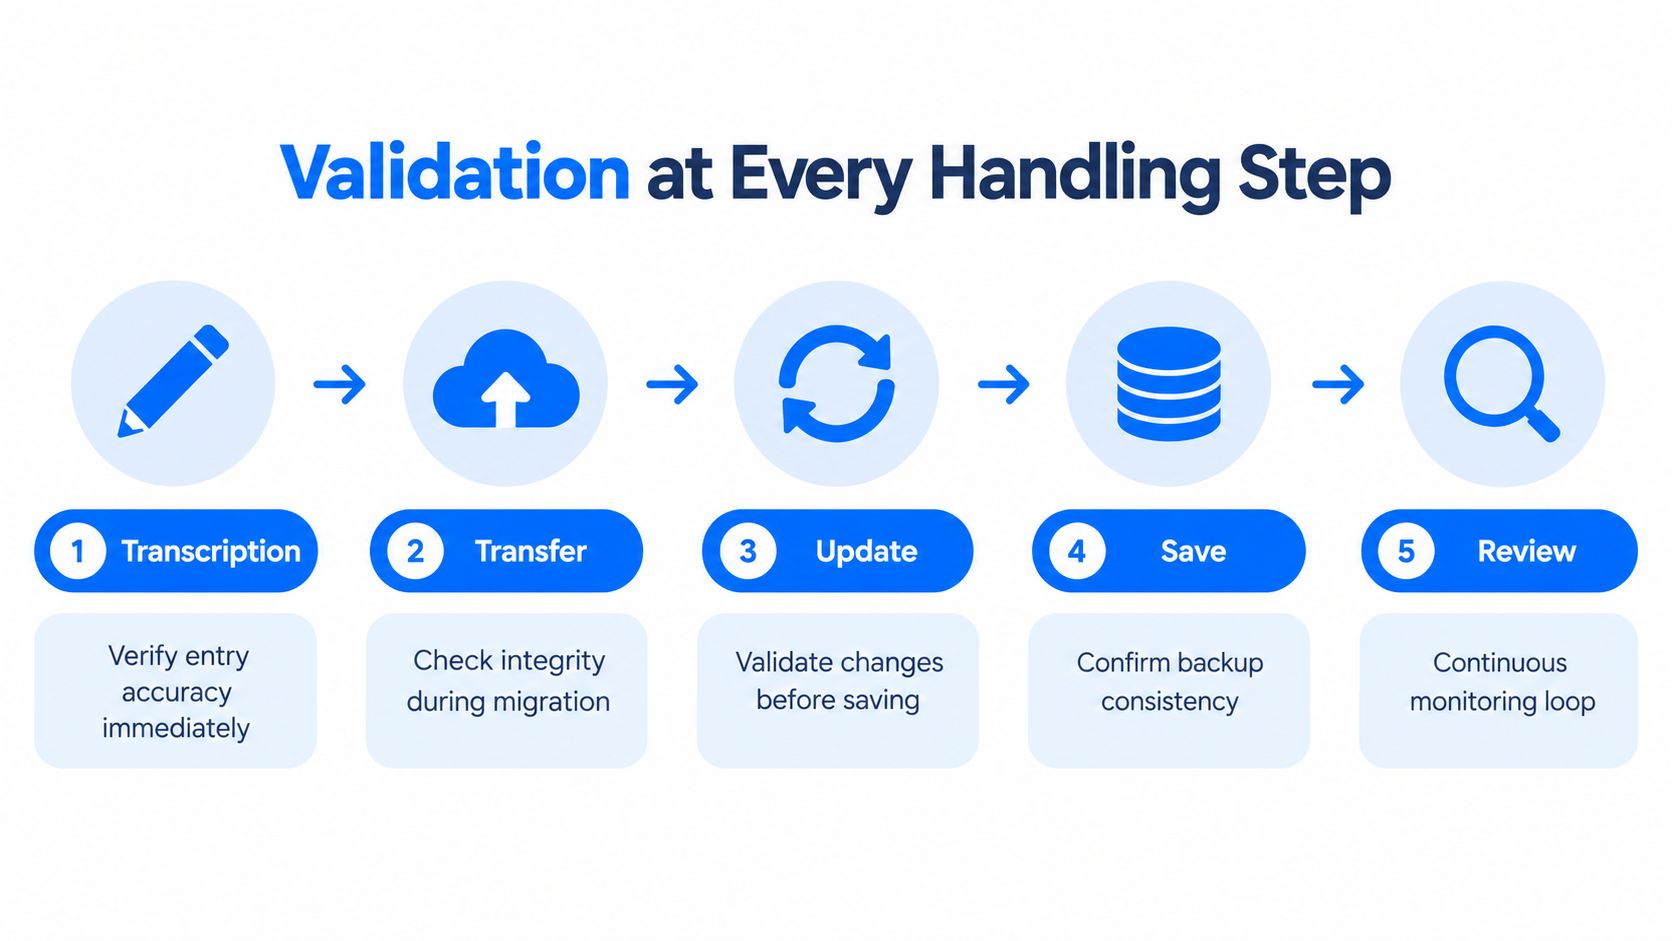
Le contrôle qualité a sa place à chaque point où les données sont manipulées, et pas seulement lors d’une revue finale. Les recommandations en recherche clinique sont explicites : la validation doit avoir lieu lorsque les données sont transcrites, transférées, mises à jour ou enregistrées sur un nouveau support, et les procédures classiques comprennent la double saisie, des contrôles programmatiques de plage et de cohérence, une revue régulière du taux d’erreur et une revue par un responsable ou un pair. L’objectif est l’auditabilité, car chaque étape de manipulation est un endroit où une erreur peut être introduite ou dissimulée.
D’un formulaire papier jusqu’à l’analyse
Commencez par les formulaires papier. Lors de la transcription, une personne saisit l’enregistrement et une autre revérifie un échantillon ou procède à une double saisie des champs faciles à mal taper, comme les dates ou les mesures numériques. Un simple journal des écarts est ici rapidement rentabilisé.
Lorsque les données passent dans un tableur, exécutez immédiatement des contrôles de plage et des règles de cohérence. Une date de naissance dans le futur, un code de visite manquant ou une valeur de laboratoire hors du domaine autorisé doivent bloquer le fichier avant que quiconque ne commence l’analyse.
Lorsque le tableur devient une base de données d’analyse, contrôlez le transfert lui-même. Cela signifie comparer le nombre de lignes, les identifiants clés et tous les champs susceptibles d’être tronqués, recodés ou convertis de type. Si la base de données est le premier endroit où un problème apparaît, vous avez déjà perdu la possibilité de savoir s’il provient de la saisie ou de la migration.
Après les mises à jour, soumettez les modifications à la revue d’un pair ou d’un responsable. Cette revue n’a pas besoin d’être solennelle ; elle doit répondre à une seule question : la mise à jour a-t-elle préservé le sens de l’enregistrement ?
La page consacrée aux règles de validation et contrôles continus illustre bien la manière dont les équipes mettent en œuvre ces garde-fous dans des systèmes qui tournent chaque jour. L’essentiel est de rattacher le contrôle à l’étape, car un balayage périodique effectué après trois passages de relais arrive déjà trop tard.
Un contrôle effectué après le transfert vaut mieux que rien, mais ce n’est pas la même chose que de maîtriser le transfert lui-même.
Des seuils mesurables pour le suivi de la qualité
Le contrôle qualité devient opérationnel dès que l’équipe s’accorde sur des chiffres plutôt que sur des slogans. Des seuils défendables, des responsables désignés et une cadence de revue fixe transforment les indicateurs de qualité en contrôles. Un tableau de bord sans responsable de revue n’est qu’un papier peint.
L’échantillonnage reste important. Les recommandations d’assurance qualité fixent des limites strictes sur lesquelles les équipes peuvent agir. Au niveau d’un site, au maximum 5 % des participants inclus devraient ne pas satisfaire aux critères d’inclusion ou d’exclusion, le recrutement devrait atteindre au moins 90 % de l’objectif dans les délais, le taux d’abandon devrait rester inférieur ou égal à 5 % et le taux d’erreur de saisie inférieur ou égal à 0,001 %.
Indicateur | Seuil | Méthode de suivi |
|---|---|---|
Revérification aléatoire à la source | 5 % des enregistrements | Rapprocher les enregistrements sélectionnés des documents sources |
Non-respect des critères d’inclusion ou d’exclusion | Au maximum 5 % par site | Examiner les registres de sélection et les déviations au protocole |
Avancement du recrutement | Au moins 90 % de l’objectif dans les délais | Suivre le recrutement par rapport aux jalons prévus |
Taux d’abandon | Pas plus de 5 % | Surveiller les registres de rétention et de retrait |
Taux d’erreur de saisie | Pas plus de 0,001 % | Comparer les valeurs saisies aux champs sources et consigner les écarts |
L’objectif n’est pas de collecter ces mesures pour les admirer plus tard. Il s’agit de les examiner selon un calendrier fixe, d’attribuer un responsable à chaque seuil et de définir par écrit la marche à suivre avant le premier dépassement. C’est là qu’une vue de suivi de l’actualité des données est utile, car un contrôle tardif revient souvent à une absence de contrôle.
Adaptez la réponse au mode de défaillance. Une petite série d’erreurs de saisie appelle des revérifications ciblées, tandis que des écarts répétés sur le recrutement ou la rétention signifient généralement que le processus lui-même doit changer. Si le seuil ne déclenche pas d’action claire, il n’est que décoratif.
Documentation de la provenance et pistes d’audit
La question que pose un auditeur n’est jamais abstraite. C’est généralement : « D’où vient ce chiffre ? » Si votre réponse repose sur la mémoire, des conversations en aparté et une recherche dans d’anciens exports, le processus n’est pas encore auditable. La documentation de la provenance est la trace de l’origine, de la manipulation et de la transformation des données qui vous permet de répondre à cette question sans vous précipiter.
Une trace de provenance défendable indique qui a manipulé les données, ce qui a changé, quand et pourquoi. Elle conserve également la valeur d’origine lorsqu’une correction est apportée, car l’original est souvent le seul moyen de savoir si une correction était valide ou simplement commode. C’est particulièrement important lorsque plusieurs personnes ont modifié le même champ dans plusieurs outils.
Ce que doit contenir la piste d’audit
La structure la plus propre est simple. Conservez des fichiers de données sous contrôle de version, un journal des modifications lié à chaque étape de manipulation, des requêtes écrites pour les valeurs suspectes ou manquantes, et une déclaration explicite des données manquantes irrécupérables dans le plan d’analyse. Ces requêtes écrites comptent, car elles transforment l’incertitude en décision traçable plutôt qu’en exception enfouie.
Les recommandations de recherche sur le contrôle qualité itératif des données sont sans ambiguïté à ce sujet. Les équipes doivent effectuer des revues statistiques simples pendant la collecte, émettre des requêtes écrites pour les valeurs suspectes ou manquantes, et signaler explicitement les données manquantes irrécupérables dans le plan d’analyse (recommandations sur le workflow itératif). Ce n’est pas une charge bureaucratique : c’est ainsi que l’analyse reste honnête sur ce qui ne peut pas être réparé.
Si vous ne pouvez pas montrer le chemin de la source à l’analyse, vous n’avez pas une piste d’audit, vous avez une histoire.
Un relecteur qui demande « d’où vient ce chiffre » doit pouvoir consulter l’enregistrement source, la transformation appliquée, la date de la modification et la personne qui l’a approuvée. Si la réponse exige un projet de reconstruction, la piste est trop mince pour un travail sérieux. La provenance permet à l’équipe d’expliquer le chiffre au lieu de défendre le souvenir qu’elle en a.
La place de l’IA dans le contrôle qualité des données
L’IA est utile dans le contrôle qualité des données, mais seulement dans un couloir étroit. Elle peut faire ressortir des anomalies, regrouper des enregistrements suspects et repérer des schémas difficiles à coder sous forme de règles, ce qui compte lorsque le jeu de données est volumineux et la référence stable. Elle réduit aussi le temps de tri humain lorsqu’elle vient compléter la validation déterministe au lieu de la remplacer. Pour les équipes qui construisent cette couche, la manière dont l’IA détecte les anomalies de données dans les pipelines est le bon modèle à étudier.
Le risque est que le nettoyage automatisé invente des corrections d’apparence plausible mais fausses. Des publications académiques récentes soulignent un réel manque de benchmarks standardisés pour les systèmes de qualité des données fondés sur des LLM, et avertissent que le nettoyage automatisé peut introduire des corrections hallucinées. Considérez l’IA comme l’assistant d’un relecteur, et non comme l’autorité qui réécrit les enregistrements de sa propre initiative.
Usages sûrs et usages risqués
Les usages sûrs consistent à signaler des anomalies pour revue, à prioriser les enregistrements à soumettre à une inspection humaine et à suggérer des problèmes potentiels qu’une personne peut confirmer. Les usages risqués consistent à écraser des valeurs sources sans le signaler, à trancher des enregistrements ambigus sans validation humaine et à faire de l’IA le seul garde-fou avant publication.
Le garde-fou est ennuyeux mais efficace. Conservez les valeurs d’origine à côté de toute correction automatisée, examinez un échantillon des enregistrements signalés par l’IA et documentez le cheminement de décision pour chaque modification acceptée. Stockez la valeur d’origine dans une colonne distincte avec l’horodatage de la transformation et le nom de la personne qui l’a approuvée, afin que chaque correction reste réversible et auditable. Si votre équipe souhaite une vision plus large de la gouvernance, la ressource gouvernance et outils de données IA de MakeAutomation est un complément utile, car elle place l’IA au sein de contrôles opérationnels plutôt que dans l’effet de mode.
Pour les équipes qui veulent appliquer l’IA sans renoncer au contrôle, une plateforme comme digna peut s’insérer dans la couche de validation et de détection d’anomalies, où les contrôles restent inspectables et liés aux données sous-jacentes. C’est le bon modèle. L’IA vous aide à remarquer, les humains décident.
Votre checklist de contrôle qualité des données
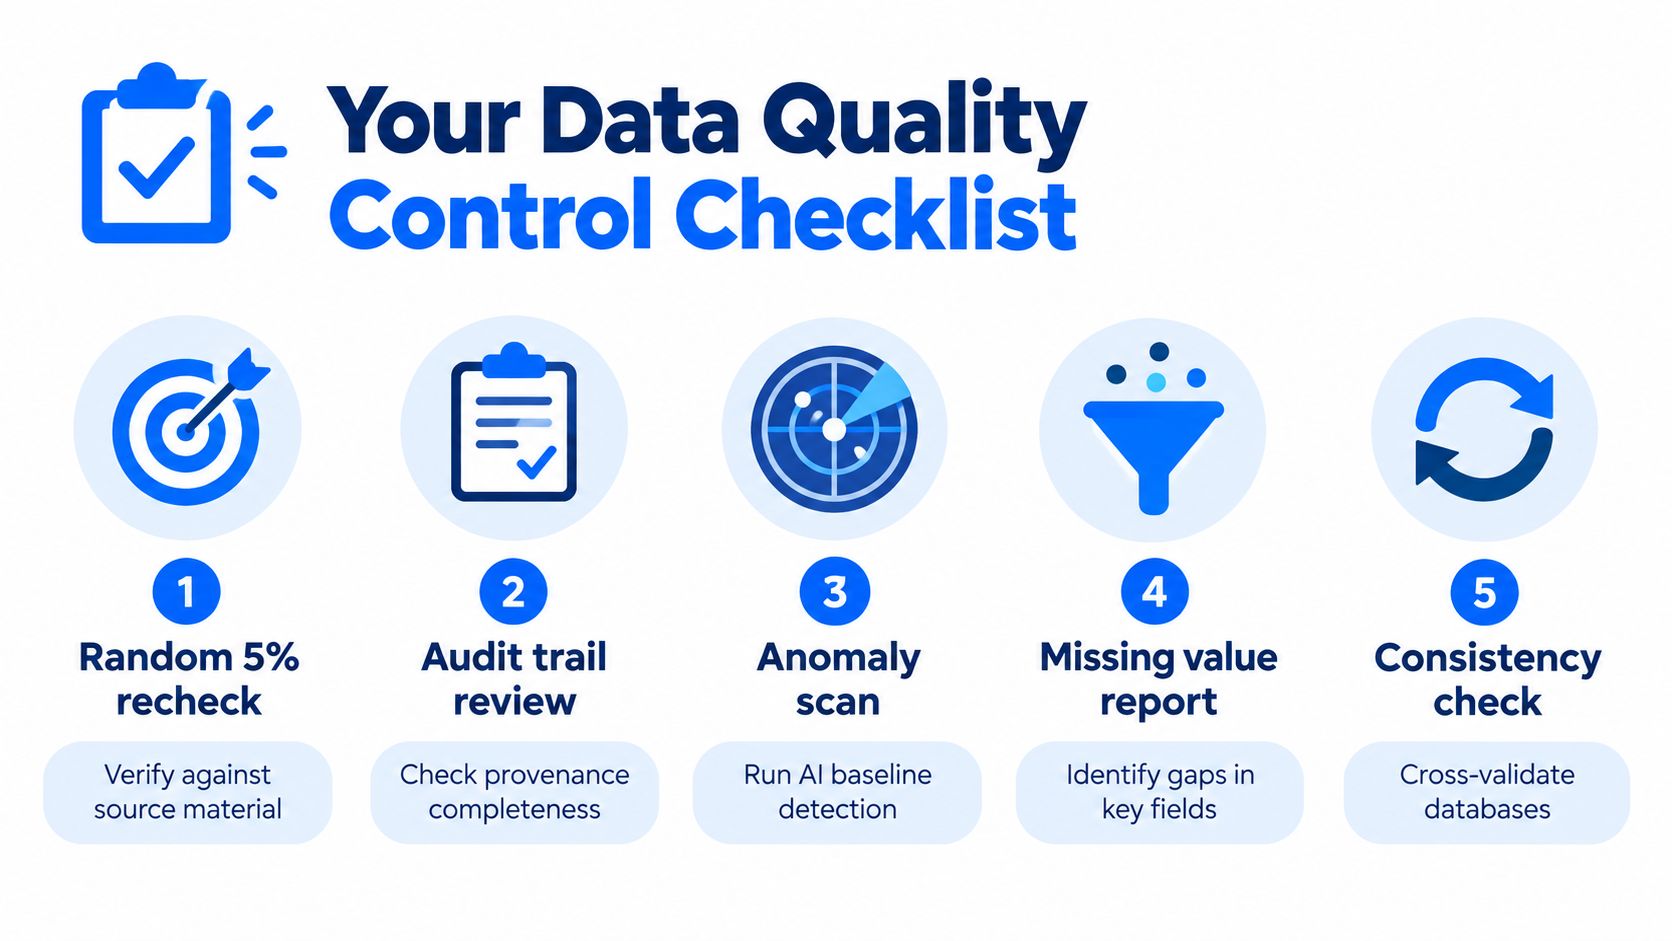
Une checklist ne fonctionne que si elle est assez courte pour être utilisée en plein travail et assez stricte pour détecter les dérives avant le début de l’analyse. Gardez-la sur le poste de travail, pas dans une présentation.
Revérification aléatoire à la source : revérifiez un échantillon aléatoire de 5 % par rapport aux documents sources selon un calendrier hebdomadaire fixe, afin de détecter les dérives de transcription tant que le fichier est encore ouvert.
Validation à chaque passage de relais : associez un contrôle spécifique à la transcription, au transfert, à la mise à jour, à l’enregistrement et à la revue. Une vague promesse de « vérifier plus tard » ne résiste pas à un pipeline chargé.
Responsable des seuils désigné : chargez une personne d’examiner selon le calendrier prévu les seuils de recrutement, d’abandon et d’erreur de saisie. Les indicateurs ne changent les comportements que lorsque quelqu’un en est clairement responsable.
Provenance consignée : conservez des fichiers sous contrôle de version, un journal des modifications et des requêtes écrites pour les valeurs suspectes ou manquantes, rattachés à la transformation exacte. Les audits ultérieurs deviennent ainsi possibles sans reconstituer toute la chaîne de mémoire.
Corrections de l’IA revues : exigez une revue humaine des enregistrements signalés par l’IA, conservez la valeur d’origine et consignez les raisons pour lesquelles une correction a été acceptée ou rejetée.
Cohérence entre bases de données : comparez les champs clés entre systèmes afin que les problèmes de concordance apparaissent avant la publication, et non après.
Si vous souhaitez un modèle opérationnel concret, associez cette checklist à une couche de contrôle en temps réel plutôt qu’à un énième tableur. Un dispositif de gouvernance et outils de données IA peut maintenir la validation au niveau des enregistrements, la détection d’anomalies, le suivi de l’actualité des données et le suivi des schémas au sein de l’environnement où les données résident déjà. digna s’intègre dans ce type de boucle de contrôle lorsque les équipes de recherche ont besoin de contrôles qui restent inspectables et liés aux enregistrements sous-jacents.
Pour les équipes qui veulent que les contrôles de plage, de cohérence et d’exhaustivité décrits ci-dessus s’exécutent automatiquement à chaque passage de relais plutôt que lors d’un balayage périodique, digna Data Validation exécute des règles au niveau des enregistrements directement dans la base de données où résident déjà les données de recherche.
Questions fréquentes
Quelles sont les cinq dimensions de la qualité des données en recherche ?
L’exhaustivité, l’exactitude, la concordance, la plausibilité et l’actualité. Ensemble, elles distinguent les valeurs manquantes des valeurs erronées, les désaccords entre systèmes des saisies impossibles, et les enregistrements obsolètes des enregistrements à jour. L’équipe de recherche dispose ainsi d’un vocabulaire commun pour décrire ce qu’un contrôle a réellement détecté, au lieu de se contenter de dire que les données semblent correctes.
À quel moment la validation des données doit-elle intervenir dans un projet de recherche ?
À chaque manipulation des données : lors de leur transcription, de leur transfert, de leur mise à jour ou de leur enregistrement sur un nouveau support. Les contrôles typiques incluent la double saisie, des contrôles programmatiques de plage et de cohérence, une revue régulière du taux d’erreur et une revue des mises à jour par un pair ou un responsable, et pas seulement une vérification finale avant l’analyse.
Quels seuils de qualité utilise-t-on en recherche clinique ?
Les recommandations du NINDS préconisent qu’au maximum 5 % des participants d’un site ne satisfassent pas aux critères d’inclusion ou d’exclusion, que le recrutement atteigne au moins 90 % de l’objectif dans les délais, que le taux d’abandon reste inférieur ou égal à 5 % et que le taux d’erreur de saisie reste inférieur ou égal à 0,001 %, avec une revérification aléatoire de 5 % des enregistrements par rapport aux documents sources.
Que doit contenir la piste d’audit des données de recherche ?
Des fichiers de données sous contrôle de version, un journal des modifications lié à chaque étape de manipulation, des requêtes écrites pour les valeurs suspectes ou manquantes et une déclaration explicite des données manquantes irrécupérables dans le plan d’analyse. Elle doit indiquer qui a modifié une valeur, quand et pourquoi, et conserver la valeur d’origine à côté de toute correction.
Peut-on faire confiance à l’IA pour nettoyer des données de recherche ?
Uniquement en tant qu’assistant. L’IA est utile pour signaler des anomalies et prioriser les enregistrements à soumettre à une revue humaine, mais le nettoyage automatisé peut inventer des corrections plausibles qui sont fausses. Conservez les valeurs d’origine à côté de chaque correction, examinez un échantillon des enregistrements signalés par l’IA et exigez une validation humaine avant d’accepter toute modification.



